

GLM-5.3 Flash est le modèle au meilleur rapport intelligence-prix que vous puissiez appeler aujourd'hui, et c'est difficile à contester. Artificial Analysis lui attribue 57 points sur son Intelligence Index pour environ 0,045 $ par tâche, trois points derrière le GLM-5.3 complet pour une fraction du prix. C'est le premier modèle nativement multimodal de la gamme GLM-5, il bat GLM-5.2 sur tous les benchmarks publiés par Z.ai, et les poids ouverts sont sur Hugging Face.
La nuance que la plupart des articles passent sous silence : c'est un modèle peu cher avec deux vrais astérisques. Sur l'API officielle de Z.ai, il est lent, autour de 49 tokens par seconde, et la réputation de « modèle le plus lent qu'AA ait jamais vu » vient de ce point d'accès, pas des poids. Passez chez un hébergeur comme Databricks et le même modèle donne 273 tokens par seconde. L'autre astérisque concerne les données : pas d'accord signé, pas de niveau à rétention nulle, et le service officiel relève du droit de la République populaire de Chine.
Mon verdict en bref. Si vous faites du code à fort volume, des exécutions d'agents ou du travail de vision et que le coût compte plus que la latence, GLM-5.3 Flash est un oui facile, surtout auto-hébergé. Si vous placez un modèle devant des clients en temps réel, le prix n'a jamais été votre vrai problème, et j'y reviens à la fin.
D'abord, de quel GLM-5.3 parle-t-on ?
Cela embrouille beaucoup de monde, alors je clarifie vite. Deux modèles portent « 5.3 » dans leur nom, et ce n'est pas la même chose.
Le GLM-5.3 phare est un modèle texte seul pour le code et la cybersécurité, affiché à 1,40 $ en entrée et 4,40 $ en sortie par million de tokens. GLM-5.3 Flash est son cousin moins cher et multimodal, lancé le 26 août 2026, et c'est lui que cet avis couvre. Il compte 320 Md de paramètres au total dont seulement 18 Md actifs dans une architecture de mélange d'experts, et avant son lancement Z.ai l'a fait tourner de façon anonyme sous le nom « ox-alpha » sur OpenRouter et OpenCode, où il est brièvement devenu le modèle le plus utilisé de la semaine, le tout servi sur des puces d'IA chinoises.
Donc, quand un tableau de benchmarks indique « GLM-5.3 », vérifiez lequel. Les scores que je cite ci-dessous sont ceux de Flash, sauf mention contraire. Pour un tour plus large de la famille, la présentation de GLM-5.3 Flash explique comment les deux s'articulent.
Je l'ai évalué comme tout grand modèle de langage que je pourrais vraiment mettre au travail : j'ai lu les deux classements, relevé le tableau de benchmarks du fournisseur, recoupé avec Artificial Analysis et la page du modèle chez Cloudflare, et confronté les promesses marketing à ce que les praticiens ont dit après l'avoir testé eux-mêmes.
Les benchmarks : où il se situe vraiment
Le message de Z.ai est que GLM-5.3 Flash « outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks. » Le tableau publié confirme nettement la première moitié.
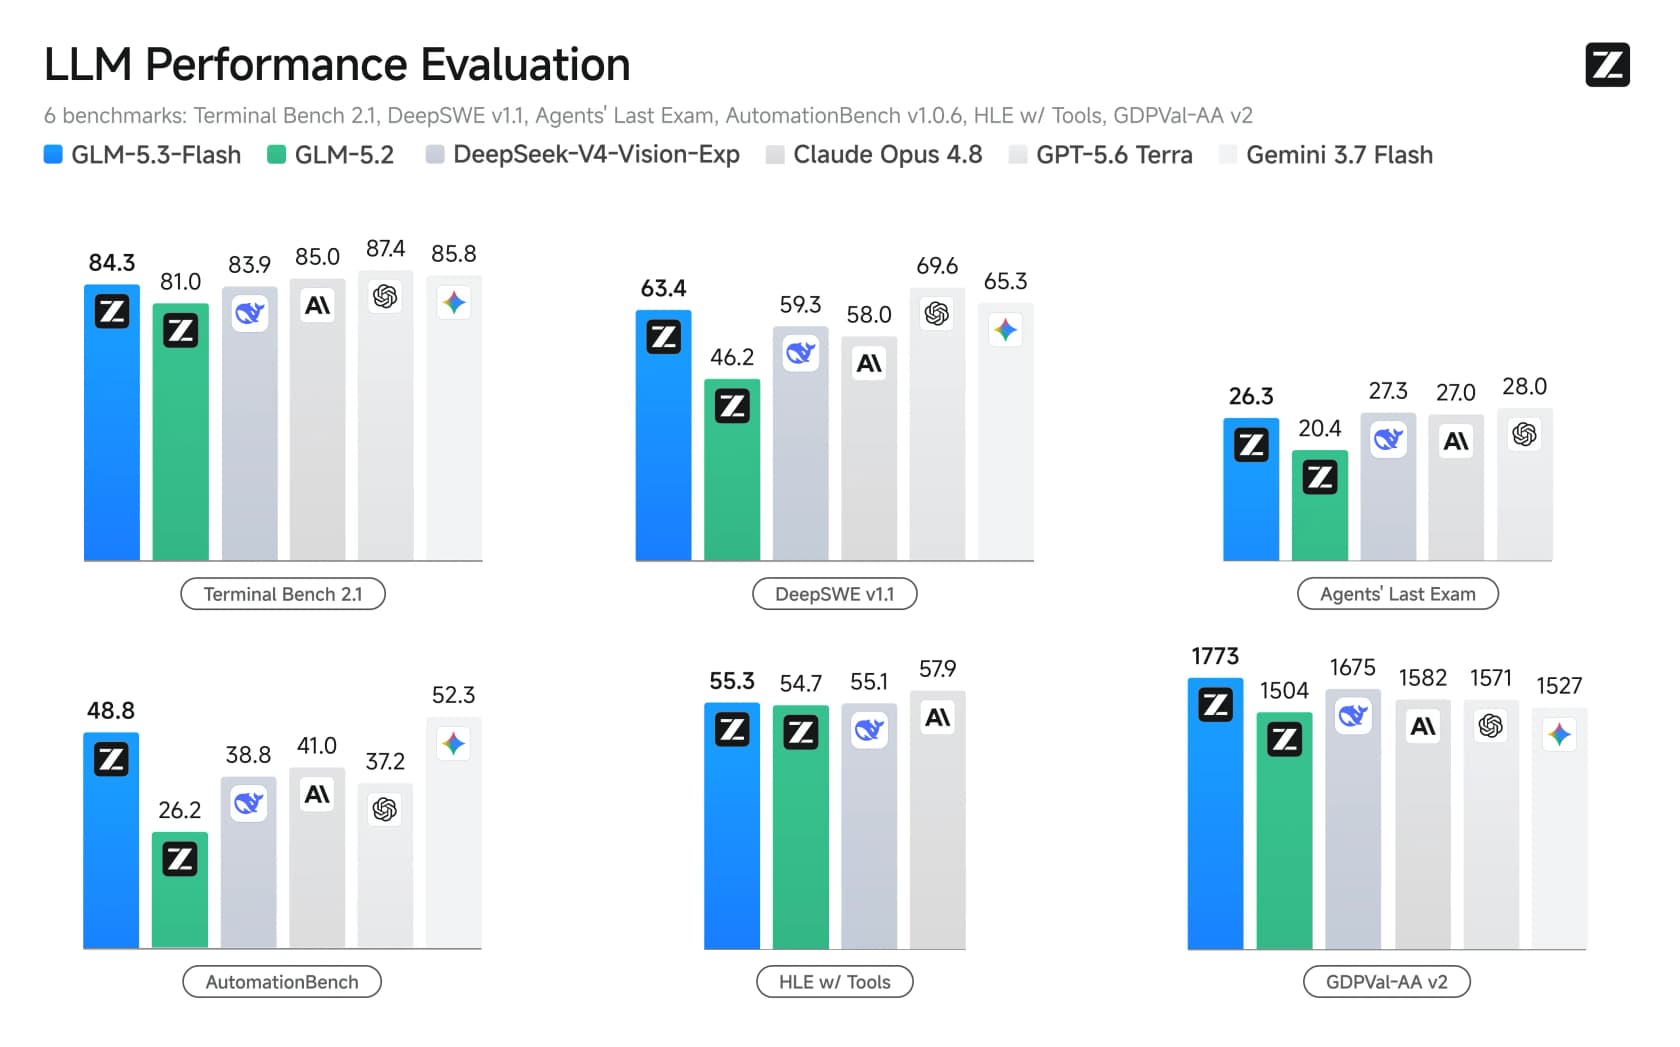
Les bonds par rapport à GLM-5.2 sont importants et constants : DeepSWE v1.1 passe de 46,2 à 63,4, AutomationBench de 26,2 à 48,8 et GDPval-AA v2 de 1504 à 1773. Sur Z.ai Code Bench v1.0, exécuté dans Claude Code à effort maximal, Flash obtient 29,0 contre 29,5 pour Claude Opus 4.8, ce qui illustre bien l'expression « égale presque Opus ».
La formule « se rapproche d'Opus » est juste pour le code et les tâches d'agents, et elle est honnête sur sa limite. Face aux modèles fermés de pointe, GPT-5.6 Terra remporte DeepSWE (69,6) et Gemini 3.7 Flash devance de peu AutomationBench (52,3). GLM-5.3 Flash ne bat pas franchement les meilleurs modèles fermés. Il arrive dans le même voisinage pour un dixième du prix, ce qui est une affirmation différente et plus intéressante.
Là où il domine nettement le tableau, c'est à deux endroits où personne n'attend un modèle économique : il est en tête de GDPval-AA v2 avec 1773, et sur les lignes de vision il affiche 89,4 sur CharXiv reasoning et 80,5 sur MMVU, devant DeepSeek-V4-Vision-Exp et Opus sur les deux. Pour un modèle aussi bon marché, c'est la surprise.
Une réserve à énoncer clairement : aucune des deux pages ne donne de score MMLU, GPQA ou AIME. Z.ai publie une suite code, agents et vision, pas un tableau classique de connaissances académiques ; si votre usage repose sur un large rappel de faits, les preuves publiées ne disent tout simplement rien. Voyez-y un trou dans les données, ni une réussite ni un échec.
Le prix, c'est toute l'histoire
Voici le chiffre qui justifie un avis sur GLM-5.3 Flash. Pendant la promotion de lancement, il coûte 0,075 $ par million de tokens en entrée et 0,25 $ en sortie, avec un tarif d'entrée en cache de 0,015 $. Le tarif catalogue après la fin de la promotion, le 9 septembre 2026, est de 0,15 $ et 0,50 $. Dans les deux cas, c'est environ un dixième du GLM-5.3 phare, et cela le place sur la frontière d'efficacité de tout le marché.
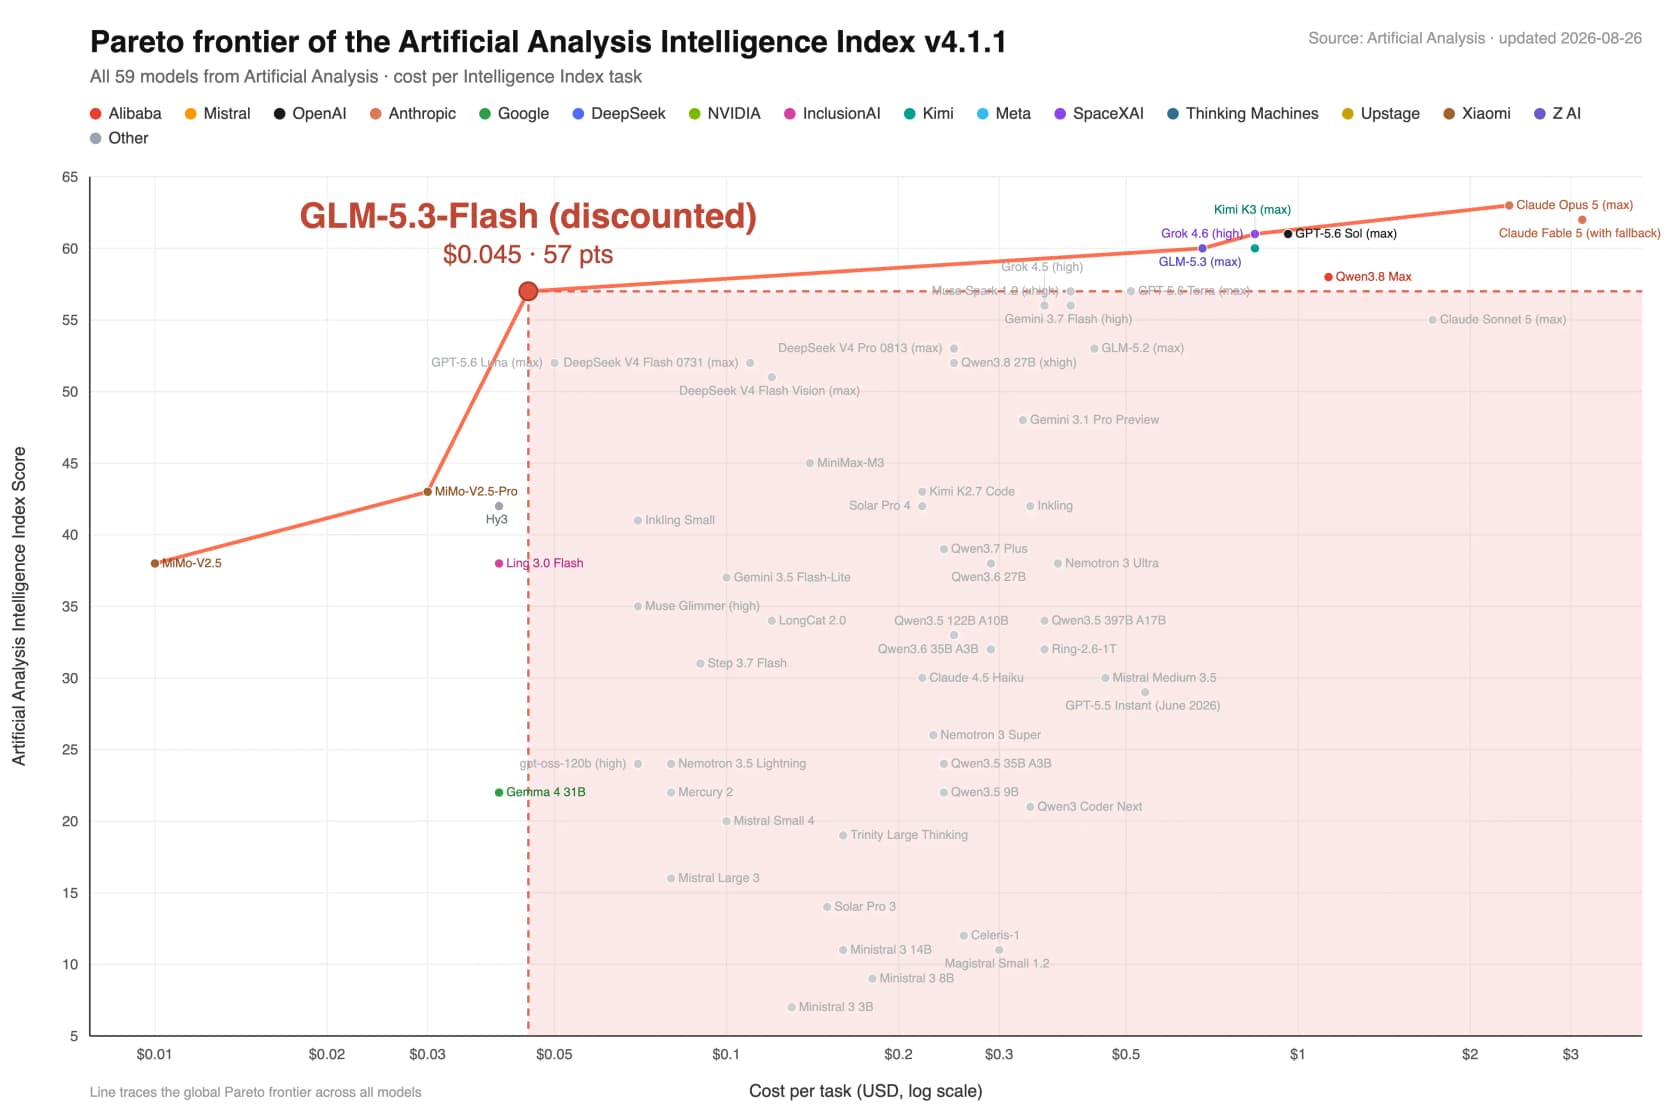
Ce point rouge est l'argument de vente. GLM-5.3 Flash repousse la frontière de Pareto : pour l'intelligence qu'il offre, rien sur le graphique n'est moins cher, et la formule de Z.ai est qu'il s'agit de « a level of intelligence previously only available at roughly 10x the cost. » La réaction de la communauté a surtout été l'incrédulité face à cela.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

La voie du Coding Plan mérite d'être mentionnée, car c'est là que la plupart des gens rencontreront vraiment ce modèle. Le GLM Coding Plan de Z.ai coûte 18 $, 80 $ et 168 $ par mois pour Lite, Pro et Max, fonctionne dans Claude Code, Cline, OpenCode, Cursor et Roo Code, et Flash vous donne 3 fois le quota utilisable de GLM-5.3 sur le même forfait. Si vous payez déjà un abonnement de code, Flash est le réglage qui fait durer vos crédits trois fois plus longtemps. Pour comparer avec les autres options de pointe économiques, l'avis sur DeepSeek V4 Flash et l'avis sur Kimi K3 couvrent les rivaux les plus proches, et Qwen 3.8 Max est la marche supérieure en prix.
Choisissez ce qui compte le plus pour vous, et je vous donne mon avis franc.
Pourquoi il peut coûter si peu
Un prix aussi bas signifie généralement un petit modèle peu malin. Celui-ci n'est ni l'un ni l'autre, et la raison est architecturale, pas une remise qui va s'évaporer. Selon Z.ai, le coût vient de trois couches qui travaillent ensemble, pas d'une seule astuce.
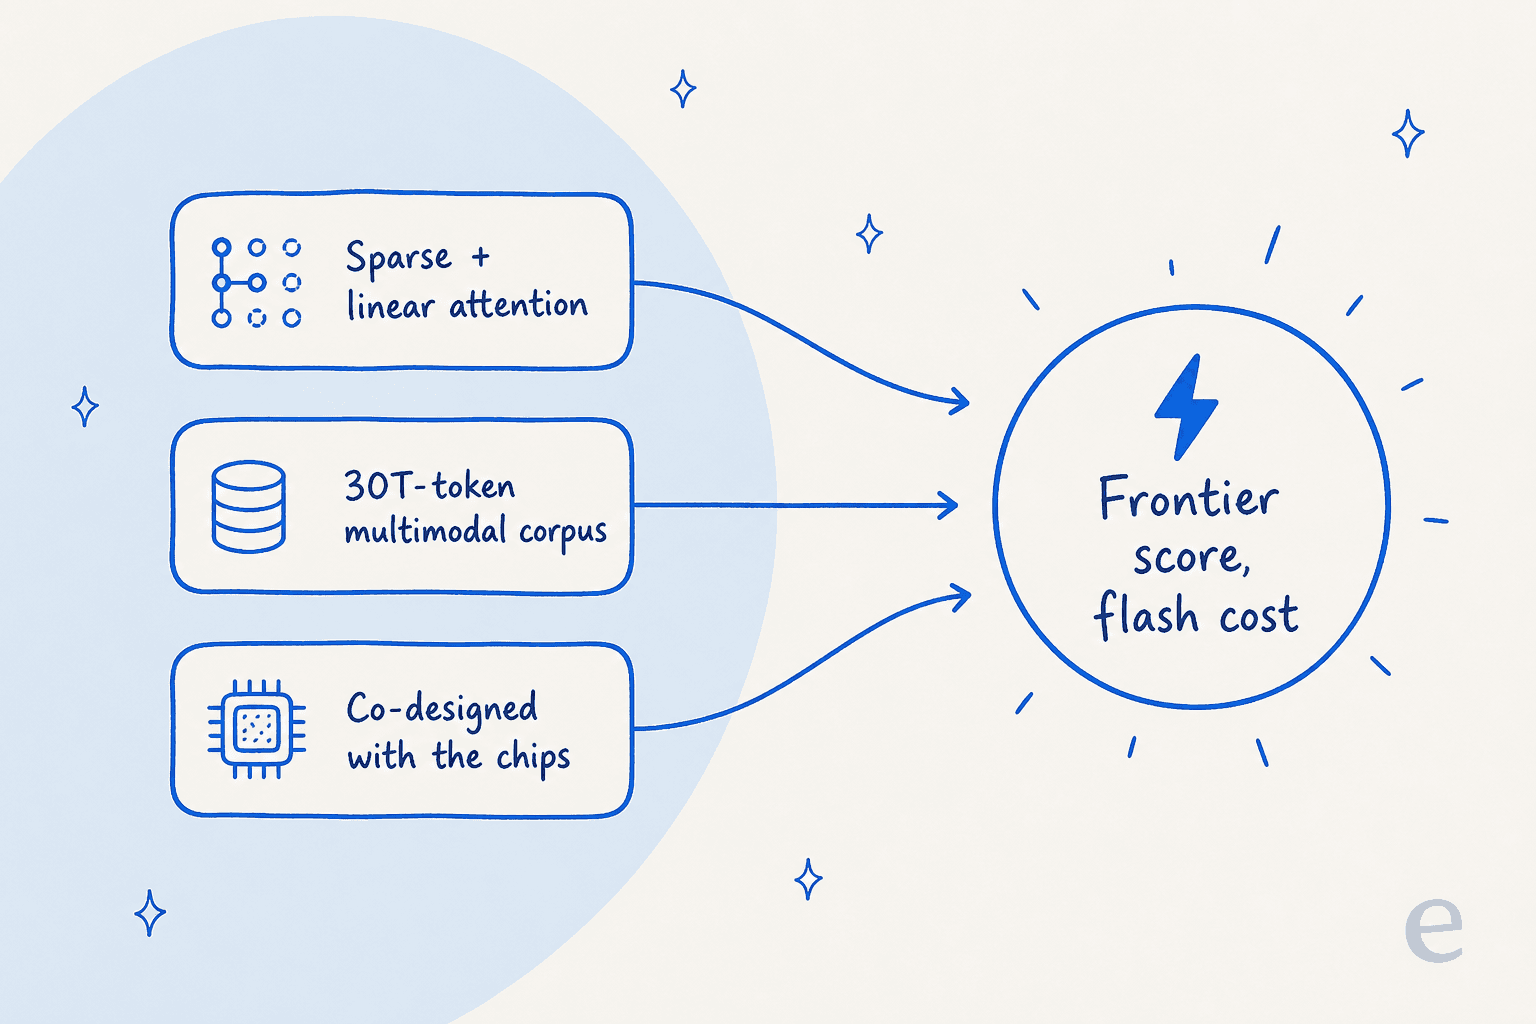
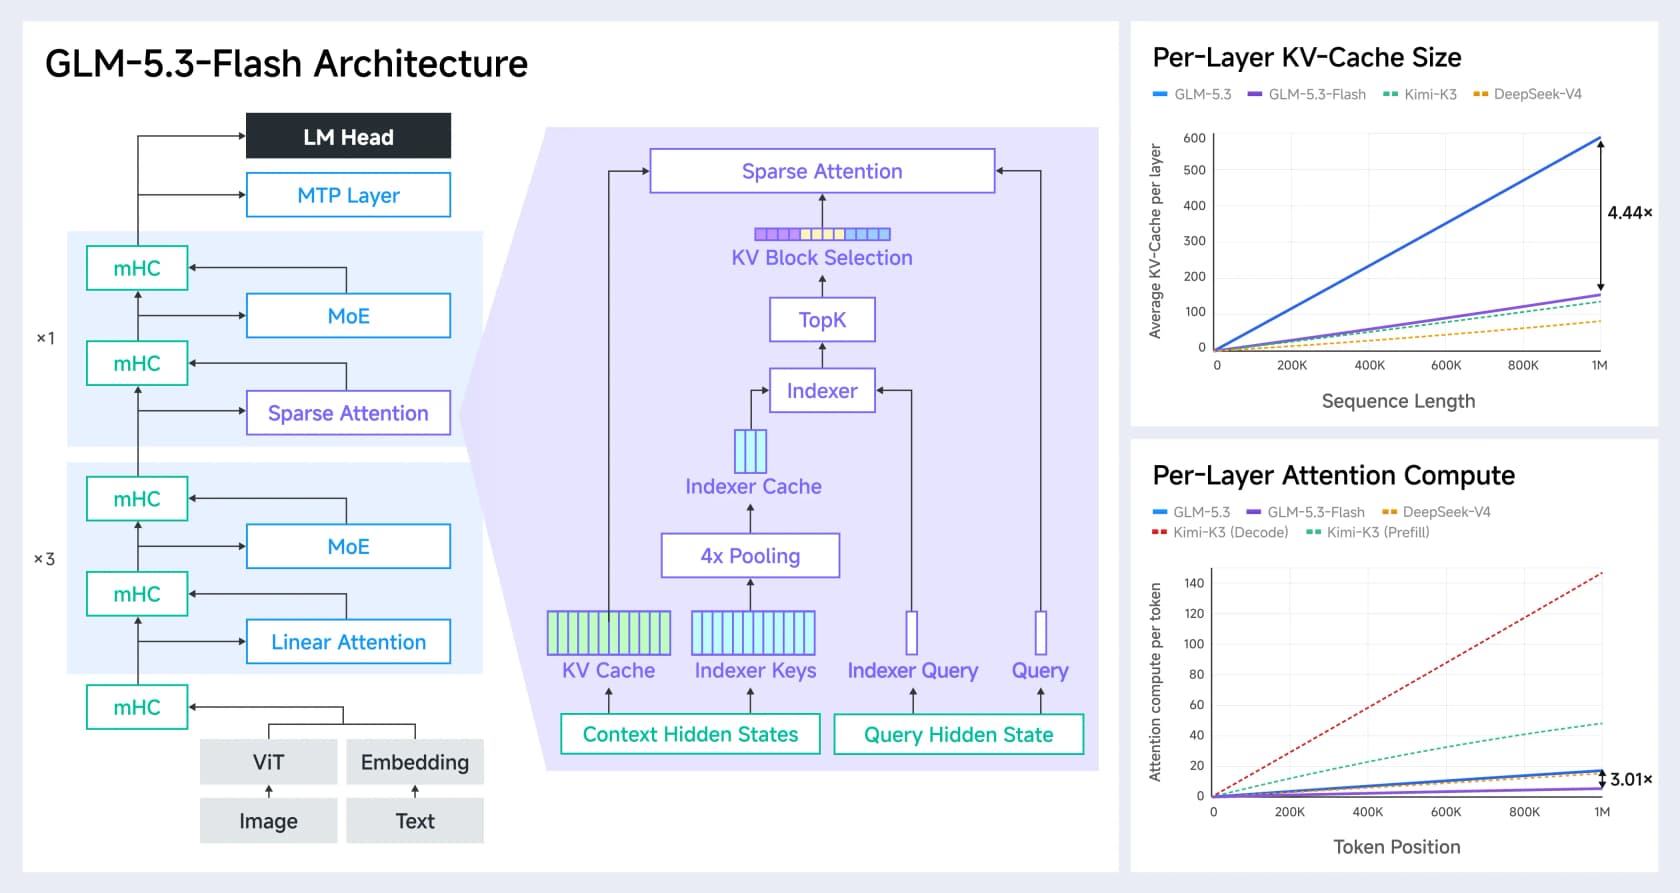
L'élément porteur est la conception de l'attention. GLM-5.3 Flash est le premier modèle ouvert à combiner attention éparse et linéaire : l'attention linéaire traite les dépendances locales par modélisation d'état, tandis qu'un indexeur léger récupère le contexte global. Le résultat, selon Z.ai, est 3 fois moins de calcul d'attention et un cache KV 4,4 fois plus petit que le GLM-5.3 phare, ce qui explique l'essentiel du fait que le servir avec 1 M de tokens de contexte reste abordable.
Les deux autres couches comptent moins au quotidien, mais méritent d'être connues. Il a été entraîné sur un corpus multimodal de 30 000 milliards de tokens, et l'ensemble a été co-conçu avec du matériel d'inférence chinois, point sur lequel Z.ai revient sans cesse : « Chinese chips can support frontier-model inference efficiently and economically at scale. » Comparé à l'ancien GLM-4.5, Flash réduit presque de moitié à la fois les paramètres actifs (18 Md contre 32 Md) et le nombre de couches (45 contre 92) pour une taille totale similaire. C'est une vraie histoire d'efficacité, pas un produit d'appel de la semaine de lancement.
Le pari multimodal : la vision dans la boucle de code
Le plus intéressant de ce que fait GLM-5.3 Flash ne figure pas dans le tableau de benchmarks. Il intègre la vision dans la boucle de code, si bien que le modèle peut rendre sa propre sortie, la regarder et corriger ce qui cloche. La formule de Z.ai est la plus nette : « Code lets the model build and change the world. Vision lets it enter the world people see and use. »
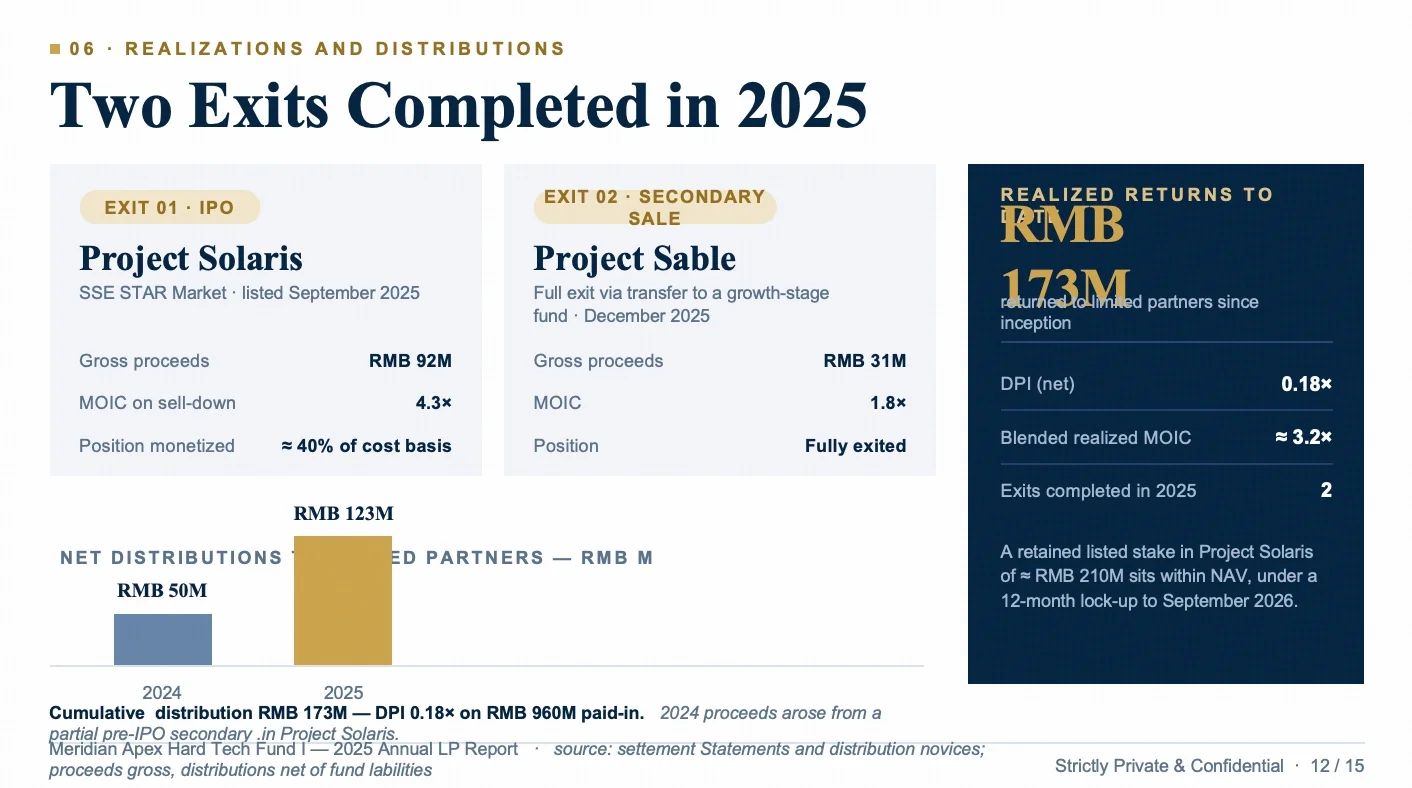
La démonstration la plus claire est une diapositive qu'il a générée puis réparée tout seul. Voici le premier jet, avec du texte qui se chevauche et une mise en page cassée :
Et voici la même diapositive après que le modèle a regardé son propre rendu et corrigé la collision :
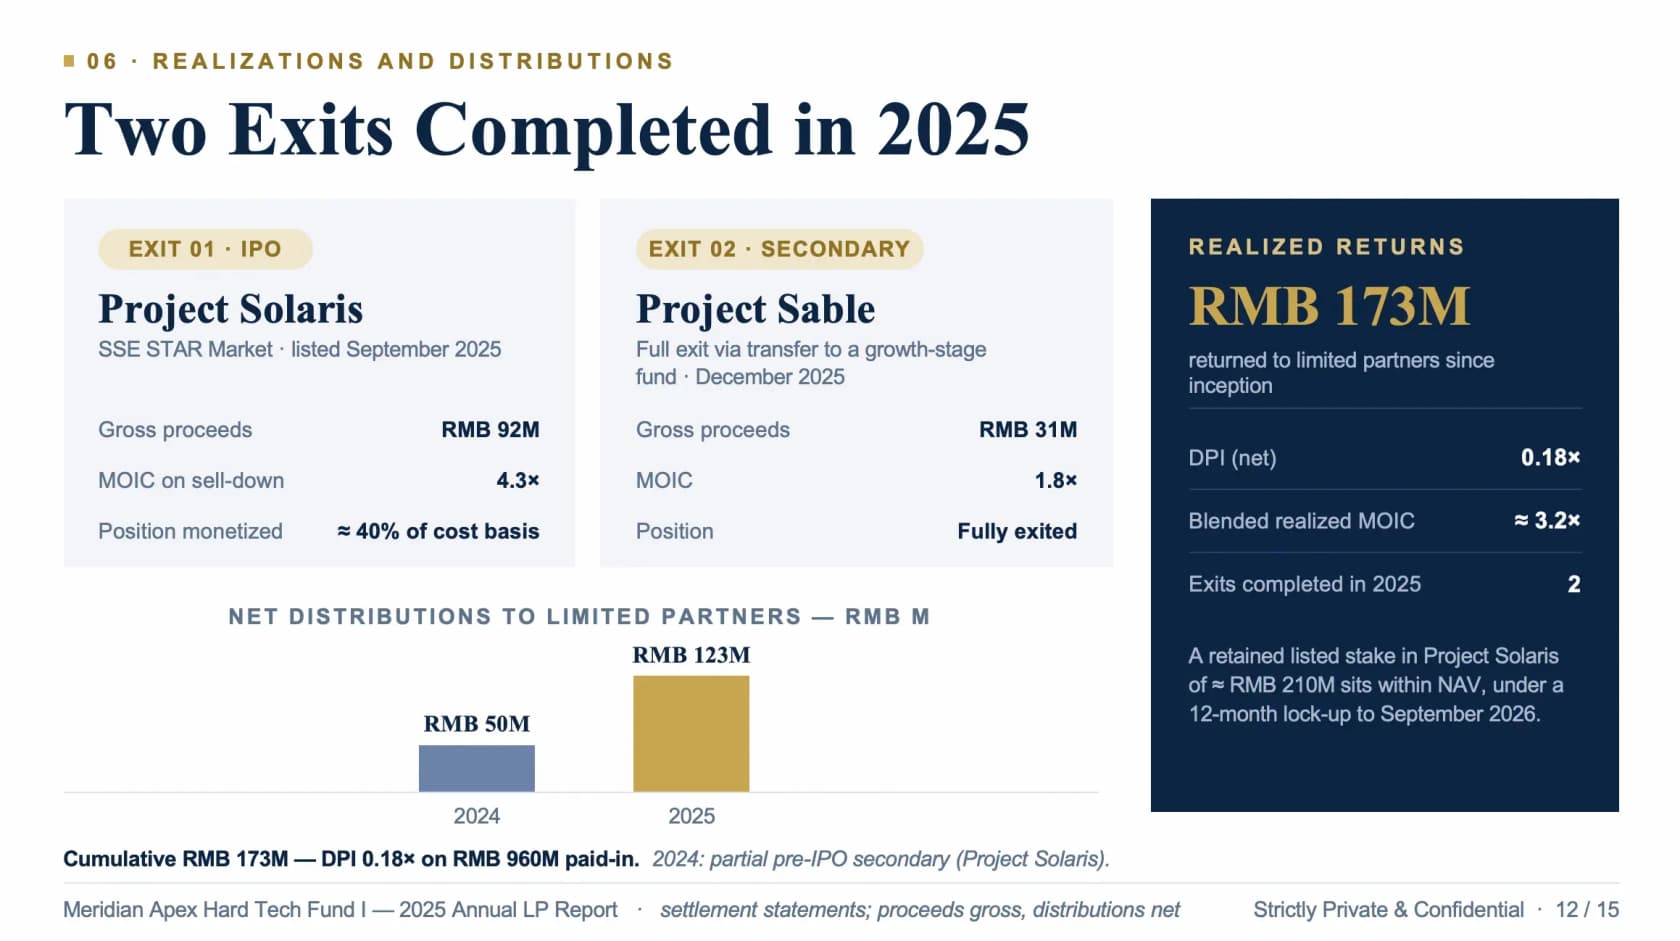
C'est une boucle utile pour le frontend, les jeux et la 3D, où « ça compile » et « ça a l'air juste » sont deux questions différentes. Elle va aussi au-delà du code, jusqu'à la lecture de tableaux de bord, de feuilles de calcul et de présentations, ainsi que des agents d'usage d'ordinateur et de navigateur dans ZCode. Les praticiens qui ont testé la partie vision en sont ressortis convaincus :
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
Je considérerais tout de même l'autovérification comme un réflexe utile plutôt qu'une garantie. Elle repère les erreurs visuelles évidentes ; elle ne remplace pas un humain qui regarde ce qui part en production. Mais pour une première version nativement multimodale, la qualité de vision est bien au-dessus de ce que le prix laisse supposer.
Là où il flanche
Un avis qui ne liste que des points forts est un communiqué de presse. GLM-5.3 Flash a deux points faibles à connaître avant de le brancher sur quoi que ce soit.
L'API officielle est lente, et la réputation est méritée. Sur le point d'accès de Z.ai, il tourne à environ 49 tokens par seconde, contre environ 86 pour le GLM-5.3 complet, et un fil de discussion l'a dit sans détour.
"GLM 5.3 Flash is one of the slowest models AA [has ever seen]. GLM's visible context grows half as fast as Deepseek Flash and is much more precise and direct."
La nuance importante, et la raison pour laquelle je ne laisserais pas cette citation trancher, c'est qu'elle décrit le service officiel, pas les poids. Artificial Analysis recense 11 fournisseurs, et l'écart est énorme.
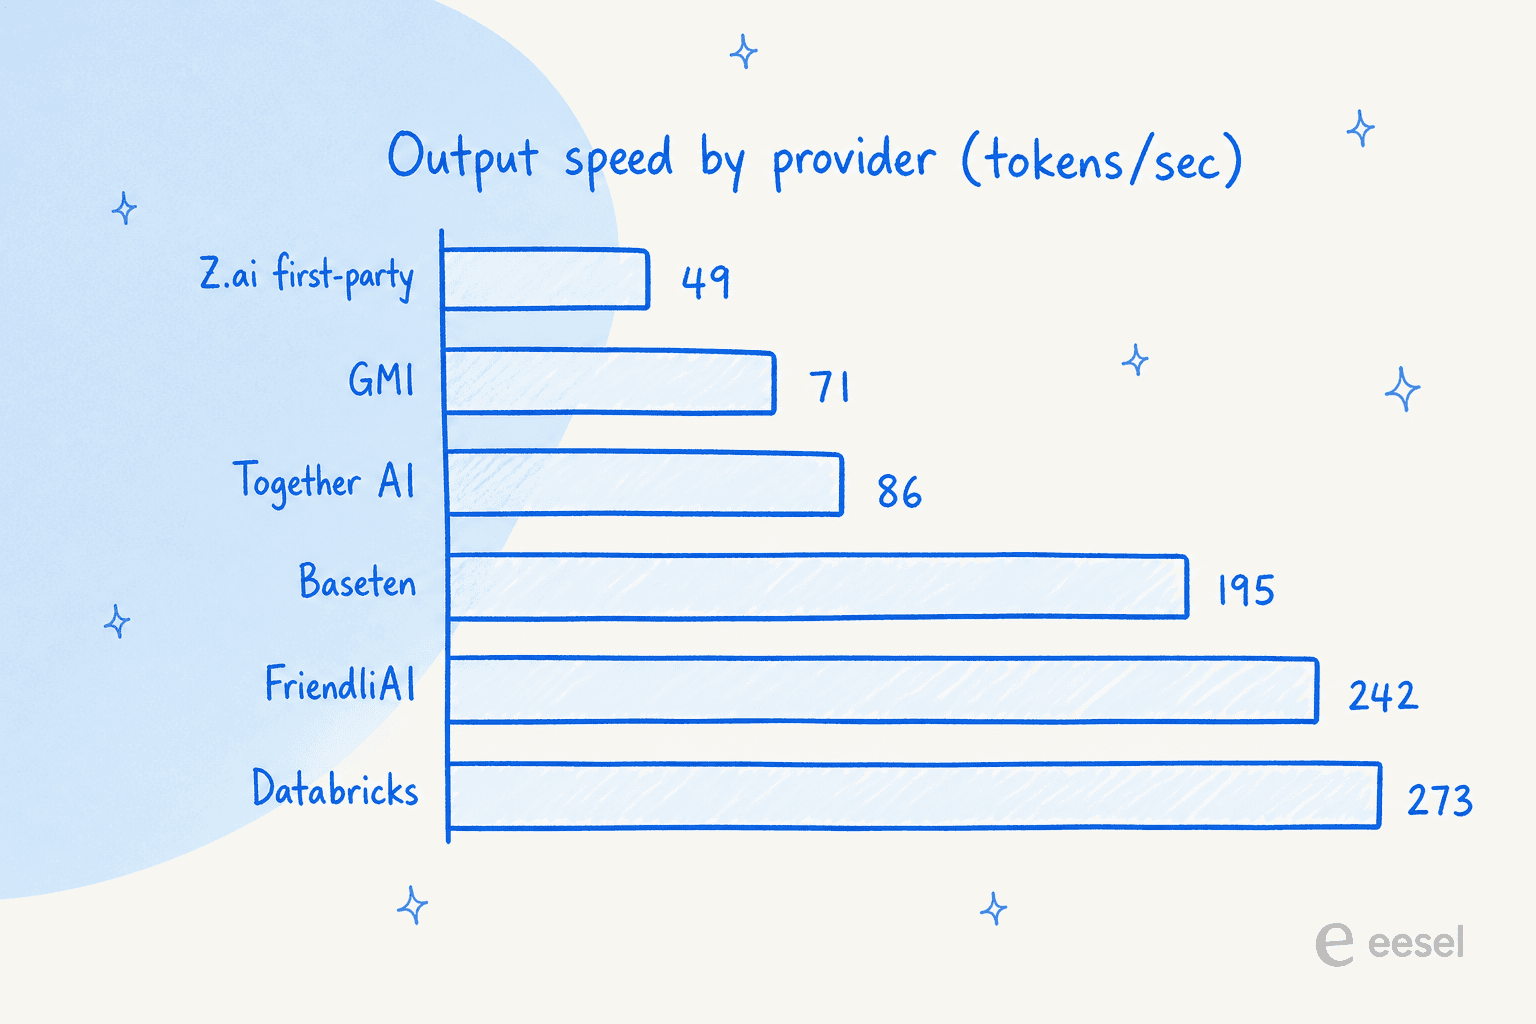
Databricks sert le même modèle à 272,9 tokens par seconde, plus de cinq fois le débit de l'API officielle, avec un délai de 8 secondes avant le premier token. Donc « GLM-5.3 Flash est lent » veut en réalité dire « l'API de Z.ai est lente ». Choisissez votre hébergeur avec soin et le problème disparaît en grande partie. La page de benchmark des fournisseurs est à consulter avant de vous engager, et si vous y faites passer du trafic réel, une bonne mise en place du suivi d'usage vous évitera une mauvaise surprise sur la facture.
Le volet données est mince si vous traitez du contenu client. L'API officielle ne propose aucun accord de traitement des données publié ni option de rétention nulle, et le service relève du droit de la RPC. C'est une vraie contrainte, pas une critique du modèle, et la solution honnête, ce sont les poids ouverts : l'auto-hébergement sous SGLang, vLLM ou TokenSpeed est le moyen d'obtenir un circuit de données maîtrisé. Si cela touche à des données clients, SOC 2 et RGPD est à lire en premier.
Autre point à anticiper : la série GLM-5.3 réfléchit d'abord, donc prévoyez les tokens de raisonnement dans vos coûts. Cloudflare expose un contrôle reasoning_effort avec les réglages low, medium et high, ce qui permet de baisser pour les tâches simples, mais il n'existe pas de mode gratuit « ne rien penser » comme certains modèles en proposent. C'est aussi une note sur les hallucinations déguisée : plus de raisonnement ne veut pas dire plus de justesse, et l'autovérification visuelle ne s'étend pas aux affirmations factuelles.
Ce que les gens construisent vraiment avec
Le signal le plus parlant n'est pas un benchmark, c'est que fournisseurs et développeurs l'ont adopté en quelques jours. James Grugett l'a intégré gratuitement à un produit dès le lancement :
"GLM 5.3 Flash is 100% free in our [product]. Leading capabilities at a highly competitive price - Natively multimodal with a 1M-token context window. Previously previewed as Ox Alpha."
C'est dans la revue de sécurité que le rapport qualité-prix a suscité la plus forte réaction. Une équipe l'a fait tourner sur un benchmark de vulnérabilités et a fait le calcul :
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Voilà la forme d'un bon travail pour GLM-5.3 Flash : fort volume, tolérant à une exécution un peu plus lente, et si peu cher qu'on peut le lancer sur des tâches pour lesquelles on ne paierait jamais un modèle de pointe. Le panorama des meilleurs agents IA open source donne d'autres exemples, et si le travail concerne précisément le support, le meilleur modèle pour les tickets de support est une lecture plus ciblée sur ce qui compte vraiment.
Mon verdict, selon l'usage
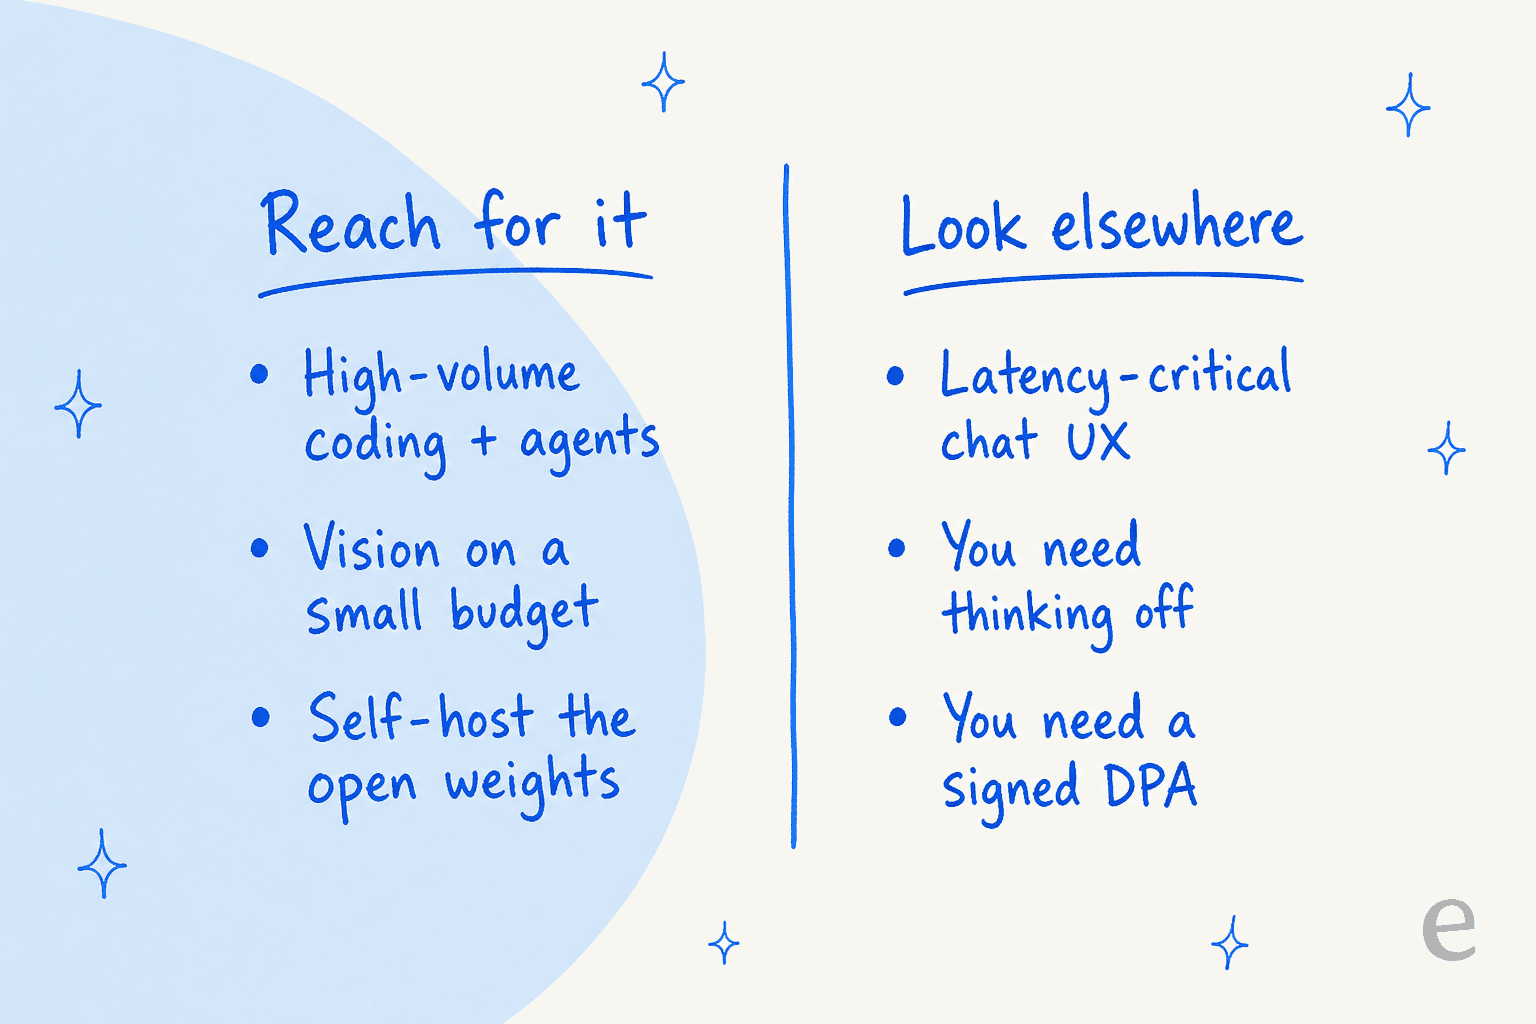
Choisissez GLM-5.3 Flash si vous faites du code à fort volume ou du travail d'agents, si vous voulez une vraie qualité de vision sans prix de pointe, ou si vous voulez auto-héberger des poids ouverts et garder vos données chez vous. Sur ces trois points, c'est l'un des meilleurs rapports qualité-prix actuels, et la présentation de GLM-5.3 Flash est l'endroit où je vous enverrais pour le mettre en place.
Regardez ailleurs si la latence est votre produit et que vous ne contrôlez pas le fournisseur, si vous avez besoin d'un mode qui saute complètement le raisonnement, ou si vous avez besoin d'un accord de données signé que vous ne pouvez pas obtenir sans auto-hébergement. Rien de tout cela n'est rédhibitoire, mais ce sont les situations où un modèle plus cher, plus rapide ou plus encadré mérite sa prime. Si vous le comparez à une option fermée de pointe, les tarifs de Claude Opus 5 sont le point de référence à l'autre bout de l'échelle.
La version en une ligne : GLM-5.3 Flash est le modèle que je choisirais par défaut pour un travail peu cher, à fort volume et tolérant à la lenteur, et celui que je testerais soigneusement avant d'y parier un produit sensible à la latence.
Try eesel
Si vous êtes arrivé ici en comparant des tarifs au token parce que vous voulez qu'une IA gère votre support, voici ce que je dirais autour d'un café : le prix du token n'a jamais été la partie difficile. Un modèle comme GLM-5.3 Flash est le moteur. Le brancher à votre helpdesk, l'ancrer dans vos vraies macros et vos anciens tickets, et savoir ce qu'il dira avant qu'un client le voie, voilà le vrai travail, et c'est un tout autre produit.
C'est là qu'eesel intervient. eesel vous donne des coéquipiers IA prêts à travailler pour des tâches précises, un agent de support IA qui se branche sur Zendesk ou votre helpdesk actuel, et un rédacteur de blog IA pour le contenu. Chacun arrive avec les compétences, les intégrations et le contexte d'entreprise de son rôle, de sorte que vous embauchez un coéquipier au lieu de louer un accès brut à un modèle.
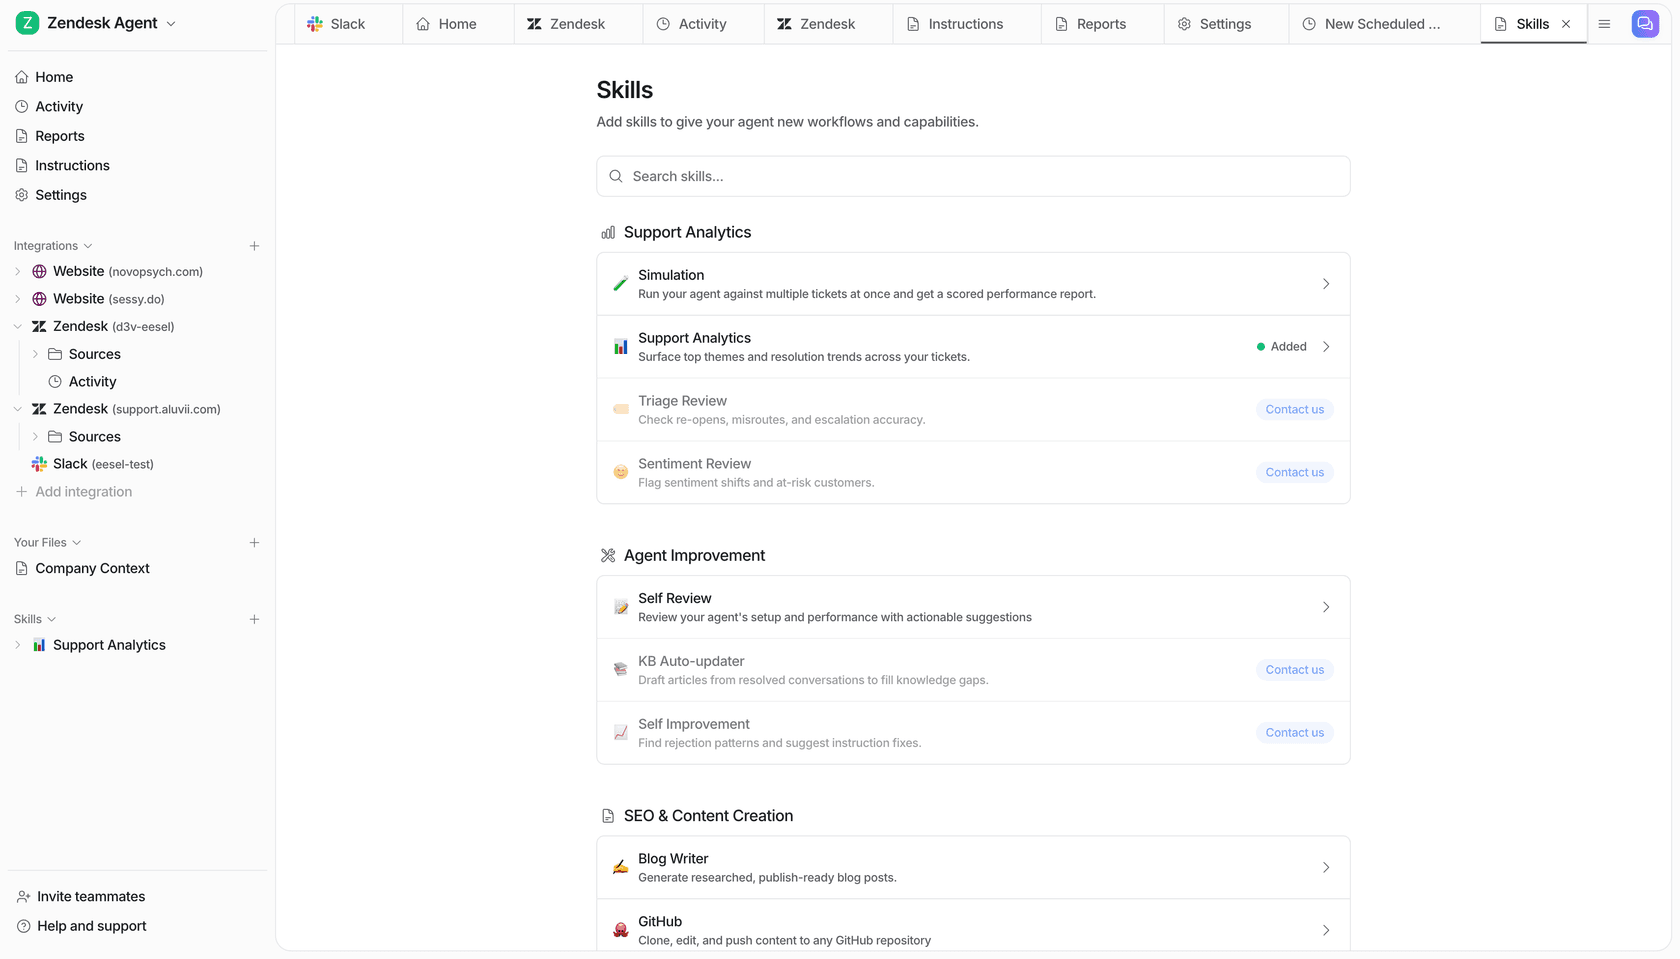
Ce qui compte le plus pour le support : nous mettons des agents IA sur de vraies files de support depuis des années, et nous avons vu un bot à l'air sûr de lui raconter un travail qu'il n'avait jamais fait. C'est précisément pourquoi chaque déploiement eesel est simulé sur d'anciens tickets avant de toucher une vraie conversation. La tarification est un prix mensuel fixe dimensionné selon le volume (1 crédit par ticket ou chat) plutôt que par poste, donc un déploiement progressif est réaliste, et 100 crédits gratuits sont offerts pour démarrer. Ce modèle de crédits explique aussi pourquoi le coût du service client par IA diffère d'une facture de tokens brute. Lancez une simulation sur les tickets du mois dernier et vous saurez en une heure si cela vaut votre temps, ce qui vaut mieux que tester un modèle à l'aveugle.