Ce qu'est vraiment Xiaomi MiMo V2.6
Je conçois des intégrations et des API pour gagner ma vie, donc mon premier réflexe face à un lancement de ce genre est de zapper la page marketing et de lire la fiche du modèle. La fiche de MiMo V2.6 tient la route.
MiMo V2.6 est une famille de modèles de langage à poids ouverts et nativement omnimodaux de l'équipe MiMo de Xiaomi, publiée le 22 septembre 2026. « Nativement omnimodal » n'est pas un vain mot dans cette phrase : le même modèle traite le texte, les images, la vidéo et l'audio, plutôt que de greffer après coup un adaptateur de vision sur un modèle textuel. Chaque version de la famille embarque une fenêtre de contexte d'un million de tokens.
Le slogan de lancement est « Scaling Reinforcement Learning Toward Self-Improvement », et Xiaomi présente toute la série comme une étape sur une voie d'auto-amélioration récursive : faire monter en échelle le calcul de RL sur des tâches complexes et vérifiables, et laisser le modèle repousser lui-même sa propre frontière de capacités. C'est le genre de phrase qui me fait habituellement lever les yeux au ciel, mais le rapport technique contient suffisamment de méthode concrète derrière pour se lire comme de l'ingénierie, pas comme un communiqué de presse.
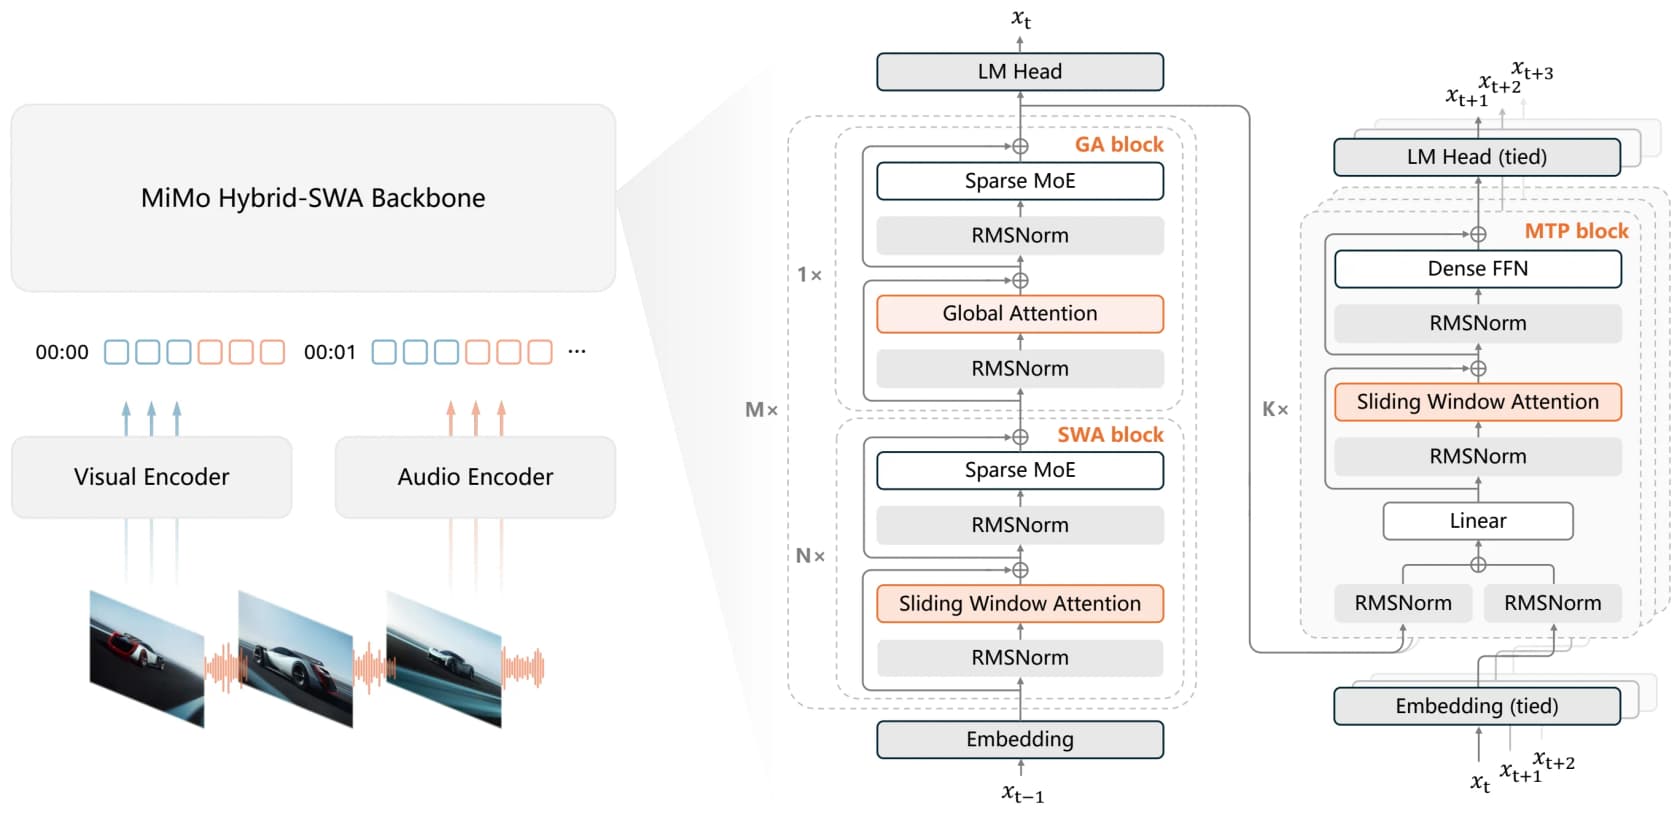
Pour la version en un paragraphe de l'architecture : Pro est un modèle de mélange d'experts creux avec un socle d'attention hybride : 70 couches qui entrelacent l'attention locale à fenêtre glissante (fenêtre de 128) avec l'attention globale, 384 experts routés dont 8 s'activent par token, un encodeur visuel de 681 millions de paramètres, des encodeurs audio dédiés, et un décodeur à prédiction multi-token à 5 couches qui prédit plusieurs tokens par passe avant pour accélérer le décodage. Vous n'avez besoin de vous soucier de rien de tout ça pour l'utiliser, mais cela explique comment un modèle « d'un billion de paramètres » reste bon marché à faire tourner : seuls 42 milliards de ces paramètres sont actifs sur un token donné.
La famille de modèles, de Flash à un Pro à un billion de paramètres
MiMo V2.6 n'est pas un seul modèle, ce sont quatre versions destinées à quatre usages différents. C'est de là que vient une bonne partie de la confusion en ligne, donc cela vaut la peine de bien poser les choses.
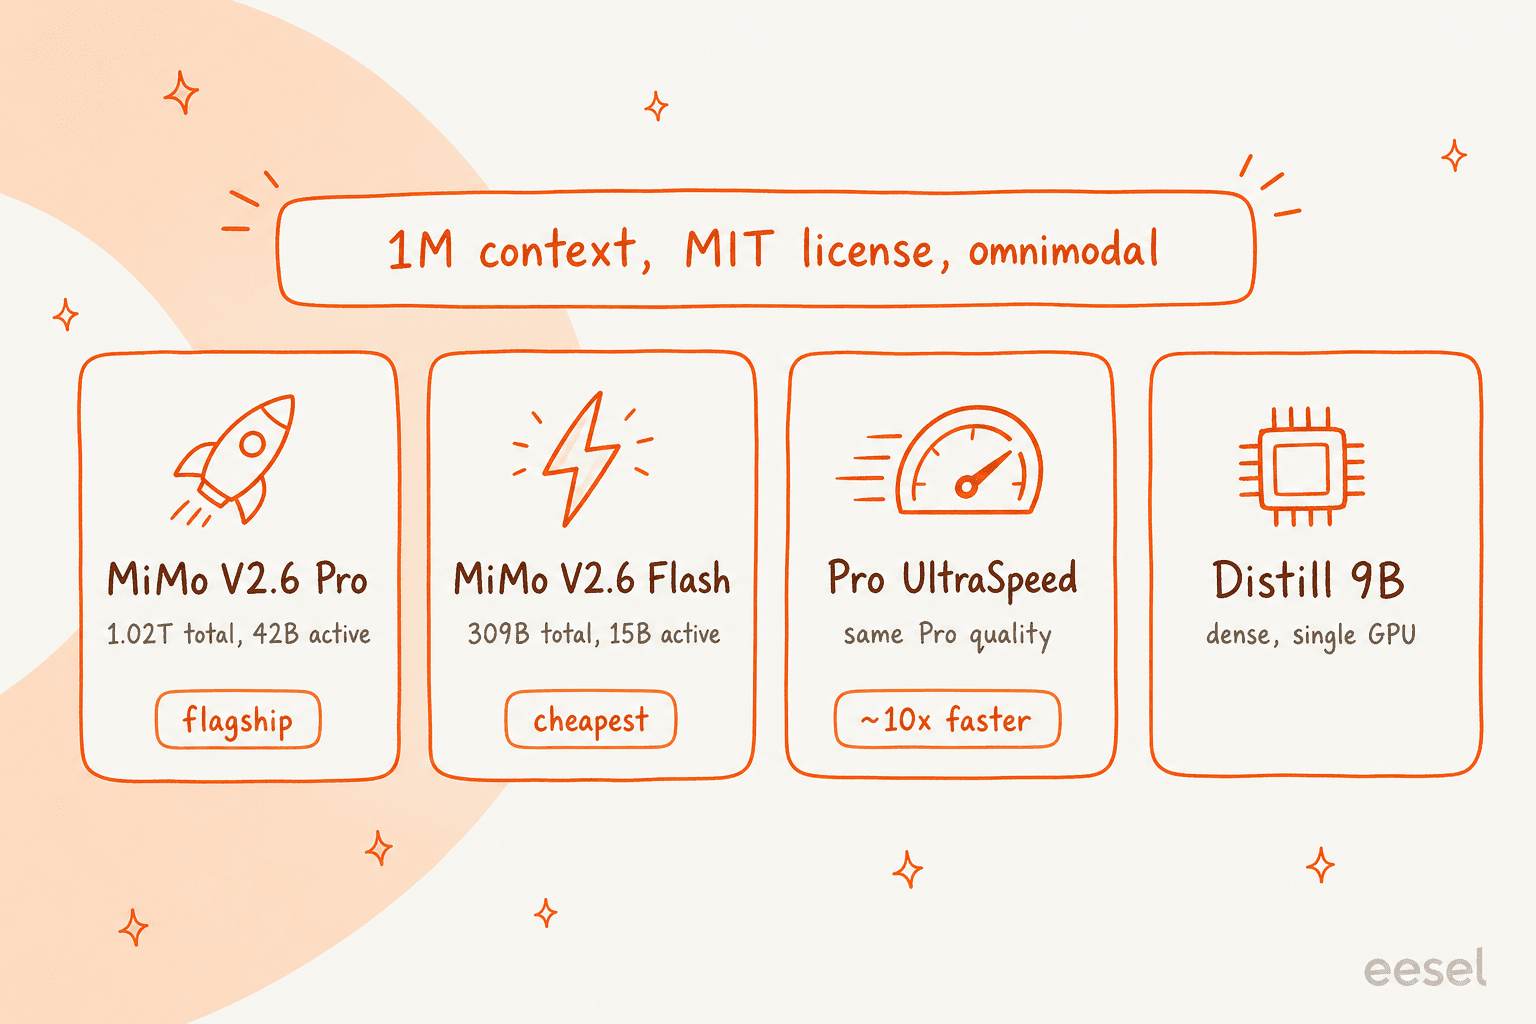
| Modèle | Architecture | Paramètres totaux | Paramètres actifs | Contexte | Idéal pour |
|---|---|---|---|---|---|
| MiMo V2.6 Pro | MoE creux | 1,02T | 42B | 1M | Le travail agentique le plus exigeant et à long horizon |
| MiMo V2.6 Flash | MoE creux | 309B | 15B | 1M | Le meilleur équilibre entre intelligence, vitesse et coût |
| MiMo V2.6 Pro UltraSpeed | Même version Pro, build rapide | ~1T | 42B | 1M | Qualité de niveau Pro quand il faut une sortie rapide |
| MiMo V2.6 Distill-Qwen-9B | Dense (SFT de Qwen3.5-9B) | 9B | 9B | n/a | Recherche RL agentique ouverte et sur GPU unique |
Quelques points à souligner. Pro est présenté comme le modèle le plus performant de Xiaomi à ce jour. Flash est celui que la plupart des gens choisiront réellement, car il offre l'équilibre recherché par la plupart des charges de travail. UltraSpeed est la même version Pro servie environ 10 fois plus vite en sortie (le blog de Xiaomi revendique jusqu'à 20 fois), ce qui compte beaucoup si vous diffusez des réponses à un utilisateur qui attend de l'autre côté. Et la distillation 9B est un fine-tuning supervisé de Qwen3.5-9B sur des données générées par MiMo, publié comme point de départ pour la recherche ouverte plutôt que comme modèle de production.
Le saut générationnel est la vraie histoire ici. Le fleuron précédent, MiMo V2.5 Pro, obtenait 19,0 sur le benchmark de codage DeepSWE v1.1. V2.6 Pro obtient 71,9 sur le même tableau. Sur Terminal Bench 4.0, il est passé de 1,5 à 34,9. Ce ne sont pas des progrès incrémentaux, c'est le genre de bond qu'on ne voit que lorsqu'un laboratoire change son approche d'entraînement, ce qui est exactement ce que Xiaomi affirme s'être produit.
Les benchmarks que Xiaomi met en avant, et ceux qu'il n'affiche pas
Chaque lancement de modèle trie ses graphiques sur le volet, donc je suis allé directement au tableau d'évaluation de la fiche du modèle, qui compare MiMo V2.6 à Claude Opus 5, GPT-5.6 Sol et Claude Fable 5. Voici le partage honnête.
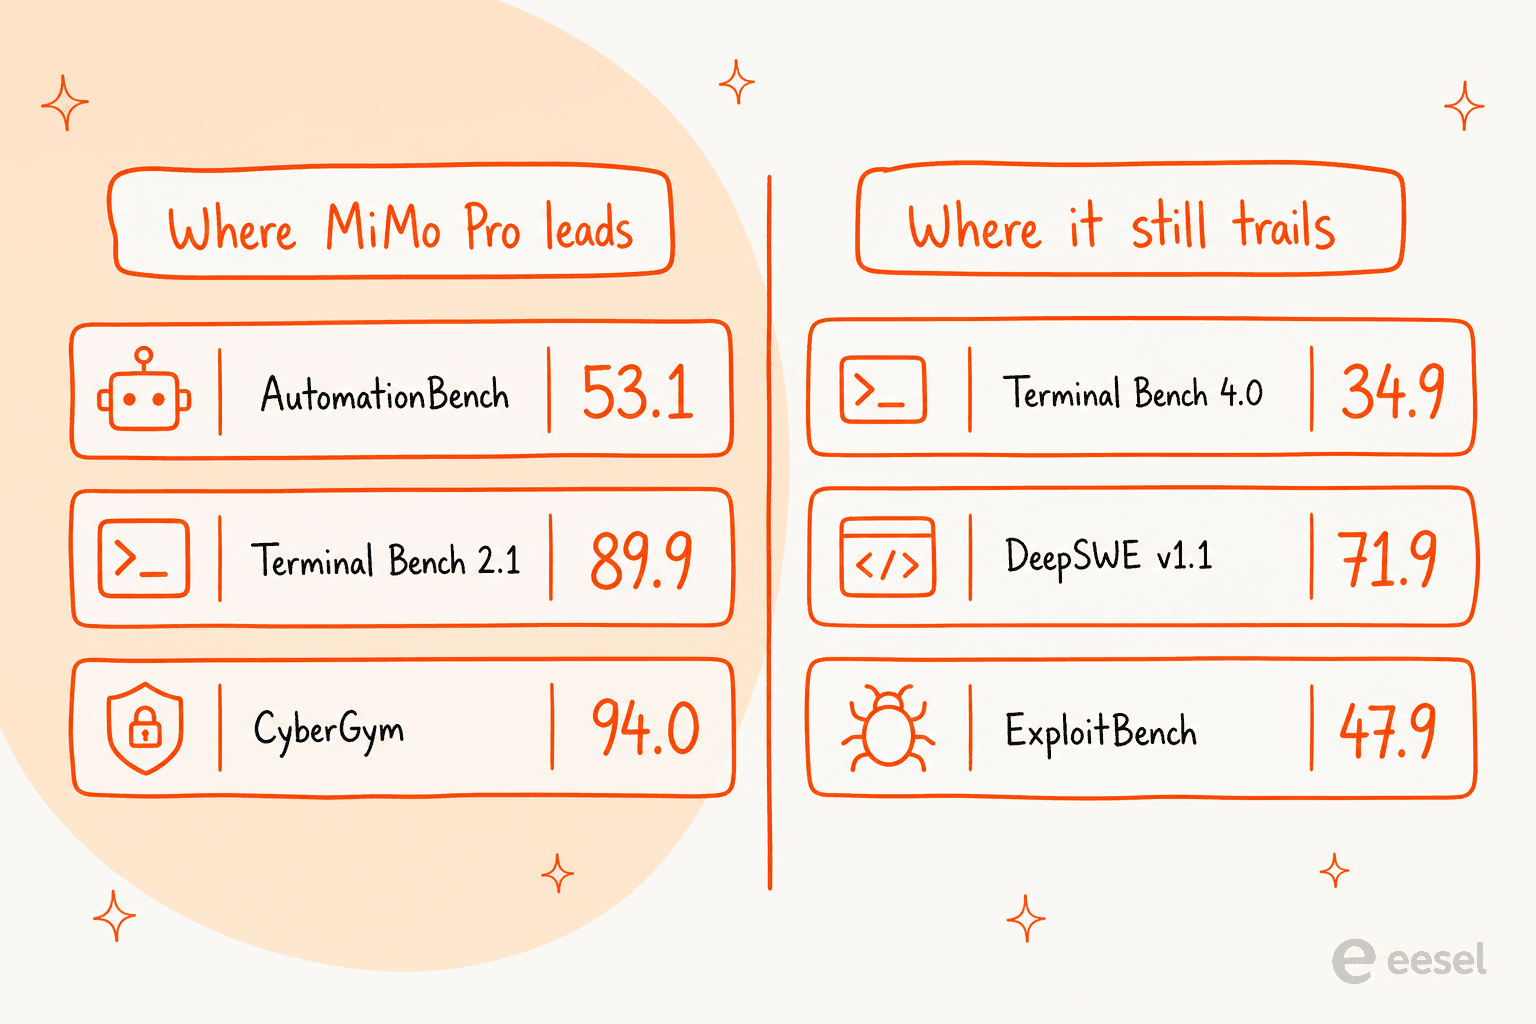
Là où Pro devance clairement les modèles fermés de pointe selon les chiffres de Xiaomi :
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53,1 | 50,3 | 45,8 |
| Terminal Bench 2.1 | 89,9 | 89,1 | 88,8 |
| Agents' Last Exam | 31,6 | 31,6 | 30,8 |
| MiMo Visual Coding | 72,3 | 70,0 | 73,4 |
Et là où il accuse un retard, ce que Xiaomi, à son crédit, publie juste à côté des victoires :
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 74,0 | 73,0 |
| ProgramBench | 26,5 | 37,0 | 25,0 |
| Terminal Bench 4.0 | 34,9 | 49,0 | 39,9 |
| ExploitBench | 47,9 | 70,0 | 78,5 |
Le schéma est cohérent et, je pense, crédible : MiMo V2.6 Pro est au coude à coude avec la pointe sur les tâches agentiques générales et l'utilisation d'outils, et il perd du terrain sur les benchmarks de codage à long horizon et d'exploitation les plus durs. Quand Xiaomi a élargi la comparaison dans son blog de lancement pour inclure GPT-6 Astra, DeepSeek V4.1 Flash et GLM 5.3, la même tendance s'est confirmée : Pro se situe près du sommet du peloton sur AutomationBench et Terminal Bench 2.1, et derrière GPT-6 Astra sur Terminal Bench 4.0 (59,6) et ExploitGym.
Un chiffre mérite un signalement. Pro affiche un impressionnant 94,0 sur CyberGym (Flash fait encore mieux avec 95,1), là où le précédent V2.5 Pro plafonnait à 40,0. La cybersécurité est clairement un domaine sur lequel Xiaomi s'est fortement entraîné, même si l'ExploitBench, plus adversarial, raconte une histoire plus modeste, donc je considérerais le résultat CyberGym comme impressionnant plutôt que définitif.
Le chiffre indépendant qui compte plus que n'importe quel tableau isolé
Les benchmarks isolés sont bruités. L'indice agrégé d'Artificial Analysis est celui que je surveille réellement, car il regroupe de nombreuses évaluations en un seul score comparable et, surtout, le confronte au coût.
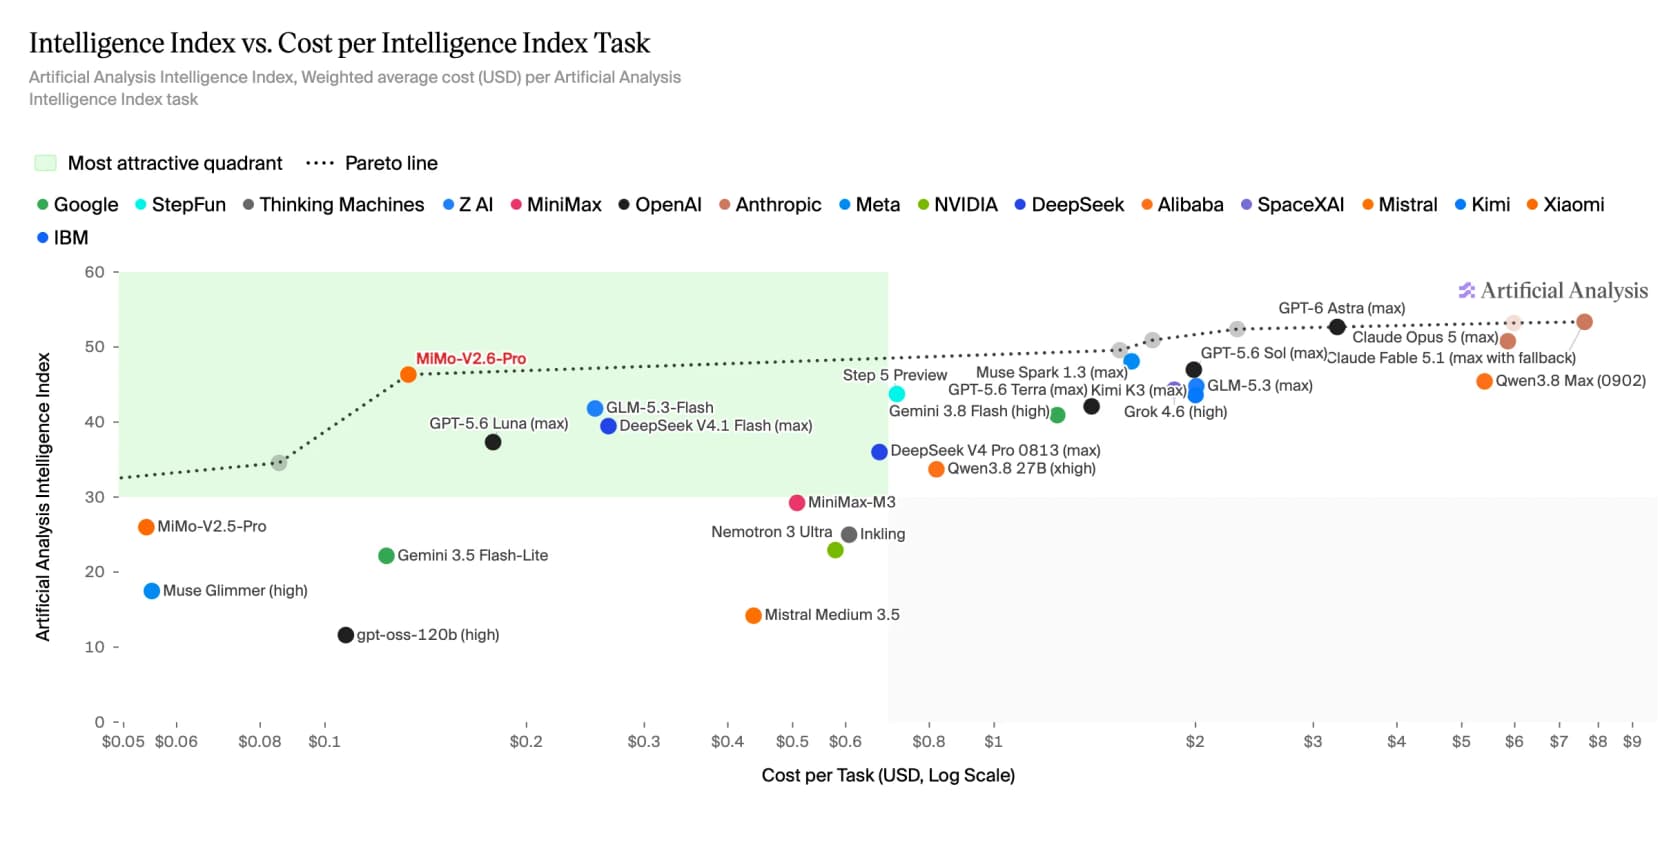
MiMo V2.6 Pro atteint un Intelligence Index de 46, le meilleur modèle à poids ouverts du tableau, se plaçant dans ce qu'Artificial Analysis qualifie littéralement de « quadrant le plus attractif ». Les modèles fermés de pointe obtiennent des scores plus élevés en intelligence brute (GPT-6 Astra, Opus 5 et Fable 5.1 se situent tous dans le milieu-bas des 50), mais ils le font pour 3 à 8 $ par tâche. MiMo obtient son 46 pour environ 0,13 $.
Ce ratio prix-intelligence est tout l'argument de vente, et c'est pourquoi ce lancement a secoué pas mal de monde. Comme l'a formulé un commentateur dans le fil de lancement, le modèle « a atterri dans le quadrant le plus vert d'intelligence contre vitesse d'AA » tout en conservant un prix identique à la génération précédente. Quand on peut obtenir 85 à 90 % de l'intelligence de pointe pour un quarantième du coût, le calcul change pour beaucoup de cas d'usage.
Comment l'utiliser réellement : poids, API et tarif
C'est la partie qui m'intéresse le plus, car un score de benchmark ne sert à rien si vous ne pouvez pas intégrer le modèle dans votre pile technique. MiMo V2.6 est agréablement facile d'accès, que vous vouliez l'auto-héberger ou simplement appeler un endpoint.
Les poids sont ouverts sous licence MIT, ce qui est aussi permissif que possible (usage commercial autorisé, presque sans conditions). Vous pouvez télécharger Pro, Flash et la distillation 9B depuis Hugging Face et ModelScope, et Xiaomi fournit une version FP8 pour ne pas vous forcer à la pleine précision.
Côté matériel, il faut être réaliste sur ce dont Pro a besoin. La propre commande de lancement de la fiche du modèle fait tourner Pro sur deux nœuds avec un parallélisme tensoriel à 16 voies, donc c'est un cluster GPU multi-nœuds, pas quelque chose qu'on lance sur une station de travail de secours. Flash est bien plus accessible sur un seul nœud à 8 GPU, et la distillation 9B tourne sur un seul GPU, avec des quantifications GGUF communautaires déjà disponibles pour llama.cpp, LM Studio et Ollama. Si vous avez suivi nos articles sur les modèles d'IA personnalisés, rien de tout cela ne vous surprendra : les poids ouverts sont gratuits, mais la facture d'hébergement est bien réelle.
Si vous préférez vous passer entièrement d'infrastructure, MiMo V2.6 est hébergé sur la propre plateforme API de Xiaomi, dans MiMo Studio et Desktop, ainsi que sur OpenRouter. Voici les tarifs OpenRouter, par million de tokens, vérifiés durant la semaine de lancement :
| Modèle | Entrée / 1M | Sortie / 1M | Contexte |
|---|---|---|---|
| MiMo V2.6 Flash | 0,14 $ | 0,28 $ | 1M |
| MiMo V2.6 Pro | 0,435 $ | 0,87 $ | 1M |
| MiMo V2.6 Pro UltraSpeed | 4,35 $ | 8,70 $ | 1M |
Deux choses ressortent. Flash, à 0,14 $ en entrée / 0,28 $ en sortie, est bon marché pour un modèle omnimodal à contexte de 1M. Et UltraSpeed est exactement 10 fois plus rapide et 10 fois plus cher que Pro, donc c'est une prime délibérée pour les travaux sensibles à la latence, pas un meilleur modèle. Pour la plupart des équipes, Flash est le choix par défaut raisonnable, et Pro est ce vers quoi on monte en gamme quand une tâche en a vraiment besoin.
Ce que les gens ont dit après l'avoir essayé
Les benchmarks, c'est l'histoire de Xiaomi. Je voulais l'histoire des utilisateurs, alors j'ai lu la discussion du lancement, et la réaction dominante ne portait pas du tout sur les scores. Elle portait sur la transparence avec laquelle Xiaomi a entraîné le modèle.
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
Ce détail sur l'abandon d'un jeu de données cyber parce qu'il dégradait les scores de codage est le genre de chose que les laboratoires n'admettent presque jamais publiquement, et c'est une grande partie de la raison pour laquelle ce lancement a gagné en crédibilité, même auprès des sceptiques. La lecture technique la plus fine du fil est venue d'un utilisateur de longue date de MiMo qui a décompté les tableaux lui-même :
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
Ce n'était pas que des éloges. L'inquiétude récurrente, celle qui suit chaque modèle ouvert performant sortant de Chine, c'est le « benchmaxxing » : de superbes scores, un travail réel décevant. Un commentateur a été direct sur la génération précédente :
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
Le contrepoids est venu de gens qui utilisaient déjà la version précédente en production. L'avis d'un ingénieur logiciel sur le calcul de valeur est celui auquel je repense sans cesse :
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models (late last year/early this year)... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
Il faut noter que cette dernière citation porte sur V2.5, que plusieurs personnes ont aussi qualifié de « rapide mais bête » pour les tâches plus difficiles, donc le vrai test de V2.6 est de savoir s'il comble cet écart dans l'usage quotidien, pas seulement sur les graphiques. Sur X, le lancement a surtout été lu comme une pique contre Grok 4.7, sorti le même jour, avec des réactions allant de « Meilleur que Grok 4.7 » à un plus mesuré « attendons d'abord les performances en conditions réelles. »
Où MiMo V2.6 se situe dans la course aux modèles ouverts
En prenant du recul, MiMo V2.6 est un point de données de plus dans une tendance de plus en plus difficile à ignorer : les modèles à poids ouverts des laboratoires chinois continuent de se rapprocher de la pointe tout en tournant sur du matériel bien moins coûteux. DeepSeek V4.1 Flash, GLM 5.3, Qwen 3.8 Max et maintenant MiMo V2.6 se disputent tous des victoires dans la même bande d'intelligence qui appartenait autrefois uniquement aux modèles fermés.
Il y a une vraie dynamique stratégique sous les benchmarks, et un commentateur l'a bien résumée :
"Chinese models are increasingly closer to the frontier, while being able to run on much cheaper hardware than what US frontier models run on... the rest of the world is going to see the risks and the availability of good enough open weight models for their purposes and be more likely to lean in favor of self-hosted Chinese models or local inference clouds."
C'est ça, la vraie histoire concurrentielle : pas « est-ce que MiMo bat Opus sur un tableau », mais « peut-on obtenir une intelligence suffisamment bonne, sur son propre matériel, à un prix qui fait passer les modèles fermés de pointe pour un luxe ». Pour beaucoup d'équipes, la réponse est désormais oui. Si vous voulez un panorama plus large de ce qui existe, notre sélection des meilleurs agents d'IA open source est une bonne lecture suivante, et notre test de DeepSeek ainsi que notre test de Kimi K3 couvrent ses plus proches rivaux ouverts.
Ce que cela signifie si vous mettez de l'IA sur une file de support
C'est ici que je dois être honnête sur mon propre biais, car j'ai passé ces dernières années à aider à déployer de l'IA sur des files de support en production, et le lancement de MiMo V2.6 confirme quelque chose que nous avons appris à nos dépens : le modèle n'est plus le goulot d'étranglement.
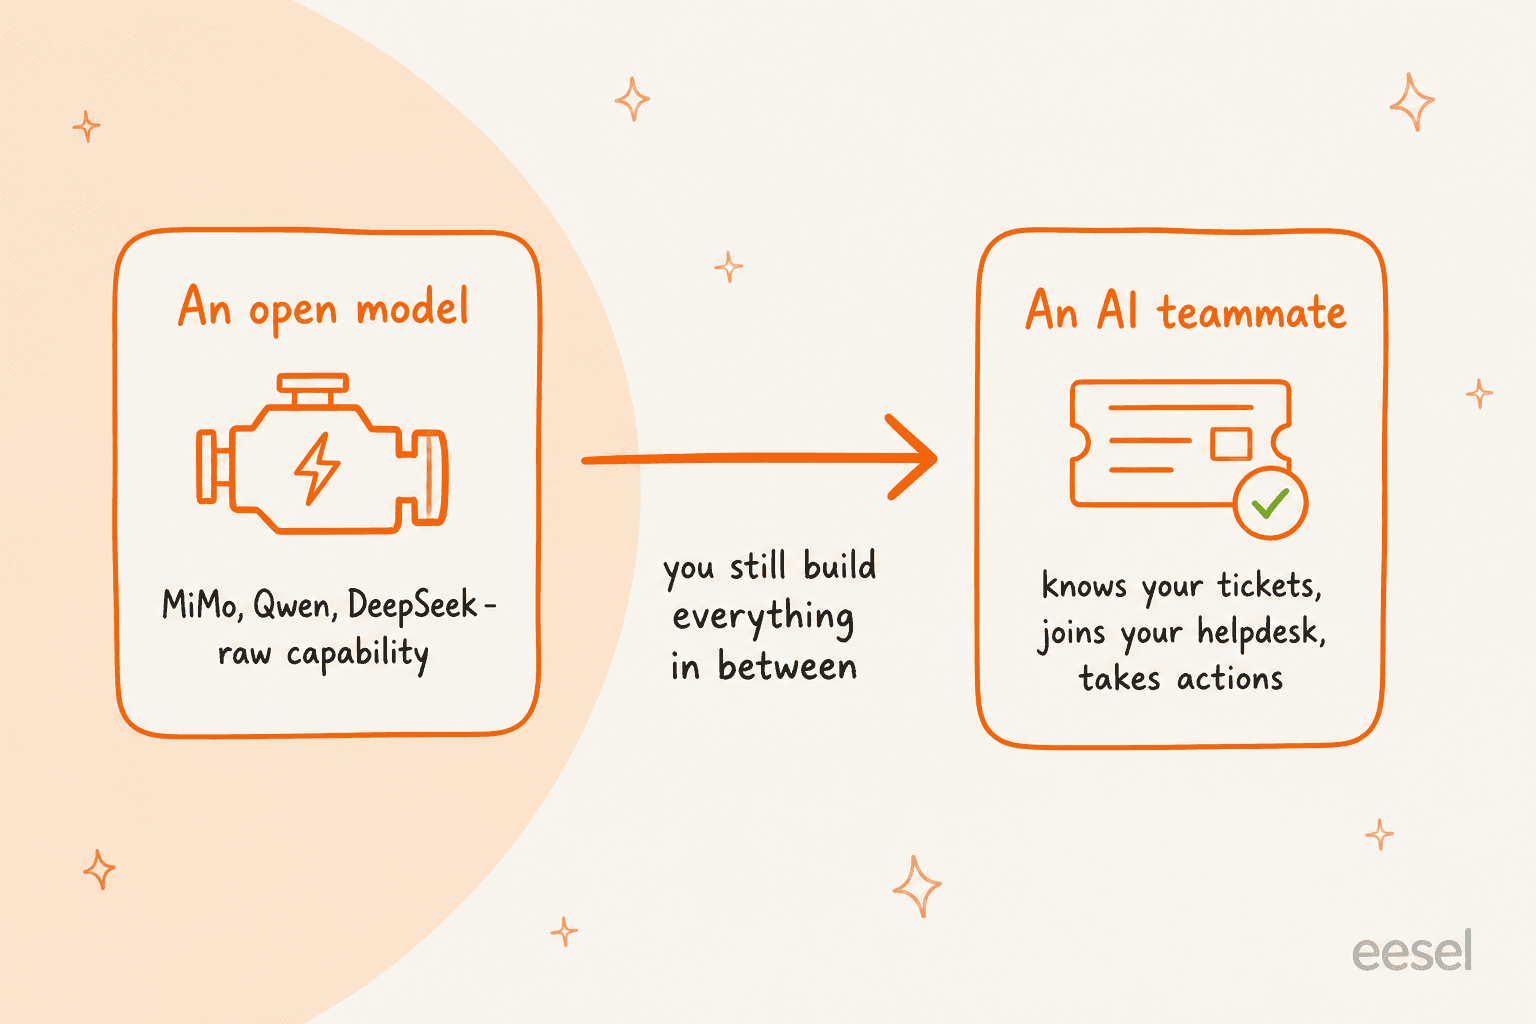
MiMo V2.6, DeepSeek, Qwen, Claude, GPT : n'importe lequel d'entre eux peut écrire une réponse fluide et d'apparence correcte à une question de client. C'était ça, la partie effrayante, il y a quelques années. C'est réglé maintenant. Ce qu'aucun d'eux ne fait de base, c'est le vrai travail : lire votre centre d'aide spécifique et vos tickets passés, suivre votre politique de remboursement au lieu d'une politique inventée qui sonne juste, consulter une commande, étiqueter et router le ticket, savoir quand escalader vers un humain et, surtout, être testé avant de répondre à un vrai client.
Ce dernier point est celui sur lequel je ne transigerais pas. Nous avons vu des modèles à l'air confiant donner de mauvaises réponses sur des files réelles, et c'est exactement pourquoi chaque déploiement que nous faisons est d'abord simulé sur des tickets historiques, pour que vous voyiez comment il aurait géré des milliers de vos propres conversations passées avant qu'il ne touche une conversation réelle. Un score de benchmark de 46 sur l'indice AA ne vous dit rien sur la façon dont un modèle gérera votre politique de retour capricieuse dans un cas limite. Une simulation sur vos 5 000 derniers tickets, si.
Donc si vous êtes emballé par MiMo V2.6 (et vous devriez l'être, c'est un excellent moteur), la bonne question n'est pas « quel modèle » mais « qu'est-ce qui enveloppe le modèle ». Le modèle est désormais une commodité. Le système qui l'entoure est le produit.
Essayer eesel
Tout l'intérêt de cet article, c'est qu'un modèle ouvert comme MiMo V2.6 est de l'infrastructure, une capacité brute qu'il vous reste encore à transformer en quelque chose qui fait le travail. eesel est la couche qui transforme un modèle en coéquipier opérationnel. Vous engagez un agent d'IA pour le helpdesk prêt à l'emploi qui se branche sur le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias, Help Scout, et plus de 1000 intégrations), s'entraîne sur vos tickets passés et votre centre d'aide, et commence à rédiger ou envoyer des réponses, sans aucune gestion de modèle requise.

Le facteur différenciant, c'est ce que les propres benchmarks de MiMo ne peuvent pas vous donner : avant qu'un agent eesel ne réponde à un seul client réel, vous le simulez sur votre historique réel de tickets et voyez le taux de résolution exact et les réponses que vous auriez obtenus. Et comme eesel est une plateforme de coéquipiers, le même compte fait aussi tourner un rédacteur de blog IA, donc si vous avez aimé ce que MiMo apporte à l'ingénierie, le côté rédaction a lui aussi son coéquipier. Pour les développeurs, eesel expose ce même coéquipier via une CLI, API et MCP publiques, pour qu'une personne, un script ou un agent de codage puissent tous le piloter depuis le terminal.
Vous pouvez démarrer gratuitement, sans carte bancaire et sans appel commercial, et avoir un coéquipier opérationnel en quelques minutes. Le modèle est devenu bon marché. Le faire réellement travailler reste la partie intéressante.
Questions fréquentes
Qu'est-ce que Xiaomi MiMo V2.6 ?
Combien coûte Xiaomi MiMo V2.6 ?
Xiaomi MiMo V2.6 est-il meilleur que DeepSeek ou Kimi K3 ?
Puis-je auto-héberger Xiaomi MiMo V2.6 ?
Dois-je utiliser Xiaomi MiMo V2.6 pour le support client ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.