

Ce qu'est vraiment Gemini 3.8 Flash
Gemini 3.8 Flash est le tout nouveau modèle multimodal rapide et bon marché de Google, disponible sous le nom gemini-3.8-flash dans l'API Gemini et comme modèle par défaut dans l'environnement de développement agentique Antigravity de Google. Il prend en entrée du texte, des images, de l'audio, de la vidéo et des PDF, et produit du texte, avec une fenêtre d'entrée de 1M de tokens et 64K en sortie. Si vous voulez le détail complet du lancement, je l'ai couvert dans mon aperçu de Gemini 3.8 Flash, et le volet financier se trouve dans l'article sur les tarifs de Gemini 3.8 Flash. Celui-ci est l'avis : est-ce que ça vaut votre temps, et où se situe-t-il vraiment.
Le fait le plus utile pour un avis est celui que personne n'a mis en titre : ce n'est pas un modèle neuf. La fiche modèle indique, mot pour mot et dans quatre sections distinctes, que "Gemini 3.8 Flash is based on Gemini 3.7 Flash." L'architecture, les données d'entraînement, le matériel et la politique de sécurité renvoient tous à la fiche de 3.7 Flash. Donc 3.8 est une passe de post-entraînement sur la base de 3.7. Cela explique la cadence de trois semaines, et cela explique pourquoi le prix n'a pas bougé d'un centime. Lisez cet avis comme la réponse à "le post-entraînement supplémentaire justifie-t-il de changer", car c'est là la vraie question.
Le seul chiffre qui tranche cet avis
Chaque article de lancement a mis la vitesse en avant. Voici le chiffre qui recadre les choses. Artificial Analysis mesure Gemini 3.8 Flash à 305,1 tokens par seconde, classé #3 sur 195 modèles. C'est réel et impressionnant. Mais la même page de mesure rapporte aussi un délai jusqu'au premier token de 13,30 secondes, alors que le modèle de raisonnement médian de sa gamme de prix se situe à 2,99 s.
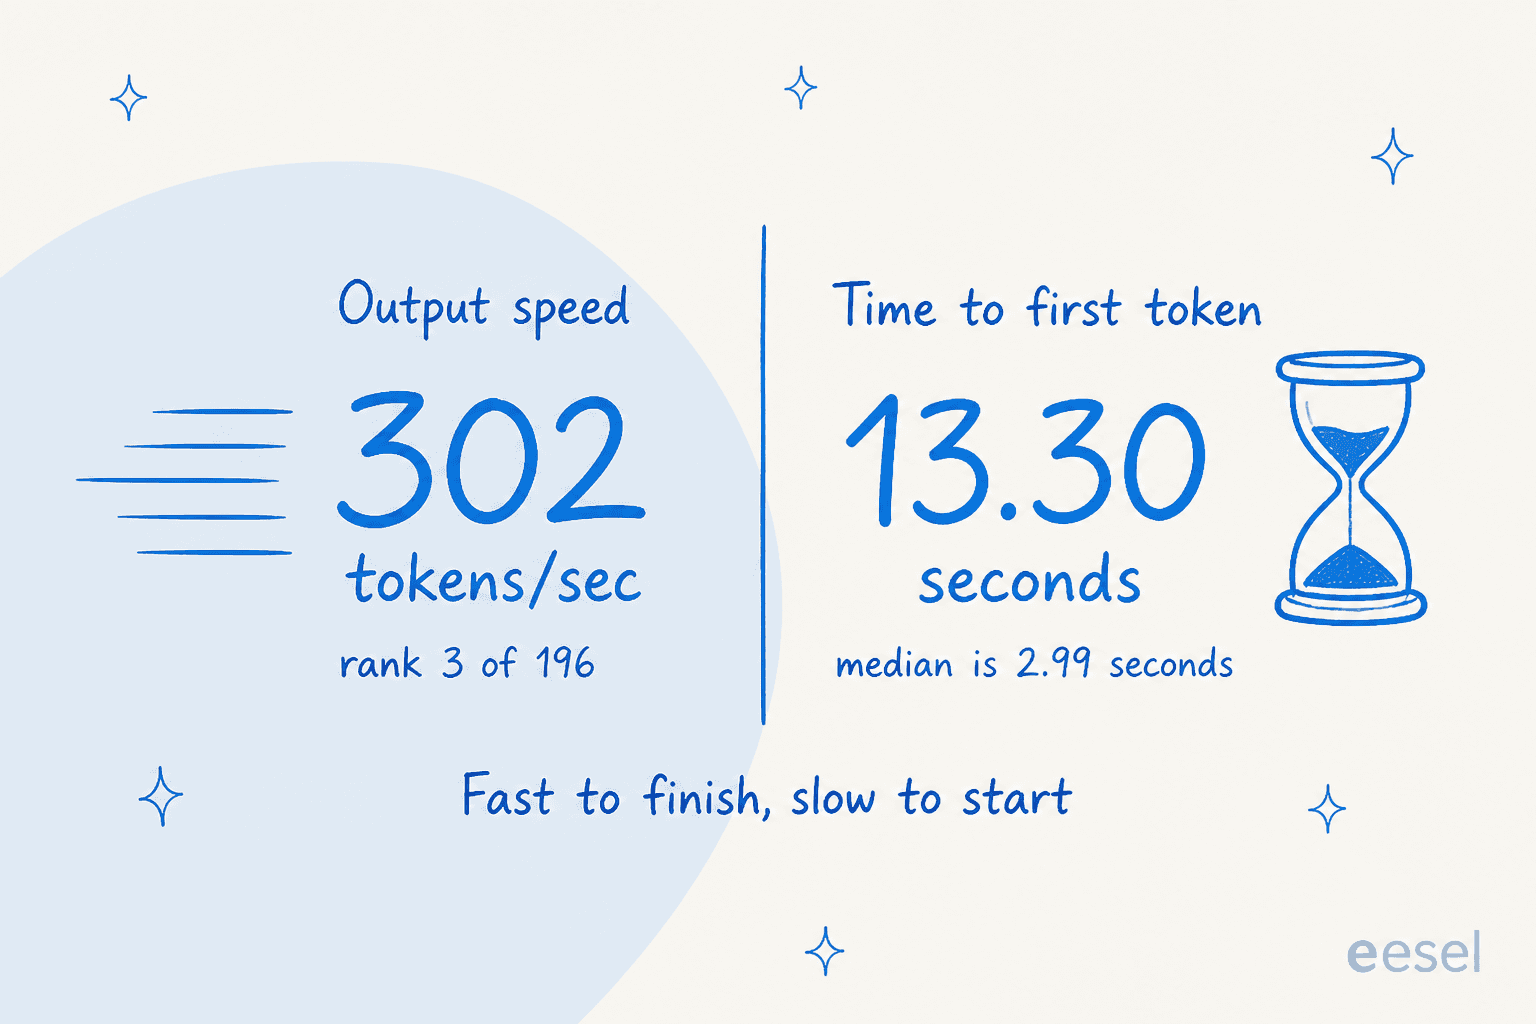
Ces deux chiffres décrivent des expériences complètement différentes. Le débit, c'est la vitesse à laquelle le texte se déverse une fois lancé. Le délai jusqu'au premier token, c'est le temps que la personne qui lit passe à fixer une case vide avant que quoi que ce soit n'apparaisse. Pour un agent en lot qui travaille toute la nuit sur un dépôt, 13 secondes de réflexion préalable sont invisibles et le débit est tout ce qui compte. Pour une personne qui regarde un widget de chat, ou un agent de support qui attend une réponse suggérée, 13 secondes de silence, c'est toute l'expérience, et aucune vitesse en aval ne rattrape ça.
C'est pourquoi je continue à contester l'idée que "3.8 Flash is the fast one". C'est le rapide pour les machines et le lent pour les humains. Cette seule distinction classe presque tous les cas d'usage auxquels je peux penser, et c'est la raison pour laquelle les benchmarks ci-dessous comptent moins qu'il n'y paraît.
Là où il est vraiment bon
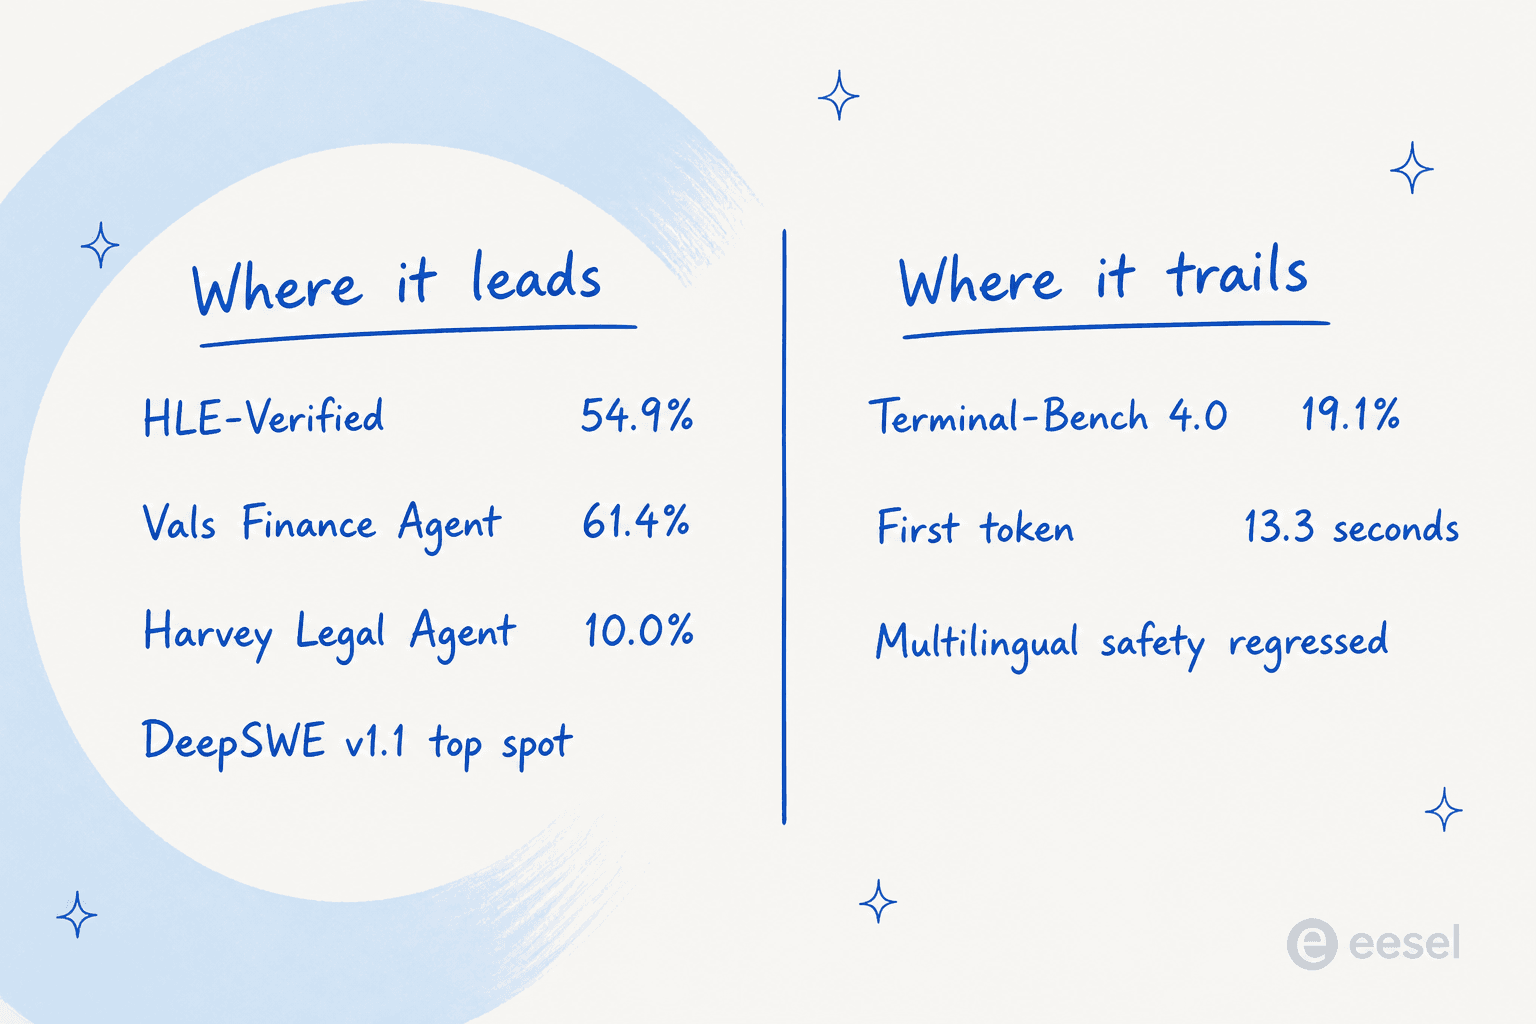
Donnez-lui une tâche de codage agentique longue et 3.8 Flash fait ses preuves. Selon les propres chiffres de Google, il domine HLE-Verified à 54,9 % (devant GPT-5.6 Sol, Claude Opus 5 et son propre prédécesseur), remporte le benchmark Vals Finance Agent v2 à 61,4 %, et arrive en tête de DeepSWE pour le travail logiciel à long terme. Le fournisseur de benchmarks david a résumé l'attrait clairement : "5x cheaper and 2x faster than Opus 5 for similar intelligence."
L'Intelligence Index confirme l'histoire du codage : 59 points sur Artificial Analysis, à égalité avec Claude Opus 5 en effort moyen, ce qui pour un modèle de la classe Flash est un résultat solide. Et le comportement à long terme est réel, pas un artefact de benchmark. Le partenaire de conception Thai Tran de Glean a rapporté qu'il réussissait "completing more than three times as many tasks as Gemini 3.7 Flash in our evaluations" sur des flux de travail intensifs en documents. Sur Hacker News, simonw a généré une visualisation HTML en 13 secondes pour 1,8 cent et a qualifié la combinaison vitesse-qualité de frontend de "pretty exciting."
Mon schéma préféré tiré du monde réel vient de panarky, qui utilise Flash comme auditeur plutôt que comme constructeur :
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus. Can't wait to try 3.8 Flash. If it's good enough, maybe I'll switch Flash to primary and make Opus the auditor."

C'est le type de charge de travail pour lequel 3.8 Flash est conçu : bon marché, rapide, infatigable, prêt à s'attaquer à une longue tâche. Si c'est vous, il mérite une place sur votre shortlist à côté des autres meilleurs outils d'assistants IA pour le codage.
Là où il pêche
Ce même design "works harder" qui gagne les benchmarks de codage est ce qui le rend gênant partout ailleurs. Google est étonnamment honnête à ce sujet dans l'article de lancement : 3.8 Flash "exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance." Traduction : il réfléchit beaucoup, et vous payez pour cette réflexion.
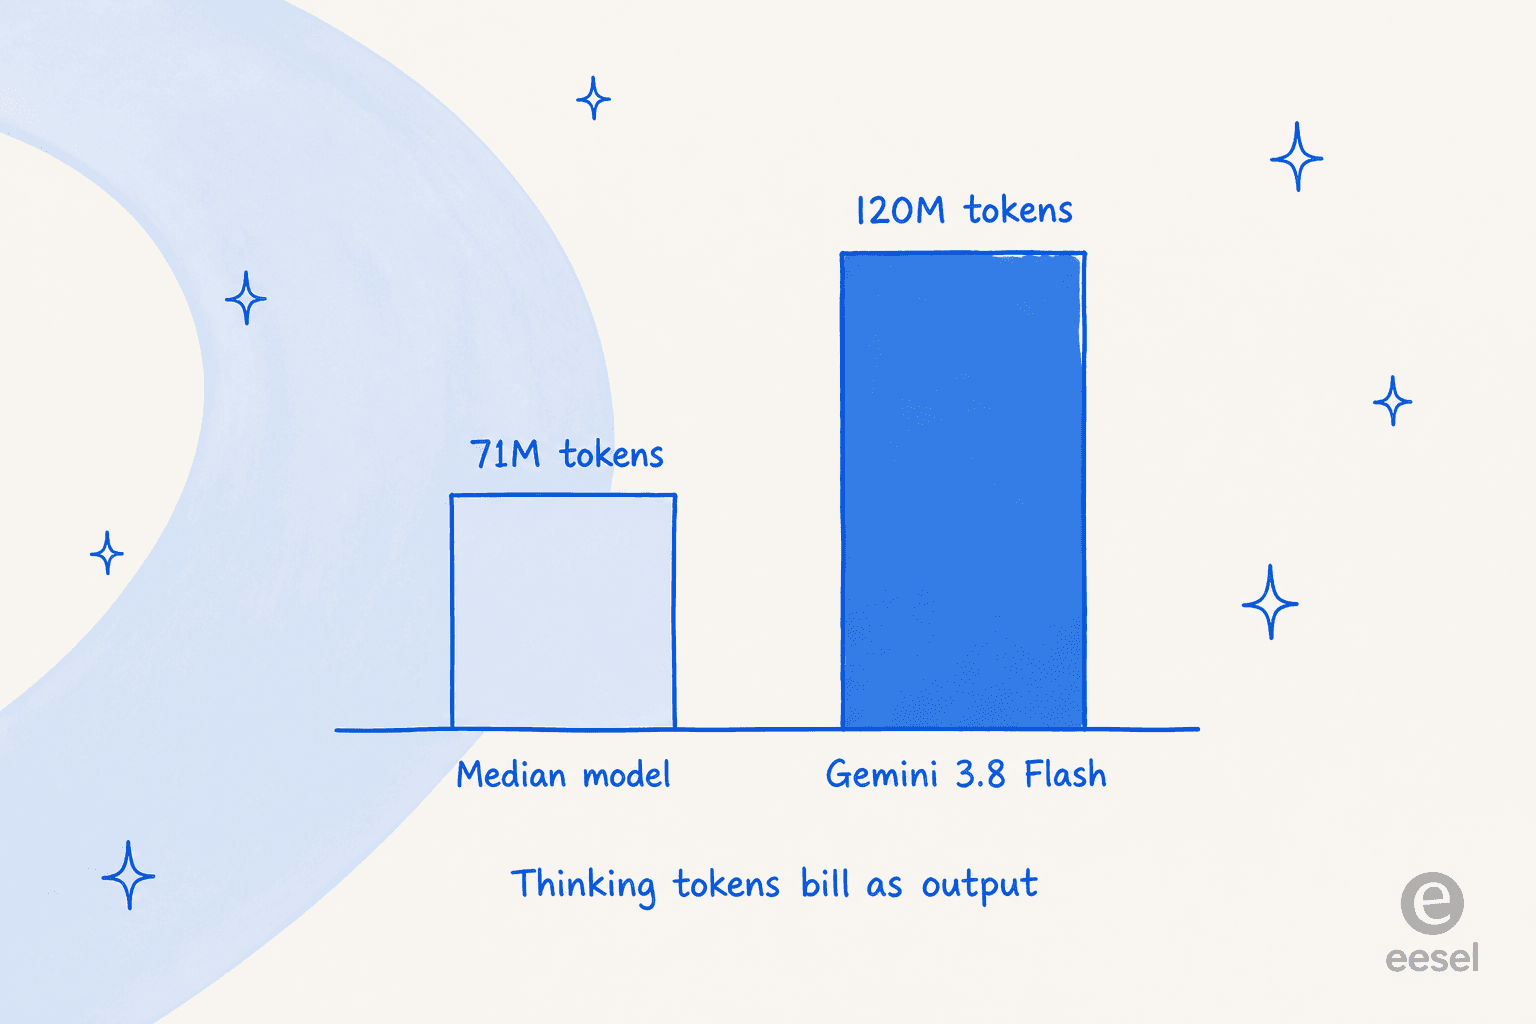
Artificial Analysis l'a signalé comme "very verbose" : 120M de tokens en sortie pour exécuter l'Index contre une médiane de 71M. Comme Gemini facture les tokens de raisonnement au tarif de sortie de 3,75 $, cette verbosité est un multiplicateur de coût direct que le prix affiché masque. L'utilisateur HN bermudi a chiffré la chose : environ 11 000 tokens de plus par tâche que 3.7 sur le même benchmark, "making it more expensive and slower in practice than the headline rate suggests." Mon article sur les tarifs de Gemini 3.8 Flash contient le calcul complet, mais en bref, un tarif au 1M ment quand le modèle choisit d'en émettre davantage.
Puis il y a le baby-sitting. mythz a capturé une frustration que je partage :
"Whilst it's a fast model, having to baby sit through and approve prompts every few seconds ends up making it slower than the Auto approve modes of Claude/ChatGPT."
Et il peut en faire trop sur des prompts simples. refulgentis a rapporté avoir tapé "Hi" et reçu une appli à quatre panneaux avec un faux widget météo et une liste de tâches. C'est un détail, mais c'est le signe d'un modèle calibré pour faire un maximum de travail, ce qui est exactement ce que vous ne voulez pas sur une tâche étroite et bien délimitée.
Deux autres mises en garde honnêtes. Sur Terminal-Bench 4.0, il obtient 19,1 % contre 51,8 % pour Opus 5, donc "matches Opus 5" n'est vrai que sur les benchmarks que Google a choisi de montrer. Et la fiche modèle enregistre deux métriques de sécurité en recul : la sécurité multilingue de 5,4 points de pourcentage et les refus injustifiés de 1,1 point de pourcentage, Google déclarant sans détour que "safety performance across non-English languages regressed slightly." L'évaluation complète de Frontier Safety n'a même pas été refaite ; elle a été héritée de 3.7 par inférence. Aucun de ces éléments n'est décisif à lui seul, mais ce sont le genre de détails qu'un avis honnête doit signaler.
Ce que les gens ont vraiment dit après l'avoir testé
La lecture de la communauté est divisée d'une manière utile, et elle correspond presque exactement au clivage machine contre humain évoqué plus haut.
Les personnes qui font tourner de longues tâches de codage ont globalement apprécié. Selta l'a qualifié de "quite a big update," notant les gains en raisonnement de codage et la réduction des hallucinations tout en conservant la vitesse. Conor Dart a déclaré "Google is back... this model takes its time to think and work through the tasks." Et scrlk a soulevé un point que les benchmarks manquent totalement : "Gemini's speed and quality doesn't degrade badly during weekday working hours compared to OAI, and especially Anthropic." La constance sous charge est un vrai avantage.
Les personnes qui attendaient un bond en avant ont été plus froides. markasoftware a noté que sur Artificial Analysis, il ne fait qu'égaler "opus 5 medium effort," et que "opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference." zuzululu a atterri où j'ai atterri : "i might consider 3.8 flash for simple side hobby projects or quick scaffolding but would not trust it for long agentic tasks." Et pkos98 a offert le scepticisme le plus sain sur n'importe quel benchmark du jour de lancement : "Wait a week with your judgement, most likely, Google is just bench-maxing very hard."
Il y a aussi un grief structurel qui vaut la peine d'être signalé. Kol Tregaskes a fait remarquer qu'il s'agit du quatrième modèle Flash consécutif "with no Pro model." Ce n'est pas une critique de 3.8 Flash en soi, mais c'est le contexte : selon certains rapports, 3.5 Pro serait complètement sauté, donc Flash porte la charge du haut de gamme alors qu'un modèle de niveau Pro manque dans la gamme. Si vous comparez entre fournisseurs, ChatGPT contre Gemini et mon panorama des alternatives à Gemini sont les deux points de départ les plus utiles.
Le verdict : faut-il passer de 3.7 Flash ?
Comme le prix est identique, c'est la seule comparaison qui compte, et elle est plus nette que la plupart des décisions de mise à niveau.
| Si votre charge de travail est... | Le choix | Pourquoi |
|---|---|---|
| Codage agentique de longue durée, tâches intensives en documents, un agent en lot de nuit | Gemini 3.8 Flash | Réellement meilleur sur les benchmarks qui comptent ici, au même prix ; la réflexion supplémentaire est payante |
| Sensible à la latence, avec un humain dans la boucle (chat, assistance en direct) | Gemini 3.7 Flash | Le coût de 13,30 s jusqu'au premier token touche directement une personne ; la verbosité supplémentaire est un surcoût pur |
| Priorité au coût, fort volume, appels simples (classification, OCR, extraction) | Gemini 3.7 Flash | Google le dit sans détour : il "remains fully supported for efficiency-first workloads" |
| Un auditeur pour revérifier le travail d'un modèle plus grand | L'un ou l'autre Flash | Assez bon marché et rapide pour que l'utiliser comme relecteur soit un choix judicieux |
Le verdict est que 3.8 Flash est une vraie mise à niveau pour exactement un type de travail, et une régression déguisée pour un autre. Que Google vous donne les deux au même prix n'est pas de la générosité, c'est un aveu que le modèle plus récent échange de l'efficacité contre de la diligence, et vous seul savez de quel côté de cet échange se trouve votre charge de travail. Encore une chose à intégrer dans votre budget : le tarif de 0,75 $ est une promotion qui double à 1,50 $ le 1er janvier 2027. Quiconque budgétise sur le chiffre d'aujourd'hui budgétise sur une remise.
Ce que cela signifie si vous voulez mettre de l'IA sur une file de support
Voici où je dois être direct, car je teste ces modèles spécifiquement pour répondre à la question que les équipes de support ne cessent de me poser : "which model should we point at our tickets?"
La réponse honnête, c'est que le modèle est la mauvaise chose à rechercher. Une charge de travail de support est l'inverse quasi parfait de ce que 3.8 Flash fait bien. Les tickets sont à contexte court, pas à long terme. Le volume est élevé, donc la latence s'accumule, et un délai de 13 secondes jusqu'au premier token multiplié par des milliers de conversations est un coût réel. Et un modèle brut ne vous donne aucun des éléments qui font réellement fonctionner l'automatisation du support : il ne connaît pas votre centre d'aide, ne peut pas lire vos tickets passés, ne s'intègre pas dans Zendesk ou Freshdesk, et n'a aucun moyen de vous montrer ce qu'il aurait dit avant de le dire à un client.
J'ai vu des bots à l'apparence confiante donner discrètement de mauvaises réponses sur des files en direct, ce qui est l'échec qu'un score de benchmark ne peut jamais vous signaler. C'est pourquoi ce qui m'importe, ce n'est pas l'Intelligence Index du modèle, mais si le système qui l'entoure peut d'abord être simulé face à vos tickets réels. Un modèle est de l'infrastructure. Ce dont une équipe de support a réellement besoin, c'est de l'employé, connecté au helpdesk avec le contexte et les garde-fous déjà en place. Le choix du modèle en dessous est un détail que la plateforme devrait gérer, pas une décision que vous devriez prendre en lisant des benchmarks de lancement.
Essayer eesel
Si ce que vous voulez vraiment, c'est que l'IA réponde aux tickets plutôt qu'un modèle à connecter vous-même, eesel est l'endroit par lequel je commencerais. eesel vend des coéquipiers IA prêts à l'emploi plutôt que de l'infrastructure brute, et le coéquipier IA de helpdesk rejoint votre file existante dans Zendesk, Freshdesk ou Gorgias, entraîné sur votre centre d'aide et vos tickets passés, en quelques minutes.

Le différenciateur, c'est la partie que les benchmarks de modèles ne peuvent pas vous donner. Chaque déploiement eesel est d'abord simulé face à vos tickets historiques réels, pour que vous voyiez ce que l'IA aurait dit à des clients que vous avez déjà servis, avant qu'elle ne dise quoi que ce soit à un client en direct. Il gère aussi la plomberie peu glamour, comme la classification des tickets et le tagging de support, et c'est gratuit à essayer. Le coéquipier rédacteur de blog IA tourne sur la même plateforme si le contenu, et non le support, est votre goulot d'étranglement.
Côté chiffres, les économies de coûts du support IA contient les calculs, et le coût agent contre humain est la comparaison que les équipes financières demandent réellement. Et si vous cherchez encore un modèle plutôt qu'un produit, les meilleurs agents IA et les meilleurs agents IA pour petites entreprises sont les deux panoramas que je lirais ensuite.
Questions fréquentes
Vaut-il le coup de passer à Gemini 3.8 Flash depuis 3.7 Flash ?
Combien coûte Gemini 3.8 Flash ?
Pourquoi Gemini 3.8 Flash est-il aussi verbeux ?
Gemini 3.8 Flash est-il adapté à un chatbot de support client ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.




Comment Gemini 3.8 Flash se compare-t-il à Claude Opus 5 ?