Les tarifs de Gemini 3.8 Flash en un coup d'œil
Voici tous les tarifs publiés pour gemini-3.8-flash sur l'API Gemini, palier payant standard, par million de tokens. J'ai placé la colonne 2027 juste à côté de celle d'aujourd'hui pour que la promotion soit impossible à manquer.
| Mesure | Jusqu'au 31 déc. 2026 | À partir du 1er janv. 2027 |
|---|---|---|
| Entrée | $0.75 | $1.50 |
| Sortie (inclut le raisonnement) | $3.75 | $7.50 |
| Cache de contexte, lecture | $0.075 | $0.15 |
| Cache de contexte, stockage (par million/heure) | $0.50 | $1.00 |
| Batch et Flex, entrée | $0.375 | $0.75 |
| Batch et Flex, sortie | $1.875 | $3.75 |
| Priorité, entrée | $1.35 | $2.70 |
| Priorité, sortie | $6.75 | $13.50 |
Quelques points faciles à manquer en lisant la page de Google de haut en bas :
- Le prix de la sortie inclut les tokens de raisonnement. Vous payez le tarif de 3,75 $ pour le raisonnement du modèle, même si l'API ne vous renvoie qu'un résumé de celui-ci. Sur un modèle conçu pour raisonner davantage, c'est la ligne qui fait bouger votre facture.
- Batch et Flex coûtent exactement moitié prix. Si votre travail n'est pas interactif, une tâche batch nocturne divise par deux chaque token dépensé.
- Le grounding est facturé séparément. Google Search en tant qu'outil vous offre 5 000 requêtes gratuites par mois, partagées entre tous les modèles Gemini 3.x que vous utilisez, puis 14 $ par tranche de 1 000. Le grounding Google Maps utilise le même quota.
- Il existe un vrai palier gratuit. L'entrée, la sortie et le cache sont gratuits pour un usage standard, ce qui suffit pour prototyper avant de dépenser quoi que ce soit.
Testez les chiffres sur votre propre charge de travail
Le tarif d'accroche ne vous dit qu'une partie de l'histoire. Ce qui compte, c'est votre volume mensuel, votre ratio entrée/sortie et le palier sur lequel vous fonctionnez. Entrez vos propres chiffres ci-dessous pour voir le coût mensuel d'aujourd'hui par rapport à ce que coûterait la même charge de travail après la hausse de janvier 2027.
Le coût caché : 3.8 Flash est verbeux à dessein
Le chiffre qui change la décision d'achat ne figure pas sur la page de tarification. Il se trouve dans le nombre de tokens que le modèle dépense pour accomplir une tâche.
Google expose ce compromis ouvertement dans son billet de lancement : 3.8 Flash « travaille plus dur », en exécutant des étapes de raisonnement supplémentaires et en appelant les outils de manière itérative, et « il arrive que le modèle utilise plus de tokens pour maximiser la performance ». C'est un atout pour la qualité, et un coût sur votre facture, car les tokens de raisonnement sont facturés au tarif de sortie de 3,75 $.
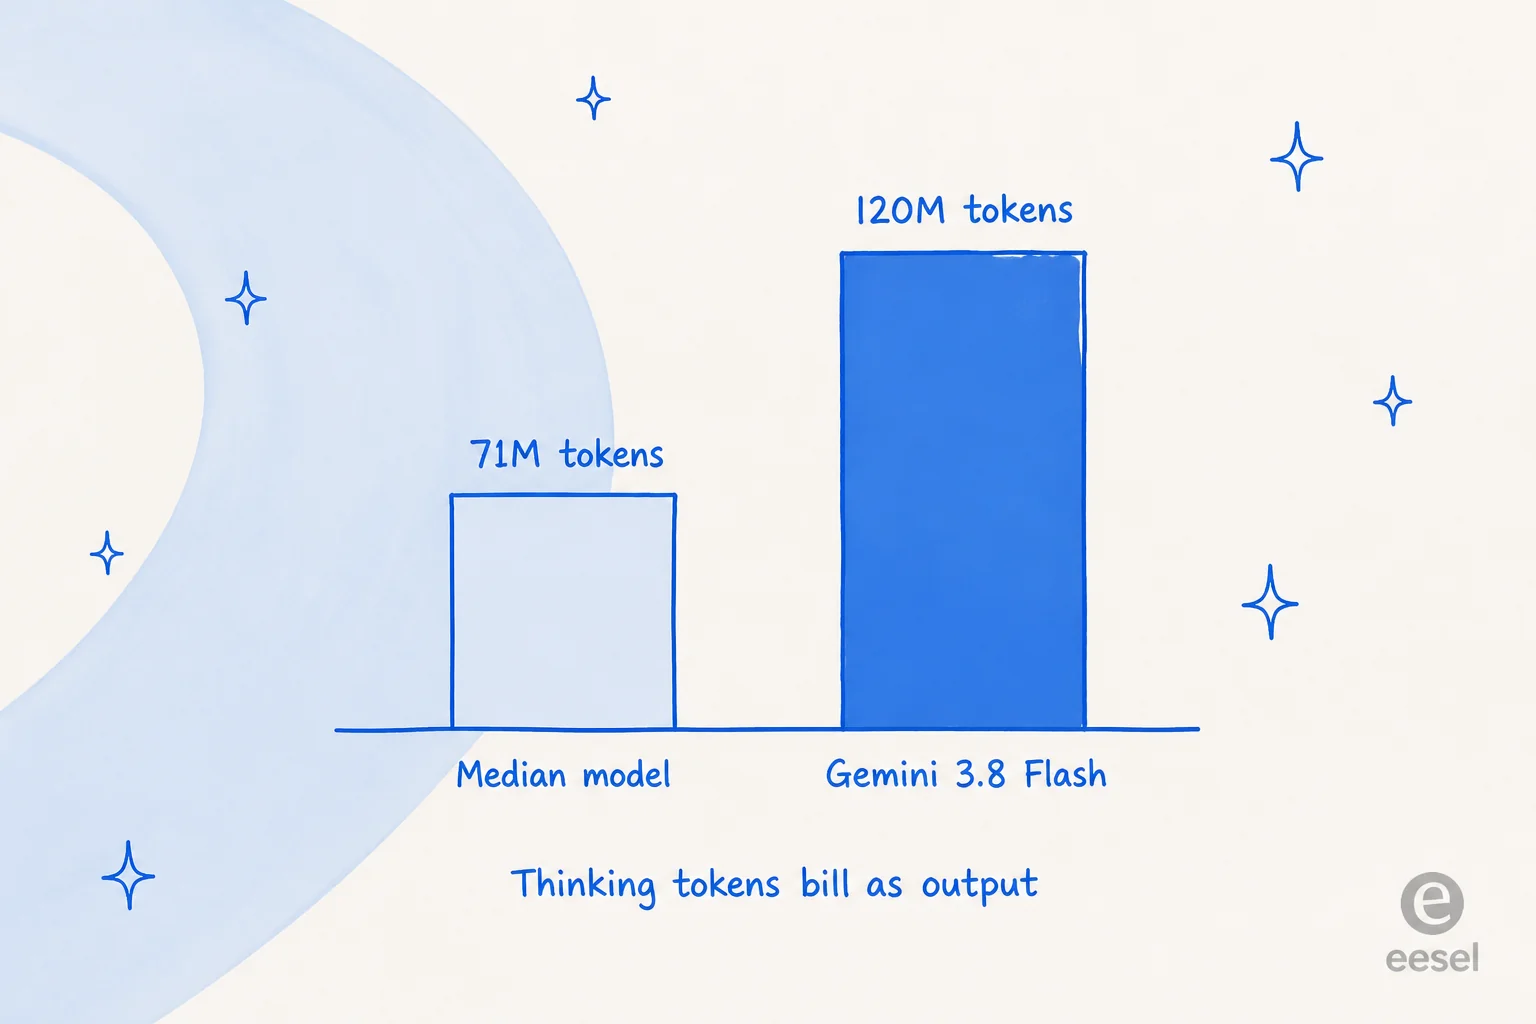
La mesure indépendante le confirme. Artificial Analysis a eu besoin de 120 millions de tokens de sortie pour exécuter tout son Intelligence Index sur 3.8 Flash, contre une médiane de 71 millions pour cette catégorie. Le verdict en un mot d'AA lui-même était « very verbose » (très verbeux).
Sur Hacker News, un commentateur a avancé un chiffre plus tranchant que le marketing :
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Le coût réel par unité de travail est donc plus élevé que ne le suggèrent les 3,75 $ par million, car 3.8 Flash dépense plus d'unités par tâche. Artificial Analysis a fixé le coût combiné à 0,58 $ par tâche dans son indice, ce qui le place à la 59ᵉ place sur 195 modèles en efficacité de coût, loin du sommet que le tarif brut par token pourrait laisser croire. Si vous voulez surveiller cela sur votre propre trafic, c'est exactement à cela que servent les outils de suivi des LLM.
Même prix que 3.7 Flash : lequel choisir ?
C'est la vraie décision, et Google y répond pour vous. Puisque 3.8 et 3.7 Flash coûtent exactement la même chose au centime, le prix ne peut pas trancher. La recommandation de Google le fait : pour les charges de travail « où l'efficacité de calcul est la contrainte principale », les développeurs devraient « continuer à s'appuyer sur Gemini 3.7 Flash, qui reste entièrement pris en charge pour les charges de travail axées sur l'efficacité ».
Pour le dire simplement :
- Codage agentique long, qualité avant le coût : 3.8 Flash. Il surpasse 3.7 sur tous les benchmarks publiés par Google, et le changement est gratuit. Si vous explorez la catégorie plus large, mon panorama des assistants de codage IA couvre tout le terrain.
- Fort volume, sensible à la latence, coût prioritaire : restez sur 3.7 Flash. Il consomme moins de tokens pour le même tarif, et un employé de Google a confirmé sur le fil de lancement que la consommation de tokens supplémentaire de 3.8 est un comportement intentionnel, pas un bug.
Il y a aussi une subtilité de latence. 3.8 Flash se classe 3ᵉ sur 195 en vitesse de sortie brute, mais son délai avant le premier token est de 13,30 secondes contre une médiane de 2,99 secondes. Pour tout ce qu'un humain attend, le modèle « rapide » est celui qui met le plus de temps à commencer à répondre. C'est du débit, pas de la réactivité, et il est facile de mal l'interpréter à partir du chiffre de vitesse en gros titre.
Comment ce tarif se compare aux autres modèles de pointe
Si vous comparez les options, voici où se situe Gemini 3.8 Flash face aux modèles avec lesquels il est réellement en concurrence sur le prix, par million de tokens, palier standard, aujourd'hui.
| Modèle | Entrée | Sortie | Remarque |
|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | Double en janv. 2027 |
| Gemini 3.7 Flash | $0.75 | $3.75 | Identique, moins de tokens par tâche |
| Claude Opus 5 | ~$5.00 | ~$25.00 | 4 fois moins de tokens de sortie par tâche |
| Claude Sonnet 5 | inférieur à Opus | inférieur à Opus | Palier Claude moins cher |
Le point de vue honnête tiré du même fil HN : un développeur a noté que Gemini Flash, avec quelques autres modèles économiques, offre « 90 % de la performance pour une petite fraction du coût » du palier de pointe. C'est le véritable argument de vente, et il est juste. Rappelez-vous simplement que cette fraction est mesurée sur le tarif brut, avant d'ajouter la taxe de verbosité et la hausse de janvier. Mon panorama des alternatives à Gemini couvre le reste du terrain, et si vous comparez Google à OpenAI, la comparaison ChatGPT contre Gemini est le point de départ, avec la liste complète des modèles OpenAI pour l'autre côté de la comparaison.
Où vous pouvez réellement l'utiliser
- Palier gratuit : entrée, sortie et cache gratuits via Google AI Studio. Suffisant pour prototyper.
- Par défaut dans Antigravity : 3.8 Flash est le modèle par défaut de Google Antigravity, avec des quotas généreux, ce que plusieurs développeurs sur HN ont signalé comme le moyen le moins coûteux de le mettre à l'épreuve d'un vrai travail.
- Applications grand public : l'application Gemini, AI Mode dans la recherche et Gemini dans Sheets, mais uniquement avec Google AI Pro ou Ultra. Si vous hésitez entre les deux, consultez les forfaits Google AI.
- Comment l'activer ou le désactiver : si vous gérez l'accès à Gemini au sein d'un Workspace, voici comment activer et désactiver Gemini.
Ce que cela signifie si vous chiffrez un bot de support
Je passe l'essentiel de mon temps à réfléchir à la façon dont les acheteurs recherchent et chiffrent l'IA pour le helpdesk, voici donc la partie qui compte si la raison pour laquelle vous lisez une page de tarification de modèle est d'automatiser le support client.
Un tarif de 0,75 $ par token paraît irrésistible face à un module complémentaire de helpdesk facturé à la résolution. Mais trois éléments cassent cette comparaison. Un modèle de support répond à des tickets courts et à fort volume, où le délai avant le premier token de 13,30 secondes se ressent à chaque réponse. La verbosité qui rend 3.8 Flash performant sur les longues tâches de codage est mal adaptée à la déviation de tickets, et elle est facturée au tarif de sortie. Et le tarif par token n'est qu'une petite partie du coût réel de l'automatisation du support, qui est dominé par le travail de récupération d'information et de tests autour du modèle, et non par l'appel au modèle lui-même.
J'ai passé les trois dernières années et plus à observer des agents IA fonctionner sur des files de support réelles, et le schéma est constant : un modèle qui semble sûr de lui peut donner discrètement de mauvaises réponses, et aucun prix par token ne corrige cela. C'est pourquoi chaque déploiement d'eesel est simulé sur vos anciens tickets réels avant de répondre à un seul client, afin que vous voyiez le taux de résolution et le coût par ticket à l'avance, plutôt que de découvrir les deux sur la facture.
Si vous choisissez vous-même un modèle pour construire l'automatisation du support, chiffrez-le honnêtement en intégrant la taxe de verbosité et le tarif de 2027. Si vous préférez ne pas connecter vous-même un modèle à votre helpdesk, eesel propose un coéquipier IA pour le helpdesk qui se branche sur vos outils existants, apprend de vos anciens tickets et est gratuit à tester, sans aucun calcul de tokens. C'est la différence entre acheter un moteur et embaucher quelqu'un qui sait déjà conduire.
Questions fréquentes
Combien coûte Gemini 3.8 Flash ?
Les tarifs de Gemini 3.8 Flash sont-ils les mêmes que ceux de 3.7 Flash ?
Pourquoi le prix de Gemini 3.8 Flash double-t-il en janvier 2027 ?
Quels sont les tarifs batch et priorité de Gemini 3.8 Flash ?
Gemini 3.8 Flash est-il moins cher que Claude Opus 5 ?
Existe-t-il un palier gratuit pour Gemini 3.8 Flash ?
Les tarifs de Gemini 3.8 Flash sont-ils adaptés au support client ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.