Ce qu'est réellement Gemini 3.8 Flash
Gemini 3.8 Flash est le modèle de référence de Google, sorti sous le nom gemini-3.8-flash et clairement orienté vers le codage à long terme et les agents autonomes plutôt que vers le chat.
Les caractéristiques n'ont pas changé par rapport à la génération précédente. Il reçoit du texte, de l'image, de l'audio, de la vidéo et du PDF en entrée, produit du texte en sortie, et conserve une fenêtre de contexte de 1M de tokens avec un plafond de sortie de 64K. Il gère l'appel de fonctions, la recherche comme outil et l'utilisation d'ordinateur. Google publie tout cela sur la fiche modèle.
L'endroit où vous pouvez réellement l'utiliser varie selon le public. Les développeurs y accèdent via Google AI Studio, l'API Gemini, Android Studio et Google Antigravity, où il est désormais le modèle par défaut. Ce dernier point compte si vous êtes à la recherche d'assistants de codage IA, car cela signifie que vous utilisez peut-être déjà 3.8 sans l'avoir choisi.
Les entreprises y accèdent via Gemini Enterprise. Les particuliers l'obtiennent dans l'app Gemini, AI Mode dans Search et Google Sheets, mais uniquement avec Google AI Pro ou Ultra. Si vous évaluez ces niveaux grand public, je les ai passés en revue dans l'article sur Google AI Plus, et il existe un guide séparé sur comment désactiver Gemini dans Workspace s'il s'est activé tout seul pour votre équipe.
Il y a un second modèle dans la même annonce, et la plupart de la couverture médiatique l'a enterré. Gemini 3.8 Flash Cyber est une variante sécurité avec des mesures d'atténuation délibérément plus souples pour le travail cyber, et son accès est réservé aux défenseurs de confiance via le nouveau Fairwind Program. Plus de détails ci-dessous, car ces chiffres sont la partie la plus impressionnante de tout le lancement.
La partie que Google dit haut et fort, et que presque personne n'a citée
Voici la phrase qui recadre le lancement. Tirée de la fiche modèle, répétée dans quatre sections distinctes :
"Gemini 3.8 Flash is based on Gemini 3.7 Flash."
Ce n'est pas une phrase anodine. Les sections Architecture, Training Dataset, Hardware, Software, Safety Policies et Acceptable Usage renvoient toutes à la fiche modèle de Gemini 3.7 Flash plutôt que de décrire quoi que ce soit de nouveau. 3.8 Flash est 3.7 Flash entraîné davantage, pas un nouveau modèle de base.
Une fois qu'on le sait, le reste du lancement n'a plus rien de surprenant. Cela explique le rythme de trois semaines. Cela explique pourquoi le prix n'a pas bougé d'un centime. Et cela fixe une attente réaliste : c'est une itération, et elle se comporte comme telle.
Le blog de Google est tout aussi direct sur le mécanisme derrière ces gains. La formulation mérite d'être lue attentivement, car c'est un compromis déguisé en fonctionnalité :
"These performance gains stem from a core design choice: 3.8 Flash works harder. On complex tasks, it exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance, especially at higher effort levels."
Puis vient la phrase qui devrait guider votre décision de mise à niveau : Google recommande aux développeurs soucieux de l'efficacité de calcul de "continue to rely on Gemini 3.7 Flash, which remains fully supported for efficiency-first workloads." Qu'un fournisseur affirme que son ancien modèle reste le bon choix est suffisamment rare pour être pris au pied de la lettre.
Tarifs : identiques à 3.7 Flash, et ils doublent en janvier
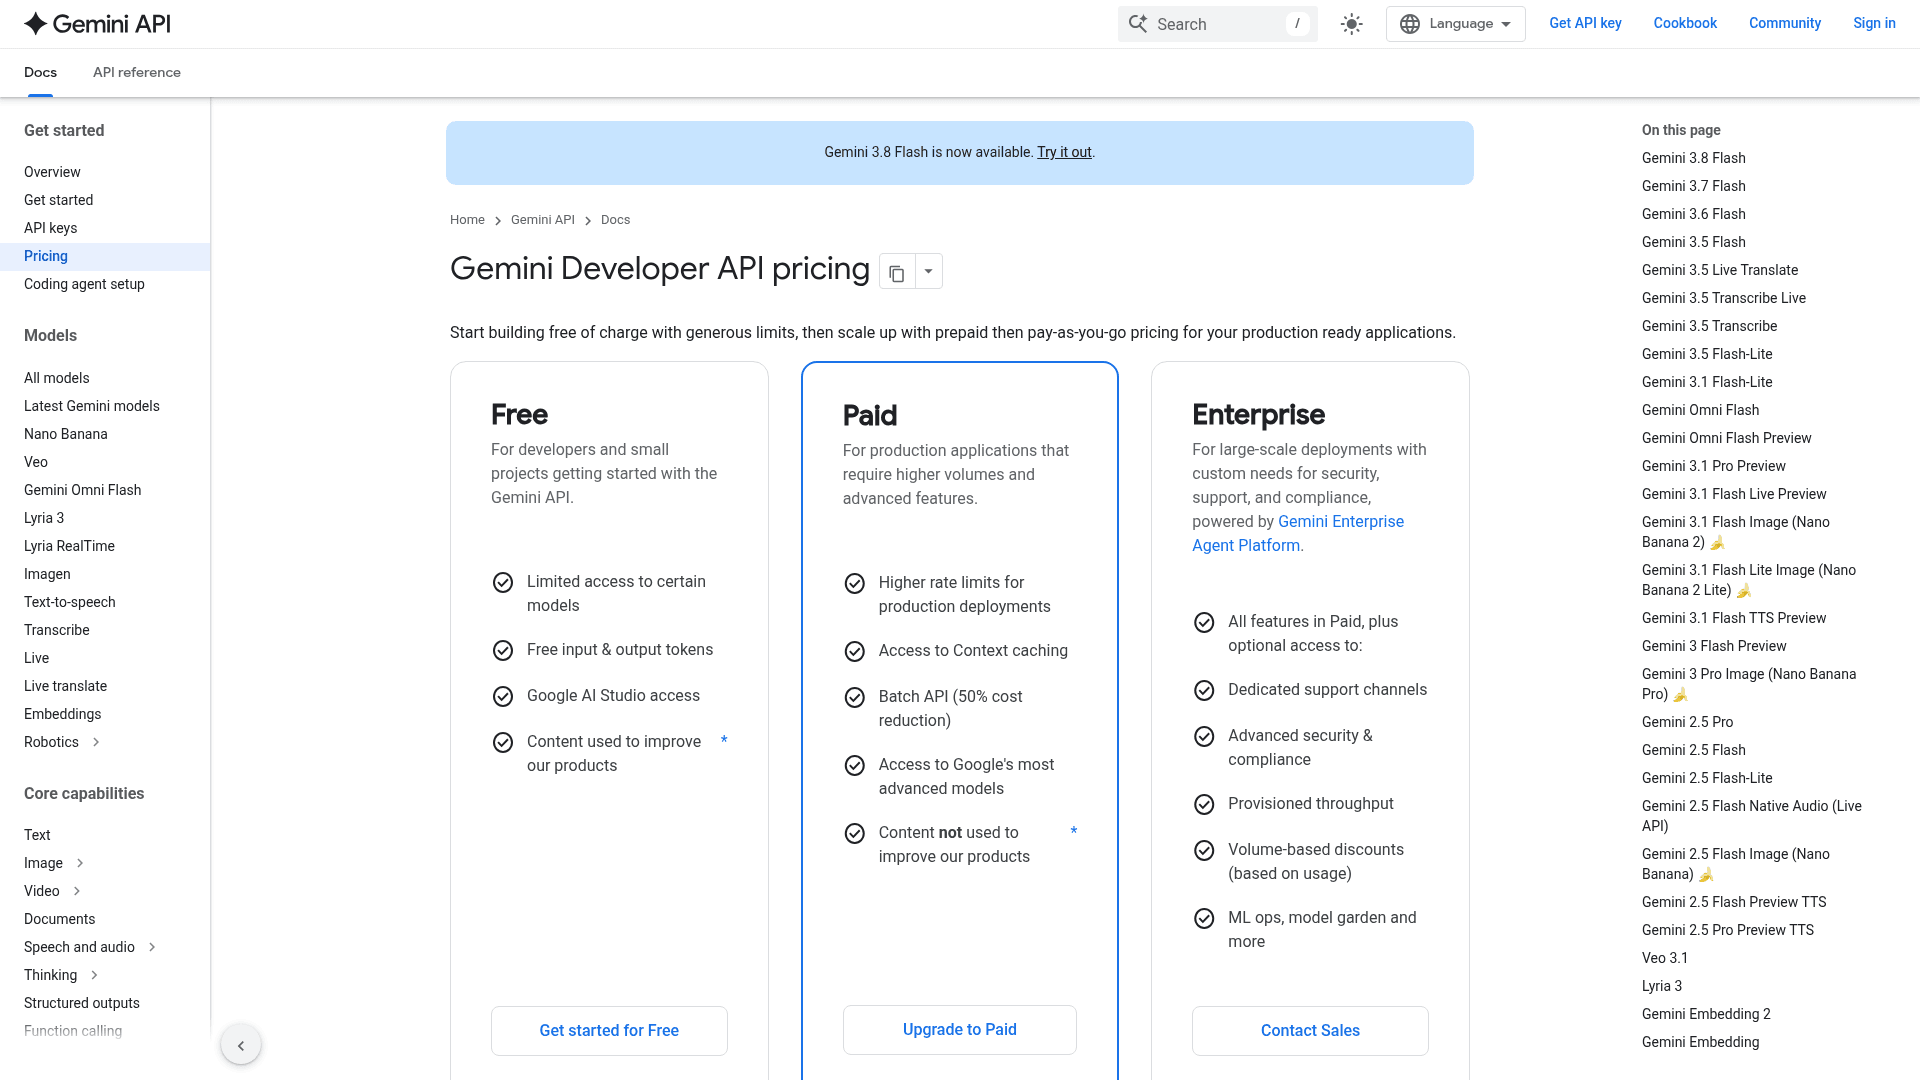
Il n'y a pas de surcoût pour le modèle plus récent. La page de tarification de l'API Gemini liste 3.8 Flash et 3.7 Flash aux mêmes tarifs, ligne par ligne.
| Niveau | Entrée / 1M | Sortie / 1M (raisonnement inclus) | Lecture de cache / 1M | À partir du 1er janv. 2027 |
|---|---|---|---|---|
| Free | $0 | $0 | $0 | inchangé |
| Standard | $0.75 | $3.75 | $0.075 | $1.50 / $7.50 |
| Batch | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Flex | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Priority | $1.35 | $6.75 | $0.135 | $2.70 / $13.50 |
Trois éléments de ce tableau méritent plus d'attention qu'ils n'en reçoivent habituellement.
Le prix de sortie inclut les tokens de raisonnement. Vous payez 3,75 $ par million pour un raisonnement que vous ne voyez jamais, seulement un résumé de celui-ci. Sur un modèle dont la caractéristique phare est de réfléchir plus, c'est le compteur qui tourne.
Le stockage du cache est facturé séparément. Les lectures coûtent 0,075 $ par million, mais le stockage coûte 0,50 $ par million de tokens par heure, doublant lui aussi en janvier.
Le grounding est partagé, pas par modèle. Vous obtenez 5 000 requêtes Google Search gratuites par mois, cumulées sur tous les modèles Gemini 3.x, puis 14 $ par 1 000. Même quota pour le grounding Google Maps.
Et le chiffre affiché n'est qu'une promotion. Tous les tarifs ici doublent le 1er janvier 2027. Si vous dimensionnez un budget 2027 sur la base de 0,75 $, vous le dimensionnez sur le mauvais chiffre, une erreur que j'ai vue des équipes commettre avec les coûts LLM plus d'une fois. Cela vaut la peine de combiner ces calculs avec de véritables outils de suivi LLM plutôt qu'une feuille de calcul, car la surcharge des tokens de raisonnement est la partie que personne ne prévoit correctement.
Pour situer ce que facturent les voisins, les tarifs de Claude Opus et les limites de débit d'OpenAI sont les deux comparaisons qui reviennent le plus souvent quand les équipes évaluent un changement.
Les benchmarks avec lesquels Google prend la tête
Google a publié quatre résultats phares, et 3.8 Flash arrive en tête sur les quatre. Voici l'ensemble complet issu de la page modèle de DeepMind, qui constitue la source primaire plutôt qu'un résumé de presse.
| Benchmark | Gemini 3.8 Flash | Gemini 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Terra | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| HLE-Verified | 54.9% | 53.6% | 54.4% | 54.5% | 51.1% | 31.0% |
| Vals Finance Agent v2 | 61.4% | 59.0% | 58.6% | 53.8% | 54.4% | 53.9% |
| Harvey's Legal Agent | 10.0% | 8.8% | 6.7% | 2.5% | 0.8% | 5.0% |
| DeepSWE v1.1 | première place | inférieur | inférieur | n/a | n/a | n/a |
Deux réserves honnêtes avant que quiconque ne fasse une capture d'écran de ce tableau.
La ligne Harvey Legal Agent ressemble à une déroute, mais le score gagnant est de 10,0 %. Chaque modèle de cette colonne échoue au benchmark ; 3.8 Flash échoue simplement le moins. Battre Opus 5 de 3,3 points sur un test que personne ne réussit est un résultat réel, mais modeste.
Et sur HLE-Verified, l'écart avec Opus 5 n'est que d'un demi-point. Google revendique une égalité avec un modèle de pointe pour une fraction du prix, ce qui est la vraie histoire, pas un coup de grâce. Pour la version génération après génération de cet argument, Gemini contre Claude Opus et ChatGPT contre Gemini tiennent tous les deux la route.
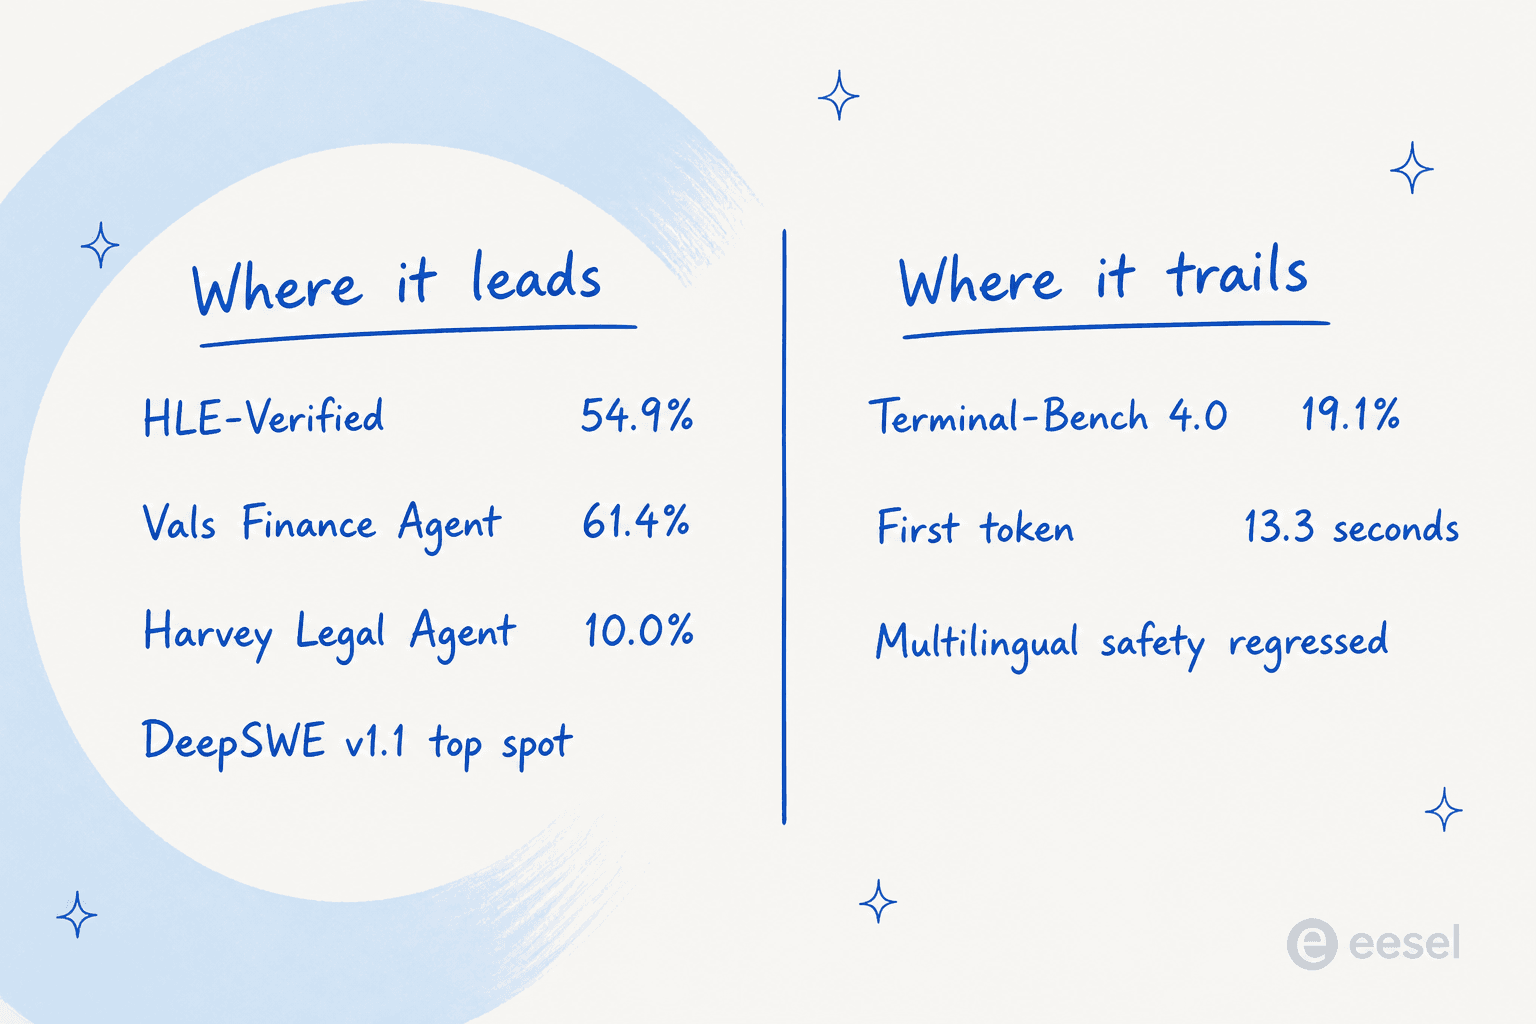
La colonne de droite est la partie que l'article de Google ne couvre pas, et elle provient de personnes qui ont réellement exécuté le modèle plutôt que de simplement l'annoncer.
Les chiffres indépendants racontent une histoire plus utile
Artificial Analysis a fait tourner 3.8 Flash à effort élevé sur son Intelligence Index composé de neuf benchmarks, et les quatre cartes de synthèse sont plus utiles pour la décision que tout ce qui figure dans l'article de lancement.
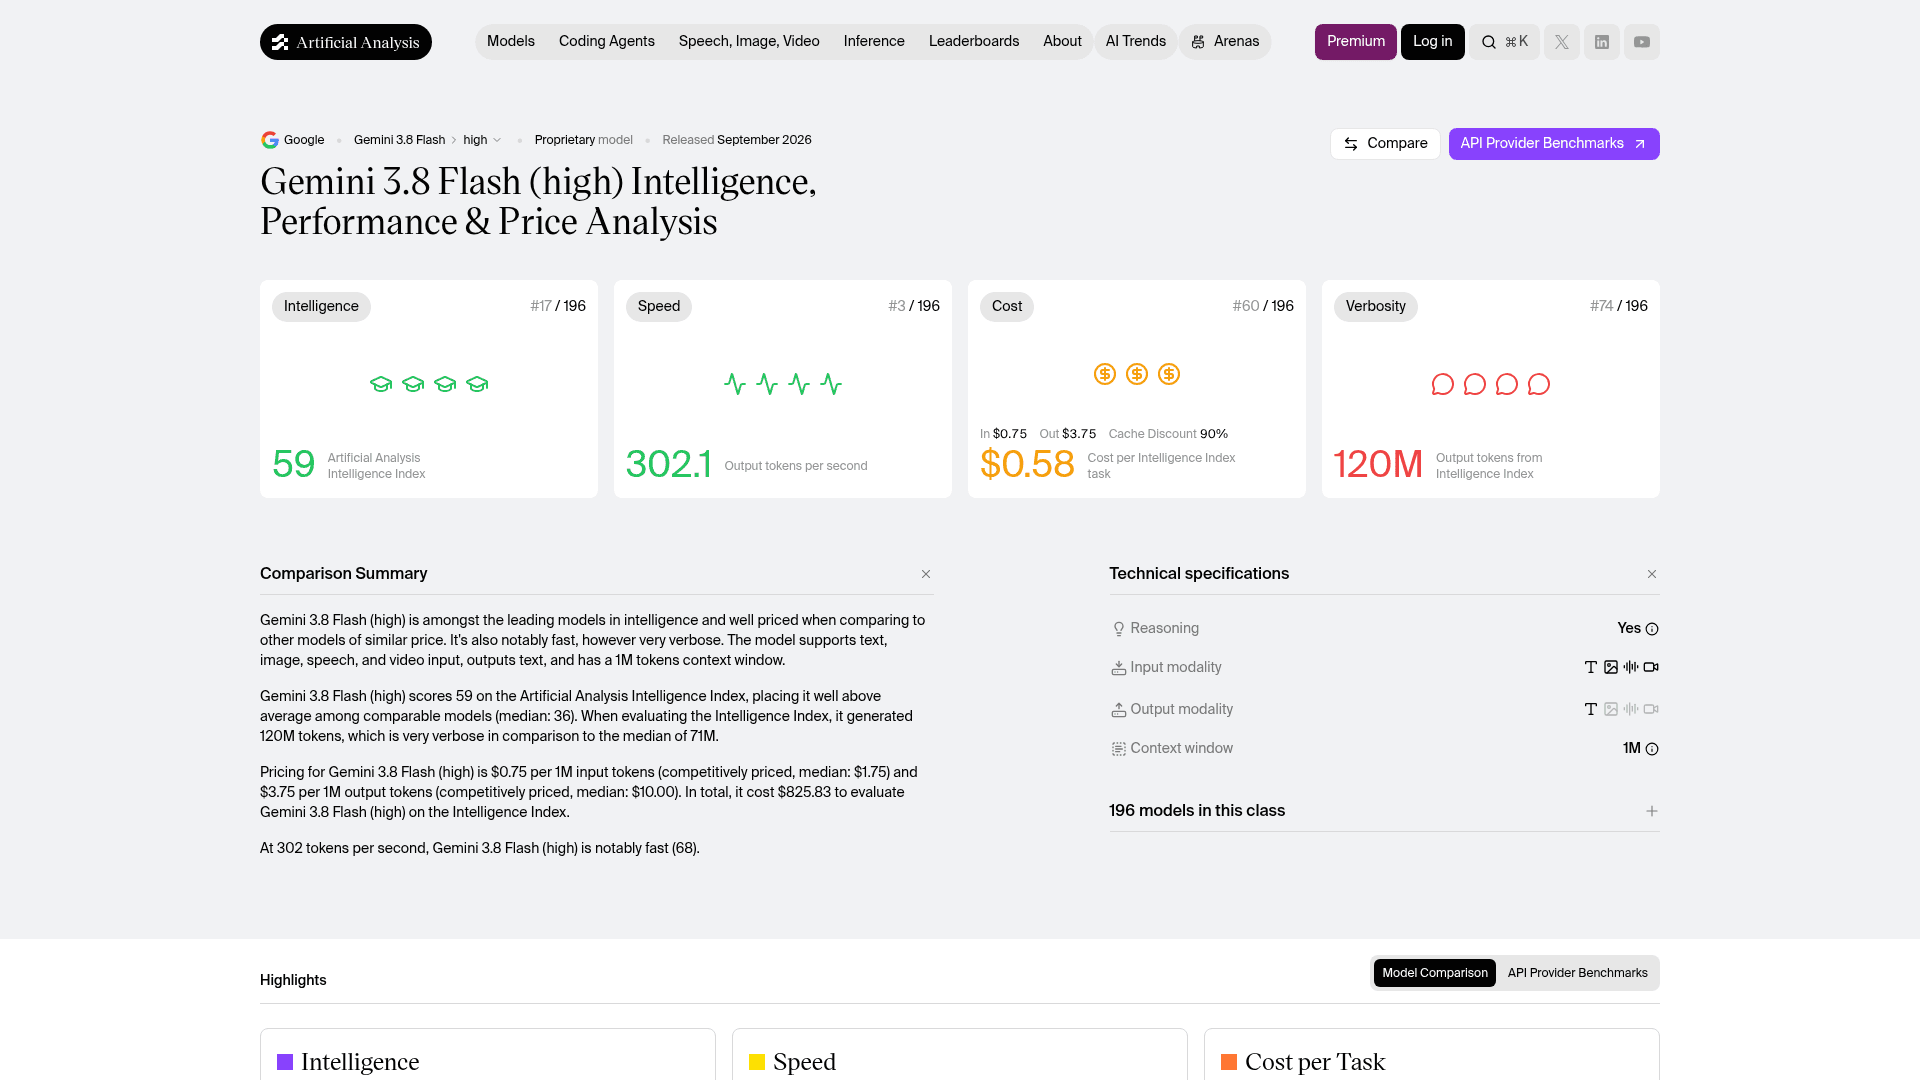
Intelligence de 59, classé 17e sur 196, contre une médiane de classe de 36. Coût de 0,58 $ par tâche de l'index, classé 60e. Vitesse de 302,1 tokens de sortie par seconde, classé 3e. Et verbosité de 120M de tokens de sortie pour terminer l'index, classé 74e, contre une médiane de 71M. Artificial Analysis le qualifie lui-même de "very verbose" dans son propre résumé. Exécuter l'index complet avec lui a coûté 825,83 $.
Ce chiffre de verbosité résume à lui seul l'histoire des tarifs.
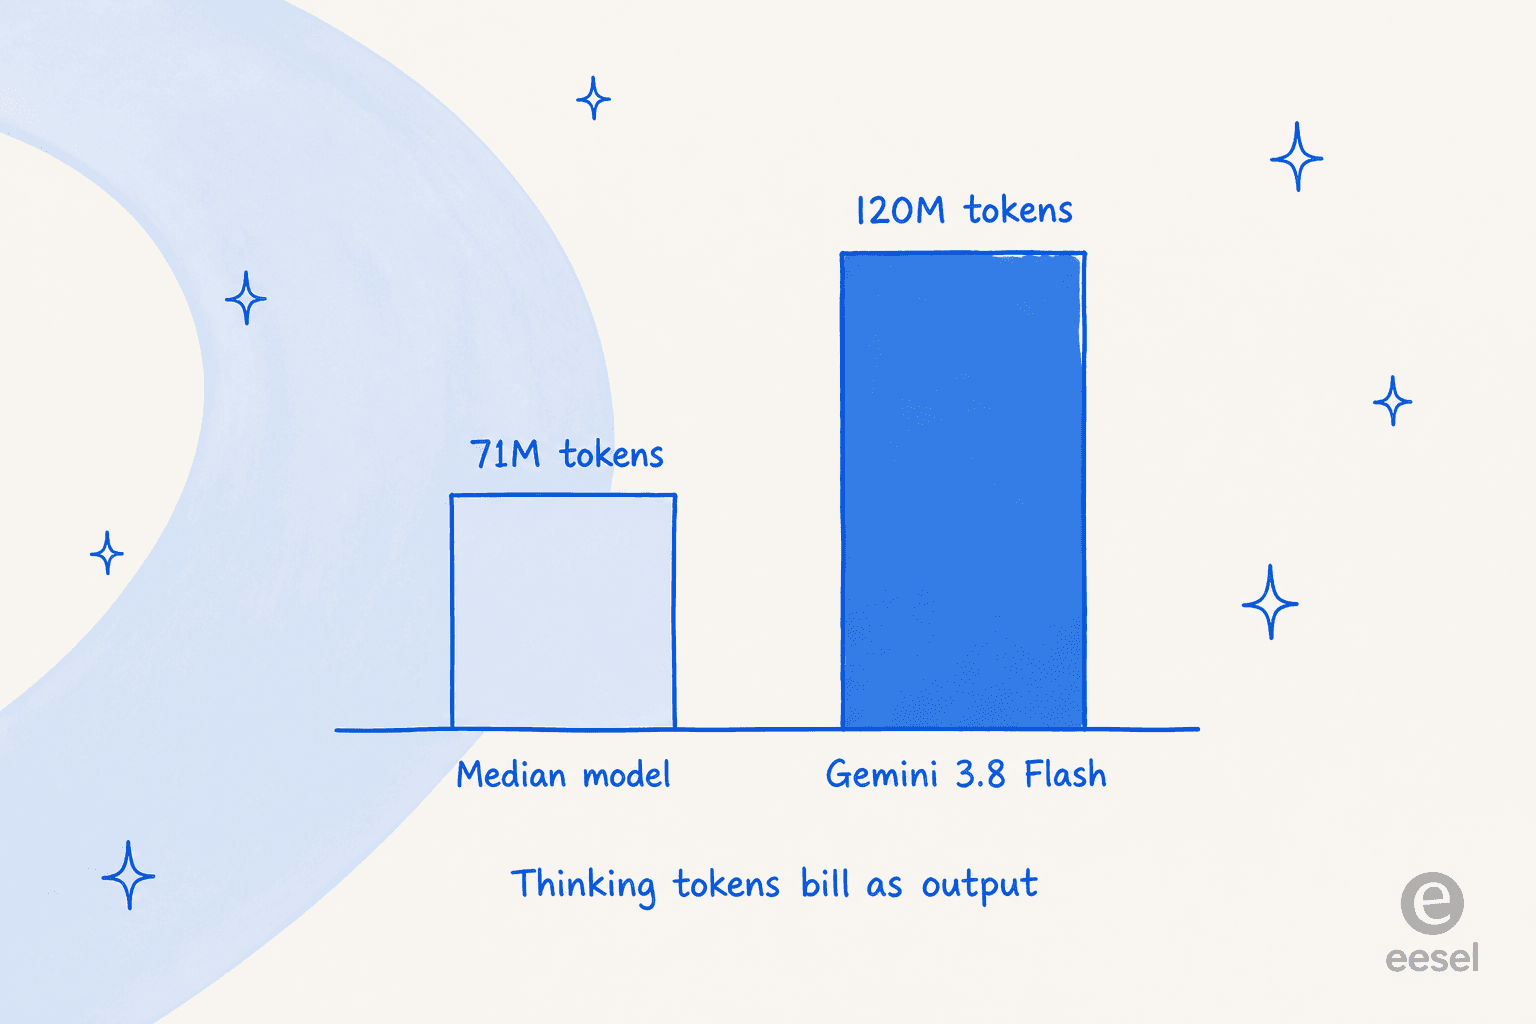
Un modèle qui utilise 70 % de tokens de sortie de plus que la médiane, à 3,75 $ par million, n'est pas aussi bon marché que sa grille tarifaire le suggère. C'était la correction la plus incisive du fil Hacker News, qui a atteint 775 points le jour du lancement :
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Puis il y a le chiffre que presque tout le monde a raté selon moi, et c'est celui qui changerait ma propre décision d'architecture.
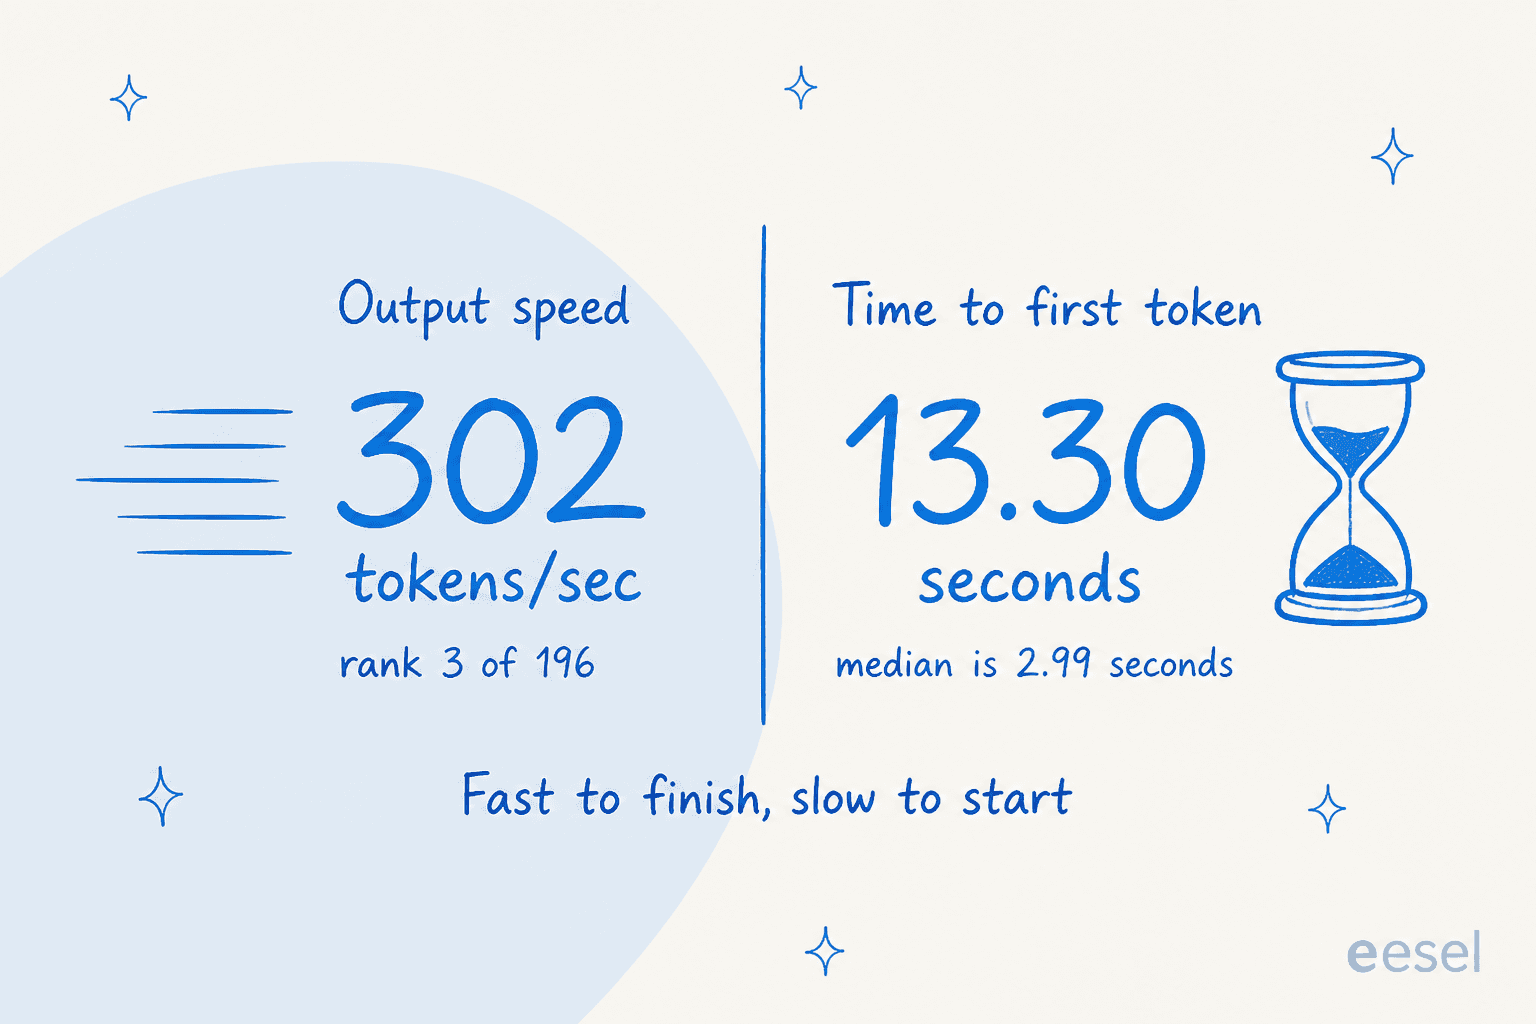
Artificial Analysis mesure le délai avant le premier token à 13,30 secondes, contre une médiane de classe de 2,99 secondes. Le troisième modèle le plus rapide au monde en débit est environ quatre fois et demie plus lent que la norme pour dire son premier mot, car il réfléchit d'abord.
Cette distinction compte énormément et est constamment aplatie. Le débit, c'est la rapidité avec laquelle un long travail se termine. Le délai avant le premier token, c'est le temps qu'une personne passe à fixer un écran vide. Pour un agent par lots qui traite un dépôt de code toute la nuit, le débit gagne et le TTFT est sans importance. Pour tout ce qu'une personne attend, comme une réponse de support ou un widget de chat, ces 13 secondes constituent toute l'expérience utilisateur.
Ce que les gens ont dit après l'avoir réellement testé
La réaction du jour du lancement s'est nettement divisée, et cette division correspond à ce clivage entre débit et latence.
Le propre développeur-avocat de Google a présenté la consommation de tokens comme un atout plutôt qu'un coût, ce qui est la version la plus honnête de l'argument du fournisseur :
"It takes smaller steps and verifies its work more often. This can leads to higher token usage but it uses those extra tokens effectively to run tests and verify changes, giving you much higher quality work overall, especially for more complex and long-running goals."
Il convient de noter qu'il travaille chez Google DeepMind, donc à traiter comme le cadrage du fournisseur plutôt que comme un test indépendant. Sa publication a recueilli 308 likes et, deux réponses plus bas, une contradiction nette venant de quelqu'un qui l'avait testé sur un vrai projet :
"Do not want to be negative, but it is absolutely not usable for SWE. Same very negative experience as it is with Gemini 3.7 Flash. Cost more than Fable on a really simple SWE tasks."
L'avis le plus utile que j'ai trouvé venait d'un développeur qui a soumis un long prompt de benchmark et publié le même soir une liste claire d'avantages et d'inconvénients :
"This model takes its time to think and work through the tasks you have given it, at a really great price and speed. Plus - long thinking, not a airhead model anymore there is subsistence here. Cons - I want to be able to have a better chat with the model before it begins it work, can't test its own work, and cant run and view in its own browser in antigravity."
Pour le chat plutôt que le code, le retour était plus positif, et précisément sur le point où les modèles Flash ont toujours été mauvais historiquement :
"The context window remains the same at 1 million tokens, but its coding reasoning ability has improved significantly, and hallucinations have been greatly reduced, so the issues where it would hallucinate or make grammatical missteps have decreased a lot."
Sur Hacker News, l'idée de flux de travail la plus pratique du fil ne consistait pas à remplacer quoi que ce soit. Elle consistait à faire travailler les modèles ensemble :
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green. Then I tell Opus to read the audit report and implement what it agrees with. Flash is really good at this, and it is blazing fast in Antigravity CLI."
Les sceptiques avaient une objection précise et vérifiable plutôt qu'une simple impression. Un commentateur a pointé le benchmark que Google avait omis :
"There are important gaps in that hot take. For example, it's not even close to Opus 5 on Terminal-bench 4.0, 19.1% vs. 51.8%."
Et plusieurs ont dénoncé une saturation du benchmark sur DeepSWE, ce qui est équitable étant donné la vitesse à laquelle chaque laboratoire le domine désormais. Comme l'a dit l'un d'eux, le benchmark a "clairement déjà été 'réglé'". Mon propre conseil est le même que celui de zuzululu dans ce fil : gardez votre propre jeu d'évaluation, car les classements publics ont cessé de différencier ces modèles depuis un moment déjà.
Deux éléments de la fiche modèle que personne ne cite
J'ai lu la fiche modèle attentivement, et deux détails qui s'y trouvent n'ont figuré dans aucune couverture médiatique que j'ai vue.
Deux indicateurs de sécurité ont régressé. Le propre tableau de Google indique Multilingual Safety à +5,4 points de pourcentage, où moins c'est mieux, et Unjustified-refusals à +1,1 point de pourcentage, également où moins c'est mieux. Google le dit clairement plutôt que de le cacher : "Safety performance across non-English languages regressed slightly relative to 3.7 Flash." Si vous servez des utilisateurs non anglophones, c'est une considération réelle, et c'est le genre de chose qui n'apparaît qu'en production.
En lien avec cela, et qu'il vaut la peine de savoir : Google n'a pas relancé l'évaluation complète de Frontier Safety sur 3.8 Flash. La fiche indique que l'équipe a évalué 3.7 Flash, puis conclu que, puisque 3.8 Flash n'a pas de "meaningful new capabilities", les résultats de 3.7 restent valables. Raisonnable étant donné la base partagée, mais c'est une déduction, pas une mesure.
Le tableau comparatif comporte une référence mal étiquetée. Le tableau de sécurité est intitulé "Gemini 3.8 Flash vs. Gemini 3.7 Flash", mais la note de bas de page 1 précise que la ligne Tone est mesurée "compared to Gemini 3 Flash". C'est un modèle différent et plus ancien qui se trouve dans une colonne prétendant être une comparaison avec 3.7. Un lecteur de Hacker News l'a repéré en premier et a qualifié cela de "Chartcrime, the major AI lab tradition". J'ai vérifié la fiche en ligne et la note de bas de page dit toujours la même chose.
Ni l'un ni l'autre n'est un scandale. Les deux sont le genre de détail qui distingue la lecture de la source primaire de la réécriture du communiqué de presse.
Gemini 3.8 Flash Cyber, le lancement le plus impressionnant
La variante sécurité a reçu une fraction de l'attention et affiche les chiffres les plus forts.
Sur CyberGym, le benchmark standard pour la découverte autonome de vulnérabilités, Google affirme que 3.8 Flash Cyber surpasse à la fois 3.5 Flash Cyber et "significantly larger frontier models". Sur un benchmark interne couvrant 20 langages de programmation, il dépasse un taux de réussite de 70 %. Sur CWE-Bench, un benchmark externe de correctifs géré par Collinear, il obtient 47,2 % de pass@1 contre 47,8 % pour un modèle de pointe leader, à un coût bien inférieur.
Les chiffres de déploiement sont meilleurs que les benchmarks. L'équipe Chrome Security de Google a constaté qu'il produisait 2,6 fois plus de correctifs corrects pour les vulnérabilités de Chrome que les meilleurs modèles commerciaux, bien plus grands. Wiz a mesuré un rappel supérieur de 7,5 à 9,7 points de pourcentage sur son benchmark interne de tests d'intrusion, à un coût 2,3 à 5,2 fois inférieur. Et l'équipe Cloud Vulnerability Research de Google l'a utilisé pour trouver une vulnérabilité fondamentale critique en moins de deux heures, un travail qui prend normalement des mois, selon leurs propres dires.
Le piège, c'est l'accès. Impossible de l'acheter. Il n'est distribué qu'aux défenseurs de confiance via le Fairwind Program, c'est-à-dire les autorités gouvernementales, les opérateurs d'infrastructures critiques et les mainteneurs de logiciels qui déposent une demande et sont approuvés. Tous les autres reçoivent le modèle standard avec les garde-fous CBRN et anti-cyberoffensive intacts.
Alors, devriez-vous vraiment changer ?
Comme le prix est identique, c'est purement une question de forme de charge de travail.
Passez à 3.8 Flash si vous exécutez du codage agentique à long terme, de la recherche multi-étapes, ou un travail intensif en documents où la qualité compte plus que le nombre de tokens. Le responsable produit IA de Glean a rapporté que le modèle "completing more than three times as many tasks as Gemini 3.7 Flash" sur des flux de travail documentaires de longue durée dans leurs évaluations. C'est désormais le modèle par défaut dans Antigravity, donc vous l'utilisez peut-être déjà.
Restez sur 3.7 Flash si votre charge de travail est à fort volume, à contexte court, ou sensible à la latence. Google le dit lui-même. L'écart de verbosité signifie que 3.8 peut coûter plus cher par tâche accomplie malgré un tarif identique, et les 13,30 secondes de TTFT sont disqualifiantes pour tout ce qui est interactif.
N'envisagez ni l'un ni l'autre si vous choisissez un modèle pour alimenter une fonctionnalité produit plutôt que pour coder avec. Cela vaut la peine d'être précisé, et c'est la même conclusion à laquelle je suis arrivé en rédigeant les meilleurs agents IA et les agents IA pour petites entreprises : le modèle décide rarement du résultat.
Ce que cela signifie si vous déployez l'IA sur une file de support
C'est ici que je veux être direct, car c'est l'erreur que je vois le plus souvent.
Les équipes qui évaluent l'IA pour le support client passent des semaines à comparer les benchmarks des modèles, puis déploient quand même quelque chose qui donne des réponses fausses avec assurance. Une équipe de support avec laquelle j'ai travaillé a rencontré exactement ce problème. Leur bot disait aux clients "yes, we support your car model" pour des marques de véhicules qui n'étaient pas dans leur base de données, parce que leur base de connaissances disait "we support all models". Aucun score de benchmark ne corrige cela. Ce n'a jamais été un échec du modèle. C'était un échec de recherche d'information et de cadrage, et un modèle plus intelligent aurait simplement formulé la mauvaise réponse avec plus de fluidité.
Le schéma se répète. Un client a formulé l'exigence aussi clairement que possible :
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
a DTC supplements CX lead, eesel customer research
C'est une exigence produit, pas une exigence de modèle. Le contrôle de confiance, les règles d'escalade, une couverture de sujets délimitée et un test à blanc sur des tickets déjà traités déterminent si le support par IA fonctionne. Rien de tout cela n'apparaît sur un classement. Pour la version plus détaillée, j'ai écrit séparément sur pourquoi les chatbots IA répondent incorrectement.
Le travail en amont compte tout autant. Bien maîtriser la classification de tickets et le tagging de support est ce qui permet à un bot de savoir quels tickets il ne doit pas toucher, et une base de connaissances bien entretenue est ce qui l'empêche d'inventer une réponse dès le départ.
La version construire-versus-acheter de tout cela revient constamment aussi :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES
Des modèles comme 3.8 Flash sont de l'infrastructure. Ils sont le moteur, pas l'employé. Intégrer l'un d'eux dans un support client signifie construire une recherche d'information sur vos documents et vos anciens tickets, des appels d'outils vers votre système de tickets, des seuils de confiance, des chemins d'escalade, et un moyen de tester tout cela avant qu'un client ne le voie. C'est le véritable projet, et c'est le même projet, que le modèle sous-jacent soit Gemini, Claude ou un modèle OpenAI.
Essayer eesel
Si ce que vous voulez réellement, c'est que l'IA réponde aux tickets plutôt que de connecter un modèle vous-même, eesel est l'endroit par lequel je commencerais. eesel vend des coéquipiers IA prêts à travailler plutôt que de l'infrastructure brute, et l'agent de support IA rejoint votre file existante sur Zendesk, Freshdesk ou Gorgias, entraîné sur votre centre d'aide et vos anciens tickets, en quelques minutes.

Ce qui distingue eesel, c'est la partie que les benchmarks de modèles ne peuvent pas vous donner. Chaque déploiement eesel est d'abord simulé sur vos véritables tickets historiques, afin que vous voyiez ce que l'IA aurait répondu à des clients déjà servis, avant qu'elle ne dise quoi que ce soit à un client réel. C'est le contrôle qui détecte l'échec du type "we support all models", et il existe parce qu'eesel observe depuis des années des bots confiants se tromper sur de vraies files de support. C'est gratuit à essayer, et le coéquipier rédacteur de blog IA fonctionne sur la même plateforme si le contenu est votre goulot d'étranglement plutôt que le support.
Pour en savoir plus sur les décisions connexes, mon panorama des logiciels de support IA couvre le marché, et l'automatisation des tickets couvre la couche de flux de travail sous-jacente.
Côté finances, les économies de coûts du support IA présente les calculs, et le coût agent contre humain est la comparaison que les équipes financières demandent réellement.
Et si vous êtes encore en train de comparer des modèles plutôt que des produits, les alternatives à Gemini et les meilleurs agents IA sont les deux points de départ les plus utiles.
Questions fréquentes
Qu'est-ce que Gemini 3.8 Flash ?
gemini-3.8-flash. Il traite le texte, l'image, l'audio, la vidéo et le PDF en entrée, avec une fenêtre de contexte de 1M de tokens et 64K en sortie, et il est optimisé pour le codage à long terme et les agents autonomes. La fiche modèle de Google indique elle-même qu'il s'appuie sur Gemini 3.7 Flash plutôt que sur un nouveau modèle de base. Si vous le comparez au reste du marché, mon panorama des alternatives à Gemini couvre le reste.Combien coûte Gemini 3.8 Flash ?
Gemini 3.8 Flash est-il meilleur que Gemini 3.7 Flash ?
Gemini 3.8 Flash est-il meilleur que Claude Opus 5 ?
Qu'est-ce que Gemini 3.8 Flash Cyber et puis-je l'utiliser ?
Gemini 3.8 Flash est-il adapté au support client ?
Où puis-je essayer Gemini 3.8 Flash gratuitement ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.