Les 8 meilleures alternatives à Xiaomi MiMo V2.6 en 2026

Rama Adi Nugraha

Katelin Teen
Dernière modification September 23, 2026
Pourquoi chercher une alternative à MiMo V2.6
Laissez-moi d'abord être juste envers MiMo, car il a gagné cette attention. Le modèle Pro à 1T de paramètres devance le modèle Kimi K3 à 2,8T de paramètres sur 14 des 15 benchmarks qu'un commentateur a comptés à la main, avec une fraction de la taille, et Xiaomi a maintenu le prix stable par rapport à V2.5. Il est sous licence MIT, nativement omnimodal, et livré avec un contexte de 1M de tokens. La réaction de la communauté a été inhabituellement chaleureuse, et surtout à propos de la transparence plutôt que des scores.
Alors pourquoi comparer ? Quelques raisons honnêtes :
- L'avance dans les benchmarks est la plus étroite là où ça compte le plus. Sur Terminal Bench 4.0, MiMo-V2.6-Pro obtient 34,9, bien en dessous des 59,6 de GPT-6 Astra et des 49,0 de Claude Opus 5. Sur les classements de code réel les plus difficiles, MiMo domine le camp ouvert à bas coût mais reste derrière les modèles vedettes. Si votre travail repose sur ces tâches, la dépense supplémentaire pour un modèle de pointe peut valoir le coup.
- La résidence des données est une contrainte réelle. L'API hébergée de MiMo fonctionne sous le droit chinois, et l'auto-hébergement du checkpoint Pro nécessite une machine à 2 nœuds et 16 GPU. Pour des données réglementées ou clients, c'est un vrai blocage, pas un détail.
- Le scepticisme du « benchmaxxing ». Une inquiétude récurrente dans la communauté est que les avances dans les index ne survivent pas au contact du code de production. Comme l'a formulé un commentateur de Hacker News, sans détour :
"No chinese lab has caught up yet... the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."

C'est un avis, et le contraire est aussi bien argumenté (de nombreux ingénieurs rapportent que les modèles chinois bon marché associés à un modèle de pointe superviseur battent les modèles américains coûteux en termes de ROI). Mais ce désaccord lui-même est une raison de connaître ses alternatives.
Comment j'ai choisi ces alternatives
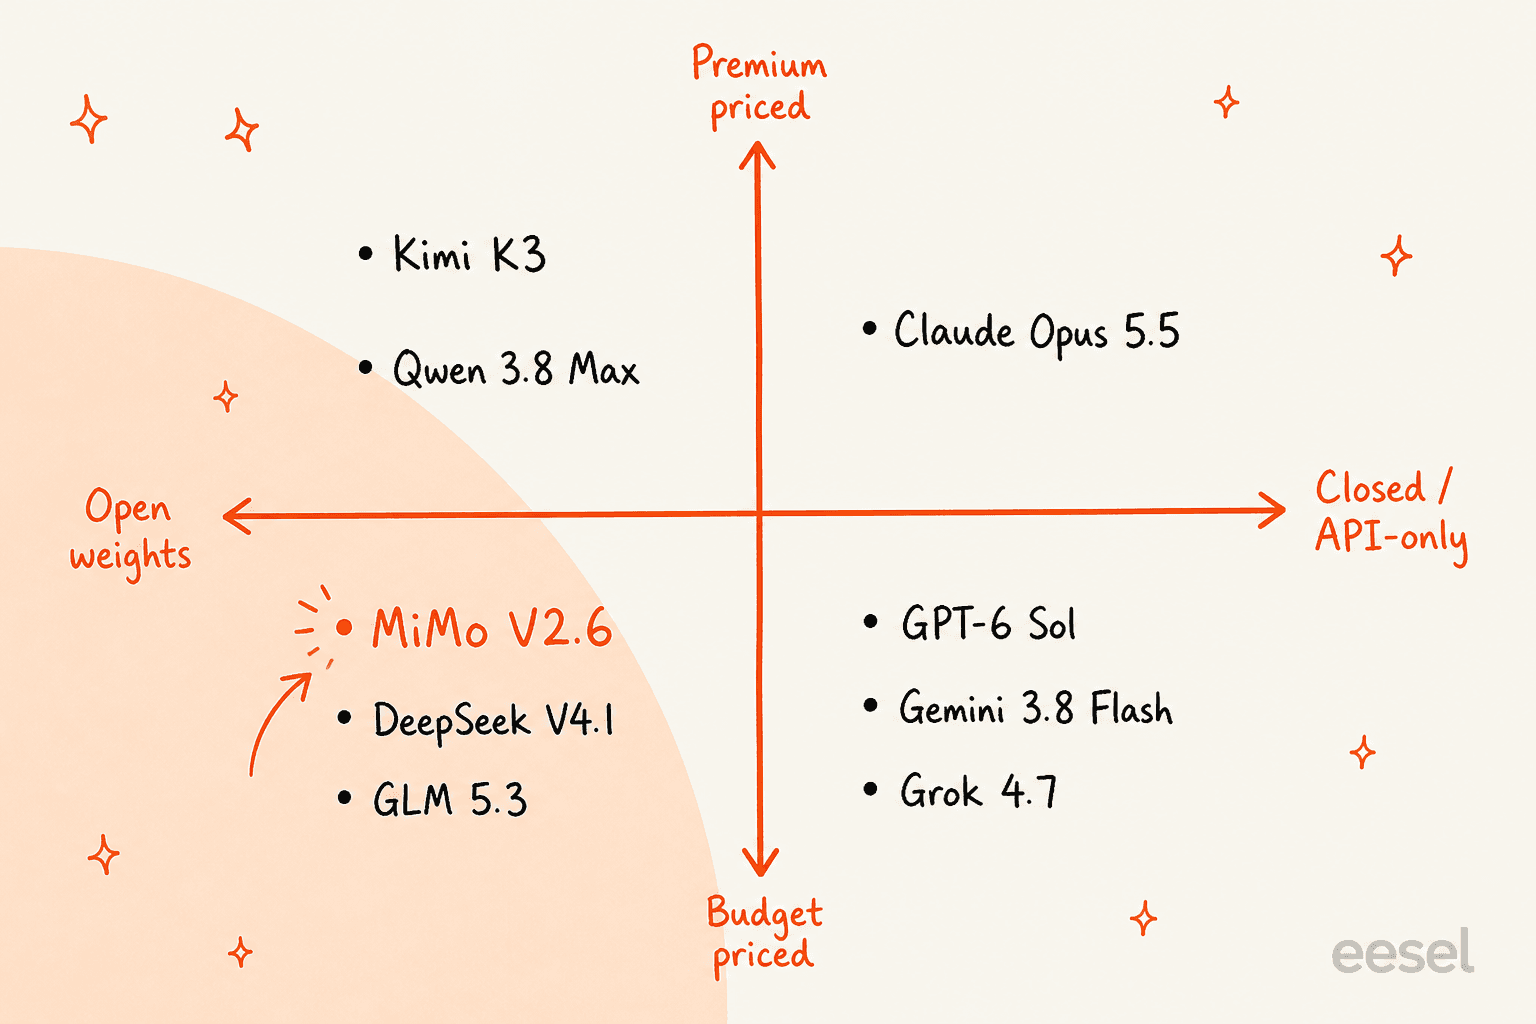
J'ai limité la sélection aux modèles réellement disponibles et qu'une vraie équipe envisagerait aux côtés de MiMo V2.6. Cela impliquait trois filtres : actuel (tous lancés ou repriced au cours des derniers mois de 2026), comparable (ils figurent dans les mêmes tableaux de benchmarks que MiMo) et distinct (chacun l'emporte sur un axe différent, pour que la liste ne soit pas huit versions du même compromis).
Je me suis appuyé sur des sources primaires pour chaque chiffre : les fiches modèles et pages tarifaires des fournisseurs eux-mêmes, les listings OpenRouter, et l'index Artificial Analysis pour une lecture neutre intelligence-versus-coût. Là où la communauté avait un point précis et vérifiable, je l'ai cité avec un lien permanent. Les prix ci-dessous sont par 1M de tokens, sauf indication contraire.
Les alternatives à MiMo V2.6 en un coup d'œil
| Modèle | Type | Paramètres | Contexte | Prix /1M (entrée / sortie) | AA Intelligence | Idéal pour |
|---|---|---|---|---|---|---|
| MiMo V2.6 Pro | Ouvert (MIT) | 1.02T / 42B actifs | 1M | $0.435 / $0.87 | 46 | Meilleur modèle ouvert le moins cher |
| DeepSeek V4.1 | Ouvert (MIT) | 552B MoE | 1M | $0.15 / $0.60 (hors pic) | niveau cheval de trait | Cheval de trait bon marché utilisant des outils |
| Kimi K3 | Ouvert | 2.8T / 104B actifs | 1M | $3 / $15 | 57 | Plus grand modèle ouvert |
| Qwen 3.8 Max | Ouvert (hébergé) | 2.4T / 95B actifs | 1M | $2 / $6 | 58 | Petites variantes adaptées au local |
| GLM 5.3 Flash | Ouvert | 320B / 18B actifs | 1M | $0.15 / $0.50 | 57 | Modèle ouvert bon marché pour du vrai code |
| Claude Opus 5.5 | Fermé | Non divulgué | 1M | $5 / $25 | 58 | Plafond de raisonnement le plus élevé |
| GPT-6 Sol | Fermé | Non divulgué | 1.05M | $2 / $10 | 48 | Le moins cher par tâche accomplie |
| Gemini 3.8 Flash | Fermé | Non divulgué | 1M | $0.75 / $3.75 | 59 | Contexte multimodal massif |
| Grok 4.7 | Fermé | Modèle de base plus grand | 500K | $2 / $6 | 46 | Boucles d'agents à volume, données X en direct |
1. DeepSeek V4.1
Idéal pour : les équipes qui veulent le modèle ouvert performant le moins cher avec un vrai historique.
DeepSeek V4.1 Flash est passé en disponibilité générale le 10-09-2026, et DeepSeek a retiré l'ancien V4 Pro en le fusionnant dedans, redirigeant ces requêtes vers V4.1 Flash aux tarifs Flash. C'est le modèle ouvert chinois de référence, et MiMo est présenté à répétition comme la solution de secours moins chère par rapport à lui, plutôt que l'inverse. L'architecture est vraiment novatrice : un encodeur-décodeur causal à 552B de paramètres qui utilise 8B de paramètres actifs pour l'entrée et 16B pour la sortie, avec un cache KV environ 4x plus petit que la génération précédente. Les poids sont sous licence MIT avec une vision native intégrée.
Dans le tableau de DeepSeek lui-même, V4.1 domine sur Terminal-Bench 2.1 (90,6), DeepSWE (74,2) et HLE-avec-outils (63,9, juste au-dessus d'Opus 5). Les benchmarks communautaires le chronomètrent à 250-400 tokens par seconde, détrônant Gemini Flash comme l'option la plus rapide que beaucoup avaient essayée.
Avantages :
- Le modèle ouvert sérieux le moins cher : l'entrée hors pic avec cache manqué coûte 0,15 $, la sortie 0,60 $ par 1M, et les heures creuses couvrent la majorité des heures ouvrées aux États-Unis et en Europe.
- Poids MIT, vision multimodale native, contexte de 1M.
- Un cheval de trait éprouvé et largement déployé, pas une sortie de la première semaine.
Inconvénients :
- Le raisonnement brut est le point faible : un HLE de 36,8 se situe en dessous de GPT-6 Sol et Opus 5. C'est un utilisateur d'outils, pas un champion du raisonnement.
- Les tarifs aux heures de pointe (01h00-04h00 et 06h00-10h00 UTC) doublent le prix, donc le coût est une cible mouvante.
- Les conditions de l'API payante sont silencieuses, et non permissives, sur l'utilisation pour l'entraînement, et les données sont traitées en RPC, réfléchissez donc à deux fois avant d'y faire transiter des données clients.
Verdict : si le prix de MiMo vous a attiré, DeepSeek V4.1 est le remplaçant le plus direct, et sans doute le pari le plus sûr en termes de maturité. Choisissez-le quand vous voulez un moteur bon marché pour du travail intensif en outils et que vous pouvez composer avec la réserve sur la résidence des données.
2. Kimi K3
Idéal pour : les équipes qui veulent le plus grand modèle ouvert du marché et sont prêtes à payer pour le plafond.
Kimi K3 de Moonshot a été lancé le 16-07-2026 comme un modèle à 2,8T de paramètres avec 104B actifs, et Moonshot a publié les poids ouverts dans les temps, ce que tous les laboratoires ne font pas. Il obtient 57 sur l'index Artificial Analysis, une bonne quatrième place au global, et c'est le modèle auquel MiMo est le plus souvent comparé pour illustrer l'argument taille-contre-performance.
Le hic, c'est que K3 est l'endroit où la leçon « plus gros n'est pas moins cher » mord. Son API coûte 3 $ en entrée et 15 $ en sortie par 1M, la même tranche qu'un modèle fermé de milieu de gamme, et le raisonnement ne peut être désactivé à aucun niveau. Ce décompte de GodelNumbering mérite d'être cité car il capture exactement cette tension :
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"
Avantages :
- Poids ouverts, contexte de 1M, vision native, forte intelligence générale (index AA 57).
- Vraiment performant en raisonnement difficile, là où MiMo est plus faible.
Inconvénients :
- Environ 50 fois le prix de sortie de MiMo, à 15 $ par 1M, à peu près au même niveau que la tarification Claude Sonnet.
- Le raisonnement est toujours actif, c'est donc un coût de latence que vous ne pouvez pas réduire.
- 1 561 Go de poids font de l'auto-hébergement un vrai projet matériel.
Verdict : K3 est le modèle ouvert vers lequel se tourner quand on veut une capacité maximale et que la taille ne fait pas peur, mais en rapport prix-intelligence pur, MiMo et DeepSeek le battent tous les deux. Choisissez K3 quand le plafond compte plus que la facture.
3. Qwen 3.8 Max
Idéal pour : les équipes qui veulent une famille ouverte avec des petites variantes vraiment adaptées au local.
Qwen 3.8 Max d'Alibaba est passé en disponibilité générale le 02-08-2026, un MoE à 2,4T / 95B actifs avec un contexte de 1M. Sur le classement Artificial Analysis, il se situe au 6ᵉ rang avec un index de 58, et il est aussi solide sur LMArena (Texte #5, Vision #2). La tarification API est de 2 $ en entrée et 6 $ en sortie par 1M via Qwen Cloud.
La raison pour laquelle Qwen revient sans cesse comme alternative à MiMo, c'est la famille, pas seulement le fleuron. Le favori de la communauté pour l'inférence locale, ce sont les modèles Qwen plus petits, qu'un commentateur a qualifiés de « crazy good for how small it is » et qui tournent indéfiniment sur une machine de classe station de travail. Les poids Max hébergés ont été publiés, mais sous une licence non-Apache ; l'option permissive et vraiment locale est le Qwen3.8-27B plus petit (Apache 2.0).
Avantages :
- Forte intelligence générale (AA 58) et excellents scores de préférence humaine.
- Une véritable échelle de tailles, y compris un petit modèle sous licence permissive pour les exécutions locales.
- Une tarification hébergée raisonnable de 2 $ / 6 $.
Inconvénients :
- Le Max hébergé et la base ouverte ne sont pas équivalents en fonctionnalités (vision, mode sans réflexion et contexte par défaut de 1M sont réservés à la version hébergée).
- Son propre environnement de codage plafonne la sortie à 65K tokens, donc il ne demande jamais le plafond complet de 131K d'origine.
- Les scores composites automatisés et la préférence humaine pointent dans des directions différentes, ne faites donc pas confiance à un seul chiffre comme verdict.
Verdict : Qwen 3.8 Max est le choix quand vous voulez une famille ouverte dans laquelle grandir, d'un petit modèle adapté aux ordinateurs portables jusqu'à un fleuron quasi-pointe. Si « local » est une exigence stricte, Qwen offre le chemin le plus propre de tous les modèles ici.
4. GLM 5.3 Flash
Idéal pour : les équipes qui veulent le modèle ouvert le moins cher qui tient la route en code réel.
GLM 5.3 Flash de Z.ai a été lancé le 26-08-2026 comme le premier modèle GLM-5 nativement multimodal, un MoE à 320B / 18B actifs avec un contexte de 1M et des poids ouverts. Il obtient un index Artificial Analysis de 57 à environ 0,045 $ par tâche, ce qui le place exactement dans la gamme de budget de MiMo. La tarification API est de 0,15 $ en entrée et 0,50 $ en sortie par 1M (la promotion de lancement à 0,075 $ / 0,25 $ a pris fin).
GLM est le modèle ouvert que les gens citent spécifiquement quand la discussion se tourne vers le code réel plutôt que les benchmarks. Dans ce même fil sceptique de Hacker News, le contre-argument était que GLM associé à un modèle de pointe superviseur bat déjà les modèles américains coûteux en pratique :
"I mean DSv4.1 Flash and GLM 5.3 kept in check by a supervising frontier like Astra or Fable already in my experience clowns massively on ever using Opus or Sonnet."
Avantages :
- Très bon marché (0,15 $ / 0,50 $) avec un index AA solide (57), des poids ouverts, un contexte de 1M.
- Une vraie réputation de tenir la route sur des tâches de codage en production.
- Un fleuron distinct uniquement texte (GLM-5.3 à 1,40 $ / 4,40 $) pour du codage plus lourd et du travail de cybersécurité.
Inconvénients :
- L'API propriétaire est lente (~49 tokens par seconde) ; il faut un hébergeur tiers comme Databricks pour un débit réel.
- La réflexion ne peut pas être désactivée.
- Comme pour les autres modèles ouverts chinois, les mêmes questions de résidence des données et d'utilisation pour l'entraînement s'appliquent.
Verdict : GLM 5.3 Flash est le choix valeur-plus-code. Si DeepSeek est le généraliste bon marché et Kimi le grand, GLM est celui à tester quand votre charge de travail est majoritairement du code et que la facture doit rester minuscule.
5. Claude Opus 5.5
Idéal pour : les équipes qui ont besoin du plafond de raisonnement le plus élevé sur le travail agentique le plus difficile.
Si le point faible de MiMo est le sommet de la courbe de difficulté, Claude Opus 5.5 est le modèle qui le maîtrise. Le fleuron d'Anthropic occupe la #1 place de l'Intelligence Index d'Artificial Analysis (58) et devance confortablement MiMo sur Terminal Bench 4.0 et sur les classements d'agents de codage les plus difficiles. Il coûte 5 $ en entrée et 25 $ en sortie par 1M avec un contexte plat de 1M (pas de surcoût de contexte long), et les lectures de cache coûtent un dixième de ce prix.
Le contrepoids honnête, c'est le coût par tâche. Opus dépense beaucoup de tokens de sortie : sur l'index Artificial Analysis, il tourne autour de 5,98 $ par tâche en effort maximal, contre 0,13 $ pour MiMo. Vous payez des tarifs de pointe pour un plafond de pointe.
Avantages :
- Scores de raisonnement et agentiques au sommet ; le plafond que MiMo n'atteint pas sur les classements les plus difficiles.
- Tarification plate à contexte de 1M, outillage mature, et une posture claire de gestion des données pour le travail réglementé.
Inconvénients :
- Coûteux par token, et encore plus par tâche accomplie car il est verbeux à effort élevé.
- Temps lent jusqu'au premier token en effort maximal, ce qui pénalise tout ce qu'une personne attend en direct.
- Poids fermés, donc l'auto-hébergement et l'inférence locale réelle sont exclus.
Verdict : Opus 5.5 est l'anti-MiMo : pas le choix valeur, mais le choix capacité. Tournez-vous vers lui quand la tâche a vraiment besoin du meilleur raisonnement disponible et que le budget peut l'absorber, et associez-le à un modèle moins cher pour les 80 % de routine.
6. GPT-6 Sol
Idéal pour : les équipes qui veulent un modèle de pointe hébergé au coût par tâche accomplie le plus bas.
GPT-6 Sol d'OpenAI a été lancé le 22-09-2026, le même jour que MiMo, et toute son histoire tourne autour de la valeur. Il a été tarifé à 2 $ en entrée et 10 $ en sortie par 1M, une réduction plate de 50 % par rapport à GPT-5.6 Sol, avec un contexte de 1,05M. Son Intelligence Index Artificial Analysis (48) est au niveau de la génération précédente, donc c'est une baisse de prix déguisée en saut de version, pas un saut de capacité, mais c'est exactement ce qui en fait une alternative solide à MiMo pour le travail hébergé.
Le chiffre qui compte est le coût par tâche, où Sol est étonnamment efficace car il utilise beaucoup moins de tokens de sortie qu'Opus. Sur l'index Artificial Analysis, il tourne autour de 1,06 $ par tâche en effort maximal contre 5,98 $ pour Opus 5.5, soit environ 5,6 fois moins cher pour un modèle à peine en retrait en intelligence. La factualité s'est aussi améliorée, le taux d'hallucination en effort maximal passant de 92 % à 60 %.
Avantages :
- Bon marché pour un modèle de pointe hébergé : 2 $ / 10 $, et nettement moins cher par tâche accomplie qu'Opus.
- Contexte massif de 1,05M, jeu d'outils Responses complet, et une grande amélioration de la factualité par rapport à 5.6.
- La fiabilité et la posture sur les données d'un laboratoire de pointe américain.
Inconvénients :
- L'intelligence stagne par rapport à la génération précédente, donc si vous vouliez un vrai bond, vous ne le trouverez pas ici.
- Poids fermés et pas de palier gratuit spécifique à Sol.
- Les requêtes à contexte long sont facturées à un palier plus élevé (4 $ / 15 $), la même limite de type 200K que facturent à la fois OpenAI et xAI.
Verdict : GPT-6 Sol est ce qui se rapproche le plus de « l'économie de MiMo avec la fiabilité d'un laboratoire de pointe ». Si vous voulez un modèle hébergé, que la facture totale vous préoccupe et que vous n'avez pas besoin d'un raisonnement de niveau Opus, Sol est le choix valeur par défaut.
7. Gemini 3.8 Flash
Idéal pour : les équipes qui veulent un contexte multimodal massif d'un laboratoire de pointe, à bas coût.
Gemini 3.8 Flash de Google est sorti le 02-09-2026, sa troisième sortie Flash en six semaines. Ce n'est pas un nouveau modèle de base (la fiche le dit quatre fois : il est basé sur 3.7 Flash), ce qui explique pourquoi le prix n'a pas bougé : 0,75 $ en entrée et 3,75 $ en sortie par 1M jusqu'à fin 2026, puis 1,50 $ / 7,50 $ à partir de janvier. Il affiche un Intelligence Index Artificial Analysis de haut niveau à 59 et accepte texte, image, audio, vidéo et PDF en entrée.
Le hic peu rapporté est la réactivité. Artificial Analysis mesure un temps jusqu'au premier token de 13,30 secondes contre une médiane de catégorie de 2,99 secondes, alors même qu'il se classe #3 sur 196 pour la vitesse de sortie brute. Le débit n'est pas la même chose que la latence, ce qui le disqualifie pour tout ce qu'une personne attend en direct, mais convient bien à un agent par lots de nuit. Fait intéressant, Google lui-même conseille aux développeurs axés sur l'efficacité de rester sur 3.7 Flash.
Avantages :
- Index d'intelligence au sommet (59) à un prix vraiment bas pour un modèle de pointe.
- L'entrée multimodale native la plus large de tous les modèles ici, avec un contexte de 1M.
- Un palier gratuit et des remises généreuses par lots et flex.
Inconvénients :
- Lent jusqu'au premier token, donc un mauvais choix pour le chat en direct ou les réponses de support.
- Verbeux (environ 120M de tokens de sortie pour exécuter l'index contre une médiane de 71M), ce qui gonfle la facture réelle.
- Le conseil de Google lui-même est que 3.7 Flash est le choix efficacité, ce qui brouille l'argument de la mise à niveau.
Verdict : Gemini 3.8 Flash est le cheval de trait multimodal par lots. Si votre cas d'usage pour MiMo est intensif en documents, images ou vidéo et fonctionne de manière asynchrone, c'est l'alternative de pointe à battre. Si une personne attend la sortie, cherchez ailleurs.
8. Grok 4.7
Idéal pour : les équipes qui exécutent des boucles d'agents à haut volume et veulent des données X en direct et une qualité quasi-pointe.
Grok 4.7 de xAI a été lancé le 21-09-2026, construit sur un modèle de base plus grand et entraîné pour des tâches agentiques de plusieurs heures. C'est le miroir intéressant de MiMo sur l'index Artificial Analysis : les deux atterrissent à 46, et cette coïncidence de date de lancement explique pourquoi « MiMo mogged Grok » a fait le tour. La tarification est de 2 $ en entrée et 6 $ en sortie par 1M en dessous de 200K tokens de prompt, et 4 $ / 12 $ au-delà, où les tarifs longs s'appliquent à toute la requête.
Le véritable avantage de Grok par rapport aux modèles ouverts ici est son outillage natif : recherche web et X en direct, exécution de code, et une conception ajustée pour de longues exécutions d'agents, plus la pile de sécurité la plus solide qu'xAI ait livrée. Il est quasi-pointe plutôt que leader de la pointe (Fable domine toujours le codage de pointe et le travail terminal), mais son prix est pensé pour tourner réellement à volume.
Avantages :
- Même intelligence AA que MiMo (46) mais avec l'outillage hébergé d'un laboratoire de pointe et la recherche X et web en direct.
- Tarifé pour le volume dans les boucles d'agents à 2 $ / 6 $, avec une pile de sécurité et de refus nouvelle et solide.
- Grandes améliorations en terminal et codage par rapport à Grok 4.6.
Inconvénients :
- Le contexte de 500K est le plus petit du groupe, et la limite de tarification au-delà de 200K s'applique à tous les tokens d'une requête.
- Il perd face à GPT-6 Sol et Fable sur certains benchmarks professionnels comme HealthBench.
- Poids fermés, et pas d'essai à blanc sur historique de tickets pour des tests de type support.
Verdict : Grok 4.7 est le choix « quasi-pointe à volume », surtout si les données X ou web en temps réel font partie du travail. Si vous avez été attiré par le prix de MiMo mais voulez de l'outillage hébergé et pouvez vivre avec un contexte plus petit, c'est un échange équitable.
Ce que tous ces benchmarks ratent
Voici ce que trois années à déployer de l'IA sur des files de support en direct nous ont appris : le modèle est le cadet de nos soucis. Chaque option ci-dessus est un moteur, et un bon moteur n'est pas une voiture terminée. Seul, un modèle brut ne connaît pas votre produit, ne peut pas voir votre helpdesk, ne peut pas effectuer d'action, et ne peut pas être testé en toute sécurité sur votre historique réel avant de parler à un client.
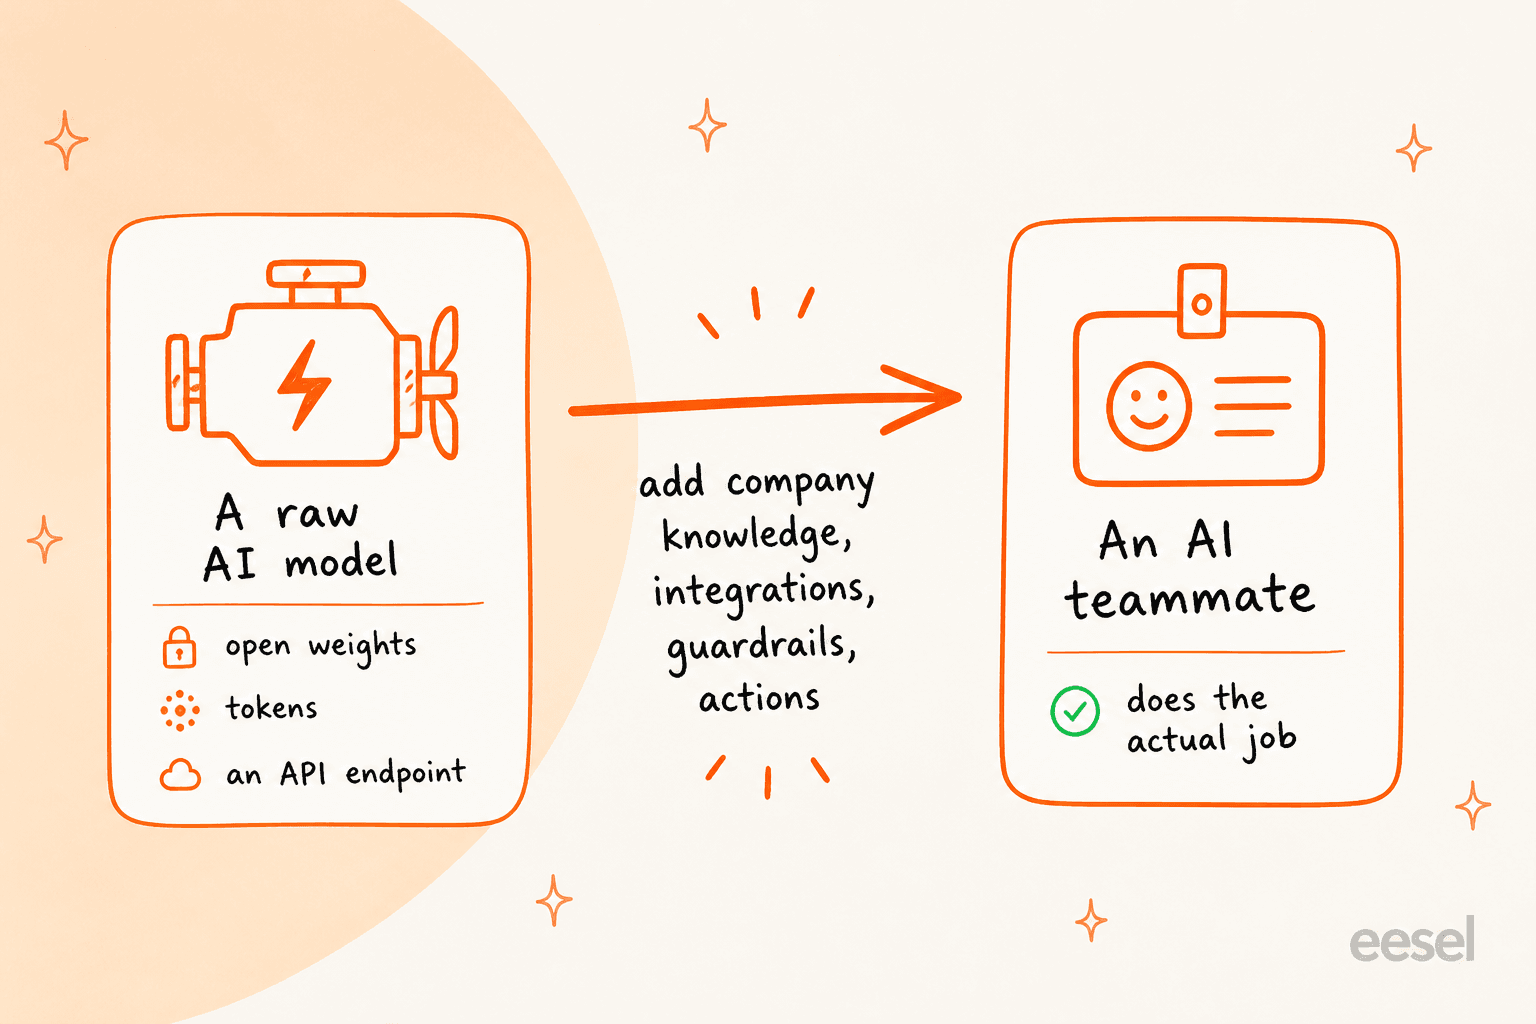
Nous l'avons appris à nos dépens, en voyant un bot au ton assuré donner tranquillement de mauvaises réponses, c'est pourquoi nous simulons désormais chaque déploiement sur des tickets historiques avant sa mise en service. Cet écart entre « un modèle intelligent » et « un coéquipier qui fait le travail » est exactement ce que les benchmarks ne mesurent pas, et c'est là que réside l'essentiel du vrai travail : connecter la connaissance, câbler les intégrations, poser des garde-fous, et prouver d'abord que ça fonctionne sur vos propres données.
La question la plus utile n'est donc souvent pas « quel modèle ? » mais « qui va faire le travail ? ». Si la réponse est votre équipe d'ingénierie, en enveloppant un modèle de tout cela, alors choisissez parmi les huit ci-dessus selon le prix, le plafond et la licence. Si la réponse est « je veux juste le résultat », le modèle devient un détail d'implémentation.
Essayez eesel
eesel travaille à l'autre bout de cette décision. Au lieu de vous remettre un moteur et un projet de construction, il vous donne un coéquipier IA prêt à travailler pour votre helpdesk qui connaît déjà vos intégrations et le contexte de votre entreprise, et laisse le modèle sous-jacent rester interchangeable. C'est tout l'intérêt de la vision « le modèle est une infrastructure » : vous embauchez le coéquipier, pas le moteur.
Concrètement, le coéquipier IA helpdesk rejoint votre file existante en quelques minutes, apprend de vos tickets passés et de votre centre d'aide, et surtout, simule sur votre historique réel de tickets avant de répondre à un client en direct pour la première fois, vous voyez donc la résolution et la qualité projetées à l'avance plutôt que d'actionner un interrupteur en espérant que ça marche. Et comme eesel est conçu pour être piloté de manière programmatique, il existe aussi un eesel CLI complet : vous pouvez piloter le même coéquipier et le même espace de travail depuis un terminal, l'automatiser dans des scripts, ou laisser un agent de codage comme Claude Code ou Cursor le piloter, ce qui est le choix naturel si vous cherchiez de toute façon un modèle brut à scripter.
Si vous évaluez MiMo V2.6 ou l'une de ses alternatives pour alimenter l'automatisation du support, cela vaut la peine d'y jeter un œil avant de vous engager dans une construction. Essayez eesel gratuitement, et laissez le modèle être la partie facile.
Questions fréquentes
Quelle est la meilleure alternative à Xiaomi MiMo V2.6 ?
Existe-t-il des alternatives moins chères à Xiaomi MiMo V2.6 ?
Quelles alternatives à MiMo V2.6 proposent des poids ouverts ?
Xiaomi MiMo V2.6 est-il assez bon pour se passer des alternatives ?
Dois-je absolument choisir un modèle pour automatiser le support ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.