

La réponse courte : ce que coûte vraiment Xiaomi MiMo V2.6
Cela fait deux ans que j'observe les pages de tarifs de l'IA, et la plupart des lancements de modèles enterrent le chiffre qu'on est venu chercher. Xiaomi a fait l'inverse : le 22 septembre 2026, toute la famille MiMo V2.6 a été mise en open source sous licence MIT, et les tarifs de l'API sont restés stables par rapport à la génération précédente.
Il y a donc en réalité deux prix à considérer. Il y a zéro, si vous téléchargez les poids et les exécutez sur votre propre matériel. Et il y a un prix par token via l'API, si vous préférez que quelqu'un d'autre héberge les GPU. Voici la liste complète des tarifs hébergés, d'après OpenRouter, vérifiée le jour du lancement :
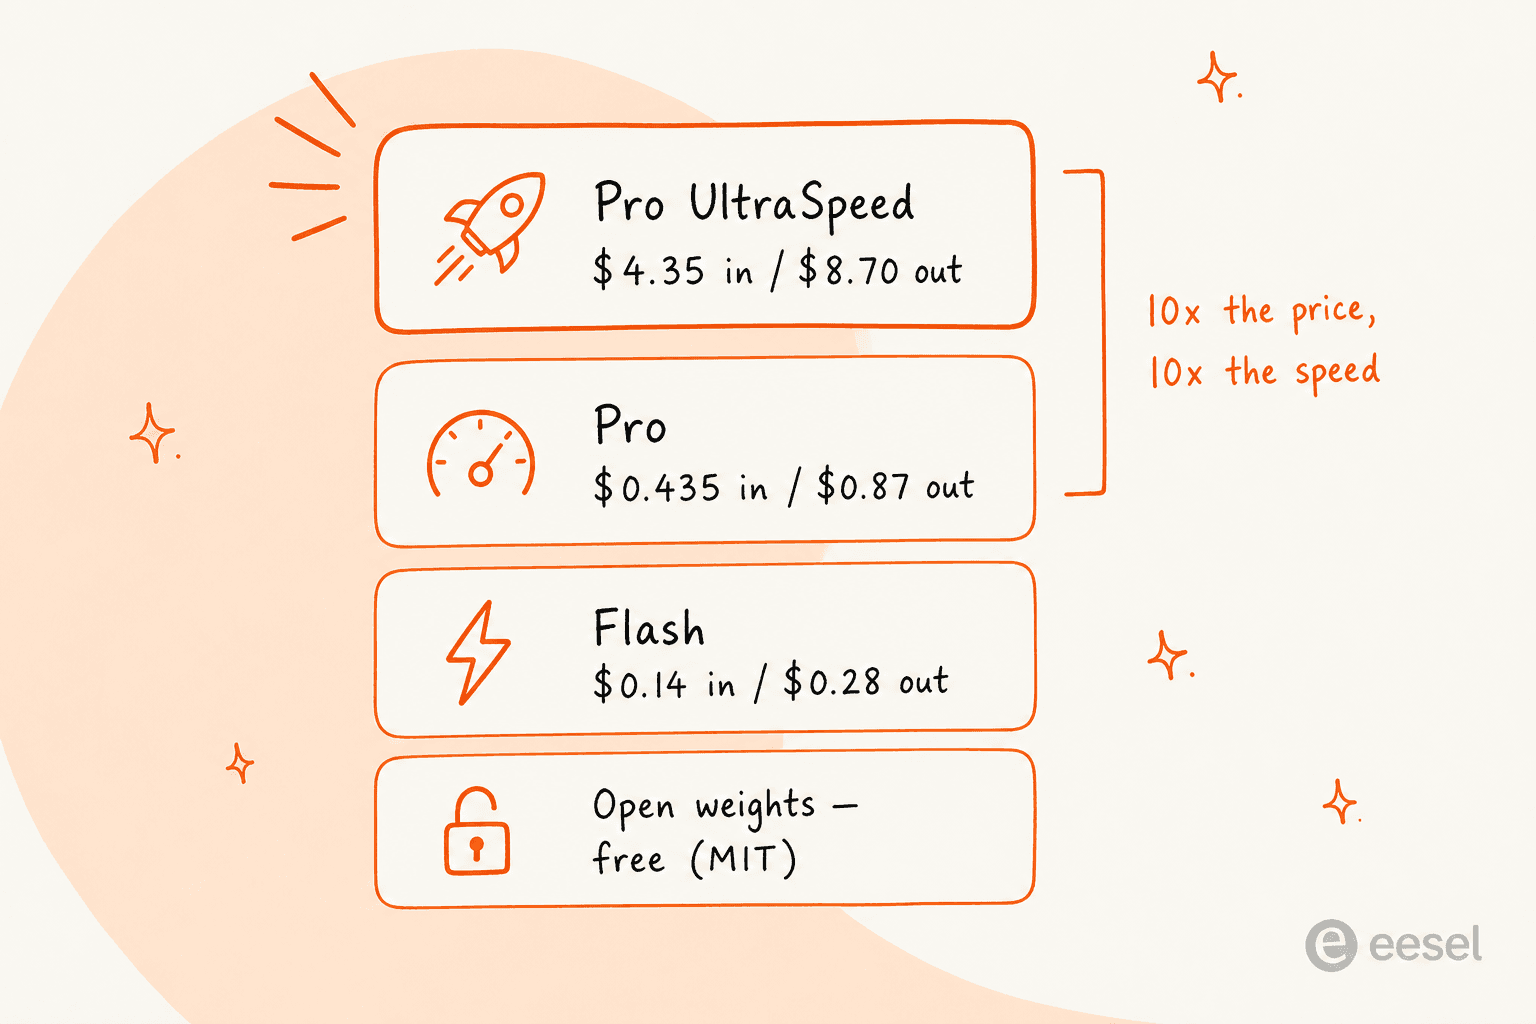
Chaque variante dispose de la même fenêtre de contexte de 1M de tokens et est nativement omnimodale (texte, image, vidéo, audio), donc vous ne payez pas de supplément pour le contexte long ou les modalités supplémentaires. C'est inhabituel, et cela explique en grande partie pourquoi ces tarifs paraissent aussi agressifs.
Les quatre variantes et à quoi chacune sert
MiMo V2.6 n'est pas un modèle unique à un seul prix. C'est une famille de quatre checkpoints, et choisir le mauvais est le moyen le plus rapide de payer trop cher. Voici comment ils se positionnent.
MiMo V2.6 Pro (0,435 $ en entrée / 0,87 $ en sortie)
Pro est le fleuron : un modèle à mélange d'experts épars avec 1,02 billion de paramètres au total et 42 milliards actifs. C'est celui qui domine les benchmarks à poids ouverts, et celui à choisir pour un vrai travail agentique, de la programmation sur le long terme, un usage d'outils en plusieurs étapes. À 0,435 $ en entrée / 0,87 $ en sortie, il est moins cher que la plupart des modèles fermés de pointe auxquels il se mesure, ce qui résume toute l'histoire de cette sortie.
MiMo V2.6 Flash (0,14 $ en entrée / 0,28 $ en sortie)
Flash est le checkpoint d'efficacité : 309 milliards au total, 15 milliards actifs, décrit par Xiaomi comme le meilleur équilibre entre intelligence, efficacité et coût. À 0,14 $ en entrée / 0,28 $ en sortie, il coûte un tiers du prix de Pro et, selon les propres chiffres de Xiaomi, ne perd étonnamment que peu en performance. Sur AutomationBench, il obtient 52,3 contre 53,1 pour Pro. Pour la plupart des tâches à gros volume et bien délimitées, Flash est le choix le plus rentable.
MiMo V2.6 Pro UltraSpeed (4,35 $ en entrée / 8,70 $ en sortie)
UltraSpeed prête à confusion jusqu'à ce qu'on réalise qu'on n'achète pas plus d'intelligence. C'est exactement le même checkpoint Pro, servi à environ 10 fois la vitesse de sortie (environ 116 tokens par seconde). Xiaomi facture 10 fois le tarif Pro pour cela. C'est donc une taxe pure sur la latence : à payer uniquement quand la vitesse est réellement le goulot d'étranglement, comme un agent de chat en direct qu'un client regarde taper. Pour un traitement par lots exécuté de nuit, c'est 10 fois de l'argent gaspillé.
MiMo V2.6 Distill-Qwen-9B (poids gratuits uniquement)
Le distill 9B est un ajustement fin supervisé dense de Qwen3.5-9B sur des données générées par MiMo. Il n'est pas disponible sur l'API payante ; il existe comme point de départ compact, mono-GPU, pour l'inférence locale et la recherche ouverte. Des quantifications GGUF communautaires existent déjà pour llama.cpp, LM Studio et Ollama, c'est donc celui qu'on peut exécuter sur une station de travail.
La réduction sur le cache que presque tout le monde manque
Les tarifs affichés ci-dessus ne sont pas ce que paient réellement les gros utilisateurs. MiMo V2.6 Pro affiche les tokens de lecture en cache à environ 0,0036 $ par million, soit une réduction de 99 % sur le tarif d'entrée de 0,435 $. Le partenaire de benchmark de Xiaomi l'a résumé ainsi :
"Despite the improvement, it retains the same attractive pricing at $0.435 per 1M input tokens (with a 99% cache-hit discount) and $0.87 per 1M output tokens."
Pourquoi cela compte-t-il pour le prix ? Parce que toute charge de travail réelle envoie encore et encore le même contexte. Un agent de programmation relit le même dépôt. Un agent de support relit les mêmes politiques et macros à chaque ticket. Une fois ce contexte mis en cache, vous ne payez plus que des centimes pour les tokens d'entrée. Si votre cas d'usage réutilise les prompts, votre prix d'entrée effectif est bien inférieur au tarif affiché, et c'est cet écart qui fait vraiment décrocher le coût total de MiMo par rapport à la pointe du marché.
Comment les tarifs de MiMo V2.6 se comparent à la pointe du marché
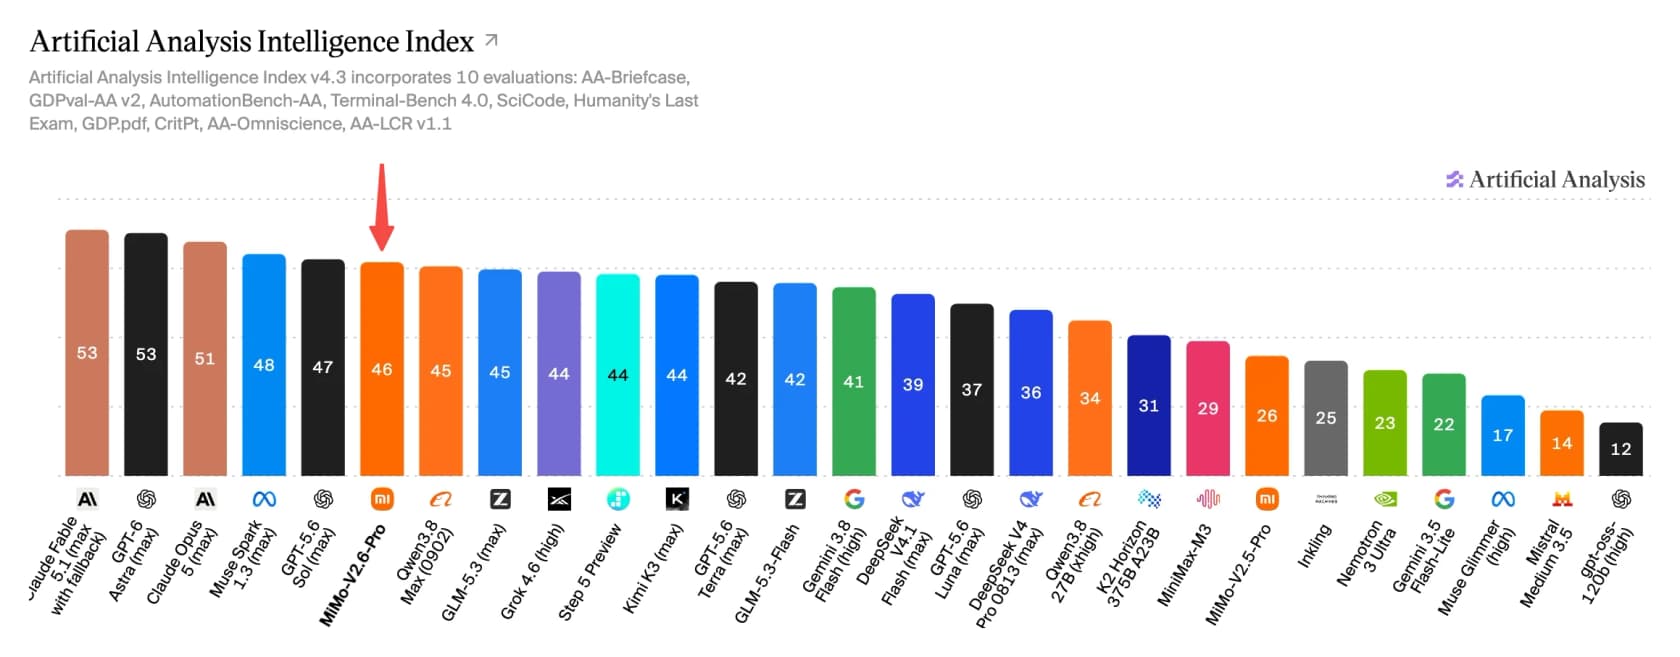
C'est la comparaison pour laquelle ce lancement a été conçu. Sur l'indice d'intelligence d'Artificial Analysis, MiMo V2.6 Pro a obtenu un score de 46, le meilleur modèle à poids ouverts, à égalité avec Grok 4.7 sorti le même jour, et juste derrière les leaders fermés.
Le score seul ne raconte pas toute l'histoire du prix. Le graphique qui compte pour le coût est celui de l'intelligence par rapport au coût par tâche, où MiMo V2.6 Pro se situe dans le "quadrant le plus attractif", en vert, à environ 0,13 $ par tâche, tandis que Claude Opus 5 et GPT-6 Astra se trouvent à l'extrémité 3 $ à 8 $ du même axe.
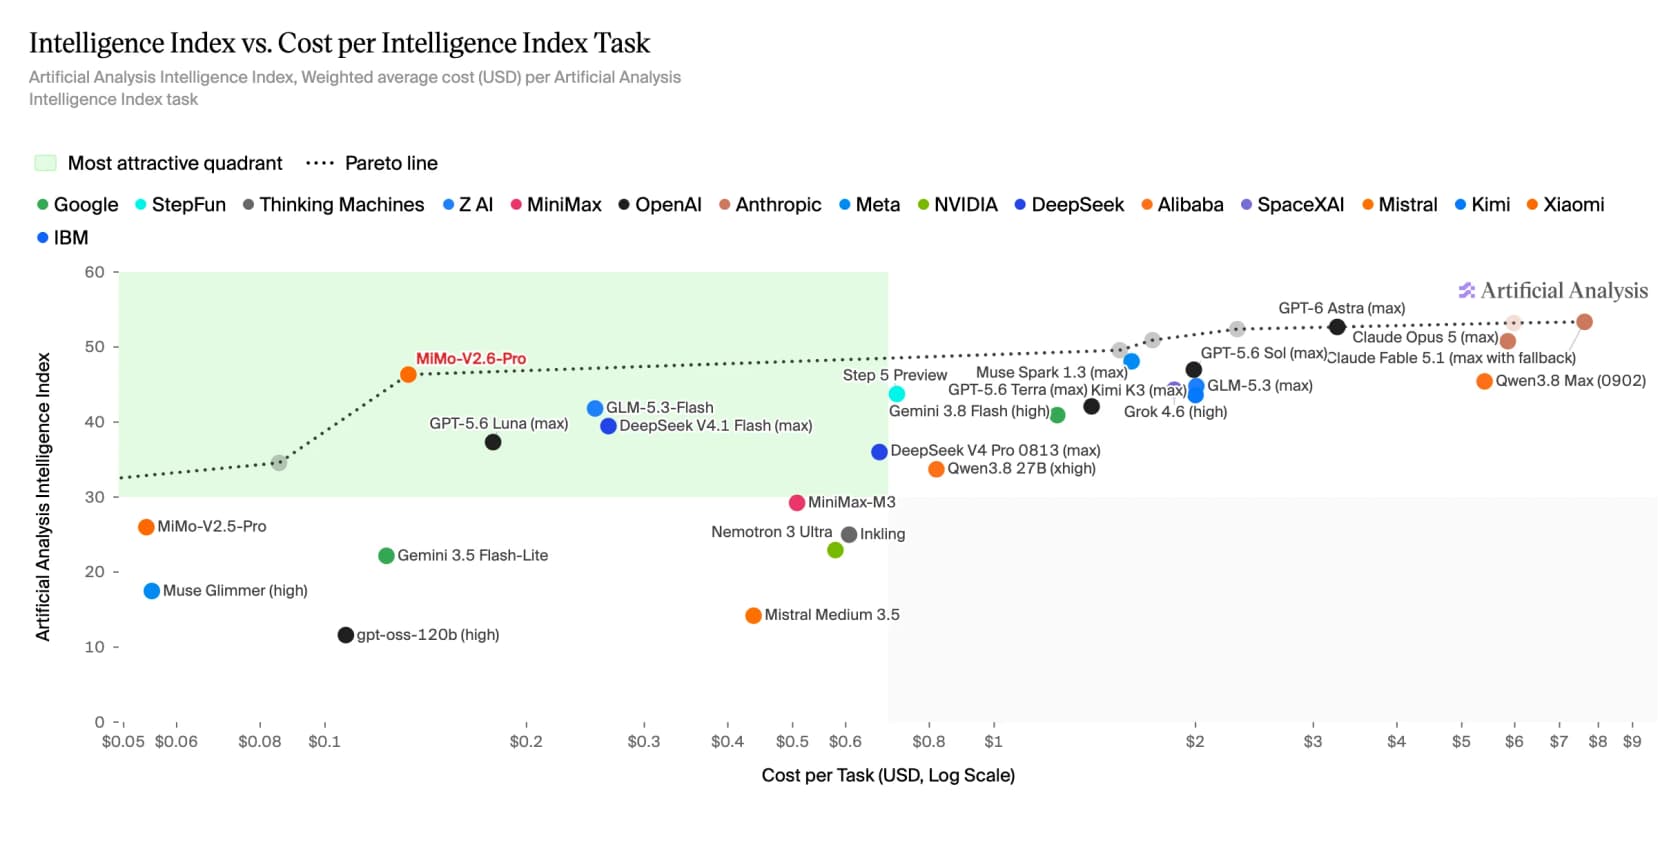
Face au champ des modèles ouverts, c'est tout aussi tranchant. Flash égale les niveaux les moins chers comme DeepSeek V4.1 Flash, et le Pro de 1,02 billion devance le bien plus grand Kimi K3, à 2,8 billions, tout en le dominant sur la plupart des classements. Un commentateur de Hacker News, qui avait beaucoup utilisé le modèle, a résumé le calcul de valeur ainsi :
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."

Précision honnête, car un article sur les tarifs se doit d'être clair sur les limites : MiMo est en retard sur les meilleurs modèles fermés dans les classements les plus difficiles. Sur Terminal Bench 4.0, il obtient 34,9 contre 59,6 pour GPT-6 Astra, et sur ExploitBench il atteint 47,9 contre plus de 70 pour GPT-5.6 Sol et Claude. Si votre travail se situe sur ces terrains d'excellence, le prix bas du token ne fait pas toute la décision. Pour tout le reste, le rapport qualité-prix est difficile à contester.
Exemples chiffrés : ce que vous paieriez réellement
Les tarifs par million de tokens sont abstraits. Voici ce que coûteraient trois charges de travail réalistes sur MiMo V2.6, pour que les chiffres prennent tout leur sens.
- Un développeur indépendant sur Flash. Disons que vous consommez 20M de tokens en entrée et 5M en sortie par mois en codant avec Flash. Cela donne 20 × 0,14 $ + 5 × 0,28 $ = 4,20 $ par mois. Une erreur d'arrondi.
- Une petite équipe faisant tourner un agent de programmation sur Pro. 300M en entrée, 80M en sortie par mois sur Pro : 300 × 0,435 $ + 80 × 0,87 $ = 200,10 $ par mois, avant toute réduction de cache. Avec une forte réutilisation des prompts, la facture réelle se situe bien en dessous.
- Une charge de travail de support à gros volume sur Flash. 10 000 tickets par mois, environ 8K en entrée et 1K en sortie chacun, soit 80M en entrée et 10M en sortie : 80 × 0,14 $ + 10 × 0,28 $ = 14 $ par mois en tokens bruts.
Ce dernier chiffre mérite qu'on s'y attarde. Dix mille conversations de support pour 14 $ de tokens de modèle. Si c'était le vrai coût du support par IA, tout le monde l'aurait déployé depuis des années. Ce n'est pas le cas, et l'écart entre "14 $ de tokens" et "un agent de support qui fonctionne" est exactement le sujet de la section suivante.
Les poids gratuits ne coûtent pas rien à faire tourner
MiMo V2.6 est véritablement ouvert sous licence MIT, donc "hébergez-le vous-même" est un conseil réel, pas du marketing. Mais le fait que les poids soient gratuits ne rend pas leur exécution gratuite. La facture matérielle est le poste caché.
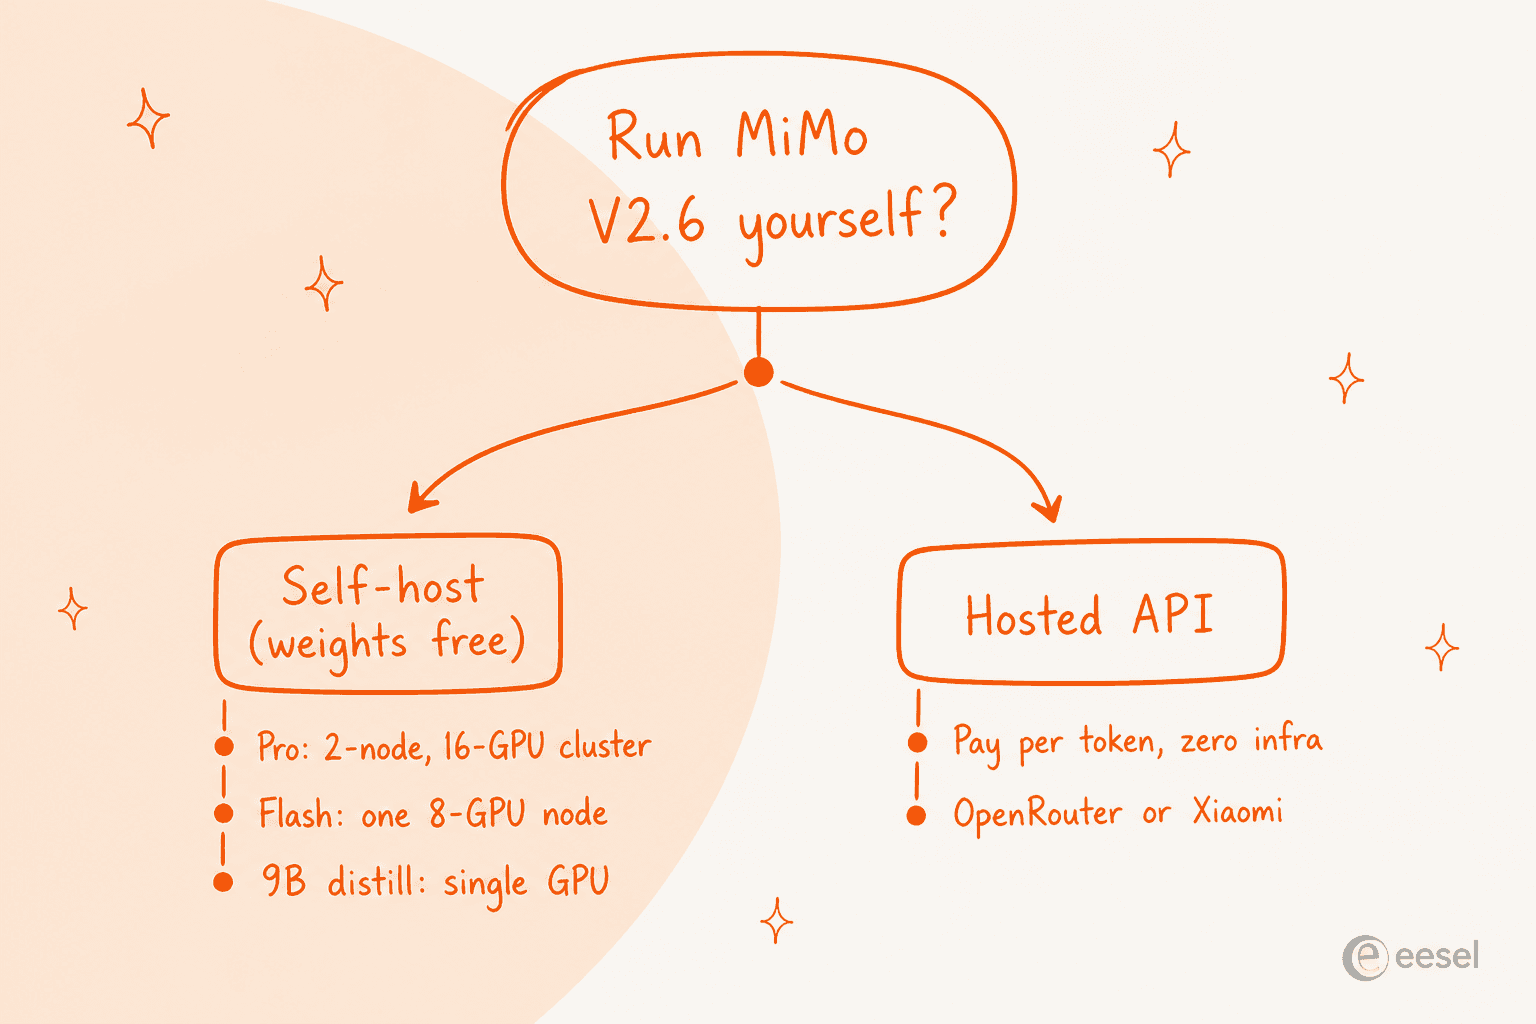
Voici ce dont chaque variante a besoin, selon les fiches du modèle :
- Pro (1,02T / 42B actifs) : le lancement de référence sur SGLang utilise un cluster de 2 nœuds, 16 GPU (tensor-parallèle 16). C'est un engagement matériel sérieux.
- Flash (309B / 15B actifs) : fonctionne sur un seul nœud à 8 GPU.
- Distill-Qwen-9B : assez petit pour un seul GPU, et des quantifications GGUF existent déjà pour les outils locaux.
Tous les checkpoints sont livrés en FP8, ce qui garde l'empreinte mémoire raisonnable, mais la lecture honnête est celle-ci : l'auto-hébergement ne bat l'API que lorsque vous avez un volume élevé et constant et des GPU inactifs à remplir. Pour un volume irrégulier ou faible, l'API hébergée à 0,14 $ - 0,87 $ par million de tokens est presque toujours moins chère que de garder un cluster allumé en permanence. Calculez votre propre taux d'utilisation avant de supposer que "poids gratuits" signifie "gratuit".
La partie que l'étiquette de prix ne montre jamais
C'est ici que je dois prendre du recul, car je construis et exploite de l'IA pour le support client dans la vraie vie, et la conversation sur les tarifs passe presque toujours à côté de la vraie facture.
Le coût en tokens de MiMo V2.6, ou de DeepSeek, ou de Qwen, ou de n'importe lequel d'entre eux, est la ligne budgétaire la plus petite d'un système en production. La partie coûteuse, c'est tout ce qui entoure le modèle.
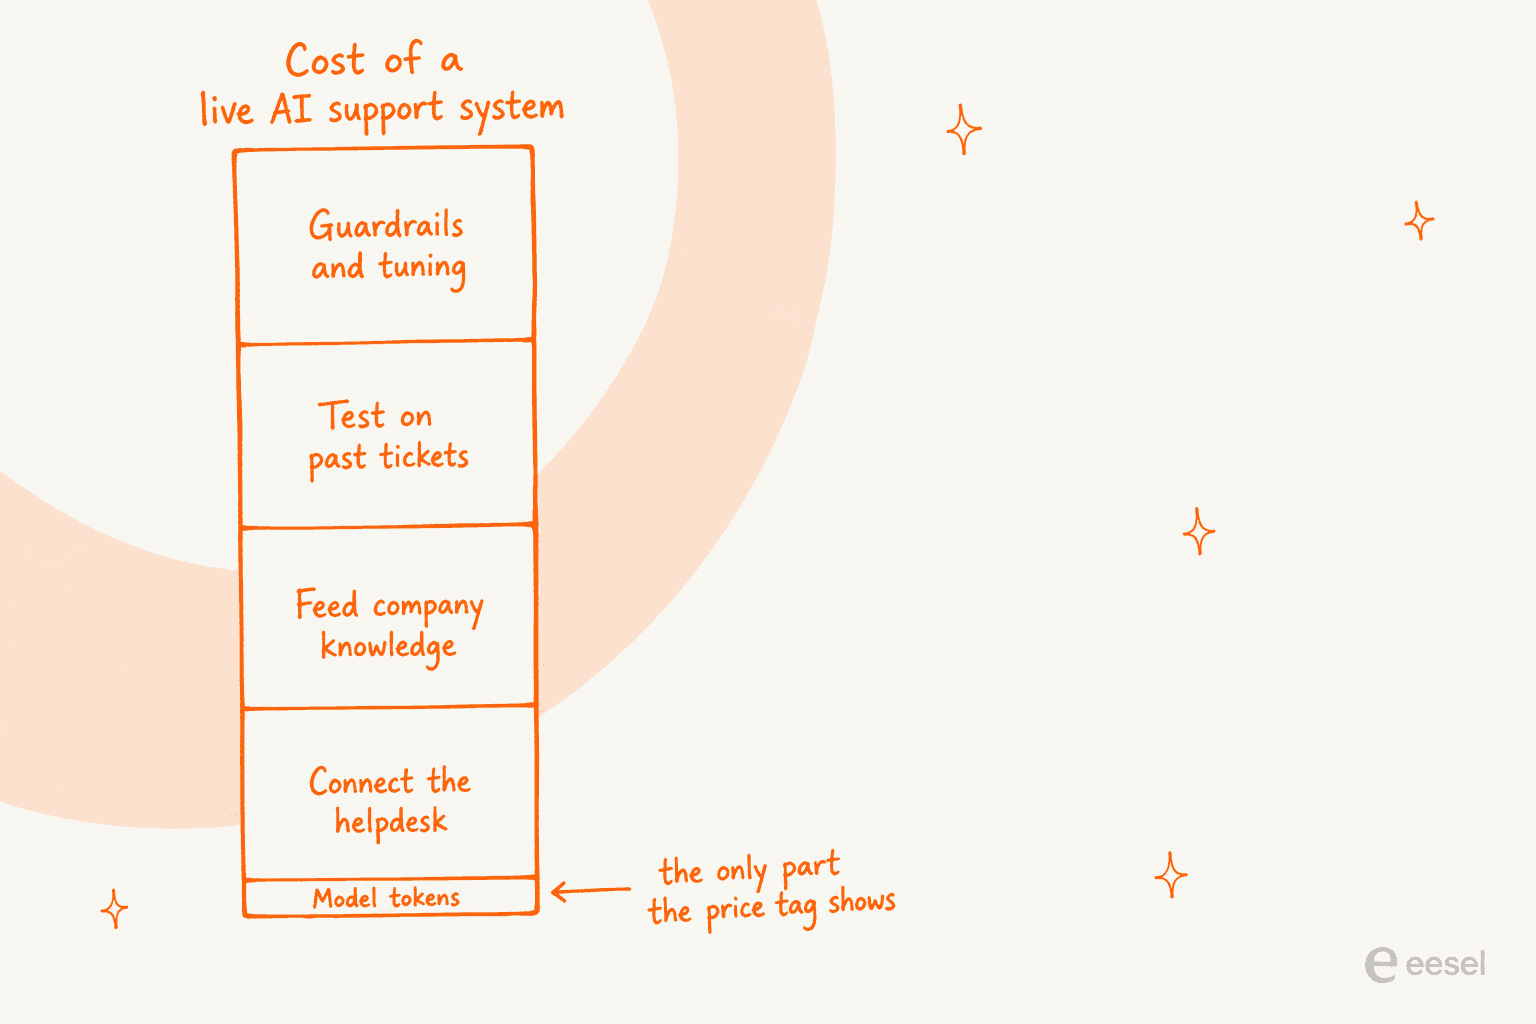
Nous avons passé ces dernières années à déployer des agents IA sur des files de support en direct, et la leçon récurrente est qu'un modèle brut, aussi bon marché et intelligent soit-il, n'est pas un agent de support. Pour passer de "14 $ de tokens" à "un agent en qui j'ai confiance face à un client", il faut le connecter à votre helpdesk, le nourrir avec votre base de connaissances et vos anciens tickets, lui enseigner vos politiques, lui donner des actions qu'il peut effectuer en toute sécurité, et surtout, le tester avant sa mise en production. Nous avons vu des bots au ton assuré donner silencieusement de mauvaises réponses, c'est exactement pourquoi tout déploiement devrait d'abord être simulé sur des tickets historiques.
Rien de tout cela n'apparaît sur une page de tarifs OpenRouter. C'est la différence entre un modèle et un coéquipier qui fonctionne, et c'est là que se trouve le véritable coût du support client par IA.
Essayer eesel
Un modèle comme MiMo V2.6 est un moteur. eesel est le coéquipier que vous engagez pour le conduire. eesel est une plateforme de coéquipiers IA, et l'agent de support client par IA est un coéquipier de support prêt à travailler : il se connecte à votre helpdesk en quelques minutes, lit déjà vos anciens tickets et votre base de connaissances, et vous pouvez le simuler sur des milliers de vos conversations historiques réelles avant qu'il ne réponde à un seul client en direct. Plutôt que de facturer un tarif fixe par poste, eesel facture à l'usage, de sorte que le coût suit le travail réellement effectué.

Et si vous vivez dans un terminal, eesel dispose d'une CLI publique ainsi que d'un serveur MCP, de sorte que le même coéquipier et le même espace de travail que vous gérez dans le tableau de bord peuvent être pilotés depuis des scripts ou par des agents de programmation comme Claude Code, Codex et Cursor. C'est la façon la plus adaptée aux agents d'exploiter eesel : une personne le manipule à la main, un script l'automatise, ou un agent IA l'appelle, le tout face au même coéquipier de support. C'est cette couche qui transforme un modèle bon marché et capable en quelque chose qui résout réellement des tickets. Essayez gratuitement.
Questions fréquentes
Combien coûte Xiaomi MiMo V2.6 ?
Quel est le moyen le moins cher d'utiliser Xiaomi MiMo V2.6 ?
Xiaomi MiMo V2.6 est-il gratuit ?
Qu'est-ce que MiMo V2.6 Pro UltraSpeed, et pourquoi coûte-t-il 10 fois plus cher ?
Xiaomi MiMo V2.6 propose-t-il une réduction sur le cache ?
Devrais-je utiliser Xiaomi MiMo V2.6 pour le support client ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.







Comment les tarifs de Xiaomi MiMo V2.6 se comparent-ils à DeepSeek et Kimi K3 ?