En bref
Xiaomi a mis en open source MiMo V2.6 le 22 septembre 2026, et après avoir lu les fiches modèles, la discussion autour du lancement et les chiffres indépendants, mon verdict est simple : c'est actuellement le meilleur rapport qualité-prix parmi les modèles à poids ouverts, pas le modèle le plus intelligent du marché.
Le porte-étendard Pro trône en tête de l'Artificial Analysis Intelligence Index des poids ouverts (46) pour environ 0,13 $ par tâche, tandis que la frontière fermée obtient des scores entre le début et le milieu des 50 pour 3 à 8 $. Il devance Claude Opus 5 et GPT-5.6 Sol sur certains classements agentiques et accuse un net retard sur les benchmarks de codage les plus difficiles. Il est sous licence MIT, omnimodal, et propose un contexte de 1M de tokens.
Si vous choisissez un modèle pour un flux de support, la vraie conclusion à laquelle je reviens toujours est celle-ci : le modèle est désormais la partie bon marché. MiMo, DeepSeek, Qwen et Kimi K3 sont tous suffisamment bons. Tout ce qui entoure le modèle — et un outil comme eesel — est là où se trouve le vrai travail.
Comment j'ai évalué ce modèle
Je passe mes journées sur l'intention de recherche et le regard de bâtisseur de produit derrière le marketing, donc ma méthode pour un lancement comme celui-ci est volontairement ennuyeuse. J'ai sauté la page presse de Xiaomi et je suis allé directement aux fiches modèles sur Hugging Face, j'ai recoupé les scores avec l'index indépendant d'Artificial Analysis, puis j'ai lu environ 670 commentaires sur les fils de lancement, de tableau de bord d'entraînement et d'analyse des prix sur Hacker News pour voir ce que rapportaient réellement les gens qui utilisent le modèle en conditions réelles.
Je n'ai pas passé un an à vivre avec MiMo comme je le fais avec les outils que je construis au quotidien, donc je préciserai clairement où je relaie la recherche plutôt qu'un usage vécu. Cette distinction compte pour un modèle vieux de quelques jours à peine, et la plupart des « avis » qui apparaissent quelques heures après un lancement l'omettent discrètement.
Ce qu'est vraiment MiMo V2.6
MiMo V2.6 est une famille de modèles de langage à poids ouverts, nativement omnimodaux, de l'équipe MiMo de Xiaomi, lancée le 22 septembre 2026. « Nativement omnimodal » mérite sa place ici : le même modèle traite le texte, les images, la vidéo et l'audio, plutôt que de greffer un adaptateur visuel sur un modèle textuel. Chaque checkpoint embarque une fenêtre de contexte de 1M de tokens sous licence MIT.
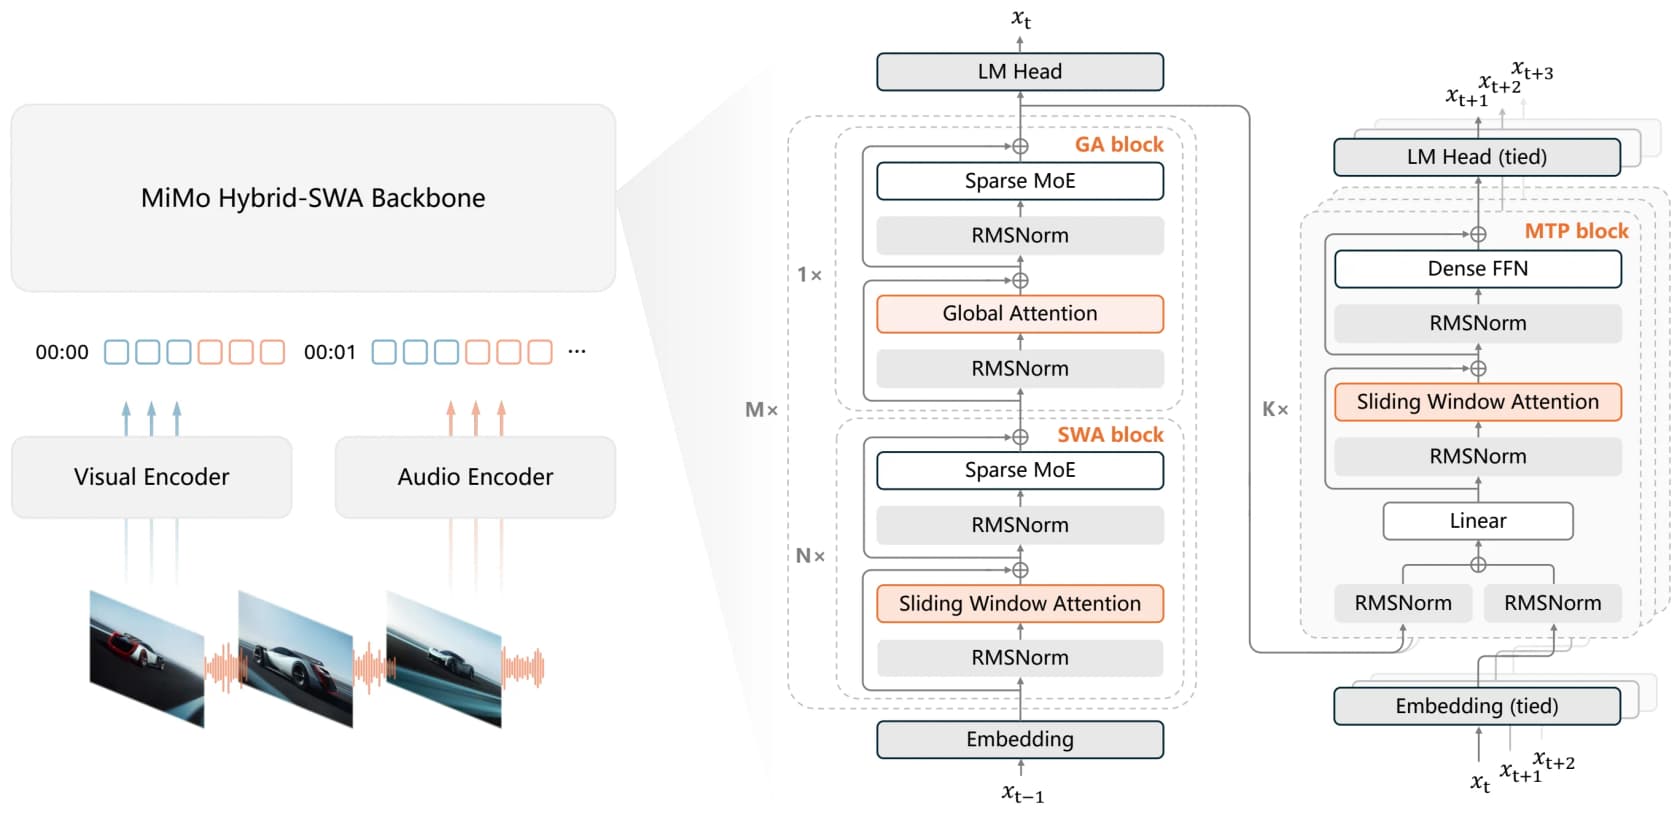
Le résumé de bâtisseur en un paragraphe : Pro est un mélange d'experts épars, avec 1,02T de paramètres au total mais seulement 42B actifs par token, avec un socle d'attention hybride (70 couches alternant fenêtre glissante locale et attention globale), 384 experts routés dont 8 s'activent par token, un encodeur visuel de 681M, des encodeurs audio, et un décodeur à prédiction multi-token à 5 couches. Vous n'avez besoin de rien de tout cela pour l'utiliser, mais cela explique comment un modèle « à mille milliards de paramètres » reste bon marché : c'est le nombre de paramètres actifs, pas le total, que vous payez à l'usage.
Il est livré en quatre checkpoints, d'où vient d'ailleurs une bonne partie de la confusion en ligne :
| Modèle | Paramètres totaux | Paramètres actifs | Contexte | Idéal pour |
|---|---|---|---|---|
| MiMo V2.6 Pro | 1,02T | 42B | 1M | Le travail agentique le plus exigeant à long terme |
| MiMo V2.6 Flash | 309B | 15B | 1M | Le meilleur équilibre entre intelligence, vitesse et coût |
| MiMo V2.6 Pro UltraSpeed | ~1T | 42B | 1M | La qualité Pro quand vous avez besoin d'une sortie rapide |
| MiMo V2.6 Distill-Qwen-9B | 9B | 9B | n/a | Usage sur un seul GPU et recherche agentique-RL ouverte |
Flash est celui vers lequel la plupart des gens se tourneront. UltraSpeed est le même checkpoint Pro servi avec une sortie environ 10x plus rapide pour 10x le prix, donc c'est une surprime de latence, pas un modèle plus intelligent. La distillation 9B est un ajustement supervisé de Qwen3.5-9B sur des données générées par MiMo, un point de départ pour la recherche plutôt que pour la production.
Les benchmarks, lus honnêtement
Chaque lancement trie ses graphiques sur le volet, alors je suis allé voir le tableau d'évaluation de la fiche modèle et je l'ai divisé en victoires et défaites. Il faut reconnaître à Xiaomi qu'il publie les deux.
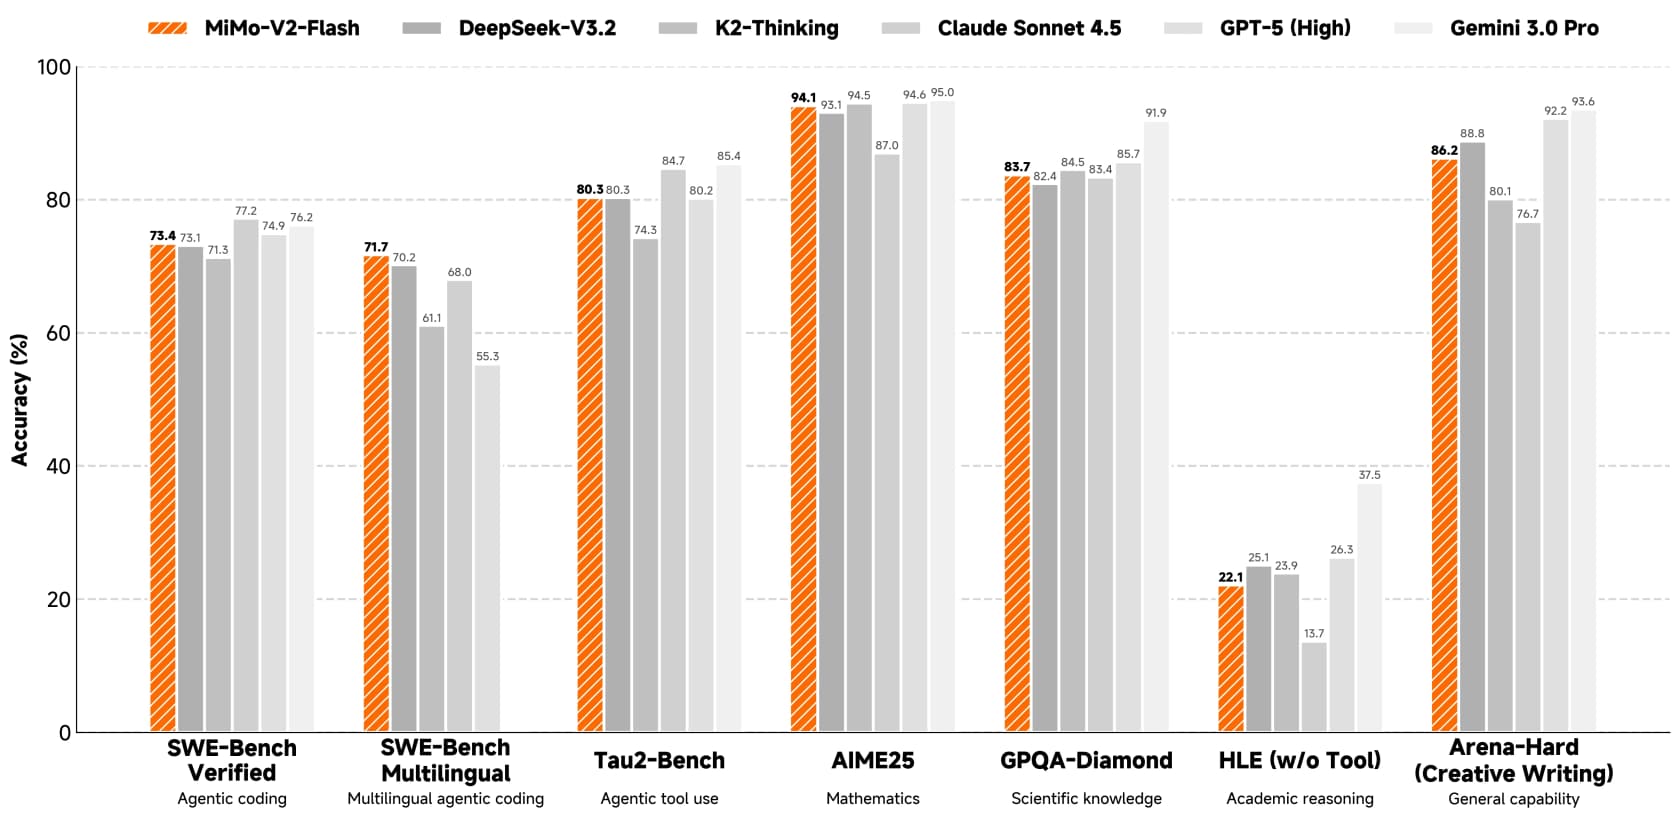
Là où Pro devance la frontière fermée selon les chiffres de Xiaomi :
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53,1 | 50,3 | 45,8 |
| Terminal Bench 2.1 | 89,9 | 89,1 | 88,8 |
| Agents' Last Exam | 31,6 | 31,6 | 30,8 |
| CyberGym | 94,0 | - | - |
Et là où il accuse un retard, ce que le classement Terminal Bench 4.0 montre clairement :
| Benchmark | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 74,0 | 73,0 |
| ProgramBench | 26,5 | 37,0 | 25,0 |
| Terminal Bench 4.0 | 34,9 | 49,0 | 39,9 |
| ExploitBench | 47,9 | 70,0 | 78,5 |
Le schéma est cohérent et, je pense, crédible : Pro est au coude-à-coude avec la frontière sur les tâches générales agentiques et d'usage d'outils, et retombe derrière sur les benchmarks de codage et d'exploitation les plus difficiles à long terme. Quand Xiaomi a élargi la comparaison à GPT-6 Astra, le même schéma s'est maintenu : Pro se hisse près du sommet sur AutomationBench et Terminal Bench 2.1, et derrière Astra sur Terminal Bench 4.0 (59,6).
Le bond générationnel est ce qui m'a réellement impressionné. Le précédent MiMo V2.5 Pro obtenait 19,0 sur DeepSWE v1.1 ; V2.6 Pro obtient 71,9. Sur Terminal Bench 4.0, il est passé de 1,5 à 34,9. Ce n'est pas incrémental, c'est le genre de bond qu'on ne voit que lorsqu'un laboratoire change son approche d'entraînement.
Un chiffre mérite un signal d'alerte plutôt qu'une ovation. Pro affiche 94,0 sur CyberGym là où V2.5 plafonnait à 40,0, mais l'ExploitBench, plus adversarial, raconte une histoire plus modeste avec 47,9. Je lirais le résultat de CyberGym comme impressionnant, pas comme définitivement acquis.
Le calcul de valeur est la vraie histoire
Les classements pris isolément sont bruités. Le chiffre que je surveille vraiment est l'index agrégé d'Artificial Analysis, parce qu'il combine de nombreuses évaluations en un score comparable et le compare au coût.
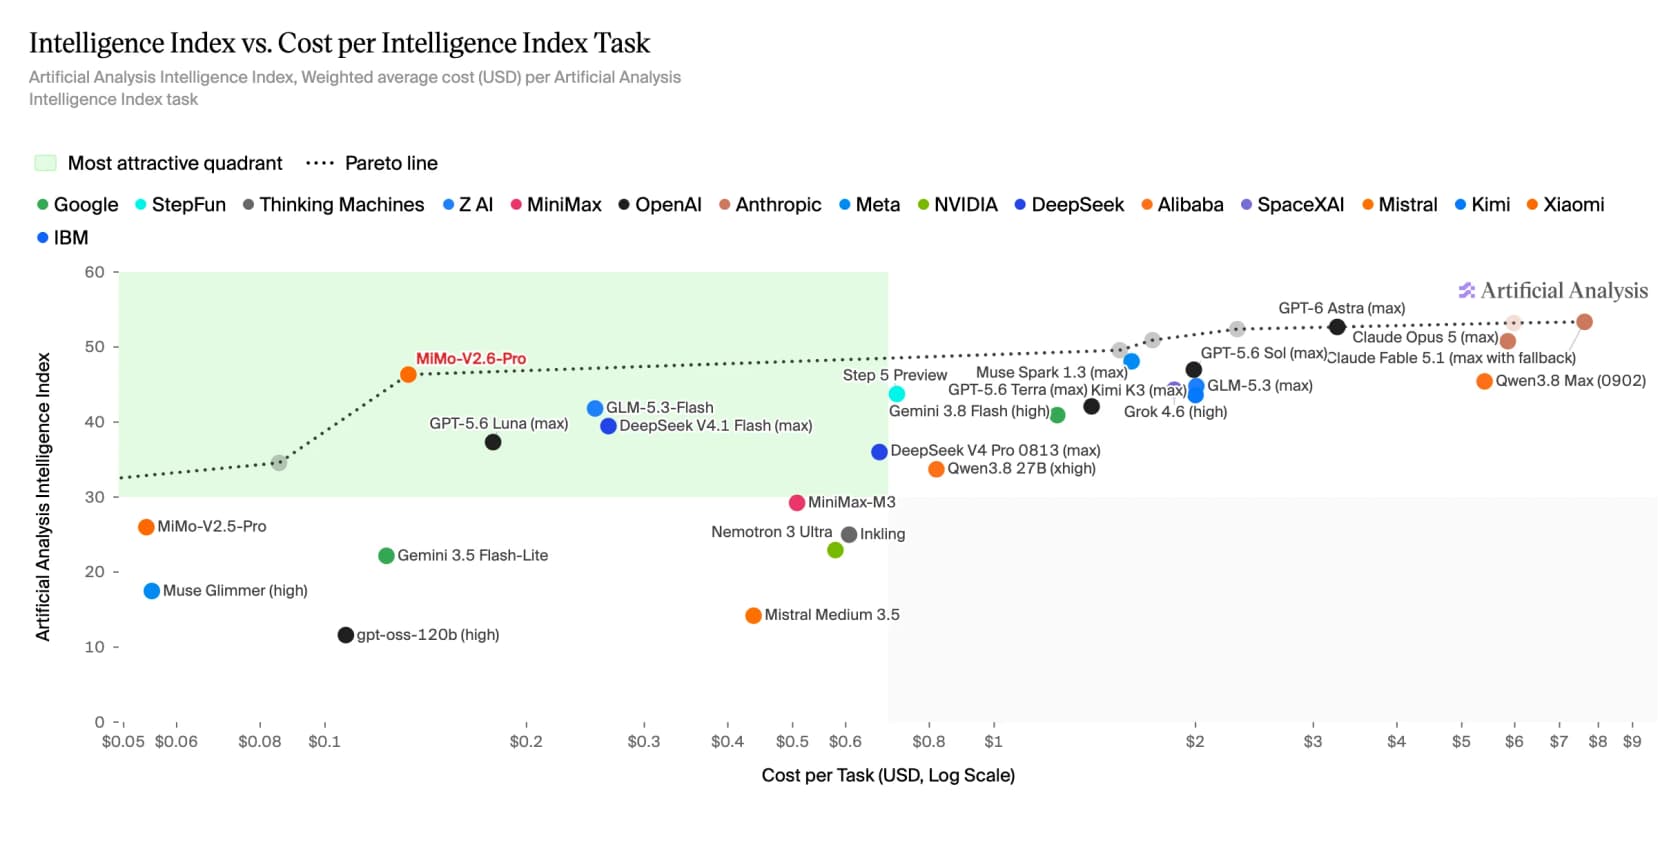
MiMo V2.6 Pro atteint un Intelligence Index de 46, le meilleur modèle à poids ouverts du marché, exactement dans ce qu'Artificial Analysis appelle littéralement le « quadrant le plus attractif ». La frontière fermée obtient des scores plus élevés en intelligence brute (Astra, Opus 5 et Fable 5.1 se situent entre le début et le milieu des 50), mais à 3-8 $ par tâche. MiMo atteint son 46 pour environ 0,13 $.
Ce ratio prix-intelligence est tout l'argument de vente. Voici les tarifs hébergés OpenRouter, par million de tokens, vérifiés la semaine du lancement :
| Modèle | Entrée / 1M | Sortie / 1M | Contexte |
|---|---|---|---|
| MiMo V2.6 Flash | 0,14 $ | 0,28 $ | 1M |
| MiMo V2.6 Pro | 0,435 $ | 0,87 $ | 1M |
| MiMo V2.6 Pro UltraSpeed | 4,35 $ | 8,70 $ | 1M |
Flash, à 0,14 $ en entrée / 0,28 $ en sortie, est remarquablement bon marché pour un modèle omnimodal avec un contexte de 1M. Pour la plupart des équipes, Flash est le choix par défaut et Pro celui vers lequel on monte en gamme.
Quel checkpoint MiMo V2.6 vous convient
La gamme à quatre checkpoints est de loin la chose la plus déroutante de ce lancement, voici donc un outil de décision rapide. Répondez aux trois questions et il vous indiquera le bon checkpoint (ou vous détournera complètement de MiMo).
Ce qu'en ont dit ceux qui l'ont vraiment utilisé
Les benchmarks, c'est l'histoire de Xiaomi ; je voulais l'histoire des utilisateurs. La réaction dominante sur le fil de lancement ne portait pas du tout sur les scores. Elle portait sur la transparence de Xiaomi lors de l'entraînement du modèle.
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
Ce détail sur l'abandon d'un jeu de données cyber parce qu'il nuisait aux scores de codage est le genre de chose que les laboratoires n'admettent presque jamais, et c'est en grande partie pour cela que le lancement a séduit même les sceptiques. La lecture technique la plus pointue est venue d'un utilisateur de longue date de MiMo qui a décompté les classements à la main :
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
Ce n'était pas que des éloges. L'inquiétude qui accompagne tout modèle ouvert puissant venu de Chine, c'est le benchmaxxing : de superbes scores et un travail réel décevant :
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
Le contrepoids est venu de gens qui font déjà tourner la gamme en production. La réflexion sur le rapport qualité-prix est celle qui me trotte le plus dans la tête, même si elle porte sur le précédent V2.5, que plusieurs personnes ont aussi qualifié de rapide mais bête sur les tâches difficiles :
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
Sur X, le lancement a surtout été lu comme une pique envoyée à Grok 4.7, sorti le même jour, avec des réactions allant de « Better than Grok 4.7 » à un mesuré « let's wait for real-world test performance first. » Cette réserve sur les conditions réelles est la bonne, et c'est exactement pour cela que la réputation de V2.5, « rapide mais bête sur les tâches difficiles », est la barre que V2.6 doit franchir dans l'usage quotidien, pas seulement dans les graphiques.
Mon verdict : le meilleur rapport qualité-prix en poids ouverts, pas le modèle le plus intelligent
Voici où j'en arrive après une semaine avec la recherche.
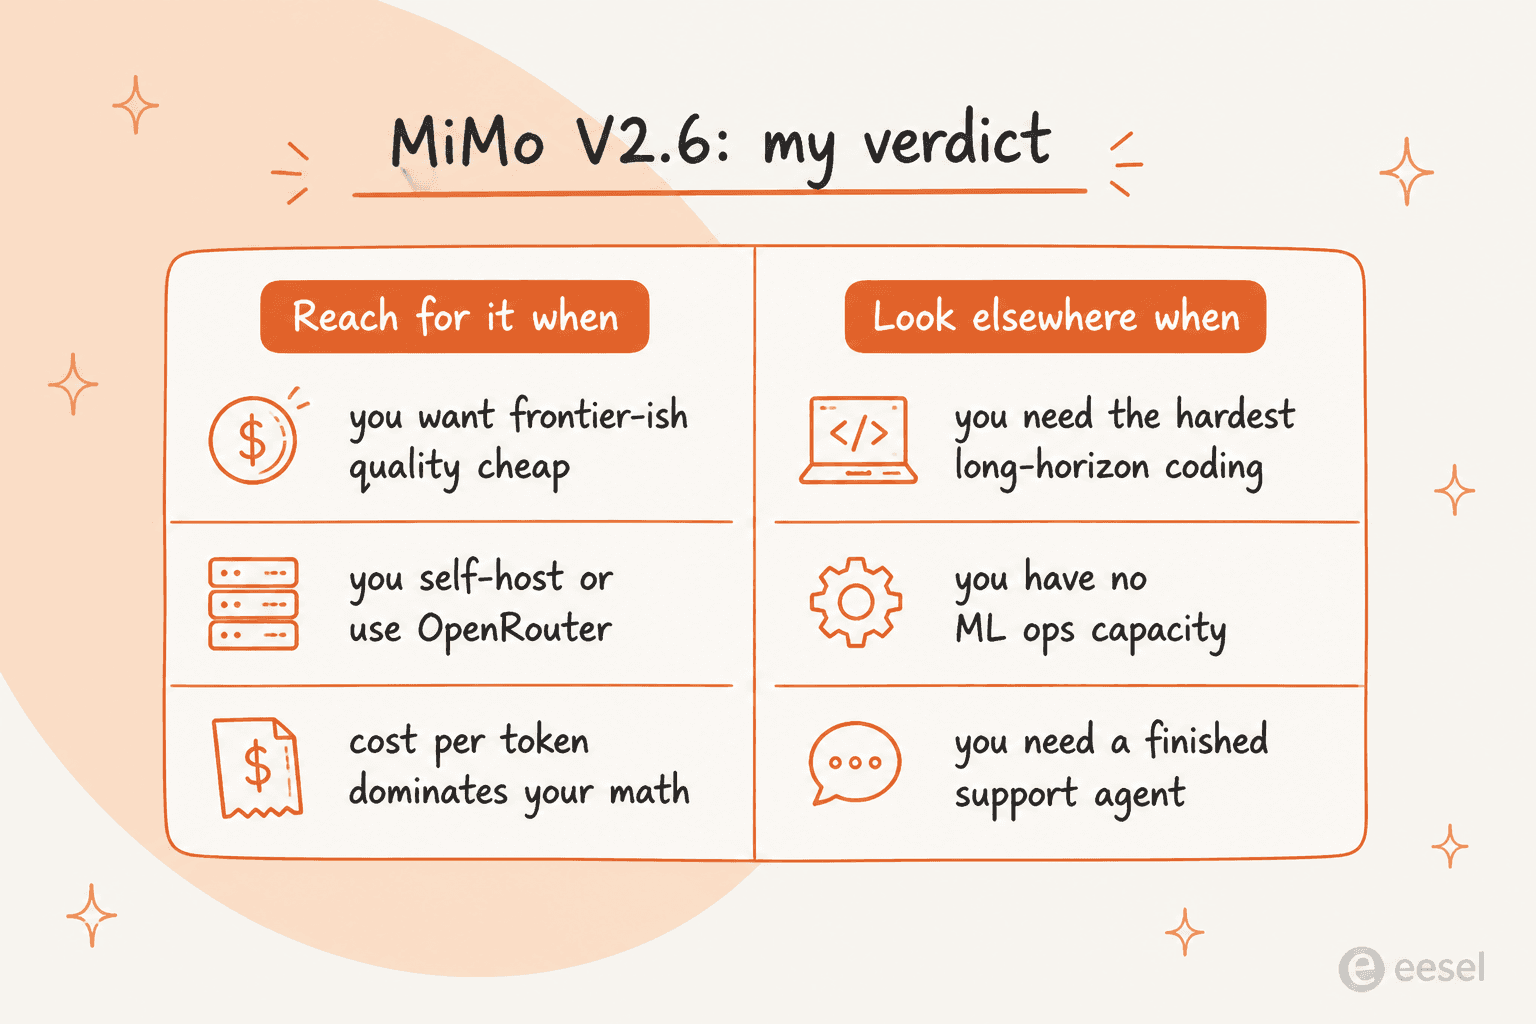
Privilégiez MiMo V2.6 quand le coût par token domine vos calculs, que vous êtes à l'aise avec l'auto-hébergement ou OpenRouter, et que vous voulez une qualité proche de la frontière sur du travail agentique général et d'usage d'outils. Flash en particulier est un excellent choix par défaut pour des tâches quotidiennes à fort volume, là où le prix par token de la frontière fermée ferait mal.
Cherchez ailleurs quand votre charge de travail relève du codage ou du travail d'exploitation le plus difficile à long terme, où Pro accuse un retard mesurable sur Astra et Opus 5 ; quand vous n'avez pas la capacité de faire tourner une infrastructure de modèles ni de plan pour la facture de service ; ou quand vous avez en réalité besoin d'un agent fini qui fait un travail, pas d'un modèle brut. Sur ce dernier point, MiMo n'est pas l'outil, et aucun autre modèle seul ne l'est non plus.
Côté notation, en tant que pari valeur parmi les poids ouverts, je le placerais près du sommet du peloton actuel, aux côtés de DeepSeek V4.1 Flash et Qwen 3.8 Max. Quant à l'affirmation « bat la frontière fermée », la réponse honnête est : sur le prix, oui ; sur les benchmarks les plus difficiles, pas encore. Pour un panorama plus large, notre tour d'horizon des meilleurs agents IA open source est une bonne prochaine lecture.
La partie qu'un avis sur un modèle omet généralement : un moteur n'est pas un employé
J'ai passé ces dernières années à aider à déployer l'IA sur des files de support réelles, et le lancement de MiMo V2.6 confirme ce que nous avons appris à nos dépens : le modèle n'est plus le goulot d'étranglement.
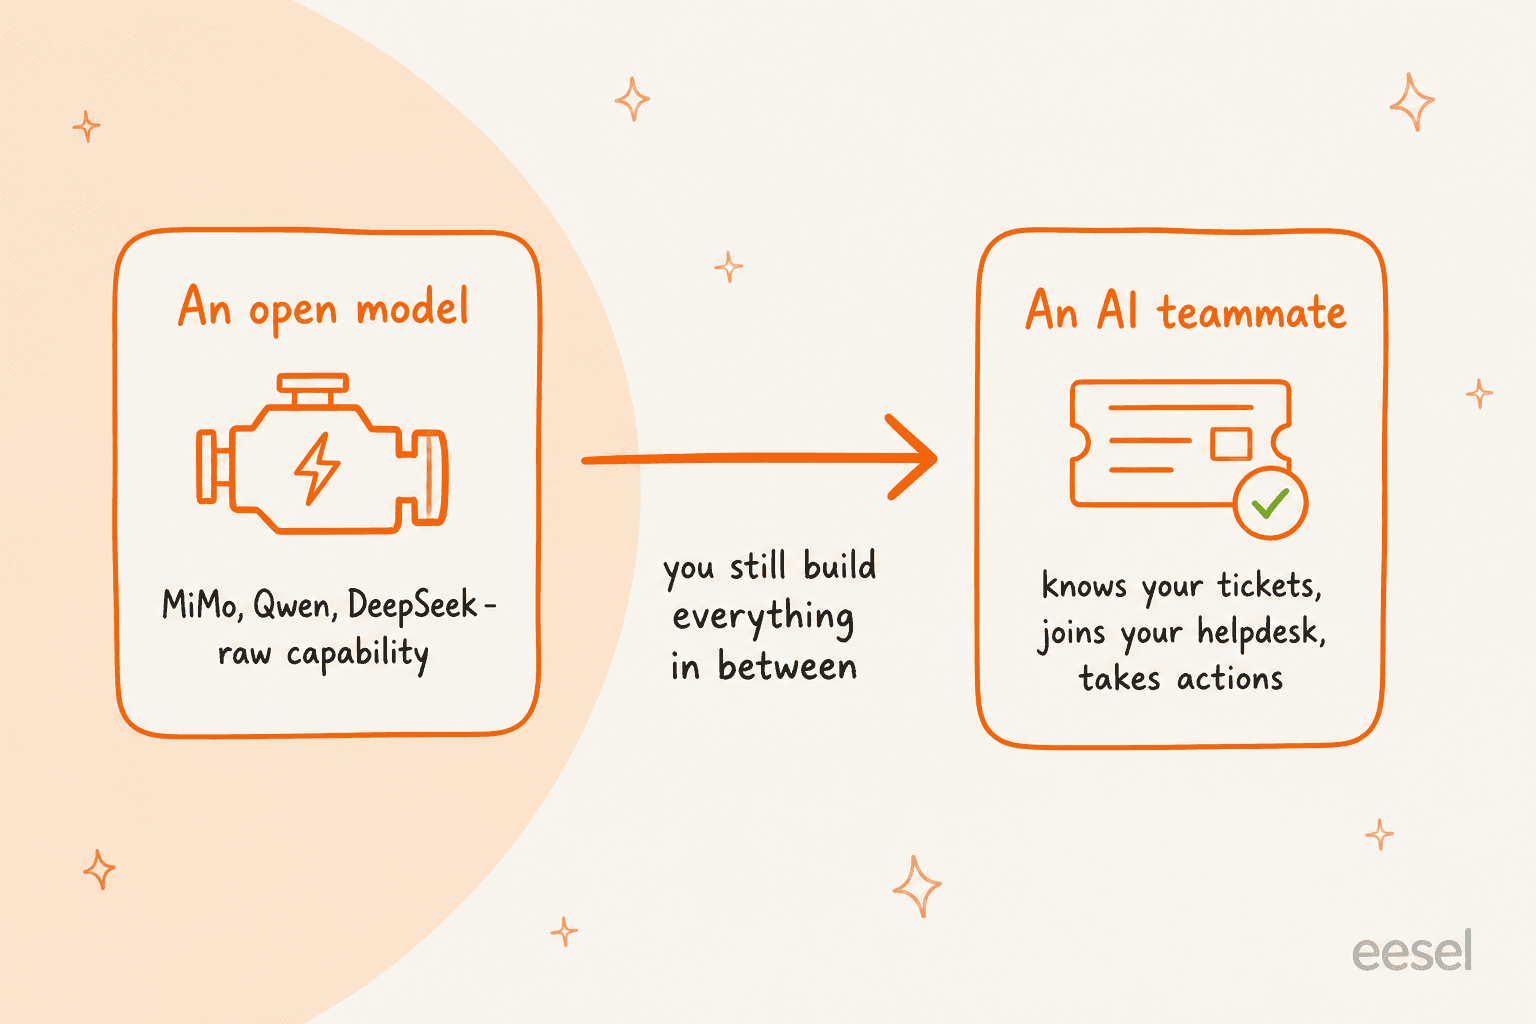
MiMo V2.6, DeepSeek, Qwen, Claude, GPT : n'importe lequel peut rédiger une réponse fluide et à l'apparence correcte à une question de client. C'était la partie effrayante il y a deux ans. C'est réglé. Ce qu'aucun d'eux ne fait par défaut, c'est le vrai travail : lire votre centre d'aide spécifique et les tickets passés, suivre votre politique de remboursement plutôt qu'une politique plausible mais inventée, consulter une commande, étiqueter et router le ticket, savoir quand escalader, et être testé avant de répondre à un vrai client.
Ce dernier point est celui sur lequel je ne transigerais pas. Nous avons vu des modèles au ton assuré donner de mauvaises réponses sur des files réelles, c'est pourquoi chaque déploiement est d'abord simulé sur des tickets historiques. Un 46 sur l'index AA ne vous dit rien sur la façon dont un modèle gère votre étrange exception de politique de retour. Une simulation sur vos 5 000 derniers tickets, si. Si vous choisissez un modèle spécifiquement pour le support, notre guide du meilleur modèle d'IA pour les tickets de support et l'analyse coût d'un agent IA face à un agent humain sont les deux prochaines lectures que je recommanderais.
Essayez eesel
Tout l'intérêt de cet avis est qu'un modèle ouvert comme MiMo V2.6 est de l'infrastructure, une capacité brute qu'il faut encore transformer en quelque chose qui fait un travail. eesel est la couche qui transforme un modèle en coéquipier opérationnel. Vous embauchez un agent IA pour helpdesk prêt à l'emploi qui se branche sur le helpdesk que vous utilisez déjà (Zendesk, Freshdesk, Gorgias, Help Scout, et plus de 1000 intégrations), s'entraîne sur vos tickets passés et votre base de connaissances, et commence à rédiger ou envoyer des réponses sans aucune gestion de modèle requise.

L'élément différenciant est celui que les benchmarks de MiMo ne peuvent pas vous donner : avant qu'un agent eesel ne réponde à un seul client en direct, vous le simulez sur votre historique réel de tickets et voyez le taux de résolution exact et les réponses que vous auriez obtenues. Et comme eesel est une plateforme de coéquipiers, ce même compte fait aussi tourner un rédacteur de blog IA. Pour les développeurs qui ont apprécié l'affinité de MiMo avec le terminal, eesel expose ce même coéquipier via une CLI, une API et un MCP publics, afin qu'une personne, un script ou un agent de codage puissent tous le piloter depuis le terminal.
Vous pouvez démarrer gratuitement, sans carte de crédit ni appel commercial, et avoir un coéquipier opérationnel en quelques minutes. Le modèle est devenu bon marché. Le faire vraiment travailler reste la partie intéressante.
Questions fréquentes
Xiaomi MiMo V2.6 est-il bon ?
Combien coûte l'utilisation de Xiaomi MiMo V2.6 ?
Xiaomi MiMo V2.6 est-il meilleur que Kimi K3 ou DeepSeek ?
Puis-je auto-héberger Xiaomi MiMo V2.6 ?
Quel modèle MiMo V2.6 devrais-je utiliser ?
Devrais-je utiliser Xiaomi MiMo V2.6 pour le support client ?
La transparence des benchmarks de Xiaomi MiMo V2.6 est-elle réelle ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.