

Le verdict en une minute
Je mets de l'IA sur des files de support en direct depuis plusieurs années, donc je lis chaque lancement de modèle de la même façon : non pas « le benchmark est-il joli », mais « pourrais-je lui confier un vrai travail demain ». À ce test, Step 5 est une preview solide et un achat faible, et l'écart entre les deux est tout l'avis.
Voici la fiche de notes avant le détail.
| Ce que j'ai examiné | Ma lecture | Note |
|---|---|---|
| Rapport prix-intelligence | Le meilleur de la gamme économique | 9/10 |
| Long contexte (1M) | Un atout réel et utilisable | 9/10 |
| Qualité du code | À parité avec les modèles ouverts, derrière la frontière fermée | 7/10 |
| Crédibilité des benchmarks | Auto-évalués, pas d'article, un test maison | 4/10 |
| Disponibilité | API uniquement, poids pas encore publiés | 5/10 |
| Prêt pour un vrai travail | C'est un moteur, pas une recrue | 4/10 |
Si vous ne retenez qu'une ligne : l'histoire du prix est légitime, celle des benchmarks a besoin d'exécutions indépendantes, et « modèle économique » et « produit fini » ne sont pas le même achat.
Ce qu'est réellement StepFun Step 5 Preview
StepFun (阶跃星辰) est un laboratoire de Shanghai qui publie la famille « Step » en texte, vision et audio depuis quelques années, avec une belle présence de poids ouverts sur Hugging Face. Step 5 Preview est son nouveau modèle phare, décrit sur la page produit comme un modèle de frontière « for complex work and agentic tasks », très orienté génie logiciel et finance.
Le cadrage auquel StepFun revient sans cesse est « advancing the Pareto frontier », la courbe des meilleurs compromis possibles entre intelligence et budget. Son propre graphique de lancement le dit clairement : égaler la gamme ouverte économique en intelligence, la battre en coût.
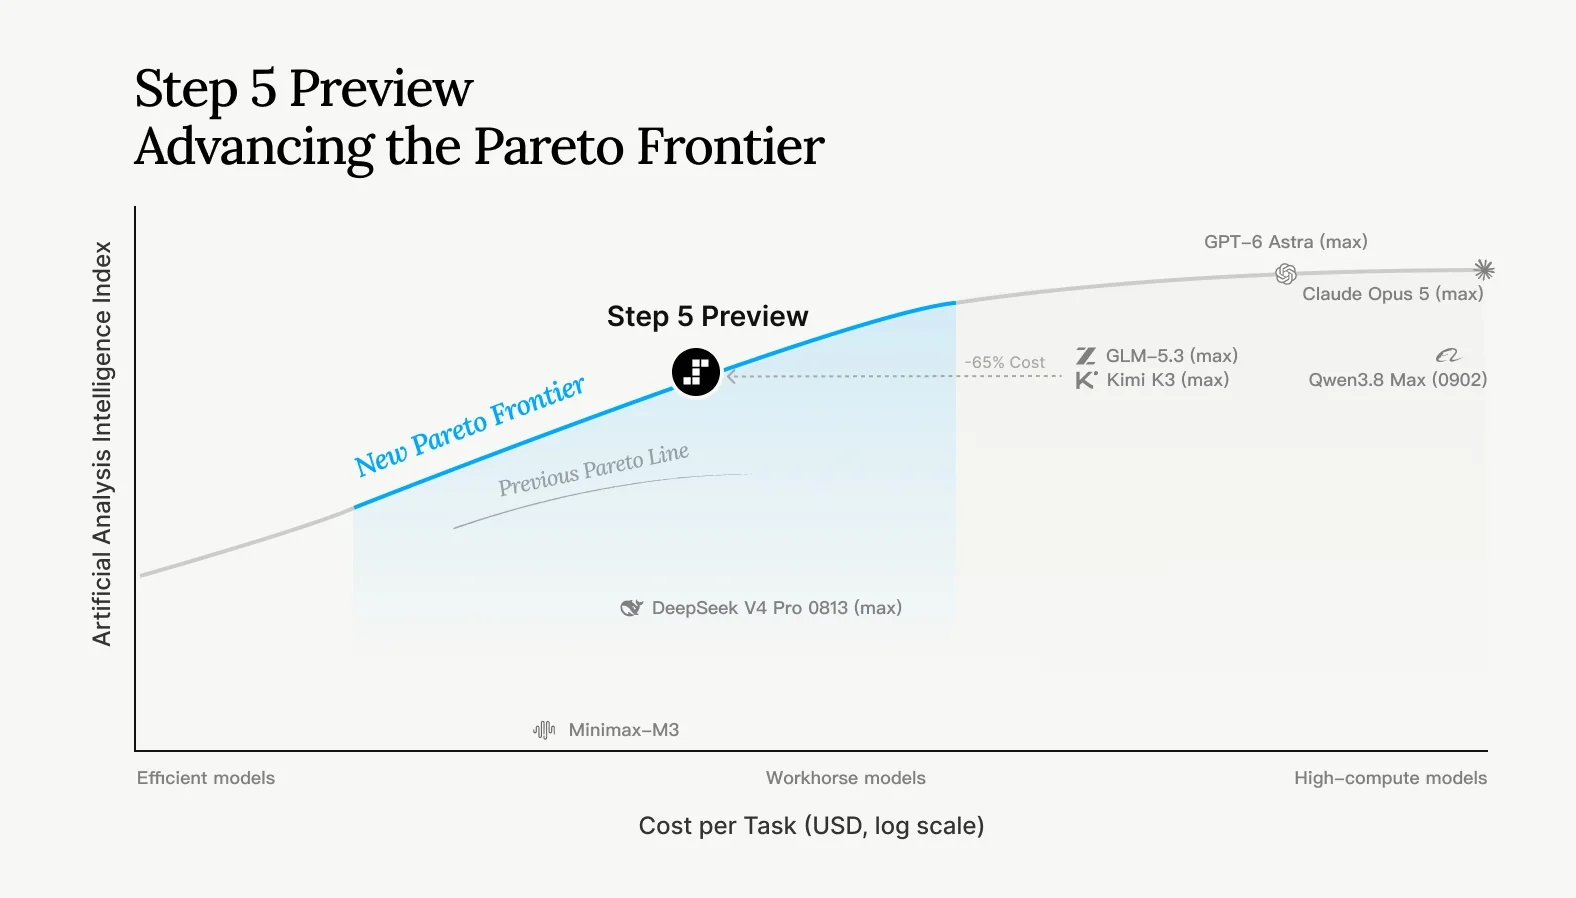
Notez l'affirmation intégrée à ce graphique : un coût inférieur de 65 % à GLM-5.3 et Kimi K3 à niveau d'intelligence comparable. C'est un graphique d'éditeur, donc je le lis comme l'argumentaire plutôt que comme le verdict, mais l'argumentaire est au moins cohérent.
L'architecture : 600B au total, 27B actifs
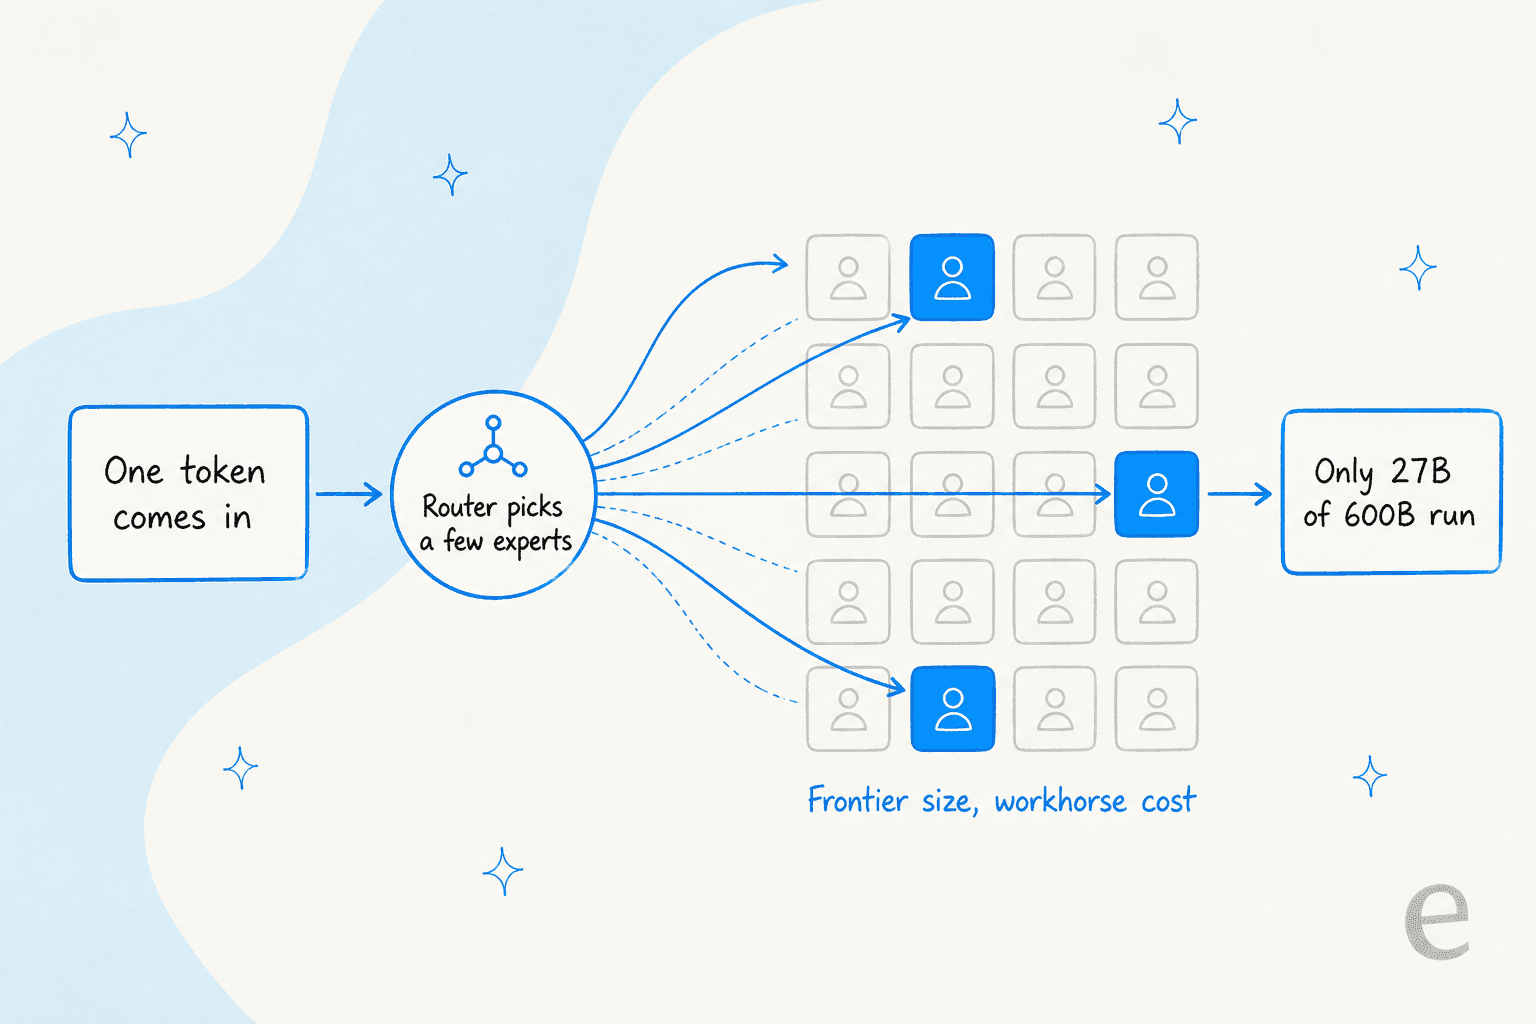
La spécification phare sur laquelle tout le monde s'est focalisé est la forme du modèle : 600B de paramètres au total, 27B actifs par token, selon la page produit. C'est une conception à mélange d'experts parcimonieux, et c'est toute l'histoire des coûts en un seul chiffre.
Dans un modèle dense, chaque paramètre s'exécute pour chaque token. Dans un modèle à mélange d'experts, un petit routeur choisit une poignée de sous-réseaux « experts » par token, de sorte que seule une partie du modèle s'active. Step 5 garde en mémoire 600B de taille frontière mais n'en allume que 27B à la fois, ce qui explique pourquoi StepFun peut le tarifer comme un modèle de milieu de gamme.
Tout le monde n'est pas convaincu que le calcul tourne en faveur de Step 5. Le nombre de paramètres actifs a vite été soulevé sur Hacker News :
"600b-a27b doesn't sound enticing. Also with the higher number of active parameters compared to GLM 5.3 flash and DeepSeek V4/4.1 flash, I don't see how they want to be more efficient at inference."

C'est une objection légitime. 27B actifs, c'est plus lourd que certaines gammes « flash » concurrentes, donc le gain d'efficacité porte en réalité sur l'intelligence par paramètre actif, pas sur le nombre de paramètres actifs seul. C'est exactement le genre de chose que des benchmarks d'inférence indépendants trancheront, et pas les graphiques de StepFun.
C'est un modèle de raisonnement, avec un contrôle reasoning_effort réglable sur low, medium ou high. Un effort plus élevé signifie une trace de réflexion interne plus longue et, comme les tokens de sortie sont facturés trace comprise, l'effort est un cadran de coût direct. Gardez cela en tête, c'est important pour la section sur les prix.
Tarifs : la partie que j'ai vraiment aimée
Le tarif est la chose la plus facile à apprécier dans ce lancement. D'après la page de tarification de StepFun, par 1M de tokens :
| Unité de facturation | Entrée (échec du cache) | Entrée (succès du cache) | Sortie |
|---|---|---|---|
step-5-preview | 1,00 $ | 0,05 $ | 2,70 $ |
step-3.7-flash (pour comparaison) | 0,20 $ | 0,04 $ | 1,15 $ |
La remise de 95 % en cas de succès du cache sur l'entrée est le point fort, et elle compte beaucoup pour les charges agentiques qui renvoient à chaque étape un gros prompt système en grande partie statique. La sortie à 2,70 $ couvre à la fois la trace de raisonnement et la réponse finale, donc une exécution bavarde à effort élevé coûte de l'argent pour de bon.
Comme ce coût de sortie plus raisonnement est facile à sous-estimer, voici un estimateur rapide où vous pouvez saisir vos propres chiffres.
Il existe aussi un niveau gratuit V0 pour essayer (5 de concurrence, 10 requêtes par minute), avec des limites de débit qui augmentent selon le montant rechargé. Pour le prix brut par token, c'est l'une des meilleures affaires de la catégorie des modèles de raisonnement en ce moment. Il joue dans la même tranche de budget que DeepSeek V4 Flash plutôt que dans le haut de gamme, et casse les prix de la plupart d'entre eux.
Benchmarks, et la réserve qui domine cet avis
StepFun a publié une comparaison complète avec des pairs ouverts (Kimi K3, GLM-5.3) et la frontière fermée (GPT-6 Astra, Claude Opus 5). En voici la forme, tous les chiffres provenant de la page produit de StepFun.
| Benchmark | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
La lecture est cohérente : Step 5 se situe à parité avec les autres grands modèles ouverts et derrière les meilleurs modèles fermés en qualité brute de code, tout en gagnant sur le coût. Il est le plus distancé par Claude Opus 5 sur les tests de code difficiles. La finance est son point fort, où il devance légèrement les pairs ouverts et bat GPT-6 Astra. Son propre radar StepCodeBench raconte la même histoire face à la gamme ouverte.
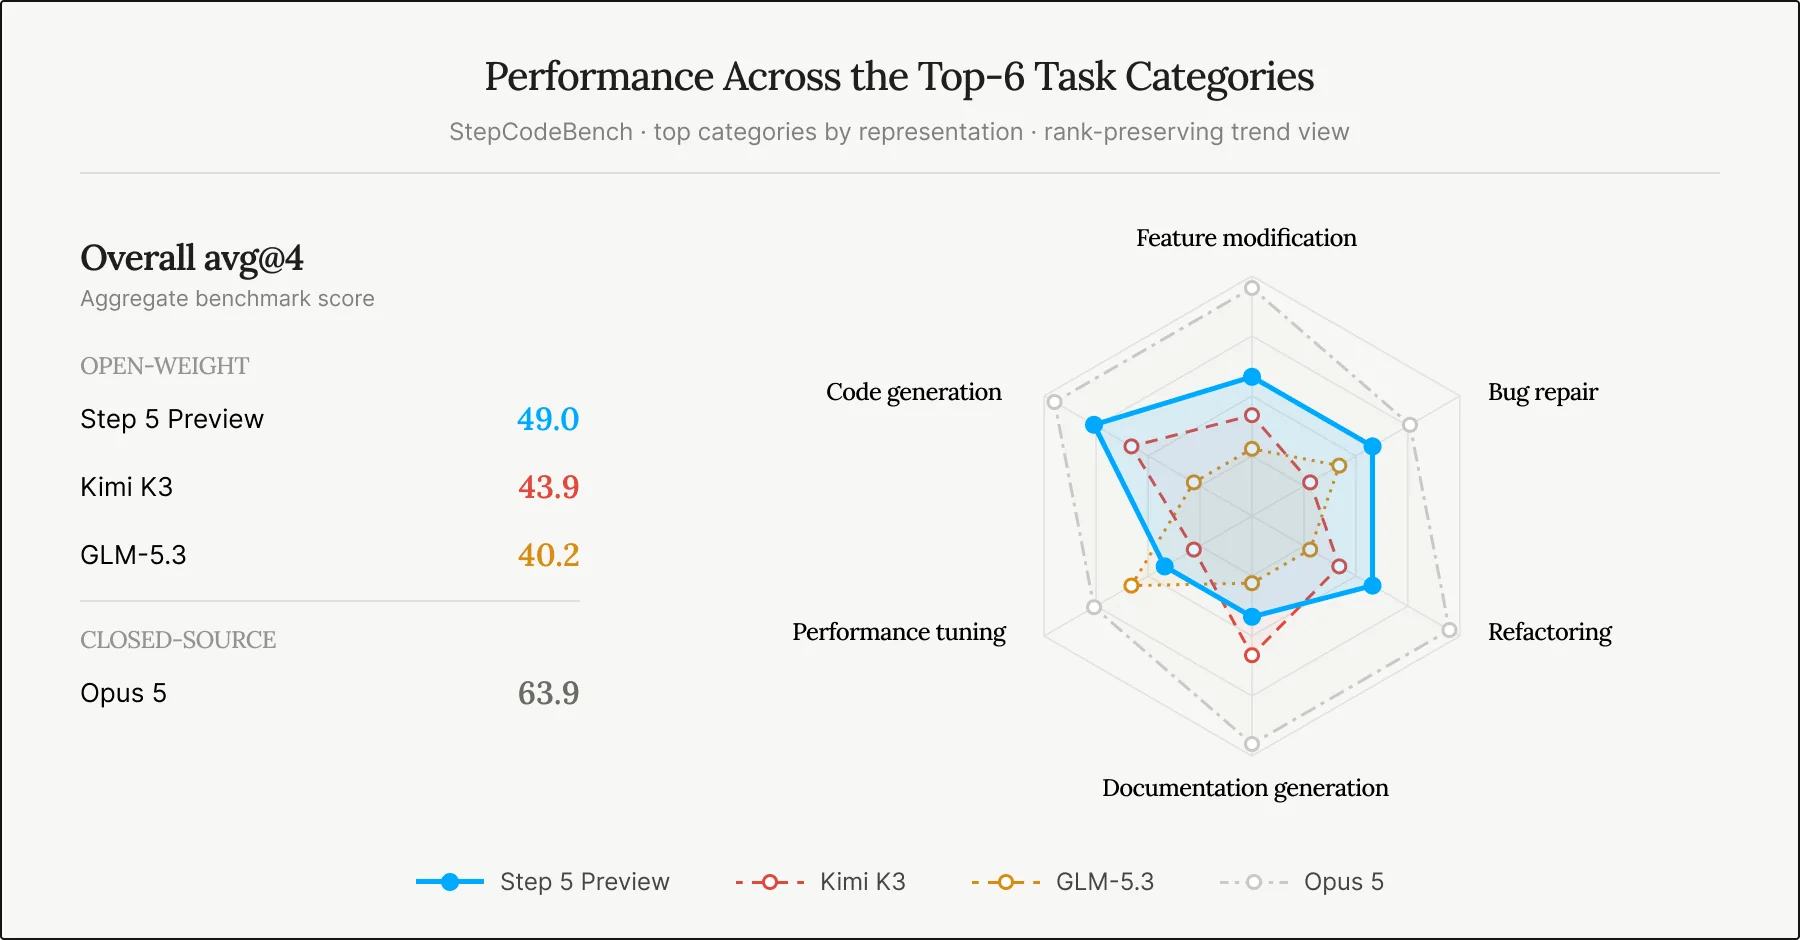
Passons à la réserve, qui est la raison pour laquelle ma note de crédibilité des benchmarks est un 4. Chaque chiffre ci-dessus est auto-déclaré, il n'y a pas encore de rapport technique ni d'article, et StepCodeBench est le benchmark maison de StepFun (553 dépôts, 33 langages). Un modèle a tendance à bien paraître sur le test conçu par sa propre équipe. La communauté a vite relevé les points faibles, surtout la verbosité :
"Based on the examples, it's like the thing took a writing class from Claude, but isn't quite as smart, kind of worst of both worlds. The 'Interactive Reporting' one is particularly terrible. A huge amount of waffly padding around a thesis that may or may not exist."
Et un commentateur a remarqué que la démo de lancement se trahissait elle-même, exactement le genre de chose qui me donne envie de lancer mes propres évaluations avant de faire confiance à un graphique de lancement :
"In their first demo video, to make a 3D render of the photo, the thinking trace gives away the game [...] I'm always astounded how little effort is put into checking the AI answers displayed in these announcements."
Rien de tout cela ne fait de Step 5 un mauvais modèle. Cela en fait un modèle non éprouvé, ce qui est différent. La bonne réaction est de le simuler sur votre propre charge de travail plutôt que de croire le graphique de lancement sur parole, et ce réflexe s'applique tout autant à la façon dont vous devez faire confiance à n'importe quelle IA dans le support client.
Où il brille : long contexte et finance
Deux points forts ont tenu dans tout ce que j'ai lu. Le contexte de 1M de tokens est la spécification sur laquelle je m'appuierais le plus. Il suffit pour déposer toute une base de code, un trimestre de transcriptions de support ou une pile de PDF dans un seul appel et demander un raisonnement entre documents. Côté multimodal, vous pouvez passer jusqu'à 60 images par requête plus de courtes vidéos, même si la sortie est uniquement du texte.
StepFun mise aussi fortement sur l'histoire du code. Il affirme que Step 5 peut aller « from software engineering and visual applications to programmable hardware », et que lors d'évaluations d'experts environ 70 % des participants l'ont jugé capable de résoudre de manière autonome des tâches de code de complexité moyennement élevée, selon sa page produit. Il existe une intégration avec Claude Code via « Step Plan » qui expose le contexte complet de 1M, une bonne façon d'aller à la rencontre des développeurs. Le résultat en finance sur FrontierFinance est le seul benchmark où il mène clairement le peloton, modèles fermés compris.
Avantages et inconvénients
Voici l'avis résumé en deux listes que j'utilise réellement pour décider s'il faut tester quelque chose :
Ce qui est bien
- Le meilleur rapport prix-intelligence de la gamme économique, à 1,00 $ / 2,70 $ par 1M de tokens.
- Un vrai contexte de 1M de tokens, pas un chiffre marketing plafonné à 128k en pratique.
- Une remise de 95 % en cas de succès du cache qui récompense les charges agentiques à prompts répétés.
- Un positionnement honnête : il dit « le meilleur de la gamme économique », pas « nous battons la frontière ».
- Une publication de poids ouverts sur la feuille de route, avec un précédent Apache 2.0 pour la gamme Flash.
Ce qui me fait hésiter
- Chaque benchmark est auto-déclaré, sans rapport technique et avec un test maison.
- La communauté constate une sortie verbeuse, qui gonfle discrètement la facture de tokens de sortie.
- 27B actifs, c'est plus lourd que certaines gammes flash concurrentes, donc le gain d'efficacité reste incertain.
- API uniquement aujourd'hui ; les poids qui rendent l'argument « ouvert » intéressant ne sont pas arrivés.
- C'est un modèle brut, donc tout le travail pour en faire un produit vous revient.
Pour qui est Step 5, et qui devrait attendre
Voici où j'atterris. Si vous êtes un développeur ou un laboratoire qui veut un modèle capable, économique et à long contexte sur lequel construire, surtout pour le code, la finance ou la recherche sur de gros ensembles de documents, Step 5 Preview mérite un vrai test. L'histoire du prix par intelligence est vraiment bonne, et la promesse de poids ouverts le rend encore plus intéressant.
Si vous attendez un modèle stabilisé et éprouvé, attendez. C'est une preview, les benchmarks sont auto-évalués, et la première lecture de la communauté est « prometteur mais verbeux et non éprouvé ». Même un commentateur bienveillant a énoncé le schéma avec douceur :
"The previous Step models were pretty decent, but unfortunately for them, their model reasons too much and too long [...] Hopefully this doesn't reason too long to get to the answer. I welcome any open model, the more the merrier."
Je reconnais à StepFun ce que la plupart des lancements ratent, à savoir savoir ce qu'ils sont :
"Their posisitoning is nice. Instead of saying they are cheaper and a bit less performant (in terms of intelligence), they say they are best among the cheaper and a bit less performant ones."
Où s'arrête un modèle brut et où commence un coéquipier
Il y a un cadrage qu'il vaut la peine de contester, et ce n'est pas la faute de StepFun, cela s'applique à chaque lancement de modèle. Un modèle n'est pas une solution. Step 5 Preview est un moteur. Il vous donne une API, une facture de tokens et une capacité brute. En faire quelque chose qui répond à vos clients signifie que vous construisez l'application, branchez vos données, écrivez les garde-fous et assurez la maintenance.
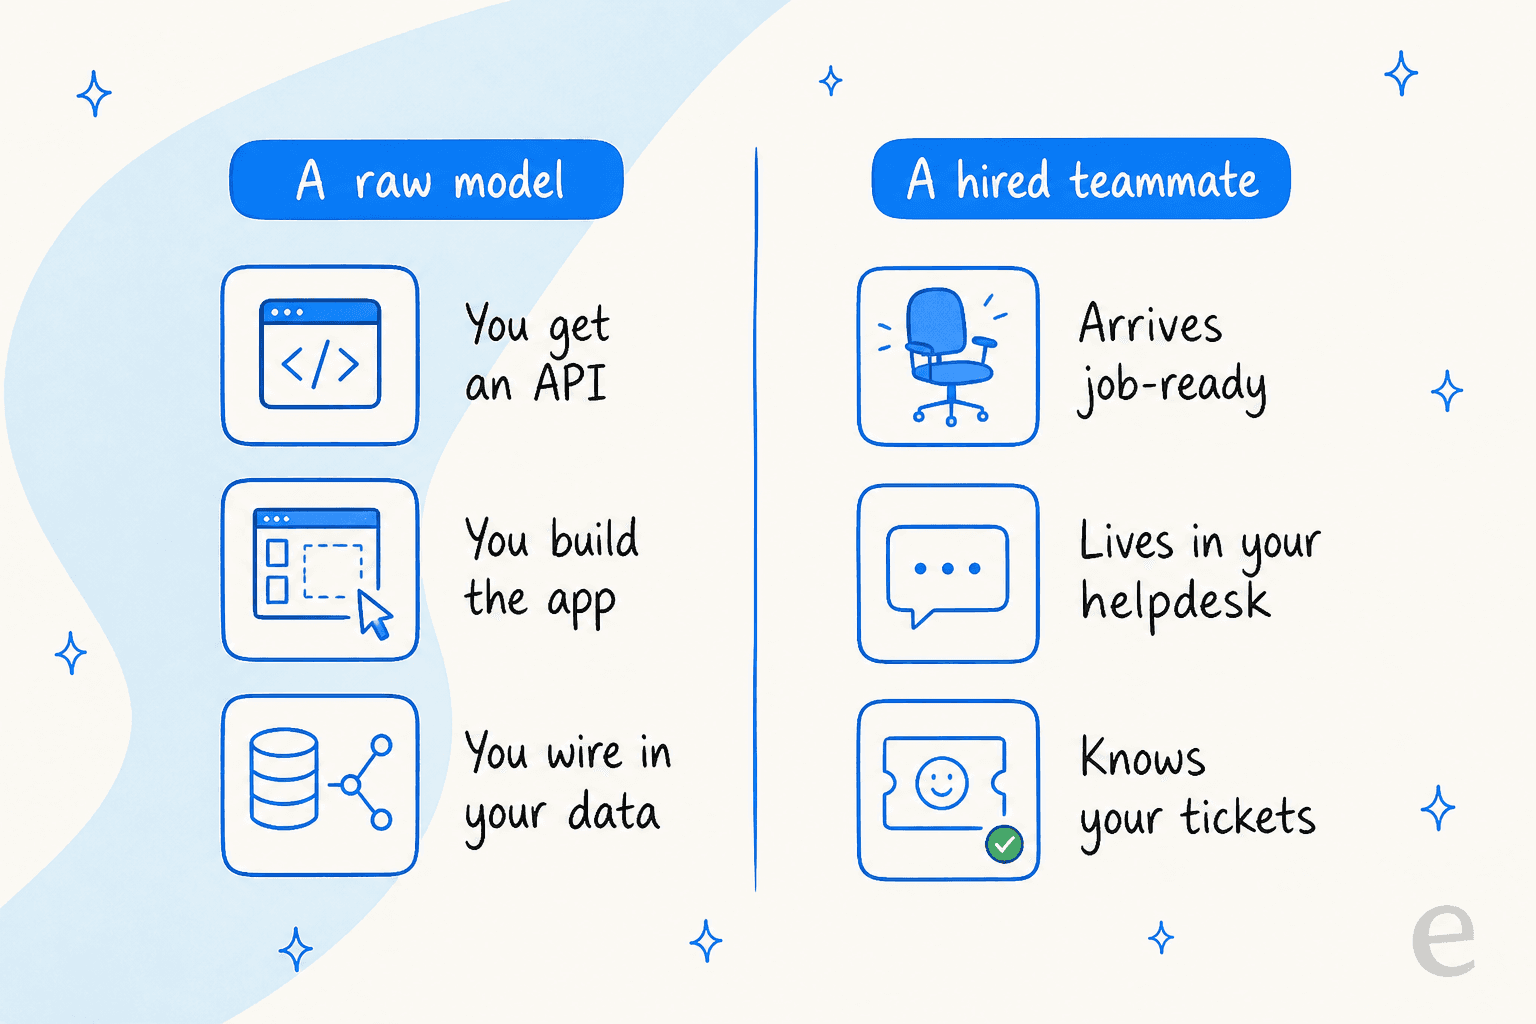
Cet écart est la raison d'être d'eesel. Au lieu d'un modèle brut, vous recrutez un coéquipier prêt à travailler pour une mission précise. Le coéquipier IA pour le helpdesk rejoint votre file existante, s'entraîne sur vos anciens tickets et votre centre d'aide, et rédige ou envoie des réponses dans le helpdesk que vous utilisez déjà, que ce soit Zendesk, Freshdesk ou Gorgias. La tarification est un forfait par résolution, sans frais par siège, donc le coût correspond au travail accompli plutôt qu'aux tokens consommés.

Ce qui m'importe le plus, vu le problème des benchmarks auto-déclarés évoqué plus haut, c'est que vous pouvez simuler le coéquipier sur des milliers de vos anciens tickets avant qu'il ne touche un client réel, et voir son vrai taux de résolution sur votre charge de travail plutôt que le graphique d'un éditeur. Et si vous préférez le piloter depuis un terminal plutôt qu'un tableau de bord, eesel fournit une vraie CLI et un serveur MCP pour que des agents de code comme Claude Code puissent opérer directement le même coéquipier. Les nouveaux modèles comme Step 5 sont une infrastructure enthousiasmante. Un coéquipier est celui qui se présente réellement pour le service. Vous pouvez essayer eesel gratuitement.
Comment StepFun Step 5 se compare-t-il à GPT-6 Astra et Claude Opus 5 ?