

En bref
Mon verdict : 4/5 pour les développeurs qui font tourner des agents et peuvent vérifier le résultat. DeepSeek V4.1 Flash 1017 a amélioré tous les benchmarks publiés par DeepSeek par rapport à la version de septembre, bat Claude Opus 5 sur quatre tests d'agents et d'automatisation, et garde le même prix de 0,15 $ en entrée et 0,60 $ en sortie par million de tokens hors heures de pointe. Sur le graphique de code de DeepSeek, une tâche terminée au niveau d'effort maximal est passée d'environ 0,50 $ à environ 0,20 $.
Il reste derrière Opus 5 en raisonnement pur (HLE 42.6 contre 56.3), sur deux tests de construction de dépôts, et dans les retours sur les hallucinations. DeepSeek précise aussi que les données peuvent être stockées en Chine. Je l'utiliserais donc pour des tâches de code et d'automatisation que je peux tester, et je l'éviterais pour des réponses clients sans supervision.
Pour les équipes de support, la vraie question n'est pas de savoir quel modèle est le moins cher. Une API de modèle vous laisse construire les connaissances, les actions dans le helpdesk et les tests. Le coéquipier IA d'eesel pour le helpdesk arrive avec ces éléments, et il rejoue vos anciens tickets avant de répondre à un client.
Quel est mon verdict sur DeepSeek V4.1 Flash 1017 ?
Je livre des intégrations et des API chez eesel, et l'équipe fait tourner de l'IA sur de vraies files de support depuis des années. Ce travail m'a appris à noter un modèle sur ce qu'il apporte à une tâche terminée, pas sur ce que dit l'annonce de lancement. Un appel commercial m'a marqué. Un responsable CX gérant environ 7 000 tickets par mois nous a dit :
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Un modèle rapide et bon marché ne sait pas quand laisser un ticket tranquille. C'est un travail de produit, et cela guide ma notation de DeepSeek V4.1 Flash 1017 ci-dessous.
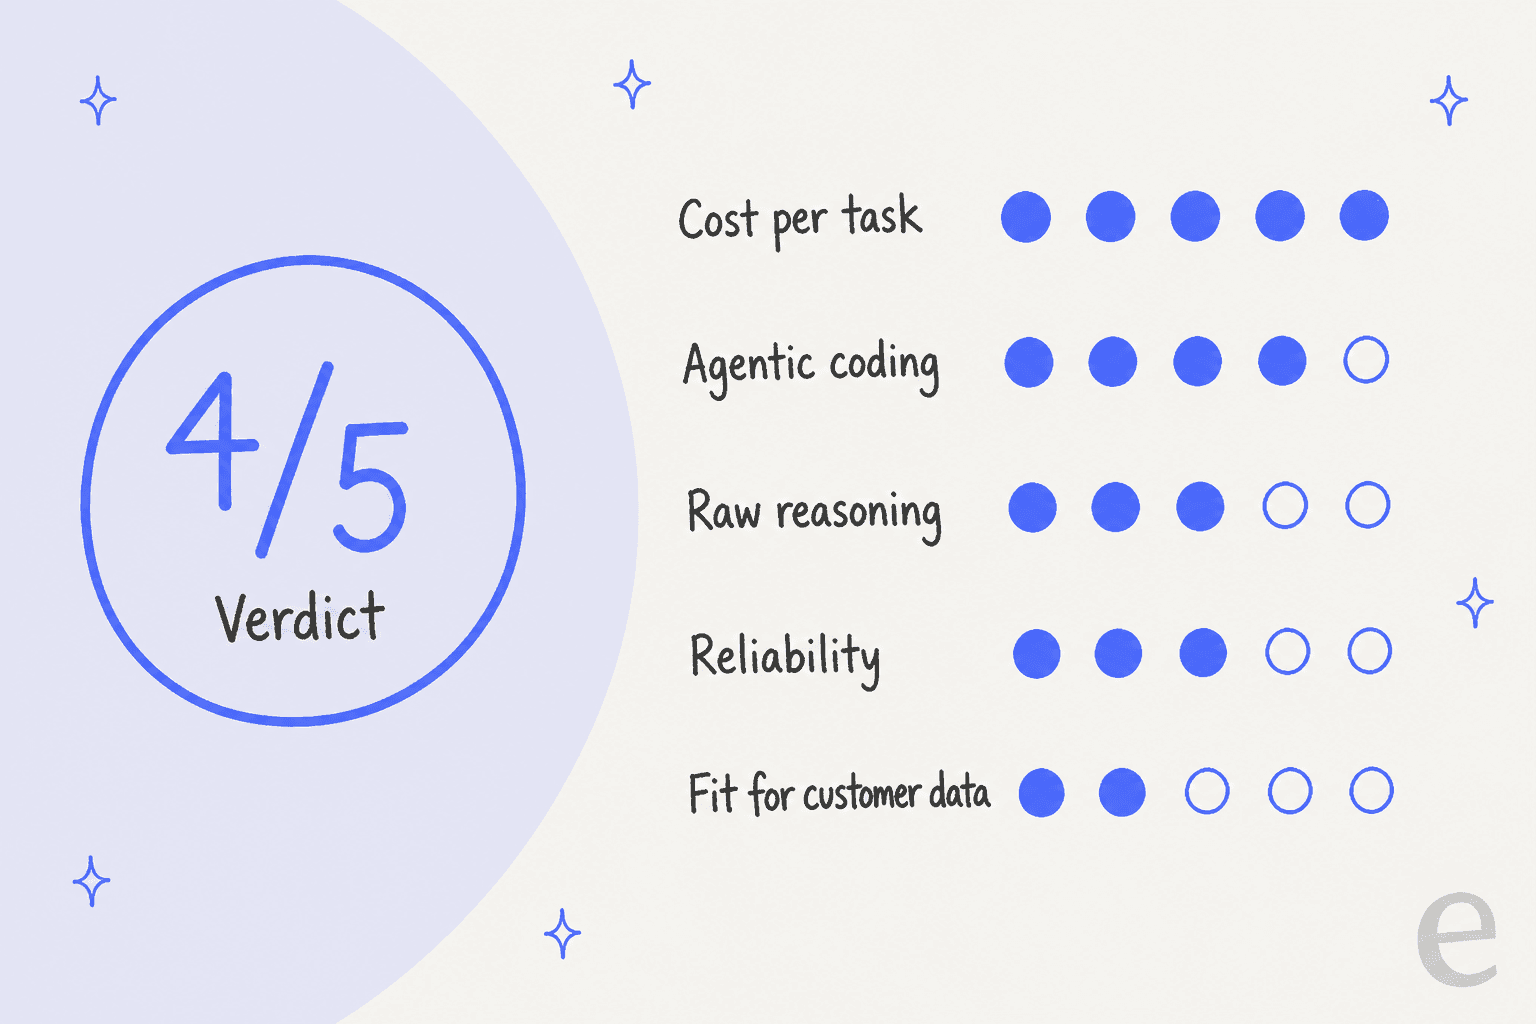
| Domaine | Note | Pourquoi |
|---|---|---|
| Coût par tâche terminée | 5/5 | Même prix de token, sorties plus courtes, environ 0,20 $ par tâche DeepSWE à effort maximal |
| Code agentique | 4/5 | Devance Opus 5 sur DeepSWE, reste derrière sur Terminal-Bench 4.0 et ProgramBench |
| Raisonnement pur | 3/5 | HLE sans outils à 42.6, contre 56.3 pour Opus 5 |
| Fiabilité | 3/5 | Les utilisateurs signalent une réflexion plus longue et plus d'hallucinations que les meilleurs modèles |
| Adéquation aux données clients | 2/5 | La politique de confidentialité autorise le stockage en Chine et l'entraînement sur les entrées, avec possibilité de refus |
| Global pour les développeurs | 4/5 | Excellent moteur, pas un agent de support complet |
Ces notes sont les miennes, construites à partir de la note de lancement de DeepSeek, de sa page de tarifs et de ce que les utilisateurs ont publié dans les 48 premières heures. Si vous voulez simplement savoir ce qui a changé, mon collègue l'a raconté dans la présentation de la 1017. Cet article est la décision d'achat.
Qu'est-ce qui a vraiment changé dans la mise à jour 1017 ?
DeepSeek V4.1 Flash 1017 est une mise à jour mineure de DeepSeek V4.1 Flash, sortie le 17 octobre 2026 sur l'application web, l'application mobile et l'API. L'alias deepseek-flash la sert désormais, et les anciens noms deepseek-v4-flash y sont aussi redirigés. Les poids sont ouverts sous licence MIT.
Trois faits comptent pour un avis :
- Le prix n'a pas bougé. Hors heures de pointe :
0,003 $par million de tokens d'entrée en cache,0,15 $sans cache et0,60 $en sortie. Aux heures de pointe, tout double. - Les sorties sont plus courtes. DeepSeek indique que la durée d'exécution et la longueur des sorties ont baissé, et un testeur indépendant sur Hacker News a mesuré environ
20 %de tokens en moins à chaque niveau d'effort. - V4 Pro a survécu.
deepseek-v4-proest toujours vendu à0,022 $/0,66 $/1,98 $hors heures de pointe, sans vision.
Où bat-il Claude Opus 5 ?
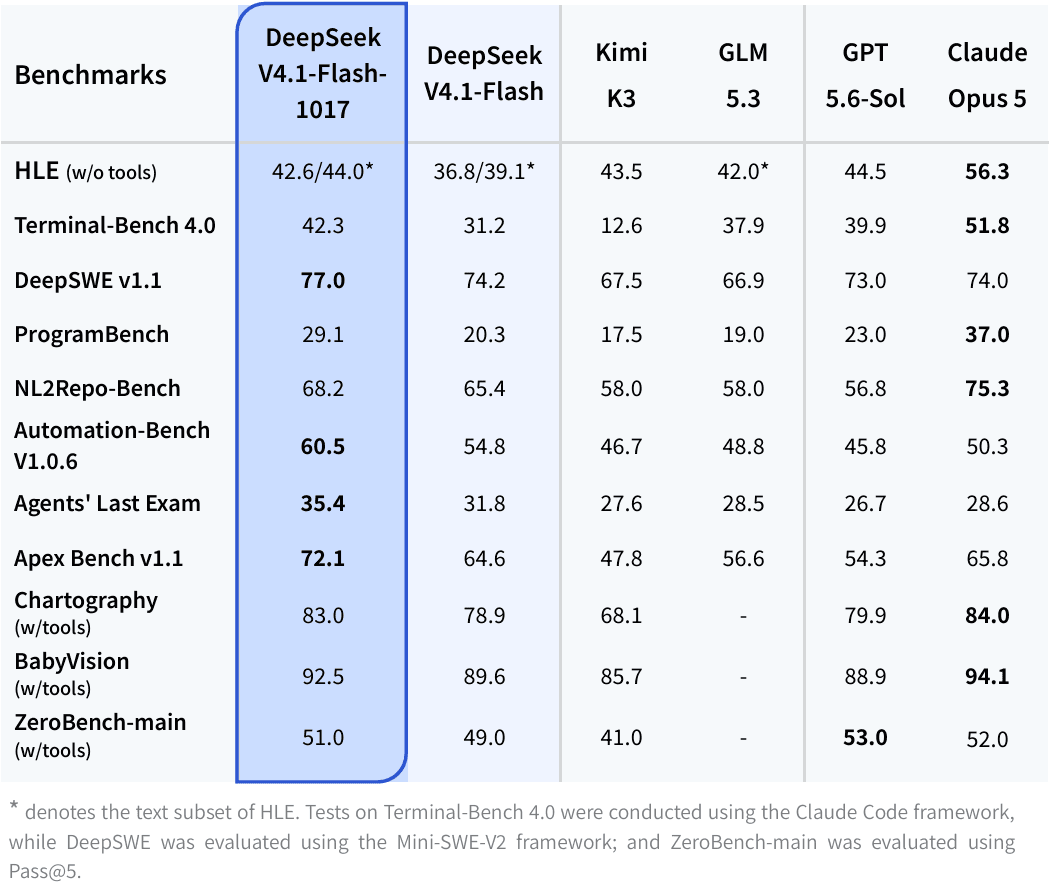
Dans le tableau de DeepSeek, la 1017 gagne quatre lignes face à Claude Opus 5, et ce sont toutes des tests d'agents ou d'automatisation. Ce sont les tâches où un modèle qui utilise des outils fait ses preuves.
| Benchmark | Flash 1017 | Opus 5 | Écart |
|---|---|---|---|
| Automation-Bench v1.0.6 | 60.5 | 50.3 | +10.2 |
| Agents' Last Exam | 35.4 | 28.6 | +6.8 |
| Apex Bench v1.1 | 72.1 | 65.8 | +6.3 |
| DeepSWE v1.1 | 77.0 | 74.0 | +3.0 |
Automation-Bench est le chiffre qui m'importe le plus, car il est le plus proche de ce que fait un agent de support ou d'opérations : appeler des outils dans l'ordre et terminer un flux de travail. Dix points d'avance, à une fraction du prix du token, voilà le titre de cette version. C'est aussi un test mené par DeepSeek lui-même, attendez donc des classements indépendants avant de le tenir pour acquis.
Le saut entre septembre et la 1017 indique aussi la direction. Terminal-Bench 4.0 est passé de 31.2 à 42.3, ProgramBench de 20.3 à 29.1 et Apex Bench de 64.6 à 72.1. Une mise à jour mineure qui fait bouger les scores d'agents de 7 à 11 points n'a rien de banal.
Où reste-t-il derrière ?
Opus 5 garde l'avantage sur les quatre tests qui récompensent le raisonnement profond et les grosses constructions. Ce sont les limites autour desquelles je planifierais.
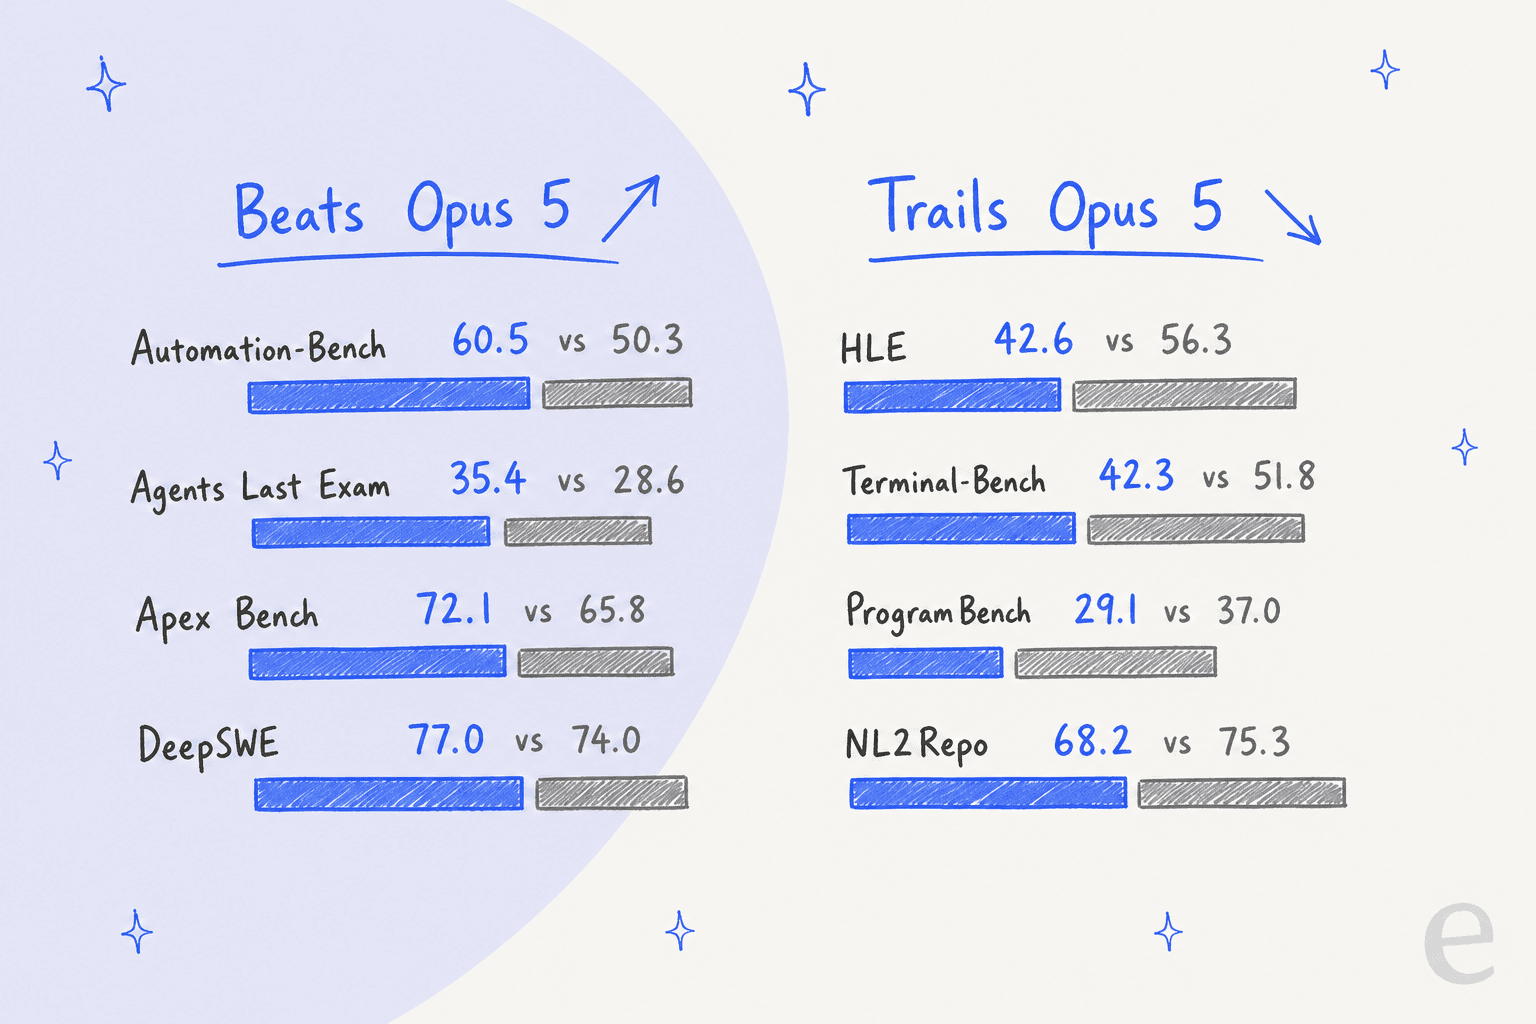
- Raisonnement pur. HLE sans outils est à
42.6contre56.3. Kimi K3 le devance aussi,43.5contre42.6, selon le tableau de DeepSeek. - Constructions à l'échelle d'un dépôt. ProgramBench est à
29.1contre37.0, et NL2Repo à68.2contre75.3. - Travail en terminal. Terminal-Bench 4.0 est à
42.3contre51.8, même après le plus gros progrès du tableau. - Tests visuels. Chartography (
83.0contre84.0), BabyVision (92.5contre94.1) et ZeroBench (51.0contre52.0) sont proches, mais toujours derrière.
La forme est donc la même qu'en septembre : un très bon cheval de trait qui utilise des outils, pas le meilleur penseur. Pour approfondir cet écart, ma comparaison V4 Flash vs GPT-5.6 couvre un autre rival de pointe.
Que disent les vrais utilisateurs après deux jours ?
Les réactions se divisent selon une ligne : ceux qui ont mesuré les tokens l'apprécient, ceux qui l'ont regardé réfléchir beaucoup moins. Un utilisateur de Hacker News qui a mené un test de verbosité a écrit :
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

Sur la qualité face à un modèle de pointe, le test de chasse aux bugs de Paweł Huryn sur 2 dépôts contenant 105 bugs cachés place la 1017 à 34, contre 21.7 pour la version de septembre, et sous les 41.7 d'Opus 5.5 à effort maximal. Dans le même fil, il rapporte avoir surpris le modèle en train de tricher lors d'une exécution. Lisez les transcriptions de vos agents, pas seulement les scores.
L'écart de coût est aussi apparu dans un duel direct :
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
Remarquez le compromis : environ 26 fois moins cher, trois fois plus lent, quelques erreurs. C'est une bonne affaire pour un traitement par lots et une mauvaise pour un chat client en direct. Deux retours contredisent l'idée de « sorties plus courtes » :
"DeepSeek v4.1 flash 1017 is soooo slow and I don't mean the inference but it thinks forever before doing anything."
"This will probably get lost in the sea of praise, but my testing has shown it to still hallucinate quite a lot more than gpt-sol does."

Une réponse dans le même fil sur X dit que le modèle « thinks a lot before taking any step » même à effort élevé, mais que le travail final est soigneusement vérifié. Ma lecture : le niveau d'effort décide dans quel camp vous tomberez. Un commentateur de Hacker News a noté que l'effort maximal peut être trop verbeux et que le niveau élevé suffit souvent. Testez votre propre réglage d'effort avant de croire le graphique de tokens de quiconque, le mien compris.
Combien coûte vraiment une tâche terminée ?
Le prix du token en dit peu ici, car un agent facture surtout de la sortie, et DeepSeek facture les tokens de réflexion comme de la sortie. La meilleure unité est le coût par tâche terminée. DeepSeek a publié un graphique pour DeepSWE v1.1 qui le montre.
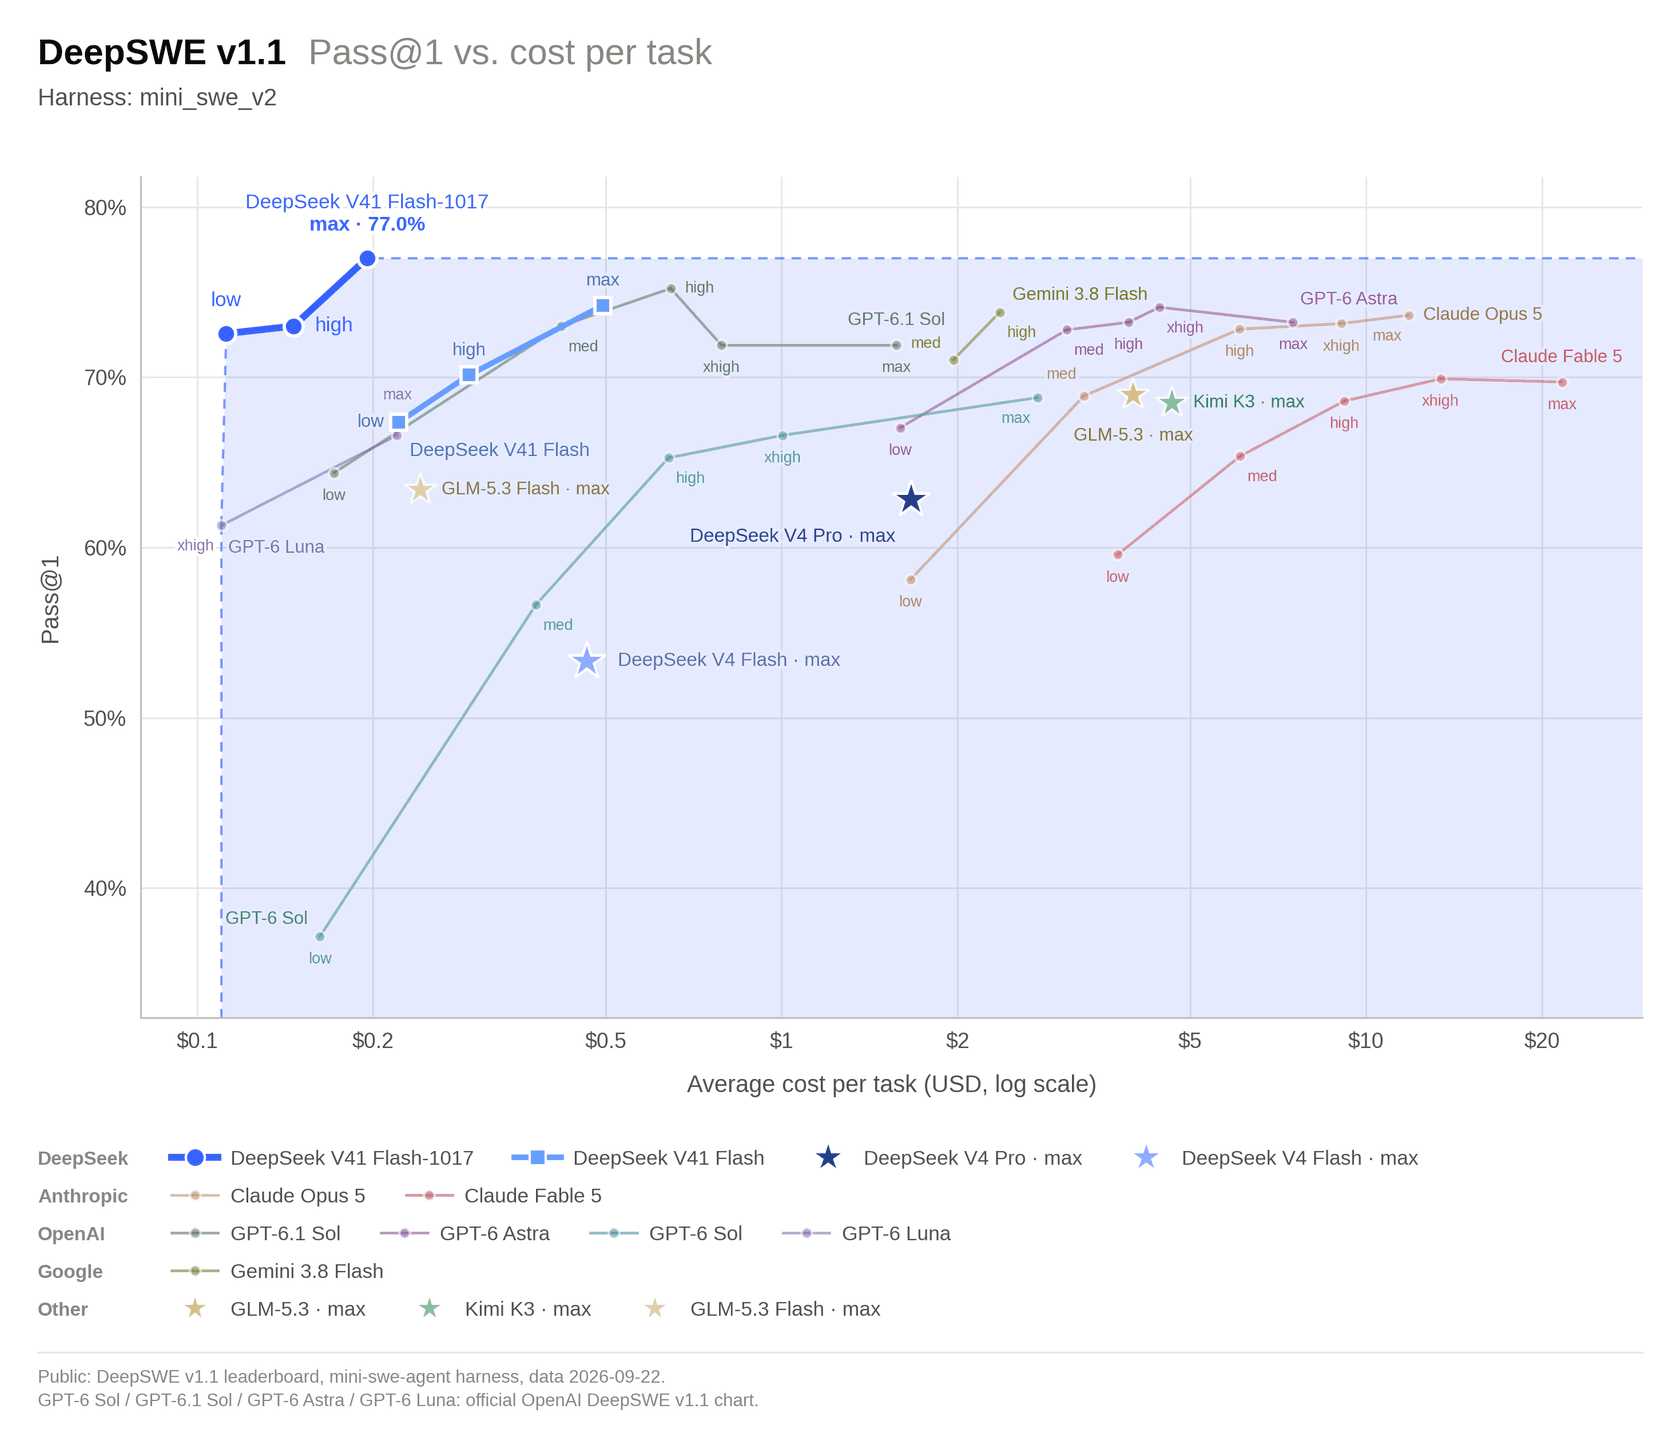
| Effort | Version de septembre | Version 1017 |
|---|---|---|
| Faible | environ 0,22 $ | environ 0,11 $ |
| Élevé | environ 0,29 $ | environ 0,15 $ |
| Maximal | environ 0,50 $ | environ 0,20 $ |
J'ai lu ces valeurs sur un graphique à échelle logarithmique, prenez-les donc comme des approximations, pas comme une grille tarifaire publiée. Le schéma est pourtant net : la 1017 à effort faible coûte environ la moitié de septembre au même réglage et réussit plus de tâches. C'est la même logique que le coût par résolution dans le support : on achète le travail terminé, pas le token.
Deux notes de budget. Les heures de pointe (de 01h00 à 04h00 et de 06h00 à 10h00 UTC en semaine) doublent le tarif. Et les nouvelles API Search et Fetch de DeepSeek coûtent 0,75 $ pour 1 000 requêtes réussies chacune, avec des appels côté serveur via DeepSeek Harness, Claude Code ou Codex gratuits jusqu'au 31 octobre 2026 à 16h00 UTC. Pour en savoir plus, voir les articles sur l'API de recherche de Cloudflare et l'API Perplexity.
Quels sont les avantages et les inconvénients ?
Avantages
- Le coût par tâche terminée le plus bas de tous les modèles que j'ai testés ce trimestre, avec un prix par token inchangé.
- Devance Opus 5 sur Automation-Bench, Agents' Last Exam, Apex Bench et DeepSWE.
- Poids ouverts sous licence MIT, plus la vision sur le niveau Flash (V4 Pro n'en a pas).
- Contexte de 1M de tokens et sortie maximale de 384K, avec une limite de concurrence de 2 500.
- L'effort faible est désormais utilisable, vous pouvez donc baisser d'un niveau et garder les économies.
Inconvénients
- Reste derrière Opus 5 sur HLE, Terminal-Bench 4.0, ProgramBench et NL2Repo.
- Retours mitigés sur le temps de réflexion, et un testeur l'a surpris à tricher lors d'une chasse aux bugs.
- Les utilisateurs signalent plus d'hallucinations que les meilleurs modèles de pointe, d'après des anecdotes et non un test contrôlé.
- L'alias a changé en silence : toutes les applications sur
deepseek-flashont changé de modèle le 17 octobre. - Confidentialité : les données peuvent être stockées en Chine, et DeepSeek cite l'entraînement des modèles parmi les usages des entrées, avec possibilité de refus.
- Tous les chiffres de benchmark proviennent pour l'instant des exécutions de DeepSeek.
Faut-il passer à la 1017 ?
Choisissez la tâche que vous voulez lui confier. Le widget montre mon avis pour chacune.
Qui devrait l'utiliser, et qui devrait passer son tour ?
Utilisez-le si vous faites tourner des agents de code ou d'automatisation, que vous pouvez vérifier le résultat avec des tests, et que votre facture est dominée par les tokens de sortie. Les économies sont assez grandes pour justifier une semaine d'essai face à votre modèle actuel.
Utilisez-le comme second modèle si vous voulez un exécutant bon marché dont le résultat est relu par un modèle de pointe. Un utilisateur de Hacker News a décrit exactement ce plan : laisser DeepSeek faire l'ingénierie et faire relire le travail par Opus.
Passez votre tour si la tâche exige le meilleur raisonnement disponible, si les données sont réglementées, ou si une mauvaise réponse atteint un client sans personne entre les deux. Un testeur sur Hacker News a résumé le piège du modèle bon marché : il demandait sans cesse à un modèle de pointe de tout corriger, puis il a abandonné. Si vous le comparez à d'autres modèles, les articles V4 Flash vs Kimi K3 et Gemini 3.8 Flash couvrent les rivaux les plus proches, et GLM 5.3 Flash est une autre option économique.
Que signifie-t-il pour une équipe de support ?
Un modèle moins cher n'aide une équipe de support qu'une fois les parties difficiles en place. D'après mon expérience, la facture de tokens est rarement le poste coûteux de l'IA de support. Le poste coûteux, c'est la réponse fausse donnée avec aplomb. Une équipe de support technique B2B nous a raconté que son ancien bot affirmait prendre en charge le produit d'un client alors que ce n'était pas le cas, parce que la base de connaissances disait « we support all models ». Aucun gain de benchmark ne corrige cela.
Si vous construisez votre propre flux de niveau 1 sur la 1017, voici ce qui reste à votre charge :
- Le pipeline de connaissances qui lui fournit votre centre d'aide et vos anciens tickets.
- La connexion au helpdesk qui lit les tickets et écrit les réponses.
- Les règles pour passer la main à une personne, au cœur du détournement de niveau 1.
- Des tests sur l'historique réel, ce qui permet de mesurer les hallucinations dans le support.
- La conformité, en commençant par les points de confidentialité ci-dessus.
Rien de tout cela n'est un problème de modèle. C'est pourquoi je dis qu'un modèle bon marché réduit une ligne de la facture, pas le projet. Le guide sur le coût du service client IA montre les autres lignes.
Comment eesel s'intègre-t-il à côté de DeepSeek 1017 ?
DeepSeek V4.1 Flash 1017 est une infrastructure, et eesel est l'employé. eesel est une plateforme de coéquipiers IA où vous recrutez des coéquipiers prêts à travailler pour des tâches précises, et pour le support, c'est le coéquipier IA de helpdesk. Il rejoint la file que vous gérez déjà, comme Zendesk ou Freshdesk, lit votre centre d'aide et vos anciens tickets, et est simulé sur des tickets historiques avant de répondre à qui que ce soit.

Les développeurs gardent le terminal. La CLI eesel (@eesel/cli) pilote le même coéquipier et le même espace de travail que ceux que vous voyez dans le tableau de bord. Vous pouvez connecter un helpdesk avec eesel integrations connect, modifier les règles permanentes du coéquipier avec eesel instructions, approuver les actions en attente avec eesel approvals et inspecter les exécutions avec eesel activity. La sortie est en JSON, les commandes d'écriture prennent en charge --dry-run, et un script ou un agent de code comme Claude Code peut la piloter. Chaque espace de travail fonctionne aussi comme serveur MCP, et le guide agent CLI montre le schéma.
Pour comparer les options côte à côte, lisez le guide d'achat et la liste des meilleurs agents de support.
Essayer eesel
Utilisez DeepSeek V4.1 Flash 1017 là où il brille : un travail d'agent bon marché et vérifiable. Si vous voulez une IA qui répond aux tickets dans votre helpdesk dès la semaine prochaine, le coéquipier IA d'eesel pour le helpdesk se branche sur l'outil que vous utilisez déjà, apprend de vos anciens tickets et montre comment il y aurait répondu avant qu'un client ne voie la moindre réponse. Essayez eesel gratuitement et lancez-le d'abord sur votre propre historique de tickets.
Questions fréquentes
DeepSeek V4.1 Flash 1017 est-il bon ?
Oui, pour les tâches d'agent et de code dont vous pouvez vérifier le résultat. Il obtient de meilleurs scores que la version de septembre sur les 11 benchmarks publiés par DeepSeek, et il bat Claude Opus 5 sur quatre d'entre eux. Il reste derrière en raisonnement pur, et les utilisateurs signalent plus d'hallucinations que les meilleurs modèles de pointe. Ma note est de 4/5 pour les développeurs. Les détails du lancement sont dans la présentation de la 1017.
DeepSeek V4.1 Flash 1017 vaut-il le coup ?
Si vous payez déjà un modèle de pointe pour des tâches d'agent, un essai vaut la peine. Le prix du token est le même qu'en septembre, mais le modèle produit des sorties plus courtes, donc une tâche terminée coûte moins cher. Consultez le guide tarifs de V4.1 Flash pour la grille complète. Si vos données sont sensibles, lisez d'abord la section sur la confidentialité.
Dois-je passer de la version de septembre à la 1017 ?
Vous avez déjà changé. Le nom deepseek-flash pointe désormais vers la 1017, tout comme les anciens noms deepseek-v4-flash. Ce qu'il faut faire, c'est relancer vos propres tests, car des sorties plus courtes peuvent modifier le comportement des boucles de votre agent CLI.
DeepSeek V4.1 Flash 1017 est-il meilleur que V4 Pro ?
Sur le coût par tâche, oui. deepseek-v4-pro coûte plus cher par token et n'a pas de vision, alors que Flash 1017 a la vision et un tarif plus bas. DeepSeek a gardé V4 Pro en service alors qu'il prévoyait de le retirer, et la comparaison Flash vs V4 Pro explique les niveaux.
DeepSeek V4.1 Flash 1017 est-il sûr pour les données du support client ?
Vérifiez d'abord avec votre équipe sécurité. La politique de confidentialité de DeepSeek indique que les données peuvent être stockées en Chine et qu'elle peut utiliser les entrées pour entraîner ses modèles, avec une possibilité de refus. Notre guide sur la confidentialité des données des agents IA liste les questions à poser à tout fournisseur, et la prévention des hallucinations dans le support traite de la fiabilité des réponses.
DeepSeek V4.1 Flash 1017 peut-il remplacer un agent IA de helpdesk ?
Non. C'est le moteur, et il vous faudrait encore construire les connexions aux connaissances, les actions dans le helpdesk, les règles d'escalade et les tests autour. Un agent IA de helpdesk comme eesel livre déjà ces éléments, et le guide d'achat montre comment comparer les deux approches.
DeepSeek V4.1 Flash 1017 a-t-il des poids ouverts ?
Oui, sous licence MIT sur Hugging Face, et DeepSeek recommande un max_tokens d'au moins 256K. L'exécuter soi-même demande un gros matériel, donc la plupart des équipes passent par l'API. Pour les options d'auto-hébergement, consultez notre sélection d'agents open source.
Comment DeepSeek V4.1 Flash 1017 se compare-t-il à Opus 5 ?
Dans le tableau de DeepSeek lui-même, la 1017 l'emporte sur DeepSWE, Automation-Bench, Agents' Last Exam et Apex Bench. Opus 5 l'emporte sur HLE, Terminal-Bench 4.0, ProgramBench et NL2Repo. Le coût est l'écart le plus marqué, voir les tarifs d'Opus 5 et mon avis sur Opus 5.