

Mon verdict sur MiniMax M3.1 Flash est 3,5/5 : un cheval de trait pour agents, bon marché et rapide, qui ne bat pas DeepSeek en code. MiniMax l'a lancé le 19 octobre 2026 à un tarif unique de $0.15 en entrée et $0.60 en sortie par million de tokens sur sa page de tarifs, sans supplément pour le contexte long sur sa fenêtre de 1M. Il domine le tableau de MiniMax sur Automation-Bench (62.8) et égale Claude Opus 5 sur BankerToolBench (76.2).
Le hic se trouve dans ce même tableau. Face à DeepSeek V4.1 Flash 1017, qui coûte autant en heures creuses, M3.1 Flash gagne un benchmark commun sur six et reste derrière sur DeepSWE (73.7 contre 77.0), Terminal-Bench 4.0 et NL2Repo. Son graphique de coût par tâche valorise DeepSeek aux tarifs de pointe, ce qui avantage MiniMax. Les poids sont promis pour le 23 octobre.
Je l'utiliserais donc pour des boucles d'agents de type bureautique, des appels d'outils et le travail sur de longs documents, et je choisirais DeepSeek pour le travail difficile sur dépôt. Pour les équipes support, le modèle est la plus petite partie du travail : le coéquipier IA helpdesk d'eesel apporte la connexion au helpdesk, les connaissances et un rejeu de vos anciens tickets, c'est ainsi que smava fait passer environ 27,000 tickets par mois.
Quel est mon verdict sur MiniMax M3.1 Flash ?
Je passe l'essentiel de ma semaine à regarder ce que les gens recherchent avant d'acheter, et les recherches autour de ce lancement sont directes : « is M3.1 Flash better than DeepSeek », « is it open source », « what does it cost ». Cet avis y répond, dans cet ordre. Si vous voulez la fiche technique simple de l'époque de la préversion, l'aperçu de M3.1 Flash de mon collègue couvre toujours le réglage d'effort et le contexte de 1M.
Je fais aussi partie d'une équipe qui fait tourner de l'IA sur de vraies files de support depuis des années, et cet historique influence ma façon de noter un modèle. Un modèle moins cher fait paraître « on le construit nous-mêmes » facile. Un client de taille moyenne qui a résilié nous l'a dit exactement ainsi en partant :
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Des modèles comme M3.1 Flash expliquent pourquoi cette phrase sonne juste. Qu'elle le soit dépend de tout ce qui entoure le modèle, alors je note à la fois le moteur et la distance qu'il vous fait parcourir.
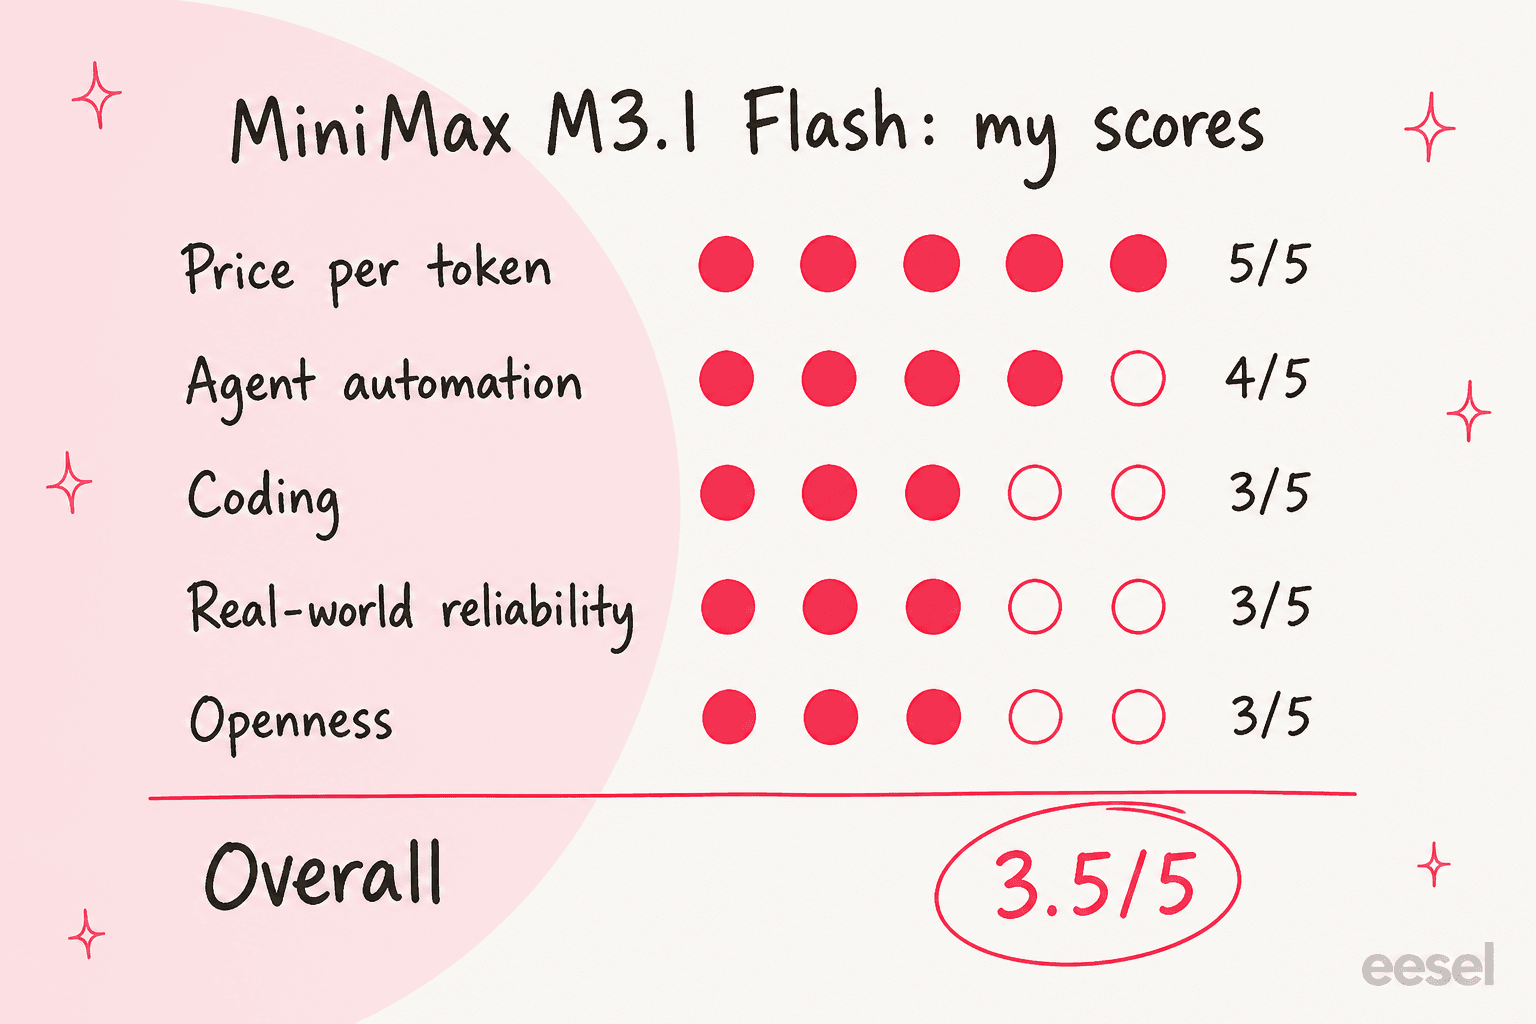
| Domaine | Note | Pourquoi |
|---|---|---|
| Prix par token | 5/5 | $0.15/$0.60 unique sur 1M de tokens, la moitié du tarif contexte court de MiniMax M3 |
| Automatisation d'agents | 4/5 | Meilleur sur Automation-Bench dans le tableau de MiniMax, égale Opus 5 sur BankerToolBench |
| Code | 3/5 | Derrière DeepSeek V4.1 Flash 1017 sur DeepSWE, Terminal-Bench 4.0 et NL2Repo |
| Fiabilité en conditions réelles | 3/5 | Les premiers testeurs signalent de la paresse et des divagations à effort élevé |
| Ouverture | 3/5 | Poids promis pour le 23 octobre, pas encore disponibles |
| Global | 3,5/5 | Un bon moteur bon marché pour boucles d'agents, pas le roi du code à bas prix |
Ces notes sont les miennes. Elles viennent du billet de lancement de MiniMax, de ses pages de documentation et de tarifs, des pages de tarifs des concurrents et de ce que les développeurs ont publié dans les premières 24 heures.
Qu'est-ce qui a vraiment été lancé le 19 octobre ?
La préversion dont j'ai parlé en septembre a disparu. La documentation de MiniMax liste désormais MiniMax-M3.1-Flash comme le dernier modèle de la série M, et la documentation M Plan indique que l'ancien nom MiniMax-M3.1-Flash-Preview a été retiré, les requêtes étant désormais servies par le nouveau modèle. Elle a aussi confirmé la rumeur de la période furtive : « Space Bunny », le modèle anonyme qui a traité plus de 200 000 milliards de tokens, était une version précoce.
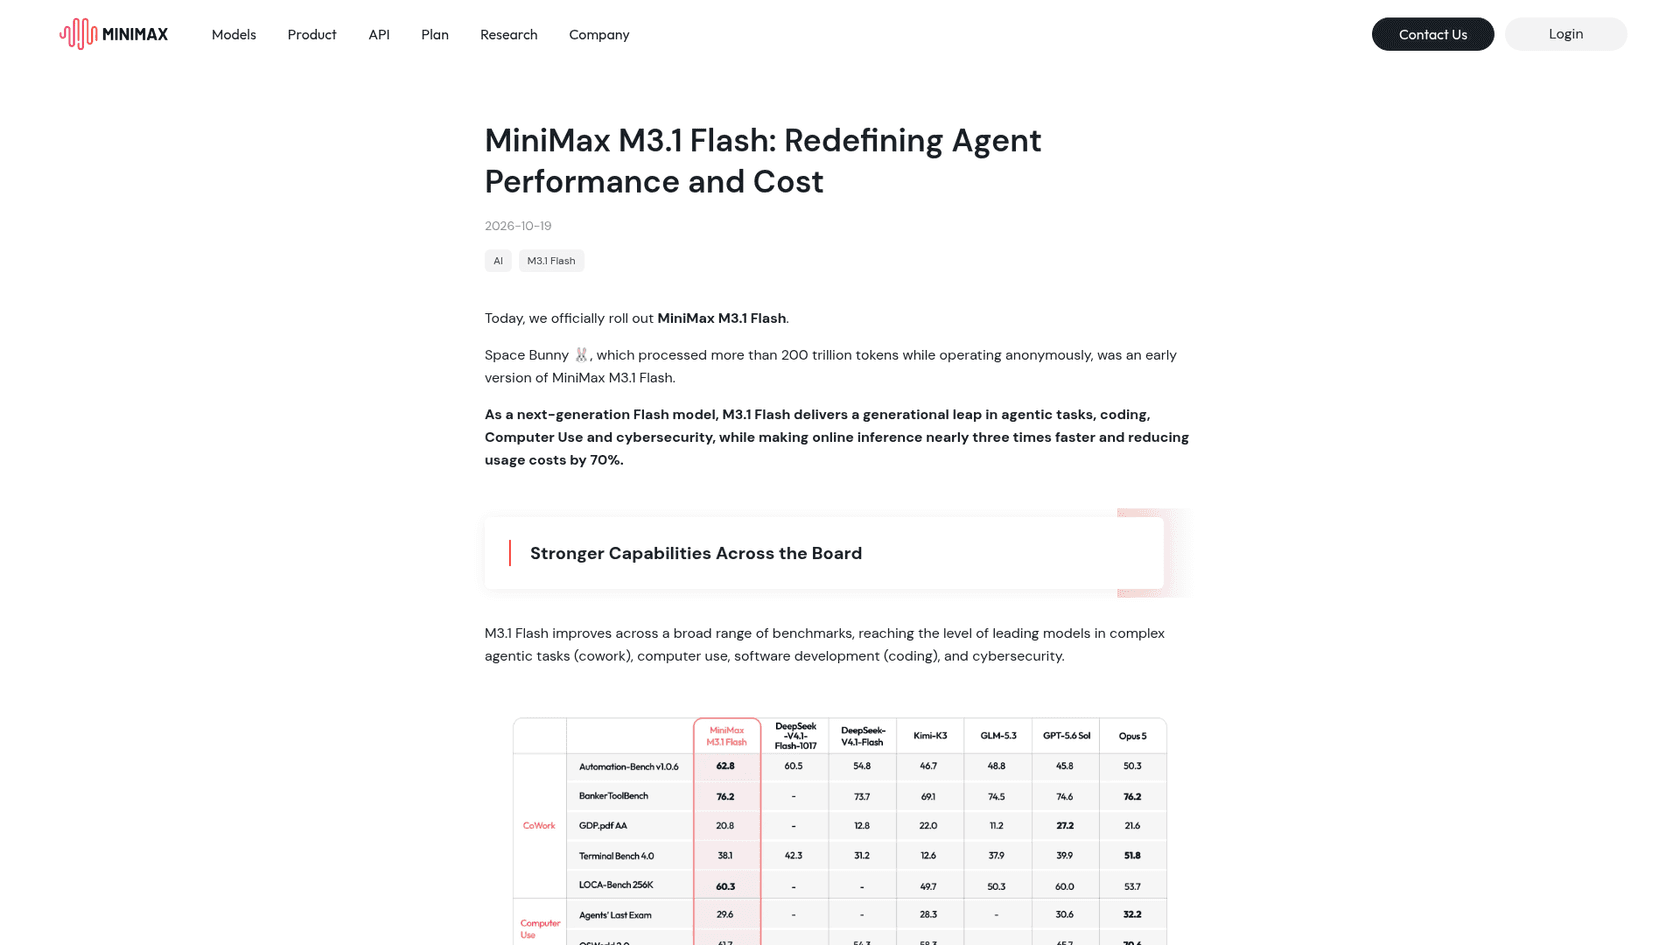
Voici ce qui a changé entre la préversion et la version générale :
| Préversion (27 sept.) | Version générale (19 oct.) | |
|---|---|---|
| ID du modèle | MiniMax-M3.1-Flash-Preview | MiniMax-M3.1-Flash |
| Disponibilité | MiniMax Code et Token Plan uniquement | API, M Plan et MiniMax Code |
| Prix par token | Aucun publié | $0.15 entrée / $0.60 sortie / $0.015 en cache |
| Vitesse annoncée | Aucune | 200+ tokens par seconde, P50 170+ |
| Benchmarks | Aucun | Tableau de 15 lignes face à six concurrents |
| Poids | Aucun | Promis pour le 23 octobre |
Trois choses sont restées identiques et conditionnent toujours l'usage. La fenêtre de contexte est de 1 000 000 de tokens. L'entrée peut être du texte, des images ou de la vidéo. Et la réflexion est toujours active : on règle effort de low à max (par défaut max), et envoyer effort: "none" renvoie une erreur 400, selon la documentation de génération de texte.
Un autre détail compte pour qui prévoit de l'héberger soi-même. Le nom « Flash » ne signifie pas petit. La page Code de MiniMax indique une architecture de mélange d'experts avec 428 Md de paramètres au total et environ 23 Md actifs, la même classe de taille que MiniMax M3. Un commentateur Reddit l'a bien dit :
"yeah fair point, the "flash" name is kinda misleading. same 428b / 23b active as m3, so if you could run m3 you can run this."

Où gagne-t-il ?
Les victoires se concentrent sur le travail d'agent de type bureautique : tâches en plusieurs étapes sur des logiciels métier, appels d'outils enchaînés et longs documents. Le tableau de MiniMax est ici la source, lisez donc ces scores comme annoncés par l'éditeur.
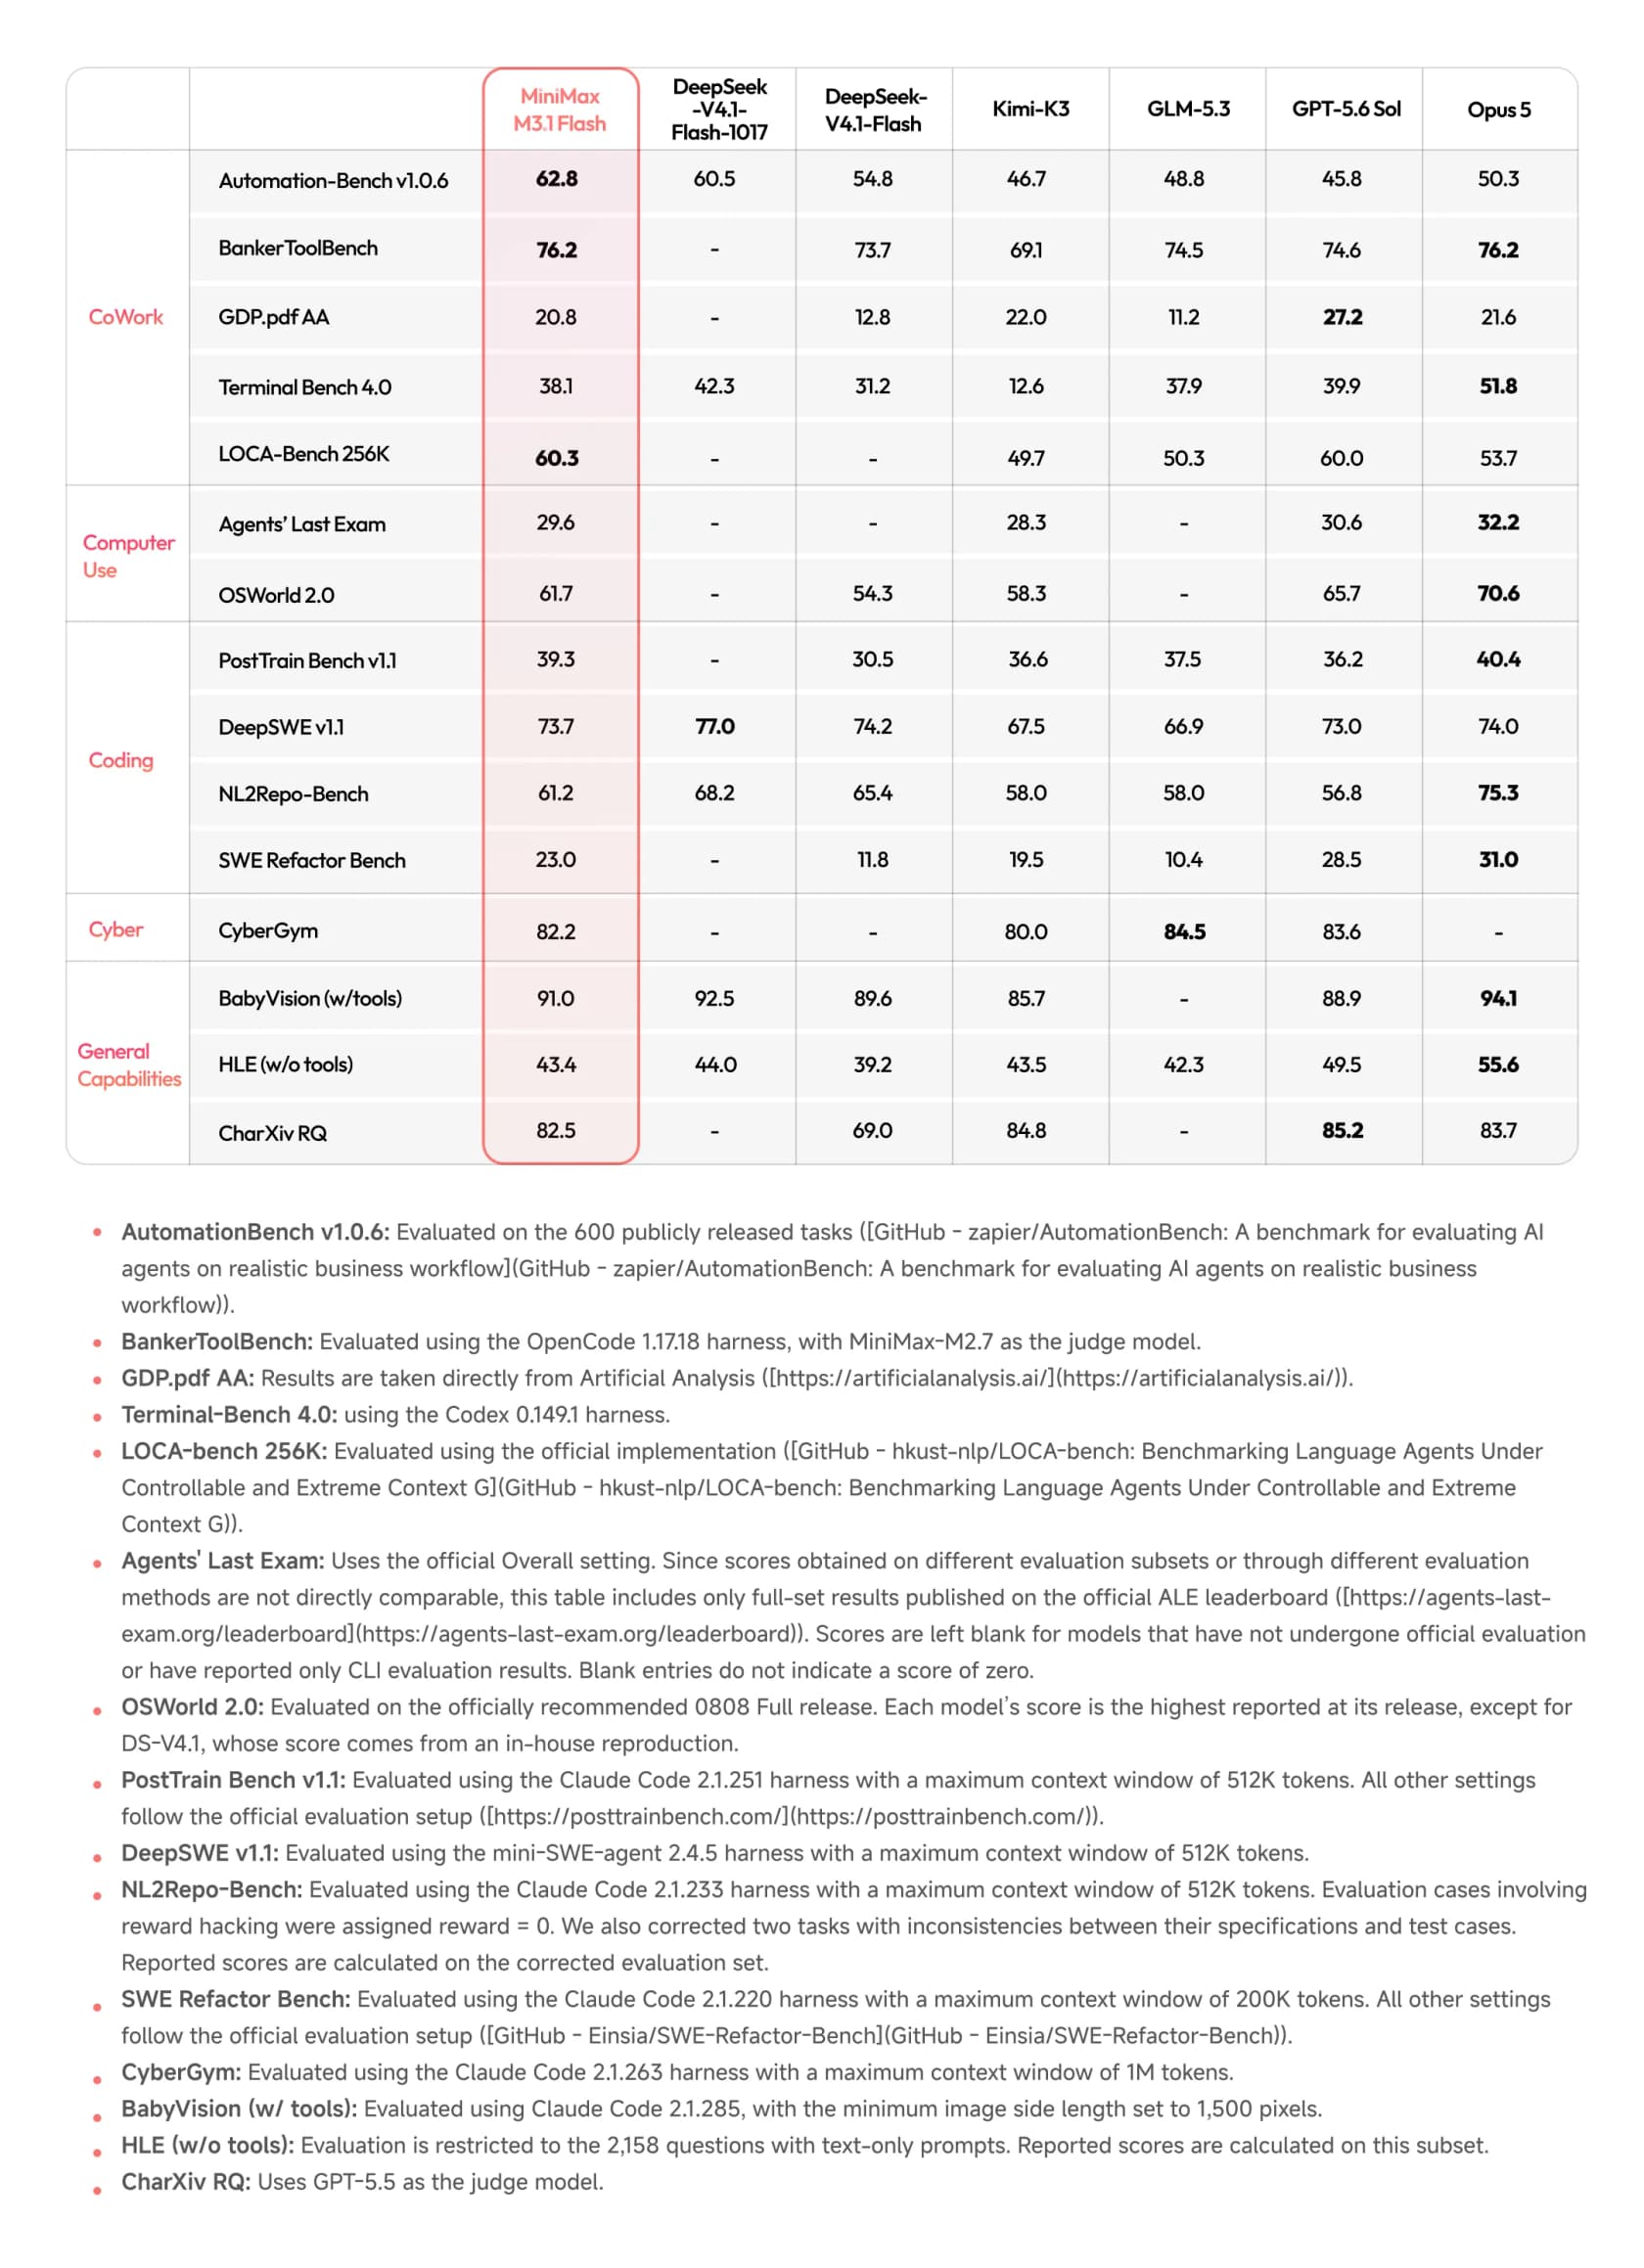
- Automation-Bench
62.8, le meilleur score du tableau, devant DeepSeek 1017 (60.5), Claude Opus 5 (50.3) et GPT-5.6 Sol (45.8). MiniMax le décrit comme de vrais workflows en ventes, marketing, opérations, service client, finance et RH. - BankerToolBench
76.2, à égalité avec Opus 5 et devant Kimi K3 (69.1). - LOCA-Bench 256K
60.3, le meilleur score d'agent à contexte long du tableau. - CyberGym
82.2, derrière seulement GLM-5.3 (84.5) et GPT-5.6 Sol (83.6).
Les graphiques de coût sont l'endroit où M3.1 Flash brille le plus. Sur le graphique Automation-Bench de MiniMax, M3.1 Flash à l'effort max atteint 62.8% pour environ $0.045 par tâche, et même l'effort low marque 52.8%, au-dessus de GPT-5.6, Kimi K3 et GLM-5.3 dans leurs meilleurs réglages. Sur le graphique Agents' Last Exam, il atteint 29.6% pour $111 au total, le point le moins cher de la frontière.
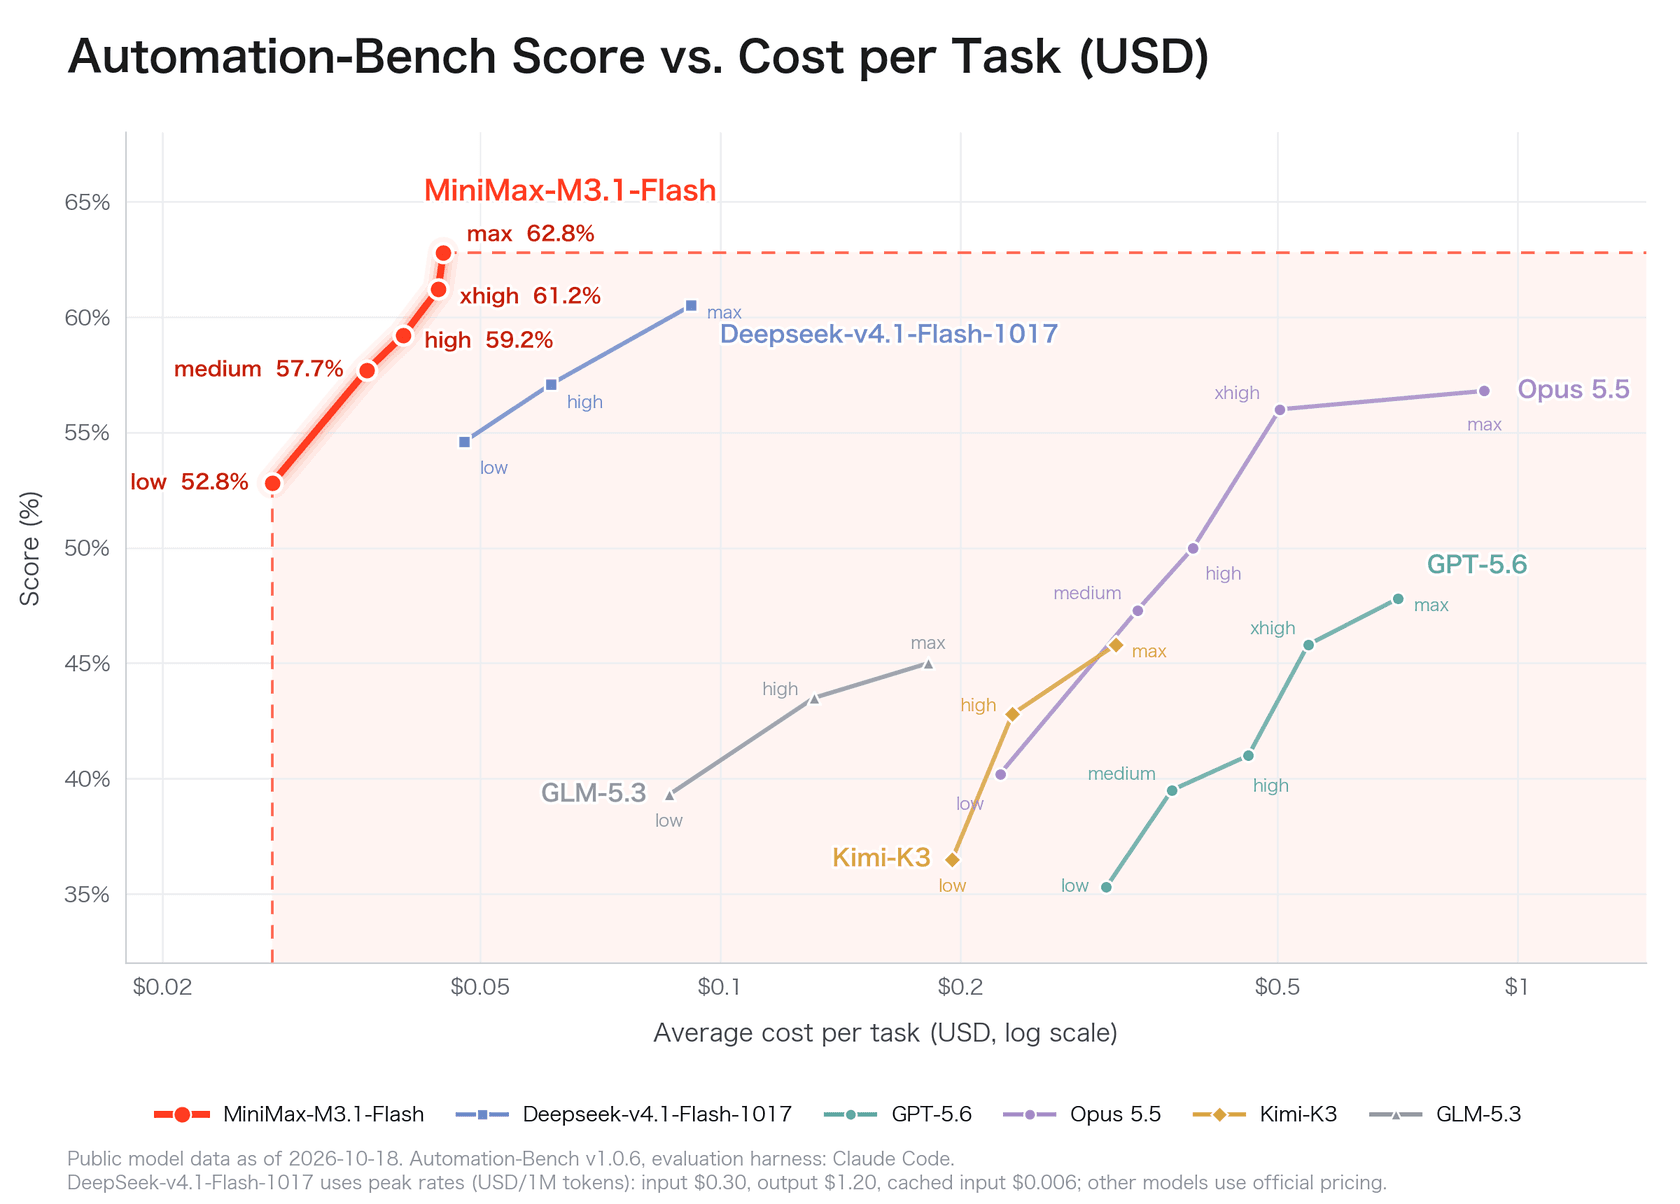
La vitesse est l'autre atout. MiniMax affirme que la sortie atteint 200+ tokens par seconde, avec une médiane de 170+, près de trois fois plus vite que M3. Les premiers utilisateurs ont confirmé la sensation, sinon le chiffre exact :
"first impression of minimax m3.1 flash been using model for the last few hours and it's a huge step up from m3. pretty good for flash model"
Où traîne-t-il derrière DeepSeek V4.1 Flash 1017 ?
C'est la section que la plupart des articles de lancement ont sautée. DeepSeek V4.1 Flash 1017 a un score sur six lignes de MiniMax et bat M3.1 Flash sur cinq d'entre elles :
| Benchmark (tableau de MiniMax) | M3.1 Flash | DeepSeek V4.1 Flash 1017 | Gagnant |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | M3.1 Flash |
| Terminal-Bench 4.0 | 38.1 | 42.3 | DeepSeek |
| DeepSWE v1.1 | 73.7 | 77.0 | DeepSeek |
| NL2Repo-Bench | 61.2 | 68.2 | DeepSeek |
| BabyVision (with tools) | 91.0 | 92.5 | DeepSeek |
| HLE (no tools) | 43.4 | 44.0 | DeepSeek |
Trois de ces défaites sont des tests de code, c'est pourquoi je donne un 3 en code. Sur le graphique de coût DeepSWE de MiniMax, la courbe de DeepSeek 1017 est à la fois plus haute et plus à gauche : environ 77% pour à peu près $0.20 par tâche à max, contre 73.7% pour à peu près $0.27 pour M3.1 Flash. L'aperçu de DeepSeek 1017 explique pourquoi ce modèle est devenu si bon marché par tâche.
Reste la note en bas de page. Le graphique Automation-Bench valorise DeepSeek 1017 aux tarifs de pointe, $0.30 en entrée et $1.20 en sortie. La page de tarifs de DeepSeek ne les applique qu'en semaine, de 01:00 à 04:00 et de 06:00 à 10:00 UTC. Toutes les autres heures sont en heures creuses à moitié prix, $0.15/$0.60, exactement le même tarif que M3.1 Flash. Mon calcul : aux tarifs creux, le point d'effort maximal de DeepSeek passe d'environ $0.09 à environ $0.045 par tâche, exactement là où se trouve M3.1 Flash, avec un score inférieur de seulement 2,3 points.
Les lecteurs de Hacker News ont remarqué le schéma en quelques heures :
"Not as strong as DeepSeek V4.1 Flash 1017 on deepswe so it's already dead to me."

C'est plus dur que ce que je dirais. M3.1 Flash gagne toujours en automatisation d'agents et coûte moins sans rien retirer. Mais ce n'est pas l'histoire nette du « moins cher et meilleur » que raconte le billet de lancement.
Combien coûte-t-il vraiment ?
Le prix est simple, ce que j'apprécie. M3.1 Flash a un seul tarif sur toute la fenêtre de 1M, alors que MiniMax M3 double au-delà de 512K tokens d'entrée.
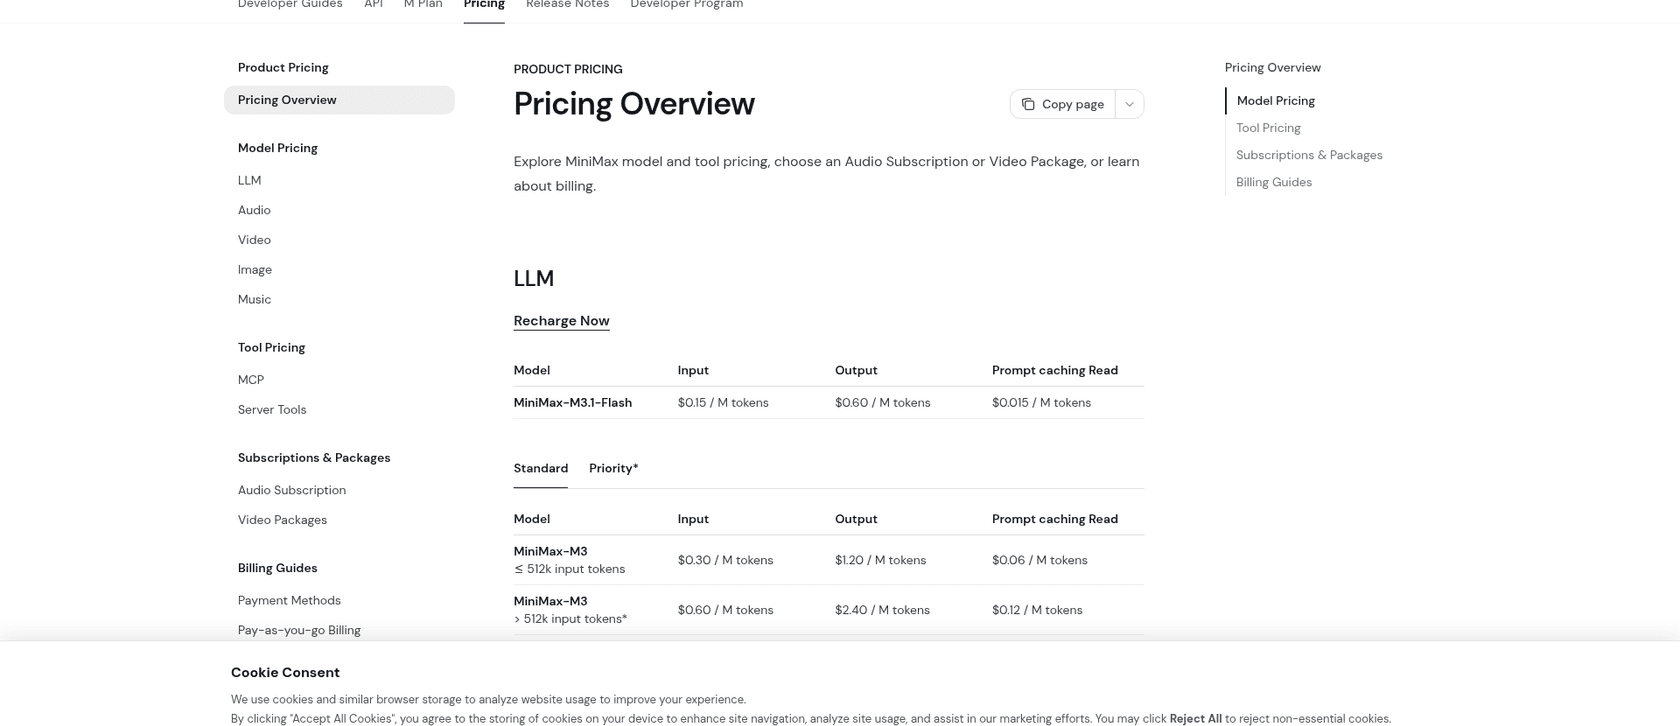
| Modèle (par 1M de tokens) | Entrée | Entrée en cache | Sortie | Source |
|---|---|---|---|---|
| MiniMax M3.1 Flash | $0.15 | $0.015 | $0.60 | MiniMax |
| MiniMax M3 (jusqu'à 512K) | $0.30 | $0.06 | $1.20 | MiniMax |
| MiniMax M3 (au-delà de 512K) | $0.60 | $0.12 | $2.40 | MiniMax |
| DeepSeek V4.1 Flash, heures creuses | $0.15 | $0.003 | $0.60 | DeepSeek |
| DeepSeek V4.1 Flash, heures de pointe | $0.30 | $0.006 | $1.20 | DeepSeek |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | OpenAI |
| Gemini 3.8 Flash (jusqu'au 31 déc. 2026) | $0.75 | $0.075 | $3.75 |
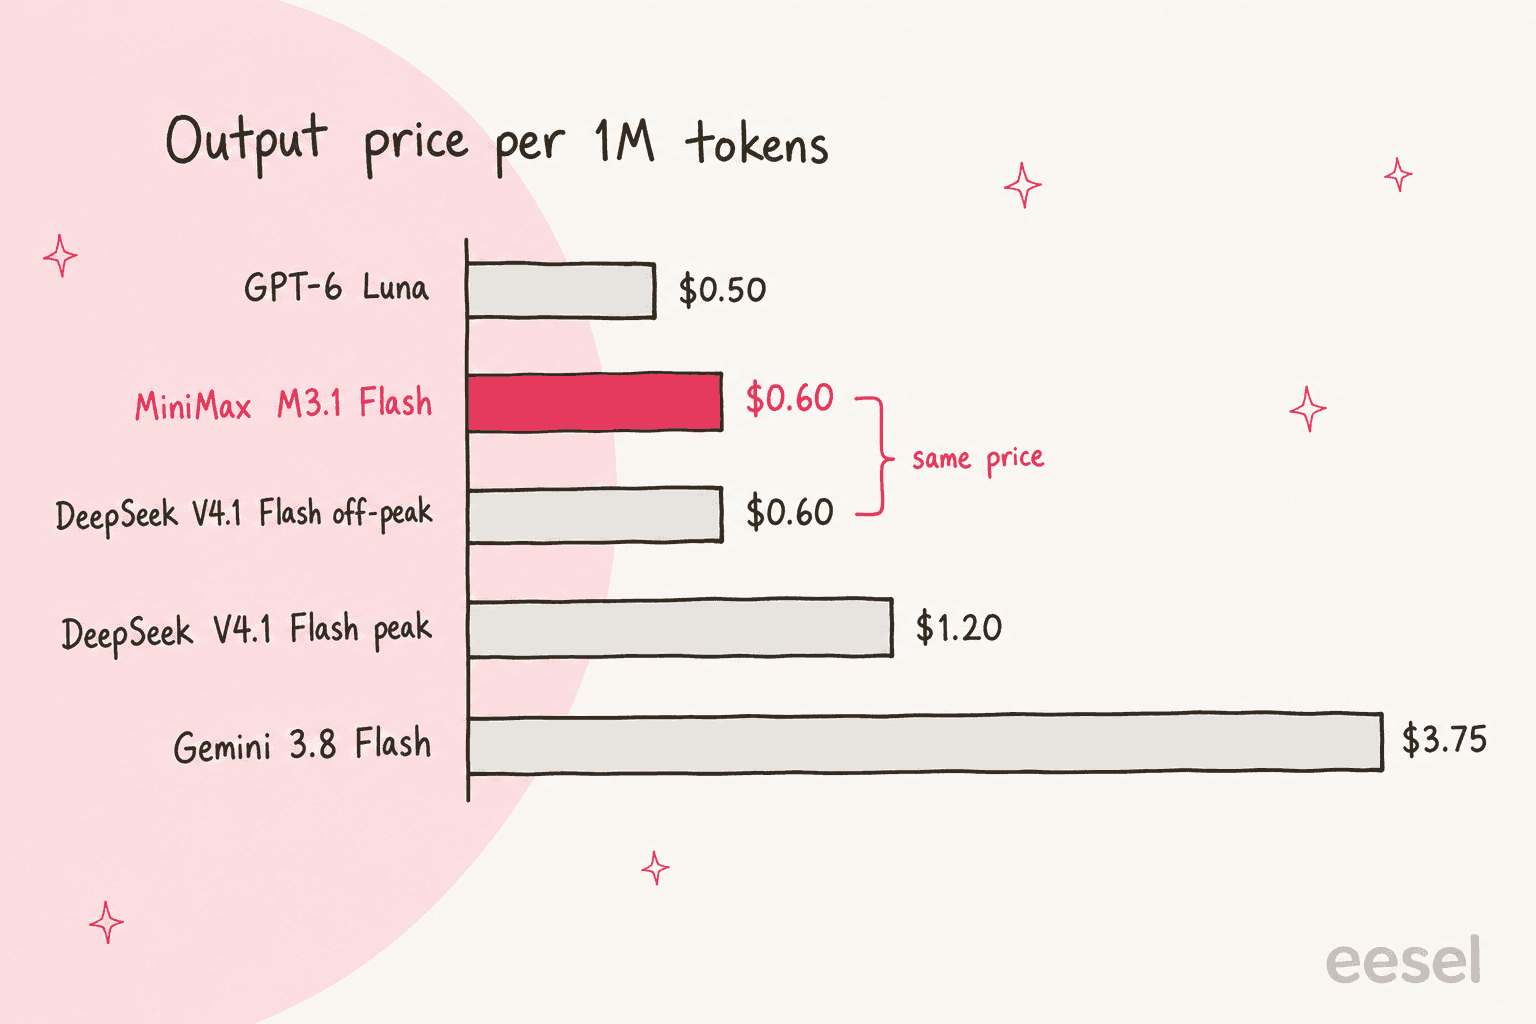
Deux choses ressortent. D'abord, l'entrée en cache est là où DeepSeek gagne encore : $0.003 en heures creuses contre $0.015 pour M3.1 Flash, cinq fois moins cher. Les boucles d'agents relisent sans cesse le même contexte, donc une charge qui utilise beaucoup le cache peut faire pencher la facture vers DeepSeek même à prix affiché égal. Ensuite, GPT-6 Luna est moins cher par token que les deux, et le détail des tarifs de Luna montre aussi son tarif de cache. Sur le graphique Agents' Last Exam de MiniMax, pourtant, les $111 au total de M3.1 Flash se situent bien sous le point de GPT-5.6 Luna, le prix du token seul ne tranche donc pas.
Si vous préférez payer un abonnement, le M Plan regroupe M3.1 Flash avec MiniMax Code et d'autres modèles. La facturation annuelle est de $220, $550 ou $1,320 par an pour les paliers Go, Explore et Build, qui offrent 1x, 3x et 7,5x l'usage de Go, réinitialisé par fenêtres de 5 heures et hebdomadaires. La FAQ M Plan de MiniMax elle-même indique que le plan est conçu pour un usage individuel et interactif et recommande le paiement à l'usage pour la production. Prenez-le au mot : l'abonnement est pour vos propres sessions de code, pas pour un produit qui sert des clients.
Que disent les vrais utilisateurs après un jour ?
Les premières réactions se partagent nettement. Les benchmarks ont impressionné. Les testeurs en conditions réelles ont été plus nuancés, et la plainte la plus fréquente concerne le comportement à effort élevé, qui est le réglage par défaut.
"I might get downvoted for this, but this model was WAY too lazy, even at Max effort"
Le même thème est venu d'un testeur sur X qui l'avait par ailleurs apprécié :
"hallucinates alot on xhigh or max and starts doing stuff i didn't ask for, and cuz of that model ends up being slow despite giving 100+ tok/s"
Sur Hacker News, un utilisateur qui avait essayé la version furtive a signalé un écart entre les scores et les résultats au quotidien :
"The deepswe and terminalbench4.0 scores don't seem to jive with what many opencode users' experience has been of this model while it was being tested as "space bunny"."
MiniMax dit que Space Bunny était un checkpoint antérieur, donc une partie de cela est peut-être corrigée. Tous les retours n'étaient pas négatifs. Un développeur qui avait utilisé la préversion dans MiniMax Code a apprécié sa façon de gérer l'incertitude :
"it found the real bug instead of patching around it, refused to pad weak results, wrote its own tests and got to 12/12 green, and said UNVERIFIED when it couldn't confirm something"
Le commentaire le plus juste que j'ai lu portait sur le temps, pas sur les tokens. Les modèles bon marché qui prennent deux fois plus de temps sont difficiles à justifier au travail :
"For a hobby project I do not mind that a cheaper model takes twice as long but at work it's hard to justify using a "cheaper" model if the time per task is so much higher than the frontier models."
Quels sont les avantages et les inconvénients ?
Avantages
- Tarif unique de
$0.15/$0.60sur 1M de tokens, sans palier de contexte long. - Meilleur score Automation-Bench du tableau de MiniMax et égalité avec Opus 5 sur BankerToolBench.
- 200+ tokens par seconde annoncés, environ trois fois M3.
- Fonctionne avec des clients de type Anthropic et OpenAI, donc Claude Code, Codex, Cursor et OpenClaw peuvent le cibler.
- Poids ouverts promis pour le 23 octobre.
Inconvénients
- Derrière DeepSeek V4.1 Flash 1017 sur cinq benchmarks communs sur six, y compris tous les tests de code.
- L'entrée en cache coûte cinq fois le tarif en heures creuses de DeepSeek.
- La réflexion ne peut pas être désactivée, et le réglage par défaut est
max, où les testeurs signalent paresse et dérive. - 428 Md de paramètres au total, l'usage local exige donc une grosse machine.
- Le M Plan est pour un usage personnel, le trafic de production passe donc par des clés à l'usage.
Quel modèle bon marché convient à votre tâche ?
Choisissez la tâche que vous voulez exécuter. Le widget montre le modèle par lequel je commencerais et pourquoi.
Qui devrait l'utiliser, et qui devrait s'en passer ?
Utilisez-le si vous faites tourner des boucles d'agents sur des outils métier, des tableurs ou de longs documents et que le coût par tâche compte. Les résultats d'Automation-Bench et de BankerToolBench pointent droit vers ce travail, et le tarif unique rend les longs contextes indolores. Il convient aussi aux développeurs déjà dans MiniMax Code qui veulent un modèle par défaut rapide.
Passez votre tour, pour l'instant, si votre travail principal est le code difficile sur dépôt. DeepSeek V4.1 Flash 1017 obtient de meilleurs scores sur toutes les lignes de code du tableau pour le même prix en heures creuses, et Qwen 3.8 Flash Next revient souvent chez ceux qui s'auto-hébergent.
Si vous voulez un modèle de pointe et pouvez le payer, GPT-6 Sol et Claude Opus 5.5 restent un cran au-dessus.
Attendez si vous voulez l'exécuter vous-même. Les poids sont attendus le 23 octobre, et sa taille exige une grosse machine multi-GPU ou un ordinateur à grande mémoire unifiée.
Que signifie-t-il pour une équipe support ?
AutomationBench cite le service client parmi ses workflows, il est donc tentant de lire un score élevé comme « prêt pour ma file ». Je ne le ferais pas. Un benchmark vérifie si le modèle a terminé une tâche scénarisée. Votre file demande si la réponse était juste pour ce client, selon votre politique, avec vos règles de remboursement, et si le modèle a su laisser un ticket tranquille.
Si vous construisez votre propre flux de support sur M3.1 Flash, voici ce qui reste à votre charge :
- Le pipeline de connaissances qui lui fournit votre centre d'aide et vos anciens tickets.
- La connexion au helpdesk qui lit les tickets et écrit les réponses.
- Les règles de passage de relais, au cœur de la déviation de niveau 1.
- Les tests sur l'historique réel, qui permettent de repérer les hallucinations dans le support.
Rien de cela n'est un problème de modèle, c'est pourquoi un modèle moins cher réduit une ligne de la facture, pas le projet. Le guide sur le coût du service client par IA couvre le reste, et la comparaison coût d'un agent IA contre humain le replace en contexte.
Comment eesel s'inscrit-il aux côtés de M3.1 Flash ?
MiniMax M3.1 Flash est de l'infrastructure. eesel est l'employé. eesel est une plateforme de coéquipiers IA où vous embauchez des coéquipiers prêts à travailler pour des tâches précises, et pour le support c'est le coéquipier IA helpdesk. Il rejoint la file que vous gérez déjà, comme Zendesk ou Freshdesk, apprend de votre centre d'aide et de vos anciens tickets, et rejoue les tickets historiques pour que vous voyiez ses réponses avant un client.
Voici ce que cela donne à grande échelle. smava, une plateforme berlinoise de comparaison de prêts, fait tourner trois agents eesel sur un seul Zendesk pour deux marques : un catégorise chaque ticket, un rédige la réponse à partir d'environ 820 macros et articles du centre d'aide, et un par marque prépare la réponse prête pour le client. Entre le 8 août et le 8 septembre 2026, cela représentait environ 27,000 tickets, avec des personnes qui approuvent les brouillons. SE Ranking fait tourner un agent distinct pour chacun de ses trois produits sur le chat en direct de Zendesk, environ 4,650 conversations en un mois, avec les remboursements et les cas de niveau 2 transmis à l'équipe avec les informations du client jointes.

Si vous êtes du genre à lire un avis sur un modèle, vous voudrez probablement le terminal. La CLI eesel (@eesel/cli) pilote le même coéquipier que vous voyez dans le tableau de bord. eesel integrations connect zendesk branche un helpdesk, eesel files upload ajoute des connaissances, eesel instructions modifie les règles permanentes, eesel approvals liste les actions en attente d'une personne et eesel activity montre ce que l'agent a fait. Chaque commande affiche du JSON, donc Claude Code ou Cursor peuvent exécuter la configuration pour vous, et chaque espace de travail fonctionne aussi comme serveur MCP. Le guide de la CLI d'agents montre le schéma.
Pour comparer les options de support côte à côte, commencez par la liste des meilleurs agents de service client ou par l'argumentaire plus large en faveur des coéquipiers IA.
Essayer eesel
Utilisez M3.1 Flash là où il brille : des boucles d'agents rapides et bon marché que vous pouvez vérifier. Si ce qu'il vous faut, c'est une IA qui répond aux tickets dans votre helpdesk la semaine prochaine, le coéquipier IA helpdesk d'eesel se branche sur l'outil que vous utilisez déjà, apprend de vos anciens tickets et montre comment il y aurait répondu avant qu'aucun client ne voie une réponse. C'est ainsi que smava obtient 15,300 brouillons par mois sans céder le contrôle. Essayez eesel gratuitement et lancez-le d'abord sur votre propre historique de tickets, ou consultez les tarifs d'eesel avant de commencer.