

Une semaine de lecture, entièrement consacrée à deepseek-v4-flash-vision-exp. La documentation. Le tableau complet des benchmarks. Trois jours de télémétrie de production, puis les 153 commentaires du fil de lancement. La découverte la plus utile est qu'il s'agit d'un meilleur modèle de texte déguisé en sortie de vision. Six des sept lignes d'agents textuels lui reviennent face à V4-Flash, dans le tableau de DeepSeek lui-même. Et le plus gros consommateur public pour l'instant ? Un outil de programmation qui n'envoie jamais d'image.
Sur la partie vision elle-même, le résumé honnête est plus étroit que la note de lancement, et plus étroit aussi que la réaction hostile. La mise en page, il la gère, les formes de graphiques aussi, et la structure d'une capture d'écran. Les petits caractères, c'est là que tout se brise, parce que chaque image est aplatie vers du 800 par 800 avant toute autre chose, et il n'y a pas de mode haute résolution à activer. L'ensemble de vérification de légendes d'un testeur : 6 sur 12, contre un concurrent à 11 sur 12. La manière dont il a échoué vaut pourtant mieux que le score. Face à une photo de la cathédrale de Wells légendée "Salisbury", il a acquiescé. L'histoire des benchmarks s'adoucit aussi à la seconde lecture. Le chiffre phare de DeepSWE tombe dans la barre d'erreur d'un concurrent, les gains multimodaux mesurent en partie "un modèle voit, l'autre non", et tout le tableau sort du propre harnais de DeepSeek, le jour du lancement.
Si vous comptez pointer tout cela vers une file de support, c'est l'échec par acquiescement qui mérite qu'on s'y arrête. Un modèle qui confirme n'importe quelle étiquette qu'on lui tend est exactement le mode d'échec qui coûte de l'argent au support, et un modèle plus gros n'y change rien. Ce qui le corrige, c'est d'ancrer l'agent dans votre vrai contenu d'aide, puis de le rejouer sur vos propres anciens tickets avant qu'un client en voie un mot. C'est précisément pour cela qu'eesel est conçu.
Ce que j'ai testé, et ce que je n'ai pas testé
Je construis des agents IA chez eesel, donc devant une sortie comme celle-ci, mon réflexe est de m'attaquer d'abord au mécanisme. Ce que le modèle voit réellement. Ce que fait le harnais avant que les poids ne voient le moindre pixel. Et où l'échec va se produire quand de vraies entrées arriveront. C'est la grille de lecture de tout cet avis.
Voici la méthodologie, énoncée clairement pour que vous la décotiez à la juste mesure. J'ai lu le guide de la vision ligne par ligne, fait de même avec la page des tarifs, puis extrait trois jours de vraie télémétrie de production d'OpenRouter.
Ensuite, j'ai parcouru chacun des commentaires du fil de lancement, qui a atteint 495 points et 153 commentaires. Quand un résultat d'usage est cité ici, les mains sont celles de quelqu'un d'autre, et je dis de qui.
Ce que je n'ai pas fait : mener ma propre évaluation de vision contrôlée sur quelques centaines d'images. C'est important, car la plus grande leçon de ce fil est que les tests de vision sur de petits échantillons produisent des conclusions sûres d'elles et fausses, et commettre précisément l'erreur dont parle ce texte serait mal venu. Prenez donc ceci comme une revue des preuves, pas comme un benchmark de ma part.
Si vous voulez la sortie expliquée de bout en bout, avec le calcul des prix et le tableau complet des limites, c'est dans mon analyse de la sortie. Ce texte-ci ne cherche qu'à savoir si la chose est bonne.
Le test de l'horloge est une étude de cas de ce qu'il ne faut pas faire pour évaluer un modèle de vision
L'échange le plus lu de tout le fil de lancement porte sur une horloge. Il vaut la peine de le parcourir dans l'ordre, car c'est l'illustration la plus nette que j'aie vue de la façon dont les avis sur la vision dérapent.
Cela a commencé par un rapport d'échec direct :
"It fails the simple clock test for me which Qwen3.8 27B got (nearly) right."

Le détail est pire que ce résumé. Face à une horloge analogique générée, DeepSeek a répondu 5:10, ratant l'aiguille des heures de trois heures et confondant en plus la couleur de chaque aiguille. Qwen3.8 27B a dit 8:10. L'heure réelle était 08:09:25, donc les deux se sont trompés, mais de manières différentes, et la lecture d'un commentateur sur la différence est plus fine que la plupart des commentaires de benchmarks :
"Also worth noting that both models got it wrong. Qwen made a mistake that humans very good at reading clocks would make. Deepseek made a mistake that a human who had just learned to read clocks would make."
Puis quelqu'un a refait l'essai, et le constat s'est retourné.
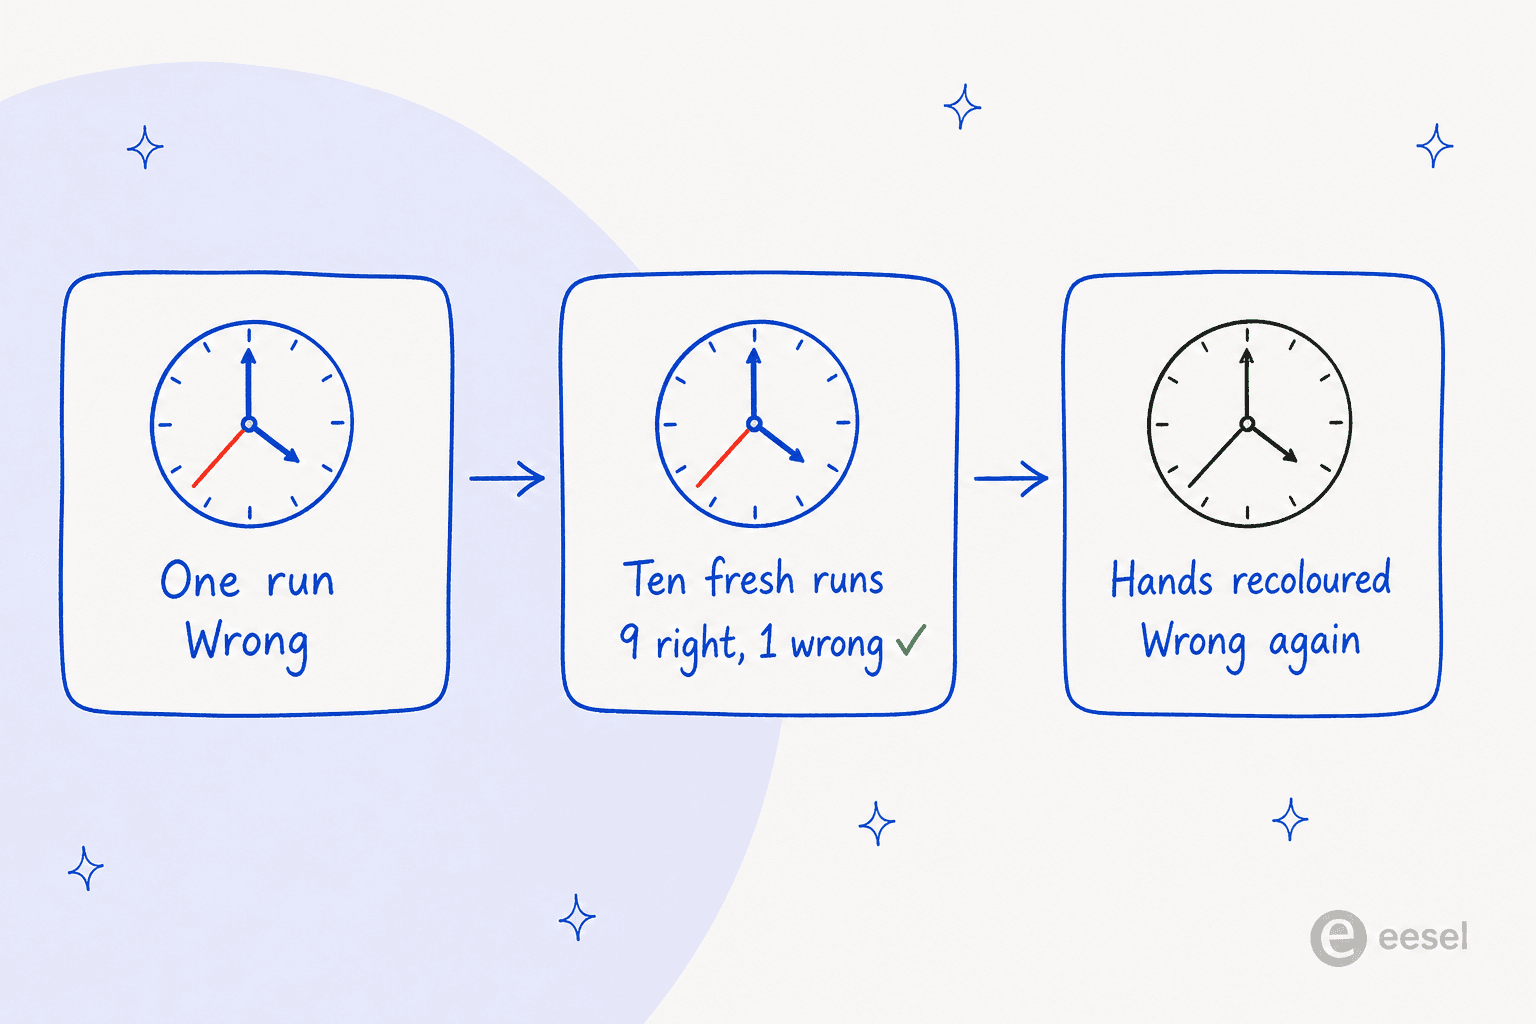
"I now ran the test 10 times total, fresh session every time, and DS4 got it right 9 out of 10 times. Lesson learned to double check what I read on the internet."
Le modèle va donc bien ? Pas tout à fait, et c'est là que cela devient intéressant. Trois personnes différentes ont décortiqué la reprise.
D'abord, la notation était indulgente. Ces neuf réponses "correctes" étaient toutes 8:10, alors que l'heure réelle sur le cadran était 8:09:25, et un lecteur l'a signalé directement :
"fwiw the clock reads 8:09:25 not 8:10:25 although it would be passable to read it as 8:10 if there were no second hand"
Ensuite, l'image de test elle-même était bizarre. Chaque aiguille de l'horloge avait une couleur différente, ce qui ne ressemble pas du tout à une horloge ordinaire, et un lecteur a admis que le dessin l'avait trompé lui aussi :
"I know that the hand lengths and thicknesses on this image are correct but for some reason I, a totally human person who grew up when analog clocks were still common, see this and think the hand on the 5 is the minute hand."
Enfin, et c'est le point de diagnostic, l'auteur original a repris cette suggestion et refait le test avec toutes les aiguilles dessinées en noir. DeepSeek a alors répondu 8:25, perdant complètement la trotteuse et la promouvant en aiguille des minutes. Ce qui laisse fortement penser qu'il se fiait à la couleur des aiguilles depuis le début et non à leur longueur. Les 9 sur 10 étaient donc réels. La raison sous-jacente n'était pas celle que tout le monde supposait.
Et la découverte qui recadre tout le sous-fil est venue de quelqu'un qui a simplement fait passer la même image partout ailleurs :
"Gemini 3.7 Flash and 5.6-Sol (on all reasoning levels) also answer 8:10:25. The new "stealth" Ox Alpha also replies with the same. Opus 5 replies with 8:10 (no seconds). Not sure why this is so hard for them; Gemini is especially good at vision and I would have expected better from it."
Aucun de ceux qui ont été testés n'est tombé sur 8:09:25. Ni Gemini, ni Opus 5, à aucun niveau de raisonnement. Ce qui ressemblait à une faiblesse de DeepSeek avec n=1 s'est donc révélé un angle mort partagé par toute la frontière, et toute l'agitation s'est résolue en un fait sur les horloges analogiques plutôt qu'un fait sur ce modèle.
Il y a un contre-argument raisonnable sur la pertinence même de ce test, et un lecteur l'a bien formulé :
"Reading any analog clock at any time level (edit: and a non-noisy vector rendered image at that) is absolutely table stakes for an allegedly frontier flagship vision model. As much as 1:1 OCR."
J'ai de la sympathie pour ce point de vue. Et ce n'est pas non plus une tâche hypothétique : un commentateur a décrit avoir demandé à un agent de programmation de tester un jeu de lecture de l'heure pour ses enfants en faisant des captures de la version Godot, ce qui est exactement ce problème au sein d'un vrai flux de travail logiciel.
La leçon opérationnelle, pourtant, est celle que j'afficherais sur un mur. Un seul test de vision ne dit presque rien. La variance entre exécutions identiques était assez grande pour renverser le verdict à elle seule. La conception du stimulus a changé le mode d'échec, et le seuil de notation a changé le score. Si vous évaluez un modèle de vision pour du vrai travail, celui-ci compris, faites-le tourner de nombreuses fois sur vos propres entrées, puis notez strictement. C'est le même principe que celui d'un vrai contrôle qualité du support plutôt que de se fier à une démo.
Où le redimensionnement pénalise vraiment, et où non
Le mécanisme est simple, et c'est aussi la chose la plus importante de ce modèle. Avant l'inférence, DeepSeek redimensionne chaque image pour que le nombre total de pixels tombe à peu près là où tomberait une image de 800 par 800, en conservant le rapport d'aspect. Il en résulte un plafond strict de 384 tokens pour une image, et la documentation énonce la conséquence sans détour : une image de 2000 par 2000 et une de 5000 par 5000 consomment le même nombre de tokens.
Un commentateur a mis ce chiffre en perspective mieux que ne le fait la documentation :
"800x800 is 640,000 pixels, or 0.64 Megapixels. That is less than the resolution of computer screens from 1995, Super VGA which has around 0.79 MPs."
La question utile n'est pas "0,64 Mpx suffit-il", mais "suffit-il pour quoi". Et la réponse se range presque entièrement selon la taille des caractères ; la difficulté de la tâche joue à peine.
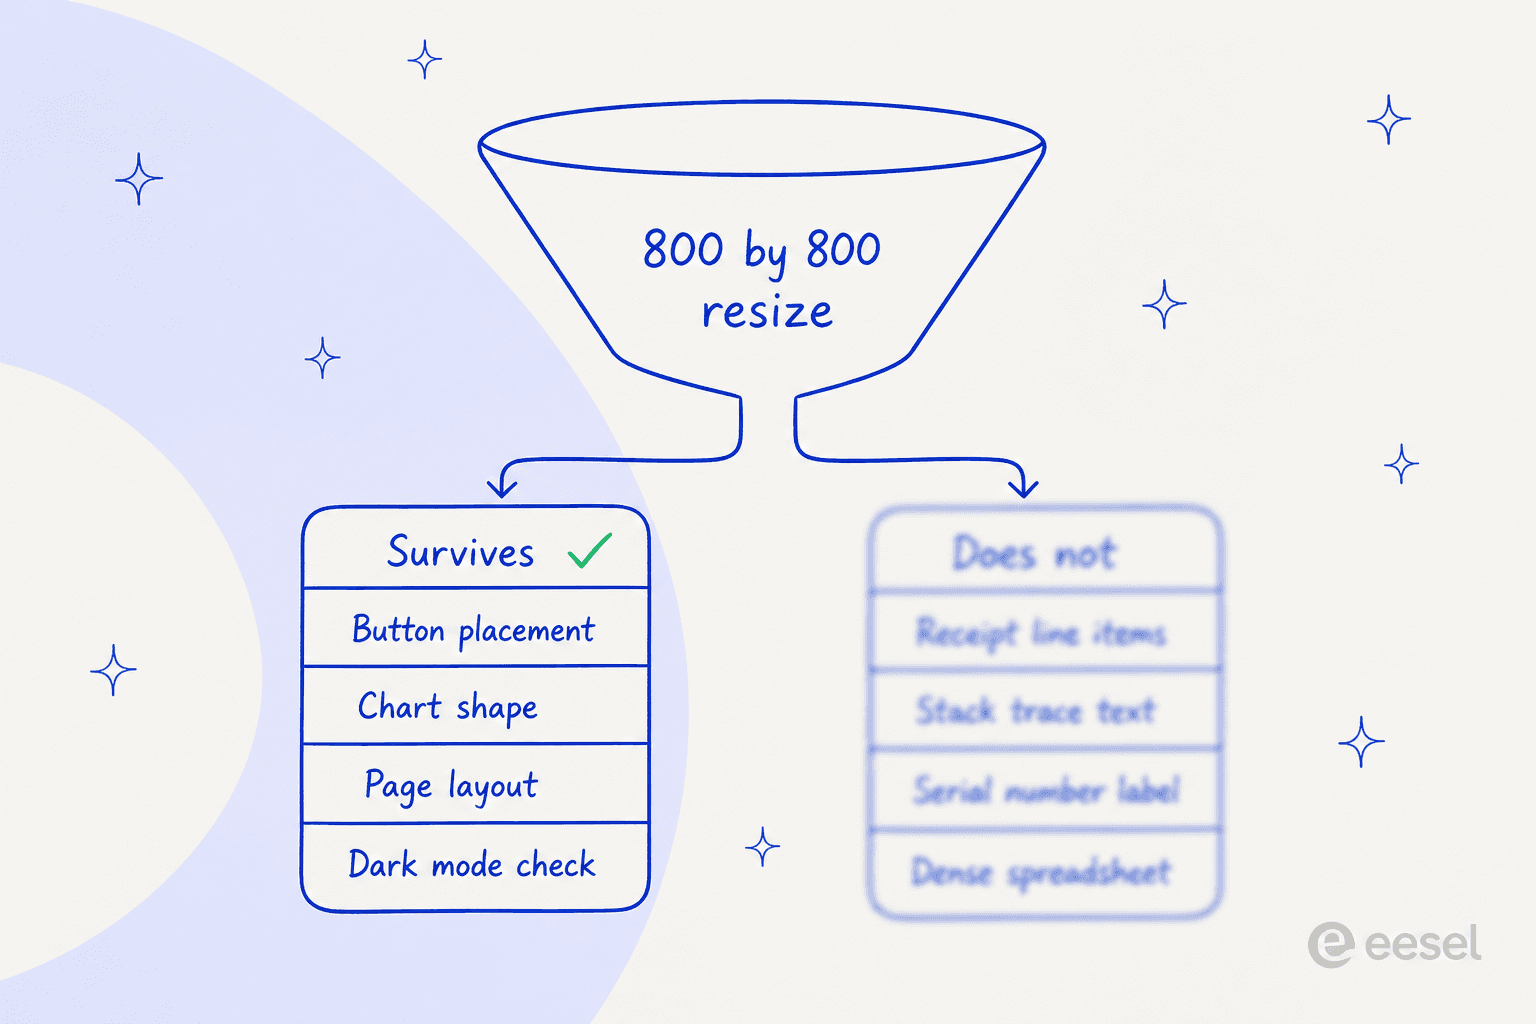
Vérifier qu'un bouton s'affiche au bon endroit, lire la forme d'un graphique, contrôler une mise en page en mode sombre, confirmer la structure d'une page : tout cela survit à une réduction sans difficulté. Lire les lignes d'un reçu, une stack trace dans une boîte de dialogue d'erreur, un numéro de série sur une étiquette de produit ou un tableur dense : c'est là que ça s'effondre. Une page entière de document se situe pile à la frontière, et un lecteur l'a signalé immédiatement :
"It's useful but for OCR and a lot of other applications it needs to be a bit higher (eg: putting in a full A4 / Letter sized page)"
Pour rendre cela concret plutôt qu'une règle empirique, voici le calcul appliqué à vos propres entrées. Saisissez les dimensions d'une image que vous enverriez réellement, ainsi que la hauteur en pixels du plus petit texte qu'elle contient.
Avec une capture de 2560 par 1440 et un texte d'interface de 14 px, le plus petit texte tombe à 5,8 px. Descendez à une capture ordinaire de 1920 par 1080 et vous obtenez 7,8 px. Une capture normale avec un texte d'interface normal n'atteint pas le seuil, et c'est la version inconfortable de l'histoire, car ce qui revient est une réponse plausible parfois fausse, jamais un échec évident.
Le contournement auquel le fil est collectivement arrivé est un outil de recadrage, et un commentateur a détaillé le pipeline exact qu'il utilise :
"When the LLM tries to read an image, it will be resized by DeepSeek's server to 800x800, which might be a bit blurry. The LLM will then crop a smaller image from the high resolution image (using e.g. the
converttool via bash) and will then read the small cropped image. This image will still be resized to 800x800 by DeepSeek's server, but since it is already small, there is no or little loss of quality."
Cela fonctionne, et plusieurs personnes ont confirmé que cela marchait pour elles. Mais ce n'est pas gratuit. La variante par grille de la même idée, où l'on découpe une grande image en tuiles et où l'on traite chaque cellule, coûte au moins le double en tokens selon l'estimation d'un commentateur, et recoller neuf recadrages en une compréhension spatiale unique est un problème en soi. Si vous le construisez vous-même, c'est un bon morceau de travail de harnais par-dessus une boucle d'appel d'outils que vous devez déjà maintenir. Plusieurs des agents open source qui valent le coup d'œil en livrent déjà un équivalent.
Et la défense selon laquelle un modèle rapide et bon marché doit simplement plafonner sa résolution ne survit pas tout à fait au contact de la concurrence. Quelqu'un a soutenu exactement cela, et la réponse est arrivée aussitôt :
"Gemini "flash" models have an option for media resolution, including a high resolution option for screenshots."
C'est la comparaison la plus honnête de tout le fil. Un concurrent du même palier de vitesse et de coût expose bien ce réglage, et Google construit de la vision agentique dessus. Le paramètre detail de DeepSeek semble devoir faire de même, mais non. low réduit bien à 512 par 512, tandis que high, original et auto signifient aujourd'hui tous la même chose : conserver l'original et appliquer quand même le redimensionnement standard.
Il faut aussi dire que beaucoup ont rapporté que le plafond n'était pas un problème pour leur travail réel. L'un l'a dit sans détour :
"It can read and extract information from screenshots and PDFs just fine (my setup). No need to worry about edge cases."
Un autre a noté que si ses captures dépassent 800 px, il aurait probablement pu mieux cadrer la capture dès le départ. Les deux points sont justes. Le plafond est une contrainte et non un défaut, et qu'il vous gêne dépend entièrement de ce vers quoi vous le pointez.
Le tableau de benchmarks est plus mou qu'il n'y paraît
Passons aux chiffres, la partie que la plupart des avis reproduisent sans la lire de près.
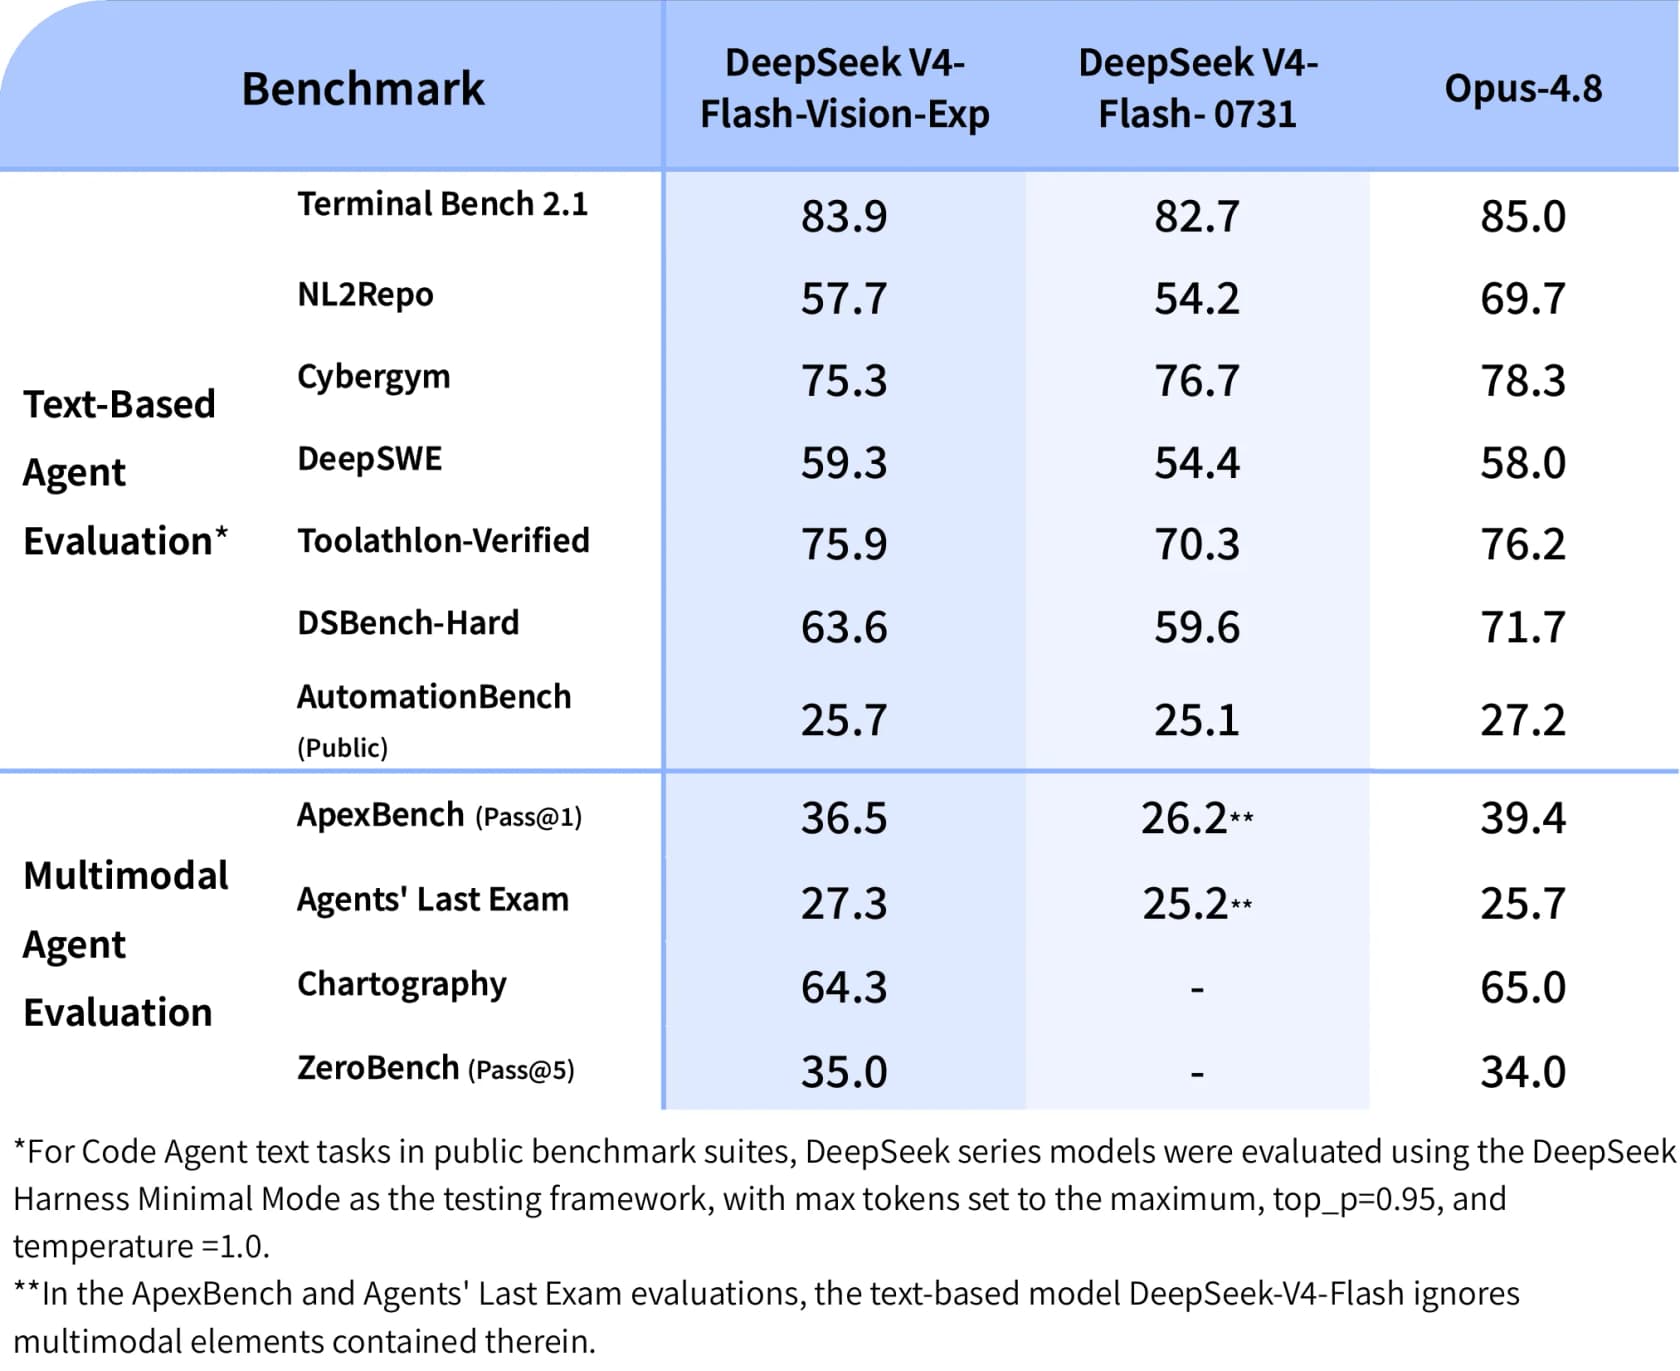
Commençons par ce qui tient. Sur les sept lignes d'agents textuels, la version avec vision bat le V4-Flash texte seul sur six : DeepSWE 59,3 contre 54,4, Toolathlon-Verified 75,9 contre 70,3, NL2Repo 57,7 contre 54,2, DSBench-Hard 63,6 contre 59,6, Terminal Bench 2.1 83,9 contre 82,7, AutomationBench 25,7 contre 25,1. La seule défaite est Cybergym, 75,3 contre 76,7. La note de sortie de DeepSeek elle-même parle d'"égaler" V4-Flash en texte, ce qui sous-vend largement son propre résultat.
Trois réserves s'ajoutent à cela, et chacune vient de quelqu'un qui a lu le tableau plus attentivement que la couverture du lancement.
Le chiffre phare chevauche la barre d'erreur d'un concurrent. Sur la ligne DeepSWE, un lecteur a aligné les intervalles :
"The DeepSWE benchmark they report (59.3%) overlaps with the confidence interval of 5.6-Sol Medium (61% +/- 2%), but likely at 1/18th the cost (they did not report the DeepSWE benchmark cost, but v4-flash had this cost ratio against Sol Medium)."
Donc "bat un modèle de pointe sur DeepSWE" signifie en réalité "statistiquement indiscernable d'un tel modèle, pour une fraction du prix". Cela reste un bon résultat, mais c'est une autre affirmation. À noter aussi : le rapport de coût de 1/18 est déduit de V4-Flash et non publié pour cette exécution, et l'ensemble n'est pas vérifié officiellement par DeepSWE.
Le modèle de comparaison est flatteur. Un deuxième lecteur a relevé que le pair choisi pour l'histoire des coûts n'est pas le plus proche disponible :
"The closer comparison would be 5.6-Luna. On DeepSWE at Xhigh it's 57% at 1/6 the cost of Sol M, on Max it's 67% at 1/3rd the cost."
Face à une variante remisée de GPT-5.6, l'écart coût-performance se réduit beaucoup. C'est toujours une avancée. Beaucoup moins un changement de palier.
Le "bond" multimodal mesure en partie la capacité à voir. C'est dans la note de bas de page de DeepSeek elle-même. Sur ApexBench et Agents' Last Exam, la colonne de V4-Flash texte seul a été notée en ignorant les éléments multimodaux de la tâche, ce qui explique qu'elle soit à 26,2 et 25,2. Comparer 36,5 à 26,2 mesure donc autant "un modèle voit, l'autre non" que n'importe quel gain de capacité. La comparaison honnête est la colonne Opus-4.8, où DeepSeek est derrière de 2,9 sur ApexBench et de 0,7 sur Chartography, puis passe légèrement devant sur Agents' Last Exam et sur ZeroBench.
Un dernier point de cadrage, facile à manquer. Chaque chiffre de la série DeepSeek dans ce tableau vient de DeepSeek Harness Minimal Mode avec top_p=0.95 et temperature=1.0, c'est-à-dire l'échafaudage du fournisseur lui-même, le jour du lancement. Les tableaux de première main sont utiles, mais ce ne sont pas des réplications. Traitez-les comme vous traiteriez le tableau de n'importe quel fournisseur, y compris ceux de mes propres comparatifs de modèles.
L'acquiescement assuré est le pire des échecs
Voici le résultat d'usage auquel je reviens sans cesse, car c'est le seul de ce fil avec un ensemble noté et un schéma d'échec nommé.
Un commentateur exploite un petit benchmark de validation de légendes : on donne au modèle une image plus un sujet affirmé, puis on lui demande si l'affirmation est vraie ou non. La question y est "est-ce bien ce que je dis", jamais "qu'est-ce que c'est". Il l'a fait tourner sur DeepSeek et sur seed 2.1 turbo de ByteDance :
"Asked "Is this Salisbury Cathedral" and supplied a picture of Wells Cathedral, it answers "Yes, the west facade of Salisbury Cathedral". Bytedance seed 2.1 turbo correctly says no. Similar results for a picture of Manhattan Bridge sent as Brooklyn Bridge, Chartres Cathedral sent as Notre Dame, etc."
Le score sur son ensemble de 12 images : DeepSeek 6, seed 2.1 turbo 11. Le classement plus large sur ce même ensemble plaçait Gemini 3.7 Flash en tête, puis seed, puis GPT-5.6-Luna et ensuite deux versions de Qwen, à peu près l'ordre auquel aboutit aussi mon comparatif Qwen contre V4-Flash en texte. Il en donne lui-même la réserve : c'est un ensemble minuscule comparé à une vraie suite de benchmarks VLM, et quelqu'un dans le fil a soutenu à raison qu'un petit modèle orienté programmation n'a jamais été entraîné à reconnaître des monuments.
Les deux sont vrais. Pourtant, à mon sens, l'intéressant n'est pas du tout le score sur les monuments. L'intéressant, c'est qu'il n'a pas dit "non", il a dit "oui, et voici un détail assuré que j'ai inventé". La façade ouest de la cathédrale de Salisbury est une élaboration précise, à l'air autorisé, plaquée sur le mauvais bâtiment. Ce n'est pas un problème de résolution, et aucun mode haute résolution ne le réglerait. C'est le modèle qui donne raison à la prémisse qu'on lui a remise.
Si vous travaillez dans le support, vous avez déjà rencontré cet échec. Lors d'un appel que j'ai relu dans mes propres notes, une équipe de support technique B2B avait vu un bot répondre "oui, nous prenons en charge le modèle de votre voiture" pour des marques absentes de leur base de données, parce que le centre d'aide disait "nous prenons en charge tous les modèles". Le bot lisait correctement et raisonnait à partir de la mauvaise prémisse, et leur propre mot pour la phase de mise en place était "trial and error in the beginning". Même forme, autre domaine. L'acquiescement assuré est plus dangereux qu'une lecture floue erronée, parce qu'une lecture floue erronée a généralement l'air fausse et que l'acquiescement assuré n'a jamais l'air faux. C'est aussi la ligne entre un vrai agent et un chatbot à scénario, et c'est ce qui décide si la déviation de tickets devient une victoire ou une file de plaintes.
C'est pourquoi "le modèle peut-il voir la capture" est la moitié facile de la question du support, et la moitié facile est celle à laquelle une sortie de modèle peut répondre. La moitié difficile est de savoir si la réponse est juste. Cela dépend de ce sur quoi l'agent a le droit de s'appuyer, et de son comportement au moment où il ne sait pas. Un problème de récupération et de garde-fous, en d'autres termes, pas un problème de vision, et c'est la différence entre le RAG et un appel brut à un LLM.
Le tableau de fiabilité que personne ne capture
Sur 153 commentaires, personne n'a signalé d'erreur d'API, de 5xx, de limite de débit ou de panne, ce qui est bon signe pour un endpoint expérimental vieux de trois jours. Personne n'a non plus signalé de distributions de latence, et le chiffre intéressant se trouve justement là.
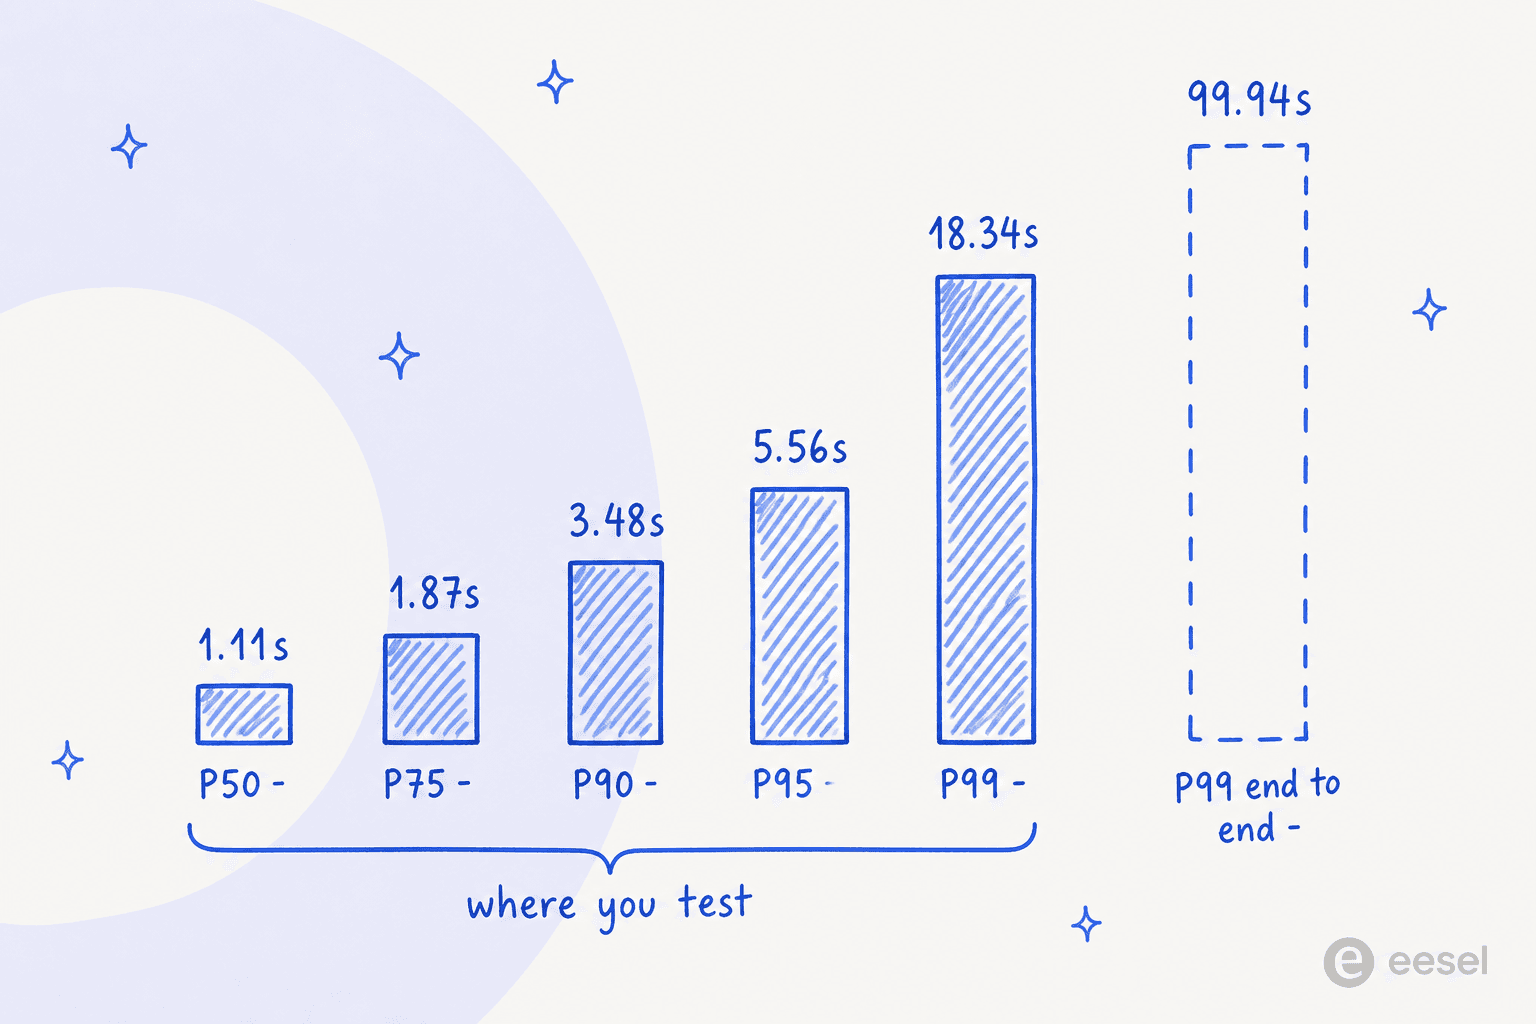
Sur trois jours de trafic de production : latence P50 de 1,11 seconde, débit de 85 tokens par seconde, disponibilité de 100 %. Un modèle rapide, donc, et la médiane est excellente pour cette gamme de prix. La transcription d'un commentateur le confirme, avec 368 ms de réflexion et 4,4 secondes au total pour une seule image.
Regardez ensuite à droite. Le P90 est à 3,48 s, le P95 à 5,56 s et le P99 à 18,34 secondes. De bout en bout, le P99 monte à 99,94 secondes. Le taux d'erreur des appels d'outils s'établit en moyenne à 1,27 %, ce qui est compétitif (Gemini 3.7 Flash est à 1,41 % sur son meilleur endpoint), et la disponibilité sur la même fenêtre était de 99,93 %.
La conséquence pratique est un budget de timeout, pas un benchmark. Fixez un timeout client de 10 secondes parce que votre médiane est d'une seconde, et vous perdrez environ une requête sur cent. Dans une boucle d'agent qui exécute douze appels d'outils par tâche, un sur cent par appel devient plutôt une tâche sur neuf. Il n'y a pas non plus de basculement : un seul fournisseur sert ce modèle, donc au moment où il ralentit, un routeur n'a nulle part ailleurs où envoyer la requête. Si vous avez mis en place une forme d'automatisation de première réponse, c'est la queue de distribution que vos clients ressentent, pas la médiane.
Qui appelle réellement ce modèle
C'est la découverte à laquelle je ne m'attendais pas du tout, et c'est celle qui a fait bouger mon verdict.
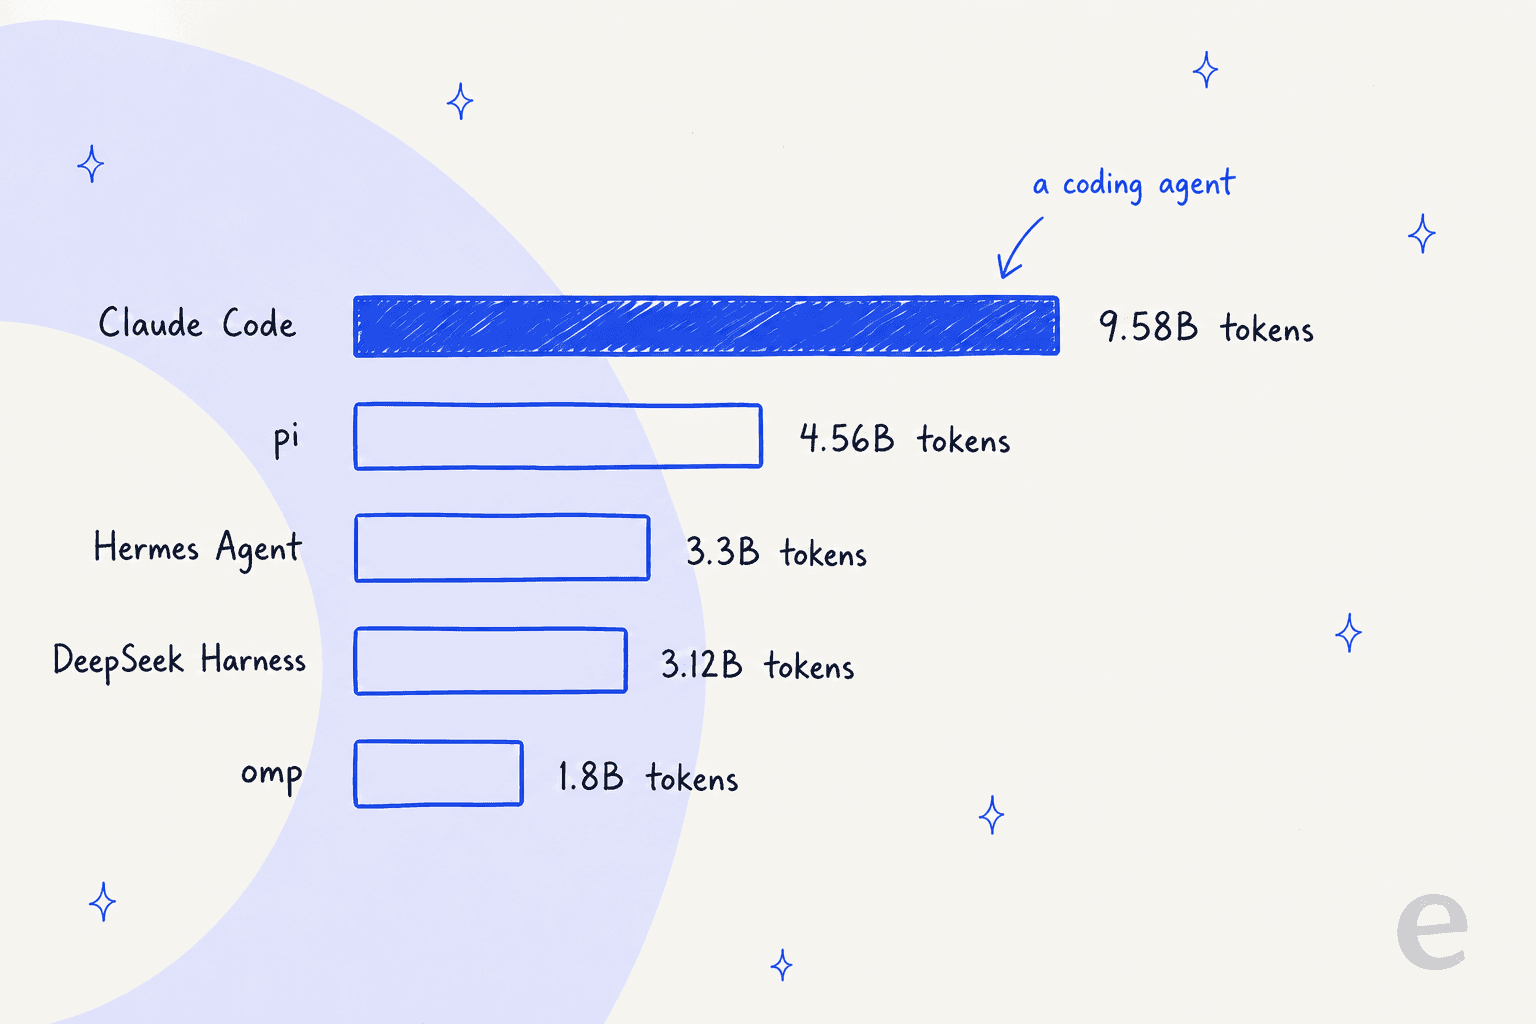
Les applications publiques qui ont envoyé le plus de trafic vers deepseek-v4-flash-vision-exp durant ses premiers jours, dans l'ordre : Claude Code avec 9,58 Md de tokens, pi avec 4,56 Md, Hermes Agent avec 3,3 Md, le harnais de pont multimodal de DeepSeek lui-même avec 3,12 Md et omp avec 1,8 Md. Le plus gros consommateur unique du premier modèle de vision de DeepSeek est un outil de programmation. Dans ce top cinq, une seule entrée concerne explicitement les images.
Le mélange de tokens raconte la même histoire sous un autre angle. Sur ces premiers jours : 25 Md de tokens de prompt, 69,6 M de tokens de complétion et 139 M de tokens de raisonnement. Le ratio prompt sur complétion est d'environ 359 pour 1, signature d'un agent qui bourre de grandes bases de code et des sorties d'outils dans une fenêtre de contexte, et non celle d'une charge de légendage d'images. Cela signale aussi un piège de coût à connaître. Le raisonnement tourne à environ le double de la complétion, le mode réflexion est activé par défaut, et le raisonnement est facturé au tarif de sortie. Donc si votre modèle de coûts traite la sortie comme la longueur de la réponse, il se trompe d'un facteur 3 environ, le même piège que parcourt le détail des prix de V4-Flash.
Quelqu'un dans le fil a posé la question de suivi évidente, et je pense que c'est la bonne :
"I've been using v4-flash without vision for this months — it's my go-to for code tasks. Now with vision, I'm wondering: if this model can do everything the text-only version does (plus see images), why keep the text-only one around?"
Personne ne lui a donné de réponse nette, et d'après les preuves publiées il n'y en a pas, hormis les deux fonctions manquantes ci-dessous et ce mot exp dans le nom.
Deux choses qui manquent en silence
Les deux n'apparaissent que dans le tableau des spécifications, et les deux comptent plus que le marketing.
La complétion FIM a disparu. La page des tarifs indique la complétion Fill-in-the-Middle comme disponible en mode sans réflexion pour deepseek-v4-flash comme pour deepseek-v4-pro, puis comme "Not supported" pour la version avec vision. Si vous utilisez FIM pour la complétion de code en ligne, ce modèle n'est pas un remplaçant direct de celui dont il dérive, aussi bonne que paraisse cette ligne DeepSWE.
Il n'y a pas de date. Le champ MODEL VERSION indique DeepSeek-V4-Flash-Vision-Exp, alors que ses frères indiquent DeepSeek-V4-Flash-0731 et DeepSeek-V4-Pro-0813. Figer la version n'est pas possible. Avec tout ce qui précède sur la variance d'une exécution à l'autre, cela devient un vrai problème d'évaluation : le modèle que vous avez testé lundi n'est pas garanti d'être celui qui sert votre trafic vendredi, et aucune chaîne de version ne permet de prouver le contraire. Sur un endpoint expérimental, c'est défendable. Sur tout ce que vous placez devant des clients, non.
Il existe une troisième lacune à signaler avec prudence, car le fil s'est corrigé à son sujet. Un commentateur a dit que les images ne pouvaient pas revenir comme résultats d'appels d'outils, ce qui serait une limitation sérieuse pour toute boucle d'agent de vérification par capture. Un autre l'a corrigé : la restriction s'applique à Chat Completions, tandis que la Responses API et l'endpoint Messages compatible Anthropic acceptent bien les images dans la sortie d'outils. Le commentateur d'origine a alors cité la documentation en retour, confirmant que input_image dans function_call_output est traité comme une vraie image pour ce modèle. La capacité existe donc, sur deux surfaces sur trois. Si vous construisez sur Chat Completions, c'est une réécriture pour vous.
Toujours à propos de réécritures, une restriction de plus qui va gêner un agent existant : les images ne sont acceptées que dans les messages user. Mettez-en une dans un message system ou assistant et vous recevez un 400. Beaucoup de boucles d'agent rangent leur sortie d'outils dans un tour assistant, et ces boucles doivent être modifiées d'abord, avant qu'une seule image ne passe. Quiconque a migré entre la gestion de fichiers d'OpenAI et celle d'un autre fournisseur sait comment ces petites différences de forme s'accumulent.
Comment il se compare aux autres modèles de vision
Grille tarifaire et performances réelles mesurées, le tout issu de la même source pour que les colonnes restent comparables. Une réserve : la fenêtre de DeepSeek est de trois jours, parce que le modèle a trois jours, tandis que les autres sont des fenêtres d'une semaine. Pour le duel direct en texte plutôt qu'en images, voir V4-Flash contre Kimi K3.
| Modèle | Entrée /M | Sortie /M | Lecture cache /M | Meilleure latence P50 | Meilleur débit | Disponibilité | Contrôle de la résolution ? |
|---|---|---|---|---|---|---|---|
| DeepSeek V4 Flash Vision Exp | $0.22 | $0.66 | $0.007 | 1.11s | 85 tps | 100.00% | Pas de mode haute résolution |
| Gemini 3.7 Flash | $1.50 | $7.50 | $0.15 | 1.70s | 197 tps | 99.74% | Oui, résolution des médias |
| Qwen3.8-Max | $2.00 | $6.00 | $0.25 | 1.83s | 45 tps | 100.00% | Non documenté |
| GPT-5.6 | $4.00 | $20.00 | $0.40 | 3.55s | 45 tps | 98.50% | Oui, niveaux de détail |
Sur le prix, ce n'est pas serré. DeepSeek est environ 6,8 fois moins cher en entrée affichée que Gemini 3.7 Flash et 18 fois moins cher que GPT-5.6, et il a aussi la latence médiane la plus basse des quatre. Deux astérisques honnêtes. Gemini bénéficie en ce moment de remises promotionnelles sur OpenRouter (75 % via Vertex, 50 % via AI Studio) qui comblent temporairement une grande partie de cet écart, et le même testeur dont le benchmark de légendes classait Gemini premier a noté qu'il n'était entré dans sa présélection que grâce à la remise.
L'économie du cache mérite aussi une ligne, car elle change le tableau plus que le prix affiché. Le taux de réussite du cache observé chez DeepSeek est de 88,9 %, ce qui ramène le prix d'entrée effectif à 0,03073 $ par million contre 0,22 $ affichés. La sortie ne bouge presque pas, 0,6595 $ effectifs contre 0,66 $ affichés. Donc votre facture ici est une facture de sortie avec une erreur d'arrondi en prime, et toute comparaison alignant les prix d'entrée affichés compare la mauvaise colonne. Si vous calculez ce que coûte vraiment une charge de travail IA, mes notes sur le coût par résolution sont un cadre plus utile que n'importe quel tarif au million. La comparaison avec les agents humains est l'autre moitié de la même somme.
Mon verdict
Utilisez-le si votre charge de travail est faite d'agents textuels, de programmation ou d'usage d'outils, et que vous êtes aujourd'hui sur DeepSeek V4 Flash. Six lignes de benchmark sur sept vont dans un sens et le profil de trafic réel va dans le même, le prix est identique, et changer la chaîne du modèle constitue toute la migration. Mon avis sur V4-Flash est la base à laquelle ceci est comparé. Vérifiez d'abord votre usage de FIM.
Utilisez-le si votre travail sur les images est structurel : vérifications de mise en page, formes de graphiques, vérification d'interface, tri de captures, du design au code. À environ 0,00008 $ l'image en heures creuses, le coût de regarder s'arrondit à rien, et 0,64 Mpx est largement suffisant pour "est-ce que ça s'est affiché correctement". La même logique le rend bon marché pour la classification de tickets en masse sur les pièces jointes.
Construisez un outil de recadrage si c'est le détail fin dont vous avez besoin. Le schéma est éprouvé et plusieurs personnes l'exécutent déjà en production, et ce qu'il vous coûte, ce sont des tokens et de la complexité de harnais, pas de la précision. Un compromis raisonnable à ce prix.
Cherchez ailleurs si le détail fin est le travail, et surtout quand vous avez besoin que le modèle contredise une affirmation au lieu de la confirmer. Petit texte, OCR de documents à l'échelle d'une page entière, validation de légendes : tout cela est mieux servi par quelque chose qui expose un réglage de résolution. La gamme Flash de Gemini est la comparaison évidente ici. Mon tour d'horizon des alternatives à V4-Flash couvre le reste de la gamme. Et si les poids ouverts comptent pour vous, notez que plusieurs personnes dans le fil attendent une publication sans que personne n'en ait confirmé une, donc ne planifiez pas là-dessus.
Attendez si la reproductibilité est une exigence pour vous. Pas de date, plus une vraie variance d'une exécution à l'autre, est une mauvaise combinaison pour tout ce que vous devez certifier. Le exp dans le nom fait là un travail honnête.
La lecture plus large, pour qui choisit des modèles plutôt que de les évaluer : cette sortie plaide mieux pour la gamme texte de DeepSeek que pour sa vision. Comparez-la à V4 Pro, puis à Kimi K3, et à l'endroit où en était V3.2 il y a un an, et la courbe prix-performance sur les agents textuels continue de s'infléchir dans la même direction. La partie vision est un bonus compétent et bon marché qui est flou exprès.
eesel pour les files de support où la réponse doit être juste
Si vous êtes arrivé ici parce que votre file regorge de captures de clients, laissez-moi être franc sur ce qu'une sortie de modèle résout et ce qu'elle ne résout pas.
Les clients envoient des captures parce que quelque chose de petit et de précis a mal tourné. Une boîte de dialogue d'erreur. Une ligne sur une facture ou un champ qui ne s'enregistre pas. C'est l'entrée la plus précieuse du support et la pire adéquation possible avec un plafond de résolution, puisque le petit texte est l'information. Et même quand le modèle la lit parfaitement, le problème plus difficile attend toujours, celui de la cathédrale de Salisbury : une réponse fluide et assurée bâtie sur la mauvaise prémisse, envoyée à un vrai client sous votre propre marque.

La réponse d'eesel à cela est de vous faire regarder les mauvaises réponses avant vos clients. Vous connectez votre helpdesk et votre contenu d'aide, puis, avant que quoi que ce soit ne soit mis en ligne, vous rejouez l'agent sur vos propres tickets historiques. Vous voyez ainsi exactement lesquels il aurait traités, lesquels il aurait ratés, et les mots qu'il aurait employés. Vous définissez ce qu'il a le droit de répondre seul et ce qui part directement vers un humain, et chaque action reste visible et réversible dans le journal ci-dessus. Démarrez-le comme un copilote IA qui rédige pour vos agents, si lui confier la file dès le premier jour vous semble trop. C'est l'opposé d'actionner un interrupteur et de lire l'analyse post-mortem ensuite.
C'est la pièce qu'un modèle de vision bon marché ne vous donne pas, et c'est aussi celle qui décide si l'IA dans votre file fait économiser de l'argent ou coûte de la confiance. Si vous voulez la voir tourner sur vos propres tickets, essayez eesel gratuitement.
Si vous en êtes encore à la présélection, commencez par mes notes pratiques sur le choix d'un modèle pour le support. Ensuite, quel LLM convient au travail de support est une bonne lecture, et ce que fait concrètement au quotidien un agent de helpdesk IA est l'autre à lire.