

Pourquoi je m'intéresse à une API de recherche
Je construis les intégrations d'eesel, le code qui fait entrer dans l'IA les articles du centre d'aide, les macros et les tickets. L'essentiel de ce travail se résume à la récupération d'informations : trouver le bon passage de texte, puis montrer d'où il vient. Une équipe de support matériel, lors d'un appel commercial eesel, a placé les citations dans chaque réponse en tête de sa liste et, dans la foulée, a demandé à eesel d'explorer un centre d'aide protégé par un identifiant.
Ce couple, c'est à peu près la lentille à travers laquelle je lis ce lancement. Une API de recherche web bon marché résout la première moitié du problème pour les informations publiques. Pour la seconde moitié, elle ne fait rien. J'ai donc parcouru la documentation et les règles de facturation de DeepSeek, comparé le prix à huit autres fournisseurs, puis lu ce que les développeurs ont dit au cours des deux premiers jours. Je n'ai pas de chiffres de benchmark à moi : quand je cite la vitesse ou la qualité, cela vient de personnes qui ont mesuré.
Qu'est-ce que l'API de recherche DeepSeek ?
L'API Search trouve des pages web pour une requête et renvoie des résultats structurés. Sa partenaire, l'API Fetch, prend une URL et renvoie cette page en Markdown. Le guide Search et Fetch de DeepSeek décrit les deux comme des API JSON brutes qui utilisent la même clé bearer que le reste de l'API DeepSeek.
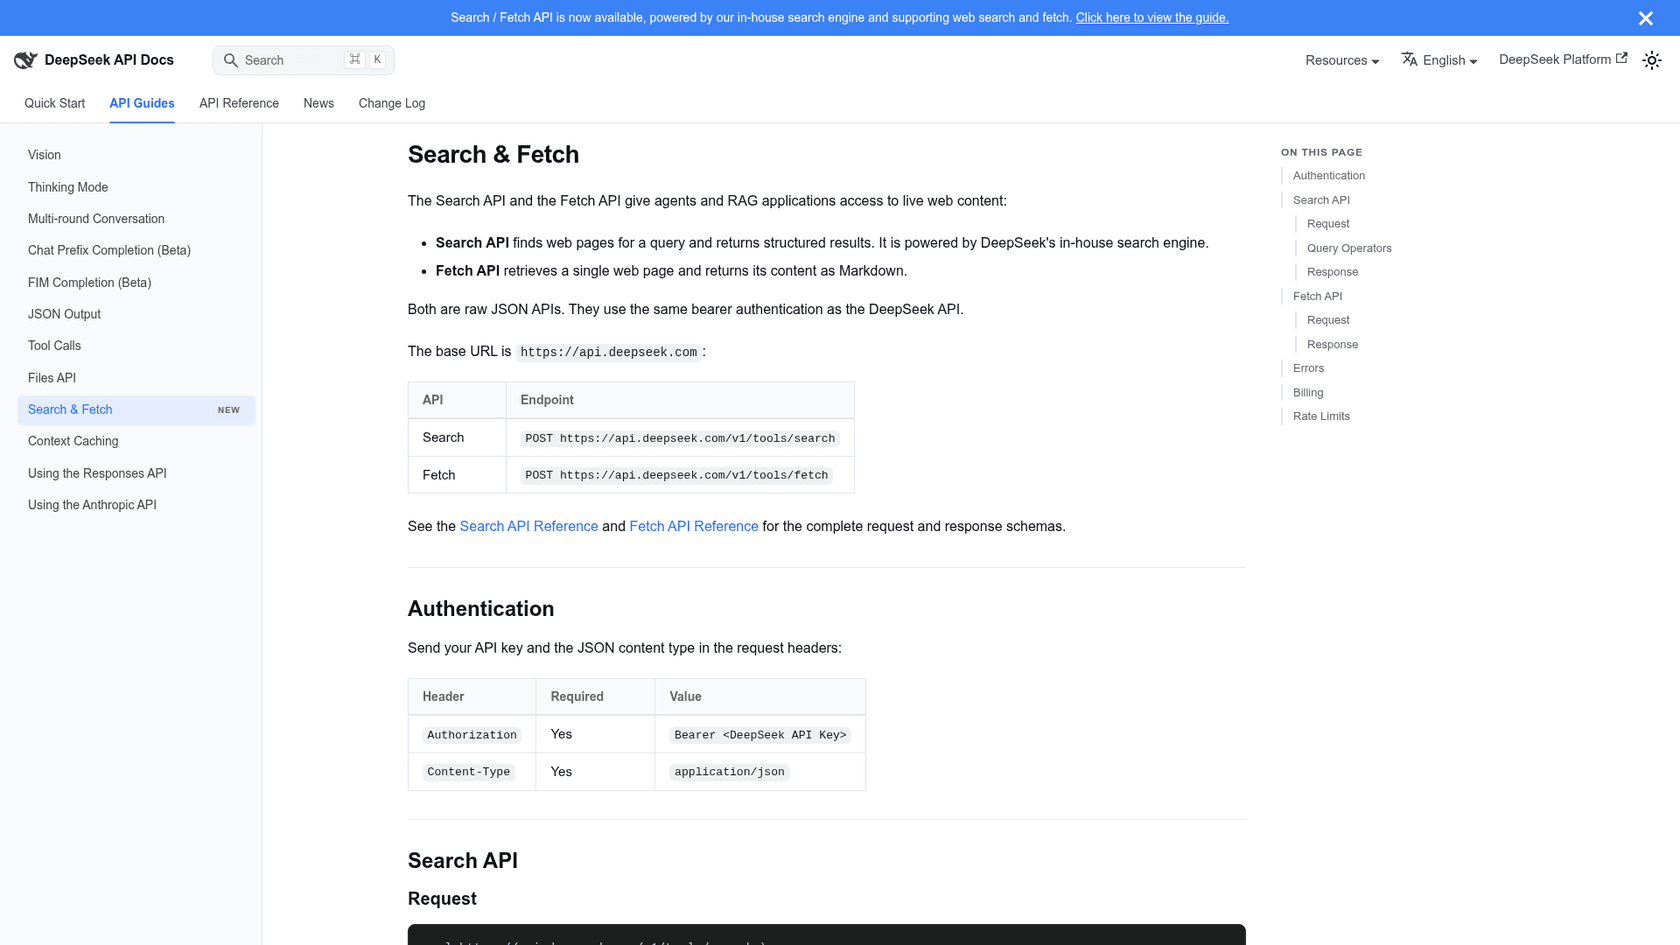
Elle est sortie le même jour que DeepSeek V4.1 Flash 1017, la mise à jour de modèle que j'ai testée séparément. L'entrée du changelog indique que le moteur derrière la recherche web et API de DeepSeek traite déjà "hundreds of millions of search requests" par jour, indexe "hundreds of billions of web pages" et filtre le spam SEO et les contenus de faible qualité générés par IA. En clair, c'est la même recherche que celle déjà utilisée par le chatbot de DeepSeek, mais désormais vendue à la requête.
| API | Endpoint | Ce qu'elle renvoie |
|---|---|---|
| Search | POST https://api.deepseek.com/v1/tools/search | Jusqu'à 50 résultats avec titre, URL, extrait, résumé, date et scores |
| Fetch | POST https://api.deepseek.com/v1/tools/fetch | Le titre de la page et son contenu en Markdown |
Comment Search et Fetch fonctionnent ensemble
Les deux endpoints correspondent à la boucle que la plupart des agents de recherche exécutent déjà : chercher, choisir les liens prometteurs, les lire, répondre. Le modèle lui-même ne touche jamais le web. Votre code (ou un harness comme Claude Code) fait les appels et dépose les résultats dans le contexte du modèle.
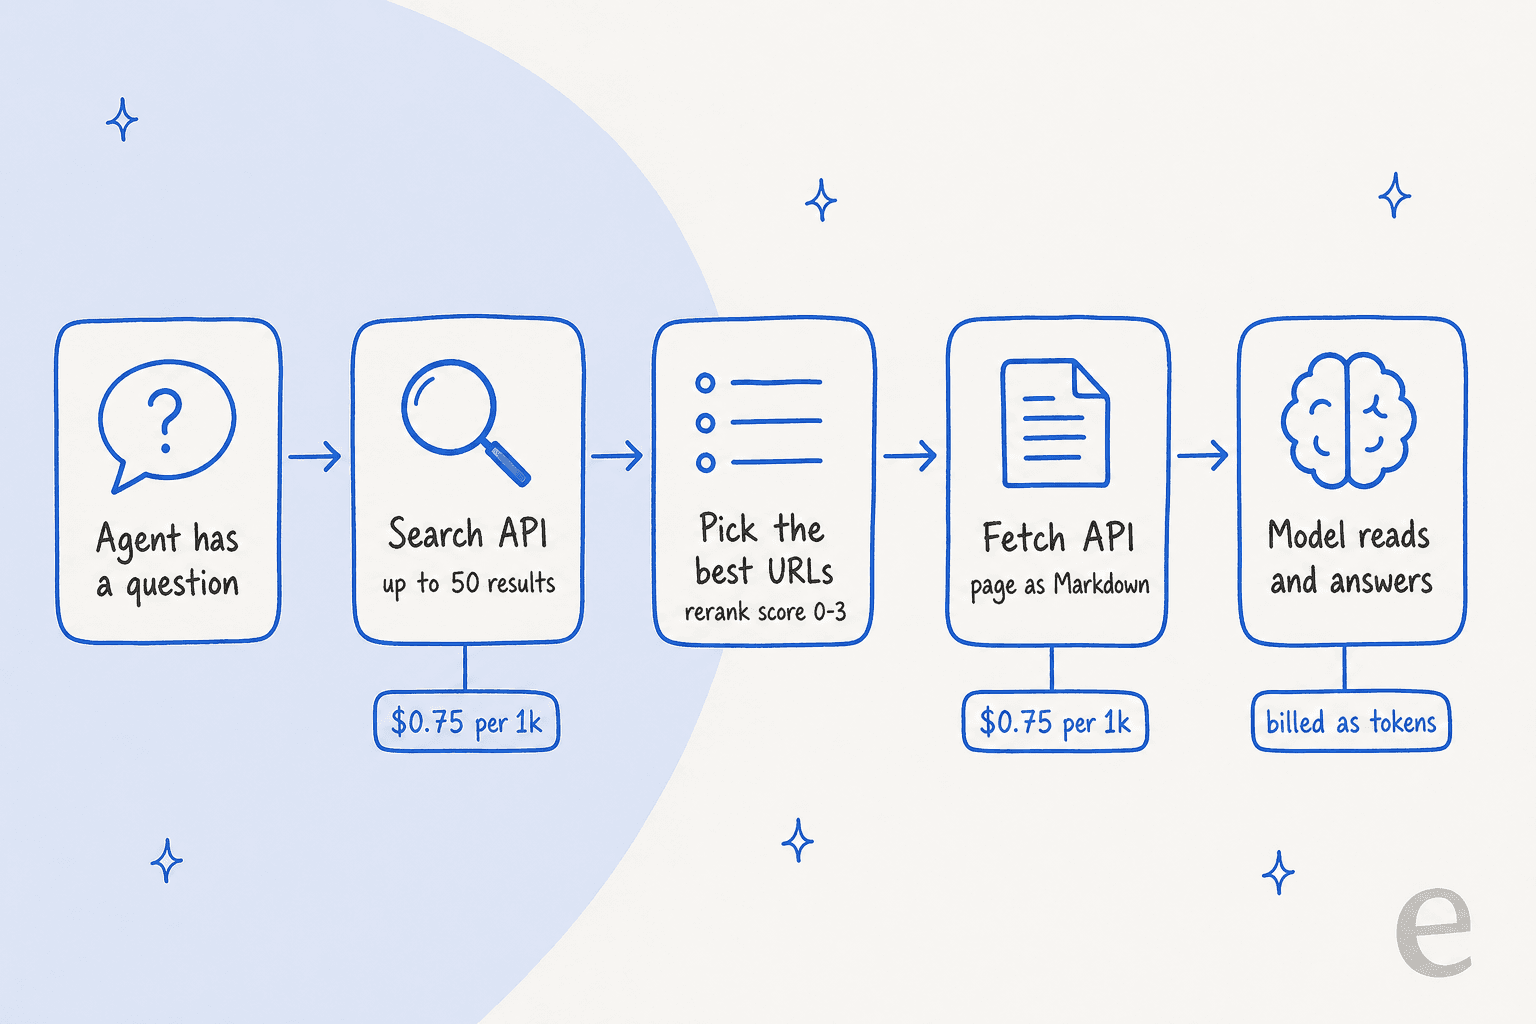
Une requête Search prend cinq champs, d'après la référence de l'API Search :
| Champ | Par défaut | Ce qu'il fait |
|---|---|---|
query | obligatoire | De 1 à 128 caractères, avec opérateurs de recherche |
count | 10 | Nombre de résultats, de 1 à 50 |
ori_question | aucun | La question d'origine de l'utilisateur, pour aider DeepSeek à comprendre la requête |
localization | "" | Une adresse IP pour localiser les résultats |
need_content | false | Renvoyer le contenu complet de la page dans chaque résultat |
La requête prend en charge les opérateurs que vous taperiez dans une barre de recherche : site: et -site:, les expressions exactes entre guillemets, lang:zh,en et les dates avec after: / before:. Cette limite de 128 caractères est serrée, surtout pour les agents qui aiment coller toute la question. ori_question est le contournement : gardez la requête courte et passez la question complète séparément.
Chaque résultat contient aussi deux champs que je n'ai pas vus présentés ainsi dans d'autres API. rerank_score va de 0 à 3, et DeepSeek dit que 1.5 ou plus compte comme de haute qualité. authority va de 0 à 4, 3 et plus signalant une source très faisant autorité. Il y a aussi un summary de 600 à 800 caractères que DeepSeek dit "intended to be read by a model." Pour un pipeline RAG, cela veut dire que vous pouvez écarter les pages sans valeur et donner des résumés au modèle avant de payer pour récupérer quoi que ce soit. Une réserve d'un constructeur de la première heure : sur 60 résultats, il a constaté que rerank_score allait de 0.03 à 2.32 et "barely changes between different queries", ce qui ressemble plus à un score de qualité de page qu'à un score de pertinence. Pour ma part, je m'en servirais pour écarter les pages de faible qualité, pas pour classer des réponses.
L'API Fetch est plus simple : envoyez une URL (jusqu'à 8,192 caractères), recevez title et content. Si la page ne peut pas être lue, parce que le site la bloque ou qu'il n'y a rien à extraire, vous obtenez un 404. Un 403 signifie que la politique de sécurité propre à DeepSeek a rejeté la requête. Il vaut la peine de gérer les deux dans le code, plutôt que de laisser votre agent réessayer indéfiniment.
Combien coûte l'API de recherche DeepSeek ?
Search et Fetch sont facturées par requête réussie, pas par tokens ni par nombre de résultats. Voici toute la grille tarifaire de la page de tarifs de DeepSeek :
| API | Unité | Prix |
|---|---|---|
| Search | Pour 1,000 requêtes réussies | $0.75 |
| Fetch | Pour 1,000 requêtes réussies | $0.75 |
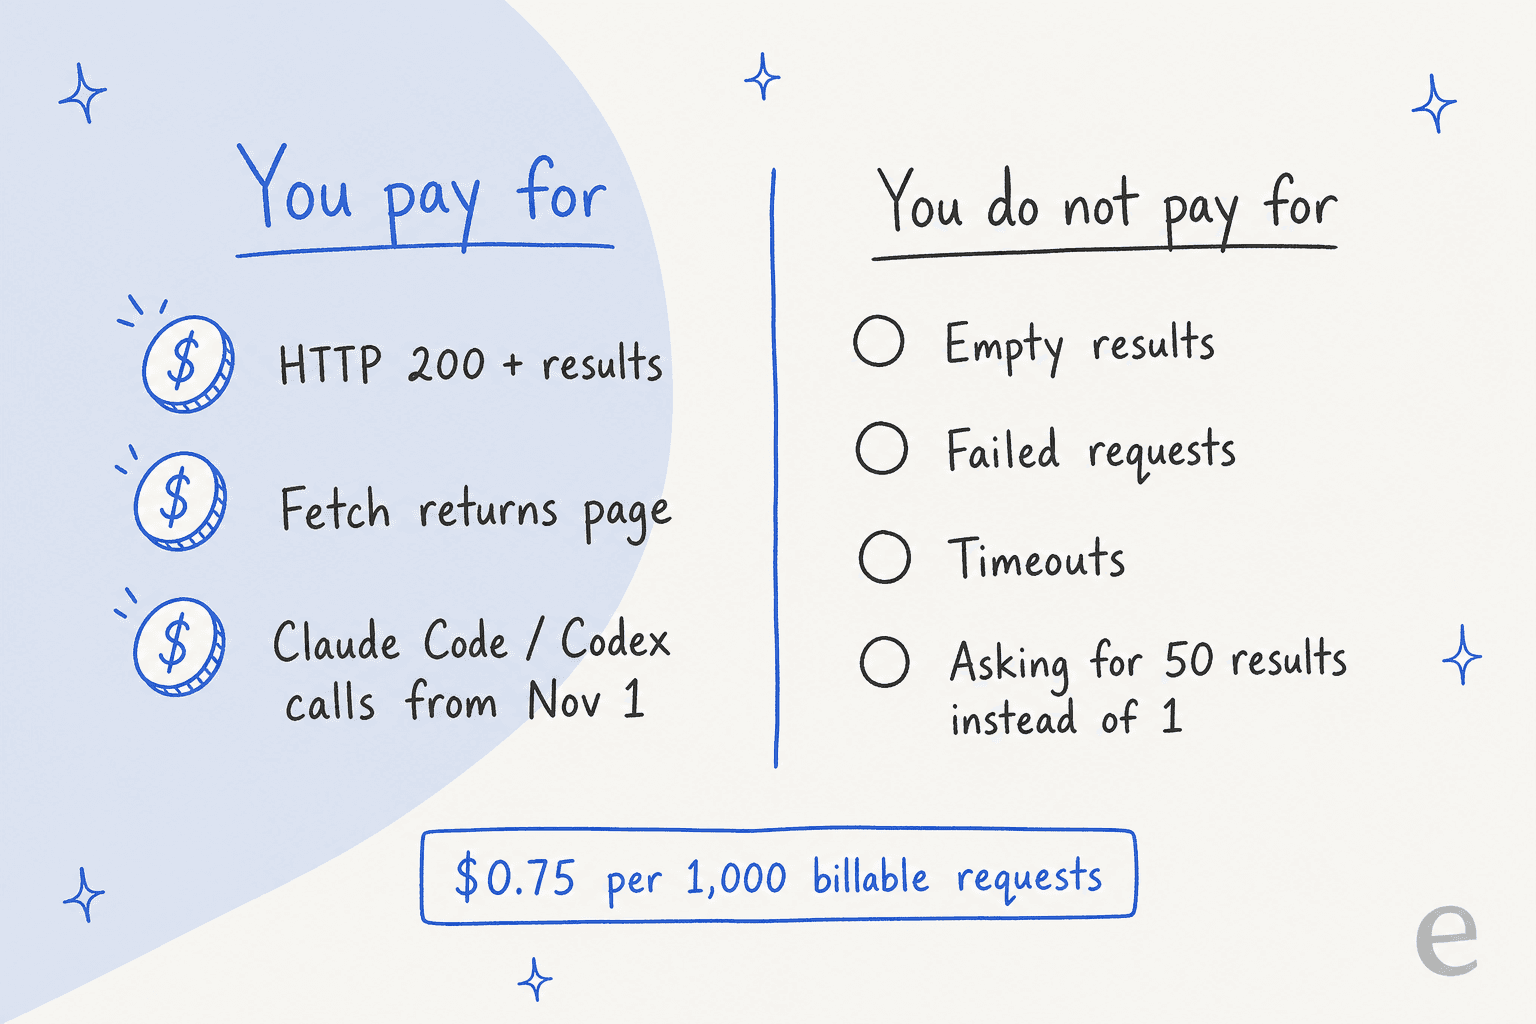
La règle de facturation est plutôt généreuse. Une requête ne compte que si elle renvoie HTTP 200 et produit réellement quelque chose : un tableau results non vide pour Search, le contenu de la page pour Fetch. Les résultats vides, les requêtes en échec et les délais d'attente dépassés sont gratuits, et demander 50 résultats coûte autant que d'en demander un.
L'autre moitié de la facture vient du modèle qui lit tout ce que vous avez récupéré. Ces tokens sont facturés au tarif normal de Flash ou de V4 Pro. Les prix hors pointe valent la moitié, et les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine :
| Modèle (par 1M de tokens) | Entrée, cache miss | Entrée, cache hit | Sortie |
|---|---|---|---|
deepseek-flash, off-peak | $0.15 | $0.003 | $0.60 |
deepseek-flash, peak | $0.30 | $0.006 | $1.20 |
deepseek-v4-pro, off-peak | $0.66 | $0.022 | $1.98 |
deepseek-v4-pro, peak | $1.32 | $0.044 | $3.96 |
Une date mérite d'être notée dans votre agenda. Quand vous utilisez l'API DeepSeek via DeepSeek Harness, Claude Code ou Codex, les recherches côté serveur de l'agent passent déjà par ces endpoints. Le guide dit que ces appels sont gratuits pour l'instant et que la facturation à la requête commence à 00:00 heure de Pékin le 1er novembre 2026 (16:00 UTC le 31 octobre). Si vous laissez la recherche web activée dans Claude Code parce qu'elle ne coûte rien, cela change dans moins de deux semaines.
Comment elle se compare aux autres API de recherche
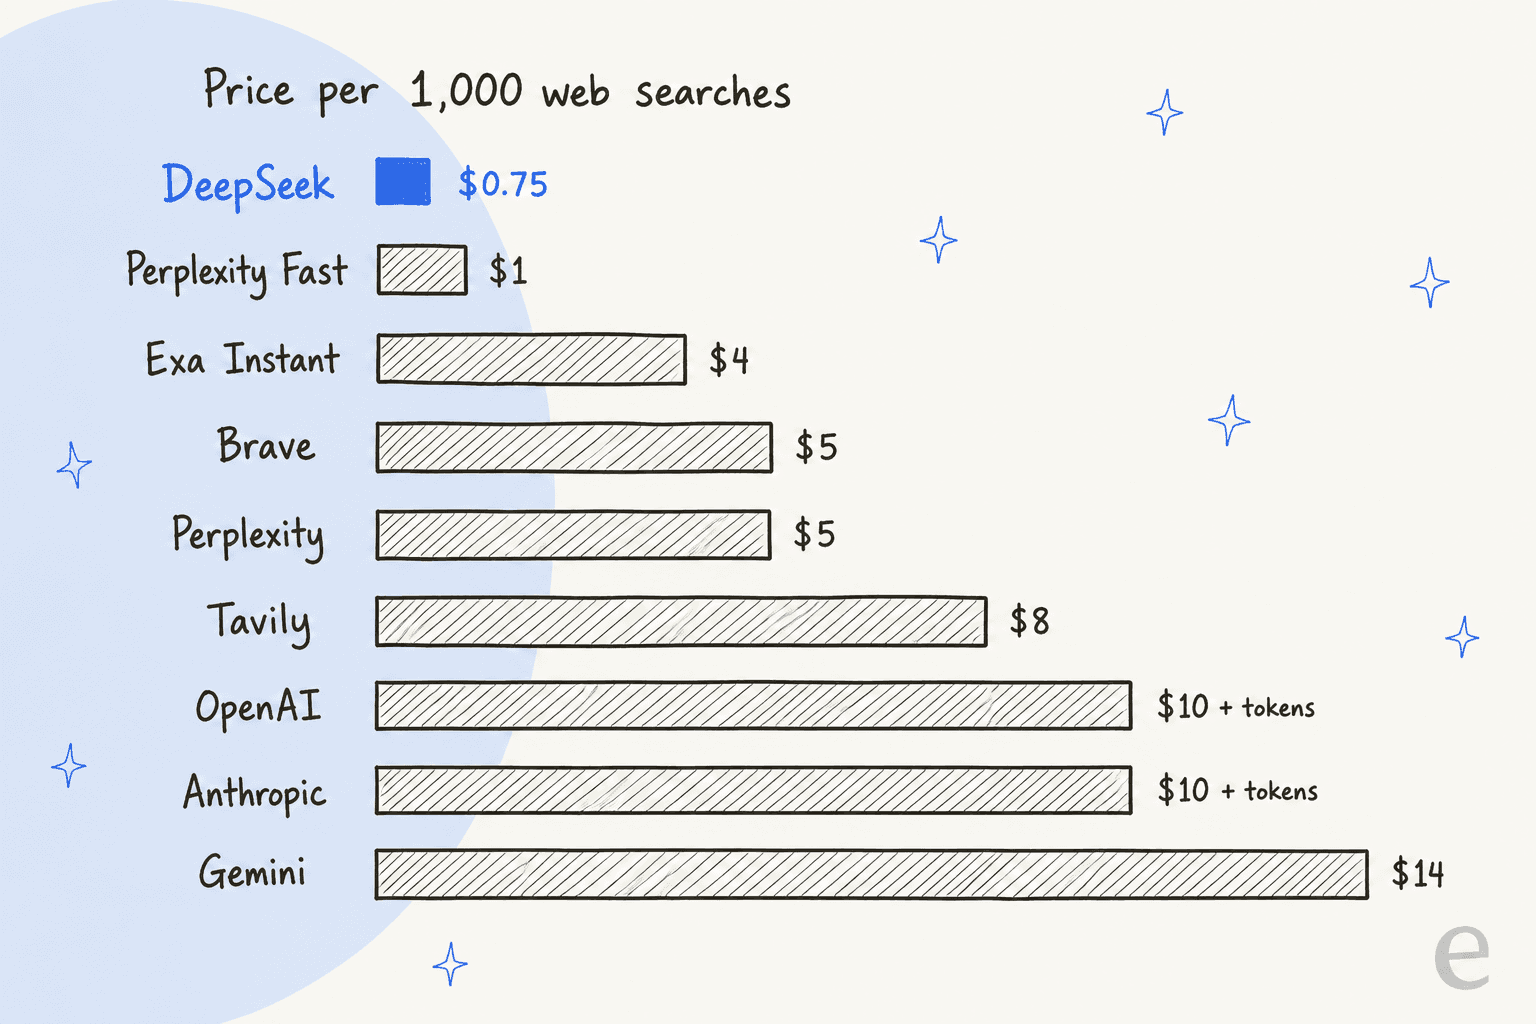
J'ai relevé la page de tarifs de chaque fournisseur le 19 octobre 2026. Les unités ne sont pas les mêmes d'un fournisseur à l'autre : regardez donc la deuxième colonne avant de comparer des chiffres.
| Fournisseur | Unité de facturation | Prix pour 1,000 | Tokens de résultats facturés en plus ? | Offre gratuite | Limite de débit |
|---|---|---|---|---|---|
| DeepSeek Search | Requête réussie | $0.75 | Non | Aucune indiquée | 5 par seconde |
| Perplexity Search | Requête (jusqu'à 5 requêtes de recherche) | $5 standard, $1 Fast Search | Non | Aucune indiquée | 50 par seconde |
| Exa | Requête (jusqu'à 10 résultats) | $4 Instant, $7 Fast/Auto, $12 Deep | Non, texte de page $1 pour 1,000 pages | $10 par mois | 10 à 25 par seconde |
| Brave Search API | Requête | $5 | Non | $5 de crédit par mois | 50 par seconde |
| Tavily | Crédit (recherche basique = 1) | $8 à l'usage, $5 à $7.50 avec abonnement | Non | 1,000 crédits par mois | 100 à 1,000 par minute |
| Firecrawl search | Crédits (2 pour 10 résultats) | Environ $1.20 à $7.60 selon l'offre | Non | 1,000 crédits par mois | Selon l'offre |
| OpenAI web search | Appel d'outil | $10 | Oui | Aucune indiquée | Limites du modèle |
| Anthropic web search | Recherche | $10 | Oui | Aucune indiquée | Par organisation |
| Gemini grounding | Requête de recherche | $14 | Pas pour les résultats | 5,000 par mois | Limites du modèle |
Les chiffres de Tavily et de Firecrawl sont mes propres calculs à partir de leurs taux de crédits, en supposant une profondeur basique et 10 résultats.
Trois choses m'ont frappé. D'abord, DeepSeek est sous tous les tarifs publics de ce tableau, et les concurrents les plus proches, à $1 ou $1.20, sont un palier rapide ou une offre à $599 par mois. Ensuite, les lignes "plus tokens" comptent : OpenAI et Anthropic facturent $10 pour mille recherches, puis facturent en plus les résultats comme tokens d'entrée, sur des modèles comme GPT-5.6 et Claude (voir les tarifs de l'API Anthropic) qui coûtent bien plus cher par token que DeepSeek Flash. Enfin, la limite de débit de DeepSeek est la plus basse du tableau, et de loin.
Si vous voulez changer de fournisseur sans réécrire de code, la Web Search API de Cloudflare en place trois derrière un seul endpoint. Pour de la recherche approfondie en plusieurs étapes plutôt que des requêtes isolées, Exa Agent Ultra est un produit différent à un prix différent.
Si vous avez surtout besoin de convertir des pages en Markdown à grande échelle, les tarifs de Firecrawl sont la référence pour comparer Fetch.
Les 5 QPS sont le chiffre sur lequel planifier
Search et Fetch autorisent chacune 5 requêtes par seconde par compte. Comme la limite s'applique au compte entier, ajouter des clés d'API ne la relève pas. Elle est aussi distincte des limites de concurrence de modèles de DeepSeek, et Fetch ajoute un plafond par domaine. Tout ce qui dépasse la ligne reçoit HTTP 429.
Cinq par seconde paraît minuscule, mais faites le calcul : cela fait 432,000 recherches par jour et par endpoint, soit plus de volume que presque tout le monde n'en a besoin. Là où cela gêne vraiment, c'est dans les pics. Un agent de recherche qui lance 20 recherches en parallèle, ou 10 utilisateurs qui sollicitent votre appli dans la même seconde, dépasseront la limite même si votre volume mensuel est faible. Brave et Perplexity autorisent 50 par seconde : c'est donc ici que le bas prix de DeepSeek montre sa contrepartie.
La solution est banale et elle marche, et c'est le même schéma que demande toute intégration d'API pour agents IA : placer devant l'API une file d'attente avec un limiteur token bucket, réessayer les 429 avec backoff et répartir les fetches entre domaines plutôt que de marteler un seul site. Le guide d'erreurs de DeepSeek recommande de réessayer sur 408, 429 et 5xx, de recharger votre solde sur 402 et de laisser les autres erreurs 4xx tranquilles jusqu'à ce que vous changiez la requête.
Que coûte vraiment une tâche d'agent ?
Prenons un exemple chiffré. Disons qu'un agent de recherche exécute 2,000 tâches par mois, et que chaque tâche fait 4 recherches et récupère 3 pages. Cela fait 8,000 recherches et 6,000 fetches, soit $10.50 par mois de frais DeepSeek. Les mêmes 8,000 recherches coûteraient $40 chez Brave, $64 chez Tavily à l'usage et $80 chez OpenAI avant ses frais de tokens.
Passons à la partie que l'on saute souvent. Ces 6,000 pages récupérées entrent dans le modèle. Si une page fait en moyenne 6,000 tokens (mon hypothèse, les pages réelles varient beaucoup), cela fait 36 millions de tokens d'entrée : $5.40 sur Flash hors pointe, $10.80 sur Flash en pointe ou $23.76 sur V4 Pro hors pointe. Sur V4 Pro, les pages que vous lisez coûtent plus cher que les recherches qui les ont trouvées.
Sur de petits travaux, c'est l'inverse. Un utilisateur de Reddit qui a relevé une semaine de travail d'agents a constaté qu'un sous-agent de recherche avait fait 85 recherches pour seulement $0.07 de travail du modèle. À $0.75 pour mille, ces recherches ont coûté environ $0.06, presque autant que le modèle lui-même. Sur des appels Flash bon marché, les frais de recherche peuvent donc finir par égaler la facture du modèle. Saisissez vos propres chiffres ci-dessous.
L'estimateur laisse de côté les tokens de sortie et les résumés de recherche : prenez-le donc comme un plancher. Deux leviers font plus bouger la facture que tout le reste. Le premier est need_content: true, qui renvoie le texte de la page dans les résultats de recherche pour que vous puissiez sauter les fetches séparés. Le créateur d'un moteur de réponses façon Perplexity a dit que cela avait fait passer une question "from 31s to 7s", avec 15 résultats et environ 119,000 caractères dans un seul appel facturable. Cela échange des frais de fetch contre des tokens, puisque 119,000 caractères représentent environ 30,000 tokens que le modèle doit lire. Le second levier est le moment : lancez les traitements par lots hors pointe, quand chaque token DeepSeek coûte moitié moins. Et si Flash n'est pas assez malin pour choisir de bonnes sources, comparez-le à Kimi K3 ou passez à la gamme supérieure en vous aidant de mes notes Flash vs Pro avant de payer pour davantage de fetches.
L'utiliser depuis Claude Code, Codex et Harness
La plupart des gens croiseront cette API sans jamais l'appeler directement. Le guide Claude Code de DeepSeek dit que l'API "natively supports the Web Search feature in Claude Code." Quand le modèle décide qu'une question nécessite le web, Claude Code appelle l'outil Web Search et DeepSeek exécute la recherche de son côté.
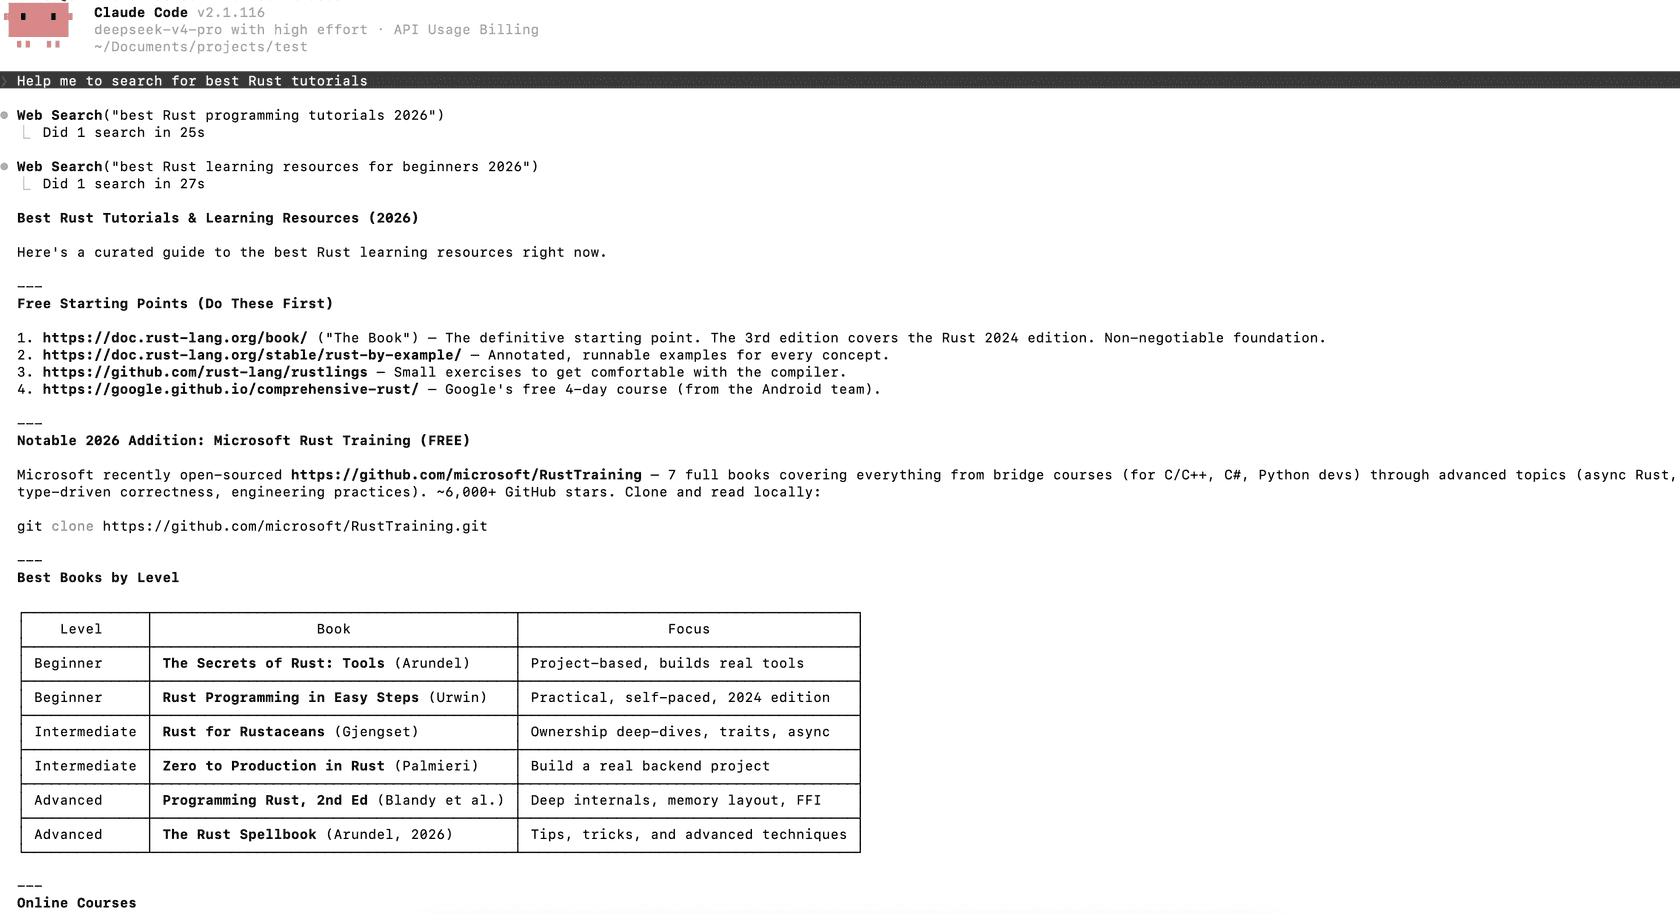
La même page détaille le coût : résumer les résultats de recherche demande des requêtes supplémentaires au modèle, donc "additional model token costs will be incurred", et les recherches elles-mêmes sont facturées au tarif de l'API Search. Cela concorde avec ce que j'ai dit plus haut. Dans Claude Code, les frais de recherche sont la petite ligne de la facture. Si vous ajustez vos dépenses, mon guide des tarifs de Claude Code couvre le reste, et l'article sur les variables d'environnement montre comment pointer Claude Code vers une autre API.
La restriction par modèle se remarque facilement. Dans la Responses API, l'outil intégré web_search est "Supported with deepseek-v4-pro" et "Ignored with deepseek-flash." L'intégration Codex est identique (mon article sur les tarifs de Codex couvre les offres propres d'OpenAI) : la recherche web ne fonctionne que lorsque Codex tourne sur deepseek-v4-pro, et le script d'installation de DeepSeek écrit web_search = "disabled" jusqu'à ce que vous le passiez à "live". Si vous avez donc basculé Codex sur Flash pour économiser et que la recherche s'est arrêtée sans bruit, c'est pour cette raison. Les endpoints autonomes se moquent du modèle que vous utilisez, puisque c'est votre code qui fait les appels.
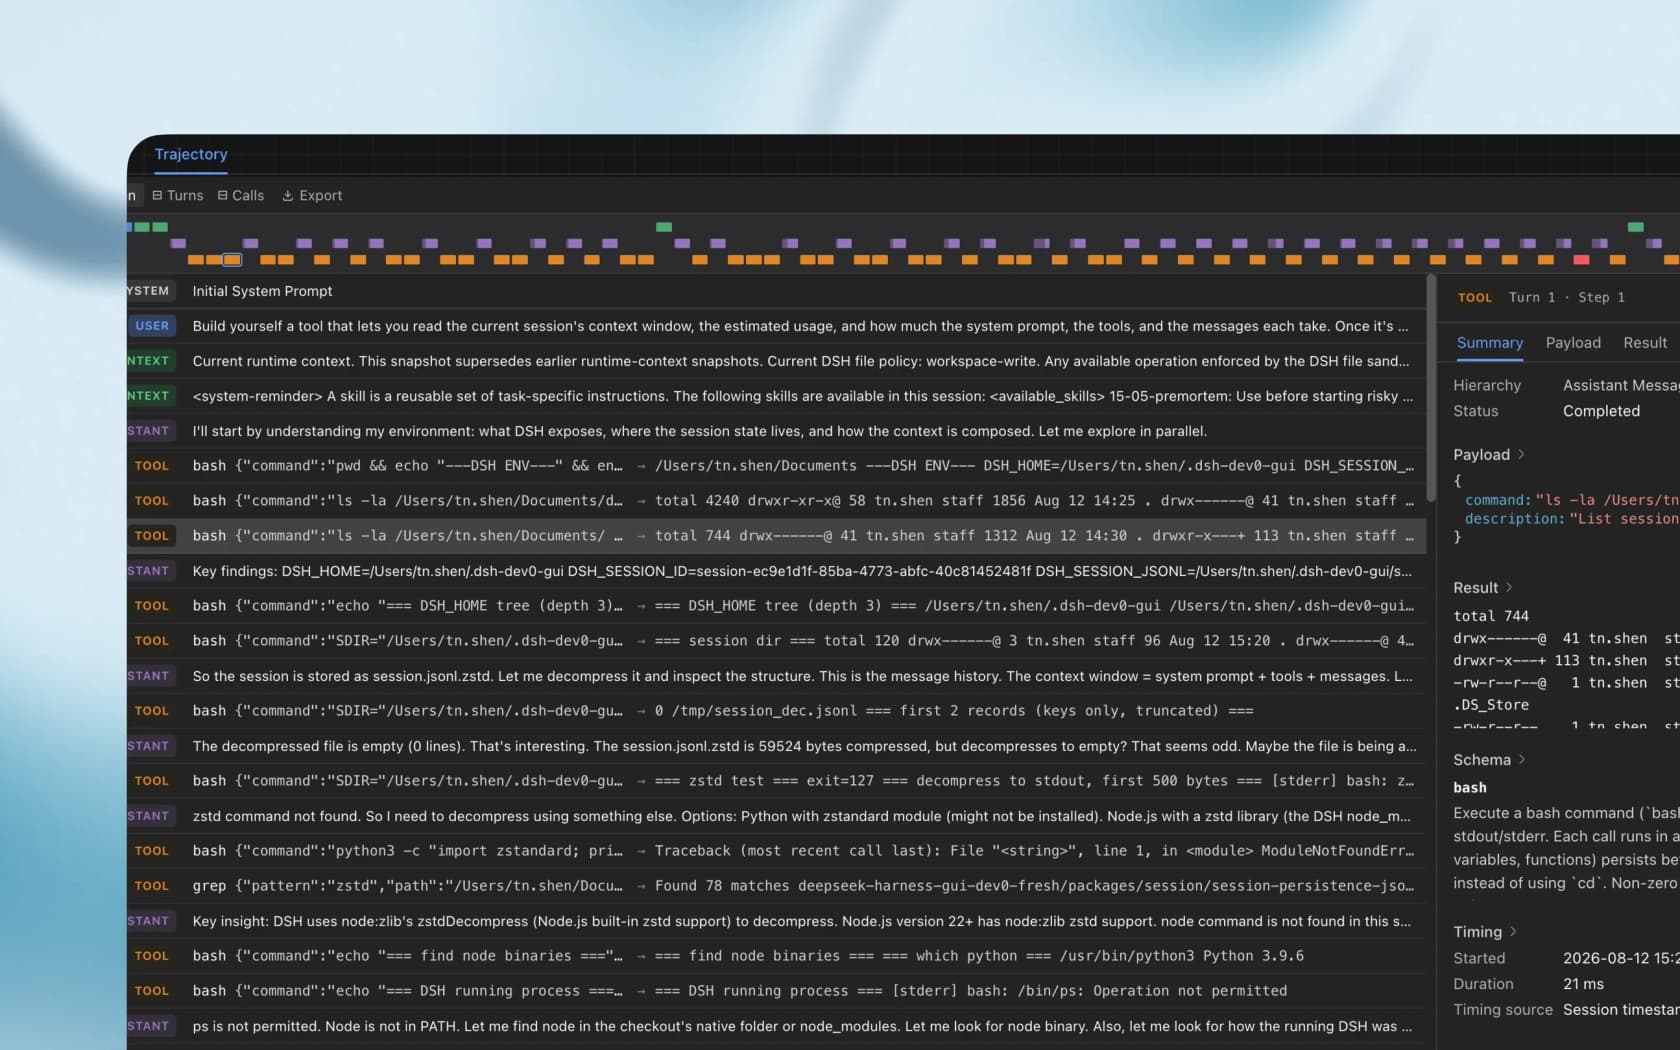
DeepSeek Harness, l'application d'agents propre à DeepSeek, est la troisième voie pendant la période gratuite (voir les alternatives à Harness si ce n'est pas votre outil). Sa vue de trajectoire montre chaque appel d'outil d'une session, ce qui est le moyen le plus simple que je connaisse de voir combien de recherches un agent fait réellement avant de commencer à les payer.
Ce que disent les développeurs
La première réaction portait sur le prix, et elle était bruyante. Le fil Hacker News sur le lancement a fait la comparaison qui intéresse les gens :
"For comparison that's $5 with Brave Search API and $12 with Kagi API"

Les développeurs qui avaient déjà construit leurs propres outils de recherche, souvent sous forme de serveur MCP, étaient eux aussi impressionnés :
"About a year ago I built my own search and fetch MCP tools for agents based on third-party scraping providers. It is about 15-20x more cost-effective than what OpenAI and Anthropic is offering with their integrated web search and fetch tools. Very impressive that DeepSeek has such a competitive offering today."
Le point de données le plus détaillé vient d'un utilisateur de Reddit qui a passé 353 requêtes et 196 fetches à la fois dans la nouvelle API et dans l'ancien chemin de recherche de DeepSeek, facturé aux tokens. Ses chiffres : le coût est passé de $0.64 à $0.41, et la latence de recherche de 4.3 secondes à moins de 0.9 seconde. (Le message dit que le modèle de DeepSeek l'a lui-même rédigé à partir des logs de l'utilisateur, et il n'a pas comparé avec Tavily, Exa ou Brave.) Son avis sur ce qui compte, au-delà des extraits et des dates qu'il obtient maintenant à la place d'URL nues :
"The 2.4× is nice. The real win is that the price is now predictable"

Sur la qualité, les avis sont plus mitigés. Un développeur qui fait tourner son propre benchmark de fetch n'a pas été convaincu :
"Ran a few quick tests on my web-fetch bench. As much as I like DeepSeek, its search and fetch aren't very good (is quite cheap tho). You'd probably be better off using free services like Jina directly, or if you're going paid, Parallel, Firecrawl, Tavily and Exa are all pretty good now."
Un autre a sondé ce qu'il y a derrière l'API :
"as expected, the typical "politically sensitive" search queries return 0 results"
Le même commentaire dit que le trafic de fetch sort par Huawei Cloud à Hong Kong. Aucun des deux testeurs n'a donné de chiffres précis : je les prendrais donc comme des raisons de tester, pas comme des verdicts. La question ouverte est celle à laquelle le widget ci-dessus tente de répondre :
"At $0.75 per 1000 requests, I want to know how many calls an agent makes in the background. Has anyone calculated the cost for typical research task?"
Et pour les équipes qui veulent simplement démarrer, l'avantage peu glamour a été relevé :
"I have been looking for Search API that will scale and no one is close to Deepseek's API search pricing. Deepseek also makes it easy to pay - just a credit card and you don't need to jump through any hoops to add money."
Là où elle est limitée
Le prix est réel, les limites aussi. Avant de changer de fournisseur de recherche, vérifiez ceci :
- Limite de débit. 5 requêtes par seconde par compte, c'est un dixième de ce qu'autorisent Brave et Perplexity. Suffisant pour un agent, serré pour un produit très fréquenté.
- Requêtes courtes. 128 caractères par requête : les longues questions en langage naturel doivent donc aller dans
ori_question. - Localisation des données. La politique de confidentialité de DeepSeek indique que des données personnelles peuvent être stockées sur des serveurs en République populaire de Chine, et cite l'amélioration de ses modèles parmi les usages des saisies des utilisateurs, avec un droit d'opposition. Les requêtes de recherche peuvent contenir des détails clients : c'est donc une vérification de conformité, pas une note de bas de page.
- Pas de conditions de conservation publiées pour la recherche. Brave décrit une conservation zéro des données par conception, et Exa et Firecrawl la proposent dans leurs offres entreprise. Je n'ai pas trouvé de déclaration équivalente pour les endpoints de recherche de DeepSeek.
- Résultats filtrés. Un testeur a signalé que les requêtes politiquement sensibles renvoient zéro résultat et que les fetches sortent par Huawei Cloud à Hong Kong. Si votre agent fait de la recherche sur l'actualité, la politique ou des sujets liés à la Chine, attendez-vous à des lacunes (et rappelez-vous que les résultats vides sont au moins gratuits).
- Un index que les extérieurs n'ont pas testé à grande échelle. DeepSeek dit que son moteur traite des centaines de millions de recherches par jour. À vous de tester, avec vos propres requêtes, comment il classe les résultats de niche en anglais face aux API adossées à Google ou à Brave, plutôt que de le croire sur parole.
Rien de tout cela n'est rédhibitoire pour un projet perso ou un outil de recherche interne. Pour tout ce qui s'adresse aux clients, en revanche, cela s'additionne vite.
Est-elle utile pour le support client ?
C'est là que je ralentirais. Une API de recherche web bon marché donne envie de construire un bot de support qui "va simplement chercher". Pour une petite part des questions, cela marche : le calendrier public des jours fériés d'un transporteur, le changelog d'un outil tiers que votre produit intègre, une réglementation qui a changé la semaine dernière.
La plupart des réponses de support ne sont toutefois pas sur le web ouvert, ce qui explique pourquoi les moteurs de recherche IA y sont mauvais. Elles se trouvent dans votre centre d'aide (souvent derrière un identifiant, comme celui de cette équipe matériel), dans d'anciens tickets, dans des macros et dans des documents internes. C'est le rôle d'une base de connaissances IA, pas d'un moteur de recherche. Une API de recherche web n'atteint rien de tout cela, et la pointer vers le web public invite le bot à citer la documentation d'un concurrent ou un message de forum vieux de trois ans comme s'il s'agissait de votre politique. eesel en a fait l'expérience à la dure : une réponse qui sonne sûre d'elle n'est pas la même chose qu'une bonne réponse, c'est pourquoi chaque déploiement eesel est simulé sur des tickets historiques avant de toucher un vrai client.
Pour le support, je traiterais donc la recherche web comme un outil étroit que vous autorisez pour des sources publiques précises, avec des filtres site:, pas comme la couche de connaissances principale. La couche principale, c'est votre propre contenu, avec des citations dans chaque réponse. Si vous la montez vous-même, mes notes sur le MCP pour le support client expliquent où les outils web ont leur place et où ils n'en ont pas.
Essayer eesel
L'API de recherche DeepSeek est de l'infrastructure : un moyen bon marché et rapide pour votre code de trouver et lire des pages publiques. Il vous resterait à construire tout ce qui rend une IA sûre à mettre devant des clients. eesel est l'employé, l'un d'une équipe de coéquipiers IA. Son coéquipier IA pour le helpdesk se connecte à Zendesk, Freshdesk, Gorgias et les autres, apprend de votre centre d'aide, de vos macros et de vos anciens tickets (y compris les centres d'aide derrière un identifiant), cite ses sources et tourne sur des centaines de vos tickets historiques avant de répondre à qui que ce soit.
Si vous êtes du genre à lire la documentation d'API de recherche pour le plaisir, vous voudrez probablement le piloter depuis un terminal. La CLI eesel le permet : npx @eesel/cli init chat-bubble --site <your-site> lance un espace de travail gratuit de 7 jours sans compte, eesel integrations connect zendesk branche votre helpdesk, eesel instructions modifie les règles permanentes du coéquipier et eesel activity montre ce qu'il a fait et pourquoi. Chaque commande affiche du JSON, les écritures acceptent --dry-run et eesel mcp token transforme votre espace de travail en serveur MCP, de sorte que Claude Code ou Codex puissent gérer votre coéquipier de support comme ils gèrent votre dépôt. Si vous écrivez du contenu au lieu de répondre à des tickets, la même équipe comprend un rédacteur de blog IA.

Démarrer est gratuit, avec 100 crédits et sans carte. Essayez eesel sur les tickets du mois dernier et voyez ce qu'il aurait répondu, et où il aurait cité vos documents plutôt que le web ouvert. Les offres sont sur la page des tarifs.
Questions fréquentes
Combien coûte l'API de recherche DeepSeek ?
L'API de recherche DeepSeek coûte $0.75 pour 1,000 requêtes réussies, et l'API Fetch coûte autant. Une requête n'est facturée que si elle renvoie HTTP 200 avec des résultats : les recherches vides, les échecs et les délais d'attente dépassés sont donc gratuits. Le détail complet figure dans la section facturation de DeepSeek, et vous pouvez le comparer au coût d'autres modèles dans mon article sur les tarifs de DeepSeek Flash.
La recherche web DeepSeek est-elle gratuite dans Claude Code ?
Pour l'instant, oui. Quand vous utilisez Claude Code, Codex ou DeepSeek Harness avec l'API DeepSeek, les recherches web côté serveur passent gratuitement par les API Search et Fetch jusqu'à 00:00 heure de Pékin le 1er novembre 2026. Ensuite, elles sont facturées au tarif normal de l'API de recherche DeepSeek, plus les tokens du modèle utilisés pour lire les résultats.
Quelle est la limite de débit de l'API de recherche DeepSeek ?
Search et Fetch autorisent chacune 5 requêtes par seconde et par compte, quel que soit le nombre de clés d'API utilisées. Fetch ajoute aussi une limite par domaine. Les requêtes au-delà de la limite reçoivent HTTP 429 : des agents IA en parallèle ont donc besoin d'une file d'attente ou d'une nouvelle tentative avec backoff.
L'API de recherche DeepSeek fonctionne-t-elle avec DeepSeek Flash ?
Les endpoints autonomes Search et Fetch fonctionnent avec n'importe quel modèle, puisque vous les appelez vous-même et transmettez les résultats. L'outil intégré web_search de la Responses API et de Codex ne tourne en revanche que sur deepseek-v4-pro et est ignoré avec deepseek-flash. Ma comparaison Flash vs Pro couvre le reste des différences.
Puis-je utiliser l'API de recherche DeepSeek pour un chatbot de support client ?
Vous pouvez, mais elle ne trouve que des pages web publiques. La plupart des réponses de support se trouvent dans un centre d'aide protégé par un identifiant, dans d'anciens tickets et dans des macros qu'aucune recherche web n'atteint. Un coéquipier IA pour le helpdesk comme eesel apprend à partir de ces sources privées, et vous pouvez le tester sur d'anciens tickets avant sa mise en service.
Que renvoie l'API Fetch de DeepSeek ?
L'API Fetch prend une URL et renvoie le titre de la page ainsi que le contenu en Markdown. Elle coûte autant que l'API de recherche DeepSeek, $0.75 pour 1,000 requêtes réussies, et les pages qu'elle ne peut pas lire renvoient un 404 non facturé. Elle joue le même rôle qu'un scraper comme Firecrawl, sans l'exploration ni les options de mise en forme.
Comment l'API de recherche DeepSeek se compare-t-elle à Brave, Exa et Tavily ?
Sur le tarif public, c'est la moins chère que j'aie trouvée : $0.75 pour 1,000 recherches contre $5 pour Brave, $4 pour Exa Instant et $8 pour la recherche basique à l'usage de Tavily. La contrepartie est une limite de débit plus basse (5 par seconde) et un index encore récent pour les développeurs extérieurs. Si vous voulez choisir entre plusieurs fournisseurs derrière un seul endpoint, la Cloudflare Web Search API est une autre option.