

Combien coûte la DeepSeek Search API ?
Je suis Rama, et je m'occupe des intégrations et de la plomberie d'API chez eesel. J'ai passé beaucoup de temps à brancher des outils de recherche sur des agents, et le schéma est toujours le même : le prix par appel paraît minuscule, puis la vraie facture apparaît ailleurs. J'ai donc lu la documentation de DeepSeek de bout en bout avant de faire le moindre calcul.
DeepSeek a lancé Search et Fetch le 17 octobre 2026, le même jour que DeepSeek V4.1 Flash 1017. Ce sont deux endpoints JSON autonomes sur api.deepseek.com, avec la même clé d'API que les modèles. Voici la grille tarifaire complète de la page Models & Pricing :
| API | Endpoint | Unité de facturation | Prix | Limite de débit |
|---|---|---|---|---|
| Search | POST /v1/tools/search | Pour 1 000 requêtes réussies | $0.75 | 5 QPS par compte |
| Fetch | POST /v1/tools/fetch | Pour 1 000 requêtes réussies | $0.75 | 5 QPS par compte, plus une limite par domaine |
Par appel, cela fait $0.00075. Mille recherches coûtent moins qu'un café, et un million coûte $750.
Il n'y a pas de distinction entre heures pleines et creuses sur ces deux lignes. Les modèles DeepSeek divisent par deux leurs prix de tokens en dehors des heures de pointe, mais Search et Fetch ont un prix fixe par requête à toute heure.
Le guide Search & Fetch indique que Search tourne sur le moteur interne de DeepSeek, que le changelog décrit comme indexant "hundreds of billions of web pages". Chaque résultat arrive avec un titre, une URL, un court extrait, un summary plus long écrit pour être lu par un modèle, une date, un score authority de 0 à 4 et, en option, le contenu complet de la page.
Qu'est-ce qui est facturé exactement ?
Cette partie du tarif de la DeepSeek Search API est plus généreuse qu'elle n'en a l'air, alors elle mérite une lecture lente. D'après la section facturation du guide, une requête n'est facturable que si elle renvoie HTTP 200 et produit réellement quelque chose : un tableau results non vide pour Search, le contenu de la page pour Fetch.
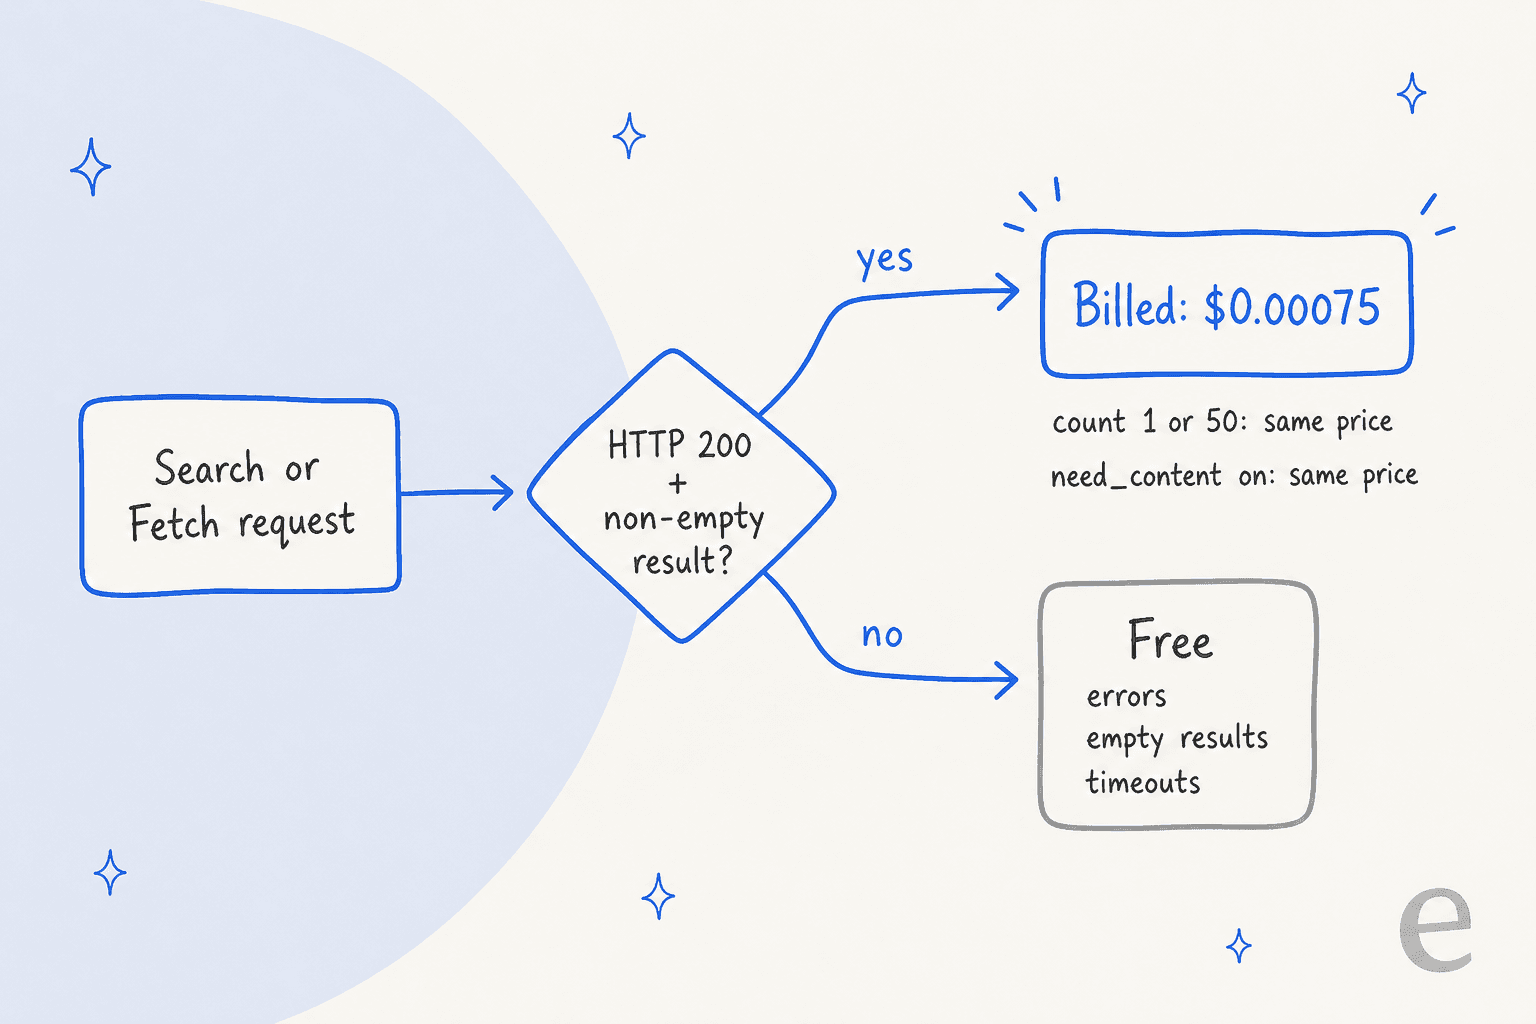
Trois détails qui représentent de l'argent réel :
- Les recherches vides sont gratuites. Si votre agent lance une requête étroite avec des filtres
site:etafter:et n'obtient rien, vous ne payez rien. La Search API de Perplexity fait l'inverse : sa page de tarifs indique qu'une réponse réussie est facturée même sans résultat. countne change pas le prix. Demander 50 résultats coûte les mêmes$0.00075que d'en demander 1. Exa facture$1pour 1 000 requêtes pour chaque résultat au-delà de 10, et Firecrawl facture 2 crédits pour 10 résultats.need_content: trueest inclus. L'activer renvoie le texte de la page dans chaque résultat de recherche, sans coût supplémentaire. Une recherche avec contenu peut remplacer une recherche plus plusieurs appels Fetch.
Les appels Fetch échoués sont aussi gratuits. Un 403 dû à la politique de sécurité de DeepSeek, un 404 parce que la page n'avait pas de Markdown extractible, ou un délai 504 ne coûtent rien. La seule façon de payer pour un mauvais appel est qu'il réussisse techniquement avec du contenu inutile, le même risque qu'avec n'importe quel scraper.
Quand la période gratuite se termine-t-elle ?
Réponse courte : le 1er novembre 2026 à 00:00, heure de Pékin, soit 16:00 UTC le 31 octobre.
Le détail qui piège les gens, c'est ce que couvre la période gratuite. La note de DeepSeek, répétée sur la page de tarifs et dans le guide, indique que lorsque vous utilisez l'API via DeepSeek Harness, Claude Code ou Codex, "server-side tool calls already hit the Search and Fetch APIs. These calls are currently free of charge". La fenêtre gratuite nomme ces trois clients. Les appels directs à /v1/tools/search depuis votre propre code sont des API autonomes facturées dès le lancement.
Voici à quoi ressemble la recherche côté serveur quand Claude Code tourne sur DeepSeek. Une question, deux recherches :
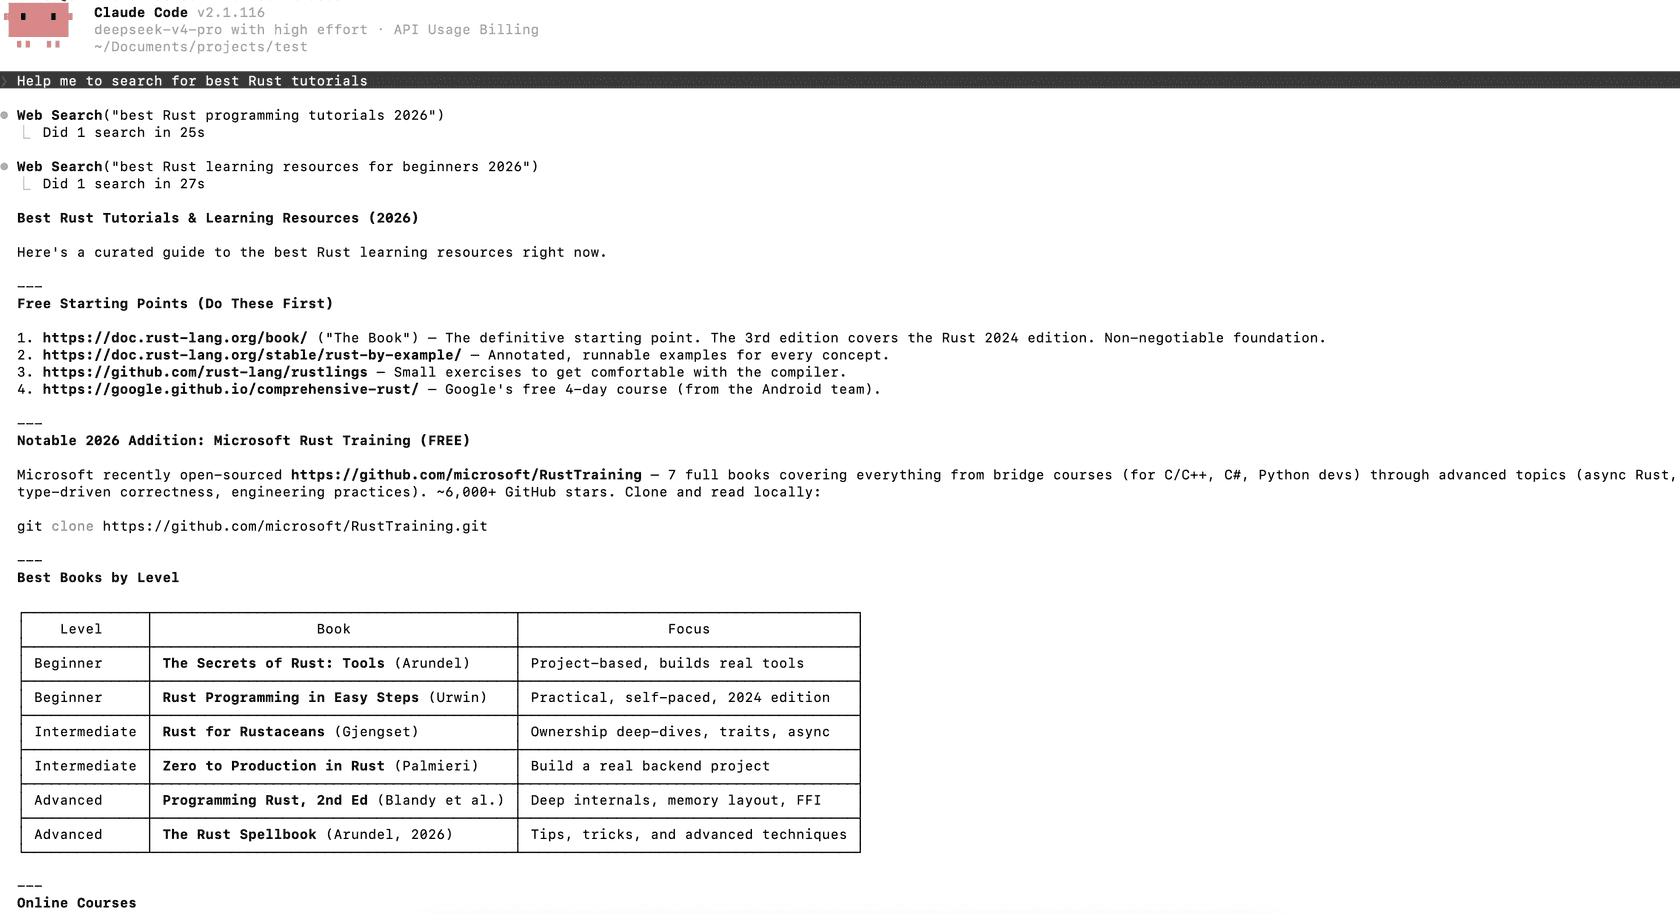
Après le 1er novembre, ces deux recherches coûtent $0.0015. La page d'intégration de Claude Code précise que les frais de recherche ne sont pas toute la facture : invoquer l'outil "generates additional LLM API requests to summarize the retrieved search content, additional model token costs will be incurred."
Le modèle capable de chercher côté serveur varie aussi selon la surface :
| Surface | Recherche côté serveur | Limite de modèle |
|---|---|---|
Outil web_search de la Responses API | Oui | deepseek-v4-pro uniquement, ignoré sur deepseek-flash |
| Codex | Oui, avec web_search = "live" | deepseek-v4-pro uniquement |
| Claude Code | Oui, Web Search natif | Aucune limite de modèle indiquée |
| API au format Anthropic | server_tool_use et web_search_tool_result pris en charge | Non indiqué |
| Chat Completions | Pas d'outil de recherche intégré | Utiliser l'API autonome |
Donc, si votre agent tourne sur Flash via la Responses API, l'outil intégré est ignoré sans avertissement. Vous appelleriez vous-même la Search API autonome et renverriez les résultats comme sortie d'outil, ce qui est de toute façon moins cher en tokens.
Que coûte vraiment une tâche d'agent ?
Un utilisateur de Reddit a posé la vraie question mieux que moi :
"At $0.75 per 1000 requests, I want to know how many calls an agent makes in the background. Has anyone calculated the cost for typical research task?"

Voici donc mon calcul. Prenons une tâche de recherche où l'agent lance 20 recherches et ouvre 10 pages. Cela fait 30 appels facturables, soit $0.0225 de frais.
Maintenant le coût de lecture. Le guide dit que chaque summary fait "typically 600 to 800 characters", soit environ 200 tokens, donc 10 résultats représentent environ 2 000 tokens par recherche. J'ai supposé 5 000 tokens par page récupérée. Cela donne environ 90 000 tokens d'entrée. Aux tarifs hors pointe avec cache manqué de DeepSeek, $0.15 par million sur Flash et $0.66 sur V4 Pro :
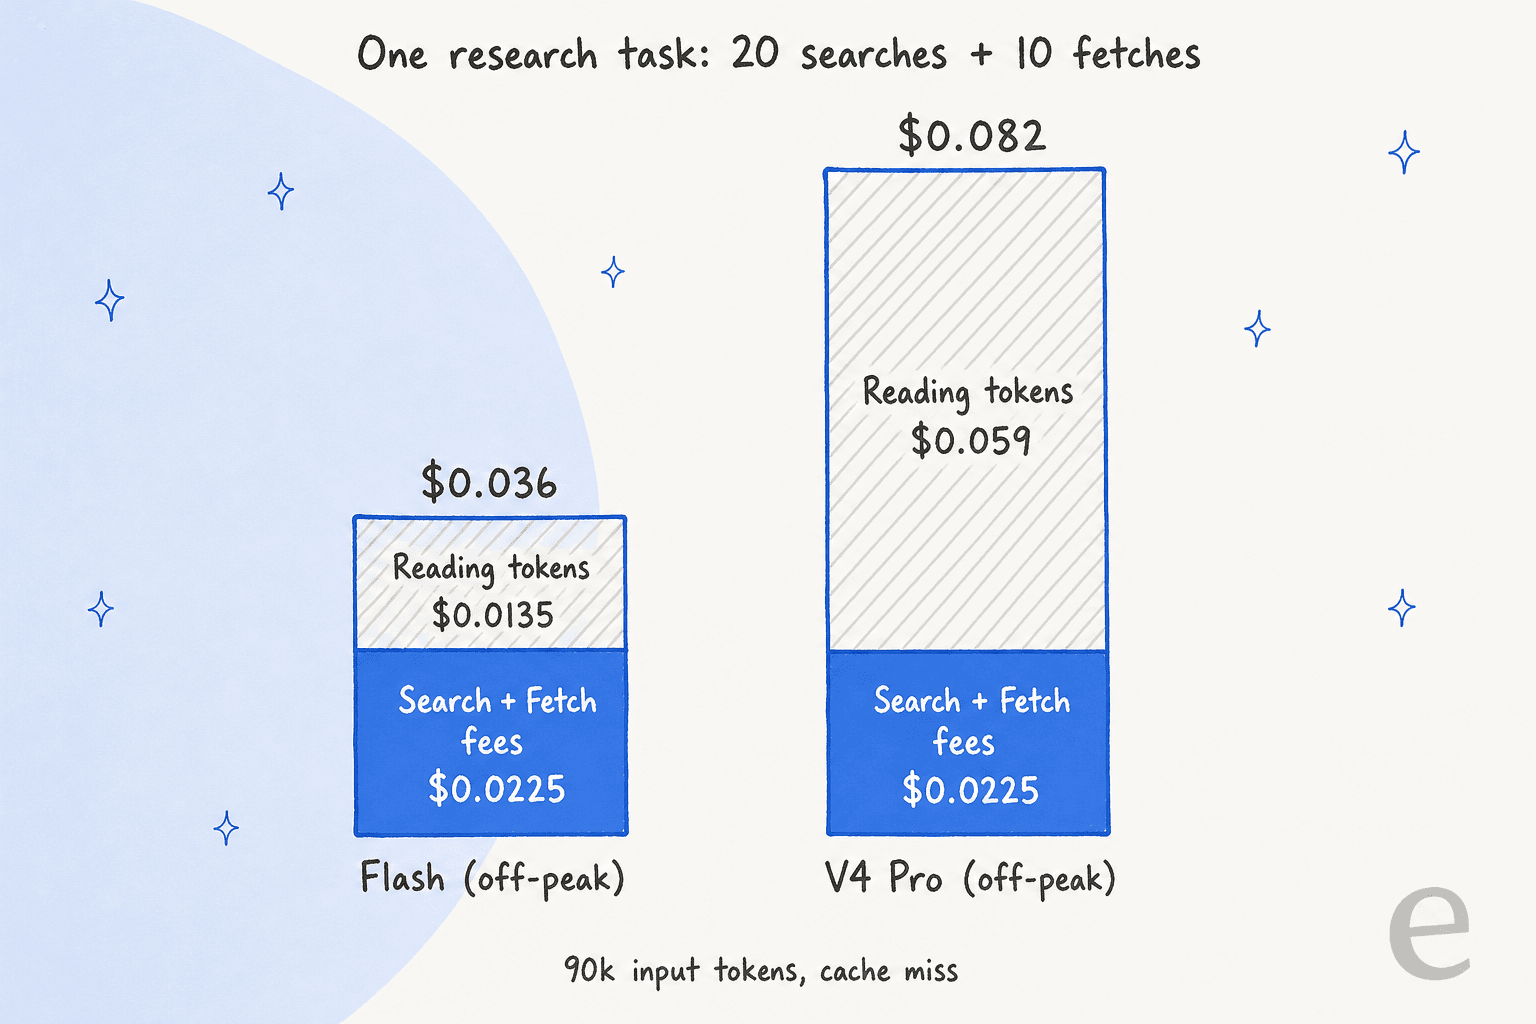
C'est le renversement à retenir. Sur la plupart des outils de recherche, les frais par appel sont la petite part et les tokens du modèle dominent. Sur Flash, c'est l'inverse : les frais de recherche représentent environ 60 % du coût de recherche de la tâche, parce que les tokens d'entrée de Flash sont très bon marché. Sur V4 Pro, les tokens reprennent le dessus. Pendant les heures de pointe (01:00 à 04:00 et 06:00 à 10:00 UTC en semaine), la part des tokens double tandis que la part des frais ne bouge pas.
Les tokens de sortie et le raisonnement du modèle ne figurent pas dans ces chiffres, et sur le travail d'agent ils sont souvent la plus grosse ligne. Mon détail des tarifs de DeepSeek V4.1 Flash couvre ce côté.
Si vous construisez vous-même la boucle d'agent au lieu de vous appuyer sur Claude Code, mon guide de l'API DeepSeek V4 Flash couvre les appels d'outils et la configuration de la Responses API, et les outils MCP de Claude Code sont l'autre moyen courant de donner un outil de recherche à un agent.
Comment se compare-t-elle aux autres API de recherche ?
J'ai relevé chaque prix ci-dessous sur la page de tarifs de chaque fournisseur, le même jour. Les unités de facturation diffèrent, donc la colonne "pour 1 000" correspond à la recherche par défaut de chacun.
| API de recherche | Unité de facturation | Pour 1 000 recherches | Tokens du modèle en plus ? | Quota gratuit | Limite de débit |
|---|---|---|---|---|---|
| DeepSeek Search | Requête réussie avec résultats | $0.75 | Seulement le modèle associé | Aucun indiqué | 5 QPS |
| Perplexity Fast Search | Requête réussie (jusqu'à 5 requêtes) | $1.00 | Non | Aucun indiqué | 50 unités/s |
| Firecrawl Scale | Crédits (2 pour 10 résultats) | $1.20 (nécessite $599/mois en annuel) | Non | 500 recherches/mois | 10 000/min |
| Exa Instant | Requête, jusqu'à 10 résultats | $4.00 | Non | $10/mois de crédits | 10 à 25 QPS |
| Brave Search API | Requête | $5.00 | Non | $5/mois de crédits | 50 req/s |
| Perplexity Search | Requête réussie | $5.00 | Non | Aucun indiqué | 50 unités/s |
| Tavily | Crédit (recherche basique = 1) | $8.00 paiement à l'usage | Non | 1 000 crédits/mois | 1 000 RPM |
| Outil de recherche web d'OpenAI | Appel d'outil | $10.00 | Oui | Aucun indiqué | Limites du modèle |
| Outil de recherche web d'Anthropic | Recherche effectuée | $10.00 | Oui | Aucun indiqué | Par organisation |
| Gemini Grounding (Gemini 3+) | Requête de recherche | $14.00 | Tokens du modèle uniquement | 5 000/mois | Limites du modèle |
Si l'on passe à un produit qui fait 100 000 recherches par mois, l'écart devient difficile à ignorer :
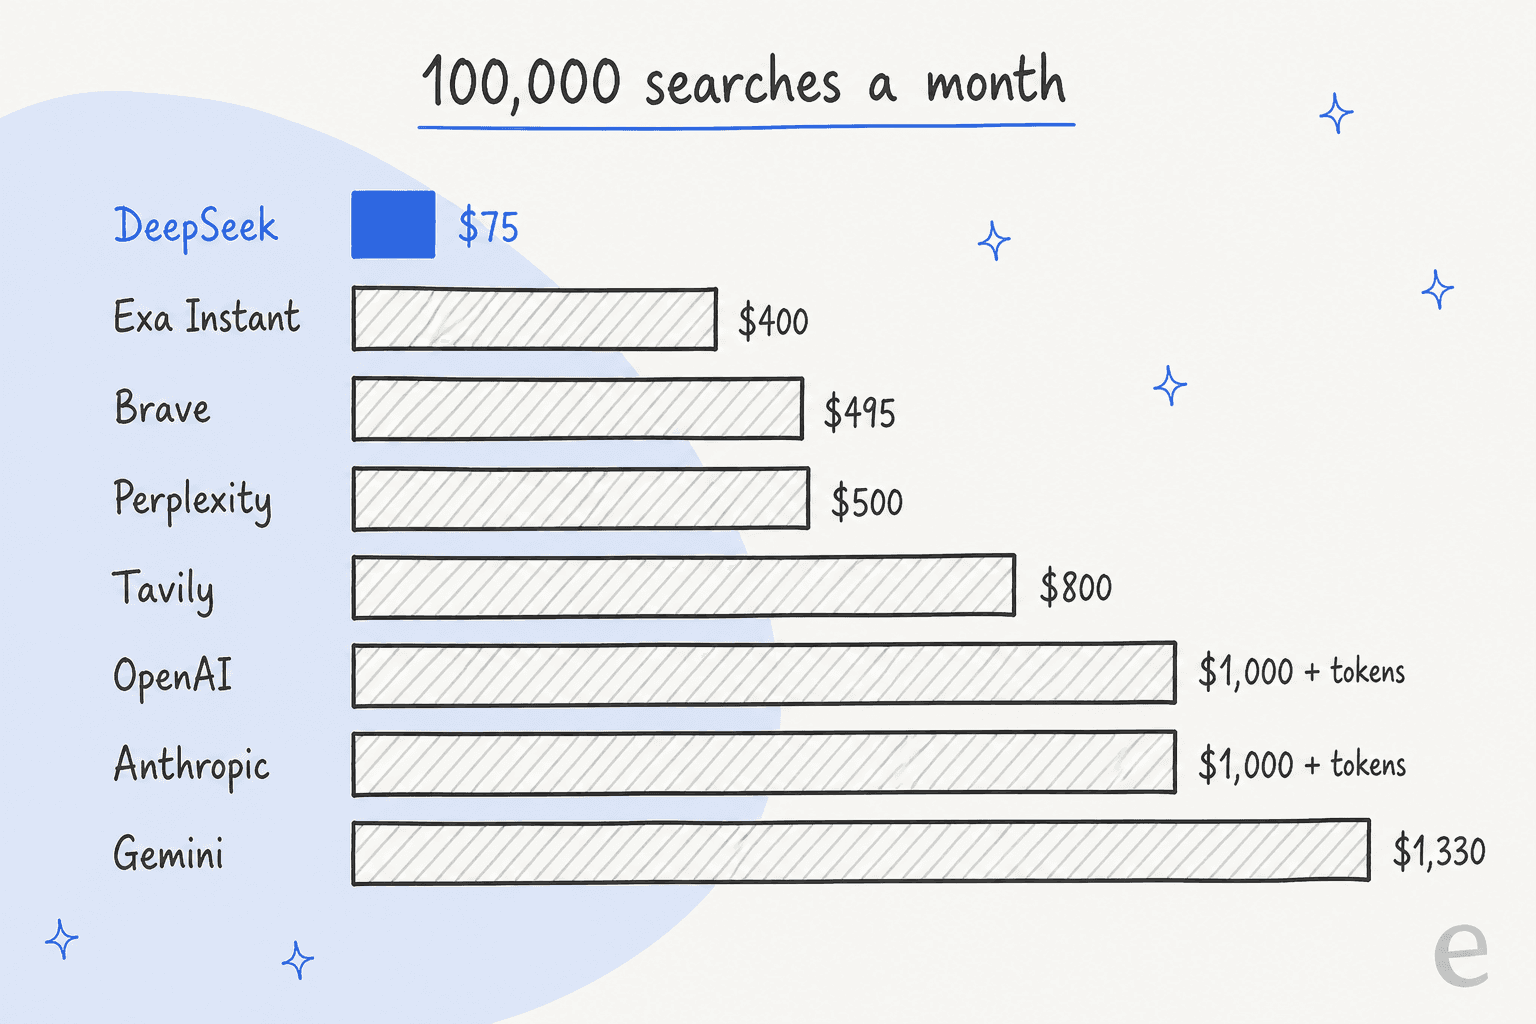
Le chiffre de Brave déduit son crédit mensuel de $5, et celui de Gemini déduit les 5 000 recherches gratuites. Même ainsi, DeepSeek revient à environ 1/7 de Brave et 1/18 de Gemini. Des commentateurs du fil de lancement l'ont comparé aux outils qu'ils paient déjà :
"For comparison that's $5 with Brave Search API and $12 with Kagi API"

Un autre développeur, qui avait déjà monté sa propre pile de recherche, décrit ainsi l'écart avec les outils intégrés des fournisseurs de modèles :
"About a year ago I built my own search and fetch MCP tools for agents based on third-party scraping providers. It is about 15-20x more cost-effective than what OpenAI and Anthropic is offering with their integrated web search and fetch tools. Very impressive that DeepSeek has such a competitive offering today."
Là où le prix plus bas ne l'emporte pas :
- Débit. 5 QPS est le plafond annoncé le plus bas de cette liste. Brave autorise 50 par seconde, Exa jusqu'à 25 en paiement à l'usage et Tavily 1 000 par minute avec des clés de production.
- Traitement des données. Brave vend la rétention zéro des données comme partie de son architecture, et Exa et Firecrawl la proposent en Enterprise. La documentation Search de DeepSeek ne mentionne pas la rétention, et sa politique de confidentialité indique que des données personnelles peuvent être stockées en République populaire de Chine. Pour des données réglementées, lisez-la avant de l'intégrer.
- Offre gratuite pour le prototypage. Tavily, Exa, Brave et Firecrawl donnent tous un quota mensuel sans carte. DeepSeek est payant dès le premier appel réussi, même si un dollar de crédit couvre environ 1 333 recherches.
Si vous préférez ne pas choisir un seul fournisseur, l'API de recherche web de Cloudflare route vers plusieurs fournisseurs aux prix très variables. Pour la partie scraping de la pile, je regarderais aussi les alternatives à Firecrawl et les alternatives à Perplexity.
Estimez votre propre facture
Saisissez votre volume mensuel et le modèle que vous associez. Les valeurs par défaut correspondent à l'exemple chiffré ci-dessus : 2 000 tokens pour lire une recherche et 5 000 pour lire une page récupérée.
La colonne de comparaison ne montre que les frais de recherche, car la tarification du fetch et du contenu chez les autres fournisseurs fonctionne différemment (Exa facture Contents par page, le web fetch d'Anthropic n'a pas de frais, Tavily facture Extract en crédits).
Où la limite de débit pose-t-elle problème ?
5 requêtes par seconde semble suffisant, jusqu'à ce qu'on fasse la multiplication. Cela donne 432,000 recherches par jour et par compte, soit environ 13 millions par mois si le trafic était parfaitement régulier. En dépense, cela plafonne un compte à environ $324 par jour sur Search.
Le guide est précis sur le fonctionnement de la limite :
- Elle s'applique par compte, pas par clé d'API, donc créer plus de clés n'aide pas.
- Search et Fetch ont des budgets séparés de 5 QPS, et le trafic de l'un ne consomme pas celui de l'autre.
- Fetch a un plafond supplémentaire par domaine, donc un agent qui martèle un seul site reçoit un HTTP 429 avant d'atteindre la limite du compte.
- La limite de recherche est distincte de la concurrence du modèle (
2,500sur Flash,500sur V4 Pro).
Pour un développeur seul ou un traitement par lots, 5 QPS est largement suffisant. Si vous comparez d'autres API de modèles à bas coût à associer, les tarifs de Kimi K3 et les tarifs de Qwen 3.8 Max sont les concurrents les plus proches. Pour un produit orienté client où 30 personnes posent des questions à la même seconde, c'est le premier mur que vous rencontrez. Le trafic arrive par rafales, donc planifiez sur les pics, pas sur les moyennes. Une file d'attente avec nouvel essai sur 429 est le minimum. La documentation dit d'attendre et de réessayer sur 408, 429 et 5xx, et de ne pas réessayer les autres erreurs 4xx sans modifier la requête.
Comment garder la facture basse ?
Comme DeepSeek facture par appel réussi plutôt que par résultat ou par token, les astuces d'économie habituelles changent de forme. Voici ce que je ferais :
- Demandez plus de résultats, moins souvent. Réglez
countsur 20 ou 50 dès la première recherche au lieu d'en lancer trois étroites. Même prix, moins d'appels. - Utilisez
need_contentavant de recourir à Fetch. Si le contenu de la recherche suffit, vous évitez un Fetch à$0.00075et un second aller-retour. - Appuyez-vous sur les opérateurs de requête.
site:,-site:,lang:,after:et la correspondance de phrase exacte passent intacts. Une requête précise qui ne renvoie rien est gratuite ; une requête vague qui renvoie du bruit est facturée. - Filtrez sur
rerank_scoreetauthorityavant que le modèle ne lise. DeepSeek considère unrerank_scorede 1.5 ou plus comme de haute qualité, et uneauthorityde 3 ou plus comme très faisant autorité. Écarter les résultats faibles avant qu'ils n'atteignent le modèle réduit la part de tokens de la facture. - Envoyez
ori_question. Il transmet la question d'origine de l'utilisateur pour améliorer la compréhension de la requête, donc l'agent a besoin de moins de recherches de suivi. - Planifiez les traitements par lots hors pointe. Les frais de recherche ne changent pas, mais le modèle qui lit les résultats coûte moitié moins en dehors des heures de pointe.
Si vous faites passer Claude Code par DeepSeek, vérifiez aussi votre sélection de modèle et n'oubliez pas que la facture DeepSeek remplace vos habituels tarifs de Claude Code au lieu de s'y ajouter. DeepSeek associe les noms de modèle claude-opus à V4 Pro et claude-sonnet et claude-haiku à Flash, donc la même recherche peut coûter environ 4x plus cher à lire selon le nom qu'envoie votre configuration.
Est-ce rentable pour le support ou le RAG ?
Pour un développeur qui construit l'un des meilleurs agents IA pour la recherche ou le code, oui. À ce prix, la recherche web n'est plus un poste qu'on rationne, et elle rend DeepSeek Harness et Codex sur DeepSeek moins chers à faire tourner que la même boucle sur GPT-5.6. Associée à Flash, une tâche de recherche typique coûte quelques centimes.
Pour le support client, je ferais une pause avant de l'intégrer. D'après mon expérience, la plupart des questions de support trouvent leur réponse dans votre propre centre d'aide, vos macros et vos anciens tickets, pas sur le web public. Une API de recherche web est le bon outil pour "que signifie le statut de suivi de ce transporteur" et le mauvais pour "quelle est notre politique de remboursement". La seconde relève de la récupération sur votre propre contenu, et c'est là que les bots de support se trompent vraiment. Un appel de recherche bon marché ne corrige pas un agent qui sort avec assurance un article de blog plutôt que votre politique réelle, c'est pourquoi la recherche hybride sur vos propres documents compte plus ici que la portée web.
C'est aussi là que se trouve l'essentiel du coût. La facture d'API d'un bot de support est faible comparée au temps passé à construire le pipeline de récupération, à connecter l'API du helpdesk, à écrire des règles d'escalade et à le tester avant que les clients ne le voient. J'ai détaillé où va cet argent dans coût du service client IA.
Un coéquipier de support plutôt qu'un pipeline de recherche
La DeepSeek Search API est de l'infrastructure, et d'un excellent rapport qualité-prix. eesel est l'employé. Son coéquipier IA helpdesk se branche sur Zendesk, Freshdesk, Gorgias et d'autres, apprend de votre centre d'aide et de vos anciens tickets, et rédige ou envoie des réponses dans la file où vous travaillez déjà. Avant qu'il ne touche un ticket réel, vous pouvez le lancer sur vos tickets historiques et voir ce qu'il aurait répondu, l'étape que je ne sauterais jamais après avoir vu un bot sûr de lui donner une mauvaise réponse sur une vraie file.

Si vous êtes du genre d'équipe à lire les pages de tarifs d'API pour le plaisir, la CLI d'eesel vous semblera familière. Elle met le même coéquipier dans votre terminal : eesel init chat-bubble --site https://your-site.com crée un agent qui commence à lire votre site, eesel files upload ajoute un document de politique, eesel integrations connect zendesk branche le helpdesk et eesel approvals liste les actions retenues pour un humain. Chaque commande affiche du JSON, donc Claude Code ou Codex peuvent exécuter toute la configuration à votre place, et chaque espace de travail est aussi un serveur MCP. Tout ce que vous configurez dans le terminal apparaît dans le tableau de bord, car c'est le même agent.
Vous pouvez essayer eesel sans carte. C'est la voie la plus rapide si ce dont vous avez vraiment besoin, ce sont des tickets traités et non un pipeline de recherche.
Questions fréquentes
Combien coûte la DeepSeek Search API ?
$0.75 pour 1 000 requêtes réussies, et la Fetch API coûte la même chose. L'appel lui-même n'est pas facturé en tokens, mais le modèle DeepSeek qui lit les résultats facture les tokens à son tarif habituel.La DeepSeek Search API est-elle gratuite ?
$0.75 pour 1 000.DeepSeek facture-t-il les recherches échouées ou vides ?
Le paramètre count change-t-il le tarif de la DeepSeek Search API ?
count peut aller de 1 à 50 résultats et le prix par requête reste le même. Activer need_content pour obtenir le texte des pages dans les résultats est aussi inclus, donc une recherche peut parfois remplacer une recherche plus plusieurs fetches.
Comment les tarifs de la DeepSeek Search API se comparent-ils à Brave, Exa et Tavily ?
$0.75pour 1 000 recherches, contre$5pour Brave,$4pour Exa Instant et$8pour Tavily en paiement à l'usage. Le compromis est une limite de 5 QPS par compte, bien inférieure à celle de Firecrawl ou de Brave sur les offres payantes.