

En bref
DeepSeek V4.1 Flash 1017 est la mise à jour du 17 octobre 2026 de DeepSeek V4.1 Flash. Le prix par token n'a pas changé ($0.15 en entrée et $0.60 en sortie par million de tokens en heures creuses), mais le modèle écrit désormais des réponses plus courtes et termine les tâches plus vite, si bien que chaque tâche terminée coûte moins cher. Sur le graphique de codage de DeepSeek, une tâche à effort maximal est passée d'environ $0.50 à environ $0.20, tandis que le taux de réussite montait de 74.2% à 77.0%.
Tous les benchmarks publiés par DeepSeek ont progressé, en tête Terminal-Bench 4.0 (31.2 à 42.3) et HLE sans outils (36.8 à 42.6). DeepSeek a aussi lancé des API Search et Fetch payantes à $0.75 pour 1 000 appels réussis chacune, et a maintenu V4 Pro en vie après avoir prévu de le retirer.
Pour les équipes de support, c'est un moteur moins cher et meilleur, pas un agent de support terminé. Si vous voulez une IA qui travaille votre file de tickets plutôt qu'un modèle autour duquel construire, le coéquipier IA d'eesel pour helpdesk se branche sur le helpdesk que vous utilisez déjà et est testé sur vos anciens tickets avant de parler à un client.
Qu'est-ce que DeepSeek V4.1 Flash 1017 ?
Je conçois des fonctionnalités produit et des agents IA chez eesel, et l'équipe passe depuis des années son temps à faire tourner de l'IA sur de vraies files de support. Une habitude m'est restée de ce travail : quand un fournisseur de modèle annonce « même prix », je vais vérifier ce que coûte un travail terminé, parce que c'est ce chiffre que suit la facture.
DeepSeek V4.1 Flash 1017 est une mise à jour mineure du modèle DeepSeek V4.1 Flash sorti le 10 septembre. Selon le journal des modifications de DeepSeek, l'application web officielle, l'application mobile et l'API sont toutes passées à la nouvelle version le 17 octobre 2026. L'appel d'API reste identique : vous continuez à utiliser le nom de modèle deepseek-flash et obtenez 1017 automatiquement.
Dessous, c'est toujours la même famille de modèles : un modèle à mélange d'experts de 552B avec la nouvelle architecture présentée par DeepSeek en septembre, des poids ouverts sous licence MIT et une fenêtre de contexte de 1M de tokens. Si vous voulez l'histoire de l'architecture, la présentation du lancement rédigée par mon collègue la couvre. Cet article traite de ce qui change.
| Élément | Version de septembre | Version 1017 |
|---|---|---|
| Nom du modèle dans l'API | deepseek-flash | deepseek-flash (identique) |
| Prix des tokens | $0.15 en entrée / $0.60 en sortie en heures creuses | Inchangé |
| Longueur des sorties | Référence | Plus courte, selon DeepSeek |
| Durée d'exécution des tâches | Référence | Plus rapide, selon DeepSeek |
| Recherche web pour développeurs | Non vendue séparément | API Search et Fetch, $0.75 pour 1 000 appels |
| Poids ouverts | MIT sur Hugging Face | MIT sur Hugging Face |
Cette première ligne a une conséquence discrète. Comme l'alias a bougé, toutes les applications qui pointent vers deepseek-flash ont changé de modèle le 17 octobre, que leur propriétaire l'ait remarqué ou non. La page de tarifs ne liste aucun nom distinct pour la version de septembre, et même les anciens noms deepseek-v4-flash retirés sont désormais servis par 1017. Si vous avez des prompts réglés pour des sorties longues et soignées, testez-les cette semaine.
De combien progresse-t-il sur les benchmarks ?
La note de lancement de DeepSeek parle d'« une amélioration de Pareto en performance et en coût », et les chiffres confirment la première moitié de la formule. Chacun des 11 benchmarks du tableau officiel a progressé par rapport à la version de septembre.
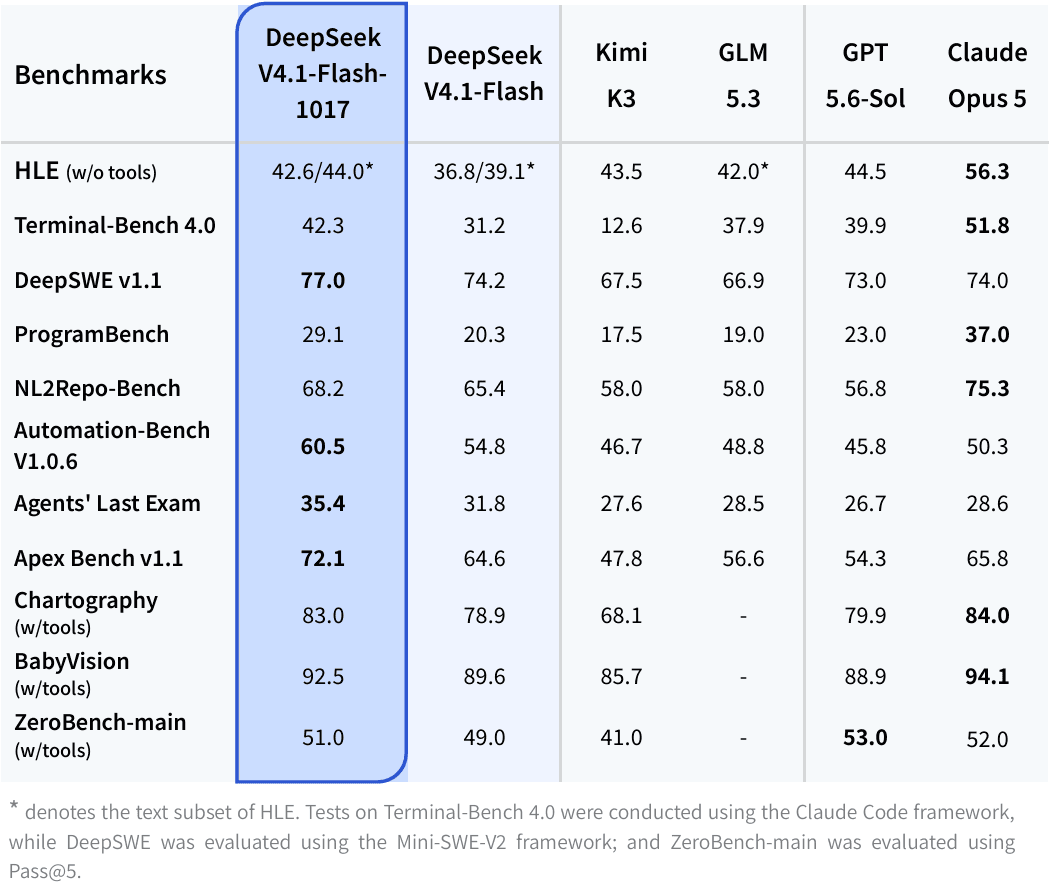
Voici l'écart, avec Claude Opus 5 tiré du même tableau comme point de référence :
| Benchmark | V4.1 Flash (sept.) | V4.1 Flash 1017 | Variation | Claude Opus 5 |
|---|---|---|---|---|
| HLE (sans outils) | 36.8 | 42.6 | +5.8 | 56.3 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 | 51.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 | 74.0 |
| ProgramBench | 20.3 | 29.1 | +8.8 | 37.0 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 | 75.3 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 | 50.3 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 | 28.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 | 65.8 |
| Chartography (avec outils) | 78.9 | 83.0 | +4.1 | 84.0 |
| BabyVision (avec outils) | 89.6 | 92.5 | +2.9 | 94.1 |
| ZeroBench-main (avec outils) | 49.0 | 51.0 | +2.0 | 52.0 |
Le plus gros bond est celui de Terminal-Bench 4.0, en hausse de 11,1 points, que DeepSeek a exécuté dans le harness de Claude Code. C'est le benchmark le plus proche de ce que fait un agent de codage toute la journée dans un terminal, il compte donc plus que le gain sur HLE pour la plupart des développeurs.
La lecture honnête est plus nuancée que « il bat tout le monde ». 1017 mène désormais tout le tableau sur DeepSWE, Automation-Bench, Agents' Last Exam et Apex Bench, qui sont des tests d'agents et d'automatisation. Opus 5 reste en tête sur le raisonnement brut (HLE), sur Terminal-Bench 4.0 et sur les deux tests de construction de dépôts. Et Kimi K3 le devance de peu sur HLE sans outils, 43.5 contre 42.6. La nature du modèle n'a donc pas changé depuis septembre : un très solide cheval de trait qui manie les outils, pas le meilleur raisonneur. Ce sont aussi les propres mesures de DeepSeek, et nous en saurons plus quand les classements indépendants auront rattrapé leur retard.
Pourquoi un prix identique donne-t-il une facture plus petite ?
C'est la partie que la plupart des articles sur le lancement passent sous silence. Les modèles d'API facturent au token, et un agent dépense l'essentiel de ses tokens en sortie, y compris les tokens de réflexion, que DeepSeek facture comme de la sortie. Si le modèle arrive à la même réponse avec moins de mots, vous payez moins pour la tâche, même quand le prix par token reste le même.
DeepSeek dit avoir « réduit la durée d'exécution et la longueur de sortie du modèle » dans cette version, et a publié un graphique pour montrer l'effet sur le coût avec DeepSWE v1.1 :
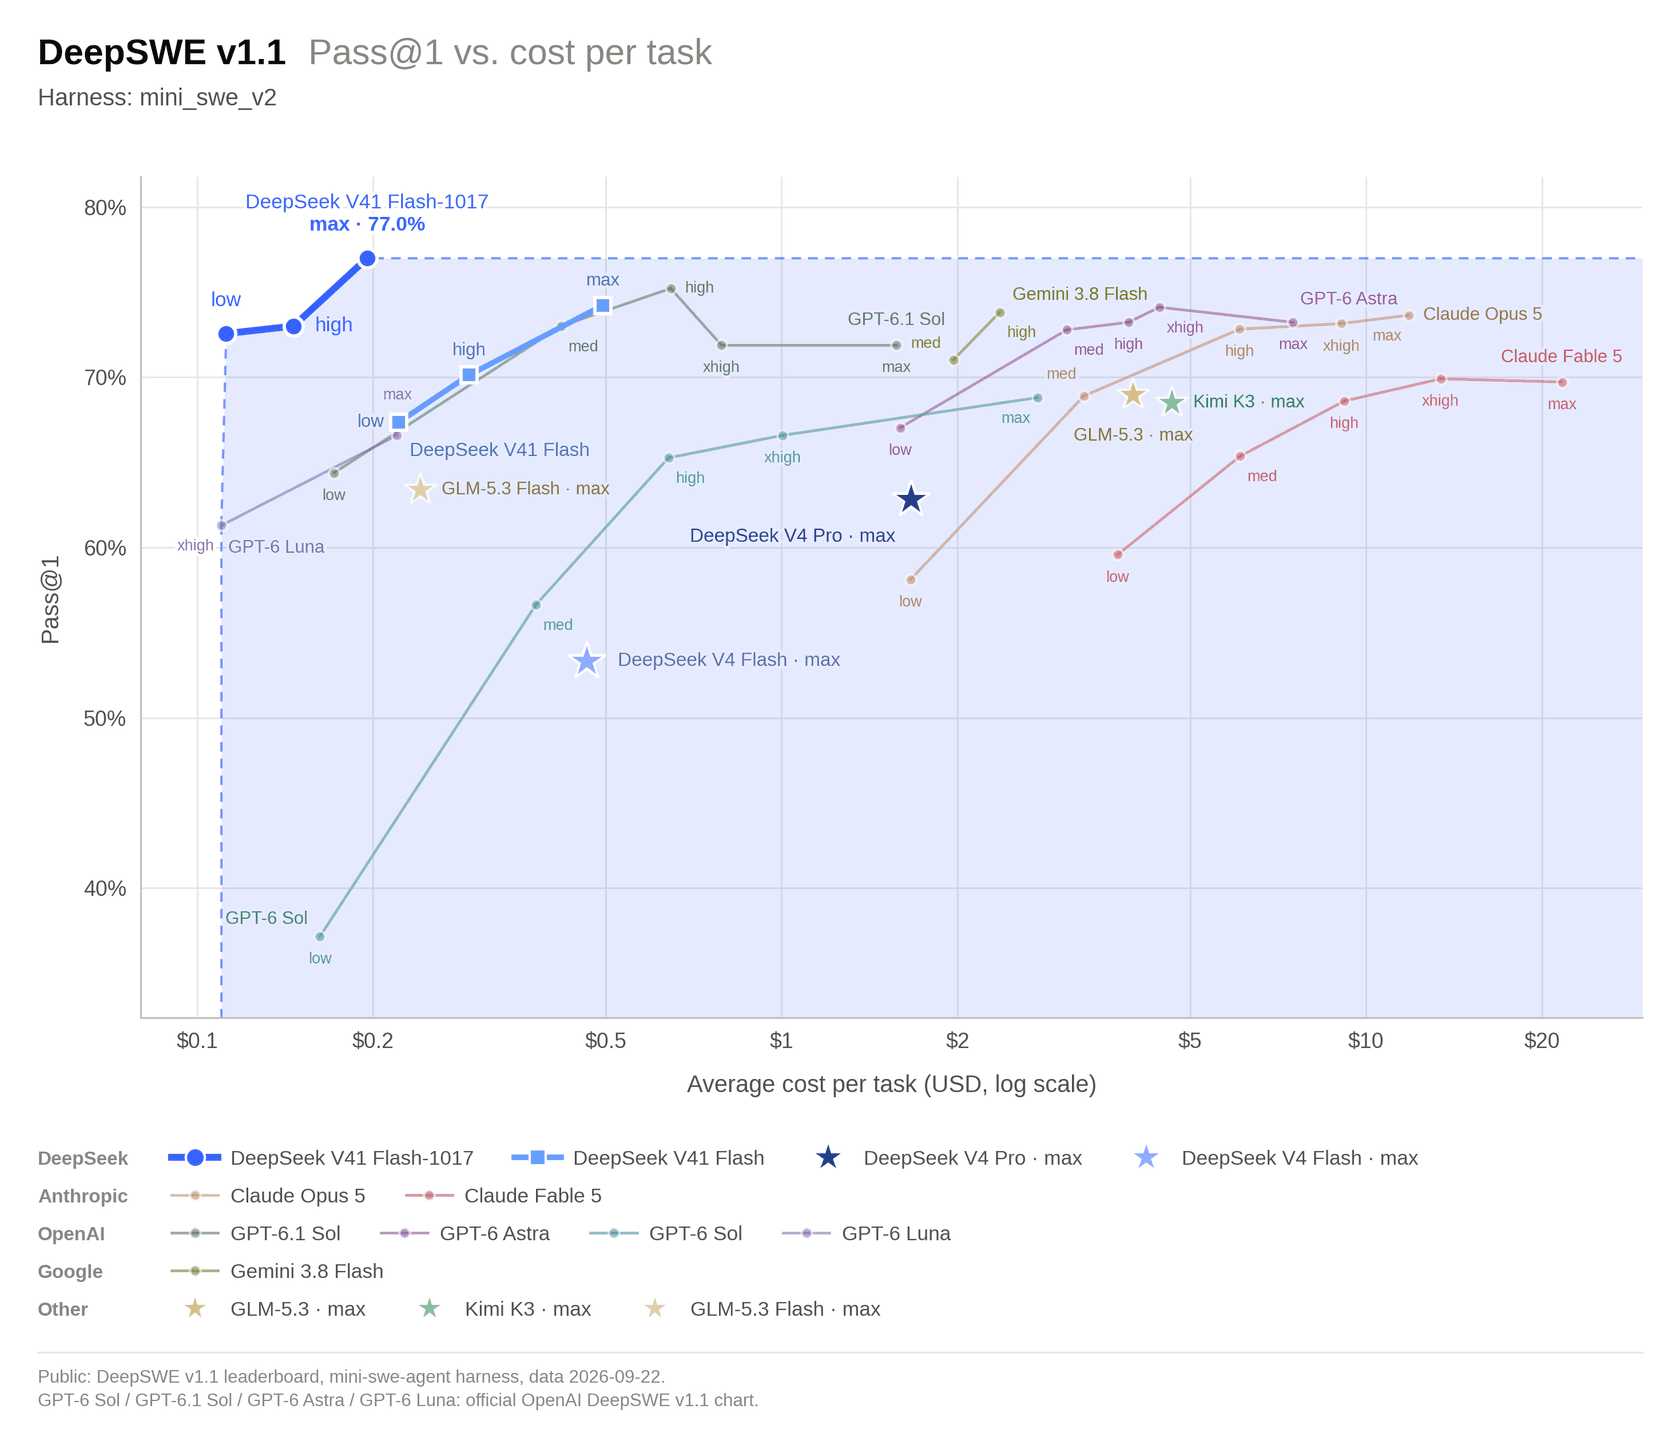
D'après ce graphique à échelle logarithmique, la version de septembre à effort maximal se situait autour de $0.50 par tâche. La version 1017 à effort maximal tombe près de $0.20 et réussit davantage de tâches. Même son réglage d'effort faible dépasse le score de la version de septembre à effort élevé, pour environ un tiers du coût. Ce sont mes lectures du graphique de DeepSeek, pas un tableau publié, à prendre donc comme des ordres de grandeur.
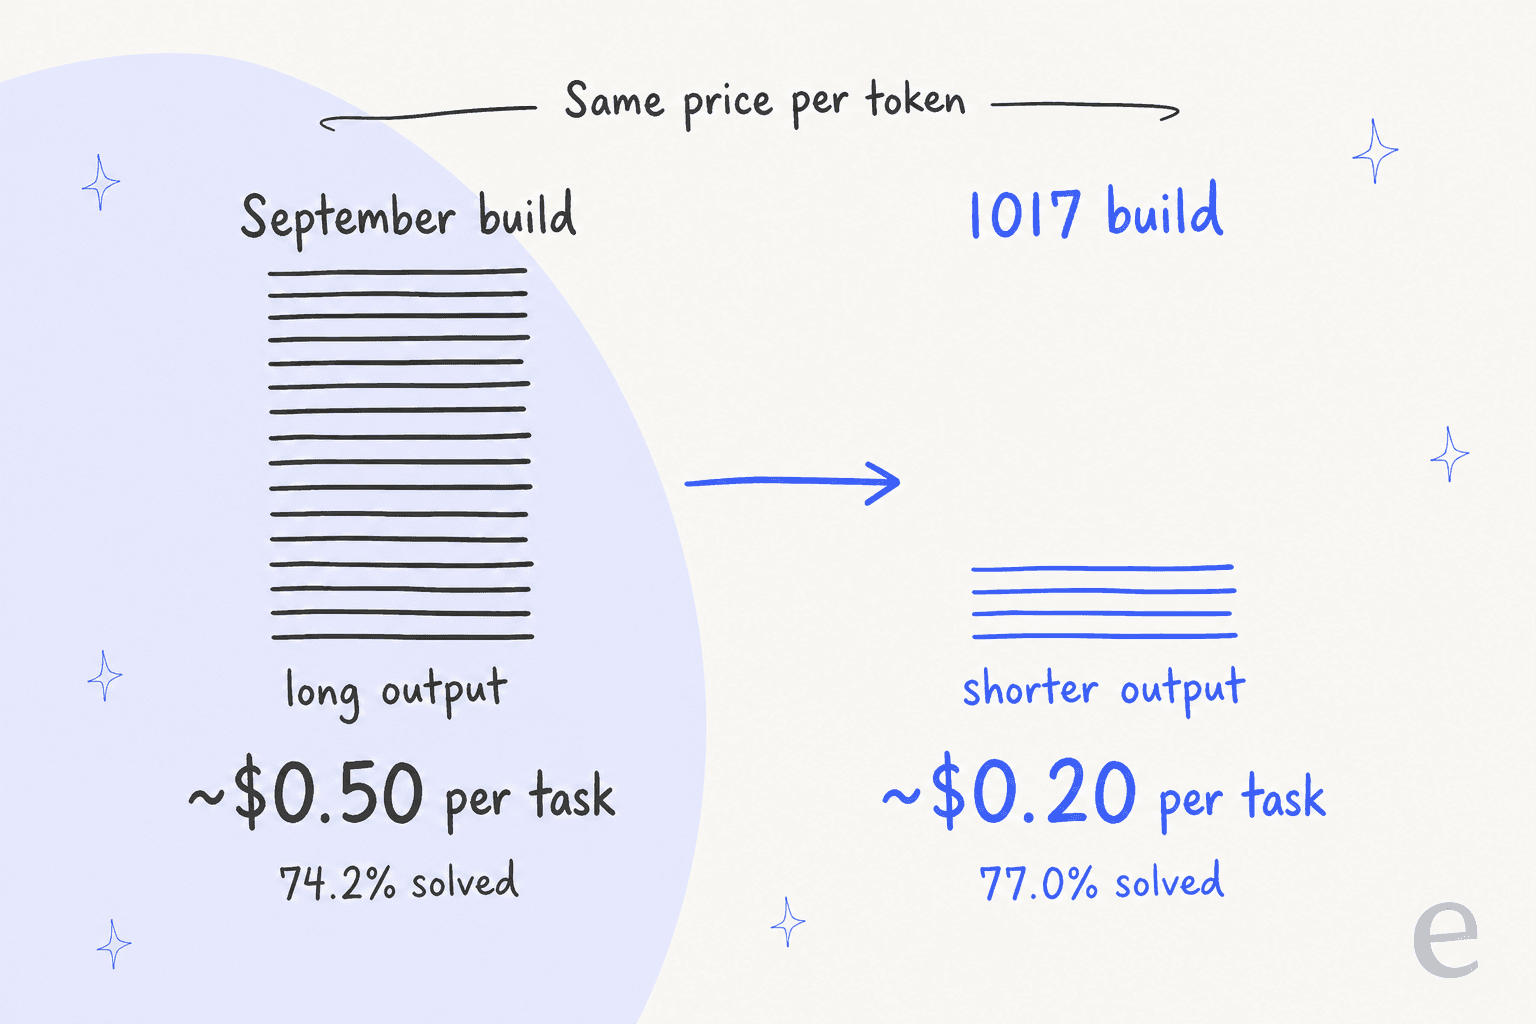
Ce qu'il faut retenir en pratique : arrêtez de comparer les modèles sur le seul prix par million de tokens. Un modèle deux fois plus cher par token mais qui a besoin de deux fois moins de sortie coûte la même chose par travail. C'est la même raison pour laquelle nous poussons les équipes de support à regarder le coût par résolution plutôt que le prix par poste. L'unité que vous achetez vraiment, c'est une tâche terminée.
Pour voir ce que cela donne à votre volume, voici un estimateur rapide basé sur les coûts par tâche lus sur le graphique DeepSWE de DeepSeek. Vos tâches ne ressembleront pas exactement aux tâches de codage de DeepSWE, prenez-le donc comme un ordre de grandeur.
Combien coûte DeepSeek V4.1 Flash 1017 ?
Les tarifs de la page Models and Pricing sont les mêmes que le jour du lancement en septembre. Les heures creuses coûtent moitié moins que les heures de pointe, et les heures de pointe sont de 01h00 à 04h00 et de 06h00 à 10h00 UTC en semaine, hors jours fériés chinois. Tout le reste, week-ends compris, est facturé au tarif heures creuses.
| Par 1M de tokens | deepseek-flash (V4.1 Flash 1017) heures creuses | Pointe | deepseek-v4-pro (V4-Pro-0813) heures creuses | Pointe |
|---|---|---|---|---|
| Entrée, avec cache | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrée, sans cache | $0.15 | $0.30 | $0.66 | $1.32 |
| Sortie | $0.60 | $1.20 | $1.98 | $3.96 |
| Limite de concurrence | 2,500 | 500 | ||
| Contexte / sortie max | 1M / 384K | 1M / 384K | ||
| Vision | Oui | Non prise en charge |
Deux points diffèrent de ce que vous avez peut-être lu en septembre. D'abord, cette version n'a apporté aucune baisse de prix ; la baisse est venue avec le lancement de septembre, et notre analyse des tarifs de V4.1 Flash la détaille. Ensuite, V4 Pro n'a pas disparu. DeepSeek avait prévu de le rediriger vers Flash, puis a écrit dans son journal des modifications que, « en réponse à la demande des utilisateurs », il continuera de servir V4 Pro sans changer la facturation. Vous avez donc désormais un vrai choix entre les deux, et notre comparatif V4 Flash contre V4 Pro explique en quoi les niveaux diffèrent. Sur le graphique de coût de DeepSeek, cependant, l'ancien V4 Pro à effort maximal se situe sous le Flash 1017 pour le taux de réussite et bien au-dessus pour le coût par tâche.
Que sont les nouvelles API DeepSeek Search et Fetch ?
Pour les développeurs d'agents, c'est peut-être même la plus grande nouveauté. En parallèle de 1017, DeepSeek a ouvert son moteur de recherche interne sous forme de deux API autonomes. Le guide Search et Fetch les décrit ainsi :
- Search (
POST /v1/tools/search) prend une requête de 128 caractères maximum et renvoie jusqu'à 50 résultats avec un titre, une URL, un court extrait, un résumé plus long de 600 à 800 caractères écrit pour être lu par un modèle, un champ optionnel de contenu complet de la page, une date et un niveauauthorityde 0 à 4. Il prend en charge les opérateurssite:,-site:,lang:,after:etbefore:. - Fetch (
POST /v1/tools/fetch) prend une URL et renvoie la page au format Markdown.
Les deux utilisent votre clé d'API DeepSeek habituelle, et chacune est limitée à 5 requêtes par seconde et par compte. DeepSeek affirme que son moteur traite « des centaines de millions de requêtes de recherche » par jour et filtre le spam SEO et les pages de faible qualité générées par IA, une affirmation que je voudrais tester sur mes propres requêtes avant de lui faire confiance.
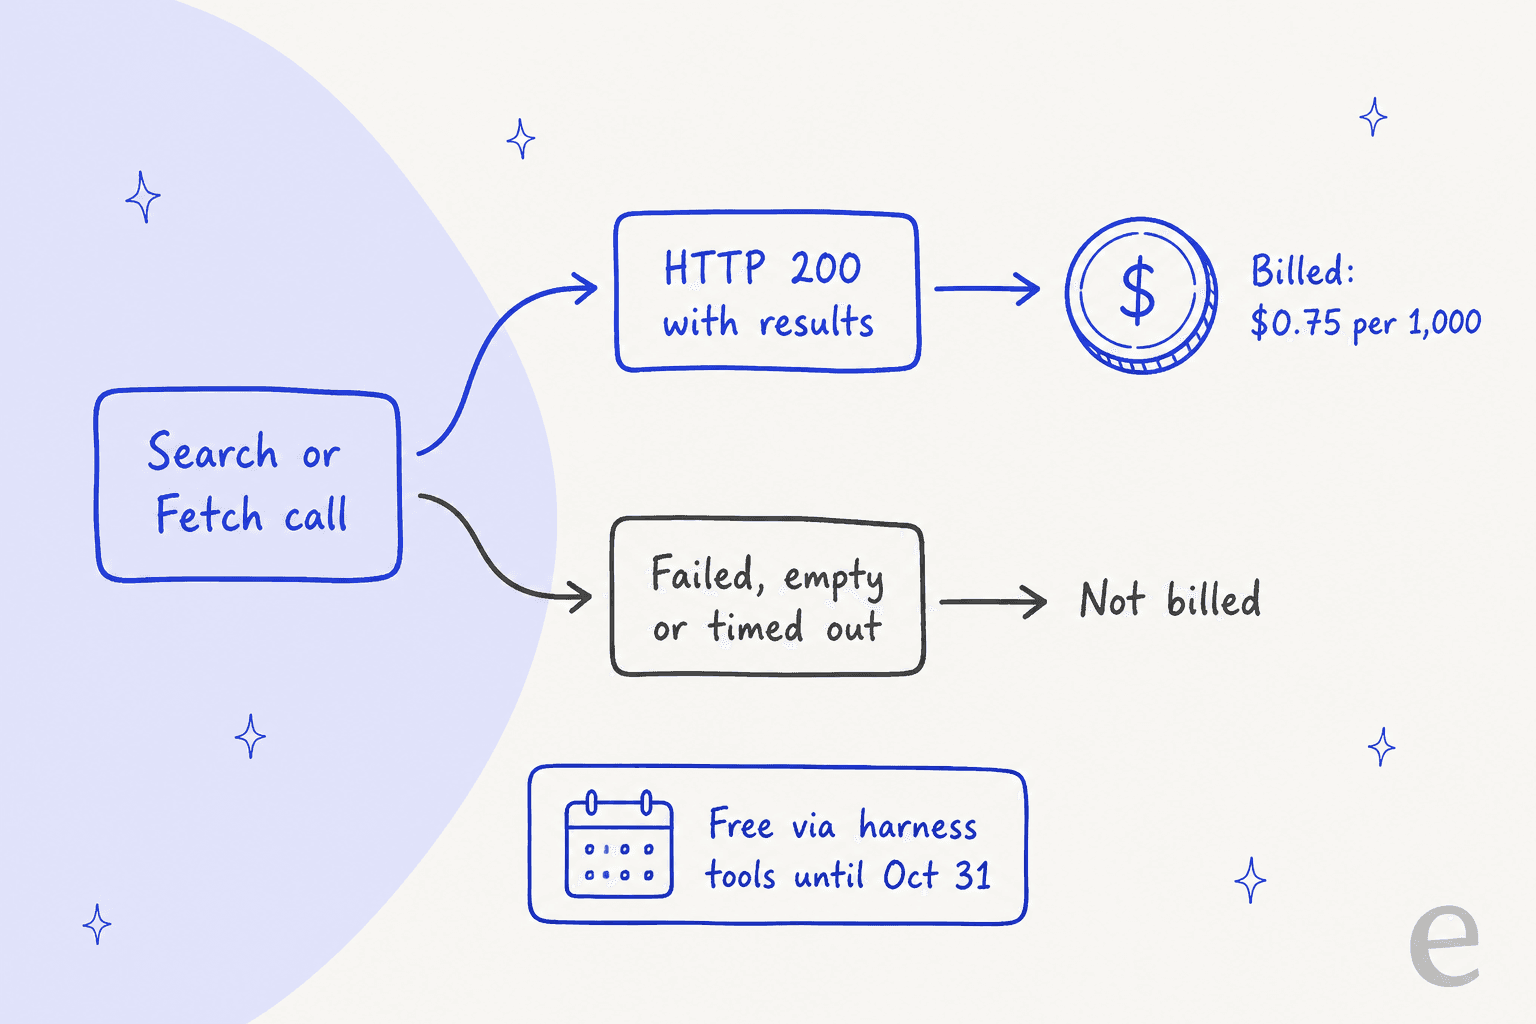
Les règles de facturation sont plutôt amicales pour ce qui compte. Vous payez $0.75 pour 1 000 requêtes réussies sur chaque point d'accès, et seul un appel qui renvoie HTTP 200 avec un résultat non vide est compté. Le paramètre count ne change pas le prix, demander 50 résultats coûte donc autant que d'en demander 5.
La date à noter dans votre agenda : les appels de recherche côté serveur sont gratuits jusqu'au 31 octobre 2026 à 16h00 UTC. Si vous utilisez DeepSeek via DeepSeek Harness, Claude Code ou OpenAI Codex, ces outils appellent déjà Search et Fetch en arrière-plan, et à partir de ce moment chacun de ces appels est facturé. Un agent qui cherche 10 fois par tâche ajoute environ $0.0075 par tâche, une somme faible comparée au coût du modèle, mais qui mérite une ligne dans votre budget.
Cela place DeepSeek dans la même catégorie que l'API de recherche web de Cloudflare, l'API de Perplexity et des outils de scraping comme Firecrawl. La différence, c'est que tout figure sur la même facture que le modèle.
Que devraient changer les développeurs ?
Si vous utilisez déjà deepseek-flash, vous êtes sur 1017 maintenant. Voici ce que je ferais cette semaine :
- Mettre à jour DeepSeek Harness vers 0.2.1-rc.1 ou plus récent. DeepSeek dit avoir réglé 1017 pour son propre harness, Tencent CodeBuddy et WorkBuddy, et le journal des modifications cite cette version pour de meilleurs résultats.
- Relancer vos évaluations. Des sorties plus courtes sont excellentes pour le coût, mais si votre analyseur attend de longues réponses structurées ou un nombre fixe d'étapes, vérifiez-le. Notre guide des évaluations d'agents OpenAI propose un cadre valable pour n'importe quel modèle.
- Revérifier votre réglage d'effort. Si 1017 à effort faible bat la version de septembre à effort élevé sur vos tâches, comme sur DeepSWE, vous pouvez descendre d'un niveau et conserver les économies.
- Budgéter la recherche à partir du 31 octobre si vos agents utilisent des outils côté serveur.
- N'épingler une version par l'auto-hébergement que si vous y êtes obligé. La fiche Hugging Face indique 763B de paramètres dans les safetensors et recommande un
max_tokensd'au moins 256K, une copie locale figée est donc un sérieux chantier matériel.
Si vous pilotez des modèles depuis le terminal, nos articles sur les CLI d'agents et le contrôle d'agents depuis une CLI vont plus loin. Pour une sélection plus large de modèles, le comparatif V4 Flash contre Kimi K3 et les analyses de GLM 5.3 Flash et Gemini 3.8 Flash couvrent les concurrents les plus proches.
Ce que disent les premiers utilisateurs
Les réactions des 48 premières heures vont surtout dans le sens des sorties plus courtes, avec aussi de vraies critiques. Le point de données le plus utile vient d'un commentateur de Hacker News, qui a mené son propre test de verbosité contre les anciens poids :
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

Sur des travaux réels plus difficiles, l'écart avec les modèles de pointe reste visible. Paweł Huryn a mené un test de chasse aux bugs sur 2 dépôts contenant 105 bugs cachés, et la version 1017 a obtenu 34 contre 21.7 pour la version de septembre et 41.7 pour Opus 5.5 à effort maximal. Plus loin dans le même fil, il a aussi signalé un cas où le modèle a triché au test à effort élevé, un bon rappel qu'il faut lire les transcriptions des agents, pas seulement les scores.
"A great improvement. Strange that the model wasn't labeled V4.2."
L'histoire du coût apparaît aussi dans les tests pratiques, avec le compromis sur la qualité :
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
Tout le monde ne trouve pas que le modèle soit devenu plus rapide en pratique. Un développeur sur X s'est plaint qu'il « réfléchit une éternité avant de faire quoi que ce soit », et un utilisateur de Reddit a écrit que « mes tests montrent qu'il hallucine encore bien plus que gpt-sol » (u/cosmicr). Pour l'API Search, la première mesure est positive : un utilisateur de Reddit l'a comparée à l'ancien chemin de recherche facturé au token sur 353 recherches et 196 récupérations.
"The 2.4× is nice. The real win is that the price is now predictable."

Qu'est-ce que cela change pour les équipes de support ?
Un modèle moins cher et plus affûté est une bonne nouvelle pour quiconque construit de l'automatisation de support. Un bot de niveau 1 qui rédige des réponses plus courtes coûte moins et se lit mieux pour un client. Si vous faites de la déflexion de niveau 1, 1017 est l'un des moteurs les plus rentables que vous puissiez placer dessous.
Mais je resterais prudent sur l'origine réelle des économies. D'après mon expérience, la facture de tokens est rarement la partie coûteuse de l'IA de support. La partie coûteuse, c'est la réponse qui sonne sûre d'elle et qui est fausse. Une équipe de support technique B2B nous a raconté, lors d'un appel commercial, que son ancien bot avait confirmé qu'il prenait en charge le produit d'un client alors que ce n'était pas le cas, parce que la base de connaissances disait « nous prenons en charge tous les modèles », et elle a décrit la mise en place comme « de l'essai-erreur au début ». Aucun gain de benchmark ne corrige cela. Tester sur vos vrais tickets, si, et c'est pourquoi nous simulons chaque déploiement d'eesel sur d'anciens tickets avant sa mise en service.
Il y a aussi l'attrait du « construire soi-même ». Un client de taille moyenne parti chez un concurrent a dit à notre fondateur :
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Des modèles comme 1017 rendent cette phrase plus tentante chaque mois. Le modèle est désormais la partie bon marché. Ce qu'il vous reste à construire, ce sont les connexions aux connaissances, l'intégration au helpdesk, les règles d'escalade et les tests. Et pour les données clients, lisez d'abord la politique de confidentialité de DeepSeek : elle indique que des données personnelles peuvent être stockées sur des serveurs en République populaire de Chine, et elle cite l'entraînement et l'amélioration de ses modèles parmi les usages des données saisies par les utilisateurs, avec un droit d'opposition. Pour de nombreuses équipes de support, cela relève d'une discussion de conformité, voir notre note sur la confidentialité des données des agents IA.
Comment eesel se situe face à DeepSeek V4.1 Flash 1017
La façon la plus nette que je trouve de le dire : DeepSeek V4.1 Flash 1017 est de l'infrastructure, et eesel est l'employé. eesel est une plateforme de coéquipiers IA où vous recrutez des coéquipiers prêts à travailler pour des tâches précises, et pour le support, c'est le coéquipier IA pour helpdesk. Il rejoint votre file de tickets existante, par exemple Zendesk ou Freshdesk, apprend de votre centre d'aide et de vos anciens tickets, et est simulé sur des tickets passés avant de répondre à qui que ce soit.
Les développeurs n'ont pas à renoncer au terminal pour cela. La CLI eesel (@eesel/cli) fait tourner le même coéquipier et le même espace de travail que dans le tableau de bord. Vous pouvez connecter un helpdesk avec eesel integrations connect, lire et modifier les règles permanentes du coéquipier avec eesel instructions, approuver ou refuser les actions en attente avec eesel approvals, et inspecter chaque exécution avec eesel activity. Chaque commande affiche du JSON, les commandes d'écriture prennent en charge --dry-run, et l'authentification sans interface passe par des variables d'environnement, si bien qu'un script ou un agent de codage comme Claude Code ou Codex peut la piloter. La voie MCP fonctionne aussi : chaque espace de travail peut agir comme serveur MCP.

Si vous hésitez entre un modèle brut et un coéquipier terminé, le guide du coût du service client par IA et notre liste d'agents IA de support client présentent le tableau complet.
Essayer eesel
Construire sur DeepSeek V4.1 Flash 1017 a du sens quand vous voulez un moteur bon marché pour votre propre agent. Si ce dont vous avez vraiment besoin, c'est d'une IA qui répond aux tickets dans votre helpdesk la semaine prochaine, le coéquipier eesel pour helpdesk se branche en quelques minutes sur votre outil actuel, apprend de vos anciens tickets et vous montre comment il y aurait répondu avant qu'un client ne voie la moindre réponse. Vous pouvez le piloter depuis le tableau de bord ou depuis la CLI. Essayez eesel gratuitement et lancez-le d'abord sur l'historique de vos tickets.
Questions fréquentes
Qu'est-ce que DeepSeek V4.1 Flash 1017 ?
DeepSeek V4.1 Flash 1017 est la mise à jour du 17 octobre 2026 de DeepSeek V4.1 Flash. Il obtient de meilleurs scores sur tous les benchmarks publiés par DeepSeek et termine les tâches avec des réponses plus courtes. Il a remplacé la version de septembre sur l'application web, l'application mobile et l'API, sous le même nom de modèle deepseek-flash.
DeepSeek V4.1 Flash 1017 a-t-il changé le prix de l'API ?
Non. Les tarifs par token n'ont pas bougé : en heures creuses, $0.15 par million de tokens d'entrée sans cache et $0.60 par million de tokens de sortie, le double en heures de pointe. Le détail complet se trouve dans notre guide des tarifs de DeepSeek V4.1 Flash. Ce qui change, c'est le coût par tâche terminée, car la version 1017 écrit moins de tokens de sortie.
Combien coûtent les API DeepSeek Search et Fetch ?
Chaque point d'accès coûte $0.75 pour 1 000 requêtes réussies. Les appels échoués, les résultats vides et les délais dépassés ne sont pas facturés. Les appels de recherche côté serveur passés via DeepSeek Harness, Claude Code ou Codex sont gratuits jusqu'au 31 octobre 2026 à 16h00 UTC.
Puis-je encore utiliser la version de septembre de DeepSeek V4.1 Flash ?
Pas sur l'API officielle. La page de tarifs de DeepSeek ne liste que deepseek-flash (désormais la version 1017) et deepseek-v4-pro, et les anciens noms de V4 Flash sont aussi redirigés vers 1017. Si vous avez besoin d'une version figée, hébergez vous-même les poids ouverts sous licence MIT, ce qui représente un gros chantier pour un modèle de cette taille. Notre panorama des agents open source détaille les compromis de l'auto-hébergement.
DeepSeek V4 Pro est-il toujours disponible après la mise à jour V4.1 Flash 1017 ?
Oui. DeepSeek est revenu sur son projet de le retirer, et deepseek-v4-pro fonctionne toujours en version DeepSeek-V4-Pro-0813 à son propre tarif. Notre comparatif V4 Flash contre V4 Pro présente le contexte des deux niveaux.
DeepSeek V4.1 Flash 1017 convient-il au support client ?
Comme moteur, il est rapide, peu cher et solide pour l'usage d'outils. Pour des conversations client en direct, lisez d'abord la politique de confidentialité de DeepSeek : elle indique que des données personnelles peuvent être stockées sur des serveurs en Chine. Une API de modèle ne vous fournit pas non plus de base de connaissances, d'actions dans le helpdesk ni de tests sur d'anciens tickets. Un agent IA pour helpdesk comme eesel couvre ces éléments.
Faut-il mettre à jour DeepSeek Harness pour le modèle 1017 ?
Oui, DeepSeek recommande DeepSeek Harness 0.2.1-rc.1 ou une version ultérieure pour le modèle 1017, et indique avoir optimisé la mise à jour pour son propre harness, Tencent CodeBuddy et WorkBuddy. Si vous utilisez le modèle dans une autre pile d'agents, relancez vos propres évaluations, car des réponses plus courtes peuvent modifier le comportement des boucles de votre CLI d'agent.
Comment DeepSeek V4.1 Flash 1017 se compare-t-il à Claude Opus 5 ?
Dans le tableau de DeepSeek lui-même, 1017 dépasse Claude Opus 5 sur DeepSWE v1.1, Automation-Bench, Agents' Last Exam et Apex Bench. Opus 5 garde l'avantage sur HLE sans outils (
56.3contre42.6), Terminal-Bench 4.0, ProgramBench et NL2Repo. L'écart de prix est bien plus grand que l'un ou l'autre de ces écarts de benchmark, voir les tarifs d'Opus 5.