

DeepSeek a lancé un modèle qui voit. 21 août 2026. deepseek-v4-flash-vision-exp coûte exactement ce que coûte le V4-Flash classique, la fenêtre de contexte de 1M reste, et les images sont facturées comme de simples tokens d'entrée.
L'annonce enterre pourtant la partie intéressante. DeepSeek dit seulement que la version vision "matches" V4-Flash sur le texte. Son propre tableau de benchmarks en dit davantage : la variante vision bat le modèle texte seul sur six des sept benchmarks d'agents textuels. Près de cinq points sur DeepSWE. Cinq et demi sur Toolathlon-Verified. La vraie question n'a donc rien à voir avec les images : faut-il basculer votre trafic de texte sur un build expérimental ?
Puis le piège. Chaque image est écrasée à environ 800 par 800 pixels avant que le modèle ne la regarde, plafonnée à 384 tokens. Une capture de 5000 pixels et une miniature coûtent pareil, car après le redimensionnement elles sont la même chose. Le prix fixe n'est donc pas de la générosité. C'est le plafond de résolution, écrit sous forme de grille tarifaire.
Chez eesel, je m'occupe des intégrations et de la plomberie d'API, et je lis les notes de version comme on lit un diff : ce qui a changé, ce qui n'a silencieusement pas changé, ce qui va me réveiller à 2 h du matin. Ici, les lignes intéressantes sont deux fonctionnalités qui ont discrètement disparu. La complétion FIM a disparu, et la chaîne du modèle n'a pas de date de build, donc ce que vous avez testé lundi n'est pas forcément ce qui sert le trafic vendredi.
Et si vous pointez tout cela vers une file de support, soyez clair sur ce que cela résout. Lire la capture d'écran d'un client est la moitié facile. La moitié difficile est de savoir que la réponse est juste avant qu'elle n'atteigne ce client, ce qui est un problème d'ancrage et de tests, pas de taille de modèle. C'est toute la raison pour laquelle eesel rejoue un agent sur vos vrais tickets passés avant qu'il ne réponde à un ticket en direct.
Ce que DeepSeek a réellement lancé
La sortie comprend trois choses à la fois, et une seule a fait les gros titres.
Un modèle de vision. deepseek-v4-flash-vision-exp accepte des images dans la même requête que votre texte, via Chat Completions, le point de terminaison /messages compatible Anthropic ou l'API Responses. Les formats pris en charge sont JPEG, PNG, GIF et WebP, et d'après le guide de vision, le format est détecté d'après le contenu du fichier, pas d'après son nom ni le type MIME déclaré.
Une API Files gratuite. Vous envoyez une image une fois, puis vous la référencez par file_id d'une requête à l'autre. Elle relève aussi le plafond par image de 32 MiB à 64 MiB, ce qui compte plus qu'il n'y paraît.
Une sortie de harness. DeepSeek Harness 0.1.1 est arrivé le même jour, avec la prise en charge déjà intégrée.
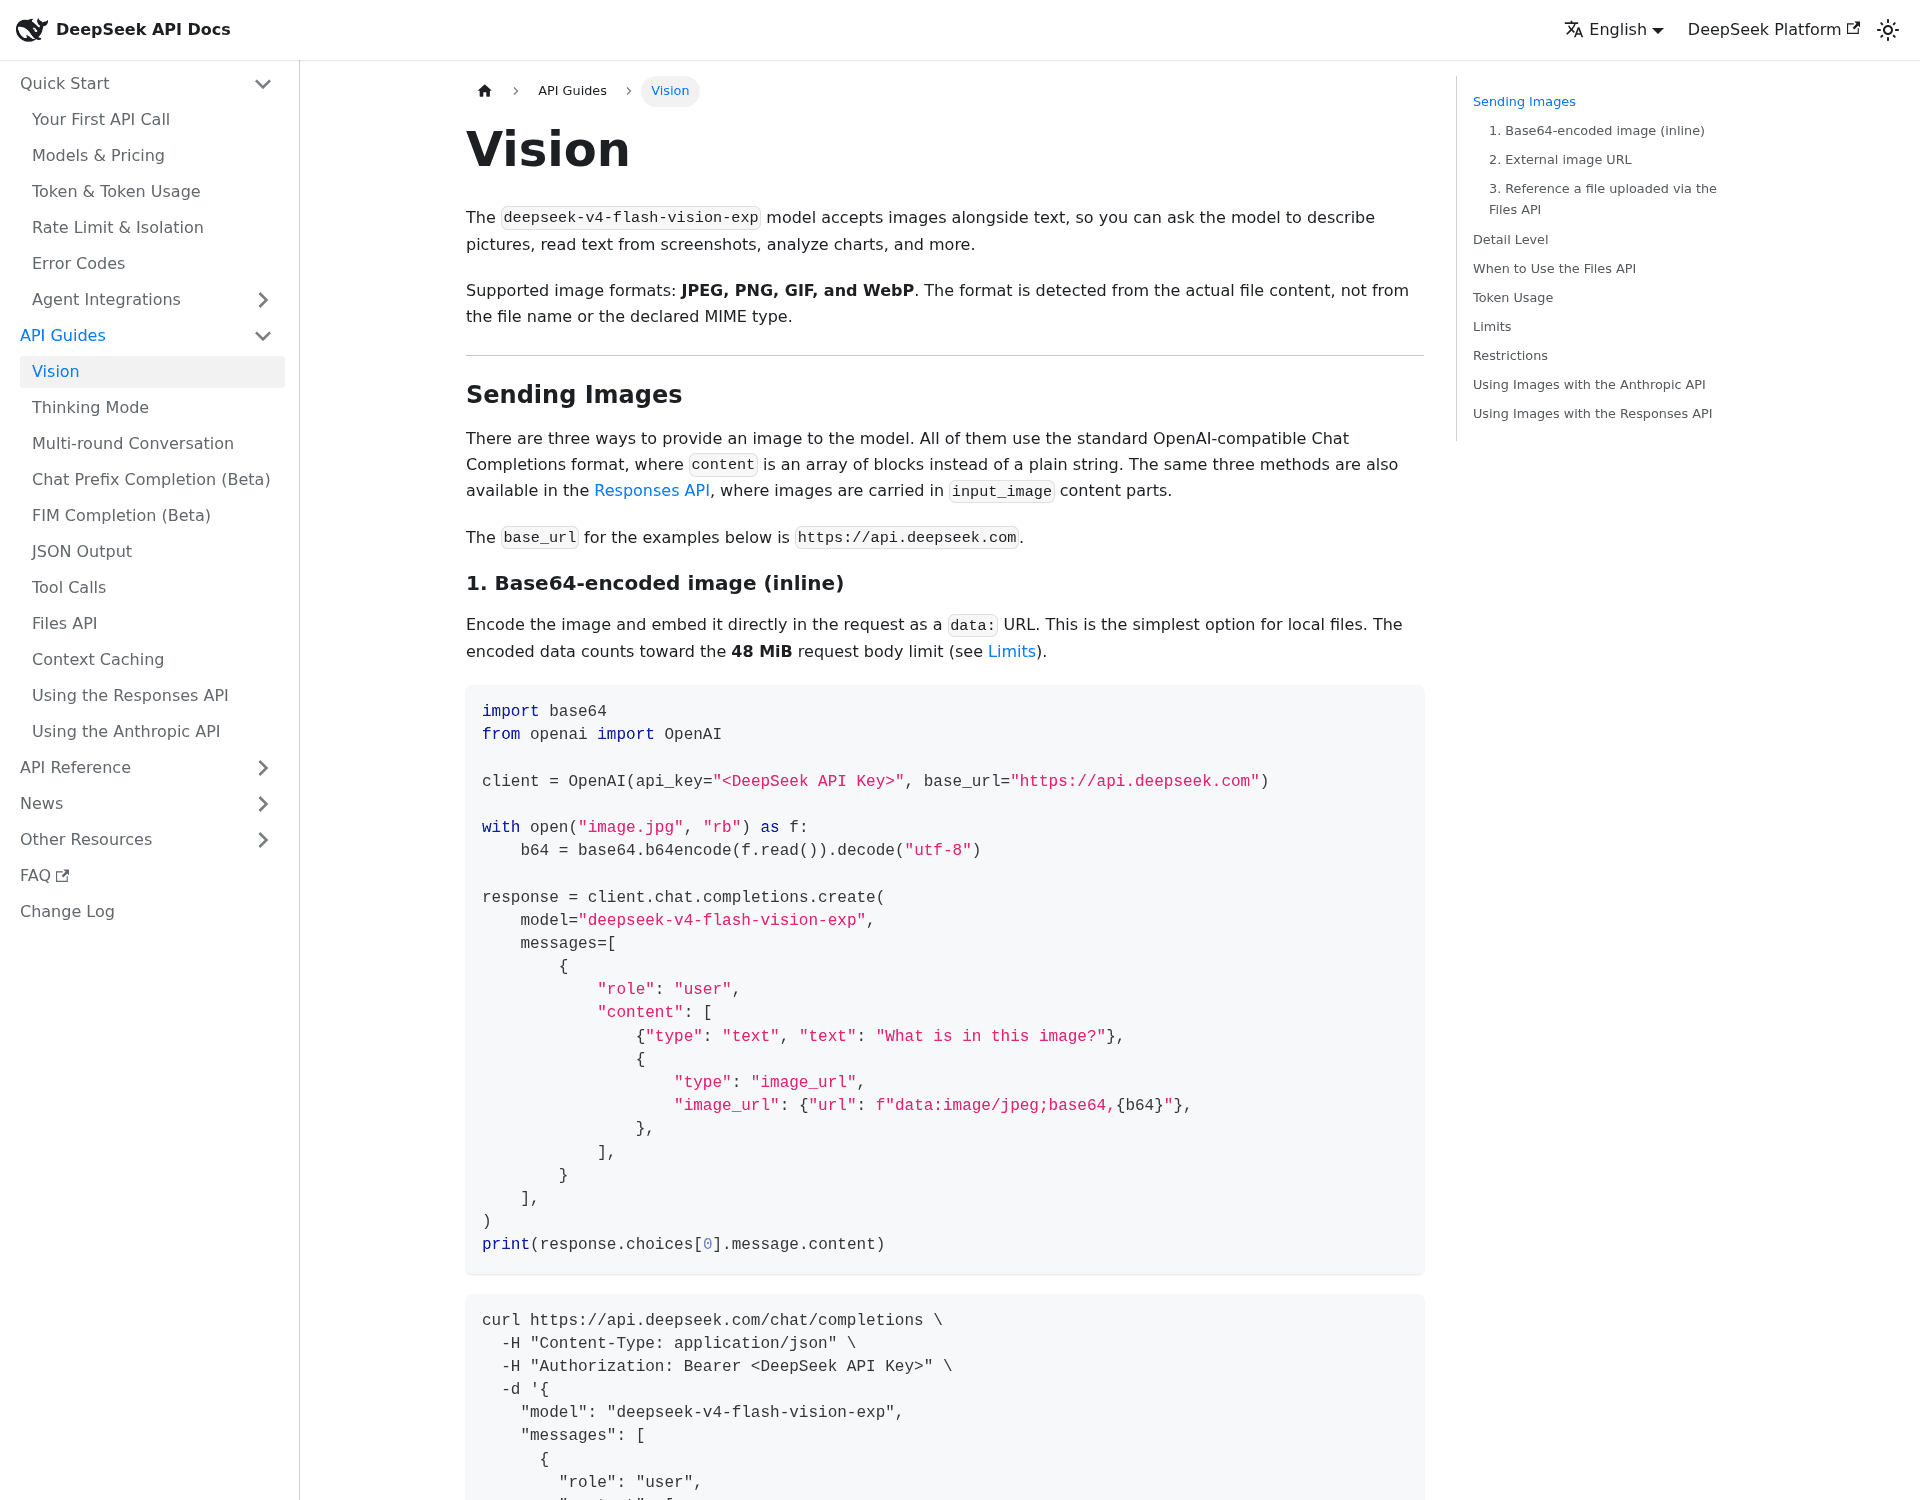
Côté architecture, rien n'a changé par rapport au modèle dont il dérive : un mélange d'experts parcimonieux avec 13B de paramètres actifs sur 284B au total, d'après la page du modèle sur OpenRouter. Le contexte reste à 1M de tokens, la sortie maximale à 384K et la concurrence à 2 500. Si vous avez déjà construit sur DeepSeek V4 Flash, changer la chaîne du modèle est toute la migration.
Un détail qui ressemble à une note de bas de page mais n'en est pas une : les images ne sont acceptées que dans les messages user. Mettez-en une dans un message system ou assistant et vous obtenez un 400. Si votre boucle d'agent range la sortie des outils dans un tour d'assistant, c'est pour vous une réécriture, pas un changement de configuration.
Le plafond de 384 tokens, c'est toute la conception
C'est la partie à comprendre avant de planifier quoi que ce soit autour du modèle.
Avant l'inférence, DeepSeek redimensionne chaque image entrante. Tout ce qui fait moins d'environ 384 par 384 pixels est agrandi, en conservant les proportions. Tout ce qui est plus grand est réduit, toujours en conservant les proportions, jusqu'à ce que le nombre total de pixels avoisine celui d'une image de 800 par 800. Le résultat est un plafond strict de 384 tokens par image, et la documentation en énonce clairement la conséquence : une image de 2000 par 2000 et une de 5000 par 5000 consomment le même nombre de tokens.
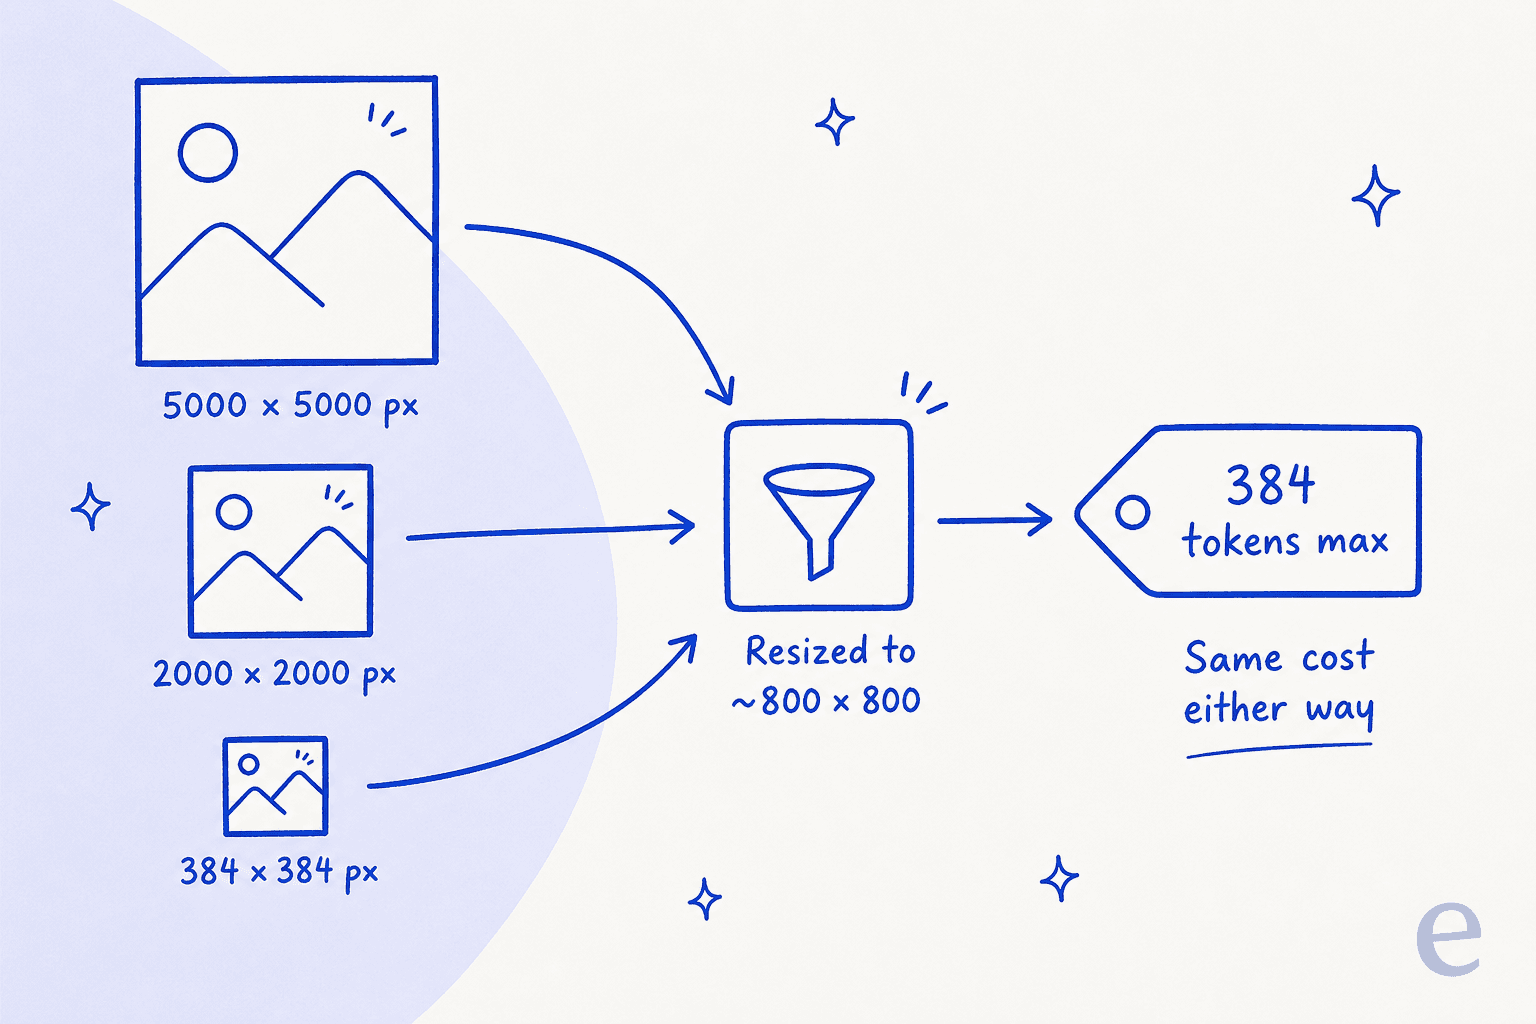
Les images sont donc presque gratuites. Au tarif hors pointe de $0,22 par million de tokens d'entrée, 384 tokens coûtent environ $0,00008. Un commentateur de Hacker News a fait le calcul et est arrivé à peu près au même résultat :
"400 tokens per image results in 2,500 images per dollar, if I'm not mistaken."

Il avait raison, et ce chiffre mérite qu'on s'y arrête un instant. À ce tarif, le coût de regarder s'arrondit à zéro dans presque n'importe quel budget d'agent.
Mais ici le prix et la résolution relèvent d'une seule décision, pas de deux. C'est bon marché parce que ça regarde de moins près. La réaction la plus tranchante de tout ce fil tenait en quelques mots :
"Oof 800 by 800 kills a lot of use cases"
C'est juste, et le fil a ensuite longuement débattu de l'importance réelle du problème. Le contournement retenu est un outil de recadrage et de zoom : on donne au modèle la possibilité de demander une sous-région d'une image haute résolution, pour qu'il lise un recadrage de 600 par 600 en détail natif plutôt que l'ensemble flouté. Plusieurs personnes ont rapporté que cela marchait bien. D'autres ont pointé la limite évidente : recoller neuf recadrages en une seule compréhension spatiale est un problème difficile en soi, et compter des éléments ou suivre des relations sur un schéma est précisément là que ça casse.
Les deux camps ont raison, mais pour des charges de travail différentes. Vérifier qu'un bouton s'est affiché au bon endroit survit sans peine à une réduction à 800 par 800. Lire du texte en 8 pt sur un reçu, non.
Il existe aussi un paramètre detail, à connaître surtout pour ce qu'il ne fait pas. low réduit à 512 par 512 pour la vitesse. high, original et auto signifient tous actuellement la même chose : conserver l'original, puis appliquer quand même le redimensionnement standard. Il n'existe aucun mode haute résolution auquel recourir.
Le tableau de benchmarks en dit plus que l'annonce
La note de version de DeepSeek décrit le côté texte du modèle de vision en un mot : il "matches" V4-Flash. Le tableau publié à côté ne dit pas tout à fait cela.
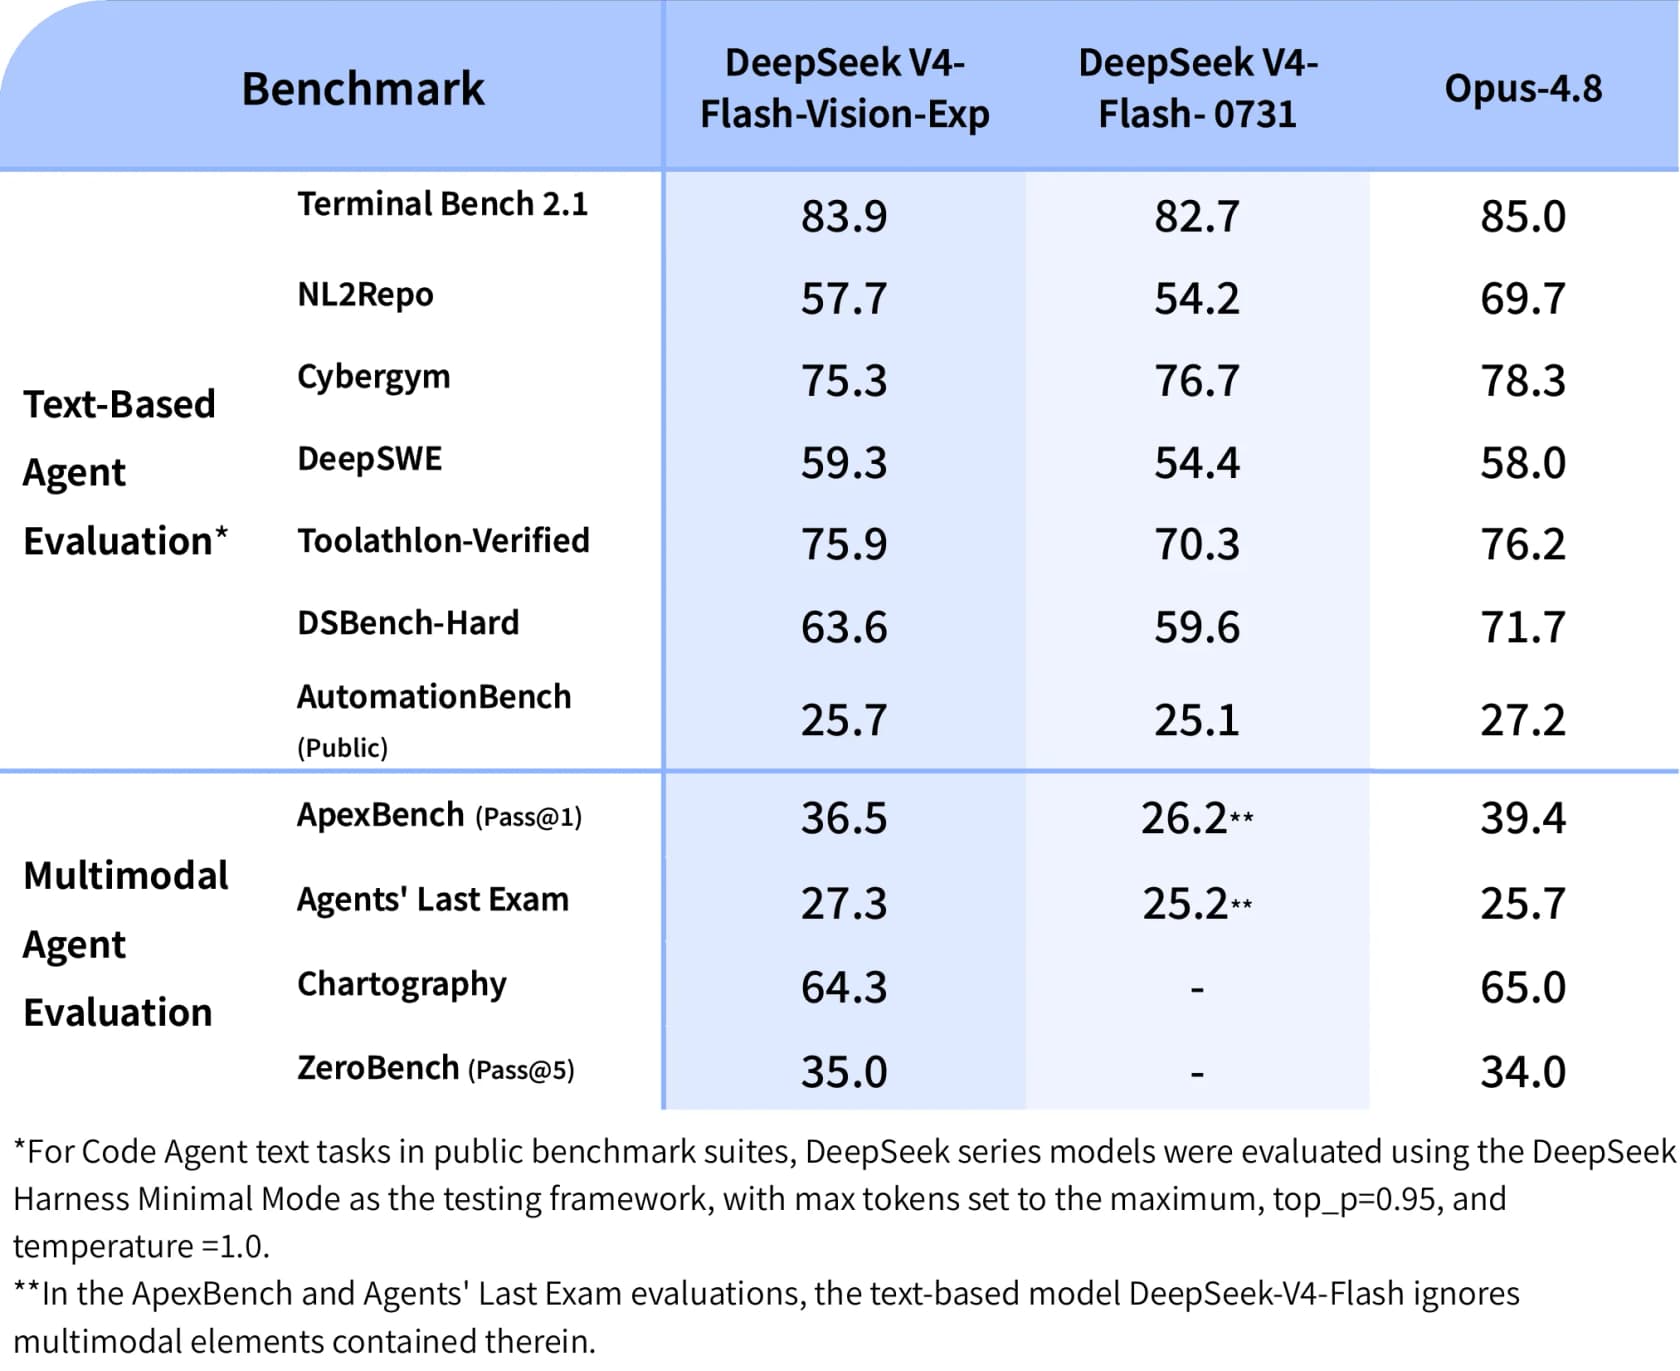
En alignant les lignes d'agents textuels, le build vision en remporte six sur sept :
| Benchmark d'agent textuel | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| Cybergym | 75.3 | 76.7 | 78.3 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
| AutomationBench (Public) | 25.7 | 25.1 | 27.2 |
DeepSWE gagne 4,9 points et Toolathlon-Verified 5,6. Ce ne sont pas des erreurs d'arrondi. Sur DeepSWE, la variante vision dépasse aussi Opus-4.8, 59,3 contre 58,0. "Matches on text" sous-estime ce que le harness de DeepSeek a mesuré ici, et si vous choisissez un modèle de code ou d'usage d'outils d'après ces lignes, le build vision est le meilleur choix même sans jamais lui envoyer une seule image.
Voyons maintenant la moitié multimodale, où le cadrage mérite un second regard :
| Benchmark multimodal | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| ApexBench (Pass@1) | 36.5 | 26.2* | 39.4 |
| Agents' Last Exam | 27.3 | 25.2* | 25.7 |
| Chartography | 64.3 | – | 65.0 |
| ZeroBench (Pass@5) | 35.0 | – | 34.0 |
*Note de DeepSeek elle-même : sur ApexBench et Agents' Last Exam, le V4-Flash textuel ignore les éléments multimodaux de la tâche.
Cette note fait beaucoup de travail. Le "grand bond par rapport à V4-Flash" sur les benchmarks d'agents multimodaux revient en partie à mesurer qu'un modèle voit et que l'autre non, ce qui est vrai mais n'est pas un gain de capacité. La comparaison honnête se trouve dans la colonne Opus-4.8, et le tableau y est serré : DeepSeek est en retrait de 2,9 sur ApexBench et de 0,7 sur Chartography, puis passe devant sur Agents' Last Exam et sur ZeroBench. "Proche d'Opus-4.8" est une affirmation juste, et pour un modèle à une fraction des tarifs de l'API d'Anthropic, c'est en réalité le gros titre.
Deux réserves pour lire correctement. Tous les chiffres de la série DeepSeek proviennent du Minimal Mode de DeepSeek Harness avec top_p=0.95 et temperature=1.0, c'est-à-dire l'échafaudage du fournisseur lui-même. De plus, ce sont des chiffres du jour de lancement fournis par le fournisseur, pas une réplication indépendante. Traitez-les comme n'importe quel tableau de première main, le nôtre compris.
Ce que cela coûte réellement
La grille tarifaire est identique à celle du V4-Flash classique, ce qui est sans doute le fait le plus utile de toute la sortie. Hors pointe, par million de tokens : $0,007 en succès de cache, $0,22 en échec de cache et $0,66 en sortie. En pointe, les trois doublent. Les heures de pointe vont de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi, ce qui signifie qu'une charge américaine ou européenne est surtout facturée au tarif réduit par pur hasard géographique.
Le prix affiché n'est d'ailleurs pas ce que la plupart des gens paient réellement. La télémétrie d'OpenRouter établit le prix d'entrée effectif à $0,03073 par million contre $0,22 affichés, car le taux de succès du cache observé atteint 88,9 %. La sortie bouge à peine, $0,6595 effectifs contre les $0,66 affichés. Quant à la destination de l'argent, le cache fait donc presque tout le travail côté entrée et rien côté sortie, ce qui fait de votre facture une facture de tokens de sortie avec une erreur d'arrondi en plus.
Saisissez vos propres chiffres :
Faites passer un agent réaliste piloté par captures d'écran là-dedans et la forme tient : les images se remarquent à peine, la facture est faite de tokens de sortie. Ce qui amène un chiffre à signaler. Sur ses trois premiers jours sur OpenRouter, le modèle a brûlé 25B de tokens de prompt, 69,6M de tokens de complétion et 139M de tokens de raisonnement, soit un raisonnement à environ le double de la complétion. Le mode raisonnement est activé par défaut et les tokens de raisonnement sont facturés au tarif de sortie. Si votre modèle de coûts traite la sortie comme "la longueur de la réponse", il se trompe donc d'un facteur 3 environ. Le même piège apparaît dans notre analyse des tarifs de DeepSeek V4 Flash, et il explique en bonne partie pourquoi comparer des grilles tarifaires brutes entre fournisseurs induit autant en erreur. Quiconque a comparé les prix de l'API d'OpenAI à un outil de support facturé à la résolution a rencontré le même problème dans l'autre sens.
Les limites qui vont réellement vous gêner
La plupart sont généreuses. Deux ne le sont pas.
| Limite | Valeur |
|---|---|
| Formats pris en charge | JPEG, PNG, GIF, WebP |
| Nombre max d'images par requête | 600 |
| Taille du corps de la requête | 48 MiB |
| Taille max d'une image (base64 / URL) | 32 MiB |
| Taille max d'une image (API Files) | 64 MiB |
| Taille totale max des images par requête | 64 MiB, ou 200 MiB avec file_id |
| Dimension max d'une image | 8192 px par côté |
| Dimension max à partir de 15 images | 4096 px par côté |
| Longueur d'une URL externe | 8192 caractères |
| Délai max de téléchargement d'une image externe | 60 secondes |
Six cents images dans une requête, c'est une grosse marge. Mais remarquez que la règle de dimension est discrètement divisée par deux dès qu'une requête contient quinze images ou plus, soit exactement la forme d'un traitement de documents par lots. Et cette fenêtre de téléchargement de 60 secondes sur les URL externes est le genre de chose qui fonctionne parfaitement en test, puis se met à produire des échecs intermittents la première fois que vous la pointez vers un CDN client lent. Si les images comptent pour votre pipeline, l'API Files est le choix par défaut le plus sûr, pas l'optimisation à laquelle vous penserez plus tard.
Ce à quoi vous renoncez
Deux choses, et aucune ne figure dans la liste à puces de l'annonce.
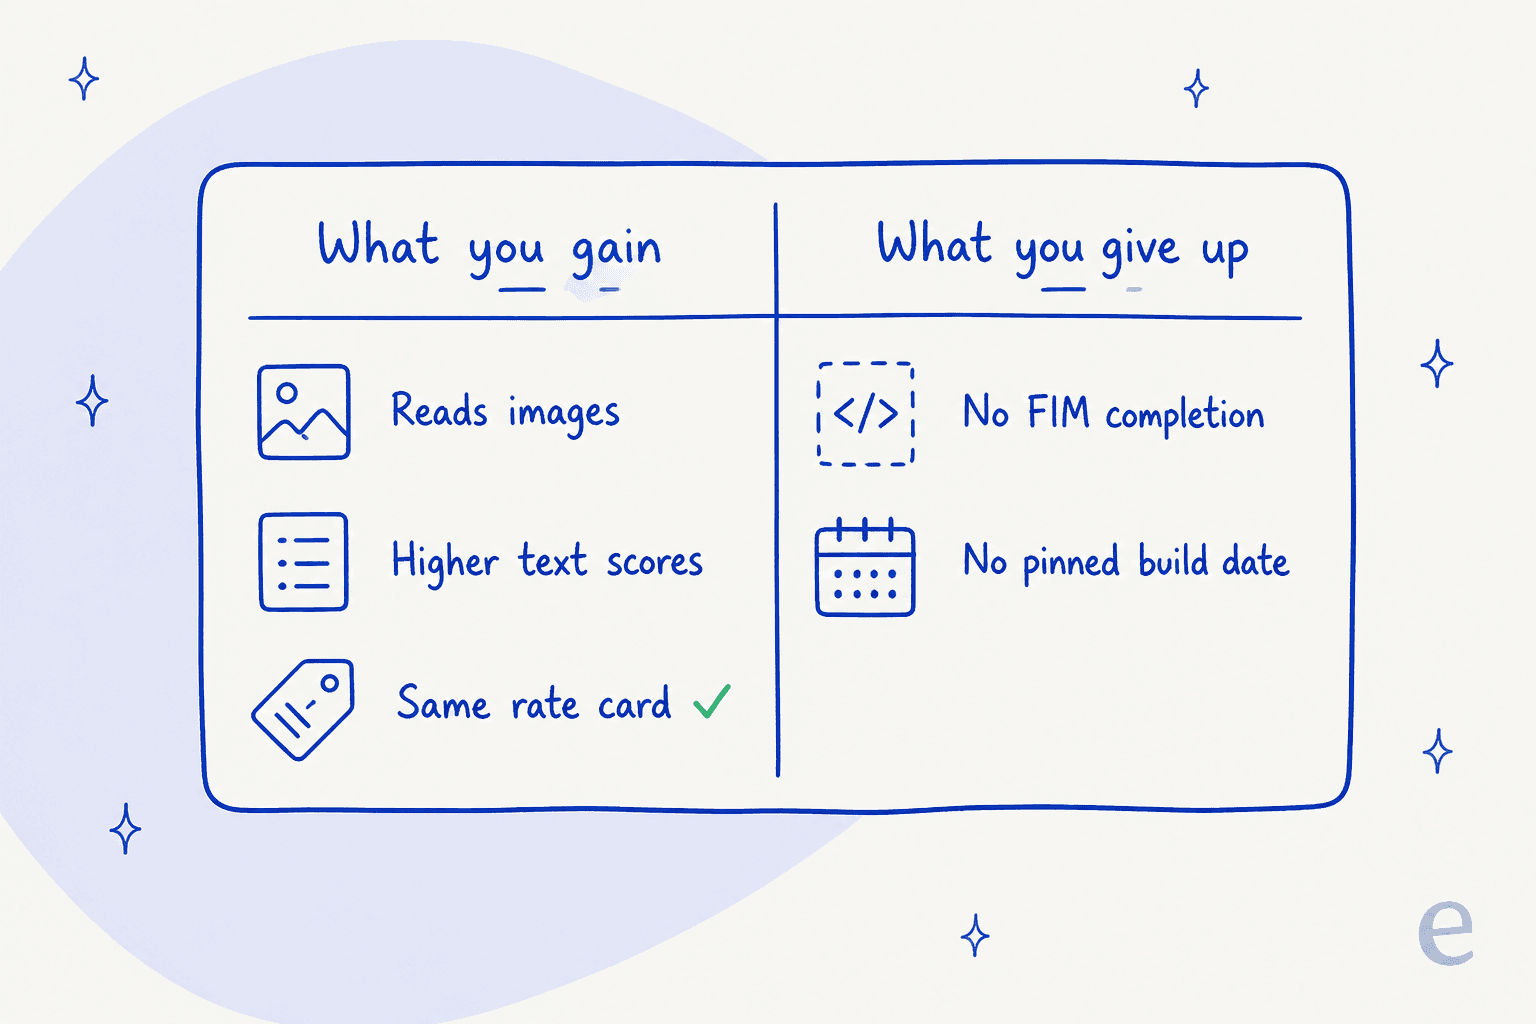
La complétion FIM n'est pas prise en charge. Le V4-Flash classique et le V4-Pro proposent tous deux le fill-in-the-middle en mode sans raisonnement, alors que la page des tarifs l'indique "Not supported" pour le build vision. Si vous utilisez FIM pour la complétion de code en ligne, ce modèle ne peut donc pas remplacer directement l'autre, et c'est le seul blocage dur de la sortie.
Il n'y a pas de date de build. C'est plus subtil, et c'est la raison pour laquelle je ne déplacerais pas encore de trafic de production. Regardez comment la grille tarifaire nomme ses versions : le Flash classique est DeepSeek-V4-Flash-0731, le Pro est DeepSeek-V4-Pro-0813, puis le build vision est simplement DeepSeek-V4-Flash-Vision-Exp. Un build daté est un build sur lequel on peut raisonner. Une étiquette exp sans tampon est une cible mouvante, et un commentateur de Hacker News a lu la feuille de route de la même façon :
"most likely a preview. they often release the preview via API, get more training data, post train some more then release the weight. i would expect to see it perform better in a few weeks or a month."
Si c'est exact, les chiffres de cet article ont une date de péremption, tout comme l'évaluation que vous lancerez cette semaine. C'est un coût normal d'utilisation des points de terminaison expérimentaux. Cela ne devient un problème que si vous oubliez que vous l'avez accepté.
Ce que montrent les 72 premières heures de trafic réel
Les benchmarks du fournisseur sont une chose. Voici ce que la couche de routage a elle-même mesuré, d'après OpenRouter, sur les trois premiers jours du modèle.
- 85 tokens/seconde de débit P50, avec une latence P50 de 1,11 seconde.
- 1,27 % de taux d'erreur sur les appels d'outils. Pour un modèle dont tout l'argument est le travail d'agents multimodal, c'est le chiffre que je vérifierais en premier, et il est correct.
- 100 % de disponibilité de service, 99,93 % de disponibilité, auprès d'un seul fournisseur. DeepSeek le sert directement, il n'y a donc pas de basculement vers lequel router.
- 90,4 % de taux de succès du cache, ce qui fait tomber le prix d'entrée effectif à environ un septième du tarif affiché.
La queue de distribution mérite pourtant un coup d'œil. La latence P99 atteint 18,34 secondes, et le bout en bout P99 99,94 secondes. C'est une bonne distribution pour un traitement par lots et une rude pour tout ce qu'une personne attend, le même compromis que pour tout agent IA placé devant un client.
La composition du trafic est la partie la plus intéressante. Les plus gros consommateurs sont tous des harness de programmation : Claude Code avec 9,58B de tokens, pi avec 4,56B, Hermes Agent avec 3,3B, plus le harness de pont multimodal de DeepSeek lui-même avec 3,12B. Personne ne l'utilise comme modèle de chat. Ils le pointent vers des bases de code et vers des écrans, ce qui correspond bien à ces victoires sur six des sept benchmarks de texte.
Un dernier élément de contexte sur la raison pour laquelle un modèle de vision bon marché a fait un tel effet. Le V4-Flash classique a apparemment passé des mois à faire semblant de voir :
"It tried to recreate vision by analyzing pixels on 3 separate projects I had it working on."
Un autre commentateur a raconté qu'il avait dû dire à 0731 d'arrêter d'ouvrir les captures d'écran, parce que les tentatives faisaient planter les sessions. Face à cette référence, un modèle qui regarde simplement l'image est une vraie amélioration, même floue.
Qui devrait l'utiliser, et qui devrait attendre
Utilisez-le dès maintenant si vous faites tourner des boucles d'agents sur des écrans et des bases de code, que vous étiez déjà sur V4-Flash et que vous ne dépendez pas de FIM. Les benchmarks de texte justifient à eux seuls le changement de chaîne de modèle, et la vision est un bonus. Le traitement de documents par lots convient aussi, à condition d'avoir vérifié vos propres documents face au redimensionnement.
Attendez si vous avez besoin d'un build figé, ou de FIM, ou si vos images dépendent de détails fins. Cadrans analogiques, schémas denses, petits caractères sur des reçus : testez tout cela avant de planifier autour. Le débat sur la lecture d'horloges qui a traversé le fil Hacker News illustre bien le bruit des jugements de vision en un seul essai, puisque l'échec d'un commentateur est devenu 9 réussites sur 10 quand quelqu'un d'autre l'a lancé dix fois, ce qui a inspiré une phrase que chacun de nous devrait coller sur son écran :
"Lesson learned to double check what I read on the internet."
Réfléchissez davantage si vous pointez cela vers une file de support. Les captures d'écran de clients comptent parmi les entrées les plus précieuses du support, et sont aussi la pire adéquation possible avec un plafond de 800 par 800, car la raison même pour laquelle un client envoie une capture est le petit texte qu'elle contient. Lisez nos notes sur le choix d'un modèle pour le support et sur quel LLM convient au support avant de brancher un modèle brut sur une file en production.
eesel pour les files de support pleines de captures d'écran
Je veux être précis sur ce que ce modèle résout pour une équipe de support, car nous avons le signal de demande en dossier. Un client, un sous-traitant de support pour locations de vacances qui utilise eesel comme copilote Zendesk, nous a dit clairement ce qui l'empêchait de passer en autonomie complète :
"Eesel is currently unable to analyze images, and our customers frequently share screenshots. Our agents are currently required to read these images and manually transfer the knowledge to Eesel."
C'est un vrai besoin non couvert, et un modèle comme celui-ci finira par le combler. Mais il faut être clair sur la moitié qu'un modèle de vision comble réellement. Lire les pixels est la moitié facile. Produire à partir d'eux une réponse correcte et conforme à la politique est la moitié difficile, et c'est aussi celle qui a brûlé tous ceux qui ont déployé du support IA.
Nous avons vu un bot à l'air sûr de lui raconter tranquillement à des clients que nous prenions en charge des modèles de voitures que nous ne prenions pas en charge, parce que la base de connaissances disait "we support all models" et que le bot l'a pris au pied de la lettre. C'était une équipe de télématique sur Zendesk, avec environ 200 tickets par mois. Rien dans un encodeur de vision ne corrige cet échec précis. Ce qui le corrige, c'est d'ancrer l'agent dans votre historique réel, puis de prouver son comportement avant qu'un client ne le rencontre, raison pour laquelle chaque déploiement eesel est d'abord rejoué sur des tickets passés et limité à un type de ticket à la fois.

Si vous évaluez donc le modèle de vision de DeepSeek parce que votre file est pleine de captures d'écran, faites les deux tests dans le bon ordre. D'abord, le modèle peut-il lire vos vraies images une fois redimensionnées ? Ensuite, et c'est le plus important, la réponse qu'il renvoie est-elle une réponse que vous auriez vous-même envoyée ? eesel gère ce second test en simulant sur votre historique de tickets avant la mise en production, en facturant au ticket plutôt qu'au poste et en renvoyant vers un humain tout ce qui passe sous votre seuil de confiance. Essayez eesel gratuitement, ou réservez une présentation sur vos propres tickets.
Où cela se place dans la gamme DeepSeek
Si vous cartographiez la famille, la version courte est la suivante : deepseek-v4-flash-vision-exp est une dérivation du build Flash 0731, avec un encodeur de vision ajouté et FIM retiré. Ce n'est pas un modèle de niveau Pro, et il ne remplace rien.
- DeepSeek V4 Flash est la base texte et reste le build figé à utiliser en production.
- Flash contre Pro traite de la situation étrange où le palier bon marché surpasse actuellement le palier cher.
- Flash contre Kimi K3 et Flash contre GPT-5.6 couvrent les comparaisons entre fournisseurs.
- Qwen 3.8 Max contre Flash est le duel de poids ouverts le plus proche, et Kimi K3 est l'autre à surveiller.
- DeepSeek V3.2 est la génération précédente, si vous la faites encore tourner.
- Notre test de V4-Flash et notre panorama des alternatives couvrent le tableau d'ensemble.
Et si vous êtes arrivé ici par l'angle de l'automatisation du support plutôt que par celui du choix de modèle, la lecture la plus utile se situe plus bas dans la pile :
- Où se place réellement un modèle : ticketing assisté par IA et agents de helpdesk IA.
- La question de la recherche d'information, qui compte souvent plus que le modèle : RAG contre un LLM.
- À quoi ressemble le travail de la file : déviation de tickets et classification de tickets.
- Ordre et volume du tri : priorisation des tickets, automatisation de la première réponse et réduction des tickets.
- Le schéma avec humain dans la boucle : copilotes IA pour le support.
- Terminologie, si les discours des fournisseurs se brouillent : agents contre chatbots.
- Les deux comparaisons qui décident des budgets : coût par résolution et coût d'un agent IA contre un agent humain, face à une base de coût du service client IA.
En bref
DeepSeek a lancé un modèle qui lit les images pour presque rien et, au passage, un meilleur modèle de texte que celui dont il dérive. Les deux sont réels, et les deux sont bon marché.
Les deux points à peser sont ceux que l'annonce ne met pas en avant. Chaque image est aplatie à environ 800 par 800 avant que le modèle ne la regarde, la vision ici est donc un coup d'œil et non une inspection. Et le build ne porte pas de date, donc tout ce que vous mesurez cette semaine est une mesure prise sur une cible mouvante.
Pour des boucles d'agents sur des écrans et du code, c'est un bon compromis à $0,22 en entrée et $0,66 en sortie. Pour une file de support où la capture d'écran est le ticket, testez le redimensionnement avant de planifier autour, et gardez en tête que lire l'image n'a jamais été la partie qui allait mal tourner.
Questions fréquentes
Qu'est-ce que DeepSeek V4 Flash Vision Exp ?
model='deepseek-v4-flash-vision-exp' et il accepte des images en plus du texte dans la même requête. C'est une variante de DeepSeek V4 Flash, avec la même architecture de mélange d'experts (284B au total, 13B actifs) et la même fenêtre de contexte de 1M.Combien coûte DeepSeek V4 Flash Vision Exp ?
DeepSeek V4 Flash Vision Exp est-il meilleur que V4-Flash ?
Quel est le piège de DeepSeek V4 Flash Vision Exp ?
DeepSeek-V4-Flash-Vision-Exp, et non un tampon figé de type 0731, si bien qu'un build expérimental peut bouger sous vos pieds entre le jour des tests et le jour du lancement.DeepSeek V4 Flash Vision Exp peut-il lire des captures d'écran de clients pour le support ?
Comment envoyer une image à l'API DeepSeek ?
file_id issu de la nouvelle API Files, d'utilisation gratuite. Passer par l'API Files relève aussi le plafond par image de 32 MiB à 64 MiB. Notre tutoriel sur l'API DeepSeek couvre l'authentification et l'URL de base compatible OpenAI.
Comment DeepSeek facture-t-il les images ?