

ERNIE 5.5 Flash est un modèle de base ouvert à 280B de paramètres de Baidu, avec 14B actifs par token, publié le 5 novembre 2026. Dans le propre tableau de Baidu, il devance DeepSeek V4 Flash Base sur 26 tests sur 30. Mais c'est un checkpoint de pré-entraînement : il n'y a ni version chat ni version tool-use, aucun prix d'API hébergée, et la licence exclut l'UE, le Royaume-Uni et la Corée du Sud. Pour un agent de helpdesk, mieux vaut attendre le modèle post-entraîné. Ceci est le modèle ; eesel est le coéquipier.
Qu'est-ce qu'ERNIE 5.5 Flash ?
ERNIE 5.5 Flash est un modèle transformer mixture-of-experts creux de Baidu. Ce que Baidu a publié le 5 novembre 2026, c'est ERNIE-5.5-Flash-Base, le checkpoint "à la fin du pré-entraînement, avant tout mid- ou post-entraînement". Baidu dit que c'est délibéré : les développeurs peuvent prendre les poids et choisir où les entraîner ensuite.
Je travaille sur les agents IA d'eesel, donc la première chose que je vérifie à chaque sortie de modèle, c'est à quelle étape d'entraînement se trouvent les poids. Ici, la réponse est l'étape la plus précoce qui soit utilisable, et cela change presque tout dans la façon de lire le reste de cet article.
La fiche technique, tirée de la model card de Baidu :
| Spécification | ERNIE-5.5-Flash-Base |
|---|---|
| Paramètres totaux / actifs | 280B / 14B par token |
| Couches | 43 (1 dense, 42 mixture-of-experts) |
| Experts | 512 routés (top 10 par token) plus 1 partagé |
| Données de pré-entraînement | 33.5T tokens |
| Contexte | 128K à l'entraînement, 1M pour le fine-tuning et l'inférence |
| Modalité | Texte uniquement |
| Poids | Safetensors FP8 et BF16 |
| Vocabulaire | 201,216 tokens |
| Licence | ERNIE 5.5 Flash Base Model License v1.0 |
Seulement environ 5% des paramètres travaillent sur un token donné, c'est ainsi qu'un modèle de 280B peut fonctionner comme un modèle de 14B. C'est le même compromis que fait DeepSeek V4 Flash avec 284B au total et 13B actifs.
Qu'est-ce qui est nouveau dans la conception ?
Le blog technique de Baidu parle surtout de coûts : combien de mémoire consomme un long contexte, et à quel point on peut continuer l'entraînement à bas coût. Quatre choix se distinguent.
- Attention économique. Une couche sur sept conserve l'attention sur le contexte complet. Le reste utilise "Heavily Compressed Attention", qui stocke une seule entrée de cache par 128 tokens, ce qui fait que la fenêtre de contexte coûte bien moins de mémoire.
- Plusieurs routers par couche. Au lieu qu'un seul router choisisse les experts, chaque couche mixture-of-experts utilise plusieurs routers indépendants, avec l'argument que le score d'un seul router est un indice faible pour savoir quel expert aide vraiment.
- Décodage spéculatif intégré. La dernière couche du modèle fait aussi office de modèle brouillon, une conception que Baidu appelle ECHO, si bien qu'une génération plus rapide ne nécessite pas de modèle auxiliaire séparé.
- Code et documents longs dans les données. Le pré-entraînement s'appuie beaucoup sur du code à l'échelle de dépôts entiers et des données à contexte long, incluant commits, pull requests et revues de code.
Rien de tout cela ne dit si le modèle est agréable pour discuter. Cela dit que le modèle a été conçu pour être peu coûteux à fine-tuner et à servir, ce qui est le but d'une publication de modèle de base.
ERNIE 5.5 Flash est-il un modèle de chat ?
Non, et c'est le fait le plus important à son sujet. Les poids sont le checkpoint de pré-entraînement, et Baidu dit que l'ERNIE 5.5 Flash post-entraîné suivra. Aucune date n'a été donnée. La model card indique qu'il est servi via l'endpoint completions, ce qui signifie que vous envoyez du texte et qu'il le continue, sans format de chat.
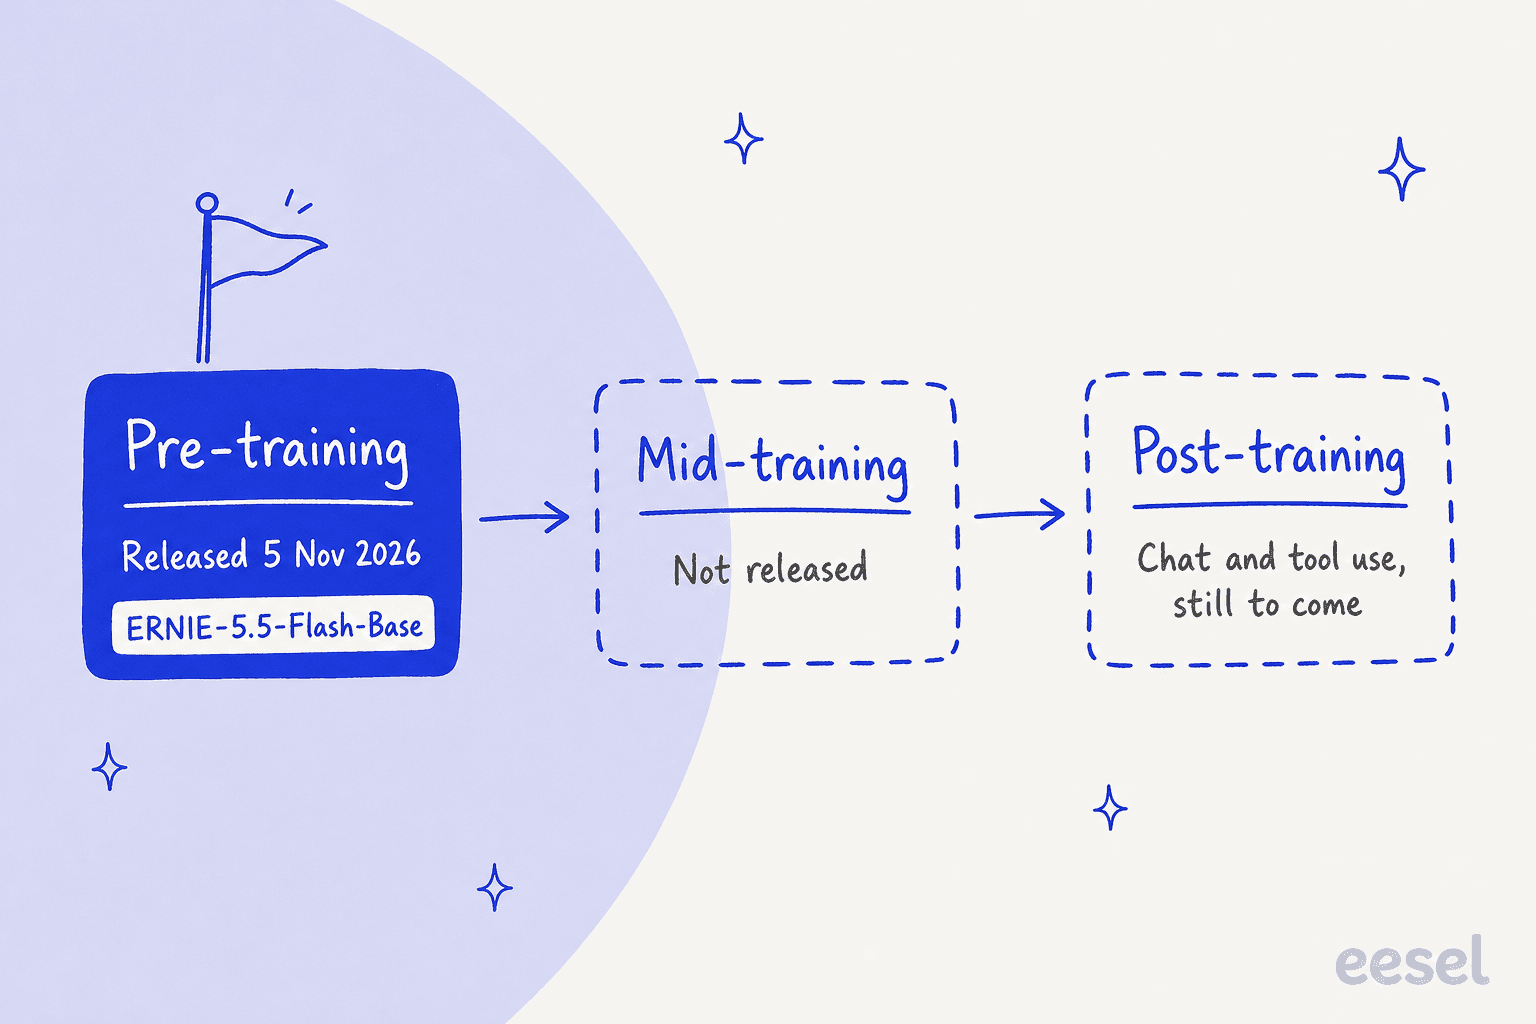
Un modèle post-entraîné est celui qui suit des instructions, reste dans une persona, appelle des outils et sait dire non. La gamme phare de Baidu est distincte : la sortie d'ERNIE 5.1 est datée du 9 mai 2026, et ERNIE 5.0 est un modèle multimodal de 2,4 billions de paramètres. ERNIE 5.5 Flash est une gamme différente, centrée sur l'efficacité, et pour l'instant seuls ses ingrédients bruts sont publics.
Un commentateur de Hacker News a résumé la portée pratique très clairement dans le fil de lancement, qui a atteint 162 points :
"It's not instruction finetuned, so no, it's not good to use for anything like coding agents."

Que disent les benchmarks d'ERNIE 5.5 Flash ?
Dans le tableau de Baidu, le modèle de base gagne la plupart des lignes. Baidu l'a comparé à trois autres modèles de base, DeepSeek-V4-Flash-Base (284B au total, 13B actifs), Hy3-preview-Base (295B, 21B) et MiMo-V2.5-Base (310B, 15B), "tous évalués avec le même pipeline, les mêmes prompts et les mêmes réglages few-shot". Face à DeepSeek, ERNIE score plus haut sur 26 lignes sur 30.
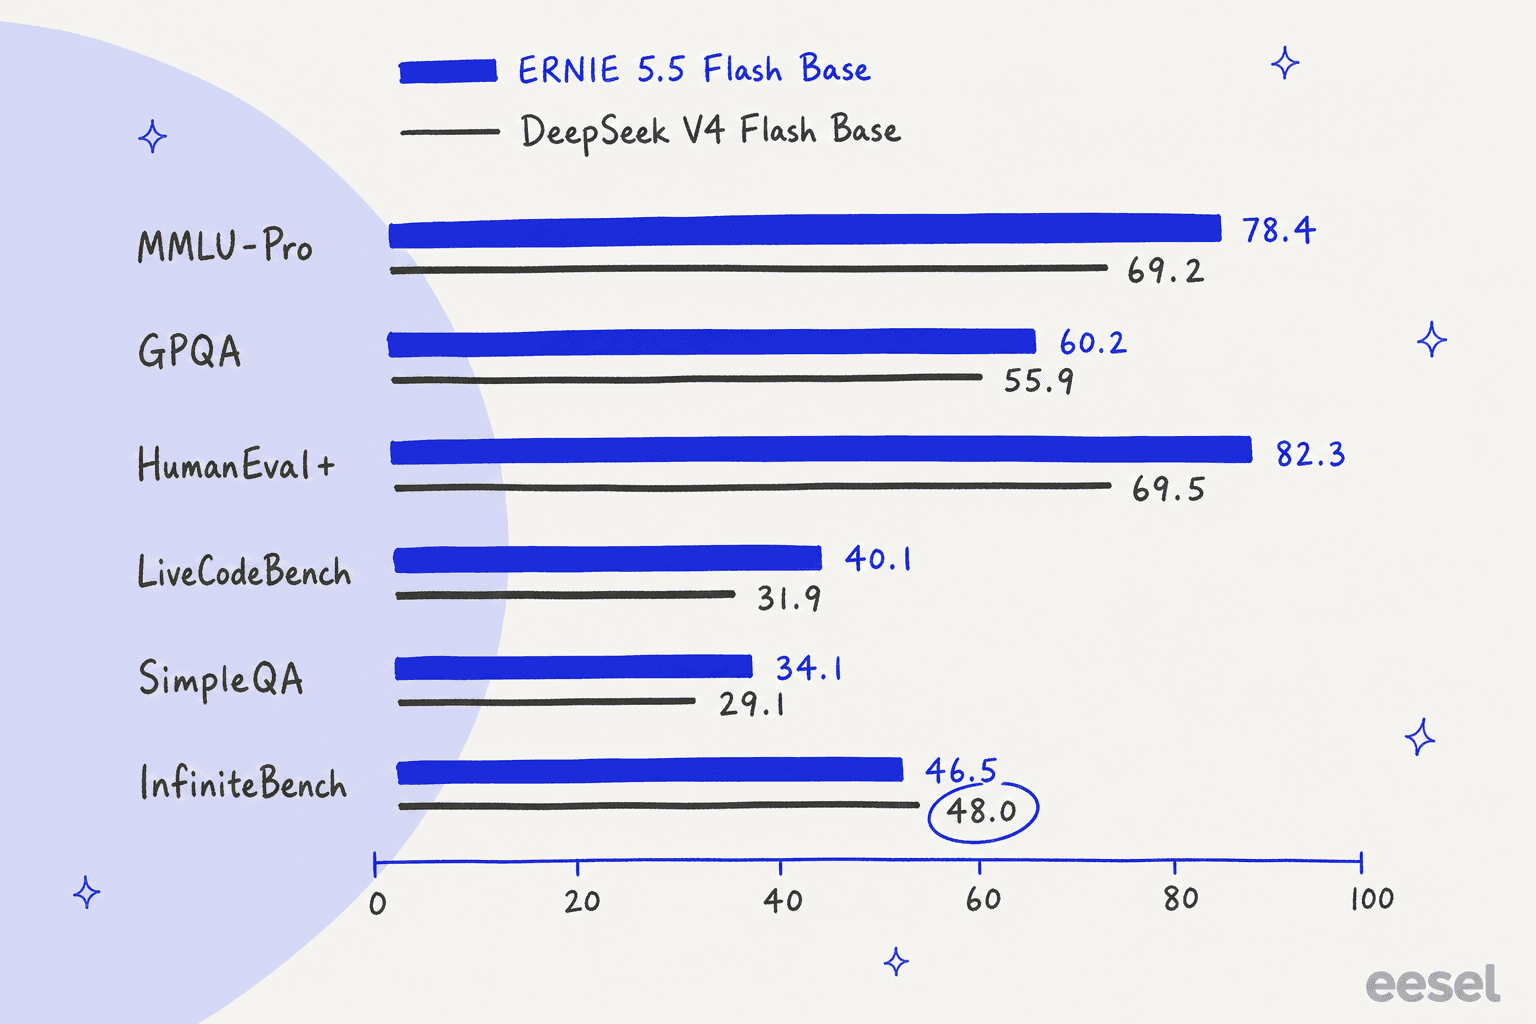
Voici un extrait du tableau complet, incluant chaque ligne où ERNIE a perdu face à DeepSeek :
| Benchmark | ERNIE 5.5 Flash Base | DeepSeek V4 Flash Base |
|---|---|---|
| MMLU-Pro | 78.4 | 69.2 |
| GPQA | 60.2 | 55.9 |
| HumanEval+ | 82.3 | 69.5 |
| LiveCodeBench | 40.1 | 31.9 |
| RepoQA (contexte long) | 91.7 | 81.0 |
| SimpleQA | 34.1 | 29.1 |
| ChineseSimpleQA | 73.0 | 75.3 |
| INCLUDE-lite (multilingue) | 79.5 | 79.8 |
| HELMET-Rerank (contexte long) | 56.2 | 60.0 |
| InfiniteBench (contexte long) | 46.5 | 48.0 |
Trois raisons de prendre ces chiffres avec prudence :
- Ce sont les propres tests de Baidu. Je n'ai trouvé aucune évaluation indépendante. Artificial Analysis n'a pas encore de page ERNIE 5.5.
- Ce sont des tests de modèle de base. Les benchmarks de connaissance few-shot et de code mesurent ce que le pré-entraînement a construit. Ils ne mesurent pas si le modèle suit un system prompt ou termine une tâche à plusieurs étapes.
- Le rival n'est pas le plus récent. Un commentateur de Hacker News a noté que Baidu s'est comparé à l'ancienne base V4 Flash, essentiellement deux versions derrière la dernière version de DeepSeek Flash.
"They're comparing it to Deepseek-v4-Flash, not 4.1 and not the 4.1 1017 update, so essentially two versions behind the latest version of Deepseek Flash."
La lecture honnête est que le pré-entraînement paraît solide, surtout en code et en connaissances, et que les lignes de contexte long sont mitigées. Reste à savoir si cela survit au post-entraînement.
Combien coûte ERNIE 5.5 Flash ?
Les poids ne coûtent rien à télécharger, et il n'y a pas de prix d'API Baidu à citer. La page Hugging Face indiquait, au moment où je l'ai consultée, que le modèle "isn't deployed by any Inference Provider", et je n'ai trouvé aucune fiche sur OpenRouter non plus.
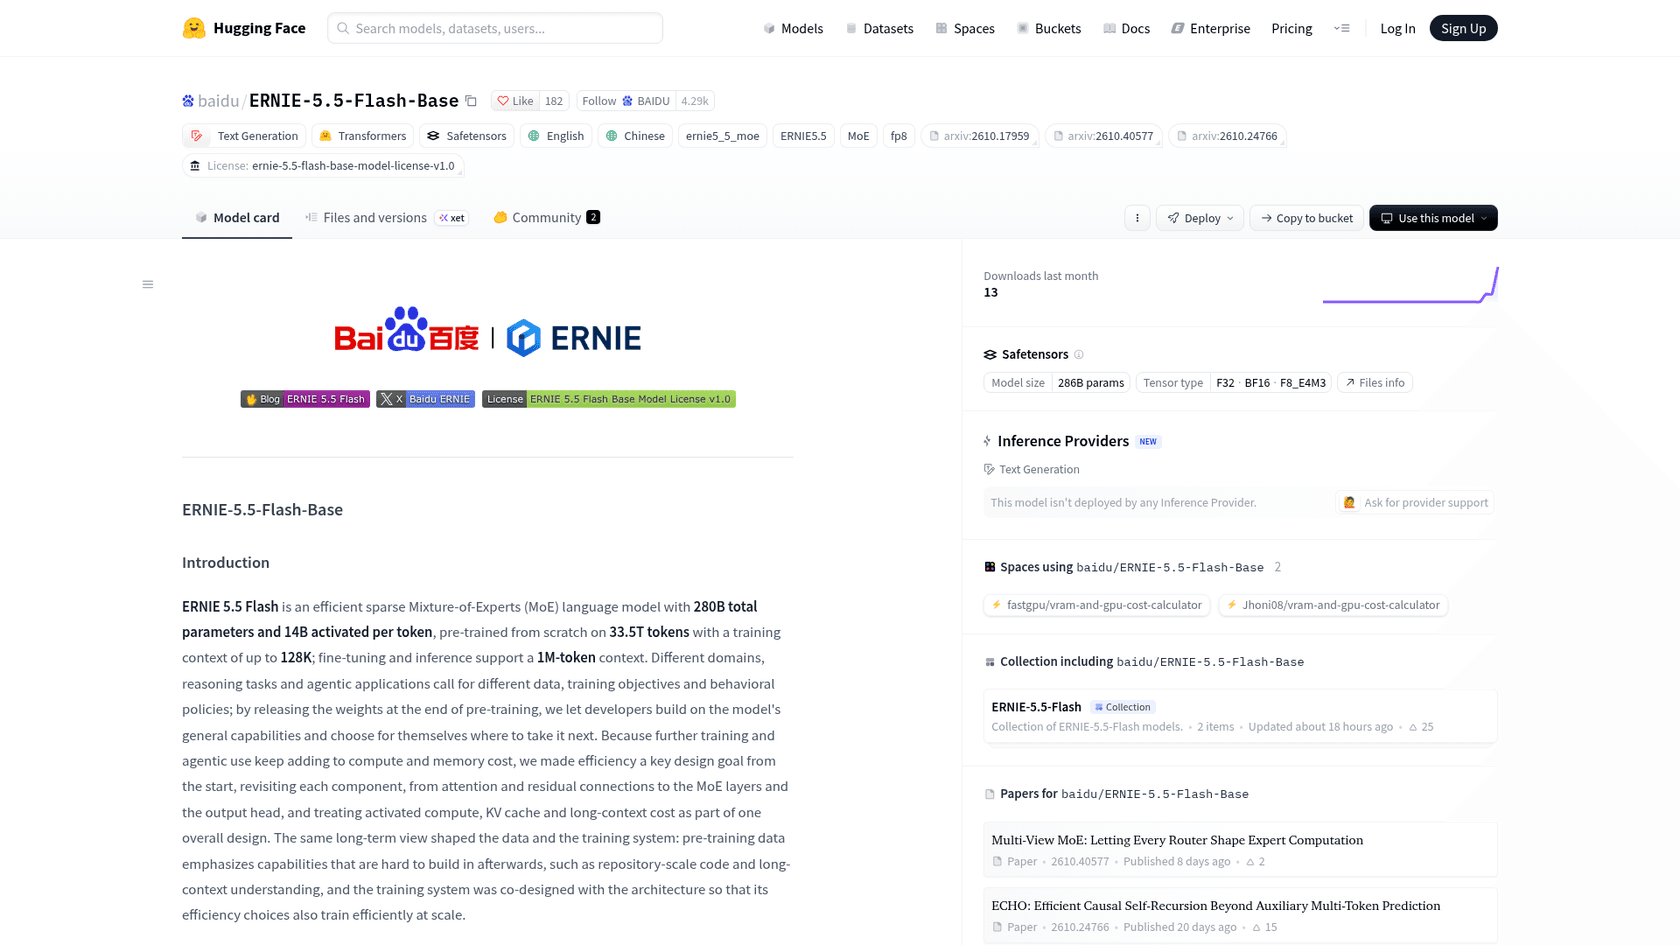
Le coût réel est donc le matériel et l'ingénierie. Hugging Face liste 286B de paramètres, et les poids FP8 prennent environ un octet chacun, donc selon mon calcul, il faut environ 286 Go juste pour tenir le modèle, avant même de compter le cache KV. Les propres commandes de lancement de Baidu sont configurées pour un parallélisme à quatre voies : --tp 4 pour SGLang et --data-parallel-size 4 pour vLLM.
Pour voir où cela situe le modèle face aux options hébergées, voici une charge de travail hypothétique : 10,000 conversations de support par mois, 3,000 tokens d'entrée et 500 de sortie chacune, soit 30M d'entrée et 5M de sortie, sans cache et sans tokens de raisonnement. Les prix viennent de la page de chaque fournisseur.
| Modèle | Entrée / sortie par 1M de tokens | Facture mensuelle pour cette charge |
|---|---|---|
| ERNIE 5.5 Flash | Aucun prix hébergé publié | Vos propres GPU |
| Claude Haiku 5.5 (prompts jusqu'à 100K) | $0.10 / $0.50 | $5.50 |
| GPT-6 Luna | $0.10 / $0.50 | $5.50 |
| Qwen3.8-Flash (international) | $0.15 / $0.47 | $6.85 |
| DeepSeek V4.1 Flash (heures creuses) | $0.15 / $0.60 | $7.50 |
| DeepSeek V4.1 Flash (heures de pointe) | $0.30 / $1.20 | $15.00 |
| Gemini 3.8 Flash (jusqu'au 31 déc. 2026) | $0.75 / $3.75 | $41.25 |
Ce sont des factures minuscules. À ce volume, les tokens hébergés coûteront presque certainement moins cher qu'un serveur multi-GPU qui tourne jour et nuit, même si je n'ai pas chiffré le matériel. Auto-héberger un modèle ouvert se justifie pour d'autres raisons, comme garder les données sur votre propre réseau ou entraîner un modèle au style de votre maison, et c'est exactement à cela que sert un modèle de base : un fine-tune. Des articles plus détaillés sur les prix se trouvent sur les prix de DeepSeek V4.1 Flash et les prix de Claude Haiku 5.5.
Qui est autorisé à utiliser ERNIE 5.5 Flash ?
Moins de monde que ne le suggère le mot "ouvert". La licence d'ERNIE 5.5 Flash est un accord propre à Baidu, et quatre clauses comptent en pratique.
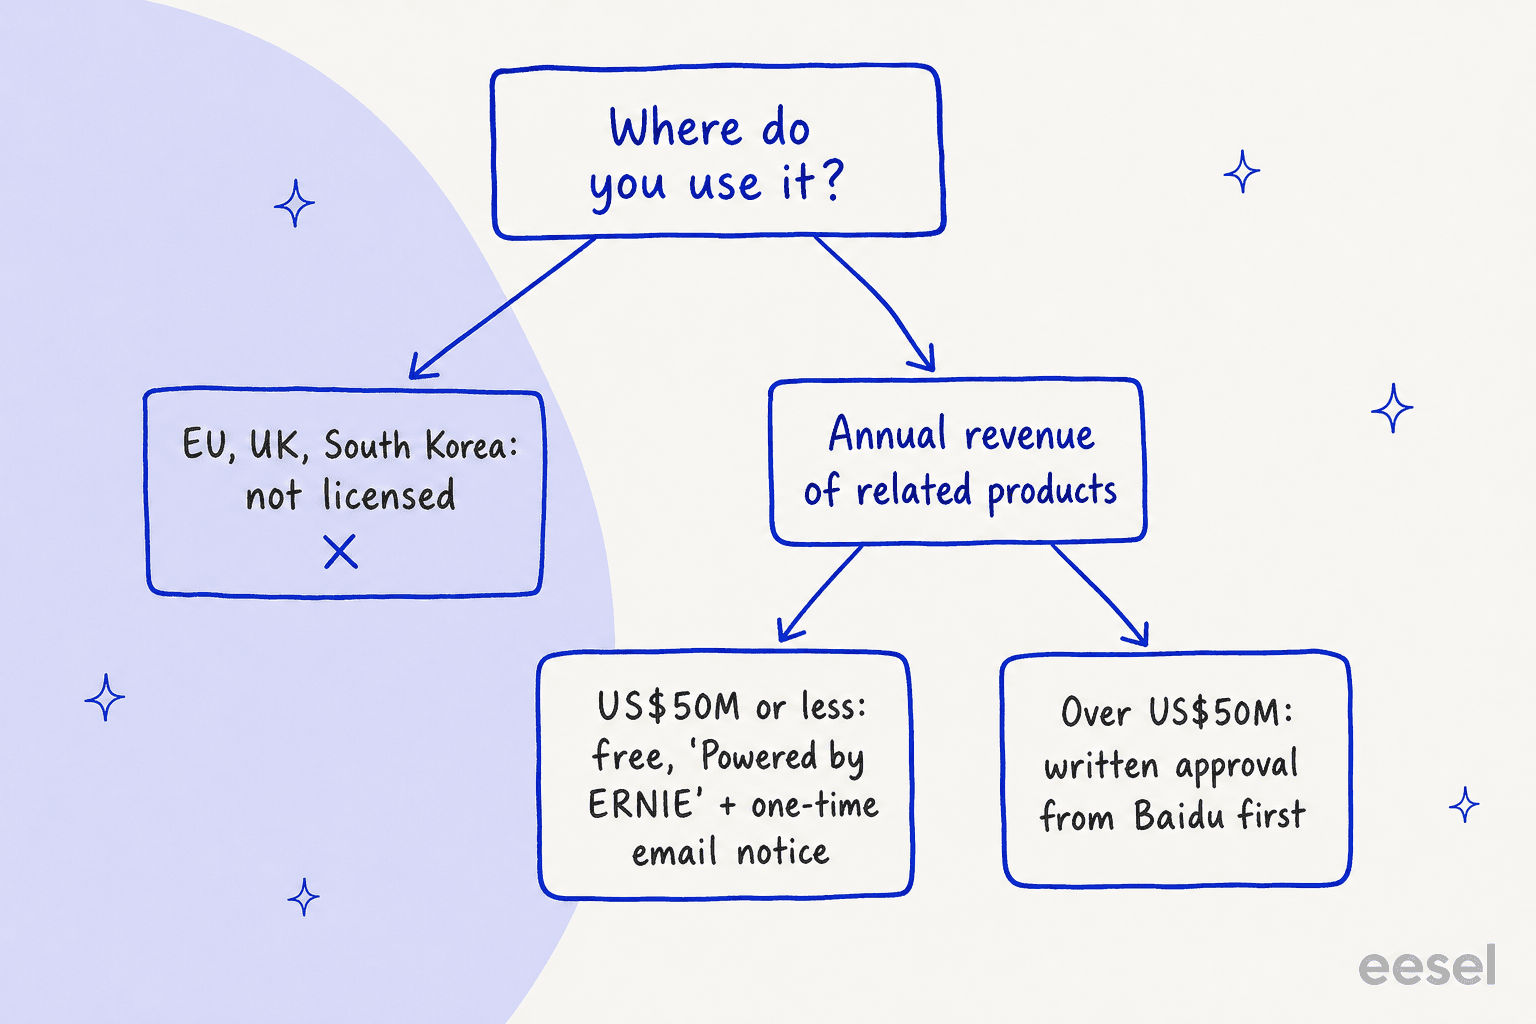
- Territoire. La concession couvre partout "sauf l'Union européenne, le Royaume-Uni et la Corée du Sud". La section 5.3 interdit aussi d'utiliser les sorties du modèle hors de ce territoire.
- Revenus. L'usage commercial est sans frais de licence jusqu'à 50 millions de dollars de revenus annuels du produit concerné, comptés sur l'ensemble des filiales. Au-delà, il faut l'autorisation écrite de Baidu avant de commencer.
- Attribution. Un produit commercial doit afficher les mots exacts "Powered by ERNIE" dans son interface, son site web ou sa documentation, et vous envoyez à Baidu une notification unique par e-mail.
- Pas de distillation. La section 5.5 interdit d'utiliser le modèle ou ses sorties pour améliorer un autre modèle d'IA, à l'exception des dérivés du modèle lui-même.
Les développeurs l'ont remarqué. Sur Hacker News, la licence était la principale plainte :
"The license seems really restrictive for something intended to be built on. Entire countries are forbidden to use it at all (European Union, the United Kingdom and South Korea), and you are responsible for making sure no one in those places uses your derivative."
Un commentateur avait une lecture plus détendue, estimant que l'exclusion est une façon d'éviter un risque réglementaire plutôt qu'une chose que Baidu compte vraiment faire respecter. Dans tous les cas, si vos clients sont en Europe, c'est à vous de régler le problème, et le guide de l'AI Act européen ainsi que le guide sur la résidence des données montrent le poids que cela représente pour le support.
Les fans de modèles de base ont aussi trouvé beaucoup à apprécier :
"Absolutely glad to see the release of a base model, I think the trend away from that has been an issue for the field."
Comment exécuter ERNIE 5.5 Flash hors de Chine ?
Vous téléchargez les poids et les servez vous-même, si votre localisation se trouve dans le territoire de la licence. Les poids sont sur Hugging Face et ModelScope en FP8, avec aussi une copie BF16.
- SGLang : l'image préconstruite est
lmsysorg/sglang:dev-ernie-55-flash, lancée avec--tp 4 --attn-dp-size 4. - vLLM : version 0.32.0 plus le plugin vLLM-ERNIE de Baidu, avec
--data-parallel-size 4. - Contexte : les deux serveurs acceptent jusqu'à 1,048,576 tokens, et le contexte d'entraînement était de 128K.
- Fine-tuning : Baidu renvoie vers un exemple Megatron Bridge de NVIDIA.
Il n'y a pas encore de raccourci hébergé. Si vous voulez simplement un modèle Flash hébergé et bon marché dès aujourd'hui, le tableau ci-dessus est votre liste de courses, et l'avis sur Qwen 3.8 Flash couvre l'un d'entre eux en détail.
ERNIE 5.5 Flash convient-il à un agent IA de helpdesk ?
Pas aujourd'hui. Je ne mettrais ce checkpoint près d'aucune file client, pour quatre raisons.
- Il ne suit pas encore d'instructions. Un agent de support doit obéir à un system prompt, utiliser des guardrails et savoir quand escalader. Ce sont des comportements de post-entraînement, et c'est justement ce qui manque.
- Il n'y a rien à appeler. L'absence d'endpoint hébergé signifie que vous portez vous-même le coût de service, la disponibilité et la revue de sécurité.
- La licence bloque les clients européens. Une équipe de support à Copenhague ou à Londres ne peut pas utiliser les sorties selon la concession telle qu'elle est écrite.
- Personne ne l'a mesuré sur du travail de support. Le tableau de Baidu ne comporte aucun test de type τ-bench de suivi de politiques, aucun test d'usage d'outils et aucun taux d'hallucination.
Le modèle n'est aussi que la plus petite moitié du travail. Même une version post-entraînée parfaite aurait encore besoin d'une base de connaissances, de règles de transfert, de retrieval et d'un moyen de vérifier les réponses avant que les clients ne les voient. C'est le vrai coût derrière construire ou acheter, et la raison pour laquelle un modèle seul ne devient jamais un agent de support. Ma règle courte : ceci est le modèle ; eesel est le coéquipier.
eesel est une plateforme de coéquipiers IA, et son coéquipier IA de helpdesk rejoint la file que vous gérez déjà dans Zendesk, Freshdesk, Gorgias et d'autres. eesel met de l'IA dans des files de support en direct depuis des années, c'est pourquoi chaque déploiement est d'abord simulé sur vos tickets historiques. Vous lisez ce que le coéquipier aurait dit avant qu'il ne réponde à qui que ce soit.
Timengo, une entreprise danoise d'e-mail sécurisé, utilise eesel sur Freshdesk. Le coéquipier rédige des réponses en danois à partir d'environ 5,300 tickets passés et d'articles du centre d'aide, a préparé 300 tickets en un mois et a écrit 180 brouillons de réponse. Un ingénieur support relit et envoie chacun d'eux, et eesel n'envoie jamais de lui-même. SamCart fait tourner un agent sur les tickets Freshdesk et un autre sur le chat du site, tous deux répondant à partir d'environ 280 articles du centre d'aide. L'agent de tickets ne répond que tant que personne n'est assigné, et se retire dès qu'un coéquipier reprend le ticket.
Ce comportement de "retrait" est exactement le genre de chose qu'un modèle de base n'a pas appris. C'est aussi pourquoi j'attendrais l'ERNIE 5.5 Flash post-entraîné plutôt que de juger cette sortie comme un agent. Quand il arrivera, notre guide pour choisir un LLM pour le support et le meilleur modèle pour les tickets de support montrent quoi tester d'abord, et la prévention des hallucinations est la partie qui fait le plus mal.
Si vous aimez travailler depuis un terminal, la CLI eesel vaut le détour. Avec elle, un agent IA de code peut téléverser des connaissances approuvées comme des articles d'aide exportés et des macros, modifier les instructions du coéquipier et poser des questions de test pour vérifier les réponses avant que quoi que ce soit ne passe en production. Connecter le helpdesk lui-même nécessite toujours quelqu'un avec un accès admin pour approuver. Il y a plus de détails dans gérer des agents IA depuis le terminal.
Qui devrait utiliser ERNIE 5.5 Flash ?
Voici mon avis après avoir lu intégralement le blog, la model card et la licence de Baidu :
- Essayez-le si vous êtes une équipe de recherche ou une entreprise hors de l'UE, du Royaume-Uni et de la Corée du Sud qui veut une base solide et efficace à fine-tuner. Un modèle mixture-of-experts avec 14B actifs et un contexte de 1M est un bon point de départ, et un checkpoint de base est exactement ce qu'il faut pour le fine-tuning.
- Attendez si vous voulez un modèle de chat ou d'agent. Baidu en a promis un sans date, et des tests externes vous diront plus qu'un tableau de fournisseur.
- Passez votre tour si vous servez des clients européens, ou si vous avez simplement besoin de tokens hébergés bon marché. DeepSeek V4.1 Flash, Claude Haiku 5.5 et GPT-6 Luna sont prêts dès aujourd'hui.
- Comparez-le à d'autres modèles ouverts si vous magasinez : Kimi K3, GLM 5.3 Flash et Ripple-65B font chacun un compromis différent entre taille, prix et licence.
Le résumé que je donnerais à un collègue : ERNIE 5.5 Flash est un ingrédient prometteur. Les chiffres de pré-entraînement sont solides dans le propre tableau de Baidu et la conception économe en coûts est réelle, mais le modèle de chat manque, et la licence a des limites géographiques.
Essayer eesel
Si vous êtes venu voir ERNIE en espérant qu'un nouveau modèle ouvert retire des tickets à votre équipe, vous pouvez vous passer de construire vous-même la couche de support. Le coéquipier IA de helpdesk d'eesel se branche sur Zendesk, Freshdesk, Gorgias et plus en quelques minutes, apprend de vos tickets passés et vous montre comment il aurait répondu avant la mise en service. Les plans démarrent à $299 par mois, et il existe un niveau gratuit pour tester.

Essayer eesel gratuitement.
Comment ERNIE 5.5 Flash se compare-t-il à DeepSeek V4 Flash ?