

En bref
LFM3 est la nouvelle famille de six modèles ouverts de Liquid AI d'environ 2B paramètres chacun, lancée le 27 octobre 2026, et le modèle textuel, LFM3-1.7B, obtient une moyenne de 49.37 dans le tableau de 29 benchmarks de Liquid, contre 47.24 pour Qwen3.5-9B, un modèle cinq fois plus grand. Il est conçu pour les agents locaux : il décode 43.6 tokens par seconde sur un iPhone 17 Pro en utilisant 1.90 GB de mémoire, soit environ 2,8x plus vite que le deuxième modèle le plus rapide testé par Liquid.
La famille couvre le texte, la vision, l'audio, un modèle « omni » qui voit, entend et parle, et deux modèles de décision (d1-2B et d1-Omni-2B) qui répondent à des questions sur un ticket ou un document en quelques millisecondes au lieu de rédiger une réponse. Les poids sont gratuits sur Hugging Face, mais uniquement pour les entreprises dont le chiffre d'affaires annuel est inférieur à 10 M$, et aucun tarif d'API n'a encore été publié pour LFM3.
Le hic : la propre fiche du modèle de Liquid déconseille d'utiliser LFM3-1.7B pour le développement agentique ou le raisonnement complexe en plusieurs étapes, et tous les chiffres ci-dessus sont communiqués par le fournisseur. Pour les équipes de support, l'élément intéressant est d1-2B, qui peut orienter et étiqueter un ticket en une seule passe. Un modèle a toujours besoin d'un outil de support autour de lui, c'est pourquoi des équipes comme Dokument 24 utilisent un coéquipier IA pour le support prêt à l'emploi pour étiqueter chaque nouveau ticket Zendesk et préparer un brouillon de réponse, plutôt que d'intégrer elles-mêmes un modèle.
Qu'est-ce que LFM3 ?
LFM3 est la troisième génération de Liquid Foundation Models de Liquid AI, l'entreprise à l'origine de petits modèles conçus pour fonctionner sur des téléphones, des ordinateurs portables et des voitures plutôt que dans un centre de données. Liquid a annoncé LFM3 le 27 octobre 2026 avec la formule "every modality for specialized intelligence," et la première version couvre des modèles "in the 2B parameter range."
J'aborde les nouveaux modèles sous l'angle de la recherche (quelles questions les gens se posent-ils vraiment à leur sujet ?), avec, en toile de fond, une question de concepteur : que faudrait-il pour les faire fonctionner derrière un vrai produit ? Pour LFM3, la réponse est plus intéressante que pour la plupart des lancements, car il ne s'agit pas d'un modèle, mais d'une famille.
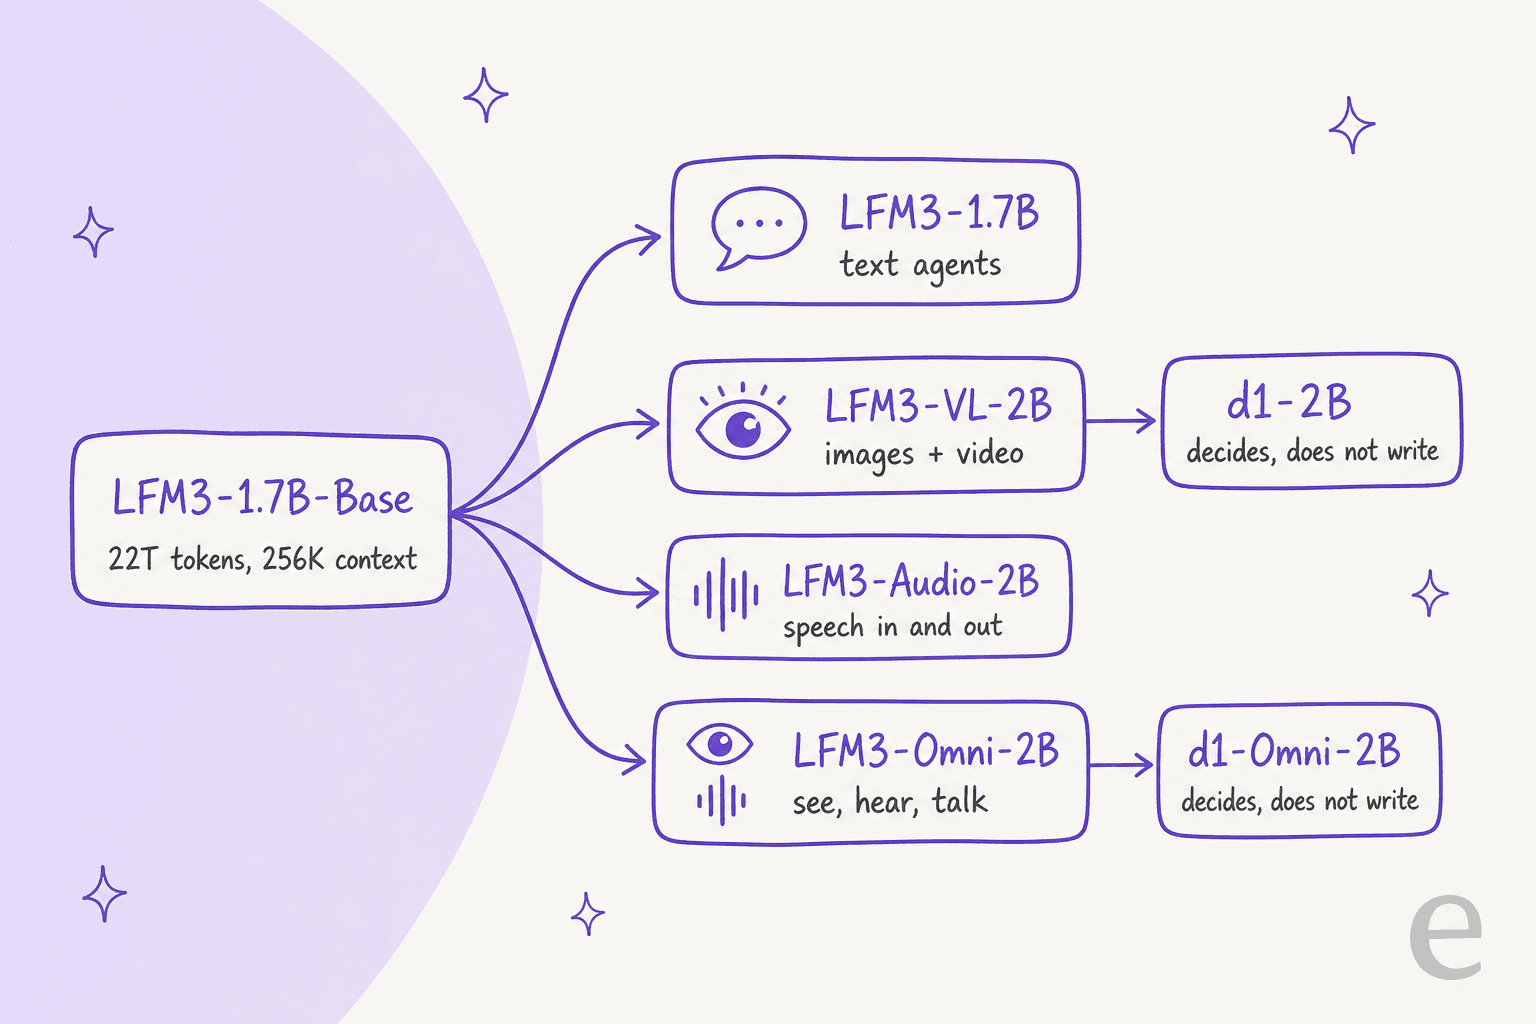
Les six modèles post-entraînés dérivent d'un même socle, LFM3-1.7B-Base, qui a été pré-entraîné sur 22 billions de tokens et possède une fenêtre de contexte de 256K tokens. Plutôt qu'un grand modèle généraliste, Liquid propose de choisir le petit modèle adapté à la tâche, de l'affiner sur vos propres données et de l'exécuter sur l'appareil.
Les modèles LFM3 en un coup d'œil
Voici l'intégralité de la première version, avec les chiffres tirés de chaque fiche de modèle Hugging Face :
| Modèle | Ce qu'il fait | Paramètres | Contexte |
|---|---|---|---|
| LFM3-1.7B | Texte, appels d'outils, agents locaux | 1.73B | 256K |
| LFM3-VL-2B | Images et vidéos en entrée, texte en sortie, avec raisonnement étape par étape | 1.92B | 128K |
| LFM3-Audio-2B | Reconnaissance vocale, sortie vocale, traduction vocale | 2B | 32K |
| LFM3-Omni-2B | Texte, image, vidéo et audio en entrée ; texte et voix en sortie | 2.17B | 32K |
| d1-2B | Décisions à partir de textes et d'images, sans génération de texte | 1.92B | 128K |
| d1-Omni-2B | Décisions à partir de textes, d'images et d'audio | 2B | Non précisé |
Le modèle textuel comprend 16 langues, dont l'anglais, l'arabe, le chinois, le japonais, l'hindi et le polonais, selon sa fiche de modèle, ce qui compte lorsque vous gérez un support multilingue. Le modèle omni parle dans 19 langues et variantes régionales.
Qu'est-ce qui a changé dans l'architecture de LFM3 ?
LFM2 a prouvé qu'un mélange de convolutions courtes et d'attention pouvait fonctionner rapidement sur un téléphone. LFM3 conserve cette idée et ajoute un troisième ingrédient. Sur ses 24 couches, le point à retenir est que 13 sont des convolutions courtes à portes, tandis que 5 utilisent une attention à fenêtre glissante de 256 tokens et 6 une attention globale. Liquid appelle cela un "tri-hybrid."
Le principal enjeu de cette refonte concerne les contextes longs. L'article de lancement indique que LFM3-1.7B égale LFM2-1.2B sur les prompts courts sur différents appareils en périphérie, à nombre de paramètres égal, et qu'il est environ 25 % plus rapide avec 8K tokens en contexte. Liquid a trouvé cette architecture grâce à une recherche avec matériel dans la boucle sur 14 combinaisons d'appareils et de moteurs d'exécution, du Samsung Galaxy S26 Ultra et du Raspberry Pi 5 aux ordinateurs portables Apple M4 Max et au NPU Qualcomm Hexagon.
L'entraînement a davantage porté sur les tâches agentiques cette fois-ci. Les derniers 3.5 billions de tokens de pré-entraînement provenaient de données sélectionnées avec "a larger share of agentic traces and diverse tool calls," puis le modèle textuel est passé par quatre étapes de post-entraînement : un affinage supervisé sur 1.75 billion de tokens, un apprentissage par renforcement mixte, une distillation à partir de six modèles enseignants spécialisés et un apprentissage par renforcement agentique dans de véritables environnements d'exécution d'agents comme OpenClaw et Hermes Agent.
Que vaut LFM3-1.7B sur les benchmarks ?
Dans le propre tableau de Liquid AI, LFM3-1.7B dépasse des modèles bien plus grands sur les tâches agentiques et le suivi des instructions, mais il est en retrait sur le code et les connaissances. Sa moyenne sur 29 benchmarks est de 49.37, contre 47.24 pour Qwen3.5-9B, 39.27 pour Qwen3.5-4B, 39.19 pour MiniCPM5 2B et 31.74 pour Gemma 4 E4B.
Voici un extrait des résultats publiés :
| Benchmark | LFM3-1.7B | MiniCPM5 2B | Gemma 4 E4B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|
| AutomationBench (public) | 41,29 | 4,71 | 1,92 | 8,67 | 15,10 |
| WebArena-Verified | 38,42 | 9,11 | 17,06 | 21,92 | 28,94 |
| BFCL V4 (appels d'outils) | 71,39 | 62,65 | 48,25 | 55,12 | 62,83 |
| τ³-bench | 68,01 | 69,44 | 33,53 | 65,98 | 67,11 |
| IFBench | 73,03 | 62,08 | 44,56 | 38,16 | 48,84 |
| SWE-bench Verified (OpenCode) | 43,40 | 34,80 | 0,50 | 41,20 | 51,20 |
| GPQA Diamond | 63,37 | 65,15 | 57,88 | 75,76 | 80,40 |
| RULER 128K | 65,56 | 37,96 | 18,82 | 84,63 | 87,11 |
| Moyenne (29 benchmarks) | 49,37 | 39,19 | 31,74 | 39,27 | 47,24 |
La ligne τ³-bench est celle que je regarderais en premier si vous travaillez dans le support, car τ-bench simule un agent aidant des clients au fil de conversations à plusieurs tours, avec des outils et des règles. LFM3-1.7B obtient 68.01, à peu près au niveau des 67.11 de Qwen3.5-9B et juste derrière les 69.44 de MiniCPM5 2B. C'est solide pour sa taille, ce qui est bien, mais ce n'est pas l'avance écrasante que l'on voit sur AutomationBench. (Pour comparer les plus grands modèles hébergés sur les tâches de support, je tiens à jour une sélection du meilleur modèle d'IA pour les tickets de support.)
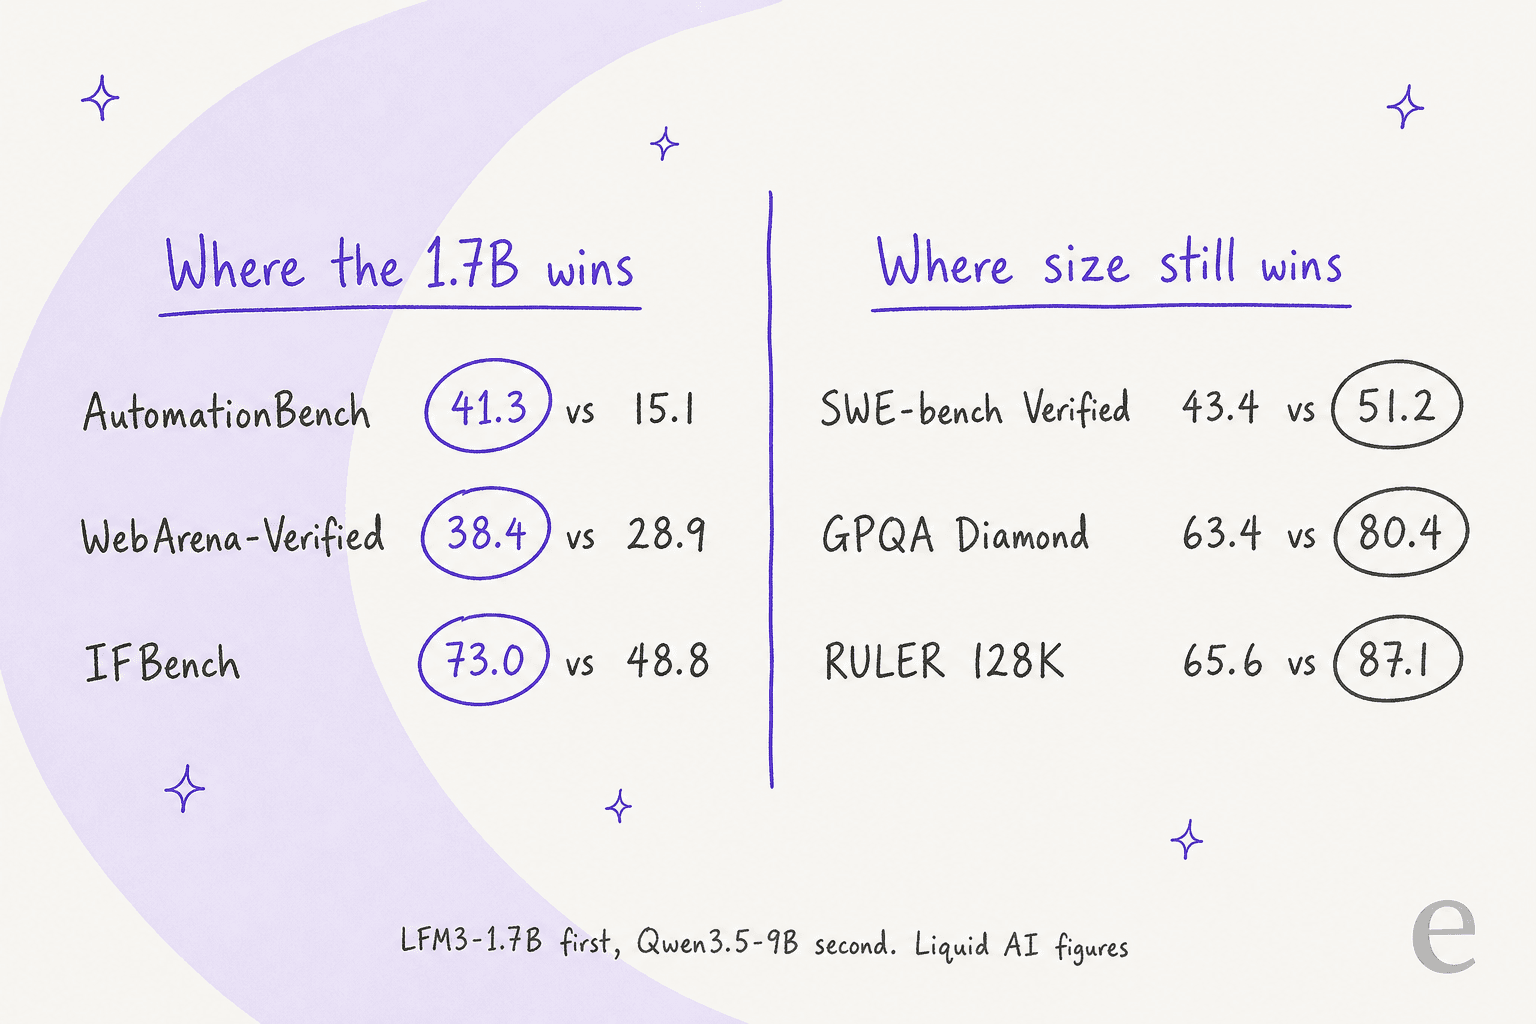
C'est ce contraste qui est vraiment révélateur. LFM3-1.7B est bon pour suivre des instructions et appeler des outils, et faible lorsque les connaissances brutes ou le rappel en contexte long déterminent le score. Liquid le dit aussi : la recherche "helps close the knowledge gap," faisant presque doubler son score à Humanity's Last Exam, de 7.17 à 13.90, lorsque les outils sont autorisés. Un lecteur du fil de discussion du lancement a résumé le tableau ainsi :
"Agentic coding numbers on par with Qwen3.5-4B, the rest of the numbers on par with Qwen3.5-9B. Most impressive for a 1.7B model!"

Un autre chiffre mérite d'être connu : sur AA-Omniscience, un test qui récompense le fait de dire « Je ne sais pas » plutôt que de deviner, LFM3-1.7B a obtenu 92.93 en non-hallucination, contre 13.64 pour Qwen3.5-4B. Son exactitude sur le même test n'était que de 7.07, il y parvient donc surtout en refusant de répondre. Pour un modèle censé faire appel de toute façon à la recherche ou à une base de connaissances, c'est le bon réflexe, et c'est la même habitude que l'on recherche pour prévenir les hallucinations de l'IA dans le support.
À quelle vitesse LFM3 fonctionne-t-il sur un téléphone ou un ordinateur portable ?
Très vite pour sa catégorie. Liquid l'a testé avec llama.cpp en Q4_0 et un contexte de 32K tokens, et LFM3-1.7B était le modèle le plus rapide sur les trois appareils, avec un décodage 1.8 à 2,8 fois plus rapide que le suivant, tout en utilisant le moins de mémoire.
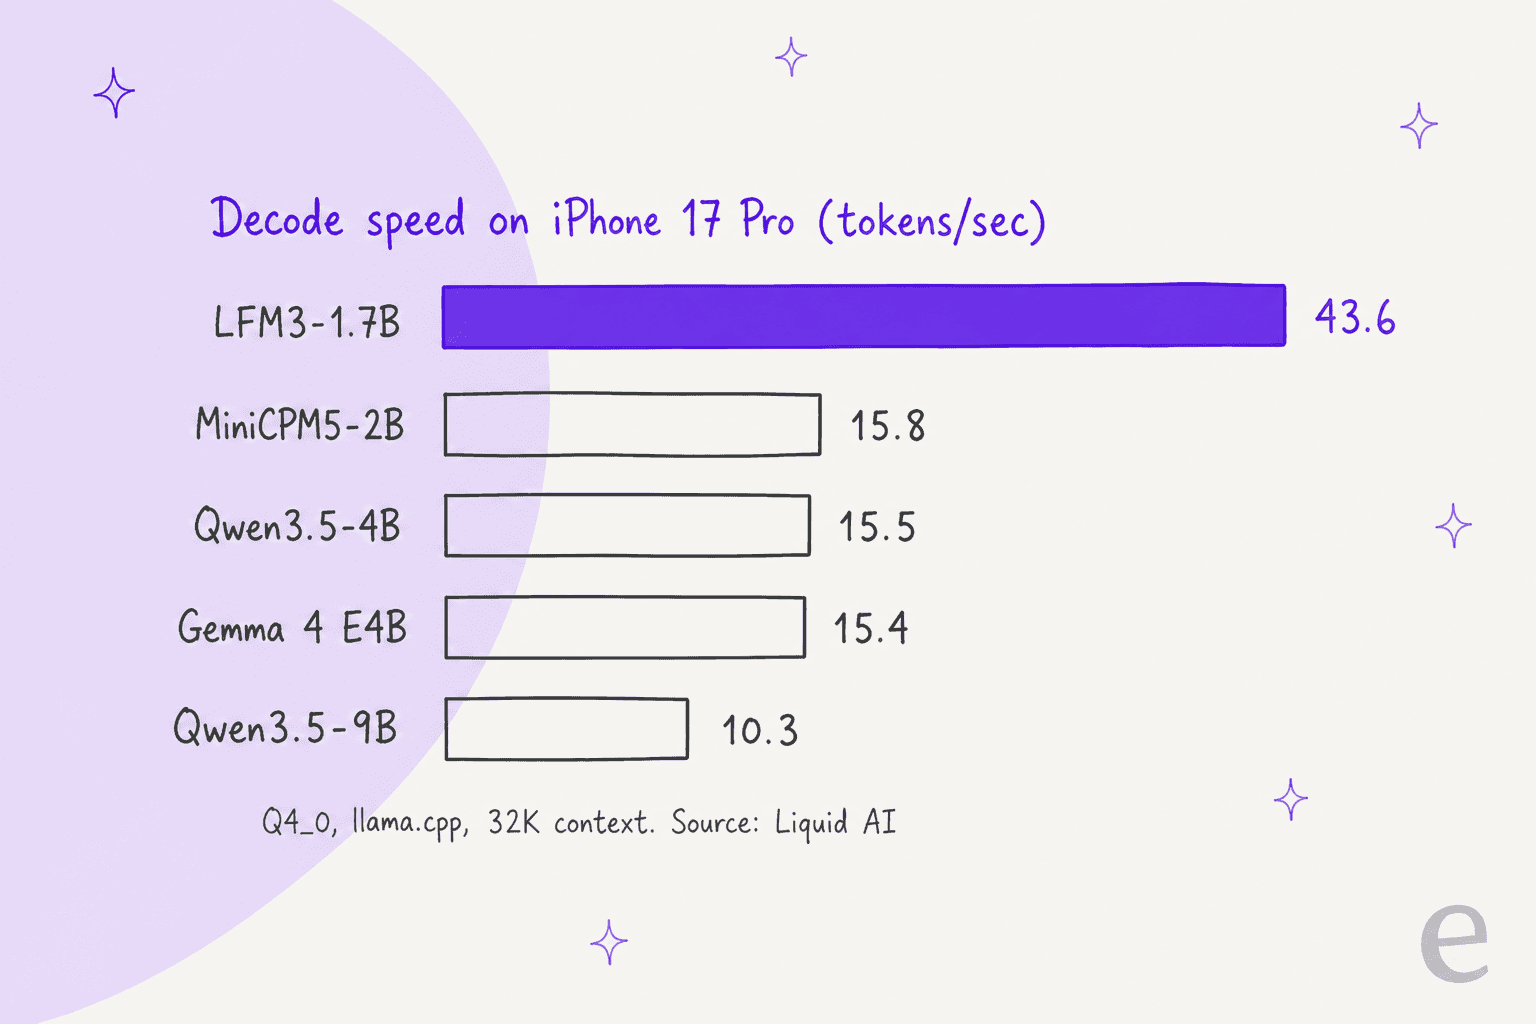
| Appareil | Décodage de LFM3-1.7B | Deuxième plus rapide | Mémoire de LFM3-1.7B |
|---|---|---|---|
| iPhone 17 Pro | 43.6 tok/s | 15.8 (MiniCPM5-2B) | 1.90 GB |
| Apple M5 Max | 237.1 tok/s | 106.0 (MiniCPM5-2B) | 2.25 GB |
| AMD Ryzen AI Max+ 395 | 129.6 tok/s | 70.1 (MiniCPM5-2B) | 2.75 GB |
Le contexte long reste lui aussi peu gourmand. Un contexte complet de 128K tokens nécessite 1.6 GB de cache KV, la mémoire qu'un modèle utilise pour conserver la conversation jusque-là, contre 4.3 GB pour Qwen3.5-4B et 5.6 GB pour MiniCPM5-2B. À titre de comparaison, un modèle dense de taille moyenne comme Nanbeige 4.3 a besoin d'environ 28 GB de cache pour la même longueur.
Sur les serveurs, les chiffres deviennent un peu fous. Sur un seul NVIDIA B300 avec 1 024 requêtes simultanées, LFM3-1.7B a produit 41,710 tokens de sortie par seconde, ce que Liquid arrondit à 3,6 milliards de tokens par jour. Pour en faire la démonstration, Liquid a exécuté plus de 300 000 agents LFM3-1.7B en parallèle sur les archives d'e-mails d'Enron. Sur sa propre infrastructure de service à faible latence, la latence p95 d'une requête courte est restée à 150 ms, même à 500 requêtes par seconde sur un seul B200.
Que peuvent faire les modèles de vision, d'audio et omni ?
C'est avec les autres modèles de la famille que LFM3 sort de l'ordinaire pour un lancement de modèles de 2B paramètres. Chacun est assez petit pour fonctionner sur un téléphone et couvre une tâche qui nécessite habituellement un modèle cloud plus grand.
LFM3-VL-2B est le premier modèle de vision de Liquid qui accepte la vidéo, et il raisonne étape par étape avant de répondre. Sur 62 benchmarks de vision, il obtient une moyenne de 71.4, devant Gemini 3.5 Flash Lite (70.0) et au niveau de Gemma 4 12B (71.7), un modèle plus de six fois plus grand. Il se situe à deux points de GPT-5.6 Luna (73.4). Il obtient ses meilleurs scores en lecture de documents, en OCR et en lecture de graphiques (83.9), ainsi qu'en compréhension des interfaces graphiques (83.1).
LFM3-Audio-2B transcrit, parle et traduit la parole, avec un nouvel encodeur audio en continu qui commence le traitement pendant que vous parlez encore. Liquid indique que le délai avant le premier token peut descendre à 50 ms.
LFM3-Omni-2B est le premier modèle de Liquid qui voit, écoute et parle à la fois : vous pouvez poser une question à l'oral sur une image et obtenir une réponse vocale, ou l'interroger sur une vidéo avec du son. Il peut aussi transformer directement une demande orale et le contenu de l'écran en un appel d'outil structuré. La démonstration de Liquid le montre en train de réserver un vol à la voix sur un ordinateur portable. Si vous comparez des outils vocaux pour une ligne de support, ma sélection des meilleurs agents vocaux IA couvre les solutions hébergées, et ce guide sur les agents vocaux IA pour le support explique leur mise en place.
À quoi servent les modèles de décision d1 ?
C'est la partie de LFM3 à laquelle je prêterais le plus d'attention si vous dirigez une équipe de support. d1-2B et d1-Omni-2B n'écrivent rien. Vous leur donnez une entrée et une liste de questions, et ils répondent à toutes en une seule passe d'inférence, chacune avec une probabilité calibrée. Liquid cite "a support ticket, an invoice, an app screen, a photo, a voice note" comme entrées typiques.
La fiche du modèle d1-2B utilise un ticket de support comme exemple principal : un client débité deux fois dont le colis n'est jamais arrivé. En une seule passe, le modèle choisit une équipe (facturation, livraison ou technique) et indique si un remboursement est dû, puis liste aussi les sujets et évalue l'urgence. Liquid annonce 5.7 ms par décision sur un H100. Cela correspond exactement au travail de triage des tickets, et c'est pourquoi je pense qu'il s'agit du modèle le plus pratique de cette version pour les équipes de support. J'ai présenté cette catégorie plus largement dans mon article explicatif sur les modèles de décision.
Les réponses typées sont une nouveauté de cette génération. En plus du oui/non, des choix multiples et des scores, les modèles d1 peuvent :
- Pointer : dessiner un cadre autour d'un élément que vous décrivez, ou en compter toutes les occurrences.
- Lire : extraire du texte, des nombres et des dates d'un document avec le passage exact, ou indiquer « non trouvé ».
- Estimer : donner un nombre avec une plage probable.
- Choisir : sélectionner toutes les options qui s'appliquent, chacune avec sa propre probabilité.
d1-2B remplace l'ancien d1-3B avec un tiers de paramètres en moins. Sur le test "Typed Decisions (customer service cases)" de Liquid, d1-Omni-2B a obtenu 50.5 avec une entrée écrite et 48.0 lorsque les mêmes questions étaient posées à l'oral, ainsi que 83.4 sur DecisionBench, un test de routage et de triage pour les entreprises. Ce sont les propres benchmarks de Liquid, considérez-les donc comme un point de départ pour vos propres tests. Si vous souhaitez d'abord la version manuelle du même travail, voici comment automatiser le triage des tickets avec des règles. Un ingénieur de Liquid a résumé clairement l'argument matériel dans le fil de discussion du lancement :
"If you want to do local classification/image processing, I think the d1-2B is amazing, it can run on 1GB of unified RAM."
La fiche est également honnête sur les limites : les questions qui demandent beaucoup de connaissances favorisent les modèles plus grands, et les réponses deviennent moins fiables au-delà d'environ 64K tokens en entrée.
Combien coûte LFM3 ?
Les poids sont gratuits pour la plupart des entreprises, et aucun tarif d'API n'a encore été publié. Voici ce qui figure sur la page des tarifs de Liquid et dans sa licence au 28 octobre 2026 :
| Option | Prix | Remarques |
|---|---|---|
| Poids ouverts, entreprise avec un chiffre d'affaires inférieur à 10 M$ | Gratuit | LFM Open License v1.0, basée sur Apache 2.0 |
| Poids ouverts, entreprise avec un chiffre d'affaires de 10+ M$ | Licence payante, sur devis uniquement | Contactez le service commercial de Liquid ; le chiffre d'affaires est calculé à l'échelle de l'ensemble du groupe |
| Recherche et organismes à but non lucratif éligibles | Gratuit | Aucune limite de chiffre d'affaires |
| Liquid API, modèles LFM3 | Non publié | Pas encore répertorié sur la page des tarifs |
| Liquid API, d1 | 0,02 $ par 1M de tokens en entrée, 0 $ en sortie | Ancien d1, pas le d1-2B basé sur LFM3 |
| Liquid API, LFM2.5-24B-A2B | 0,05 $ en entrée / 0,70 $ en sortie par 1M de tokens | Le plus grand modèle hébergé de Liquid |
| Nouveau compte Liquid Console | 2 $ de crédit gratuit | Par organisation |
Deux détails comptent plus que les prix. D'abord, le seuil de chiffre d'affaires de 10 M$ s'applique à l'ensemble de votre groupe, pas au produit, et le nombre d'utilisateurs n'a pas d'importance. Ensuite, la licence ne comporte pas de copyleft, vous pouvez donc garder une version affinée privée, à condition d'inclure une attribution et une copie de la licence lors de toute redistribution.
OpenRouter est cité comme partenaire dès le jour 0 du lancement, mais le 28 octobre, sa page Liquid ne répertoriait que les anciens modèles Liquid et d1.1, sans aucun modèle LFM3 pour le moment. Si vous souhaitez aujourd'hui un modèle hébergé avec une grille tarifaire publique, le point de comparaison est la tarification de GPT-6 Luna. Gemini 3.5 Flash Lite est l'autre option bon marché.
Comment exécuter LFM3 ?
Vous le téléchargez depuis Hugging Face et l'exécutez localement, ou vous l'essayez d'abord dans l'espace de test de Liquid sur navigateur. La collection LFM3 propose chaque modèle en BF16, GGUF, MLX 4 bits et ONNX, avec des versions FP8 et NVFP4 pour les serveurs.
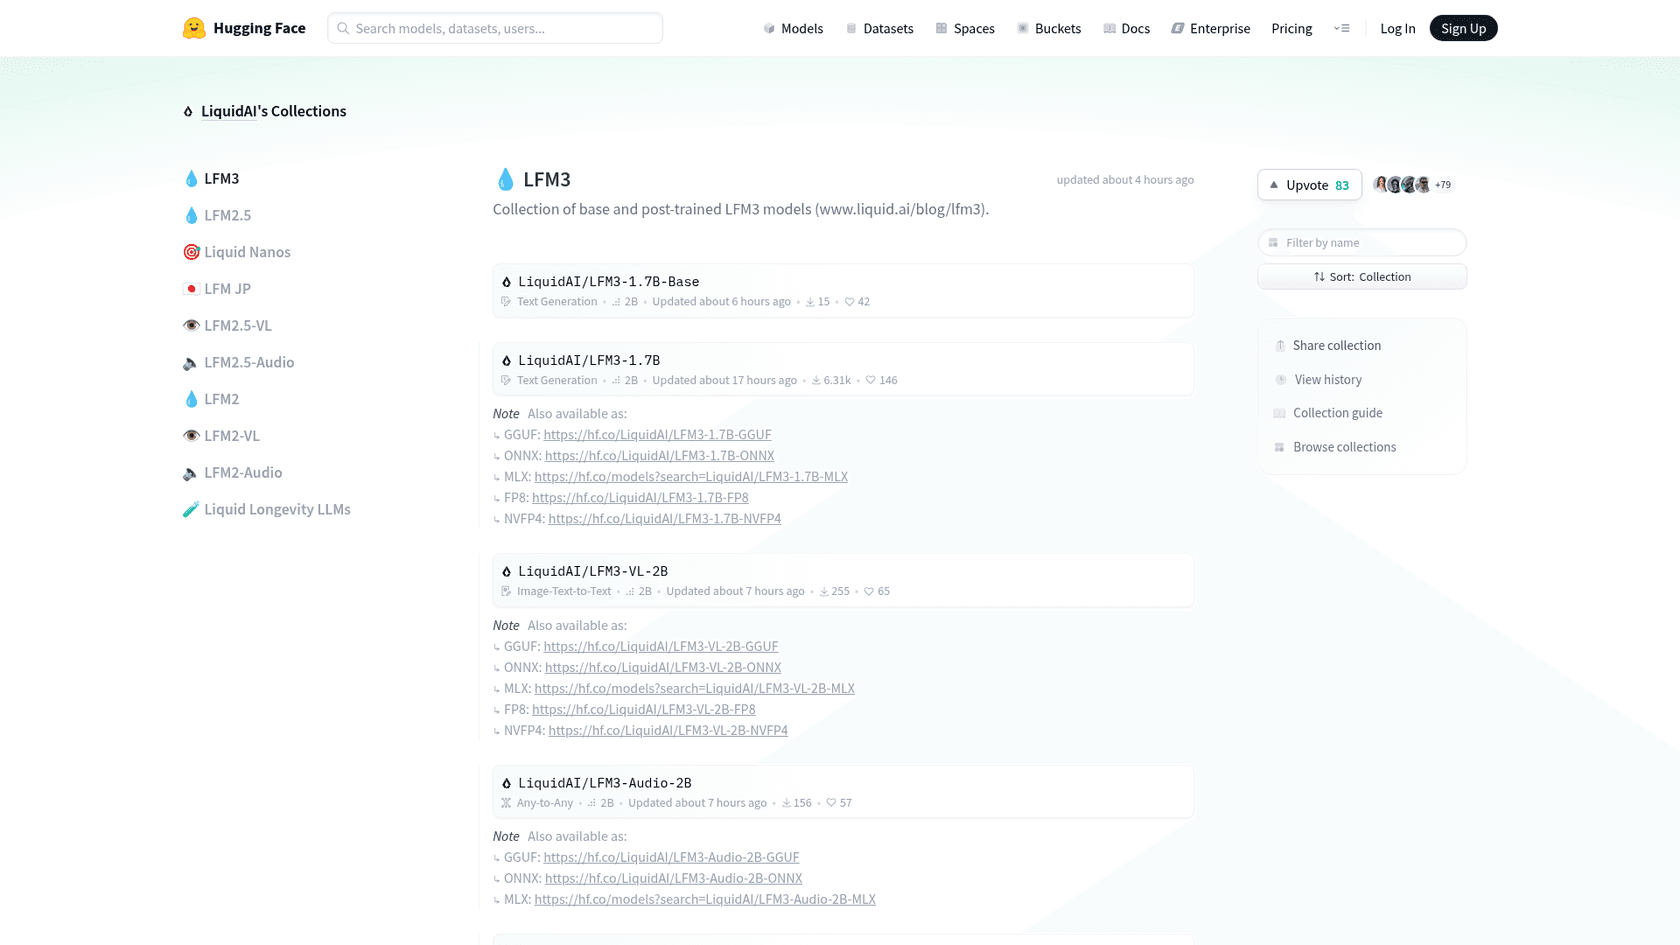
Le moyen le plus rapide en local est llama.cpp. La documentation de LFM3-1.7B fournit cette commande, avec les réglages recommandés par Liquid :
llama-cli -hf LiquidAI/LFM3-1.7B-GGUF --temp 0.1 --top-k 50 --repeat-penalty 1.1
Quelques points à connaître avant de commencer :
- Vous avez besoin d'une version récente. La fiche GGUF indique qu'il vous faut une version de llama.cpp compatible avec LFM3. Le fichier Q4_0 fait
1.05 GBet le Q8_0 fait1.85 GB. - vLLM et SGLang fonctionnent pour le déploiement en service. Les propres benchmarks GPU de Liquid utilisaient SGLang 0.5.22 avec la prise en charge de LFM3.
- Le raisonnement est activé par défaut. Le modèle de conversation ouvre un bloc
<think>, et la fiche avertit que sa désactivation peut donner des résultats irréguliers. - Les appels d'outils ont changé de format. LFM3 utilise un format XML qui est un sur-ensemble de celui de Qwen3-Coder, et non le format personnalisé de LFM2 ; les anciens analyseurs doivent donc être mis à jour.
- L'affinage est peu coûteux. Liquid propose des notebooks TRL pour SFT, DPO et GRPO sur LFM3-1.7B. Sa démonstration d'inspection d'éoliennes a affiné LFM3-VL-2B sur environ 3 000 photos en quelques heures sur un seul A100. (Pour le contenu de support, la question la plus courante est RAG ou affinage.)
Si vous préférez essayer avant de télécharger, le Liquid Playground propose LFM3-1.7B, LFM3-VL-2B, LFM3 Omni 2B et LFM3 Audio 2B dans un sélecteur de modèles.
Que disent les premiers utilisateurs de LFM3 ?
Il n'a qu'un jour, les retours d'expérience sont donc peu nombreux et proviennent surtout du fil de lancement sur Hacker News, qui a atteint 101 points et 36 commentaires. Ces premières observations permettent utilement de confronter le tableau des benchmarks à la réalité.
Un lecteur a relevé une erreur factuelle élémentaire dans l'espace de test et l'a attribuée à la quantification :
"when asked “what does a cow say?”, LFM3-1.7B said that a cow can say “Oink”... I assume this is lower quant problem, though: Q8 versions I’ve played with through llama both give the correct “moo” answer."
Un autre a constaté que l'entraînement intensif à l'utilisation d'outils se manifestait là où personne ne l'avait demandé, sur une question de culture générale sans prompt système :
"I am seeing the following in the reasoning trace: > However, the instructions say I must use available tools when answering questions."
Les outils du premier jour avaient aussi quelques ratés. Un lecteur n'arrivait pas à charger les versions MLX dans LM Studio ni dans deux autres moteurs d'exécution MLX. Le commentaire le plus pertinent pour le support venait d'une personne utilisant la génération précédente pour trier les messages entrants :
"The LFM annotations are basically triage... Right now LFM 2.6 gets trustworthy annotations on just over 40% of data points."
C'est une image réaliste d'un petit modèle en production : il traite les cas faciles, et un modèle plus grand ou une personne s'occupe du reste. C'est la même répartition que j'utiliserais pour la classification des tickets par l'IA.
Quelles sont les limites de LFM3 ?
Les limites reconnues se trouvent surtout dans les propres mentions détaillées de Liquid :
- Pas pour le développement agentique ni le raisonnement difficile. La fiche de LFM3-1.7B indique qu'il est "not recommended for agentic coding or complex multi-step reasoning," et suggère la récupération d'informations ou la recherche pour les tâches exigeant beaucoup de connaissances. La fiche du modèle de vision ajoute les conversations à plusieurs tours à cette liste.
- Tous les chiffres sont communiqués par le fournisseur. Artificial Analysis n'avait pas répertorié LFM3 au 28 octobre, il n'y a donc pas encore de score indépendant.
- La licence n'est pas Apache 2.0. Elle s'en rapproche, mais le seuil de chiffre d'affaires de 10 M$ signifie que les plus grandes entreprises ont besoin d'un accord payant avant de le commercialiser.
- Un contexte court sur les modèles vocaux. LFM3-Audio-2B et LFM3-Omni-2B ont des fenêtres de 32K tokens, soit un huitième de celle du modèle textuel.
- Les outils sont encore en train de s'adapter. La fiche du modèle de vision indique que la prise en charge de llama.cpp est en cours de validation, sans vidéo, et que celle de vLLM est en cours de développement.
Devriez-vous utiliser LFM3 ?
Cela dépend de ce que vous construisez :
- Assistants sur appareil et agents locaux : oui, essayez d'abord LFM3-1.7B. Aucun autre modèle comparé par Liquid ne fonctionne aussi vite avec si peu de mémoire, et il a été entraîné dans de véritables environnements d'exécution d'agents. Il a sa place dans toute liste d'agents IA open source à tester.
- Classification, routage et extraction à grande échelle : regardez d1-2B. Une passe, de nombreuses questions, quelques millisecondes par décision et environ 1 GB de RAM. Il convient naturellement au routage des tickets et à leur étiquetage.
- Applications vocales et avec caméra : LFM3-Omni-2B est l'un des rares petits modèles qui entend et parle. Attention au contexte de 32K.
- Agents de développement : non. Liquid le dit lui-même, et des modèles comme Nanbeige 4.3 ou le duo Nemotron 3.5 Bolt sont de meilleurs points de départ.
- Un agent de support client : LFM3 est un moteur solide pour certaines parties du travail, notamment le triage, mais ce n'est pas un agent à lui seul. La section suivante explique ce qui manque.
Faire fonctionner de petits modèles sur une vraie file de tickets de support
Un modèle comme d1-2B peut vous dire qu'un ticket concerne la facturation et qu'il est urgent. Pour aider concrètement, il faut encore un système intégré à votre outil de support, capable de lire le ticket à son arrivée, de chercher des informations dans votre centre d'aide et vos anciens tickets, d'appliquer l'étiquette, de rédiger le brouillon de réponse et de savoir quels tickets une personne doit prendre en charge. C'est le travail pour lequel le coéquipier IA pour le support d'eesel est conçu, l'un de ces coéquipiers IA prêts à travailler que vous recrutez pour un rôle précis, plutôt qu'un modèle que vous devez intégrer vous-même.

Dokument 24, une entreprise danoise de documents juridiques en ligne, est un bon exemple de triage en pratique. Entre le 8 août et le 8 septembre 2026, eesel a préparé environ 680 tickets Zendesk, en a étiqueté environ 430 par produit (testament, contrat prénuptial, mandat de protection future ou création d'entreprise) et a laissé environ 670 brouillons de réponses en danois sous forme de notes internes à envoyer par l'équipe. Il répond à partir d'environ 2 600 pages web et éléments Zendesk. Qontro, un éditeur de logiciels ERP à Auckland, génère un brouillon pour chaque ticket Freshdesk, mais les pannes, les pertes de données, les migrations et la facturation sont directement confiées à une personne. Ces règles de routage sont la partie qu'un benchmark ne teste jamais, et c'est aussi ce qui détermine le véritable coût par ticket.
Avant la mise en production, eesel teste votre configuration sur vos anciens tickets pour que vous puissiez voir ses réponses avant qu'un client ne les voie. J'ai expliqué séparément comment ces tests fonctionnent. Et si vous aimez travailler depuis un terminal comme vous le feriez avec un modèle local, l'eesel CLI vous permet, à vous, à un script ou à un agent de développement comme Claude Code, de connecter des intégrations, de modifier les instructions permanentes de l'agent, d'approuver ou de refuser ses actions en attente et de lire son journal d'activité, le tout en JSON.
Essayez eesel
LFM3 est un moteur rapide et peu coûteux pour les agents sur appareil et les décisions en une seule passe, comme le routage d'un ticket. Si vous avez besoin que vos tickets soient étiquetés, orientés et accompagnés de brouillons de réponse dans votre configuration Zendesk AI ou Freshdesk dès cette semaine, le coéquipier IA pour le support d'eesel rejoint votre outil de support en quelques minutes, apprend à partir de vos anciens tickets et de votre centre d'aide, et travaille dans le cadre des règles que vous définissez. Vous pouvez commencer gratuitement avec 100 crédits et sans carte bancaire, pour le tester sur de vrais tickets avant de vous décider. Essayez eesel.
Questions fréquentes
Qu'est-ce que LFM3 ?
LFM3 est la troisième génération des Liquid Foundation Models de Liquid AI, sortie le 27 octobre 2026. Cette première version comprend six modèles à poids ouverts d'environ 2B paramètres chacun, tous construits sur un même socle appelé LFM3-1.7B-Base : un modèle de texte, un modèle de vision, un modèle audio, un modèle omni et deux modèles de décision. Ils appartiennent à la même catégorie de petits modèles de langage que MiniCPM5 2B et les petites versions de Gemma 4.
LFM3 est-il gratuit ?
Les poids sont téléchargeables gratuitement sur Hugging Face sous la LFM Open License v1.0, qui repose sur Apache 2.0. L'utilisation commerciale n'est gratuite que tant que le chiffre d'affaires annuel de votre groupe d'entreprises reste inférieur à 10 $ millions ; au-delà, vous devez obtenir une licence payante auprès de Liquid AI. La recherche et les usages à but non lucratif éligibles ne sont soumis à aucune limite de revenus. À comparer avec des modèles entièrement sous Apache 2.0 comme Nanbeige 4.3.
Combien coûte l'API LFM3 ?
Liquid AI n'a pas encore publié de tarif par token pour les modèles LFM3. Sa page de tarifs ne répertorie que d1 (0,02 $ par million de tokens en entrée, 0 $ en sortie), d1-ultra (0,042 $ / 0 $) et LFM2.5-24B-A2B (0,05 $ / 0,70 $), et les nouvelles organisations reçoivent 2 $ de crédit gratuit. LFM3 n'est pas non plus disponible sur OpenRouter pour le moment. Pour en savoir plus sur les tarifs des modèles hébergés, consultez les tarifs de GPT-6 Luna.
De combien de mémoire LFM3-1.7B a-t-il besoin ?
D'environ 1 Go en 4 bits. Le fichier GGUF Q4_0 fait 1.05 Go et le Q8_0 fait 1.85 Go. Lors des tests de Liquid AI, il utilisait 1.90 Go sur un iPhone 17 Pro avec un contexte de 32K, et un contexte complet de 128K nécessite 1.6 Go de cache KV, contre 4.3 Go pour Qwen3.5-4B. C'est pourquoi il fait partie des rares petits modèles qui fonctionnent sur un téléphone avec un contexte long.
LFM3-1.7B est-il meilleur que Qwen3.5 ?
Dans le propre tableau de Liquid AI, LFM3-1.7B obtient une moyenne de 49.37 sur 29 benchmarks, contre 47.24 pour Qwen3.5-9B, un modèle environ cinq fois plus grand. Il l'emporte nettement sur l'automatisation des tâches métier et les tâches dans le navigateur (AutomationBench : 41.29 contre 15.10), mais perd sur le code et les connaissances (GPQA Diamond : 63.37 contre 80.40). Ces chiffres proviennent du fournisseur, pas de tests indépendants. Consultez la présentation de Qwen pour découvrir l'autre côté de la comparaison.
Peut-on utiliser LFM3 pour trier les tickets du support client ?
Le modèle de décision d1-2B est le plus adapté. Sa fiche montre comment il oriente un ticket vers la facturation, l'expédition ou le support technique, signale les remboursements et évalue l'urgence en un seul passage. Vous devrez tout de même le connecter à votre outil de support et le tester sur vos propres tickets. Pour des solutions prêtes à l'emploi, consultez les meilleures IA pour le tri des tickets de support.
Que sont les modèles de décision LFM3 d1 ?
d1-2B et d1-Omni-2B sont des modèles qui ne rédigent pas de texte. Vous leur fournissez une entrée, comme un ticket, une facture, une photo ou une note vocale, ainsi qu'une liste de questions, et ils répondent à toutes en un seul passage, avec une probabilité pour chaque réponse. d1-2B traite le texte et les images, tandis que d1-Omni-2B ajoute l'audio. Pour en savoir plus, consultez notre article sur les modèles de décision.