

En bref
Strands Decider 2B est un modèle de décision de 1,9B gratuit et ouvert, issu d'AWS Strands Labs et publié le 1er octobre 2026. Vous lui donnez un texte et des questions typées (« quelle équipe ? », « est-ce urgent ? ») et il renvoie une étiquette avec un score de confiance en une seule passe. Il obtient 0,762 sur JevBench, près du sommet de sa classe de taille, et tourne en environ 115 ms sur un GPU de joueur.
Ce que la plupart des articles sur le lancement passent sous silence : les poids sont la partie la moins intéressante de la boîte. Il n'y a pas d'API hébergée, le serveur local n'a pas d'authentification, et sur un serveur CPU ordinaire une question prend environ 1,6 seconde, pas 115 ms. Ce qu'AWS a réellement publié, c'est un kit ouvert, avec les données d'entraînement, la recette et un journal de recherche, de sorte que vous pouvez le réentraîner sur vos propres questions en environ 11 heures sur une seule RTX 3090.
Pour les équipes de support, trier le ticket est la moitié facile. Lors d'un essai eesel sur du trafic réel, le tri par IA a atteint 93% de précision, alors que seulement 12% des réponses rédigées sont parties sans modification. Si vous voulez que le tri, le routage et la réponse soient traités ensemble dans Zendesk ou Freshdesk, le coéquipier IA de helpdesk d'eesel s'en charge sans que vous ayez à héberger un modèle.
Qu'est-ce que Strands Decider ?
Strands Decider 2B est un petit modèle de décision de Strands Labs, la branche expérimentale du projet open source Strands Agents d'AWS. L'article de lancement cite Marc Brooker, Mike Chambers et Fabio Nonato de Paula comme auteurs, et tout est publié sous licence Apache-2.0.
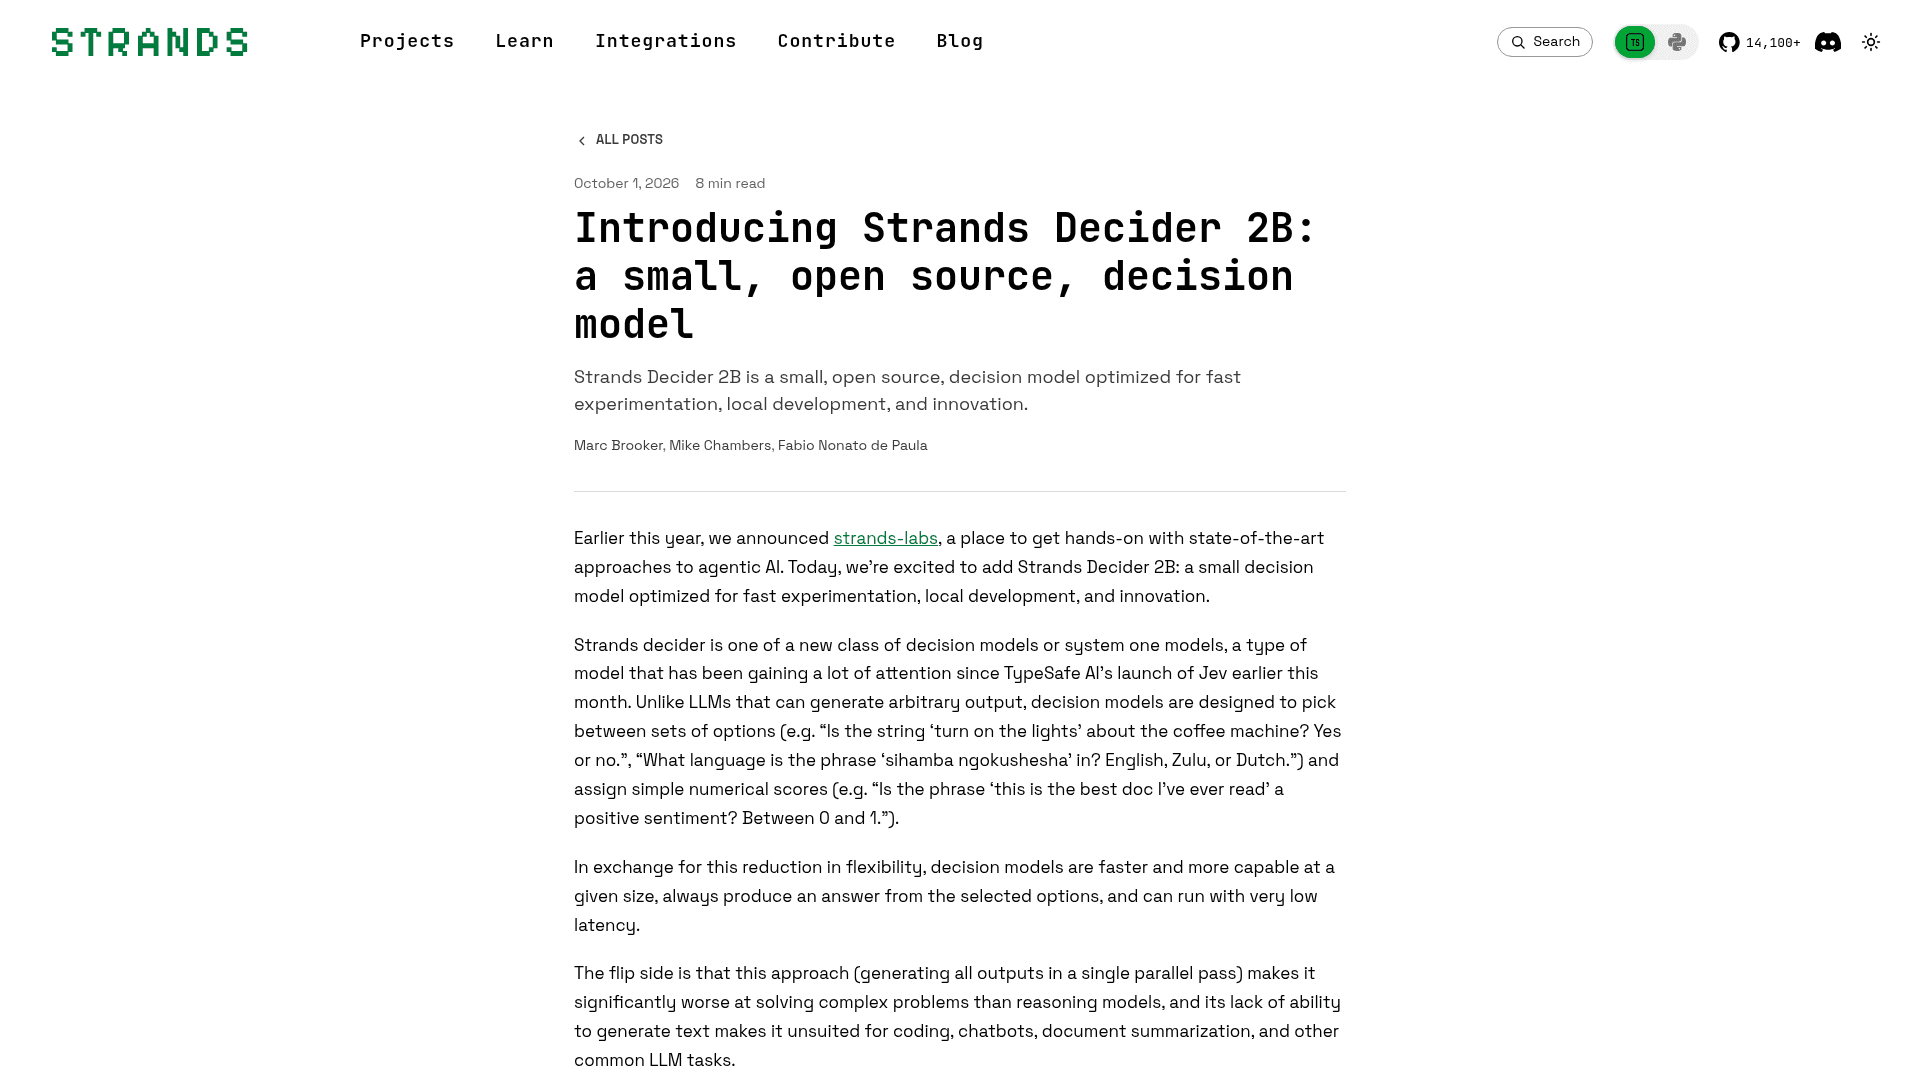
Un modèle de décision n'écrit pas de texte. Voyez-le comme un petit modèle de langage dont on a retiré la parole. Il répond aux questions que vous définissez, parmi les options que vous définissez, et donne une probabilité pour chacune. La catégorie a pris son essor après le lancement de TypeSafe Jev en septembre, et l'équipe Strands le dit sans détour : c'est "a type of model that has been gaining a lot of attention since TypeSafe AI's launch of Jev."
Je construis les intégrations d'eesel et la surface de l'API de helpdesk, et l'appel de tri (quelle équipe, quelle urgence, est-ce du spam) est l'étape que j'ai branchée dans plus de helpdesks que toute autre. J'ai donc lu cette publication comme je lirais une pièce que je pourrais intégrer à un pipeline : ce qu'elle renvoie, à quelle vitesse, où elle casse et ce qu'il me reste à construire.
Voici la fiche technique résumée :
| Caractéristique | Strands Decider 2B |
|---|---|
| Publication | 1er octobre 2026 |
| Paramètres | 1,9 milliard |
| Modèle de base | Qwen3.5-2B-Base, LoRA de rang 16 + tête de pointeurs |
| Modèle de référence actuel | strands-decider-2B-hobson-v21 (v19 reste publié) |
| Types de questions | noul (oui/non), choice (un parmi N), score (échelle ordonnée) |
| Sortie | Une réponse par question, avec une probabilité calibrée |
| Contexte | 4 096 tokens par défaut |
| Licence | Apache-2.0 (poids, code, données, recette) |
| Option hébergée | Aucune |
| Matériel | CUDA, Apple MPS ou MLX, CPU |
Chaque ligne provient du README GitHub du projet et de sa fiche de modèle Hugging Face.
Comment fonctionne Strands Decider ?
L'astuce est la soustraction. Strands prend un modèle de langage normal, garde son « torse » (les couches qui comprennent le texte) et jette la tête qui générerait normalement des mots. À sa place se trouve une minuscule tête de pointeurs, d'un peu plus d'un million de paramètres, qui note chaque option de réponse. Le README résume : "One forward pass, no generation, no decoding loop."
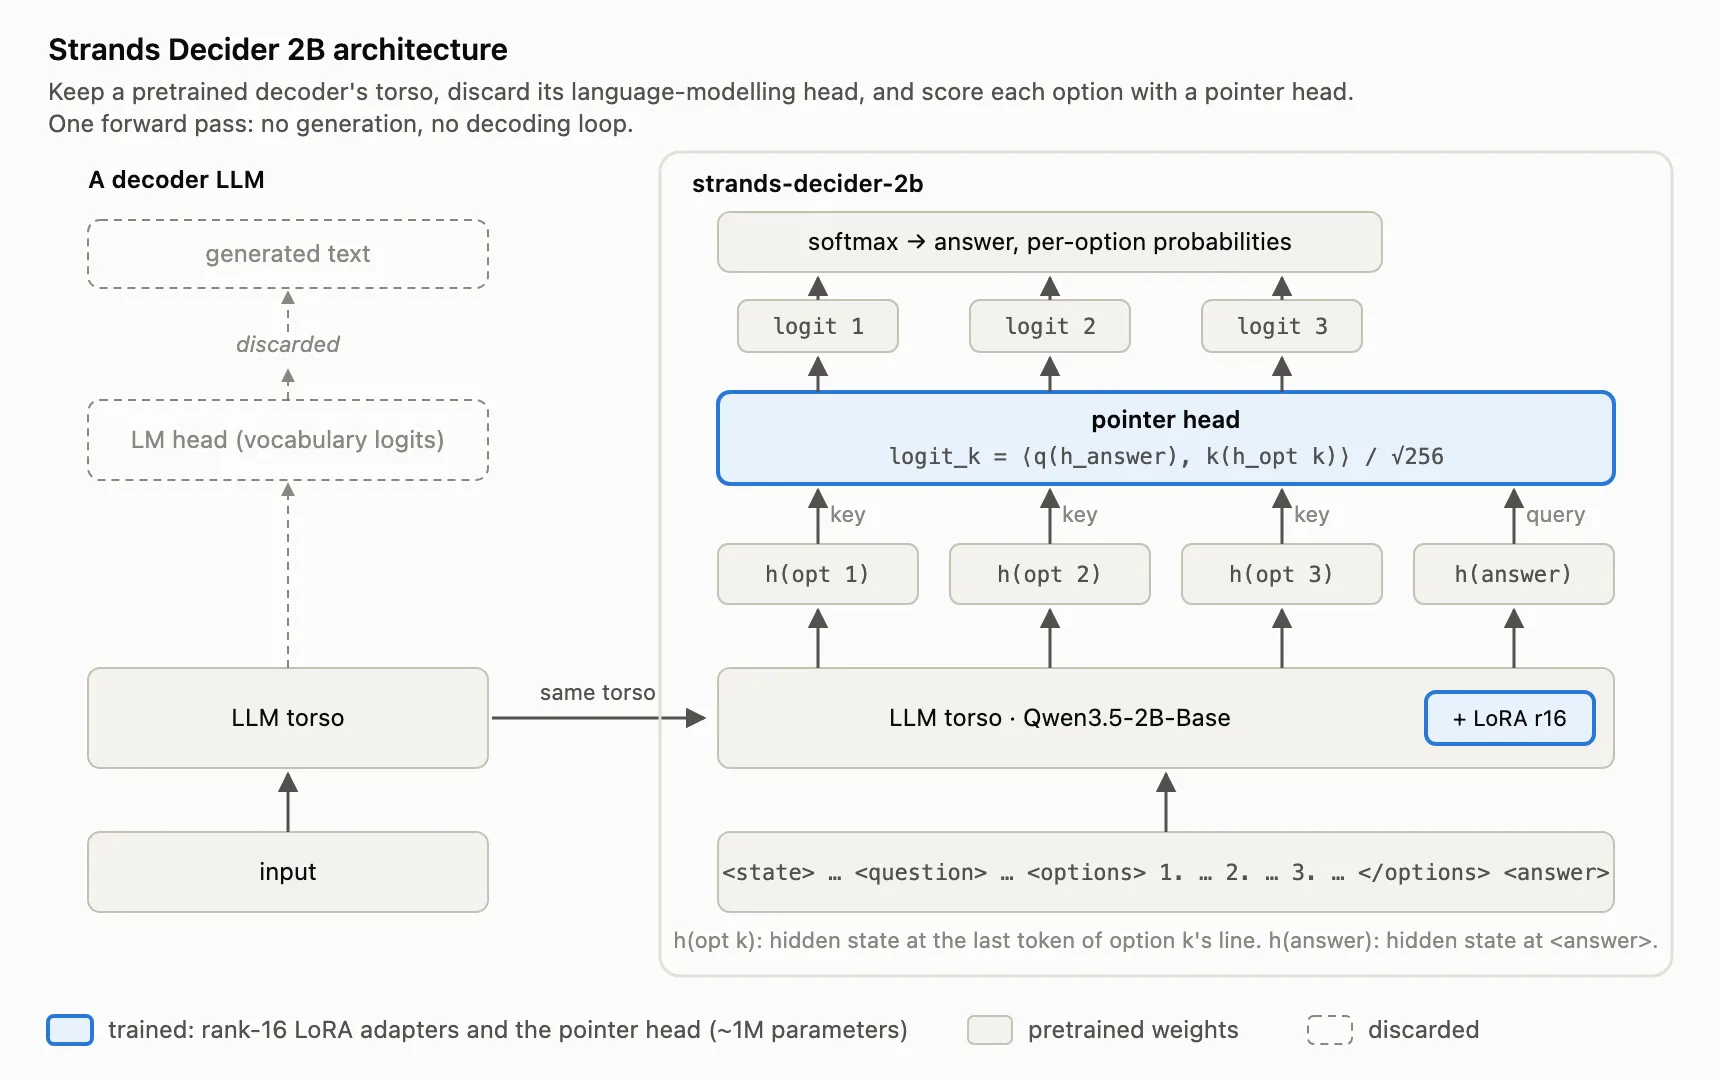
Comme il ne génère jamais, il ne peut pas sortir du format. Si vous demandez l'un de billing, sales ou retail, vous obtenez l'un de ces trois, à chaque fois. C'est la même promesse que l'appel de fonctions sur un grand LLM (ou le mode JSON, son cousin plus lâche), mais moins cher, car il n'y a ni boucle token par token ni JSON à analyser.
Cela signifie aussi que chaque question supplémentaire coûte très peu. Le modèle lit votre texte une fois, et "each question adds only its own tokens." Poser « quelle équipe ? », « est-ce urgent ? » et « à quel point l'auteur est-il frustré ? » en un seul appel coûte donc presque autant qu'en poser une.
La démo de la fiche Hugging Face est un ticket de support, ce qui dit exactement qui AWS pense être l'acheteur :
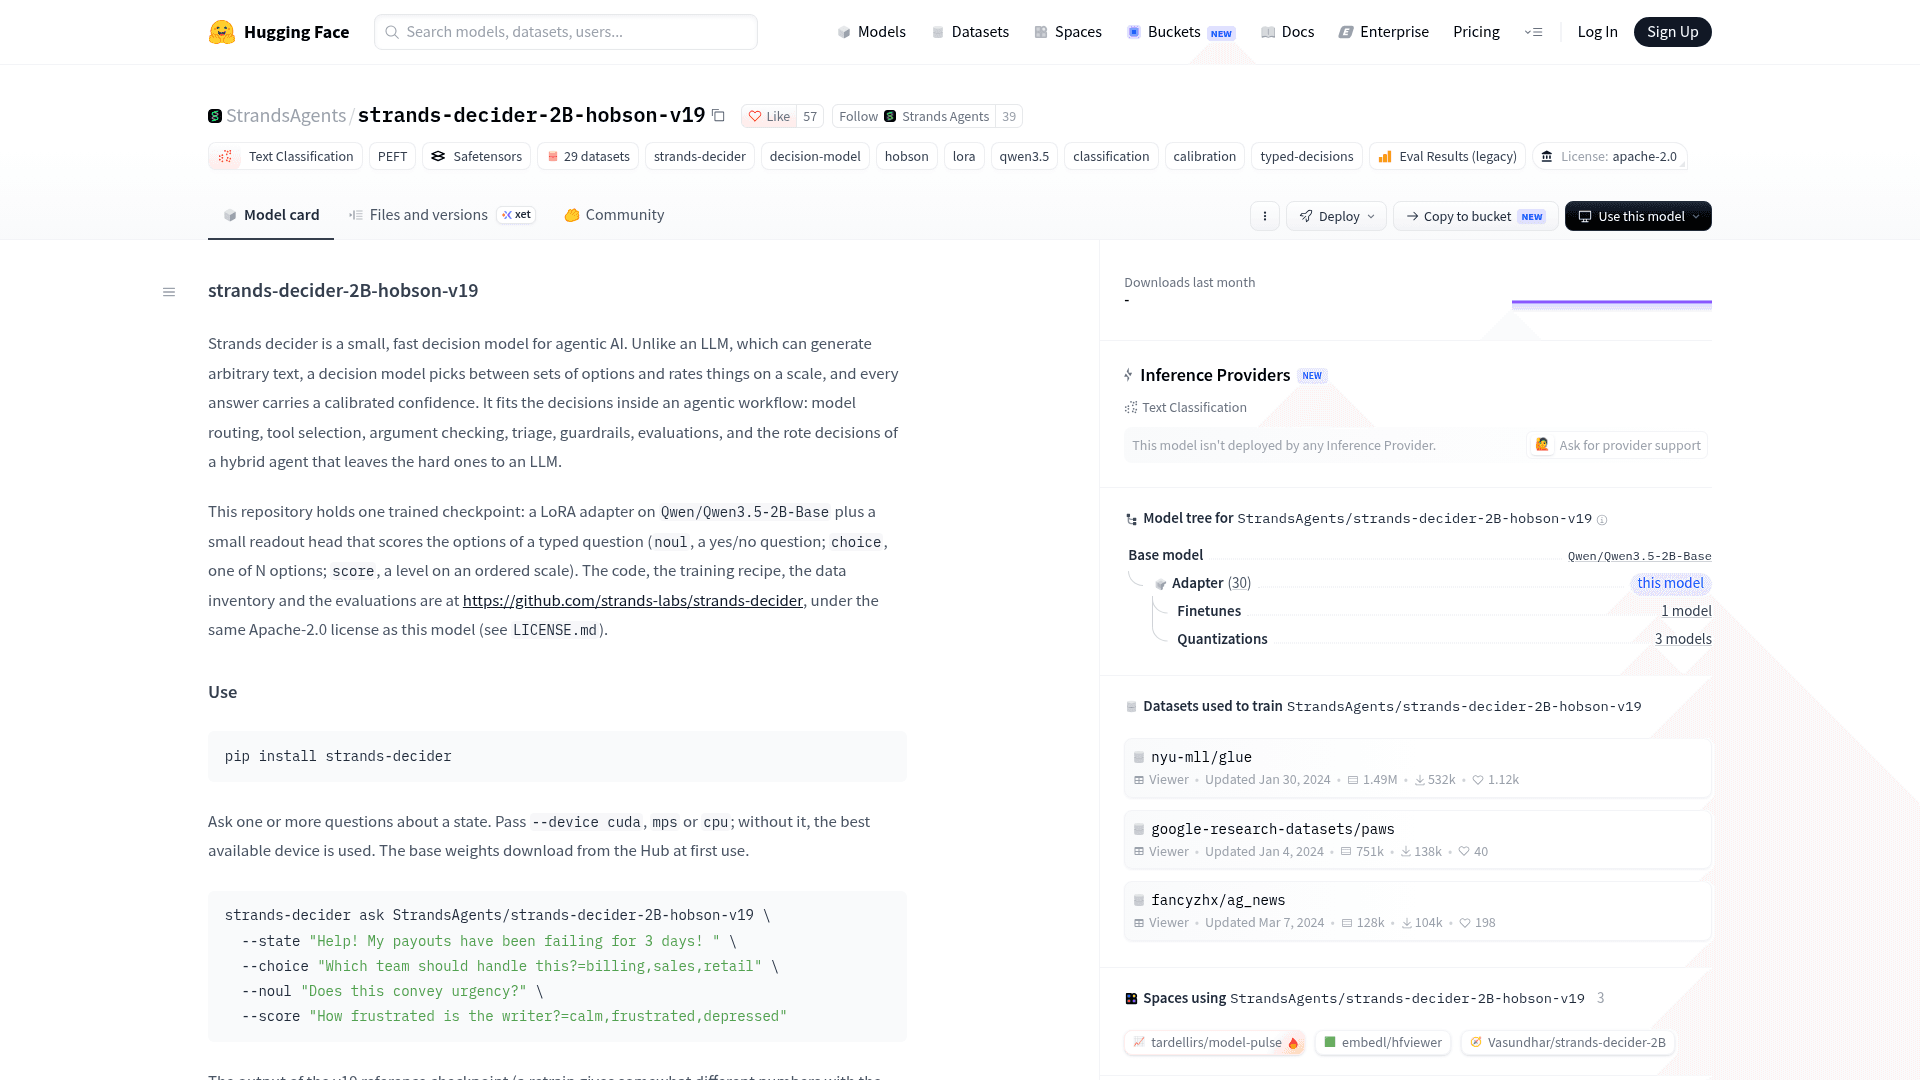
Pour l'exécuter comme un service, vous lancez le serveur fourni et lui envoyez des requêtes :
pip install strands-decider
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --port 8000
Les poids sont téléchargés depuis Hugging Face à la première utilisation. Ensuite, un POST /v1/systemone avec un objet state et un objet questions vous renvoie les réponses par question, l'usage de tokens (output_tokens: 1) et latency_ms. Une chose à savoir avant de vous enthousiasmer à l'idée de remplacer Jev : la documentation dit que l'adaptateur de JevBench fonctionne sans modification sur ce point d'accès, puis ajoute : "Compatibility with the Jev API itself is not verified" (docs/inference.md).
Le fournisseur est aussi franc sur les limites. L'article de lancement dit que la conception en une passe le rend "significantly worse at solving complex problems than reasoning models", et qu'il est "unsuited for coding, chatbots, document summarization." La fiche du modèle ajoute que les documents longs et à étapes multiples sont son point faible.
Quelle est la précision de Strands Decider ?
Sur l'ensemble public de JevBench (231 tâches), les chiffres du dépôt sont les suivants :
| Mesure | v21 (référence) | v19 (lancement) |
|---|---|---|
| Précision | 0.762 (176/231) | 0.723 (167/231) |
| Score de Brier (plus bas est mieux) | 0.323 | 0.342 |
| Erreur de calibration (ECE) | 0.064 | 0.052 |
| Niveaux facile / standard / difficile | 1.000 / 0.931 / 0.550 | 1.000 / 0.875 / 0.505 |
La phrase que je respecte le plus dans toute la publication est celle où l'équipe minimise sa propre mise à niveau. Sur six entraînements chacune, les recettes de v19 et v21 atteignent en moyenne "172.8 and 172.3 JevBench tasks: the same accuracy." Le chiffre plus élevé de v21 relève surtout de la chance de la graine aléatoire, et ils le disent. Cette honnêteté vaut plus que les quatre points supplémentaires.
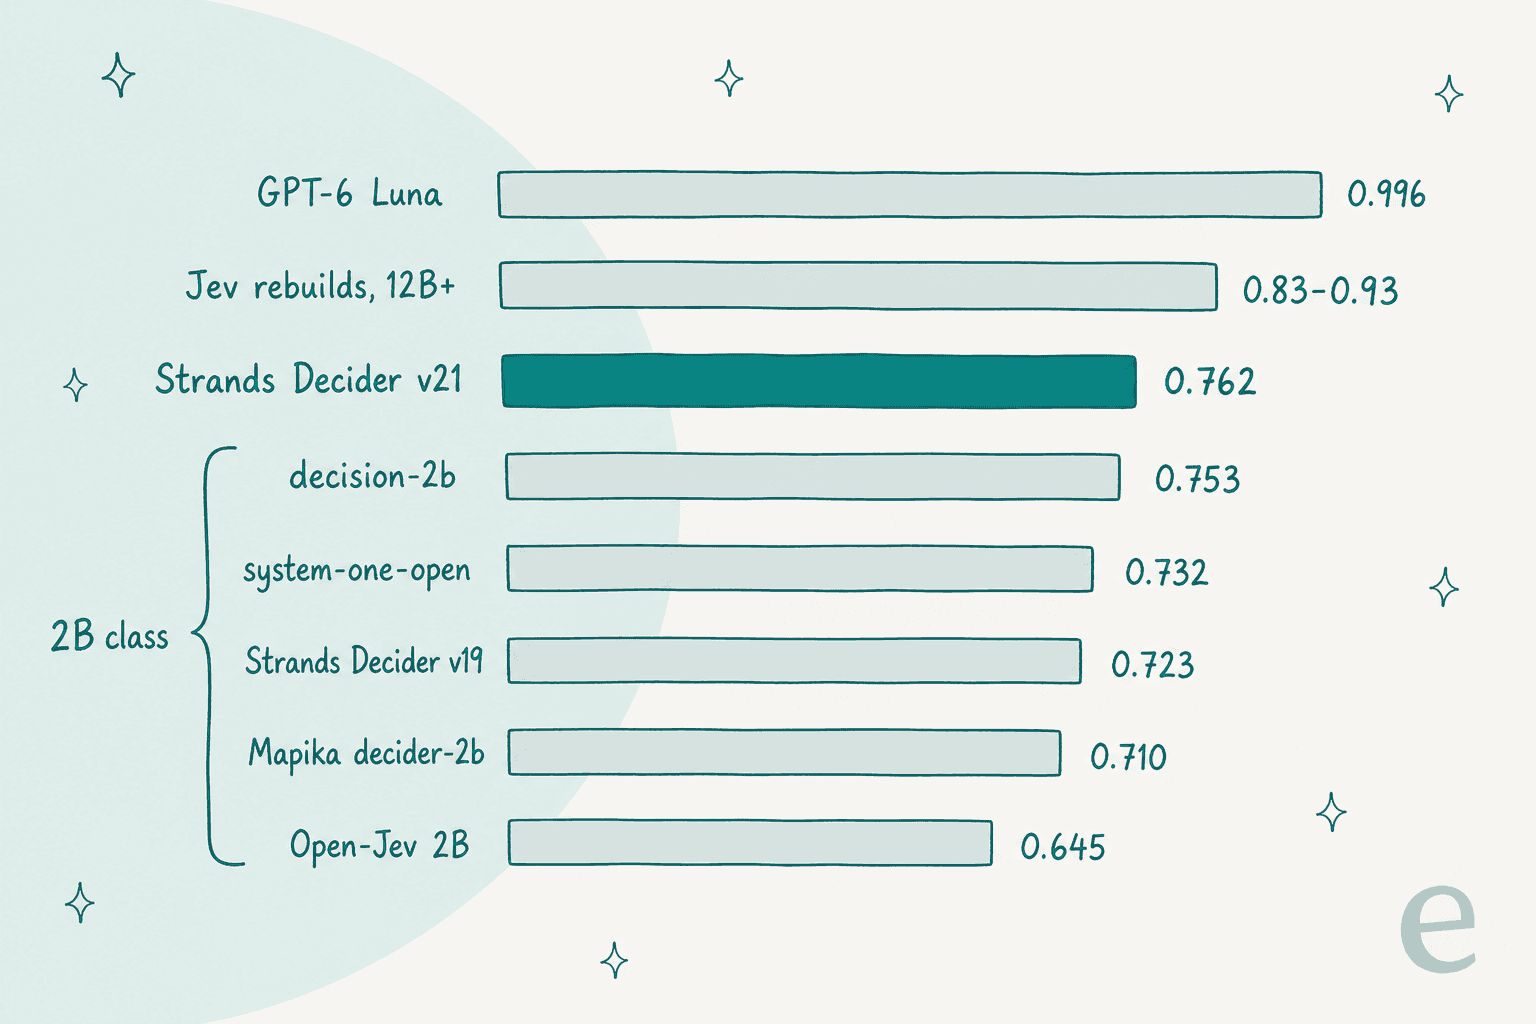
Où cela le place-t-il au classement ? Sur le classement JevBench v1.4.2 (89 systèmes, 25 septembre), v19 était 50e au général et 3e sur 33 dans la classe 2B, derrière decision-2b de FlyMy.AI (0,753) et system-one-open, basé sur Gemma (0,732), d'après les notes d'évaluation. Le haut du tableau appartient aux modèles de raisonnement, avec GPT-6 Luna à 0,996, puis les reconstructions de Jev sur des torses de 12B et plus, de 0,83 à 0,93. Si vous voulez voir tout le champ côte à côte, le panorama des alternatives à Jev les classe.
Le cadrage honnête, donc : Strands Decider est un bon petit modèle, pas un bon modèle tout court. Il échange environ 23 points de précision par rapport à un LLM de pointe contre de la vitesse, un prix bas et la possibilité de tourner sur votre propre machine.
Une remarque si vous regardez le graphique de l'historique d'entraînement dans l'article de lancement : il étiquette deux points de comparaison "strands-decider-2b v10/v11". Marc Brooker l'a corrigé sur Hacker News : il s'agit d'un autre modèle appelé "decider-2B", "which isn't ours."
Les scores de confiance veulent-ils dire quelque chose ?
La calibration est tout l'argument de vente. Un score de confiance n'est utile que s'il est honnête : une étiquette ne sert à automatiser que si l'on peut dire « agir au-dessus de 0,9, confier à un humain en dessous ». Le dépôt affirme que, sur des tâches de classification courtes jamais vues, "answers at a confidence of 0.9 or more are right about 95% of the time."
C'est encourageant, avec deux réserves que la fiche du modèle soulève elle-même : les bandes de confiance n'ont été établies que sur de la classification courte, donc "measure on your own traffic before you trust a threshold", et le modèle lit les questions moins attentivement que les documents, si bien qu'une question reformulée obtient souvent la même réponse. Les premiers utilisateurs en ont trouvé une troisième :
"From what i can tell from my (limited) experiments, there is a lot of variation caused by simply reordering options, plus a heavy bias toward the first option listed"

La parade est banale et elle marche : mélangez l'ordre des options dans vos tests, et évaluez le modèle sur quelques centaines de vos propres tickets étiquetés avant de croire le moindre chiffre. Brooker lui-même a suggéré sur HN qu'à 2B on peut l'affiner sur ses questions, ou simplement le recalibrer sans affinage.
Quelle est sa vitesse sur du matériel réel ?
Le chiffre phare de l'article de lancement est une médiane de 115 ms sur une RTX 3090. Il est réel, et c'est un chiffre de GPU. Voici le tableau plus large, avec tous les chiffres tirés du dépôt, de ses pull requests ou de Hacker News :
| Matériel | Latence par question | Source |
|---|---|---|
| RTX 3090 (GPU) | médiane 115 ms, p95 299 ms | README |
| M3 Pro (Apple silicon) | médiane à chaud 153 ms sous 300 tokens, 234 ms sur toutes les tâches | README |
| M4 Pro (CPU seul) | 0,3 à 0,5 s une fois chargé | PR #46 |
| Xeon 8375C, 8 threads | environ 1,6 s en entrée courte, 16 à 18 s vers 3 000 tokens | docs/inference.md |
| Graviton 4, bf16 (PR non fusionnée) | 1,15 s | PR #48 |
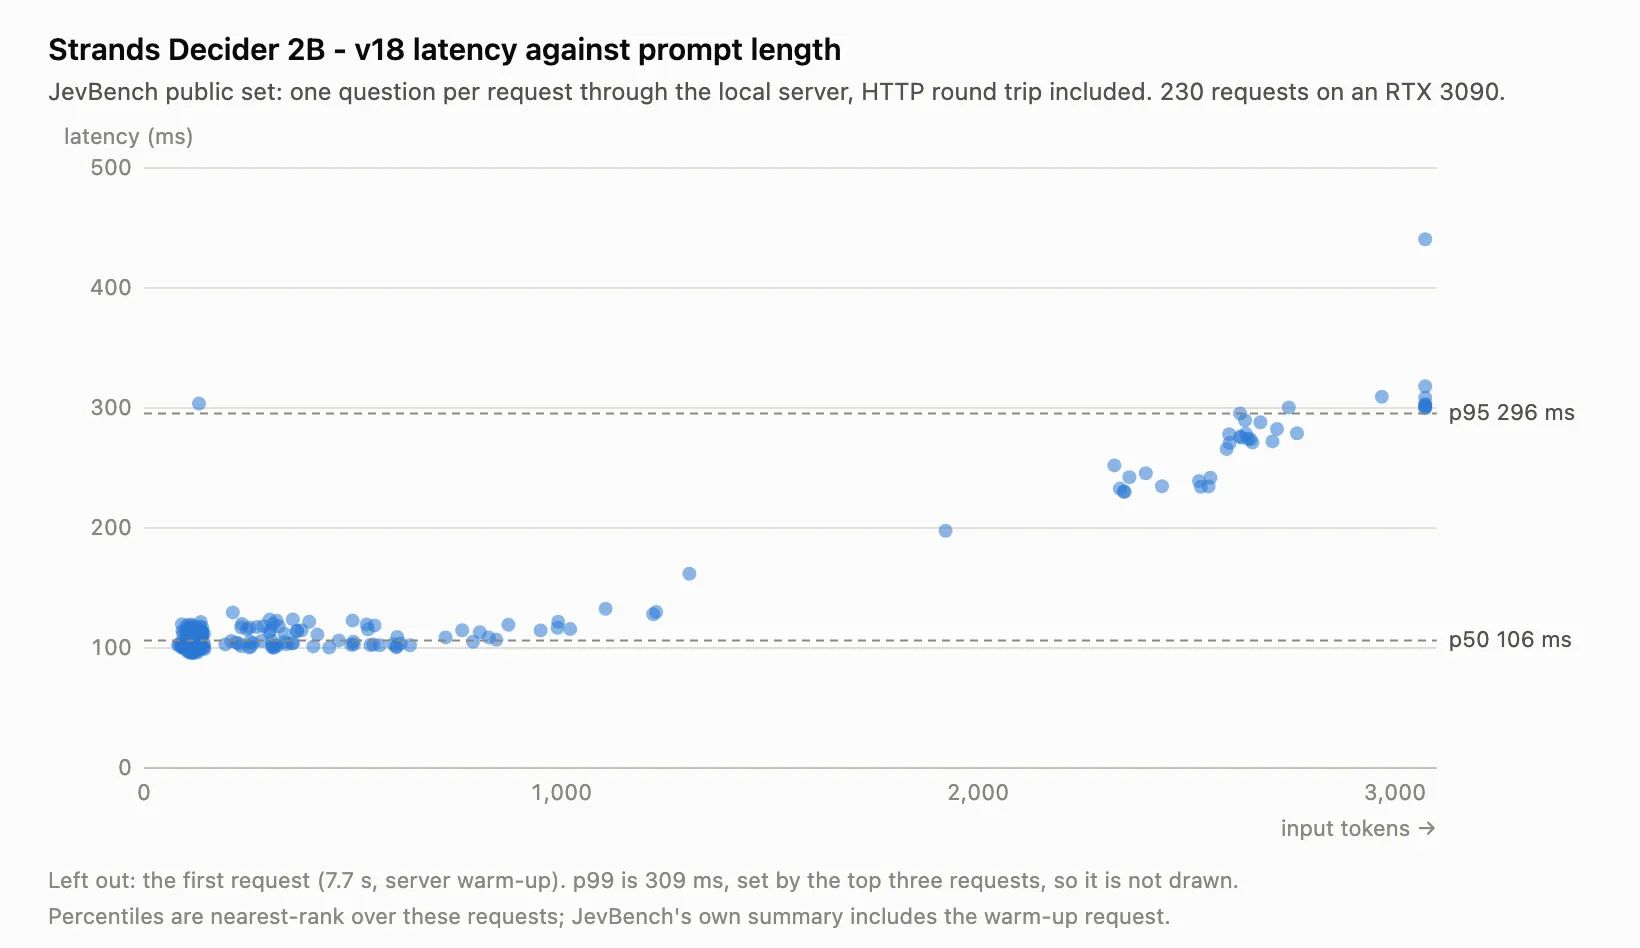
Le schéma compte plus que n'importe quel chiffre isolé. La latence croît à peu près avec la longueur de l'entrée, donc un long fil d'e-mails coûte bien plus qu'un message de chat d'une ligne. Et sur le type de machine CPU que la plupart des équipes lancent par défaut, une décision prend des secondes. Un utilisateur de HN a vu environ une demi-seconde sur six cœurs ; un autre a mesuré 1 732 ms dans un conteneur Docker uniquement CPU. Si la décision se place devant un client qui attend une réponse de chat, ou dans une étape de routage intelligent, il vous faut un GPU ou Apple silicon.
Combien coûte Strands Decider ?
Le modèle est gratuit. Pas son exécution, et il n'y a personne d'autre que vous pour la payer.
- Pas de point d'accès hébergé. La page Hugging Face dit "This model isn't deployed by any Inference Provider", et il n'y a pas de fiche Bedrock. Bedrock n'apparaît dans l'article de lancement que comme LLM de l'exemple d'agent.
- Pas d'authentification. Le serveur local se lie à
127.0.0.1et, selon la fiche, "has no authentication: use it for local experiments." Le placer derrière un répartiteur de charge, avec authentification et supervision, c'est à vous de le faire, les mêmes corvées que celles abordées dans les alternatives à Strands harness pour l'hébergement d'agents. - Pas encore de build llama.cpp officiel. Brooker l'a expliqué sur HN : on ne peut pas convertir seulement le LoRA, car "there's a whole pointer head and some custom layers." Un port GGUF communautaire existe, tout comme un port ONNX, mais les deux sont non officiels.
Voici comment il se situe face aux deux options hébergées auxquelles la plupart des équipes le comparent :
| Strands Decider 2B | TypeSafe Jev | Cloudflare Clef | |
|---|---|---|---|
| Poids | Ouverts, Apache-2.0 | Fermés | Ouverts, Apache-2.0 |
| Taille | 1,9B | Non communiquée | 27B (Clef-flash 9B) |
| API hébergée | Aucune | Oui, dont Workers AI | Workers AI |
| Prix | Gratuit, plus votre matériel | $0.042 par 1M de tokens en entrée, sortie gratuite | $0.24 par 1M en entrée (flash $0.09) |
| Contexte | 4 096 par défaut | 32 000 | 64K hébergé |
| L'affiner soi-même | Oui, recette complète | Non | Réglage par RL via l'équipe Cloudflare |
| Analyse détaillée | Cet article | Test de Jev | Clef expliqué |
Le tarif de Jev vient de sa fiche Workers AI, et celui de Clef de la page de modèle de Cloudflare. Le calcul complet se trouve dans le détail des tarifs de Clef.
Au tarif de Jev, un million de décisions de 500 tokens coûtent environ $21 en tokens d'entrée. C'est la barre qu'un GPU auto-hébergé doit franchir une fois ajoutées les heures d'ingénieur pour le maintenir. Pour la plupart des équipes, ce ne sera pas le cas (le même calcul que pour tout modèle auto-hébergé, voir les tarifs de Qwen), jusqu'à ce que le volume soit très élevé ou que les données ne puissent pas quitter votre réseau. Ce dernier cas, les données réglementées, est celui où Strands Decider se justifie le plus facilement.
Qu'est-ce qu'AWS a réellement publié ?
C'est ici que Strands Decider se distingue de Jev, et c'est la partie vers laquelle j'orienterais un développeur. L'article de lancement dit que la publication inclut "all the training data and scripts we used to build the model."
- Les données d'entraînement. Des jeux de données Hugging Face, ContractNLI et MuSiQue, des lignes synthétiques vérifiées par des modèles à poids ouverts, et les distributions de sortie d'un enseignant Qwen3.5-4B figé. Chaque source et sa licence sont listées dans data/sources.md.
- La recette. Un script,
training/recipe.sh all. Un réentraînement prend environ11 heures sur une RTX 3090ou environ1 h 10 min sur huit H100. - Un journal de recherche préenregistré. Chaque entraînement énonce ses prédictions et ses conditions d'échec avant de tourner. J'ai rarement vu une publication de modèle le faire, et c'est la raison pour laquelle je crois à l'aveu « v21 revient au même que v19 ».
Cela fait de Strands Decider moins un concurrent de Jev qu'un kit pour construire votre propre classificateur de tri. Si vos catégories sont spécifiques (vos gammes de produits, vos règles de remboursement, vos niveaux d'escalade), réentraîner sur quelques milliers de vos propres lignes étiquetées de classification de tickets est la voie que les auteurs eux-mêmes indiquent. Si l'affinage est nouveau pour vous, la recette est l'un des endroits les plus propres pour l'apprendre.
Le dépôt évolue vite, lui aussi. Des pull requests fusionnées les 7 et 8 octobre ajoutent la prise en charge des torses Gemma 4 (E2B, E4B, 12B et 26B-A4B) et une commande soup qui moyenne plusieurs entraînements en un seul checkpoint. Les PR citent cinq checkpoints à venir, et Brooker a écrit sur HN que "we've got some new ones coming this week." Aucun n'a encore de chiffres de benchmark publiés, j'attendrais donc avant de planifier autour d'eux.
Que disent les développeurs de Strands Decider ?
Le fil de lancement sur Hacker News a dépassé 270 points en une journée. Le ton est plus chaleureux que pour les fils sur Jev, surtout parce que les poids sont ouverts. Le retour positif le plus net vient de quelqu'un qui l'exécute sur l'appareil :
"This is a great model. I've been running it on device in chrome extension to filter things like email. It is just the right mix of size, capability and speed to make it generally useful for adhoc bulk classification tasks."
Le coauteur Marc Brooker a décrit où il voit cela aller, un modèle mental utile pour quiconque construit des agents :
"There are a ton a ways to use models like this. Model routing is a popular emerging one. The one that really interests me is hybrid agentic workflows - filling the gap between deterministic workflows (e.g. AWS StepFunctions) and fully agentic workflows that use frontier intelligence."
Les réserves sont justes et précises. Un fil a soutenu qu'une bonne calibration sur benchmark "does not establish reliability on unfamiliar production inputs" (soltanov). Un autre commentateur a noté que Clef de Cloudflare tourne sur llama.cpp, alors que Strands exige pour l'instant son propre CLI et son propre serveur :
"clef from cloudflare runs on llama.cpp - being locked-in to strands cli would be a bummer and will slow down adoption."
Cela correspond à ma lecture. Le modèle est bon pour sa taille, l'outillage est jeune, et ceux qui en tirent parti aujourd'hui sont des développeurs à l'aise pour héberger leur propre inférence.
Où Strands Decider s'insère-t-il dans une file de support ?
L'usage évident est le tri des tickets : quelle équipe, quel degré d'urgence, est-ce du spam. C'est de la classification d'intention classique, et les modèles de décision conviennent bien à cet appel. C'est là que je fixerais prudemment les attentes.
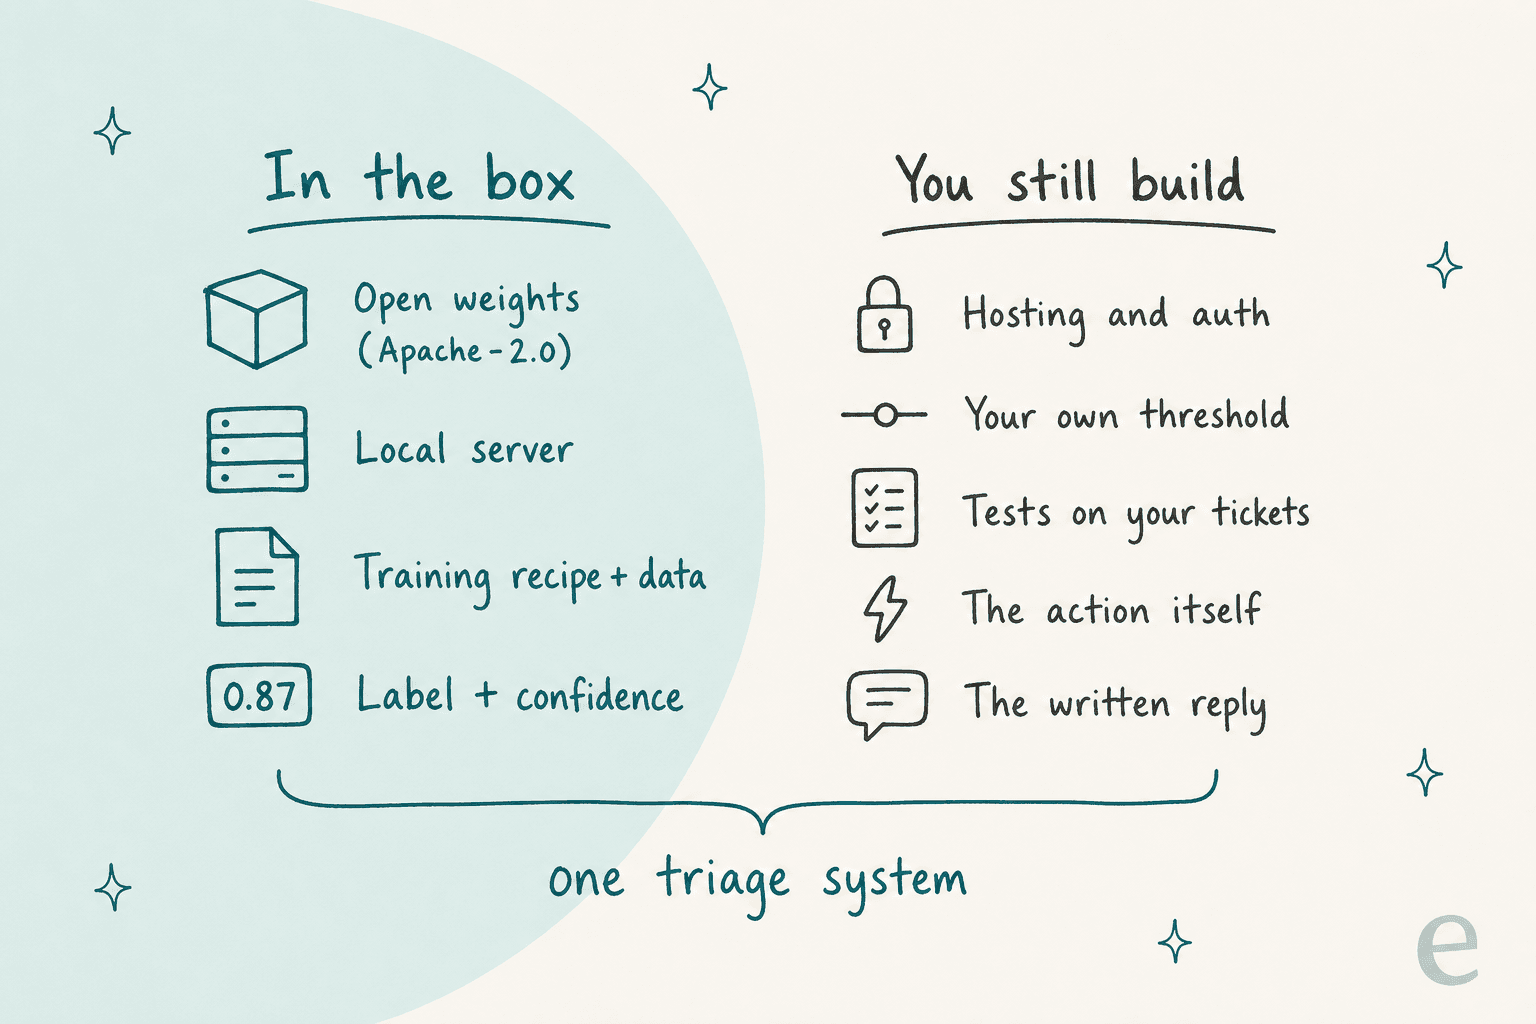
Une étiquette n'est qu'une fraction d'un système de tri. Quelqu'un doit encore héberger le modèle, choisir un seuil, le tester sur de vrais tickets, puis réellement étiqueter, assigner ou escalader le ticket dans Zendesk ou Freshdesk. Et après tout cela, le client a toujours besoin d'une réponse.
Voici à quoi cela ressemble quand le seuil de confiance fait son travail :
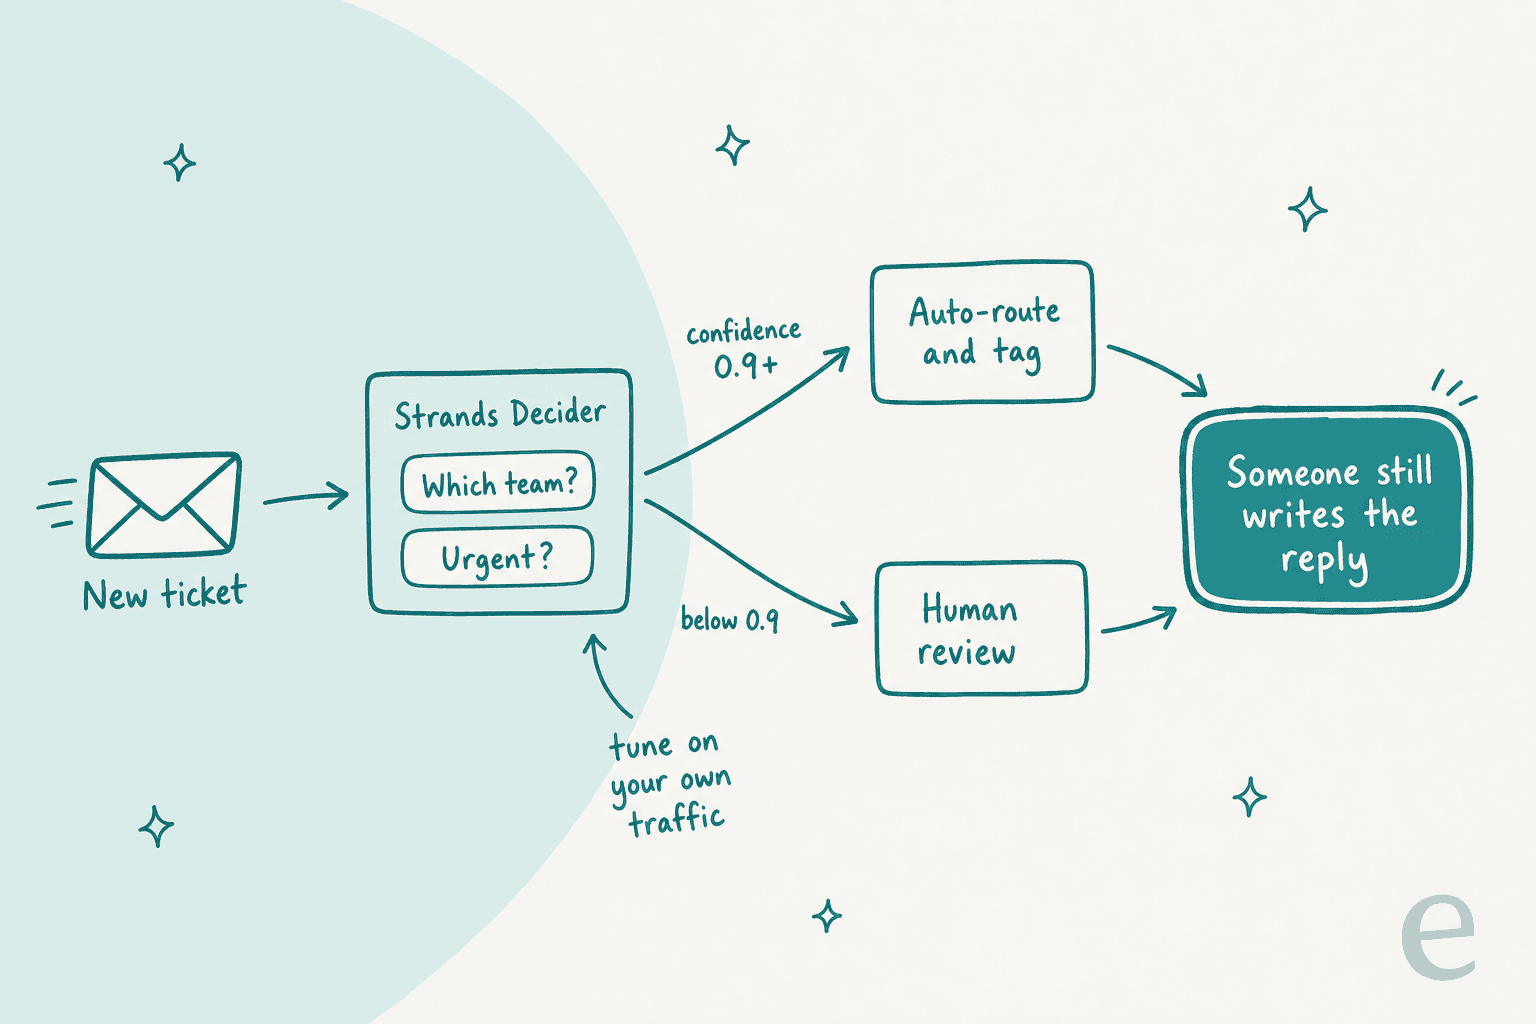
Cette dernière case est celle que les équipes sous-estiment. Lors d'un essai eesel recoupé sur une vraie boîte de réception Zendesk d'e-commerce, le tri par IA a atteint 93% de précision et détecté 100% du spam (environ 22% de la boîte), mais seulement 12% des réponses rédigées ont été envoyées telles quelles. Le tri est la moitié facile ; la réponse est là où se trouve le travail.
Ce que demandent les acheteurs est exactement ce que promet un modèle de décision calibré. Un responsable CX gérant environ 7 000 tickets par mois l'a formulé ainsi lors d'un appel commercial eesel :
"I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Voici ma recommandation selon la situation :
- Vous êtes développeur et construisez un agent ou un pipeline sur mesure, vos données ne peuvent pas quitter votre réseau et vous avez un GPU : Strands Decider est une excellente base. Réentraînez-le sur vos propres étiquettes.
- Vous voulez un appel de décision sans aucun hébergement : commencez plutôt par Jev. Clef et la Decisions API d'OpenAI sont les autres options hébergées.
- Vous dirigez une équipe de support et voulez des tickets triés et traités : vous n'avez pas du tout besoin d'un modèle de décision. Il vous faut quelque chose qui prend la décision et agit dessus dans votre helpdesk. Le panorama des outils de tri par IA couvre cette voie, et l'entrée du glossaire sur le tri automatique explique les termes.
eesel pour le tri, le routage et la réponse
Si le travail que vous imaginez pour Strands Decider est « trier ma file de support », le coéquipier IA de helpdesk d'eesel fait ce travail de bout en bout. Il se branche sur Zendesk, Freshdesk ou Gorgias en quelques minutes (l'intégration Zendesk est la configuration la plus courante), apprend de vos anciens tickets et de votre centre d'aide, puis étiquette, route, escalade et rédige la réponse.

La même répartition sur laquelle repose Strands Decider, un modèle léger pour la décision rapide et un plus lourd pour la partie difficile, est déjà un réglage. Chaque automatisation eesel a une option "Model strength" : le modèle habituel pour la rédaction et le travail à étapes multiples, ou un plus léger pour des tâches comme l'étiquetage ou le routage de tickets. Les événements qui ne correspondent pas à vos instructions sont ignorés et consignés avec un motif, ce qui correspond au comportement "leave them alone" que demandait ce responsable CX. Chaque action peut être réglée sur Auto, Needs approval ou Disabled dans actions et approbations, de sorte que les remboursements peuvent rester derrière un clic humain pendant que l'étiquetage tourne seul.
Si vous auriez choisi Strands Decider parce que vous aimez travailler dans un terminal, la CLI eesel vous donne le même coéquipier en ligne de commande. npx @eesel/cli fonctionne sans compte (un espace de travail temporaire avec $5 d'usage), chaque commande affiche du JSON, et les erreurs reviennent sous la forme d'une ligne JSON avec un indicateur retryable, de sorte que Claude Code, Cursor ou Codex peuvent piloter toute la configuration. Un développeur ou un agent de code peut câbler une tâche de tri avec eesel automations enable <platform> <key> --instructions "...", vérifier un changement au préalable avec --dry-run et débloquer les actions en attente avec eesel approvals approve <id>. C'est le même agent que dans le tableau de bord, et les changements se synchronisent dans les deux sens. Plus de détails dans mon tour d'horizon des CLI d'agents.
Avant que quoi que ce soit ne passe en production, la compétence de simulation fait tourner l'agent sur vos vrais tickets passés et note chaque réponse, de sorte que vous voyez la précision sur votre propre trafic plutôt que sur un benchmark. L'offre gratuite inclut 100 crédits sans carte, et les offres payantes commencent à $299 par mois pour 500 tickets ou chats selon les tarifs eesel, sans frais par siège.
Essayez eesel sur une partie de votre file et voyez combien de tickets il trierait, et traiterait, cette semaine.
Questions fréquentes
Qu'est-ce que Strands Decider ?
Strands Decider 2B est un modèle de décision open source publié par l'équipe Strands Labs d'AWS le 1er octobre 2026. Il lit un texte ainsi que des questions typées (oui/non, choix unique ou note sur une échelle) et renvoie chaque réponse avec un score de confiance en une seule passe avant, au lieu de générer du texte. Il est conçu pour des tâches comme le tri des tickets, le routage et les garde-fous.
Strands Decider est-il gratuit ?
Oui. Les poids, le code, les données d'entraînement et la recette sont tous publiés sous licence Apache-2.0, donc le télécharger ne coûte rien. Vous payez le matériel sur lequel vous l'exécutez, car il n'existe aucun point d'accès hébergé sur Bedrock ni chez un fournisseur d'inférence Hugging Face. Comparez avec les tarifs de Jev ou les tarifs de Clef, qui sont hébergés et facturés au token.
Quelle est la précision de Strands Decider 2B ?
Le modèle de référence v21 obtient 0,762 sur l'ensemble public de JevBench (176 tâches sur 231), et v19 obtient 0,723. Cela le place près du sommet de la classe des 2B, mais les LLM de raisonnement comme GPT-6 Luna obtiennent encore 0,996 sur les mêmes tâches. Le dépôt lui-même indique que v21 et v19 ont la même précision une fois moyennées sur six entraînements.
Strands Decider peut-il tourner sur un CPU ?
Oui, mais comptez en secondes, pas en millisecondes. Le dépôt mesure environ 1,6 seconde par question sur un Xeon à 8 threads pour une entrée courte, et de 16 à 18 secondes autour de 3 000 tokens. Sur un GPU RTX 3090, la médiane est de 115 ms. Pour une étape de routage en direct, prévoyez un GPU ou Apple silicon.
Strands Decider ou Jev : lequel choisir ?
Choisissez Strands Decider si vous avez besoin de poids ouverts, d'auto-hébergement ou de la possibilité de l'affiner sur vos propres questions. Choisissez TypeSafe Jev si vous voulez une API hébergée sans serveurs à gérer et un contexte de 32 000 tokens. Le panorama des alternatives à Jev couvre le reste du marché.
Puis-je utiliser Strands Decider pour le tri des tickets de support ?
Oui. L'exemple de la fiche Hugging Face route une plainte sur des versements vers la facturation, les ventes ou le commerce de détail, et signale l'urgence. Il reste à l'héberger, à régler un seuil de confiance sur vos propres tickets et à construire l'étape qui étiquette, route ou répond. Un coéquipier IA de helpdesk comme eesel gère toute cette boucle dans votre helpdesk.
Existe-t-il une API Strands Decider sur AWS Bedrock ?
Pas au 8 octobre 2026. Le seul serveur est local (strands-decider serve), lié à 127.0.0.1 et sans authentification. Bedrock n'apparaît dans l'article de lancement que comme LLM de l'exemple d'agent. Si vous voulez une API de décision hébergée, regardez la Decisions API d'OpenAI, Jev ou Clef.