Qu'est-ce que PostHog Jeeves ?
Jeeves est un « reasoning Jev-style classifier with a diffusion drafter », publié par PostHog le 29 septembre 2026. Il a été conçu par Nicholas Waltz, ingénieur de recherche en IA dans l'équipe AI Research de PostHog, qui a auparavant passé deux ans dans une startup YC à construire des modèles de RL pour la livraison par drone, d'après son profil PostHog.
Pour comprendre Jeeves, il faut savoir ce qu'il copie. Un « modèle de décision » n'écrit pas de texte. Vous lui envoyez un état (un e-mail, un ticket, un bloc JSON) et un ensemble de questions typées, et il renvoie une probabilité pour chaque option de réponse. La catégorie s'est popularisée deux semaines plus tôt, quand TypeSafe a lancé Jev avec trois types de questions : un oui/non noul, un choix unique choice et une grille de notation score. Jev est fermé et hébergé. En quelques jours, Kev de Jared Palmer a publié des poids ouverts compatibles Jev, et Jeeves cite Kev comme source d'inspiration.
Ce que Jeeves ajoute, c'est la réflexion. Le README pose le problème sans détour : les modèles de type Jev « give calibrated decision probabilities, but at low accuracy », donc « a lot of pipelines therefore rely on a reasoning model as a fallback. » Ce recours est généralement un LLM hébergé facturé au token, le genre de coût que j'ai détaillé dans Claude Sonnet 5.5 pricing. Jeeves essaie d'être ce recours, dans la forme même de Jev.
Les caractéristiques principales :
| PostHog Jeeves | |
|---|---|
| Modèle de base | Qwen3.5-9B avec LoRA et une tête pointeur (voir les alternatives à Qwen) |
| Types de questions | noul (oui/non), choice, score, combinables dans une même requête |
| API | /v1/systemone compatible Jev, plus un SDK Python prêt à l'emploi |
| Licence | Code MIT, poids Apache-2.0 (hérité de Qwen3.5) |
| Taille des poids | 21 Go en bf16, 11.5 Go avec couches linéaires FP8 |
| Matériel | GPU CUDA ; Mac Apple Silicon de 48 Go+ pour l'inférence |
| API hébergée | Aucune. Auto-hébergement uniquement |
| Traction au lancement | 241 points sur Hacker News, 356 étoiles GitHub |
Je suis Alicia et je construis les agents IA au sein d'eesel, je passe donc beaucoup de temps sur cette couche précise : la partie du pipeline qui décide ce qu'un ticket est avant que quoi que ce soit ne soit écrit. Voici comment Jeeves s'y prend et où il mérite sa place.
Comment Jeeves raisonne-t-il avant de décider ?
Le mécanisme est un joli morceau d'ingénierie, et il explique à la fois le gain de précision et le coût en latence.
Jeeves charge l'état et chaque question dans le template de chat de Qwen en utilisant comme marqueurs des tokens rares, peu employés (<|fim_prefix|> pour l'état, <|box_start|> pour chaque option, etc.). Puis il fait ce que Jev ne fait pas : il génère une chaîne de raisonnement en texte libre dans un bloc <think>. Une fois la chaîne refermée, la question et les options sont répétées, et une petite tête pointeur note chaque option en comparant l'état caché au token <decide> avec l'état caché à la fin de chaque option. Un softmax sur ces scores, divisé par une température ajustée sur des données de dev (1.859, d'après la fiche du modèle sur Hugging Face), donne les probabilités finales.
Deux détails issus des ablations méritent d'être connus si vous entraînez un jour ce genre de modèle. Remplacer les tokens rares par des mots ordinaires comme « State » a dégradé les résultats. Supprimer la question répétée après le bloc de raisonnement aussi. Le modèle a besoin qu'on lui rappelle les options juste avant de s'engager.
L'entraînement s'est déroulé en trois étapes, toutes documentées dans le dépôt :
- Fine-tuning supervisé : 2 époques, 596 étapes sur 8 GPU, sur 19,126 questions issues de 12 jeux de données publics plus des données synthétiques de politiques. La moitié des questions comportait une chaîne de raisonnement échantillonnée à partir du modèle de base.
- Apprentissage par renforcement avec CISPO : la méthode de RL de MiniMax-M1, sur 9,992 questions avec 8 rollouts chacune, plafonnée à 2,560 tokens de réflexion. Le calendrier de 624 étapes a été arrêté à l'étape 402, car au-delà « the head over-sharpens » et la calibration se dégrade.
- Calibration : une seule température ajustée sur le dev et enregistrée avec le checkpoint.
Cet arrêt à l'étape 402 est ce que je souligne. L'équipe a sacrifié un peu de score brut pour garder des probabilités honnêtes, ce qui est toute la raison d'être d'un modèle de décision. Un modèle qui dit 90 % et a raison 70 % du temps est pire qu'inutile dans un pipeline de routage, et c'est le même problème de fond que la plupart des hallucinations de l'IA en support.
Pour regagner de la vitesse, Jeeves fournit un drafter à diffusion qui propose plusieurs tokens de raisonnement à la fois pour le décodage spéculatif. Sur une question, il fait passer la vitesse de la chaîne de 109 à 176 tokens par seconde avec un drafting de bloc 4, et à environ 960 tokens par seconde au total quand huit questions sont traitées en lot.
Où Jeeves bat-il Jev, et où perd-il ?
Le tableau de résultats de PostHog est d'une franchise inhabituelle, et le schéma qu'il révèle est ce qu'il y a de plus utile dans ce lancement.
| Benchmark | Kev-9B | Jev | Jeeves |
|---|---|---|---|
| Test global (mis de côté et hors domaine) | 0.822 | 0.857 | 0.889 |
| JevBench global (231 éléments publics) | 0.715* | 0.866 | 0.935 |
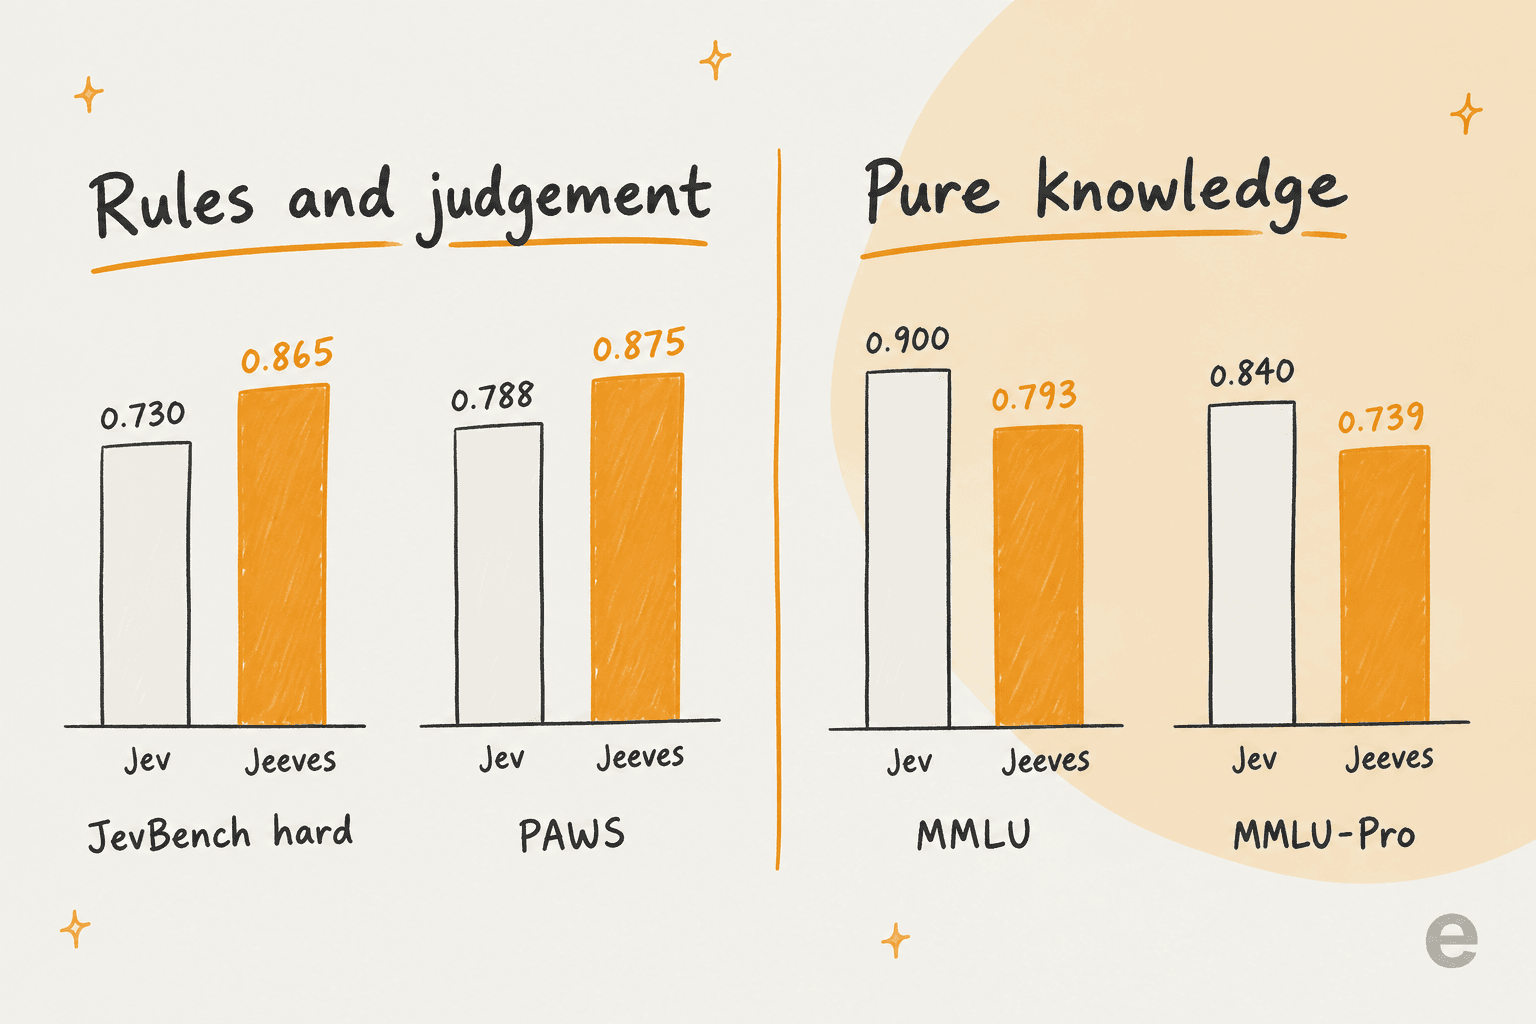
| JevBench hard (111 éléments publics) | 0.451* | 0.730 | 0.865 |
| PAWS (détection de paraphrases) | 0.763 | 0.788 | 0.875 |
| Structures de règles mises de côté | 0.896 | 0.885 | 1.000 |
| Politiques contrastives | 0.900 | 0.963 | 1.000 |
| MMLU | 0.738 | 0.900 | 0.793 |
| MMLU-Pro (10 choix) | 0.515 | 0.840 | 0.739 |
| Inconnaissable répondu à p ≥ 0.9 (plus bas est mieux) | 0.000 | 0.090 | 0.055 |
| Erreur de calibration JevBench (plus bas est mieux) | 0.049 | 0.037 |
*PostHog note qu'aucun résultat JevBench de Kev-9B n'est publié, ces cellules correspondent donc à Kev-8B. Tous les chiffres viennent du README de Jeeves.
En lisant le tableau de haut en bas, une scission apparaît. Là où la question consiste à appliquer des règles à une entrée désordonnée (structures de règles mises de côté, politiques contrastives, détection de paraphrases, JevBench hard), la réflexion gagne, parfois largement. Là où la question consiste à connaître un fait (MMLU, MMLU-Pro), Jev gagne d'environ 10 points. Raisonner ne peut pas conjurer une connaissance qu'un modèle de 9B n'a pas. Pour les connaissances, les équipes de support ancrent généralement le modèle dans leurs propres documents, l'arbitrage traité dans RAG vs fine-tuning.
Cette scission correspond bien au travail de support. « Cette demande de remboursement entre-t-elle dans notre politique de 30 jours, vu la date de commande enfouie au troisième paragraphe ? » est une question de règles. « Quelle est la capitale du Pérou ? » n'apparaît jamais dans une file de tickets. Si vos décisions ressemblent à la première, le tableau joue pour vous.
Deux réserves honnêtes de PostHog lui-même : les comparaisons avec Kev et Jev hors JevBench « use different items from the same sources », et les chaînes de raisonnement ne sont pas très lisibles, car « no language consistency reward was included. » Vous obtenez la réponse et une chaîne, mais ne comptez pas montrer cette chaîne à un auditeur.
Quelle est la lenteur de la « réflexion » en pratique ?
C'est là que le fil Hacker News a le plus tapé, et à juste titre.
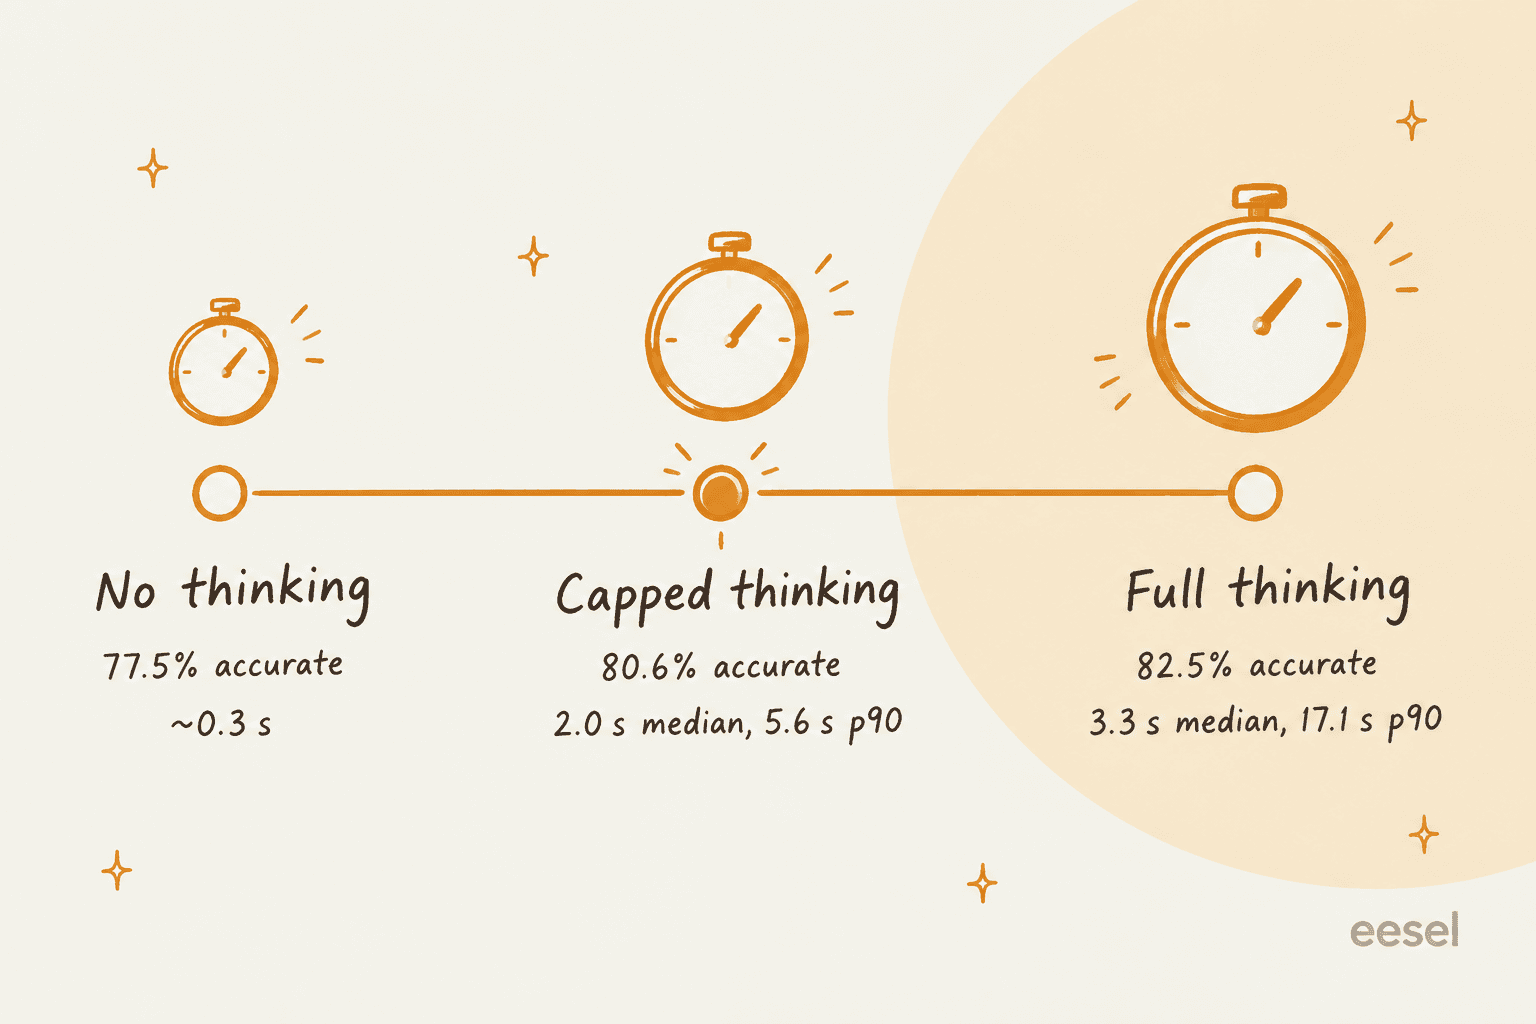
PostHog a mesuré trois réglages sur 325 questions de dev, sur une H100 en FP8 :
| Réglage | Précision | Tokens de raisonnement (moyenne) | Latence médiane / p90 |
|---|---|---|---|
| Réflexion complète | 0.825 | 1,138 | 3.3 s / 17.1 s |
max_think 768, nothink_threshold 0.9 | 0.806 | 344 | 2.0 s / 5.6 s |
| Sans réflexion | 0.775 | 0 | environ 0.3 s |
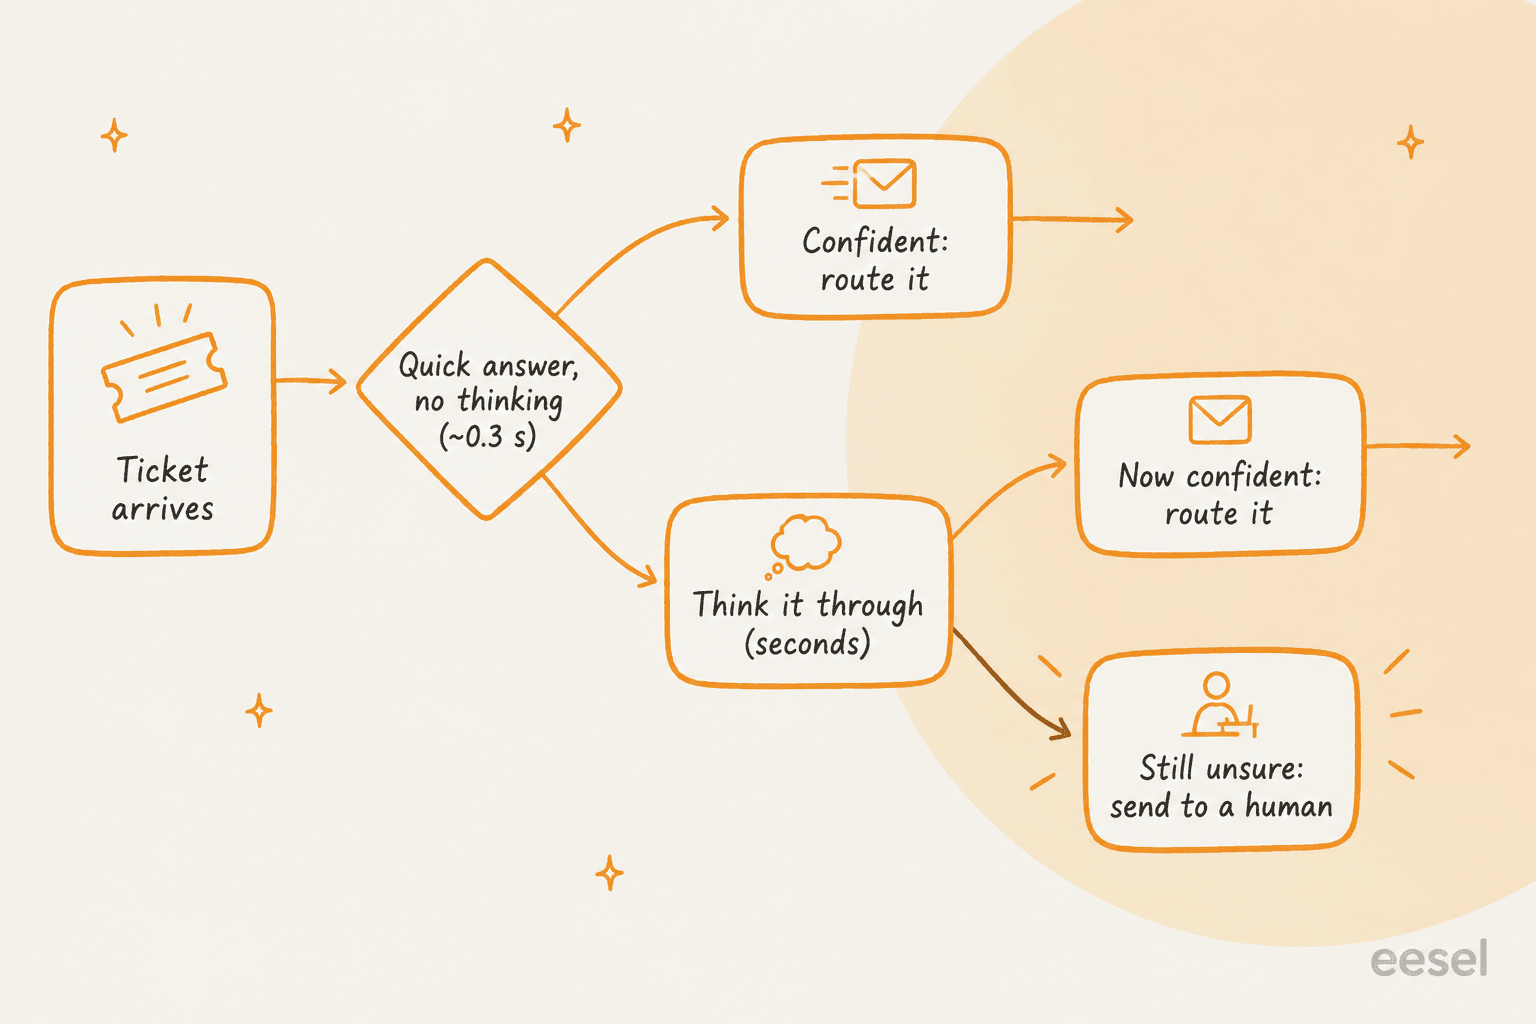
La ligne du milieu est celle que je mettrais en production. max_think coupe chaque chaîne de raisonnement à un budget de tokens, et nothink_threshold saute entièrement la réflexion quand la réponse rapide est déjà sûre. Vous gardez l'essentiel du gain de précision (0.806 vs 0.775) et réduisez la latence p90 des deux tiers.
À titre de comparaison, l'argument de Jev est de 70 à 500 millisecondes par appel, ce que j'ai couvert dans mon test de vitesse de Jev. Les gens de HN l'ont remarqué :
"Cool engineering, but 17s p90 latency kind of defeats the point of a Jev-class model, which is supposed to be fast and cheap."

C'est vrai si on traite Jeeves comme un remplaçant de Jev. Ça l'est moins si on le traite comme ce qui tourne après que le modèle rapide a haussé les épaules. Un commentateur a résumé l'architecture simplement :
"Seems like this is the way, a hybrid approach where some of the pipeline will be jev like and some traditional LLM depending on the nature of the work."
Jeeves condense cet hybride en un seul modèle. Réflexion désactivée, c'est votre niveau rapide. Réflexion activée, c'est votre niveau lent. Et comme les deux niveaux partagent une API et une calibration, vous n'avez pas à concilier les probabilités d'un classifieur avec la réponse en texte libre d'un LLM.
Que se passe-t-il avec un vrai ticket de support ?
La requête de démo du README est un ticket de support, ce qui a facilité mon travail. L'état dit : « Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card. » Trois questions l'accompagnent : quel service, faut-il escalader, et à quel point le client est frustré.
Jeeves a renvoyé billing 0.46, returns 0.40, shipping 0.14, et une confiance de choix de seulement 0.19. L'escalade a obtenu 0.72. La frustration est tombée à 1.5 sur une échelle de 0 à 2. Toute la requête a pris 8.1 secondes, les trois questions réfléchissant en parallèle.
Voici le même ticket (plus une phrase supplémentaire) passé dans Kev-4B dans le playground de Kev :
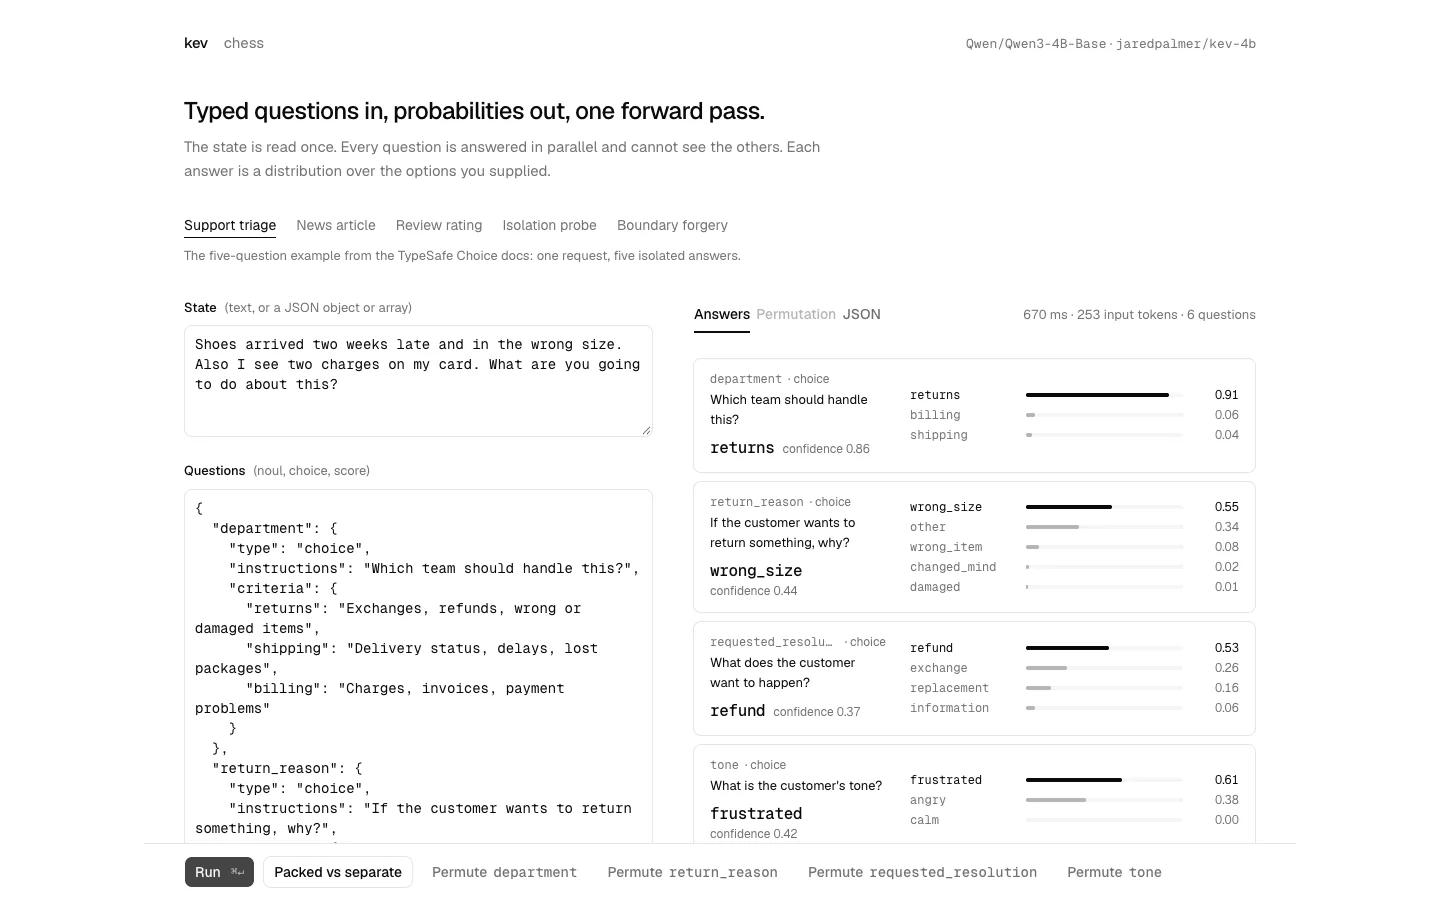
Kev-4B a dit returns à 0.91 en 670 millisecondes. C'est un modèle plus petit et le prompt est légèrement différent, ce n'est donc pas une comparaison directe propre. Mais regardez le ticket. Il contient réellement deux problèmes relevant de deux équipes. Kev a répondu vite et semblait sûr de lui. Jeeves a réfléchi et a dit, en substance : « c'est serré, et je ne suis pas sûr ».
Pour une file de support, la seconde réponse est la plus utile. Un mauvais routage assuré signifie que le client attend dans la file des retours pendant que son double prélèvement reste intact. Un partage à faible confiance est un signal pour faire quelque chose de plus malin : router vers la facturation et taguer les retours, scinder le ticket, ou l'envoyer à une personne avec un passage de relais IA vers humain propre.
Cela correspond à ce que j'ai vu en faisant tourner l'IA d'eesel sur de vraies files. Dans un essai sur trafic réel dans une boîte de réception e-commerce, les décisions étaient la partie fiable : 93 % de précision de tri et 100 % de détection de spam sans faux positif. Ce sont les réponses générées qui ont dérapé, avec 7 % d'erreurs factuelles dans les brouillons. La classification est la moitié de l'IA de support à laquelle on peut se fier tôt, tant que le modèle admet quand il n'est pas sûr. J'ai aussi vu des bots à l'air sûr donner discrètement de mauvaises réponses, c'est pourquoi chaque déploiement eesel est simulé sur des tickets historiques avant de toucher un client réel. Un « je ne sais pas » calibré vaut mieux qu'une supposition rapide.
Qui devrait vraiment utiliser PostHog Jeeves ?
Jeeves est une publication de recherche, pas un produit, et ça se lit, comme une bonne partie de l'espace des agents IA open source : code d'entraînement complet, données train/dev/test, un script de reproduction, aucun endpoint hébergé. La page du modèle sur Hugging Face note que le modèle « isn't deployed by any Inference Provider. »
Voici comment je classerais :
| Vous êtes... | Choisissez | Pourquoi |
|---|---|---|
| Une équipe ML qui fait déjà tourner Jev ou Kev, avec un recours à un LLM | Jeeves | Même API, un modèle pour les deux niveaux, meilleur sur les cas limites riches en règles |
| Une équipe qui veut des décisions sous la seconde à chaque appel | Jev ou Kev | Passe unique, pas de traîne de réflexion |
| Une équipe qui veut des poids ouverts sur un portable | Kev-0.8B ou Kev-4B, ou Laya | Empreintes bien plus petites |
| Une équipe qui veut entraîner son propre modèle de décision | Jeeves | La recette complète SFT, CISPO et drafter est dans le dépôt |
| Une équipe de support qui veut des tickets triés et traités | Un agent IA de helpdesk | Un modèle de décision ne répond pas, ne met pas à jour de champs et n'escalade pas |
Les premiers tests de la communauté sont encourageants pour de la modération. Un commentateur de HN l'a essayé sur ses propres données :
"Update: Jeeves took about 2 hours to moderate 394 data points and performed really well. It's not as good as Jev, but it's super close!"
Notez les « 2 hours ». C'est encore la taxe de la réflexion, sur un matériel qui n'est pas une H100. Un ingénieur de PostHog, Robbie Coomber, a répondu dans le même fil qu'un portage MPS était en cours pour accélérer Apple Silicon, et le dépôt montre qu'il a depuis été fusionné.
Si c'est vous qui l'intégrez, la carte complète des alternatives à Jev vaut un coup d'œil d'abord, car les fonctions de sortie structurée des LLM hébergés pourraient couvrir votre cas sans GPU.
Ce qu'un modèle de décision ne fera pas pour votre helpdesk
Voici le glissement sur lequel j'insisterais. Un modèle de décision répond très bien à « qu'est-ce que ce ticket ? ». Il ne répond pas à « alors que fait-on maintenant ? ». Quelqu'un doit encore écrire le code qui transforme billing: 0.46 en tag de helpdesk, en réponse, en vérification de remboursement, en escalade avec note et en trace du pourquoi.
C'est là qu'apparaît l'écart entre infrastructure et employé. Jeeves, Jev et Kev sont de l'infrastructure : d'excellentes briques, peu coûteuses à faire tourner, pour la classification de tickets, la priorisation et l'analyse de sentiment. Un coéquipier IA est l'employé qui prend les mêmes décisions dans votre vrai helpdesk puis fait le travail. Si vous pesez les deux, mon guide sur l'automatisation du tri des tickets expose plus en détail l'arbitrage entre construire et embaucher.
Essayer eesel

Si vous regardez Jeeves parce que vous voulez un tri plus intelligent, vous ne voulez probablement pas héberger un modèle de 9B et écrire le code de liaison autour. Le coéquipier IA de helpdesk d'eesel rejoint votre file existante dans Zendesk, Freshdesk ou Help Scout, apprend de vos anciens tickets et de votre centre d'aide, et prend la décision de router, taguer et escalader sur chaque ticket, en suivant les règles d'escalade que vous utilisez déjà. Il rédige ensuite ou envoie la réponse, et confie à une personne, avec une note, les cas vraiment incertains. Avant la mise en production, vous pouvez le simuler sur des centaines de vos anciens tickets et voir exactement où il aurait eu raison ou tort.
Si l'attrait de l'auto-hébergement de Jeeves est en réalité le contrôle par le code, la CLI eesel y répond. Elle exécute le même coéquipier depuis votre terminal : eesel activity liste chaque exécution et en affiche une en détail, eesel approvals vous laisse approuver ou refuser les actions nécessitant un humain, et eesel instructions modifie les règles permanentes du coéquipier. Chaque commande affiche du JSON, les commandes d'écriture prennent en charge --dry-run pour voir l'appel exact avant qu'il n'ait lieu, et l'espace de travail sert aussi de serveur MCP, si bien que des agents de code comme Claude Code peuvent le piloter directement. Il y a plus à ce sujet dans mon guide de la CLI d'agents IA.
Si vous le comparez à l'IA intégrée de votre helpdesk, le comparatif eesel vs Zendesk AI est une bonne lecture suivante. Le démarrage est gratuit avec 100 crédits et sans carte, et un ticket ou un chat compte pour un crédit, d'après la page des tarifs. Essayez eesel sur votre propre file et voyez combien de tickets il aurait routés correctement le mois dernier.
Questions fréquentes
Qu'est-ce que PostHog Jeeves ?
PostHog Jeeves est un modèle de décision de 9B à poids ouverts, issu de l'équipe de recherche en IA de PostHog. Vous lui donnez un état (texte ou JSON) et des questions typées oui/non, à choix multiples ou de notation, et il écrit une chaîne de raisonnement avant de renvoyer une probabilité calibrée pour chaque option. Il reprend le format de requête de Jev de TypeSafe, il s'intègre donc dans les mêmes pipelines de classification.
PostHog Jeeves est-il gratuit ?
Oui. Le code est sous licence MIT et les poids sur Hugging Face sont en Apache-2.0, télécharger PostHog Jeeves ne coûte donc rien. Vous payez le matériel à la place : un GPU CUDA ou un Mac Apple Silicon de 48 Go ou plus. Il n'y a pas d'API hébergée, ce qui est la principale différence avec la tarification au token de Jev.
En quoi PostHog Jeeves diffère-t-il de Jev ?
Jev répond en une seule passe, sans raisonnement visible. PostHog Jeeves réfléchit d'abord, ce qui améliore la précision sur les tests de référence mis de côté (0.889 vs 0.857) et sur JevBench hard (0.865 vs 0.730), mais porte la latence p90 à 17.1 secondes avec réflexion complète. Jev reste devant sur les questions de connaissances comme MMLU. Le test de Jev détaille le côté passe unique.
PostHog Jeeves peut-il trier des tickets de support ?
Il peut prendre en charge la partie décision du tri des tickets : choisir un service, signaler l'urgence, noter la frustration. La démo du README est un ticket de support. Il ne répond pas aux clients, ne met pas à jour votre helpdesk et n'escalade pas seul, il vous faut donc toujours du code ou un agent IA de helpdesk autour.
Quelle est la vitesse de PostHog Jeeves ?
Sur une H100 en FP8, PostHog Jeeves répond en environ 0.3 seconde sans réflexion, 2.0 secondes en médiane avec réflexion plafonnée, et 3.3 secondes en médiane (17.1 secondes en p90) avec réflexion complète. C'est plus lent que les modèles de décision en passe unique, la plupart des équipes voudront donc l'option nothink_threshold pour sauter la réflexion sur les cas faciles, un peu comme un parcours d'escalade à niveaux.
De quel matériel ai-je besoin pour faire tourner PostHog Jeeves ?
Les poids occupent 21 Go en bf16 ou 11.5 Go avec des couches linéaires FP8. Le README demande Python 3.12 et un GPU CUDA, et indique que l'inférence tourne aussi sur les Mac Apple Silicon de 48 Go ou plus si vous réduisez les caches. Si vous préférez ne pas gérer de GPU, une API de service client IA managée est la voie la plus simple.
PostHog Jeeves est-il meilleur que Kev ?
D'après les chiffres publiés par PostHog, Jeeves bat Kev-9B sur les données de test mises de côté (0.889 vs 0.822) et sur JevBench (0.935 vs 0.715 pour Kev-8B). Kev est plus petit et plus rapide, existe en quatre tailles de 0.8B à 27B et tourne sur un portable. Choisissez Kev pour la vitesse, PostHog Jeeves pour les décisions difficiles fondées sur des règles. Les deux côtoient Laya dans l'espace des modèles de décision ouverts.


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.