

Tester la Gemini Decisions API vaut le coup si ton code fait le même contrôle à ensemble fermé des milliers de fois par jour : router ce ticket, cette photo montre-t-elle un dommage, cette réponse enfreint-elle une politique. Gemini Decision 1 répond à jusqu'à 1 000 questions oui/non, à choix et à barème en une seule passe et renvoie des probabilités, pas du texte, à 0,10 $ par million de tokens d'entrée avec zéro token de sortie facturé. Son avantage sur les autres modèles de décision est l'input : elle lit l'audio, la vidéo et les PDF nativement. Ses manques sont l'absence de caching, de batch, et pas encore de Vertex AI. Elle trie les tickets mais ne peut pas y répondre, et c'est exactement le travail que fait le coéquipier IA de helpdesk d'eesel dans ton helpdesk. Avec le eesel CLI, un agent de code peut charger tes règles de triage et tes articles d'aide, puis faire tourner des tickets de test avant que rien ne passe en production.
Qu'est-ce que la Gemini Decisions API ?
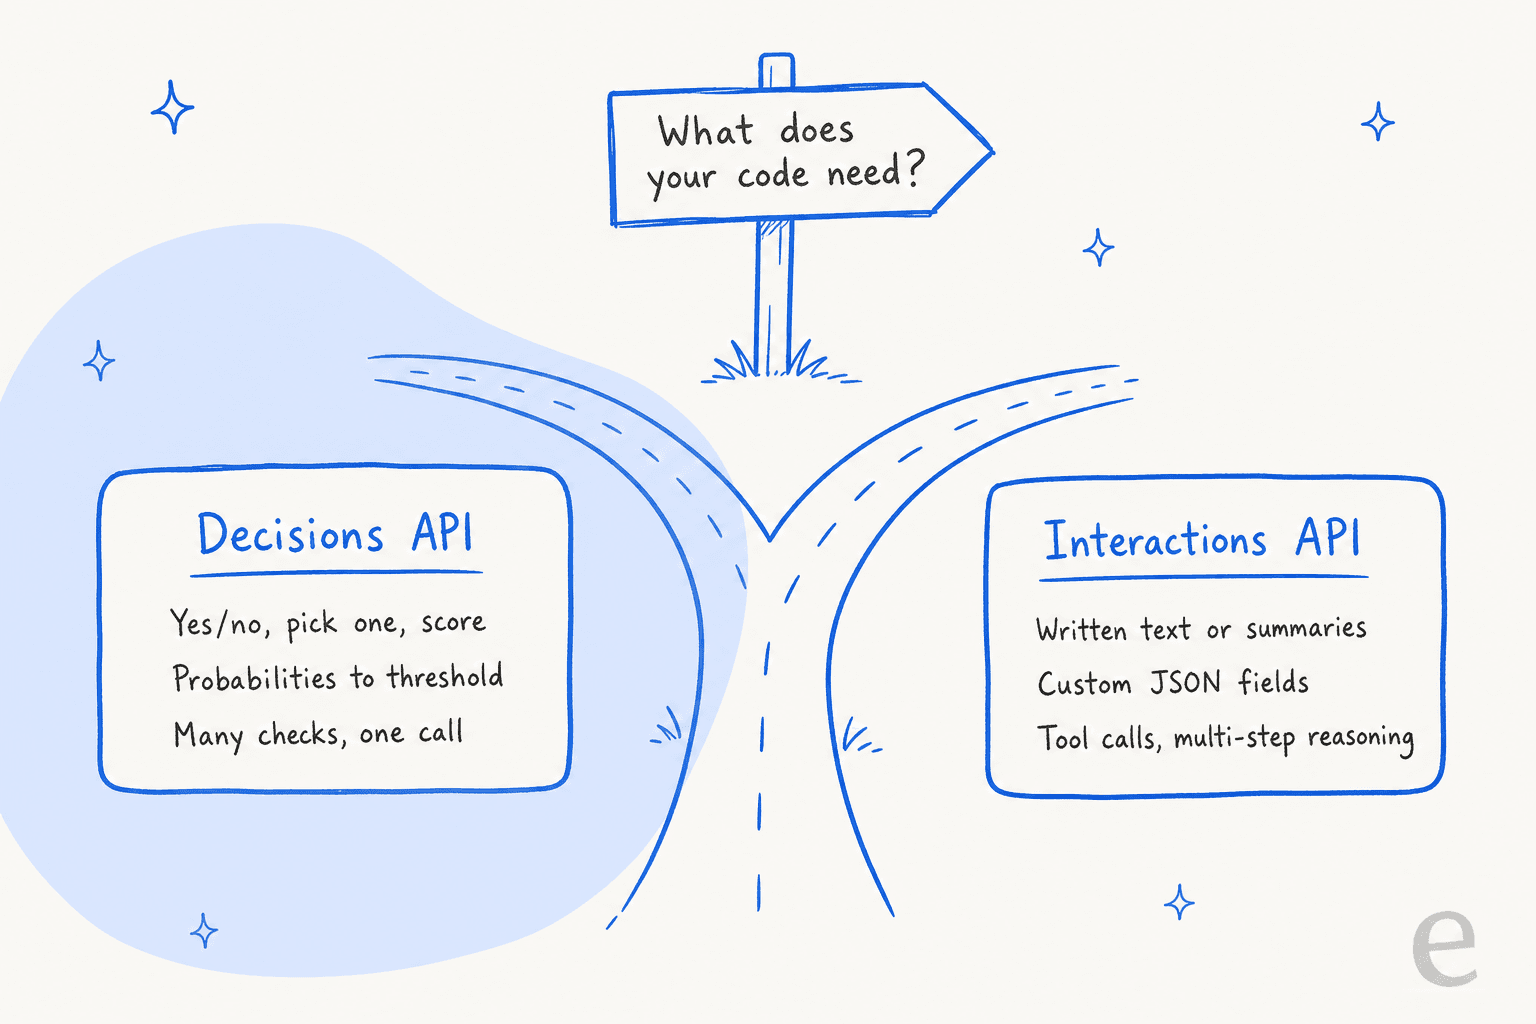
La Gemini Decisions API est un nouvel endpoint de l'API Gemini pour des décisions rapides à ensemble fermé. Google l'a lancée le 11 novembre 2026, avec un nouveau modèle appelé Gemini Decision 1 (gemini-decision-1). Tu envoies un input partagé et une liste de questions typées, et elle renvoie une réponse par question avec une probabilité calibrée et un confidence score.
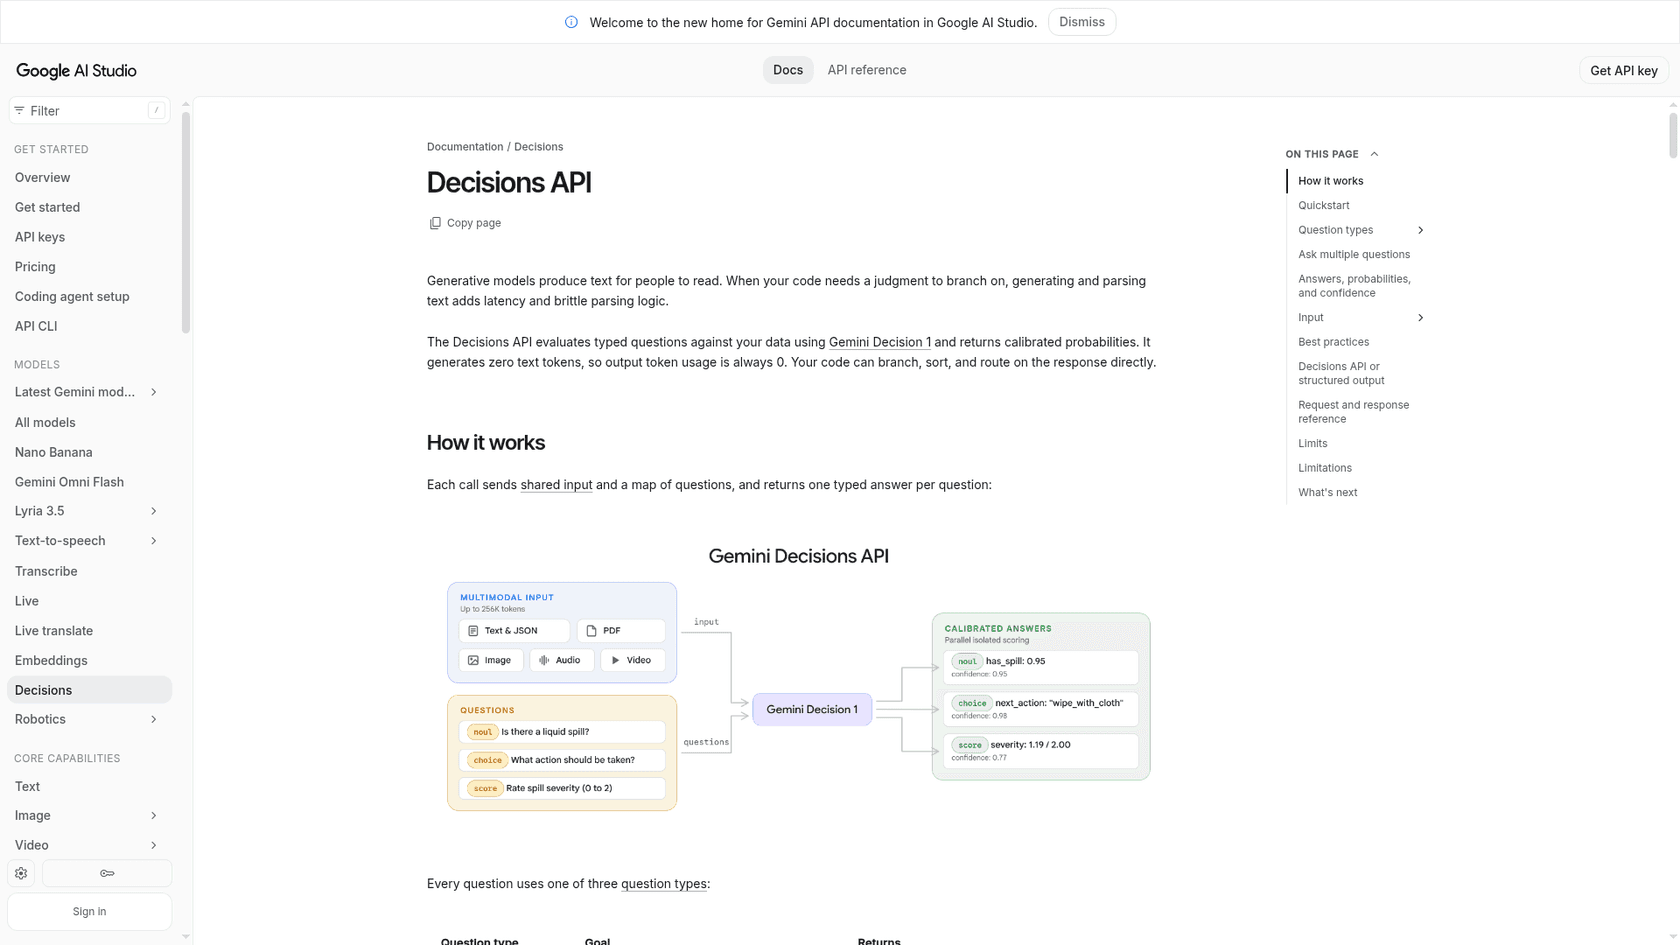
La phrase clé des docs de la Decisions API est qu'elle "generates zero text tokens, so output token usage is always 0." Ton code se branche sur un nombre au lieu de parser une phrase.
Je construis des intégrations et des API pour eesel, et la partie de ce travail que je ne voudrais plus jamais réécrire, c'est le code de colle autour d'un LLM censé renvoyer un seul mot. Tu demandes "billing" ou "shipping", tu récupères "Billing." avec un point, ou un paragraphe poli, et tu écris un parser plus un retry. Un endpoint de décision supprime toute cette couche. C'est la vraie promesse ici, plus encore que la vitesse.
Voici ce que Google a confirmé au lancement :
| Spécification | Gemini Decision 1 |
|---|---|
| ID du modèle | gemini-decision-1 |
| Entrées | Texte, images, audio, vidéo et PDF, mélangés dans une seule requête |
| Sortie | Probabilités et confidence scores, 0 token de sortie |
| Types de question | Oui/non (noul), choix, barème |
| Questions par requête | 1 à 1 000 |
| Fenêtre de contexte | 262 144 tokens, input partagé plus toutes les questions |
| Latence (chiffre de Google) | 150 à 250 ms de bout en bout |
| Prix | 0,10 $ par 1M de tokens d'entrée, palier gratuit dans AI Studio |
| Où ça tourne | Gemini Developer API (v1beta), OpenRouter. Google Cloud "bientôt" |
| Non supporté | Génération de texte, thinking, function calling, caching, Batch API, Flex et Priority |
Google arrive en retard dans cette catégorie, et le reconnaît ouvertement. TypeSafe Jev l'a lancée en septembre, et l'OpenAI Decisions API est passée en beta publique début octobre. Un commentateur de Hacker News a résumé le timing sans détour :
"It took OpenAI 2 weeks after Jev to release a decision end point, and now google does it 2 months later."

Comment fonctionne Gemini Decision 1 ?
Gemini Decision 1 lit ton input une seule fois et note chaque réponse autorisée en une seule passe avant, au lieu de générer une réponse token par token. C'est pour ça que la sortie est gratuite et que la latence reste plate quand tu ajoutes des questions. Google dit que le calcul médian du modèle est de 50 à 100 ms, presque plat de 1 à 100 questions par requête, pour des inputs allant jusqu'à 16 000 tokens.
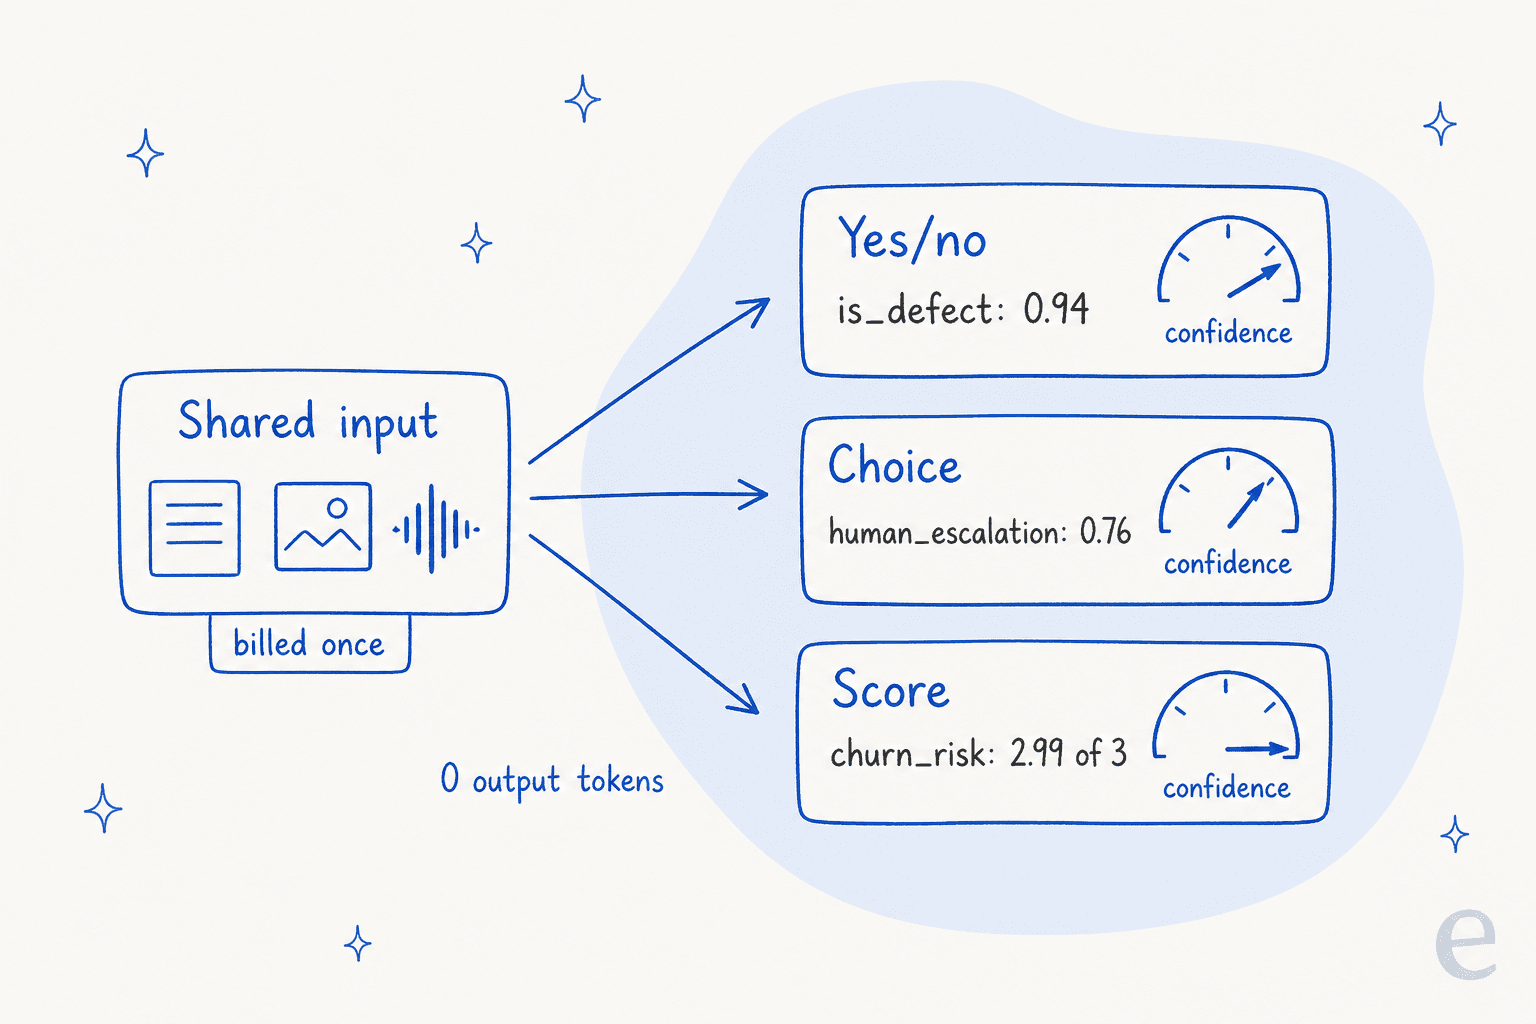
Les chiffres de ce schéma viennent directement du propre exemple de ticket support de Google dans les docs, qui vaut la peine d'être détaillé.
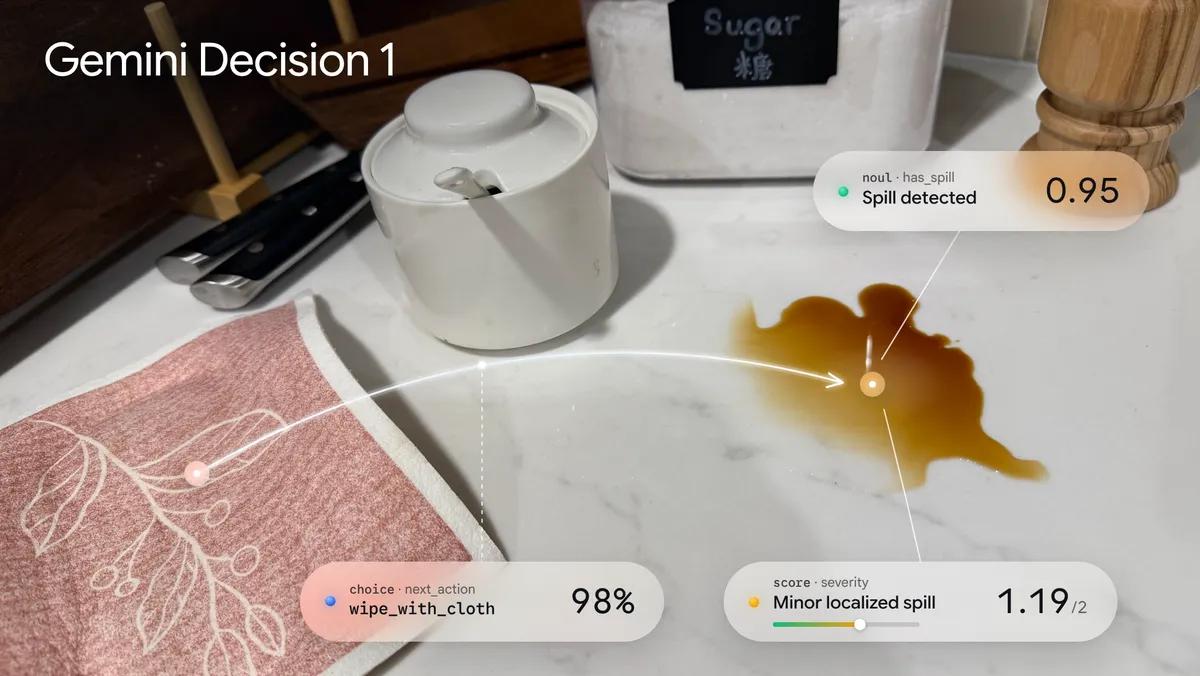
Les trois types de question
Chaque question appartient à un des trois types, et tu peux les mélanger dans un seul appel :
- Oui/non (
noul) renvoie la probabilité qu'une affirmation soit vraie, de 0,01 à 0,99. Tu peux ajouter unetrue_descriptionet unefalse_descriptionquand "oui" est ambigu. Le nom bizarre suit l'API de Jev (des commentateurs de HN pensent que ça vient de "Bernoulli"), tandis qu'OpenAI appelle la même chose unpredicate. - Choix sélectionne une option parmi 2 à 255 et renvoie la gagnante plus une probabilité pour chaque option, qui totalisent 1.
- Barème note l'input selon un barème ordonné de 2 à 255 niveaux (Google recommande 2 à 10) et renvoie une moyenne pondérée par probabilité. Un score de 1,12 veut dire "surtout niveau 1, un peu de niveau 2".
Un exemple support tiré des docs de Google
Le propre exemple multi-questions de Google est un ticket support. L'input, ce sont des données de commande (casque audio, 240 $, palier Gold) plus le message "Audio cuts out on the left earcup. Fix it today or I cancel my membership." Trois questions tournent là-dessus :
| Question | Type | Réponse | Confiance |
|---|---|---|---|
| Est-ce un défaut matériel ? | Oui/non | 0,94 | 0,94 |
| Quelle résolution convient ? | Choix | human_escalation (0,76), replacement 0,18 | 0,76 |
| Quel est le risque de churn ? | Barème, 0 à 3 | 2,99 ("menace d'annuler") | 0,99 |
Le tout a consommé 324 tokens d'entrée et 0 token de sortie. C'est ensuite le code qui fait la composition : si la probabilité de défaut dépasse 0,9 et la confiance du choix dépasse 0,6, l'action est prise, sinon ça part vers une personne. Google appelle ça des "atomic checks, composed in code", et c'est la bonne façon d'utiliser ces modèles. Chaque question ne voit pas les autres, donc en ajouter une ne change jamais les autres.
C'est aussi comme ça qu'un bon routage de tickets fonctionne dans un helpdesk. Tu ne veux pas un seul prompt géant qui décide de tout. Tu veux des contrôles petits et testables (intention, urgence, sentiment) et une règle claire sur quand une personne prend le relais. J'ai couvert le côté helpdesk dans mes guides sur la classification de tickets par IA et le routage par détection d'intention.
Les pièges que les docs signalent
Les docs ont quelques règles qui vont te mordre si tu les survoles :
- Les clés d'option sont triées alphabétiquement avant d'être notées. Un catch-all appelé
none_of_the_abovearrive avantshipping, appelle-le doncother. - Le choix répartit toujours la probabilité entre tes options, même quand aucune ne convient. Vérifie la confiance, ou ajoute un contrôle de périmètre oui/non séparé comme "Ce message parle-t-il d'une commande ?"
- Le modèle ne voit jamais les clés de tes questions. Mets la question complète dans
instructions. - Fais les calculs dans le code. Compare les dates, montants et durées toi-même, puis passe le résultat en entrée.
- Traite l'input comme non fiable. Google prévient que le texte utilisateur "can argue for its own classification", garde donc une personne ou un second contrôle sur les paiements et remboursements. C'est la même logique derrière les guardrails IA dans toute configuration de support.
Qu'est-ce qui la distingue de Jev et OpenAI ?
Les types d'input. Gemini Decision 1 lit texte, images, audio, vidéo et PDF en une seule requête, avec une fenêtre de 262K. La plupart des rivaux sont uniquement texte, ou texte plus images, à 24K-65K tokens.
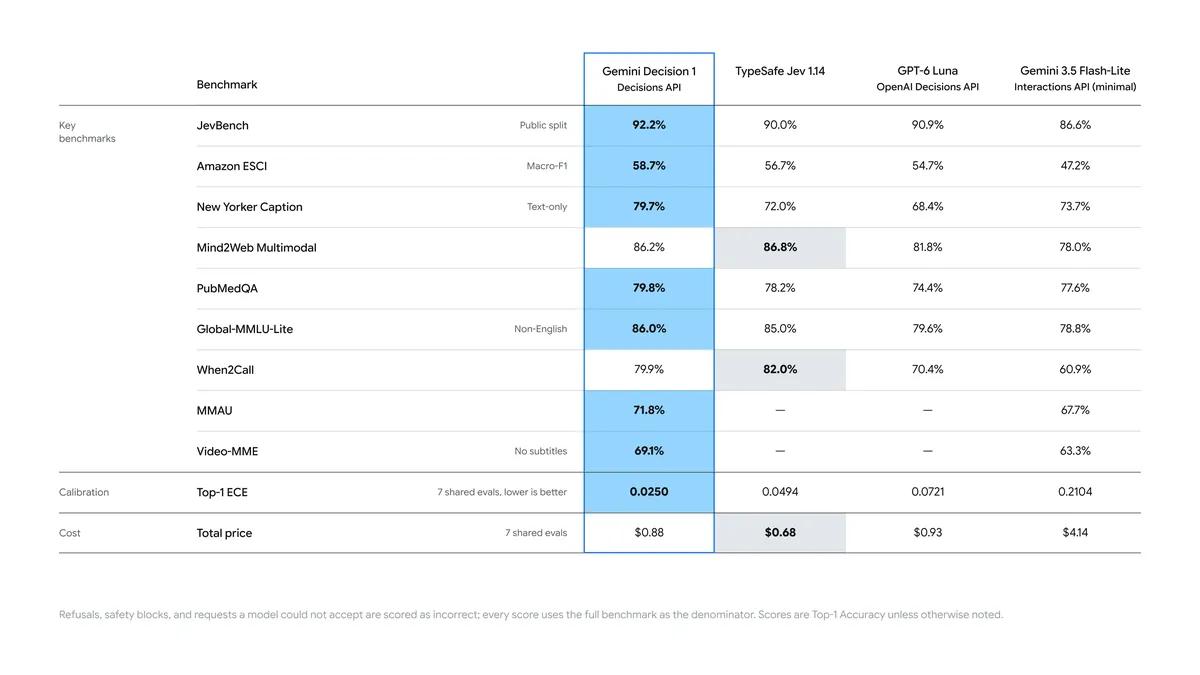
Le post de lancement de Google dit que Decision 1 "leads across the suite, with the lowest calibration error." Prends ça comme Google qui corrige ses propres devoirs, jusqu'à ce qu'un comité externe le vérifie. Voici à quoi ressemble la catégorie sur la page de chaque fournisseur :
| Modèle | Prix d'entrée par 1M | Sortie | Contexte | Lit |
|---|---|---|---|---|
| Gemini Decision 1 | 0,10 $ | Gratuit | 262 144 | Texte, images, audio, vidéo, PDF |
| OpenAI Decisions API (GPT-6 Luna) | 0,10 $ | Gratuit | Fenêtre de Luna, 2x input après 272K | Texte, images intégrées |
| TypeSafe Jev | 0,042 $ | Gratuit | 32 000 | Texte |
| Microsoft-Decision-1 | 0,042 $ | Gratuit | 32 768 | Non précisé |
| Cloudflare Clef | 0,24 $ | Pas de prix de sortie | 65 536 | Texte, JSON, images, vidéo |
| Cloudflare Clef-flash | 0,038 $ | Pas de prix de sortie | 24 576 | Texte, JSON, images, vidéo |
| Strands Decider 2B | Gratuit (self-host) | Gratuit | Fenêtres d'exécution 3K à 4K | Texte |
Chiffres Gemini vérifiés le 12 novembre 2026. Chiffres des rivaux issus de la page de chaque fournisseur, vérifiés en dernier le 11 octobre 2026.
Trois choses ressortent :
- Gemini égale exactement le prix d'OpenAI et coûte environ 2,4 fois celui de Jev par token. Tu paies pour l'input multimodal et la grande fenêtre.
- L'audio et les PDF sont nouveaux pour cette catégorie. Les propres exemples de Google associent "a call recording with account metadata or a scanned PDF claim with damage photos." Pas de frais séparé de transcription ou d'OCR.
- L'hébergement est plus étroit qu'il ne paraît. Pas de poids ouverts, pas de self-hosting, et pas encore de Vertex AI. Jev tourne sur Cloudflare, le modèle de Microsoft sur Azure, et Strands tourne n'importe où.
Le fil de lancement sur Hacker News est arrivé à la même conclusion sur le prix face à l'input :
"Its bit more expensive than other other Decision Models in the same lane. However, it can accept Audio and Video as input as well and for those specific cases it can be extremely useful."
Si tes inputs sont des tickets en texte brut, Jev ou Clef-flash te coûteront moins cher par décision. Si tes inputs sont des messages vocaux, des enregistrements d'appels, des photos de produits cassés ou des factures en PDF, Gemini est le seul modèle de décision hébergé que je connaisse qui les prend tous nativement. Pour un tour d'horizon plus large des options texte seul, voir ma sélection d'alternatives à Jev.
Combien coûte la Gemini Decisions API ?
Gemini Decision 1 coûte 0,10 $ par million de tokens d'entrée sur le palier payant, et la sortie est toujours gratuite parce qu'il n'y en a pas. Le palier gratuit est "Free of charge" pour prototyper, et Google peut utiliser ces données pour améliorer ses produits (pas sur le palier payant).
Deux détails de facturation comptent plus que le tarif :
- L'input partagé est facturé une seule fois par requête, quel que soit le nombre de questions posées. Chaque question n'ajoute que ses propres tokens d'instruction et de critères. Donc dix questions sur un ticket coûtent bien moins que dix appels.
- Rien n'est réduit. Il n'y a ni context caching, ni Batch API, ni palier Flex, donc le même contexte système envoyé à chaque requête est facturé en entier chaque fois. Avec une configuration Gemini 3.5 Flash-Lite, tu aurais au moins un input caché à 0,03 $.
Google affirme que Decision 1 est "nearly 5x cheaper" que Flash-Lite sur sa suite de référence. Mon propre calcul approximatif confirme ça. Prends 10 000 tickets par mois, 600 tokens chacun, trois questions d'environ 60 tokens chacune :
- Decision 1 : 7,8M tokens d'entrée x 0,10 $ = environ 0,78 $ par mois.
- Flash-Lite avec structured output : 7,8M x 0,30 $ = 2,34 $, plus environ 600K tokens de sortie x 2,50 $ = 1,50 $, donc environ 3,84 $, avant tout token de thinking.
Dans les deux cas, la facture du modèle pour la triage est de la petite monnaie face au coût de faire lire chaque ticket par une personne. Entre tes propres chiffres ici :
Qu'est-ce que tu peux construire avec ?
Google liste quatre usages : router une requête vers un modèle, une queue, un agent ou un outil ; vérifier les inputs et outputs contre de nombreuses règles de politique à la fois ; décider quels outils un agent a besoin, ou s'il doit compacter, escalader ou s'arrêter ; et filtrer ou classer des candidats selon un barème. Les équipes de Google l'utilisent déjà en production :
- Gemini Notebook route chaque requête vers le bon palier de modèle et niveau de thinking, ce qui selon Google dessert les requêtes quotidiennes avec jusqu'à 40 % de latence en moins.
- Google Search l'utilise comme couche de sécurité pour les outils MCP, en capturant du contenu adversarial dans son budget de latence.
- CC de Google Labs choisit une réaction emoji parmi plus de 200 options en une fraction de seconde.
- Stitch l'utilise dans une expérience de canvas rapide qui construit des wireframes jouables en quelques secondes.
Pour les équipes support, les usages sont évidents, et les propres exemples de la doc Google sont surtout des tickets support. Voici où je l'utiliserais :
- Triage et routage. Département, priorité et langue en un seul appel, avant qu'une personne ou un agent ne voie le ticket. C'est de l'auto-triage classique.
- Contrôles d'escalade. "Le client menace-t-il d'annuler ?" et "Est-ce un sujet légal ou de sécurité ?" en questions oui/non avec un seuil fixe, qui alimentent une règle d'escalade.
- QA des réponses. Passer un brouillon de réponse contre dix règles de politique (pas de remboursement promis, pas de nom de concurrent, ton correct) avant l'envoi. C'est le remplaçant bon marché pour faire juger chaque brouillon par un LLM.
- Prise en charge de voicemail et de photos. Noter l'intention d'un enregistrement d'appel, ou le dommage visible sur la photo d'un client, sans étape de transcription.
- Notation de sentiment et de churn selon un barème, pour qu'un "2,99 sur 3" puisse faire remonter un ticket dans la queue.
Ce qu'elle ne fera pas, c'est écrire la réponse. Chacun de ces usages se termine par "et ensuite quelque chose répond au client". Quand quelqu'un dans le fil de lancement a demandé où ces modèles sont utiles, une réponse a résumé ça par "Routing, classification, replacement for LLM-as-judge." C'est le périmètre honnête.
Qu'est-ce que ça signifie pour une équipe support ?
Pour la plupart des équipes support, la Gemini Decisions API est une brique, pas un produit. Si tu as des ingénieurs et que tu veux câbler la triage dans ta propre stack, c'est un moyen bon marché et rapide de le faire, et le confidence score te donne un point net pour passer le relais à une personne. Si tu n'en as pas, tu devrais construire toi-même les règles de routage, les seuils, le harnais de test et les écritures vers le helpdesk, et rien de tout ça n'est inclus.
Cette couche environnante, c'est exactement ce qu'est le coéquipier IA de helpdesk d'eesel. Il rejoint ta queue existante dans Zendesk, Freshdesk ou HubSpot, prend les mêmes décisions de catégorisation, de routage et d'escalade, puis fait la partie qu'un modèle de décision ne peut pas faire : il rédige ou envoie la réponse à partir de tes propres macros et de ton centre d'aide. Avant de toucher un ticket réel, il est simulé contre tes conversations historiques, parce qu'une étiquette fausse mais sûre d'elle reste fausse.
Deux clients d'eesel montrent à quoi ça ressemble :
- smava, un site allemand de comparaison de prêts sur Zendesk, se rapproche d'un cas d'école pour un modèle de décision. En un mois, eesel a traité 27 000 tickets sur deux marques, catégorisé 14 600 d'entre eux (langue, éligibilité à la réponse et catégorie écrites dans des champs Zendesk) et préparé 15 300 brouillons de réponse à partir de 820 macros et articles synchronisés.
- MentorShow, une plateforme française d'apprentissage en ligne sur HubSpot, fait analyser chaque ticket avec un brouillon de réponse joint. En un mois, ça représentait 1 200 conversations et tickets lus et 432 brouillons rédigés en français, anglais ou espagnol.
Dans les deux cas, les étiquettes ne sont utiles que parce que quelque chose agit sur elles. C'est l'écart entre une decision API et un coéquipier.
Devrais-tu utiliser la Gemini Decisions API ?
Utilise-la si tu écris déjà du code autour d'appels LLM qui renvoient un seul mot, et surtout si tes inputs sont de l'audio, des images ou des PDF. Le modèle à une seule passe avec de nombreuses questions est une vraie amélioration par rapport au parsing de JSON issu d'un modèle génératif, et 0,10 $ par million de tokens avec une sortie gratuite, c'est difficile à battre.
Choisis-la si tu as besoin de décisions multimodales, de plus de 32K de contexte, ou de dizaines de contrôles sur le même input, et que la Developer API de Google te convient. Choisis autre chose si tes inputs sont du texte brut (Jev et Clef-flash sont moins chers par token), si tu as besoin de Vertex AI ou de self-hosting dès maintenant, ou si tu comptes sur de l'input caché ou en batch pour limiter les coûts.
Et si ce que tu veux vraiment, c'est que les tickets soient triés et répondus, passe sur le câblage. Pour une vue plus large, ma sélection meilleure IA pour la triage compare les outils qui font les deux.
Teste eesel pour une triage qui finit en réponse
Un modèle de décision peut te dire qu'un ticket est un défaut de facturation avec une confiance de 0,94. eesel prend ce ticket dans Zendesk, Freshdesk ou HubSpot, l'étiquette, le route, et rédige la réponse que ton équipe aurait écrite, testée d'abord sur tes propres tickets passés. smava l'utilise pour trier et rédiger 27 000 tickets Zendesk allemands par mois. Regarde les tarifs, ou essaie eesel gratuitement.
Questions fréquentes
Qu'est-ce que la Gemini Decisions API ?
La Gemini Decisions API est un endpoint Google, lancé le 11 novembre 2026, qui répond à des questions à ensemble fermé (oui/non, choisir une option, ou noter selon un barème) sur un input et renvoie des probabilités calibrées plutôt que du texte généré. Elle tourne sur le modèle Gemini Decision 1 et appartient à la même catégorie de modèles de décision que TypeSafe Jev.
Combien coûte la Gemini Decisions API ?
Gemini Decision 1 coûte 0,10 $ par million de tokens d'entrée sur le palier payant, avec zéro token de sortie facturé, et le palier gratuit est gratuit pour prototyper. L'input partagé est facturé une seule fois par appel, quel que soit le nombre de questions posées. Pour comparer, les tarifs de Gemini 3.5 Flash-Lite sont de 0,30 $ en entrée et 2,50 $ en sortie par million de tokens.
Quel modèle utilise la Gemini Decisions API ?
Elle utilise gemini-decision-1, un modèle multimodal spécialisé qui note les options en une seule passe de prefill. Il a une limite d'entrée de 262 144 tokens et une limite de sortie de zéro. Il ne peut pas générer de texte, appeler d'outils ni raisonner, il complète donc des modèles comme Gemini 4 Carbon plutôt que de les remplacer.
En quoi la Gemini Decisions API diffère-t-elle du structured output ?
Le structured output fait écrire du JSON conforme à ton schéma par un modèle génératif, et tu paies pour chaque token de sortie. La Gemini Decisions API n'écrit jamais de texte : elle renvoie une probabilité pour chaque réponse autorisée, que tu peux filtrer avec un seuil. Google dit d'utiliser le structured output quand on a besoin de valeurs extraites ou d'objets personnalisés, le même compromis qu'entre le mode JSON d'OpenAI et un endpoint de décision.
La Gemini Decisions API est-elle meilleure que l'OpenAI Decisions API ?
Elles coûtent pareil, 0,10 $ par million de tokens d'entrée avec sortie gratuite. Gemini lit l'audio, la vidéo et les PDF en plus du texte et des images, tandis que l'OpenAI Decisions API prend du texte et des images intégrées. Le graphique de référence de Google place Decision 1 en tête, mais c'est le propre test de Google et ça n'a pas encore été reproduit de façon indépendante.
Puis-je utiliser la Gemini Decisions API pour la triage de tickets support ?
Oui. La propre documentation de Google utilise des exemples de support : router un ticket vers la facturation ou l'expédition, vérifier un défaut produit, et noter le risque de churn en un seul appel. Ça convient très bien à la triage de tickets, mais ça ne fait que trancher. Il te faut toujours un système qui rédige la réponse, et c'est là qu'intervient un agent de helpdesk.
La Gemini Decisions API est-elle disponible sur Vertex AI ?
Pas encore. Au 12 novembre 2026, elle tourne uniquement sur la Gemini Developer API (v1beta) via Google AI Studio, et Google dit que le support de Gemini sur Google Cloud arrive bientôt. Elle est aussi sur OpenRouter. Si tu en as besoin sur Vertex dès aujourd'hui, regarde les alternatives à Gemini ou patiente.
Quelles sont les limites de la Gemini Decisions API ?
Un appel prend de 1 à 1 000 questions, de 2 à 255 options par question à choix, et de 2 à 255 niveaux par question à barème, tout dans une fenêtre de 262 144 tokens. Il n'y a ni context caching, ni Batch API, ni palier Flex ou Priority, donc un input répété est facturé en entier chaque fois. Les instructions des questions sont du texte uniquement, et les inputs qui déclenchent les filtres de sécurité renvoient un HTTP 400 au lieu de réponses, prévois donc un chemin d'escalade.