Qu'est-ce que l'OpenAI Decisions API ?
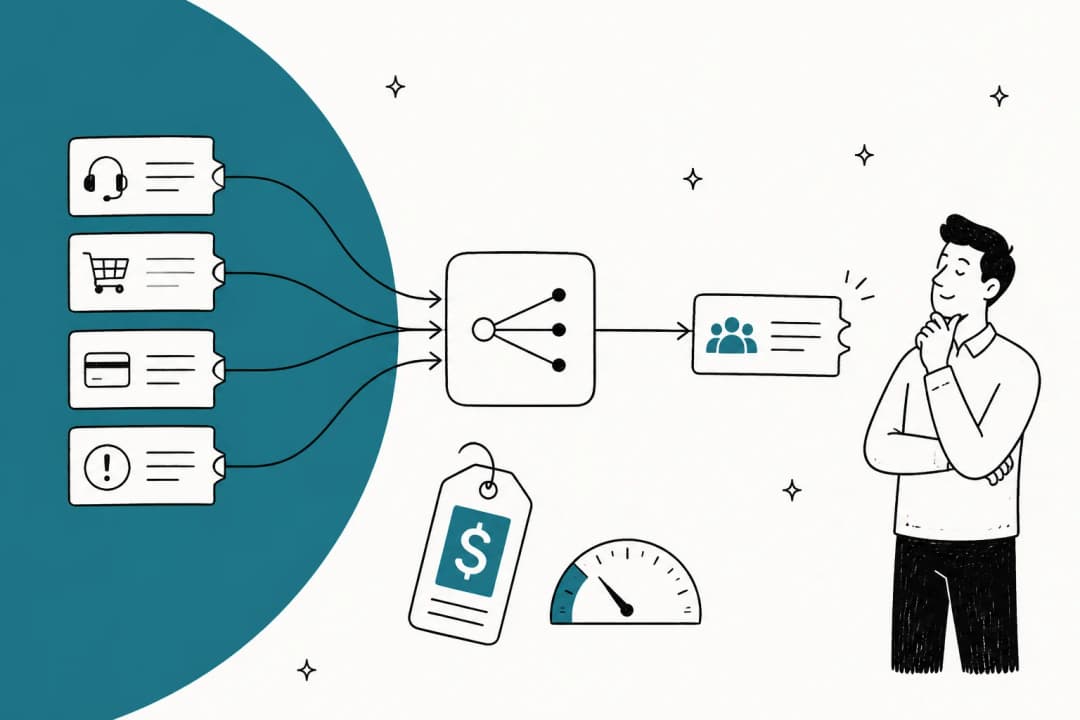
La Decisions API est un nouvel endpoint d'OpenAI pour une tâche étroite : choisir entre des options que vous définissez à l'avance. Voici comment le récap de la DevDay 2026 d'OpenAI la décrit :
"Decisions API enables real-time decision-making by focusing Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers. Developers supply context using text or images, and get back answers they can use to classify content, route requests, or choose an agent's next action."
Je construis des agents IA pour vivre, et la plupart des appels de modèle à l'intérieur de l'un d'eux n'écrivent rien du tout. Ce sont de petites bifurcations, comme quelle équipe est responsable de ce ticket ou si cela demande une personne. Un modèle généraliste peut y répondre sans problème, mais il prend le chemin lent, en générant d'abord du texte. La Decisions API est le pari d'OpenAI que ce type d'appel mérite sa propre voie.
Elle se place à côté des lancements plus gros de la DevDay, comme les agents toujours actifs OpenAI Dots, le modèle GPT-6.1 Sol et Codex Security Cloud.
Elle a eu moins de temps de scène que ceux-là. Le passage de la keynote dure moins d'une minute, à partir d'environ 22:15 dans la keynote, et la même semaine a aussi apporté ChatGPT Space. Pourtant, si vous gérez une file de support, c'est le lancement qui correspond le plus à votre travail quotidien.
Comment fonctionne la Decisions API ?
Vous envoyez trois choses et vous en recevez une. Le flux, tel qu'OpenAI l'a décrit jusqu'ici, ressemble à ceci :
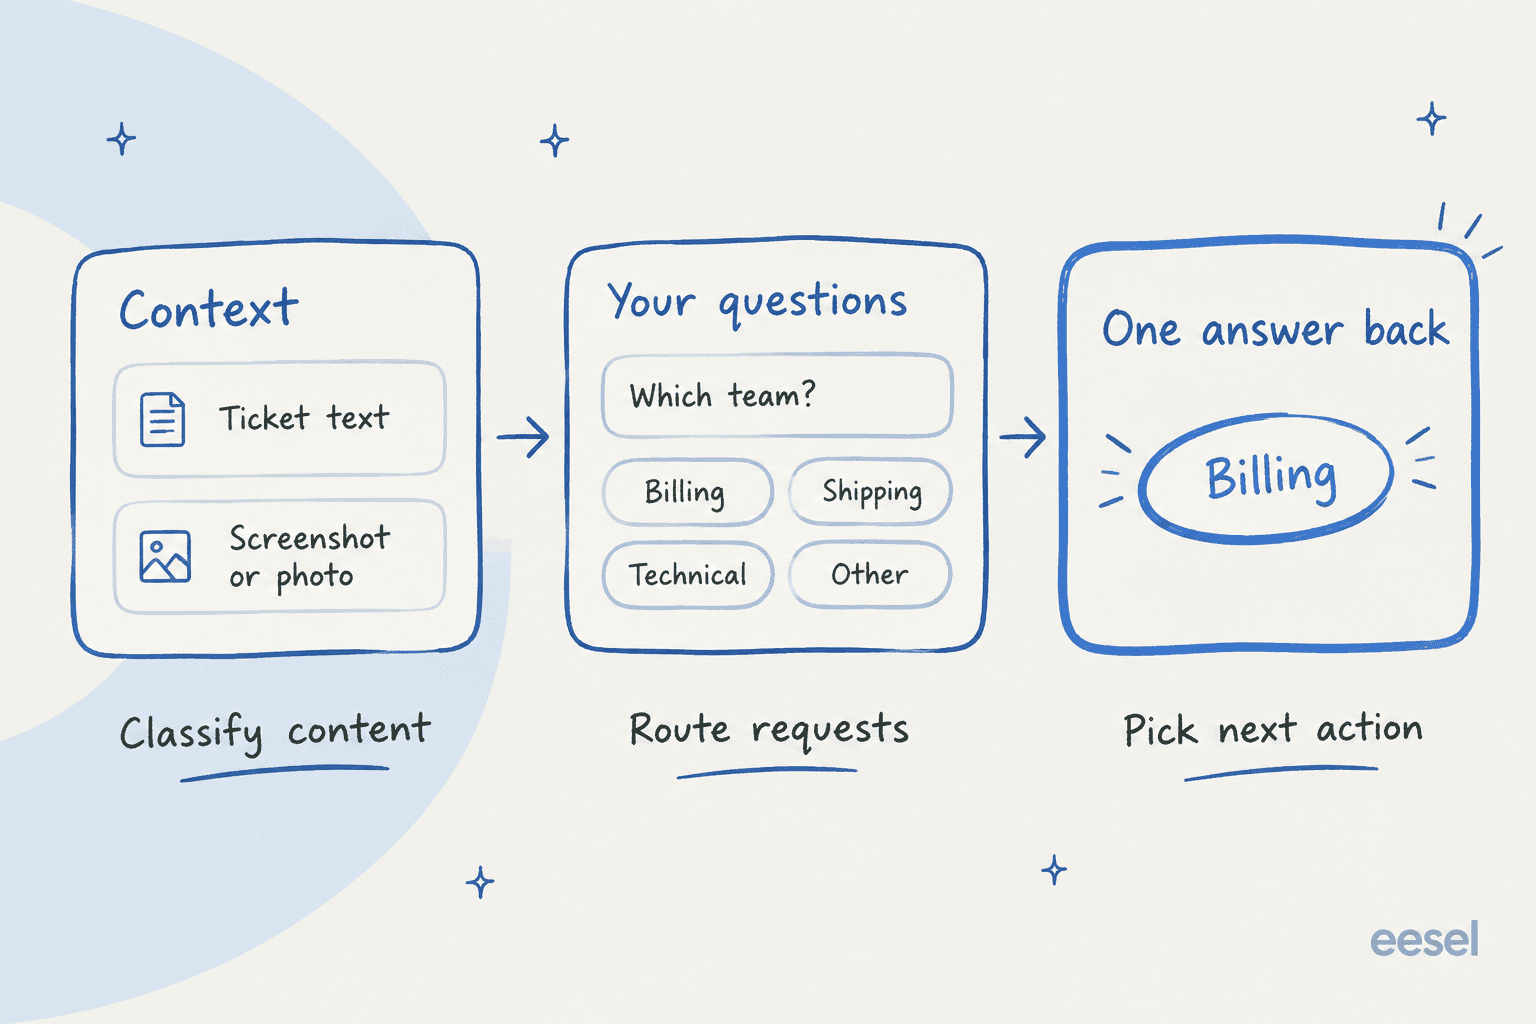
- Contexte. Du texte ou des images, donc le corps d'un ticket, la transcription d'un chat ou une photo de produit jointe par le client.
- Questions à réponses finies. Vous définissez chaque question, plus la liste complète des réponses qu'elle a le droit de renvoyer.
- Une sélection en retour. Une réponse issue de votre liste, puis votre code agit.
L'exemple de support est en fait venu du compte développeurs d'OpenAI lui-même, dans un fil de @OpenAIDevs :
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use."
Sous le capot, elle tourne sur GPT-6 Luna, qu'OpenAI qualifie de "most efficient model for focused, high-volume tasks" sur la page du modèle Luna. La keynote explique la vitesse par le fait qu'un ensemble d'options prédéfini permet à Luna de répondre en une fraction de seconde. Rien n'a besoin d'être écrit mot après mot, il y a donc moins à attendre.
Si vous comptez construire dessus, les points qu'OpenAI n'a pas encore expliqués comptent presque autant :
- Le schéma de requête et de réponse, puisqu'il n'y a pas de page de référence de l'API.
- Si un appel peut porter plusieurs questions, et combien de réponses chaque question peut avoir.
- Si la réponse contient un score de confiance. La presse dit oui, mais je n'ai trouvé aucune page ni publication d'OpenAI qui en mentionne un.
- L'unité de facturation et les limites de débit, ainsi que la question de savoir si Batch ou Flex s'appliquent.
Un lecteur de Hacker News a deviné le mécanisme dans le fil de la DevDay : "I think they simply use the LLMs softmax scores (uncalibrated confidence)". C'est une lecture plausible, mais personne ne l'a confirmée.
Peut-on déjà utiliser l'OpenAI Decisions API ?
Seulement si OpenAI vous a choisi. Le récap indique qu'elle est "available in limited preview today with a broad release planned in the coming days", et le fil d'OpenAI Developers ajoute que "preview access is limited to selected API customers for testing."
Je suis allé vérifier ce que cela donne en pratique. POST https://api.openai.com/v1/decisions est une vraie route, et une clé standard en reçoit cette réponse :
{"error":{"message":"Decision API is not enabled for this user.","type":"invalid_request_error","param":null,"code":null}}
C'est un HTTP 403, donc un verrou de fonctionnalité plutôt qu'une route manquante. Des chemins voisins comme /v1/decisions/create et /v1/beta/decisions renvoient bien 404. Le verrou se déclenche même avec un corps vide, donc les erreurs ne révèlent rien non plus sur la forme de la requête. J'ai obtenu le même 403 le 1er octobre, puis le 2 octobre, trois jours après la promesse du « dans les prochains jours ».
Les traces écrites sont minces elles aussi. Au 2 octobre :
| Ce que j'ai vérifié | Résultat |
|---|---|
Guide de documentation (/api/docs/guides/decisions) | 404 |
Référence de l'API (/api/reference/decisions) | 404 |
| Changelog de l'API, entrées du 29 sept. | Pas d'entrée Decisions API |
| Page des tarifs de l'API | Pas de ligne Decisions API |
| Article d'annonce dédié | Aucun, seulement le récap de la DevDay |
GET /v1/models | Aucun ID de modèle contenant "decision" |
Pour l'instant, la Decisions API est donc une promesse et un endpoint verrouillé. C'est assez normal pour un aperçu, mais cela veut dire que vous ne pouvez ni la tester en charge, ni la chiffrer, ni lire ses limites.
Que la Decisions API apporte-t-elle de plus que les structured outputs ?
Un commentateur de HN a posé la question évidente quelques heures après le lancement :
"It seems a bit silly since OpenAI LLMs already can output structured data."

C'est une remarque juste. Vous pouvez déjà faire répondre Luna à partir d'une liste fixe aujourd'hui : utilisez la Responses API, mettez le reasoning sur none, puis passez un schéma JSON strict dont le seul champ est une énumération de vos réponses. Voici la requête exacte que j'ai exécutée pendant que la Decisions API restait verrouillée :
{"model":"gpt-6-luna","reasoning":{"effort":"none"},
 "input":[{"role":"developer","content":"Route the support ticket. Which queue?"},
          {"role":"user","content":"I was charged twice for my order #4471"}],
 "text":{"format":{"type":"json_schema","name":"route","strict":true,
   "schema":{"type":"object","properties":{"queue":{"type":"string","enum":["billing","shipping","technical","other"]}},
   "required":["queue"],"additionalProperties":false}}}}
Elle a renvoyé {"queue":"billing"} sur les trois exécutions, avec 60 tokens d'entrée et 12 de sortie. Cela revient à $0.000012 par appel aux tarifs Standard de Luna. Quiconque a utilisé le function calling d'OpenAI connaît l'idée, mais avec une laisse plus courte, et c'est aussi la configuration derrière la plupart du routage de tickets par IA pour le SaaS aujourd'hui.
Il y a pourtant un hic, soulevé par un commentateur dans un fil HN plus ancien sur OpenAI et Jev :
"It's not guaranteed to be correct: it's guaranteed to be formatted in a particular way. You can get the same thing with grammars on any LLM."
Le problème du format est donc déjà résolu. Ce que la Decisions API promet en plus, c'est la vitesse, ainsi que ce que finira par signifier le réglage de précision de "focusing Luna's intelligence". Sur ce qui est public à ce jour, les deux se comparent ainsi :
| Decisions API | Luna + structured outputs | |
|---|---|---|
| Statut | Aperçu limité, clients sélectionnés | Disponible maintenant |
| Entrée | Texte ou images | Texte et images |
| Sortie | "A selection" parmi vos réponses | JSON conforme à votre schéma |
| Vitesse | "Less than a few hundreds of milliseconds end to end" (affirmation d'un employé d'OpenAI) | Médiane de 1,46 s dans mon test |
| Prix | Non publié | $0.10 en entrée / $0.50 en sortie par 1M de tokens |
| Score de confiance | Non confirmé | Aucun par défaut |
| Documentation | Aucune pour l'instant | Guide des structured outputs |
Quelle est la vitesse de la Decisions API ?
La seule affirmation écrite d'OpenAI sur la vitesse vient d'un employé, il n'y a rien dans la documentation. Thibault Sottiaux, qui travaille chez OpenAI, a publié le jour du lancement :
"Decisions API, for lightning fast constrained decision making powered by Luna. Supports visual inputs, and tuned to be able to make decisions in less than a few hundreds of milliseconds end to end."
Pour voir ce qu'elle devrait battre, j'ai fait passer 20 tickets de support dans Luna deux fois par configuration, en demandant une file et une priorité, ainsi que si le ticket pouvait recevoir une réponse automatique sans risque. Cela fait 160 appels au total, chronométrés de bout en bout depuis un portable, donc l'aller-retour réseau est compté.
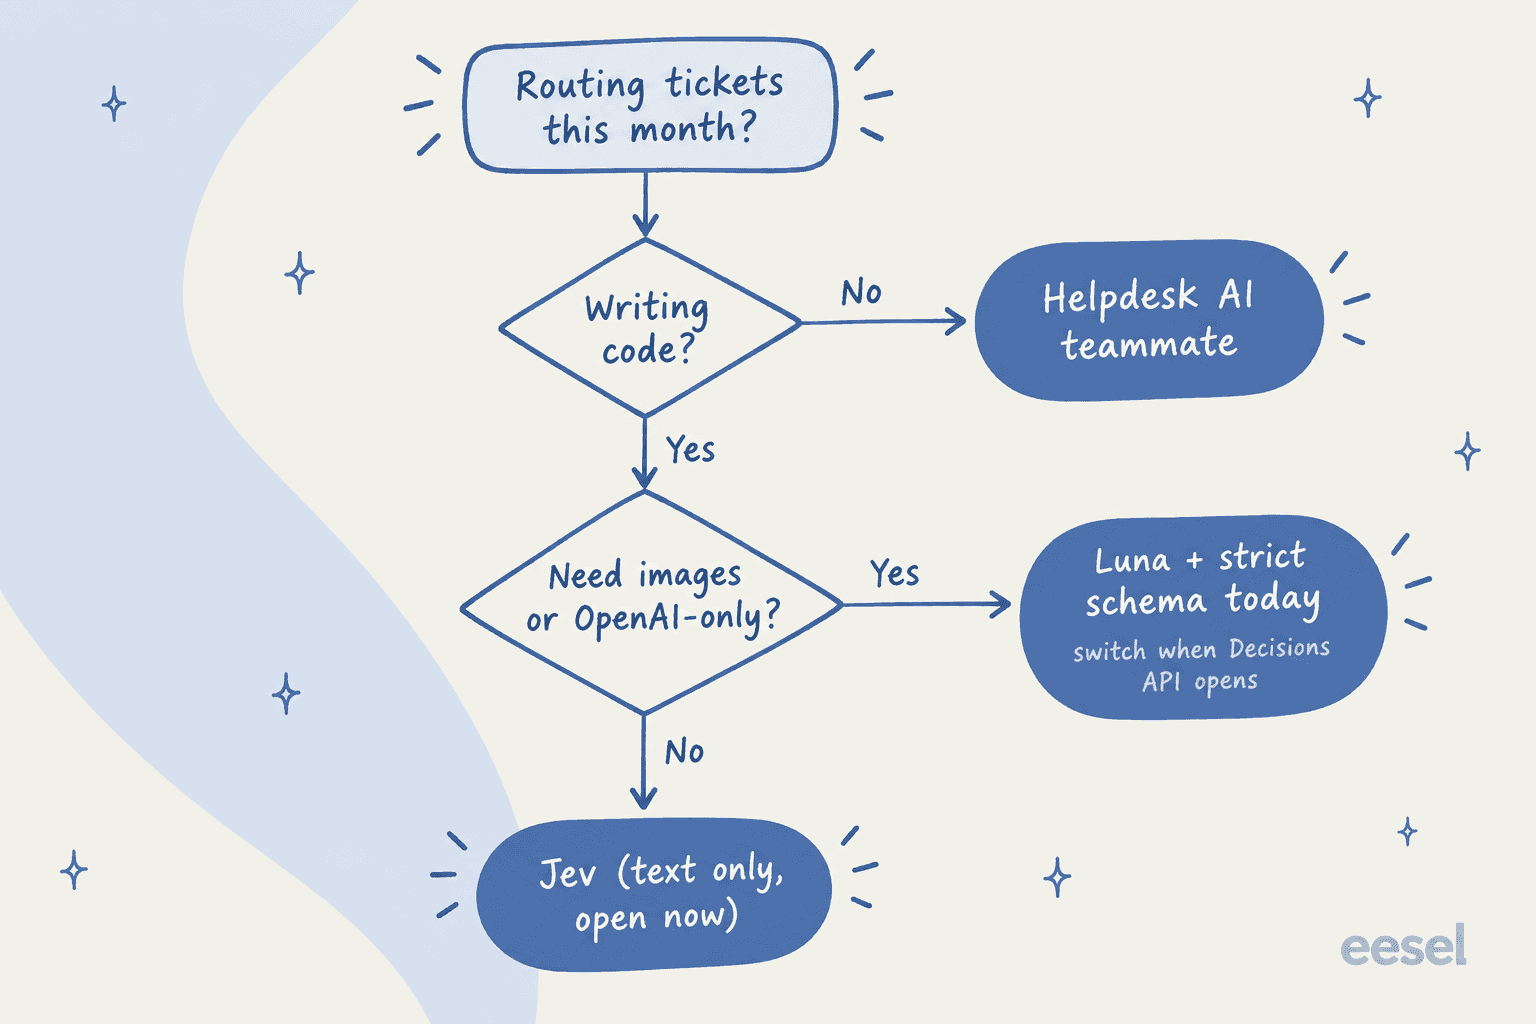
| Configuration (mon test) | Médiane | Plus rapide | Plus lent |
|---|---|---|---|
| GPT-6 Luna, reasoning none | 1,46 s | 0,95 s | 2,79 s |
| GPT-6 Luna, reasoning low | 1,62 s | 0,95 s | 3,20 s |
| GPT-6 Luna, reasoning medium | 2,33 s | 1,44 s | 5,75 s |
| GPT-6.1 Sol, reasoning low | 2,17 s | 1,52 s | 4,98 s |
Si l'affirmation d'OpenAI tient, la Decisions API serait environ cinq fois plus rapide que ma meilleure configuration Luna. Là où cet écart compte, et là où il ne compte pas :
- Tri d'e-mails et de tickets. Pas vraiment. Personne ne remarque si un ticket a été étiqueté en 300 ms ou en 1,5 seconde.
- Chat en direct. Oui. Une pause de 1,5 seconde avant même que le bot ait décidé qui doit répondre s'accumule au fil d'une conversation.
- Agents. C'est là que cela compte le plus. Un agent construit avec quelque chose comme OpenAI AgentKit qui fait 20 petits choix par tâche attend 30 secondes sur Luna, contre quelques secondes à la vitesse annoncée.
Certains articles de presse montrent un graphique « 150 ms vs 1.6 s ». Je n'ai trouvé ces chiffres sur aucune page ni publication d'OpenAI, donc je ne planifierais rien dessus avant la sortie de la documentation.
Comment se compare-t-elle à TypeSafe Jev ?
Il est difficile de parler de ce lancement sans évoquer TypeSafe Jev. TypeSafe a lancé Jev le 15 septembre comme un modèle conçu uniquement pour les décisions typées, puis la Decisions API est arrivée deux semaines après. Un commentateur de HN l'a dit sans détour dans le fil de la DevDay : "Decisions API is a validation for Jev and the entire space it created."
D'après ce que chaque entreprise a publié, elles se positionnent ainsi :
| OpenAI Decisions API | TypeSafe Jev | |
|---|---|---|
| Accès | Aperçu limité | Ouvert à tous depuis le 27 sept. |
| Entrée | Texte ou images | Texte uniquement, selon la page des modèles Jev |
| Types de questions | Questions à réponses fixes | Choice, Score et Noul (probabilité de vrai ou faux) |
| Sortie | Une sélection | Choix plus probabilités et confiance |
| Prix | Non publié | $0.042 par 1M de tokens en entrée, sortie gratuite |
| Vitesse | "Less than a few hundreds of milliseconds" | "70ms-500ms" de bout en bout, selon l'article de lancement |
| Options par question | Non publié | Jusqu'à 255 par Choice |
| Limites de débit | Non publié | 100K tokens/s ou 40 requêtes/s |
Pour la plupart des équipes, tout se joue sur deux lignes. Jev n'accepte pas les images, donc si votre file est pleine de captures d'écran et de photos de dégâts, cela pointe vers OpenAI. De l'autre côté, Jev renvoie une probabilité avec chaque réponse, et c'est exactement ce qu'il faut pour décider quand ne pas agir.
Mon test de Jev raconte comment il s'est comporté. Pour le calcul des tarifs, le détail des prix de Jev l'a, y compris le niveau plus rapide Jev Ultrafast.
Côté prix, la comparaison précoce avec Luna penche déjà vers Jev :
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
Gardez en tête qu'il s'agit du prix catalogue de Luna, pas d'un prix de la Decisions API. OpenAI pourrait tarifer l'endpoint très différemment à son ouverture.
À quoi servir la Decisions API en support ?
OpenAI a cité trois tâches, et chacune a une version claire en support :
- Classer du contenu. Étiqueter un ticket par intention, produit ou sentiment, repérer le spam, ou distinguer une demande de remboursement d'un retour.
- Router des demandes. Envoyer un ticket vers la facturation, l'expédition ou le technique, ou vers une file par langue ou par niveau. C'est le classique routage intelligent, la tâche qu'OpenAI a prise comme exemple. Le même schéma marche pour le routage e-commerce.
- Choisir la prochaine action d'un agent. Décider s'il doit consulter la commande, poser une question de clarification, répondre ou escalader vers une personne, en général à partir de la détection d'intention.
Les deux premières correspondent à ce que la plupart des équipes entendent par tri de tickets, et les décisions typées y fonctionnent déjà bien. La plupart des helpdesks proposent aussi une version native, du tri automatique de Freshdesk à une longue liste d'apps de classification pour Zendesk. Lors d'un essai sur trafic réel avec une boutique en ligne de bijoux traitant environ 1 000 tickets par mois sur Zendesk et Shopify, les appels typés d'eesel ont atteint 93 % de précision de tri et attrapé 100 % du spam sans aucun faux positif, le spam représentant 22 % de cette boîte.
Mon propre test a montré où les ennuis commencent. Chaque configuration a choisi la bonne file 40 fois sur 40. Sur « une réponse automatique est-elle sûre ? », en revanche, Luna sans reasoning a obtenu 33 sur 40, et même GPT-6.1 Sol seulement 39 sur 40. Router est l'appel facile ; savoir quand ne pas agir est le difficile. Une mauvaise file vous coûte quelques minutes, alors qu'une mauvaise réponse automatique part directement chez un client.
Les acheteurs tracent la ligne au même endroit. Un responsable CX d'une marque de compléments alimentaires traitant environ 7 000 tickets par mois sur Gorgias a dit à eesel lors d'un appel commercial qu'ils ne pouvaient pas vérifier chaque réponse de l'IA à la main, donc l'IA devait rester à l'écart de tout ce dont elle n'était pas sûre :
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Un endpoint de décisions vous donne la réponse. À moins qu'il ne renvoie aussi une confiance calibrée, il ne vous dit pas quand laisser un ticket tranquille, cette règle reste donc à construire par vous. Avant de confier une action à un classifieur, il vaut la peine de lire sur les faux positifs dans l'étiquetage par IA.
Combien coûtera la Decisions API ?
Personne en dehors d'OpenAI ne le sait encore. Il n'y a pas de ligne de prix, et OpenAI n'a pas dit si elle facture par token, par appel ou par question. Pour l'instant, le seul repère public est la grille tarifaire de Luna :
| Niveau GPT-6 Luna | Entrée par 1M | Entrée en cache par 1M | Sortie par 1M |
|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.50 |
| Batch / Flex | $0.05 | $0.005 | $0.25 |
| Fast | $0.20 | $0.02 | $1.00 |
À ces tarifs, mon test de 160 appels a coûté $0.047 pour 1 000 tickets sans reasoning, et $0.089 à effort moyen. Même un mois de 10 000 tickets reste bien en dessous d'un dollar. Le calcul complet et les coûts cachés, ainsi que la bataille de prix avec Jev, sont dans mon article sur les tarifs de la Decisions API, et le guide plus large des tarifs de l'API OpenAI donne le tarif de chaque modèle. Sur le seul prix, la décision n'est jamais la partie coûteuse d'une pile de support.
Faut-il construire dès maintenant sur la Decisions API ?
Pas encore, sauf si vous êtes dans l'aperçu. Vous pouvez quand même construire la même fonctionnalité aujourd'hui et changer d'endpoint plus tard. Voici comment je déciderais :
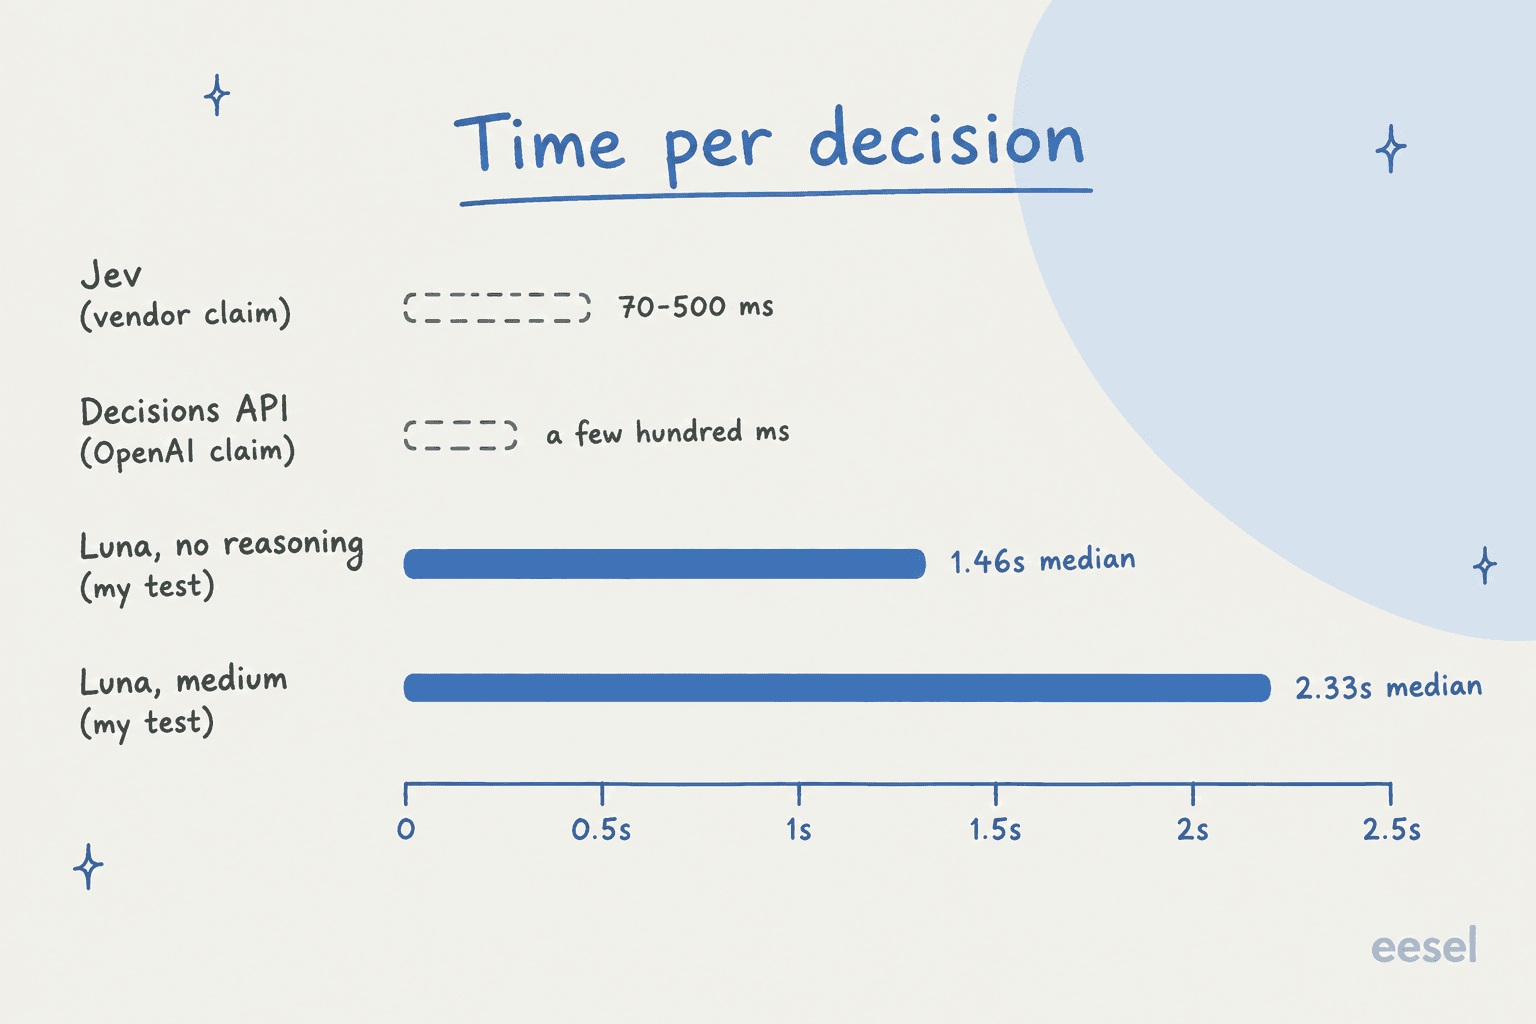
- Vous écrivez du code et restez chez OpenAI. Livrez Luna avec un schéma d'énumération strict et le reasoning sur
noneoulow. Gardez les questions et la liste de réponses au même endroit, ainsi passer à/v1/decisionsreste un petit changement. L'article sur les alternatives à Luna couvre d'autres petits modèles si vous voulez une solution de repli, comme Gemini 3.5 Flash-Lite. - Vous avez besoin de réponses en moins d'une seconde sur du texte. Testez Jev maintenant. Il est ouvert et tarifé, et il renvoie aussi des probabilités. La liste des alternatives à Jev couvre le reste de ce domaine.
- Vos entrées sont des images. Restez chez OpenAI. Luna accepte les images aujourd'hui, et d'après le changelog de l'API, OpenAI a corrigé le 25 septembre un bug d'encodage d'image qui avait "degraded image understanding", relancez donc vos anciennes évaluations d'images.
- Vous voulez du routage dans Zendesk ou Freshdesk, pas une API. Vous pouvez alors éviter complètement la question de l'endpoint. Commencez par mon guide sur comment automatiser le tri de tickets, ou le panorama de la meilleure IA pour le tri de tickets. Les équipes Zendesk peuvent aussi comparer Zendesk Intelligent Triage.
Sur le calendrier, les sceptiques n'ont pas tort :
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
Je serais moins sévère. Un aperçu verrouillé sans prix est normal, et l'entrée d'images est une vraie différence. Reste que « pas de documentation, pas de prix, pas de benchmarks » est une assez bonne raison de ne pas bâtir une feuille de route dessus cette semaine.
eesel pour un routage de tickets en confiance
La Decisions API est de l'infrastructure. Elle choisit une réponse dans votre liste, et tout ce qui entoure cette réponse reste à construire par vous, comme la connexion au helpdesk et les étiquettes, la règle « passer à une personne » et un journal de ce qu'elle a fait. eesel est le coéquipier qui fait déjà ce travail. Son coéquipier de helpdesk IA rejoint votre file dans Zendesk ou Freshdesk, apprend de votre centre d'aide et de vos anciens tickets, puis route, étiquette et répond, avec des règles d'escalade que vous écrivez en langage simple.

D'après mon test, la partie qui compte le plus est l'appel « réponse automatique sûre ? », et c'est là qu'eesel concentre ses efforts. Avant de toucher une file en production, eesel rejoue des centaines de vos anciens tickets et note ses réponses par rapport à ce que votre équipe a réellement envoyé, afin que les appels risqués apparaissent avant qu'un client les voie. Tout ticket dont il n'est pas sûr va à une personne.
Si vous êtes arrivé ici parce que vous préférez construire en code, la CLI eesel exécute le même coéquipier et le même espace de travail depuis un terminal. eesel instructions modifie les règles de routage, eesel activity liste chaque ticket qu'il a touché, et eesel approvals permet à une personne de valider une action avant qu'elle ait lieu. Chaque commande affiche du JSON et accepte --dry-run, si bien que des scripts et des agents de code comme Claude Code ou Cursor peuvent le piloter, et chaque espace de travail fonctionne aussi comme un serveur MCP.
La tarification se fait par ticket, pas par token : un ticket ou un chat vaut un crédit, les forfaits démarrent à $299 pour 500 crédits, et l'offre gratuite donne 100 crédits sans carte. Essayez eesel sur une tranche de votre file et voyez pour quels tickets il est assez sûr de lui pour s'en charger.
Questions fréquentes
Qu'est-ce que l'OpenAI Decisions API ?
L'OpenAI Decisions API est-elle déjà disponible ?
Combien coûte l'OpenAI Decisions API ?
En quoi la Decisions API diffère-t-elle des structured outputs ?
L'OpenAI Decisions API est-elle une copie de TypeSafe Jev ?
Puis-je utiliser l'OpenAI Decisions API pour router des tickets de support ?
La Decisions API renvoie-t-elle un score de confiance ?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.