Qu'est-ce qu'Amazon Bedrock Managed Agents ?
Amazon Bedrock Managed Agents, propulsé par OpenAI, est un runtime géré pour agents IA avec état sur AWS. Vous créez une session avec un modèle, des instructions, des outils et un environnement d'exécution, vous lui envoyez des messages, et le service exécute la boucle de l'agent et les appels au modèle. Selon AWS, il est "built on a customized version of OpenAI's Agents API engineered to be AWS-native" (AWS What's New), et la page du produit dit qu'il "combines OpenAI models with the Codex harness and Amazon Bedrock AgentCore" (AWS).
Je livre les intégrations et les API d'eesel, donc j'ai déjà monté ce genre de boucle à la main plus d'une fois. Et la première chose à savoir, c'est un point que la page marketing enterre un peu : "géré" couvre ici la conversation et la boucle de raisonnement, pas la machine sur laquelle travaille votre agent. Cette machine, c'est vous qui la faites tourner.
Il a fallu du temps pour arriver ici. Voici la chronologie, entièrement issue de sources primaires :
| Date | Ce qui s'est passé | Source |
|---|---|---|
| 27 fév. 2026 | Amazon et OpenAI annoncent un partenariat, incluant un "Stateful Runtime Environment" sur Bedrock | Amazon |
| 28 avr. 2026 | BMA annoncé en preview limitée, avec les modèles OpenAI et Codex sur Bedrock | OpenAI |
| 1 juin 2026 | Les modèles OpenAI et Codex sur Bedrock passent en GA ; BMA reste "coming soon" | AWS ML blog |
| 29 sept. 2026 | BMA ouvre en preview publique dans 3 Régions américaines | AWS What's New |
Les clients de lancement nommés sont Box et Salesforce. Dans l'article de lancement d'Amazon, le CTO de Box, Ben Kus, dit qu'il réunit les modèles d'OpenAI "with the scale, security, and infrastructure of AWS", et Salesforce l'associe à son produit Headless 360 sur la page produit d'AWS.
Si vous avez lu mon guide de l'OpenAI Agents API, la forme vous sera familière : même lignée de harness qu'OpenAI Codex (son tarif est à part), mêmes objets agent, session et événements. La différence tient surtout à qui héberge la boucle et qui signe les requêtes.
Comment fonctionne Bedrock Managed Agents
La documentation d'AWS découpe le service en six parties (documentation AWS) :
- Session : une conversation avec état avec un agent. Elle désigne un modèle, des instructions, des outils, un rôle IAM et un environnement d'exécution.
- Tour : le travail effectué en réponse à un message : raisonnement, appels d'outils et sortie.
- Environnement d'exécution : le calcul que vous fournissez, où les commandes et les outils locaux s'exécutent réellement.
- Exec server : le processus
codex exec-serverqui relie votre environnement à BMA par une connexion sortante. - Items et événements : les items sont la trace durable de ce qui s'est passé ; les événements sont un flux en direct de la progression.
- Rôle de session : le rôle IAM que BMA assume pour appeler le modèle (et, si vous l'utilisez, pour démarrer AgentCore Runtime).
AWS a son propre schéma de la façon dont ces éléments communiquent :
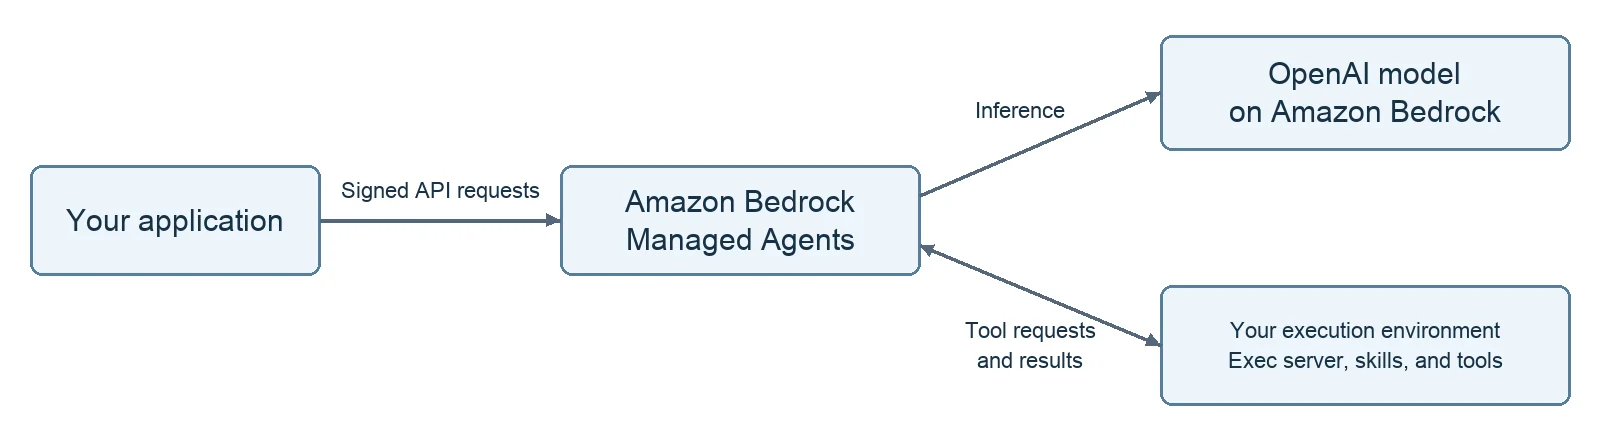
Ce qui m'a surpris, c'est l'encadré en bas à droite. Avec Claude Managed Agents ou l'Agents API hébergée d'OpenAI, vous pouvez laisser l'éditeur exécuter un sandbox pour vous. Avec BMA, il n'existe aucune option de sandbox éditeur. Les outils "execute in the compute environment that you provide" (documentation AWS), donc l'exec server, l'espace de travail, les règles réseau et les éventuels serveurs MCP sont à votre charge.
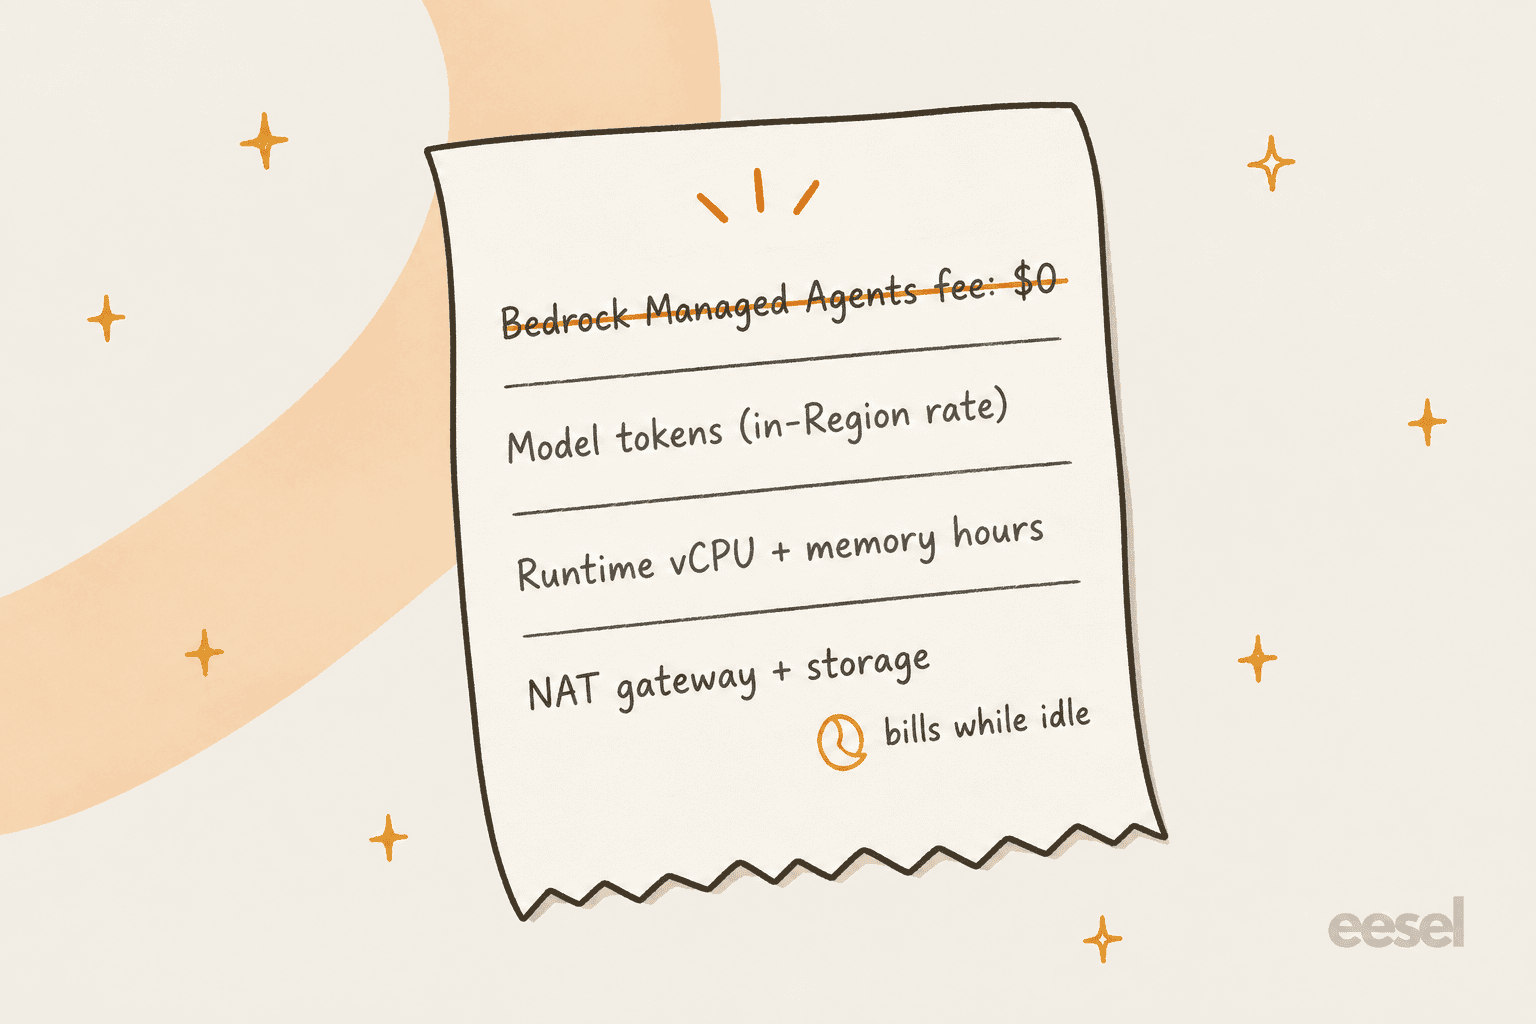
C'est le compromis, le même que je retrouve dans chaque comparatif des meilleurs agents IA. Vous perdez en confort et vous gagnez un discours de sécurité net : l'inférence du modèle, le runtime de l'agent et vos outils restent tous dans AWS, et la page produit d'AWS le dit en toutes lettres : "The agent runtime and model inference remain inside AWS" (AWS).
L'API est petite
La surface REST de la preview compte sept opérations sur le endpoint régional bedrock-mantle, toutes signées avec AWS SigV4 plutôt qu'avec une clé d'API OpenAI (référence de l'API) : créer, lister, récupérer et supprimer une session, soumettre des événements, diffuser des événements et lister des items. Vous envoyez un message en postant un événement agent.session.input.message, puis vous lisez les résultats sur le endpoint des items, de 1 à 100 par page (guide des sessions).
Deux détails de la documentation vous feront gagner une après-midi :
- Une soumission réussie renvoie un corps vide. Cela veut dire "accepté", pas "terminé". L'achèvement apparaît dans l'état de la session, les items et les événements.
- Une session
idlene prouve pas que la tâche a fonctionné. AWS dit de vérifier les items de sortie et, pour les commandes, le code de sortie. Annuler un tour "does not undo side effects from tools that already completed."
Skills et outils
Une skill est un dossier contenant un fichier SKILL.md, placé sous l'un des répertoires de capacités de la session (jusqu'à 32 chemins). Les outils viennent de serveurs MCP STDIO qui tournent dans votre environnement (mon guide du serveur MCP pour agents IA explique le principe), et vous pouvez restreindre chaque serveur avec une liste allowed_tools (skills et outils). Si vous avez déjà utilisé des skills dans Claude Code, le format est assez proche pour vous sentir chez vous.
AWS est franche sur la sécurité : "Treat instructions from documents, websites, and tool responses as untrusted input" (documentation de sécurité). C'est un conseil sur la prompt injection, et il résonne autrement quand l'agent dispose d'un vrai shell sur un vrai hôte.
Où votre agent tourne vraiment : auto-hébergé ou AgentCore
Vous avez deux environnements d'exécution, et le choix détermine l'essentiel du travail de configuration et une partie de votre facture (documentation AWS) :
| Calcul auto-hébergé | AgentCore Runtime | |
|---|---|---|
| Ce que vous fournissez | Un hôte, un espace de travail, un accès réseau et un codex exec-server en cours d'exécution | Un AgentCore Runtime avec l'exec server et son adaptateur intégrés dans un conteneur ARM64 |
| Ce que crée la stack d'exemple d'AWS | Uniquement des rôles IAM (pas d'hôte) | Runtime, VPC avec sous-réseaux privés, 1 NAT gateway, buckets S3 versionnés pour les skills et les sorties, montages S3 Files |
| Qui démarre l'exec server | Vous, dans un second terminal | BMA active le Runtime pour vous |
| Limites de temps de l'exemple | À vous de décider | 28,800 secondes (8 heures) d'inactivité et de durée de vie maximale |
| Adapté à | Machines de développement, conteneurs existants, tests rapides | Calcul géré par session qui reste dans votre compte |
AgentCore est la plateforme d'agents plus large d'AWS, et c'est le calcul par défaut de BMA. L'argument d'AWS est qu'à mesure que vos agents grandissent, vous pouvez vous appuyer sur davantage de ses fonctions : autorisation, découverte d'agents et d'outils, observabilité et évaluation (AWS).
Si vous voulez juste voir quelque chose fonctionner, la voie auto-hébergée est la plus rapide. La voie AgentCore est celle que vous mettriez réellement en production, et c'est aussi là que les coûts absents de la ligne "aucun frais supplémentaire" commencent à s'accumuler.
Ce que la preview inclut, et ce qu'elle laisse de côté
Si vous ne deviez relire qu'une seule section avant de vous engager, que ce soit celle-ci. La page des limitations de la preview d'AWS est inhabituellement claire sur les limites :
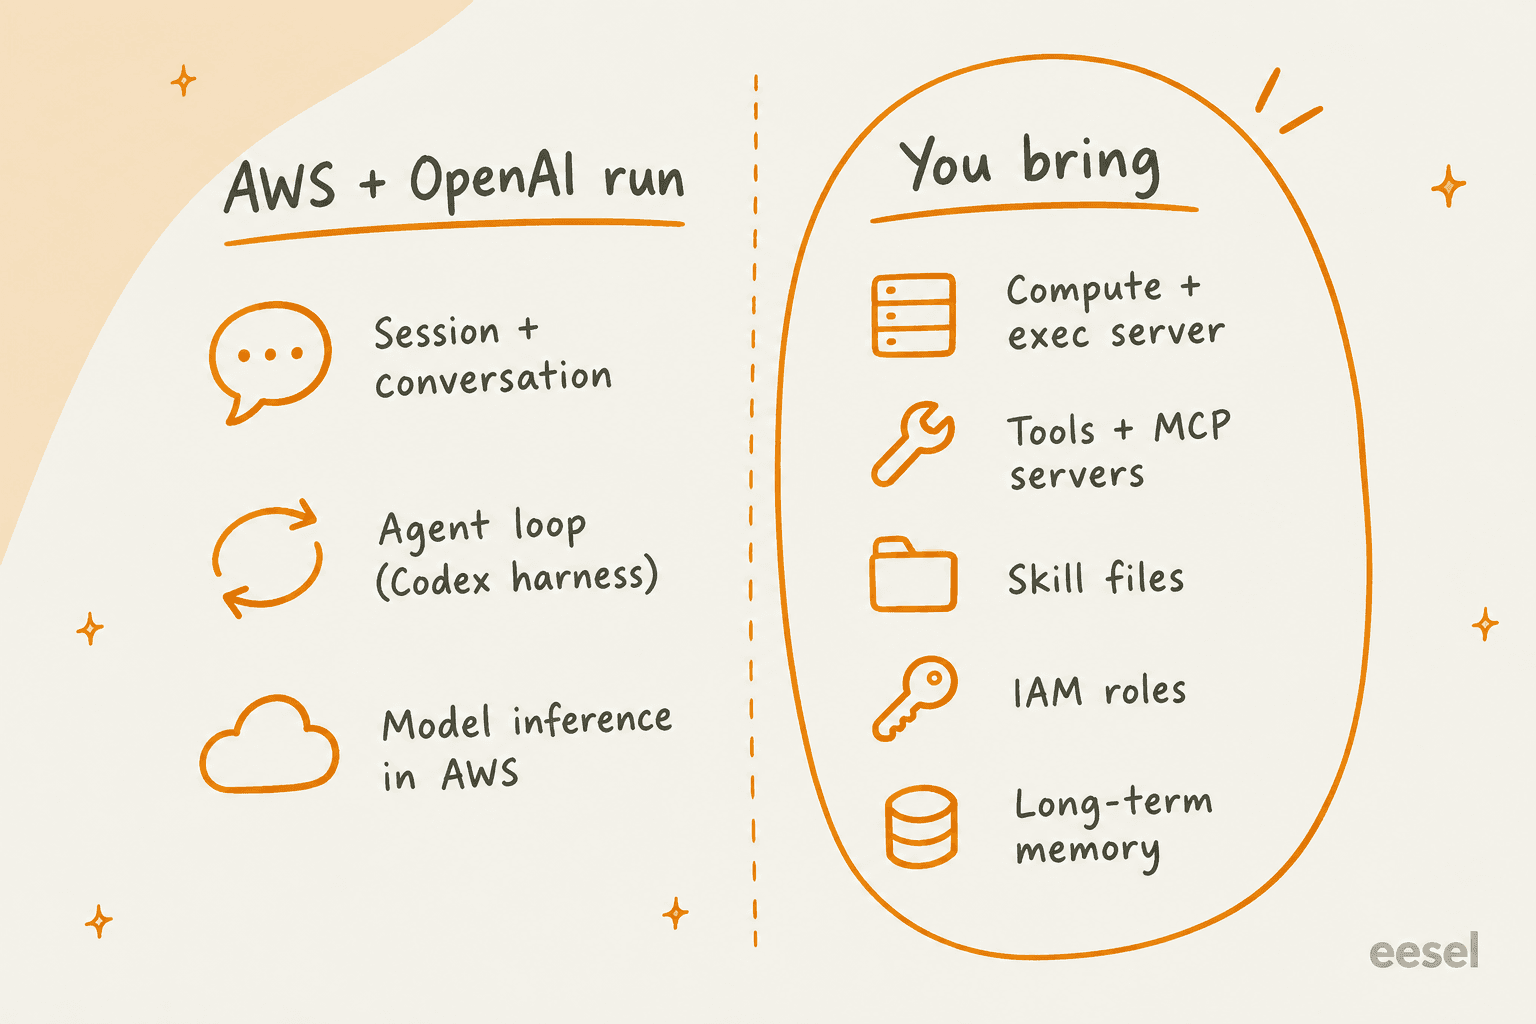
- L'entrée est uniquement du texte. La surface d'entrée de session documentée est du texte.
- Pas de sous-agents, pas de code mode. AWS dit de ne pas les activer dans la configuration d'une session, donc les schémas d'orchestration de sous-agents sont exclus pour l'instant.
- Pas de mémoire à long terme. "The preview does not provide a built-in long-term memory integration; provision and authorize any application-specific datastore separately."
- Pas d'inférence inter-Régions. Ce qui compte pour le prix, comme vous le verrez plus bas.
- Pas de clé KMS gérée par le client pour les données de session gérées par le service.
- Pas de console. Tout passe par l'API et le bundle d'exemple d'AWS.
- Pas d'API dédiée pour lister les tours. Vous corrélez les tours via les valeurs
turn_iddes items.
Il y a un écart facile à manquer. Le message de lancement dit que le runtime géré "handles inference, memory, and skills" (AWS) et que chaque agent "supports human approval before consequential actions", d'après la même annonce de la preview. Sur ces deux points, la documentation développeur dit quelque chose de plus étroit. La mémoire signifie le contexte au sein d'une seule session, et pour les actions ayant des effets externes, le guide de sécurité dit d'"enforce authorization and any required human review in the application or tool implementation" (documentation de sécurité). Le garde-fou human-in-the-loop est donc quelque chose que vous construisez, pas que vous activez.
Pour une preview, rien de tout cela n'est inhabituel. Cela veut toutefois dire que la version utilisable aujourd'hui ressemble plus à "une boucle gérée plus un bon dépôt d'exemple" qu'à une plateforme d'agents finie. La page BMA d'OpenAI ajoute un avertissement à prendre au pied de la lettre : "Shared concepts don't imply identical API contracts or feature availability." Ne copiez pas une requête de l'OpenAI Agents API en espérant qu'elle marche sur Bedrock.
Combien coûte Bedrock Managed Agents
La ligne de tarification d'AWS est courte : "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New). La documentation précise ce que signifient les "ressources sous-jacentes" : l'inférence du modèle plus toutes les ressources AWS que votre application utilise, et l'exemple AgentCore "can continue to incur charges when no BMA turn is running" (documentation AWS).
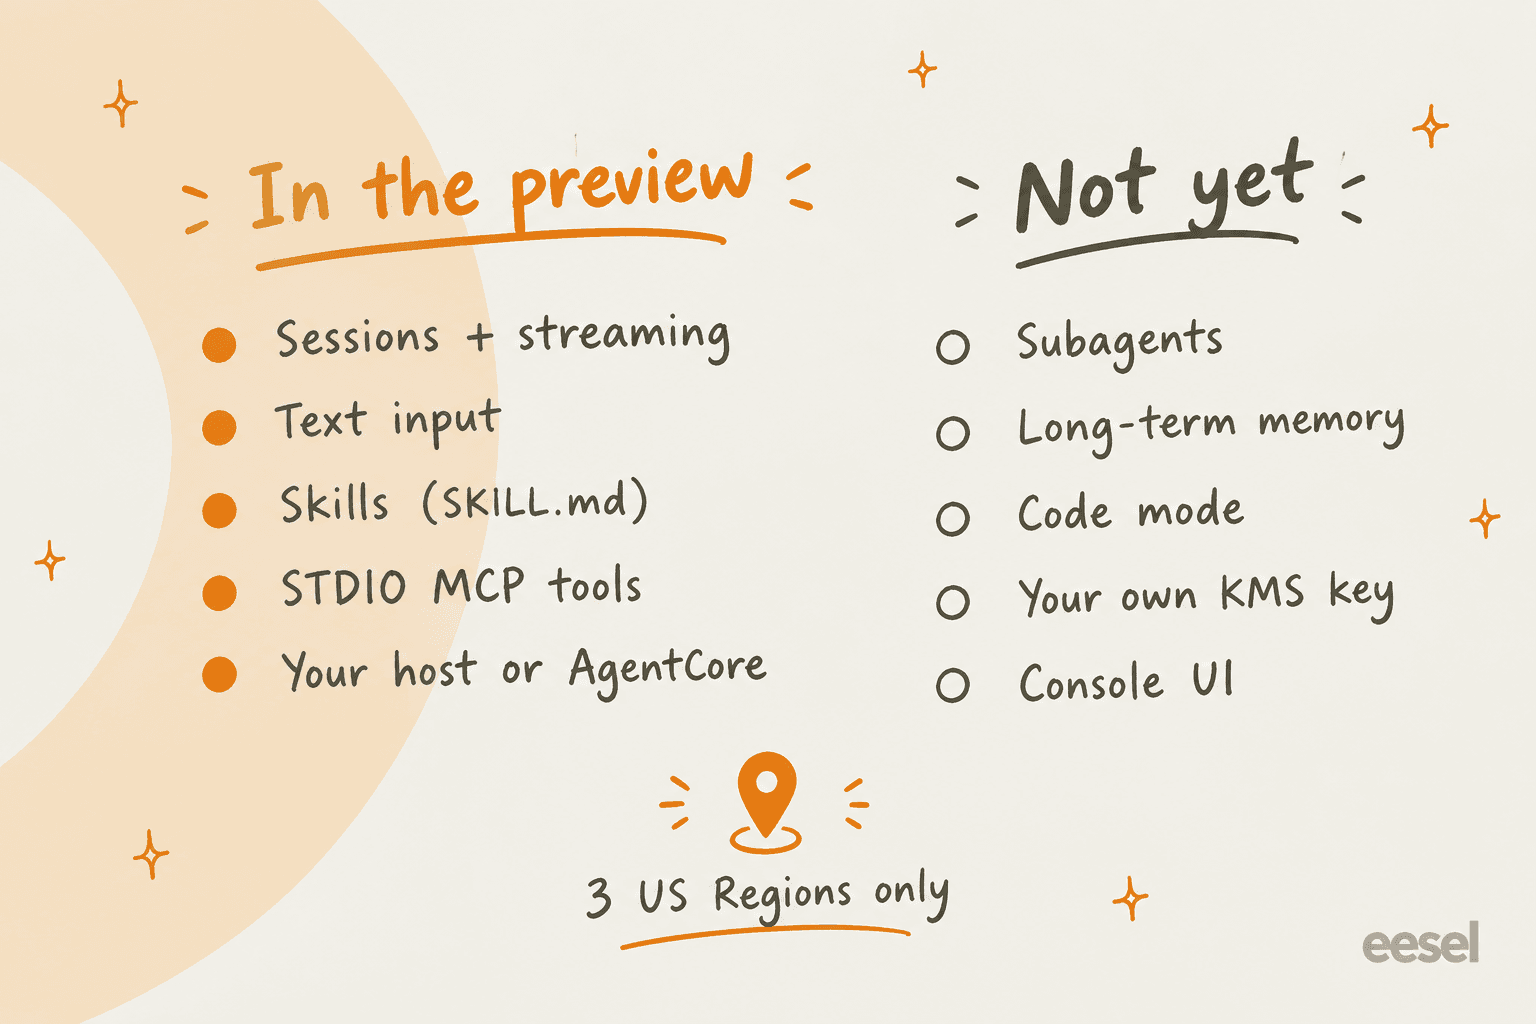
Ligne 1 : les tokens du modèle, au tarif in-Region
Chaque modèle OpenAI sur Bedrock a son prix sur sa fiche de modèle. Le piège est que la preview de BMA ne prend pas en charge les profils d'inférence inter-Régions, donc vous payez le tarif in-Region, et AWS note que "Commercial In-Region prices include a 10% fee over OpenAI rates" (fiche GPT-5.6 Luna). Voici les tarifs en contexte court (272K tokens d'entrée ou moins) par million de tokens :
| Modèle | Entrée (in-Region) | Entrée en cache | Sortie (in-Region) | Tarif global, identique à celui d'OpenAI (ent. / sort.) |
|---|---|---|---|---|
| GPT-5.6 Luna (défaut de l'exemple BMA) | $0.22 | $0.022 | $1.32 | $0.20 / $1.20 |
| GPT-6 Luna | $0.11 | $0.011 | $0.55 | $0.10 / $0.50 |
| GPT-6.1 Sol | $2.20 | $0.11 | $11.00 | $2.00 / $10.00 |
| GPT-5.6 Terra | $2.20 | $0.22 | $13.20 | $2.00 / $12.00 |
| GPT-5.6 Sol | $4.40 | $0.44 | $22.00 | $4.00 / $20.00 |
| GPT-6 Astra | $11.00 | $1.10 | $55.00 | $10.00 / $50.00 |
Chaque tarif vient de la fiche Bedrock du modèle, toutes liées depuis la page des modèles OpenAI d'AWS. AWS ne publie pas de liste fixe des modèles pris en charge par BMA, et la fiche GPT-6.1 Sol indique que le prompt caching explicite n'est pas pris en charge pour ce modèle sur Bedrock, alors vérifiez votre modèle avant de compter sur les remises de cache. Les requêtes en contexte long (plus de 272K en entrée, une fraction de la fenêtre de contexte de plus de 1M) coûtent encore plus cher. GPT-5.6 Sol grimpe à $8.80 en entrée et $33.00 en sortie.
Ligne 2 : les heures de runtime
Si vous utilisez AgentCore Runtime, vous payez ses tarifs de calcul. Sur les microVM v2, c'est $0.1276 par vCPU-heure et $0.0169 par Go-heure, facturés à la seconde, et AWS dit que le CPU n'est pas facturé pendant que l'agent attend des E/S, comme la réponse du modèle (tarifs AgentCore). En auto-hébergé, vous payez simplement ce que coûte déjà votre hôte.
Ligne 3 : la NAT gateway dont personne ne parle
La stack d'exemple AgentCore d'AWS crée une NAT gateway. Au tarif publié pour US East, c'est $0.045 par heure plus $0.045 par Go traité, et les heures partielles sont facturées comme des heures complètes (tarifs Amazon VPC). Laissée allumée un mois (730 heures), cela fait environ $33 par mois avant que votre agent ne fasse quoi que ce soit. Pour une entreprise, c'est une petite somme. C'est pourtant exactement le genre de ligne qui apparaît sur un compte de développement trois mois après que quelqu'un a oublié d'exécuter les étapes de nettoyage.
Un exemple chiffré
Supposons qu'une tâche de l'agent lise une base de code et quelques documents : 200,000 tokens d'entrée, 20,000 de sortie, environ 10 minutes sur une session AgentCore de 2 vCPU / 4 Go.
- Sur GPT-5.6 Luna : $0.044 d'entrée + $0.026 de sortie = environ $0.07 en tokens.
- Sur GPT-5.6 Sol : $0.88 d'entrée + $0.44 de sortie = environ $1.32 en tokens.
- Plafond du runtime : 2 vCPU x $0.1276 + 4 Go x $0.0169 = $0.32 par heure si le CPU était occupé en permanence, soit environ $0.05 pour 10 minutes, et moins en pratique car l'attente du modèle n'est pas facturée en CPU.
À retenir : le choix du modèle fait varier la facture d'environ 19 fois ; le runtime ne la fait presque pas bouger. À faible volume, ce sont les coûts fixes (NAT gateway, stockage) que vous remarquerez, et à fort volume, ce sont les tokens. Si vous voulez le même calcul pour la version hébergée d'OpenAI, mon article sur les tarifs de l'Agents API couvre ses tarifs de conteneur par tranche de 20 minutes, et mon guide des tarifs AWS couvre le reste de la facture AWS.
Comparaison avec les autres runtimes d'agents gérés
Tous les grands laboratoires vendent désormais une version de "nous exécutons la boucle d'agent pour vous". Ce qui les distingue vraiment, c'est l'endroit où vivent deux choses : la boucle et les outils.
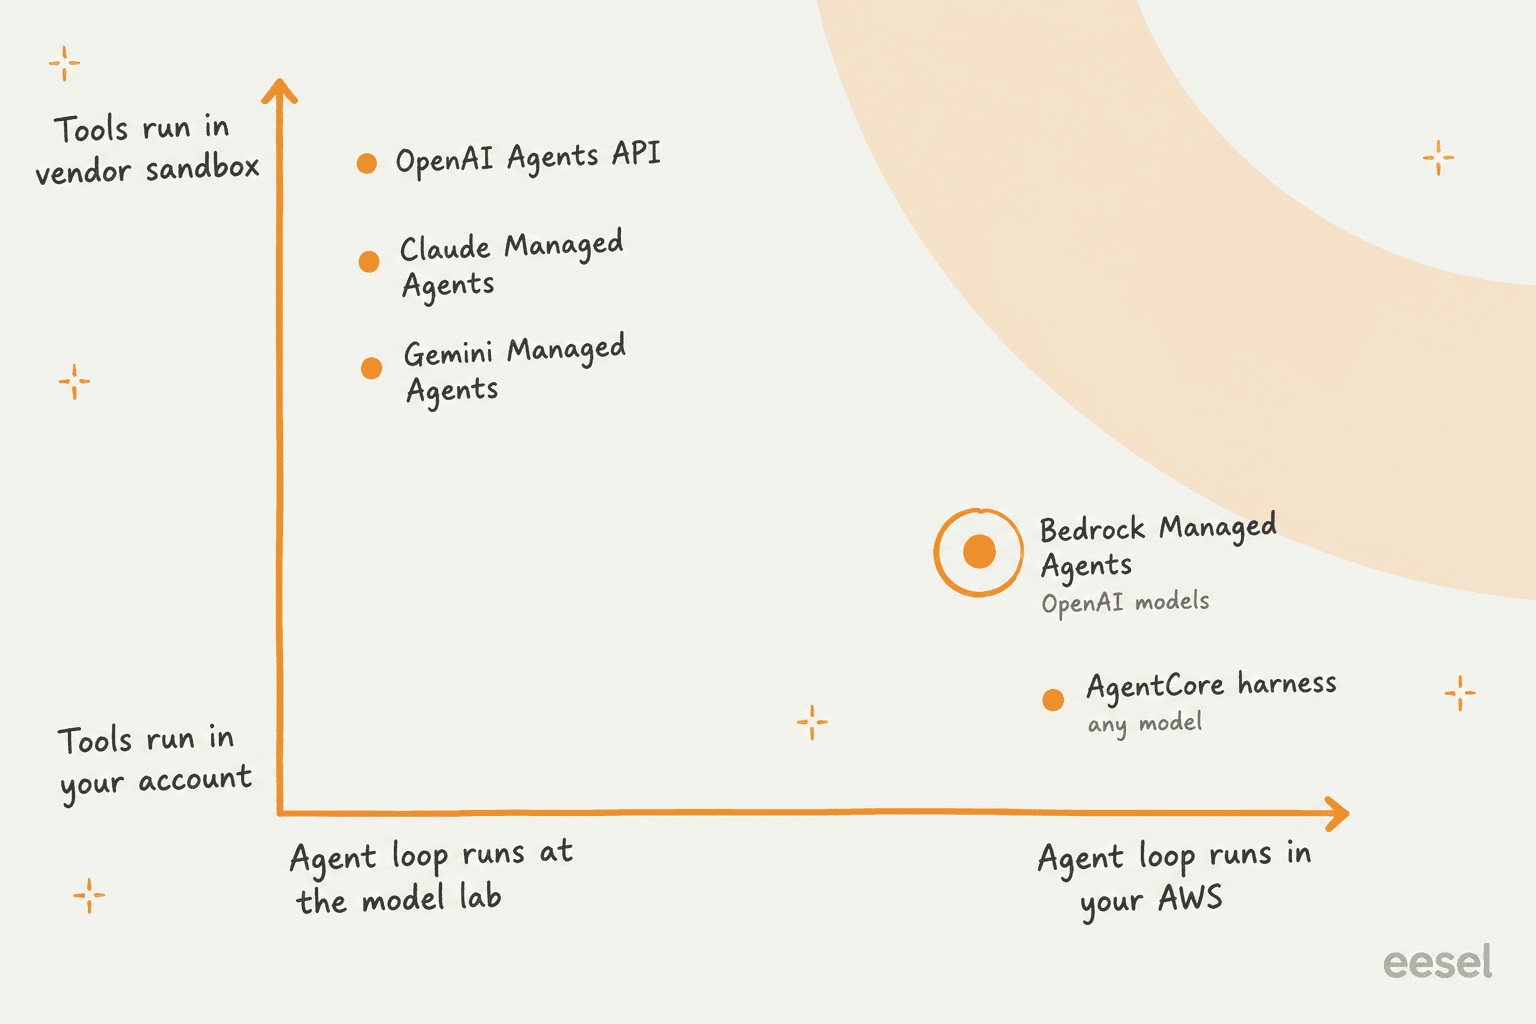
Claude Managed Agents et l'Agents API d'OpenAI proposent aussi des sandboxes auto-hébergés, donc le groupe en haut à gauche est leur mode par défaut plutôt que leur seul mode. Même dans ce cas, l'orchestration reste chez le laboratoire : chez Anthropic, les entrées et sorties des outils continuent de transiter par le plan de contrôle d'Anthropic, et chez OpenAI, choisir un sandbox auto-hébergé ne déplace que l'exécution des outils. BMA est la seule option ici qui garde le harness d'OpenAI, les modèles d'OpenAI et vos outils tous dans AWS.
| Bedrock Managed Agents | Claude Managed Agents | OpenAI Agents API | Gemini Managed Agents | Harness AgentCore | |
|---|---|---|---|---|---|
| Statut | Preview publique, 3 Régions américaines | Bêta | Bêta publique (10 sept. 2026) | Preview publique (19 mai 2026) | Disponibilité générale |
| Modèles | OpenAI sur Bedrock | Claude uniquement | OpenAI uniquement | Gemini uniquement | Bedrock, OpenAI, Gemini, tout fournisseur LiteLLM |
| Où tournent les outils | Votre hôte ou AgentCore uniquement | Sandbox d'Anthropic ou le vôtre | Sandbox d'OpenAI, le vôtre, fournisseurs partenaires, ou aucun | Sandbox de Google (4 CPU / 16 Go) | microVM par session dans votre compte |
| Frais de runtime | Aucun pendant la preview | $0.08 par heure de session en cours d'exécution | $0.03 à $1.92 par conteneur de 20 min ; aucun en auto-hébergé | Calcul non facturé pendant la preview | $0.1276 par vCPU-heure + $0.0169 par Go-heure |
| Mémoire à long terme | Non (preview) | Memory stores | Non publié | Non (fichiers conservés 7 jours) | AgentCore Memory |
| MCP | STDIO dans votre environnement | Serveurs distants + tunnels | Distant ou local | HTTP distant | Via AgentCore Gateway |
| Sous-agents | Non | Oui (multi-agents) | Oui | Non publié | Non publié |
Quelques points de ce tableau méritent un second regard.
Le harness AgentCore est le rival le plus proche de BMA, et il vient aussi d'AWS. Il est en GA, il prend en charge "any model provided by Amazon Bedrock, OpenAI, Google Gemini, or any LiteLLM-compatible provider", et il n'y a pas de frais de harness séparés (harness AgentCore). AWS a aussi placé les Bedrock Agents d'origine en mode maintenance : ils ont été renommés Bedrock Agents Classic et fermés aux nouveaux clients le 30 juillet 2026, AWS orientant les nouveaux projets vers le harness (documentation AWS). Donc, sauf si vous tenez précisément au harness d'OpenAI, je commencerais par là.
Claude Managed Agents est le produit le plus complet aujourd'hui. Il a des memory stores, l'orchestration multi-agents, des sandboxes éditeur et du MCP distant, et il est aussi accessible via Claude Platform on AWS d'Anthropic. Par cette voie, toutefois, c'est Anthropic et non AWS qui traite les données. Si votre exigence est "AWS est le seul sous-traitant de traitement", BMA (ou Claude dans Amazon Bedrock, que j'ai couvert dans Claude Code sur Bedrock) est la réponse la plus nette. Pour une liste plus large, voyez mon tour d'horizon des alternatives à l'OpenAI Agents API.
Comment démarrer avec Bedrock Managed Agents
La voie la plus rapide est l'exemple auto-hébergé d'AWS. Si votre AWS CLI est déjà configurée, comptez une heure. Le tutoriel auto-hébergé d'AWS contient toutes les commandes :
- Installez les outils. Node.js 20+, AWS CLI v2,
curlavec prise en charge de SigV4,jqet Codex CLI 0.154.0 ou plus récent (il inclutcodex exec-server). - Choisissez une Région et un endpoint.
us-east-1,us-west-2ouus-east-2, avec le endpointhttps://bedrock-mantle.<region>.api.aws. - Téléchargez le bundle d'exemple et le binaire Codex qui correspond à votre hôte (toujours Linux ARM64 pour AgentCore).
- Déployez les rôles IAM avec
npm ci,npx cdk bootstrapetnpm run deploydepuis le dossierself-hosted/. Vous obtenez un rôle client et un rôle de session que BMA assume. - Créez une session, attachez l'exec server, soumettez un tour. Les scripts numérotés du bundle (
0.create-session.sh,1.attach-exec-server.sh,2.submit-turn.sh,3.read-result.sh) vous guident pas à pas.
La plupart des premières exécutions échouent sur le modèle IAM. Il y a trois identités : l'appelant (il faut les permissions BMA plus iam:PassRole sur le rôle de session), le rôle de session (approuvé par bedrock-mantle.amazonaws.com et autorisé à bedrock-mantle:CreateInference pour votre modèle) et l'identité que votre environnement d'exécution utilise (documentation de sécurité). La page de dépannage vaut le coup d'être mise en favori avant de commencer, surtout le passage sur la vérification de AWS_PROFILE dans chaque terminal. Utilisez aussi un espace de travail dédié, car "the agent can use the files, tools, and permissions available to that environment."
Ce que disent ceux qui construisent
La preview publique ne s'est ouverte que cette semaine, donc les retours d'expérience sont encore minces. Ce qui existe, ce sont des réactions au lancement de personnes qui vivent dans AWS, et elles s'accordent en grande partie sur l'attrait :
"Bedrock Managed Agents (limited preview): AWS runs OpenAI's agent harness, and all inferences run through Bedrock. Basically, you'd use the OpenAI SDK against AWS-owned infrastructure, and your data stays in AWS.
AgentCore Runtime is the only one that's GA right now, so it's the only viable option if you need something for production."

L'angle de la conformité revient sans cesse dans le fil Hacker News sur le lancement initial :
"This would be a nice compliance win. One less sub-processor and all our data is already on AWS so less worrying about sending it off somewhere else"

Les sceptiques méritent aussi d'être écoutés. L'analyste Mitch Ashley a posé la question de l'enfermement sans détour :
"The question for enterprise architects is whether AgentCore stays open enough to govern non-AWS execution, or quietly becomes the lock-in seam."
Et un commentateur de Hacker News, parlant de la couche de calcul que BMA utilise par défaut, ne s'est pas retenu :
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
Cette dernière phrase, "on top of building our actual product", résume toute l'histoire des runtimes d'agents gérés. Ils réduisent le travail d'infrastructure, mais le travail de produit reste le vôtre.
Qui devrait utiliser Bedrock Managed Agents (et qui ne le devrait pas)
Utilisez-le si vous êtes déjà bien installé dans AWS, que votre équipe sécurité ou achats a validé AWS mais pas un nouveau fournisseur d'IA, et que vous voulez précisément le harness et les modèles d'OpenAI. Le modèle IAM par agent, la journalisation CloudTrail et le discours "rien ne quitte le compte" sont la vraie valeur, et ils sont difficiles à obtenir ailleurs avec les modèles OpenAI.
Attendez si vous avez besoin de sous-agents, de mémoire à long terme, d'entrée d'images ou de quoi que ce soit en dehors de trois Régions américaines. Rien de cela n'est dans la preview, et il n'y a pas de date de GA.
Passez votre chemin si vous n'êtes pas lié aux modèles OpenAI (le harness AgentCore est en GA et agnostique du modèle), ou si vous voulez que l'éditeur exécute aussi le sandbox (Claude Managed Agents ou l'Agents API hébergée d'OpenAI).
Et réfléchissez bien si votre véritable objectif est un agent métier, comme un agent qui répond à des tickets de support. Un agent de support est un produit, pas un runtime. Je rencontre souvent ce cas. Dans les notes de départ de clients d'eesel, plusieurs clients, dont une entreprise de AR et de technologies de la construction et une marque de beauté DTC, sont partis pour construire leur agent de support directement sur une API de LLM. D'autres ont fait l'inverse. Un responsable ingénierie d'une entreprise de matériel pour distributeurs de Bitcoin, avec une base de connaissances de plus de 300 articles dans Confluence, a expliqué à l'équipe d'eesel pourquoi il avait choisi d'acheter :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
BMA raccourcit le chemin du "construire". Il ne supprime ni l'intégration au helpdesk, ni la recherche de connaissances, ni la logique d'escalade, ni les tests. Et ce sont ces parties-là qui prennent des mois.
eesel pour les équipes qui veulent l'agent, pas la plomberie
Bedrock Managed Agents est de l'infrastructure. eesel est l'employé. Plus précisément, eesel est une plateforme de coéquipiers IA où vous embauchez des coéquipiers prêts à travailler pour des missions définies, et pour le support, c'est le coéquipier IA pour helpdesk : il se branche en quelques minutes sur Zendesk, Freshdesk, Gorgias et le reste de votre helpdesk, apprend de vos anciens tickets et de votre centre d'aide, et est exécuté sur des centaines de vos tickets historiques dans une simulation avant de répondre à un vrai client. D'après les propres statistiques clients d'eesel, Gridwise a vu 73 % de ses tickets de niveau 1 résolus dès le premier mois.
Si vous regardiez BMA parce que vous aimez piloter des agents depuis un terminal, eesel a aussi cela. La CLI d'eesel (@eesel/cli) pilote le même coéquipier et le même espace de travail que ceux que vous voyez dans le tableau de bord : connecter des intégrations, modifier les instructions permanentes de l'agent, approuver ou refuser les actions en attente avec eesel approvals, et lire chaque exécution avec eesel activity. Chaque commande affiche du JSON, les commandes d'écriture prennent en charge --dry-run pour voir l'appel exact avant son envoi, et l'authentification sans interface fonctionne en CI. Des agents de code comme Claude Code, Codex et Cursor peuvent la piloter, et chaque espace de travail expose aussi un serveur MCP. C'est la même idée que la conception API-first de BMA, orientée vers un agent de support fini plutôt qu'une boucle vide.
Essayez eesel gratuitement. Les tarifs commencent par un plan gratuit de 100 crédits, puis des plans payants à partir de $299 par mois pour 500, et un ticket ou un chat traité compte pour un crédit.
Questions fréquentes
Qu'est-ce qu'Amazon Bedrock Managed Agents ?
Combien coûte Bedrock Managed Agents ?
Bedrock Managed Agents est-il en disponibilité générale ?
Quelle est la différence entre Bedrock Managed Agents et l'OpenAI Agents API ?
Bedrock Managed Agents a-t-il de la mémoire ?
Quels modèles Bedrock Managed Agents prend-il en charge ?
Faut-il utiliser Bedrock Managed Agents pour le support client ?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.