

En bref
Bedrock Managed Agents (BMA) facture 0 $ pour le service lui-même pendant sa préversion publique, ouverte le 29 septembre 2026. Ce que vous payez réellement, ce sont trois choses : les tokens des modèles OpenAI au tarif in-Region de Bedrock (10 % au-dessus des prix d'OpenAI), le CPU et la mémoire d'AgentCore Runtime si vous l'utilisez, et environ 33 $ par mois pour le NAT gateway de la pile d'exemple d'AWS, facturé même quand rien ne tourne.
Sur une tâche typique de 10 minutes (200K tokens d'entrée, 20K de sortie) avec GPT-5.6 Luna sur AgentCore, j'obtiens environ 0,09 $ par tâche. Avec GPT-5.6 Sol, la même tâche coûte environ 1,34 $. Le modèle choisi fait donc varier la facture d'un facteur 15 environ, alors que la majoration AWS sur cette tâche avec Luna est d'environ un demi-cent. Et AWS dit que le tarif "is subject to change" à la GA.
Mon avis : le tarif de BMA est correct pour les équipes qui ont besoin que les agents OpenAI restent dans AWS. Budgétez simplement le modèle, pas le titre à 0 $. Si l'agent que vous chiffrez est un agent de support, eesel est l'option prête à l'emploi : un forfait mensuel fixe de crédits, avec l'intégration au helpdesk et les tests sur l'historique de tickets déjà en place.
Combien coûte Bedrock Managed Agents ?
La ligne tarifaire d'AWS pour la préversion tient en une phrase : "During preview, there is no additional charge for BMA beyond the underlying AWS resources your agents consume. Pricing is subject to change at general availability" (AWS What's New).
Deux ans de SEO m'ont appris une chose sur les recherches de prix : le mot "gratuit" mène plus de gens à une mauvaise conclusion que n'importe quel autre. Quelqu'un qui cherche "bedrock managed agents pricing" veut le chiffre que verra son équipe finance, et ce chiffre n'est jamais 0 $. La documentation pour développeurs précise ce que couvrent les "ressources sous-jacentes" : "You incur charges for model inference and the AWS resources that your application uses," et l'exemple AgentCore "can continue to incur charges when no BMA turn is running" (AWS docs).
Si le service lui-même est nouveau pour vous, mon guide de Bedrock Managed Agents explique comment s'articulent les sessions, l'exec server et les environnements d'exécution. Cet article ne parle que de la facture.
Voici chaque ligne qui peut apparaître, dans un tableau :
| Poste de coût | Prix en préversion | Unité facturée | Quand cela s'applique |
|---|---|---|---|
| Frais du service BMA | 0 $ | n/a | Toujours (susceptible de changer à la GA) |
| Tokens des modèles OpenAI | Tarif in-Region, p. ex. 0,22 $ en entrée / 1,32 $ en sortie pour GPT-5.6 Luna | Par 1M de tokens d'entrée, en cache et de sortie | À chaque tour |
| CPU d'AgentCore Runtime v2 | 0,1276 $ par vCPU-heure | À la seconde, CPU actif uniquement | Si AgentCore est votre environnement d'exécution |
| Mémoire d'AgentCore Runtime v2 | 0,0169 $ par Go-heure | À la seconde, mémoire inactive récupérée après 120 secondes | Si AgentCore est votre environnement d'exécution |
| NAT gateway | 0,045 $ par heure + 0,045 $ par Go | À l'heure (les heures partielles sont facturées entières) | Pile d'exemple AgentCore d'AWS |
| S3, S3 Files, CloudWatch | Tarifs AWS standard | Stockage et requêtes | Skills, sorties et journaux |
| Calcul auto-hébergé | Ce que coûte votre hôte | Votre facture existante | Si vous lancez vous-même codex exec-server |
Voilà la structure complète. Toutes les lignes ne pèsent pas pareil, donc le reste de l'article porte sur celles qui comptent.
Ligne 1 : les tokens du modèle et la majoration in-Region de 10 %
Chaque modèle OpenAI sur Bedrock affiche ses prix sur sa propre fiche. Le détail qui compte pour BMA figure dans les limitations de la préversion : l'inférence inter-régions n'est pas prise en charge. Autrement dit, chaque requête BMA paie le tarif in-Region, et AWS le dit clairement : "Commercial In-Region prices include a 10% fee over OpenAI rates" (fiche GPT-5.6 Luna).
Voici les tarifs du niveau Standard, contexte court (272K tokens d'entrée ou moins), par million de tokens, pour les modèles OpenAI que j'envisagerais pour un agent, tous issus de leurs fiches Bedrock sur la page des modèles OpenAI d'AWS :
| Modèle | Entrée (tarif BMA) | Écriture en cache | Lecture du cache | Sortie (tarif BMA) | Tarif propre d'OpenAI (ent. / sortie) |
|---|---|---|---|---|---|
| GPT-6 Luna | 0,11 $ | 0,1375 $ | 0,011 $ | 0,55 $ | 0,10 $ / 0,50 $ |
| GPT-5.6 Luna | 0,22 $ | 0,275 $ | 0,022 $ | 1,32 $ | 0,20 $ / 1,20 $ |
| GPT-6.1 Sol | 2,20 $ | 2,75 $ | 0,11 $ | 11,00 $ | 2,00 $ / 10,00 $ |
| GPT-5.6 Terra | 2,20 $ | 2,75 $ | 0,22 $ | 13,20 $ | 2,00 $ / 12,00 $ |
| GPT-5.6 Sol | 4,40 $ | 5,50 $ | 0,44 $ | 22,00 $ | 4,00 $ / 20,00 $ |
| GPT-6 Astra | 11,00 $ | 13,75 $ | 1,10 $ | 55,00 $ | 10,00 $ / 50,00 $ |
Quatre détails de ces fiches changeront votre estimation plus que le tableau ne le laisse penser :
- Le contexte long double l'entrée. Dès qu'une requête dépasse 272 000 tokens d'entrée, le tarif de contexte long s'applique "to the full request," pas seulement au dépassement (fiche GPT-6.1 Sol). Sur GPT-5.6 Sol, cela fait 8,80 $ en entrée et 33,00 $ en sortie. Un agent qui traîne une grande fenêtre de contexte à chaque tour y arrive vite.
- Pas de remises Priority ni Flex. Chaque fiche ci-dessus indique que les niveaux Priority et Flex ne sont pas pris en charge, donc pas de niveau moins cher façon traitement par lots pour les tâches de nuit. Seul Standard existe.
- Le cache n'est pas uniforme. La fiche GPT-6.1 Sol liste des prix de cache mais précise "Explicit prompt caching is not supported for this Bedrock model." Vérifiez la fiche du modèle exact avant de compter sur la remise de 90 % en lecture de cache.
- Les modèles les plus récents n'existent que dans une région. Sur le endpoint
bedrock-mantlequ'utilise BMA, GPT-6 Luna et GPT-6.1 Sol ne sont disponibles qu'enus-east-1. Si vous déployez en Oregon ou en Ohio, vous êtes sur la famille GPT-5.6.
La génération la plus récente est aussi la moins chère au token ici : GPT-6 Luna coûte moitié moins que GPT-5.6 Luna, en entrée comme en sortie. Si vous comptiez de toute façon prendre un Luna, testez d'abord GPT-6 Luna. Mes articles sur les tarifs de GPT-6 Luna et les tarifs de GPT-6.1 Sol les comparent au reste de la gamme OpenAI.
Ligne 2 : les heures d'AgentCore Runtime
BMA n'exécute pas lui-même vos outils ; ils tournent sur du calcul que vous fournissez : votre propre hôte, ou Amazon Bedrock AgentCore Runtime, qui est le choix par défaut dans l'exemple d'AWS. Si vous utilisez AgentCore, vous payez ses tarifs de runtime (tarifs AgentCore) :
| Ressource AgentCore Runtime | Tarif à la consommation | Base engagée |
|---|---|---|
| CPU microVM v2 | 0,1276 $ par vCPU-heure | 0,0997 $ par vCPU-heure (lancement d'ici octobre 2026) |
| Mémoire microVM v2 | 0,0169 $ par Go-heure | 0,0132 $ par Go-heure (lancement d'ici octobre 2026) |
| CPU microVM v1 | 0,0895 $ par vCPU-heure | n/a |
| Mémoire microVM v1 | 0,00945 $ par Go-heure | n/a |
| Instances de runtime (EC2) | Tarif On-Demand EC2 | plus 12 % de frais de gestion |
Ce modèle de facturation est plus favorable aux agents qu'il n'y paraît. AWS dit que le CPU "scales to zero during I/O wait (waiting for LLM responses, tool / API calls, or database queries)," et que sur v2 "idle memory is reclaimed automatically" après 120 secondes. Comme un agent passe l'essentiel de sa vie à attendre le modèle, la plupart de son temps réel ne facture aucun CPU.
La page de tarifs d'AWS contient un exemple chiffré proche d'un agent de support : 1 million de sessions par mois, 10 minutes chacune, 90 % d'attente d'E/S, 1 vCPU et jusqu'à 2,5 Go. Son total est de 0,006703 $ par session, soit 6 703 $ par mois pour le million. Et c'est uniquement le runtime, avant d'avoir payé le moindre token.
Un point de vigilance : l'exemple AgentCore de BMA fixe le délai d'inactivité et la durée de vie maximale du runtime à 28 800 secondes, soit huit heures. La mémoire inactive est bien récupérée, mais une session oubliée reste une session.
Ligne 3 : le NAT gateway qui facture pendant que votre agent dort
La pile d'exemple AgentCore d'AWS crée un VPC avec des sous-réseaux privés, un endpoint de passerelle S3 et un NAT gateway. D'après les tarifs d'Amazon VPC en US East, un NAT gateway coûte 0,045 $ par heure plus 0,045 $ par Go traité, et les heures partielles sont facturées comme des heures entières.
Sur un mois de 730 heures, cela fait 32,85 $ avant que votre agent ne fasse quoi que ce soit. Pour une équipe en production, c'est peu. Sur un compte de développement où quelqu'un a testé l'exemple un vendredi puis l'a oublié, c'est une ligne qui revient chaque mois jusqu'à ce que quelqu'un lance les étapes de nettoyage. C'est pourquoi la documentation d'AWS elle-même suggère d'exécuter l'exemple dans un compte de développement.
Les autres lignes de stockage (buckets S3 pour les skills et les sorties, montages S3 Files, journaux CloudWatch) se comptent normalement en centimes à volume de test. Comme elles évoluent avec ce que l'agent écrit, mieux vaut les vérifier sur votre facture AWS une fois en production.
Ce que coûte réellement une tâche d'agent
Voici l'exemple chiffré que j'utilise. Une tâche où l'agent lit du code et de la documentation, puis écrit un résultat. Cela représente 200 000 tokens d'entrée et 20 000 de sortie, sans cache, 10 minutes sur une session AgentCore de 2 vCPU / 4 Go où le CPU est occupé 20 % du temps.
- Runtime : 120 secondes occupées x 2 vCPU x 0,1276 $ par heure = 0,0085 $, plus 600 secondes x 4 Go x 0,0169 $ par heure = 0,0113 $. Disons 0,02 $, et moins si v2 récupère la mémoire inactive.
- Tokens sur GPT-5.6 Luna : 0,2M x 0,22 $ + 0,02M x 1,32 $ = 0,070 $.
- Tokens sur GPT-5.6 Sol : 0,2M x 4,40 $ + 0,02M x 22,00 $ = 1,32 $.
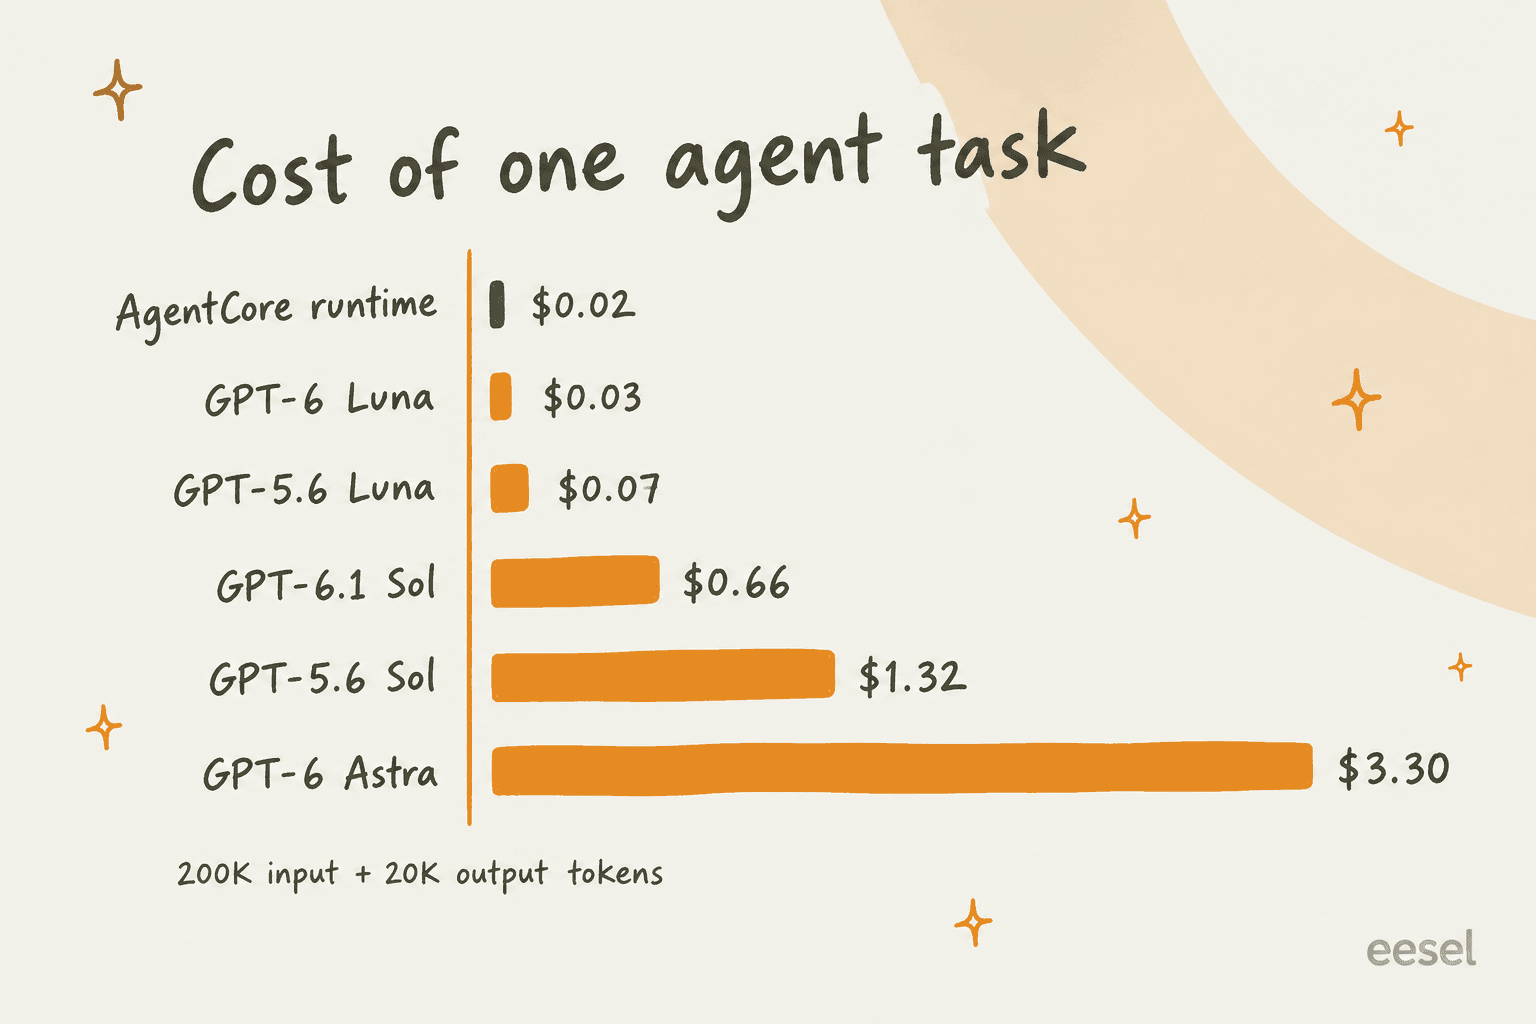
Si vous ne deviez retenir qu'une chose de cet article, retenez ce graphique. Le runtime est la plus petite barre du graphique. Passer de GPT-6 Luna à GPT-6 Astra sur la même tâche multiplie le coût en tokens par 100, alors que le runtime AgentCore reste autour de deux centimes. Si vous voulez réduire une facture BMA, le levier, c'est le choix du modèle. Ajuster les vCPU ne change presque rien.
Voici comment cela évolue sur un mois avec GPT-5.6 Luna, NAT gateway laissé actif :
| Tâches par mois | Tokens | Runtime AgentCore | NAT gateway | Total mensuel | Par tâche |
|---|---|---|---|---|---|
| 1 000 | 70 $ | 20 $ | 33 $ | 123 $ | 0,123 $ |
| 10 000 | 704 $ | 198 $ | 33 $ | 935 $ | 0,093 $ |
| 100 000 | 7 040 $ | 1 977 $ | 33 $ | 9 050 $ | 0,091 $ |
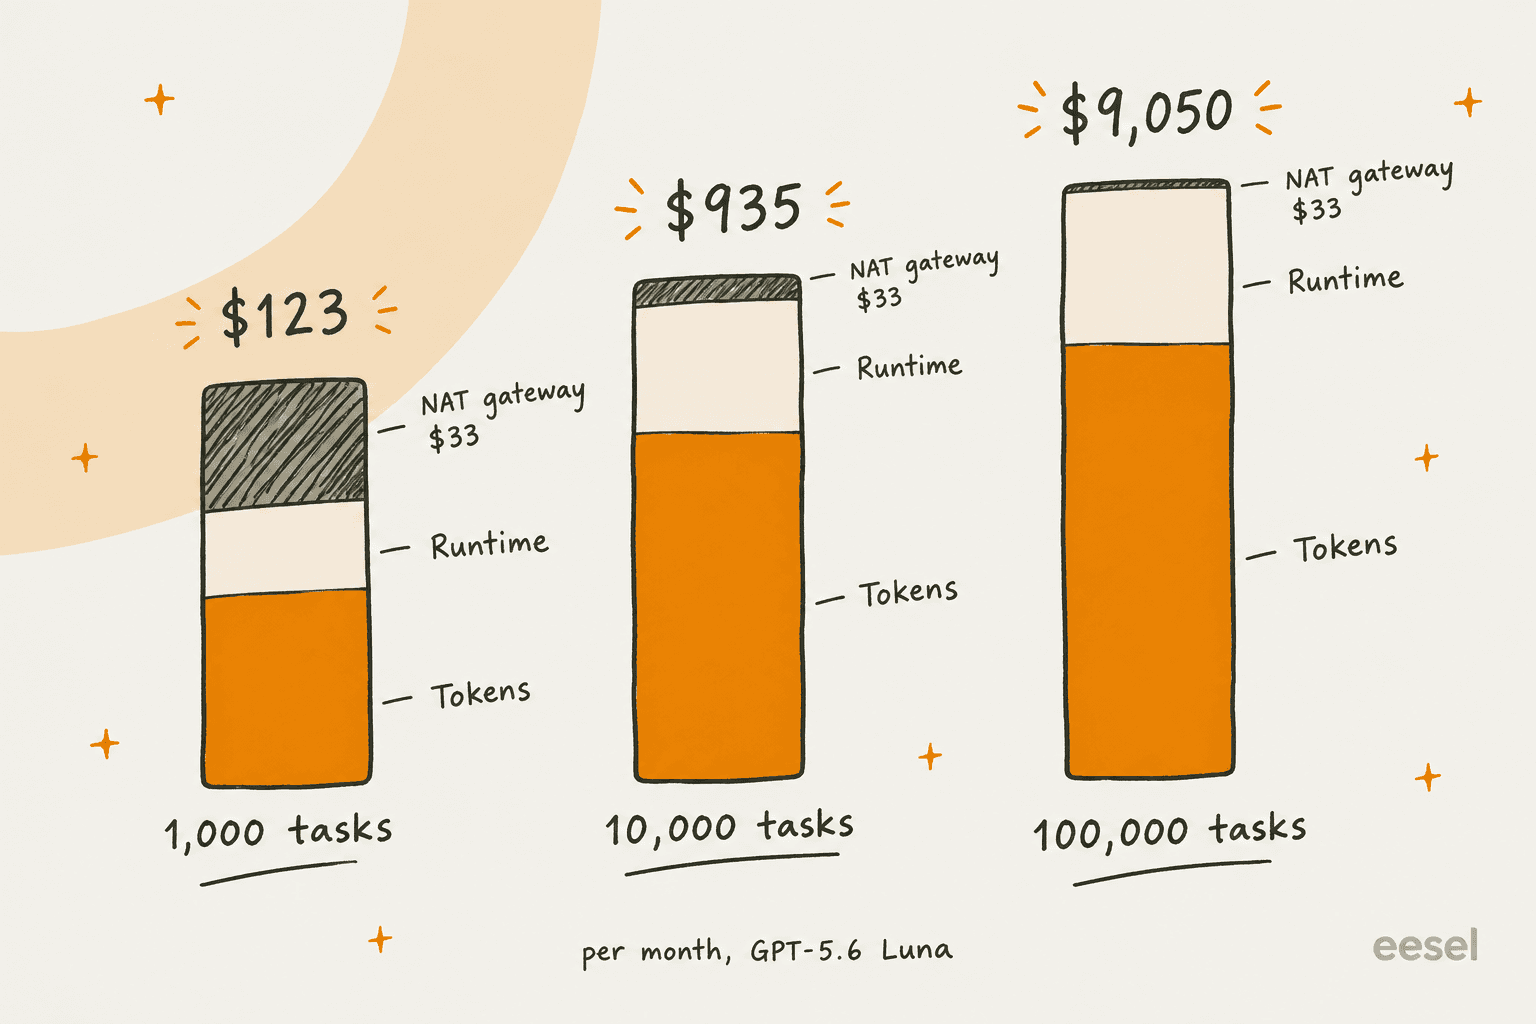
À faible volume, le NAT gateway fixe représente plus d'un quart de la facture. À 100 000 tâches, ce n'est plus que du bruit et les tokens pèsent près de 80 %. Le conseil s'inverse donc selon l'échelle : les petites équipes devraient auto-héberger ou démonter la pile d'exemple entre deux tests, et les grandes devraient concentrer leurs efforts sur le choix du modèle et le prompt caching (rendre le contexte répété mis en cache).
Vous pouvez saisir vos propres chiffres dans le calculateur ci-dessous, qui utilise les mêmes tarifs que les tableaux ci-dessus :
La majoration de 10 % d'AWS vaut-elle le coup ?
Je pense que c'est la question que se posent vraiment la plupart des acheteurs. La réponse est plus favorable à AWS que le titre ne le laisse penser. Voici la même tâche de 10 minutes sur GPT-5.6 Luna, chiffrée de quatre façons :
| Configuration | Tokens | Runtime | Par tâche |
|---|---|---|---|
| API OpenAI Agents, sandbox auto-hébergé | 0,064 $ (tarif OpenAI) | 0 $ | 0,064 $ |
| Bedrock Managed Agents, auto-hébergé | 0,070 $ (tarif in-Region) | 0 $ | 0,070 $ |
| Bedrock Managed Agents sur AgentCore | 0,070 $ | environ 0,020 $ | 0,090 $ |
| API OpenAI Agents, conteneur hébergé de 4 Go | 0,064 $ | 0,06 $ | 0,124 $ |
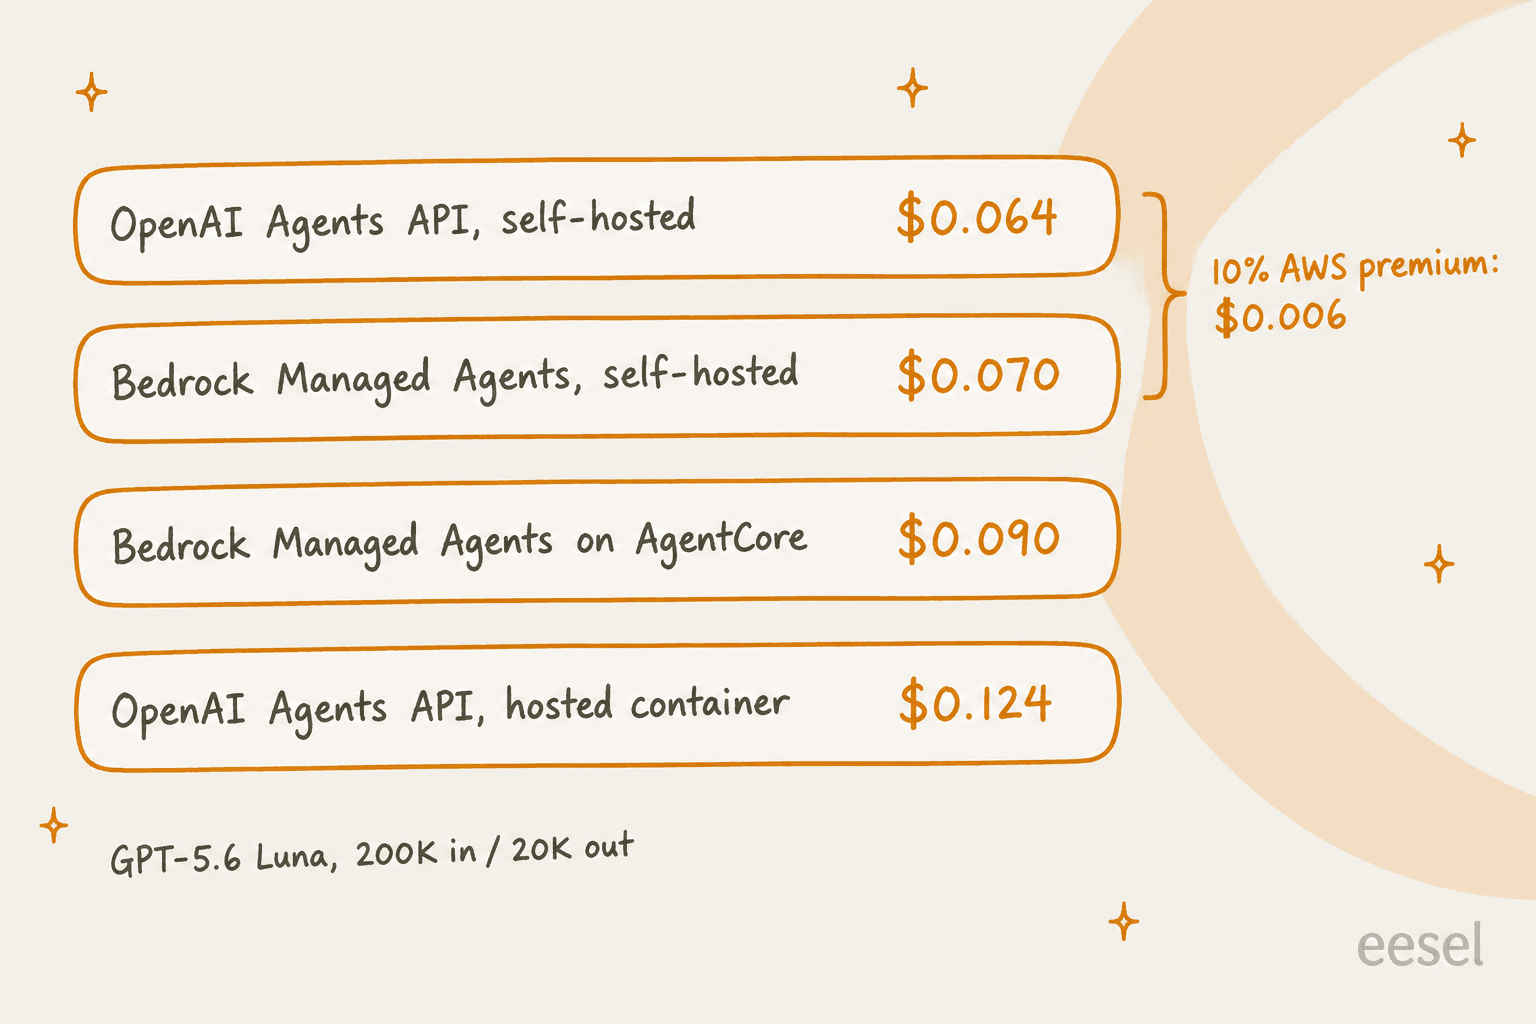
La ligne du conteneur hébergé utilise le tarif publié par OpenAI de 0,12 $ par session de 20 minutes pour un conteneur de 4 Go, facturé à la minute avec un minimum de 5 minutes (tarifs OpenAI). Mon article sur les tarifs de l'API Agents passe en revue toutes les tailles de conteneur.
La majoration AWS sur cette tâche est donc d'environ 0,006 $. C'est de l'argent réel à un million de tâches par mois (6 400 $ environ), mais c'est moins que l'écart entre le conteneur hébergé d'OpenAI et la facturation d'AgentCore qui tient compte des E/S. Si vous alliez sinon utiliser le sandbox hébergé d'OpenAI, BMA sur AgentCore peut revenir moins cher par tâche, pas plus cher. Si vous auto-hébergiez dans les deux cas, BMA vous coûte exactement ces 10 %.
Ce que la majoration achète, c'est la partie qui compte lors d'une revue de sécurité : le runtime de l'agent, l'inférence du modèle et vos outils restent dans votre compte AWS, sous le contrat d'AWS. La logique d'achat a été bien résumée par un commentateur de Hacker News :
"A lot of companies already have data processing agreements and compliance sign-off for using AWS. Many are hesitant to send their data to AI startups with an incentive to train their models and a history of being.... loose with how they intake training data. Even when they do give assurances otherwise. AWS is more trusted in this aspect. If this ends up similar to Claude on Bedrock, it's the same price."

Ce n'est pas tout à fait le même prix, mais c'est proche : 10 % de plus pour la garantie in-Region. Si votre entreprise a déjà la paperasse AWS signée et mettrait des mois à valider un nouveau fournisseur d'IA, ces 10 % sont probablement le travail de conformité le moins cher que vous achèterez cette année.
Comment le tarif de BMA se compare aux autres runtimes d'agents managés
Chaque grand laboratoire vend désormais une boucle d'agent managée, et chacun facture le runtime à sa façon. Les tokens sont toujours en plus, aux tarifs de modèle de chaque fournisseur :
| Runtime | Frais de runtime | Unité facturée | Modèles |
|---|---|---|---|
| Bedrock Managed Agents | 0 $ en préversion, plus votre calcul | n/a | OpenAI sur Bedrock |
| Claude Managed Agents | 0,08 $ par heure de session | Temps à l'état running | Claude uniquement |
| API OpenAI Agents | 0,03 $ à 1,92 $ par conteneur de 20 minutes | À la minute, minimum de 5 minutes | OpenAI uniquement |
| Gemini Managed Agents | Calcul non facturé en préversion | n/a | Gemini uniquement |
| AgentCore harness | Pas de frais de harness, plus AgentCore Runtime | CPU et mémoire à la seconde | Tout modèle Bedrock, OpenAI, Gemini ou compatible LiteLLM |
Aujourd'hui, deux d'entre eux sont gratuits côté runtime, et ce sont tous deux des préversions. C'est le schéma à retenir : les prix de lancement sont généreux dans cette catégorie, et aucun laboratoire n'a dit combien coûtera sa préversion une fois disponible de façon générale.
L'AgentCore harness est la seule option native AWS déjà disponible de façon générale, indépendante du modèle et sans frais de harness distincts. Sauf si vous tenez précisément au harness d'OpenAI, il offre la même facturation de runtime et plus de choix de modèles. Claude Managed Agents ajoute des frais de runtime mais propose plus de fonctionnalités aujourd'hui : memory stores, multi-agents et sandboxes fournisseurs. Mon article sur les tarifs de l'API Anthropic couvre le volet tokens de cette comparaison, et le tour d'horizon des alternatives à l'API OpenAI Agents couvre le reste du paysage.
Il y a aussi un angle stratégique qu'un post LinkedIn a mieux formulé que moi :
"Near-zero switching costs between frontier models on the same bill sounds like a buyer's market. It is, for now. When you can swap Claude for GPT-5.5 with a one-line code change, models start looking interchangeable, and the platform hosting them all owns the customer relationship and the pricing power."

C'est une raison de garder le code de votre agent portable, pas d'éviter BMA.
Coûts cachés à budgéter
Les grilles tarifaires sont assez claires. Ce qui surprend les équipes, c'est ce qui ne figure sur aucune grille :
- Les frais de GA que personne n'a annoncés. AWS n'a publié ni tarif ni date post-préversion. Si vous voulez une valeur provisoire, les 0,08 $ par heure de session de Claude ajouteraient environ 0,013 $ à la tâche de 10 minutes ci-dessus. Prenez cela comme un scénario budgétaire, pas comme une prévision.
- La croissance du contexte au fil des tours. Chaque tour renvoie la conversation jusque-là, donc une tâche de 20 tours peut coûter bien plus que 20 fois le premier tour. Le cache aide sur les modèles qui le prennent en charge, et le seuil de contexte long de 272K fait mal sur les autres.
- Ce que BMA n'inclut pas encore. La préversion n'a pas de mémoire à long terme intégrée, donc AWS dit de "provision and authorize any application-specific datastore separately" (limitations de la préversion). Si vous ajoutez AgentCore Memory, il en coûte 0,25 $ par 1 000 nouveaux événements plus 0,75 $ par 1 000 enregistrements à long terme stockés par mois (tarifs AgentCore).
- La relecture humaine. Pour les actions à effets externes, la documentation de sécurité vous demande d'appliquer vous-même l'autorisation et toute relecture human-in-the-loop. C'est du temps d'ingénierie, pas une ligne de la facture AWS.
- Le temps d'ingénierie, tout simplement. C'est la plus grosse ligne de toutes, et elle n'apparaît jamais sur la facture AWS.
Sur ce dernier point, il vaut la peine d'écouter les critiques d'AgentCore eux-mêmes :
"There's not really a good solution, as AgentCore runtime sucks and is expensive. You basically have to build this yourself because nobody is solving for self-hosted managed infra for agents, and we don't really have the time to build this sort of system on top of building our actual product."
D'après les chiffres ci-dessus, je ne suis pas d'accord pour dire que le runtime est cher. Mais la seconde moitié de ce commentaire est le vrai coût de tout runtime managé : construire le produit reste à votre charge.
Bedrock Managed Agents vaut-il le coup pour un agent de support ?
C'est là que je vois le plus souvent le calcul dérailler. Quelqu'un chiffre un agent de support sur BMA, voit environ neuf centimes par conversation et décide que ce sera quasi gratuit. Le calcul des tokens est juste, lui aussi. Mais il oublie l'intégration au helpdesk, la recherche dans votre base de connaissances, les règles d'escalade, les tests sur de vrais tickets et l'ingénieur d'astreinte qui le maintient.
Chez eesel, je l'ai vu se produire dans les deux sens pendant des années. Un client de taille moyenne qui est parti après une intégration cassée et un support lent a dit à l'équipe eesel "long term we will just build our own, which is so possible now with AI." Et dans l'autre sens : un responsable ingénierie d'une entreprise de matériel avec une base de connaissances de plus de 300 articles a expliqué pourquoi ils avaient choisi d'acheter :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Les deux sont des choix raisonnables. Si vous avez des ingénieurs qui veulent maîtriser un agent IA et que vous avez besoin de modèles OpenAI dans AWS, le tarif de BMA ne sera pas ce qui vous arrête. Si vous comparez BMA à l'embauche d'un agent prêt à l'emploi, comparez le coût total de construire ou acheter plutôt que la seule facture de tokens. Mon guide sur la création d'agents de support liste toutes les pièces auxquelles vous vous engageriez.
eesel : l'agent de support à prix fixe
Si ce que vous chiffrez réellement, c'est un coéquipier IA pour le helpdesk, eesel retire le compteur de tokens du budget. Il se branche sur Zendesk, Freshdesk, Gorgias et le reste de votre helpdesk et apprend de vos anciens tickets et de votre centre d'aide. Avant de répondre à un vrai client, il est testé en simulation sur des centaines de vos tickets historiques.
Les tarifs sont un forfait de crédits plutôt qu'une facture de tokens : un forfait gratuit avec 100 crédits, puis des forfaits payants à partir de 299 $ par mois pour 500 crédits, où un ticket ou un chat traité vaut un crédit, avec toutes les fonctionnalités et des sièges illimités. La finance peut mettre ce chiffre dans un tableur sans deviner la croissance du contexte, et côté support client, Gridwise a vu 73 % de ses demandes de niveau 1 résolues dès le premier mois.
Et si vous regardiez BMA parce que vous voulez piloter des agents depuis un terminal ou un script, la CLI eesel le permet avec le même coéquipier que vous voyez dans le tableau de bord. Vous pouvez connecter des intégrations, modifier ses instructions, approuver ou refuser des actions en attente et lire son activité, avec une sortie JSON et --dry-run sur les écritures. Elle peut aussi être pilotée par des agents de code comme Claude Code, Codex et Cursor, ce que j'ai traité dans mon article sur les CLI d'agents IA.
Essayez eesel gratuitement et voyez ce que coûte un agent de support quand la plomberie est déjà faite.
Questions fréquentes
Combien coûte Bedrock Managed Agents ?
Bedrock Managed Agents est-il gratuit pendant la préversion ?
Pourquoi le tarif de Bedrock Managed Agents est-il plus élevé que celui de l'API OpenAI ?
Quelle est la façon la moins chère d'exécuter Bedrock Managed Agents ?
Les tarifs de Bedrock Managed Agents changeront-ils à la disponibilité générale ?
Dois-je construire un agent de support sur Bedrock Managed Agents pour économiser ?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.





Comment les tarifs de Bedrock Managed Agents se comparent-ils à Claude Managed Agents ?