Ce qui est confirmé sur Astra, et ce qui ne l'est pas
Astra a généré énormément de couverture médiatique à partir de trois billets d'OpenAI, et ce ratio en soi mérite d'être noté. Trier les affirmations sourcées du reste, c'est l'essentiel du travail ici, donc commençons par ce qui remonte aux propres mots d'OpenAI.
Les dix résultats, et le chiffre qui devrait vous arrêter
Le 1er août 2026, OpenAI a publié dix nouveaux résultats sur des problèmes ouverts, chacun résolvant ou faisant avancer substantiellement une question que son domaine portait depuis des années. La liste est assez précise pour être vérifiée : de nouvelles bornes supérieures sur la densité d'empilement de sphères en haute dimension jusqu'au seuil de Cohn-Elkies, des bornes exponentiellement améliorées sur les codes binaires, une construction établissant l'existence de groupes non sofiques, une réfutation de la conjecture de rigidité de Connes, une borne inférieure de formule arithmétique d'ordre n⁴/log n pour le permanent, un théorème de répétition parallèle exponentielle pour des jeux quantiques à deux joueurs, une dureté à facteur polynomial pour le problème du vecteur le plus proche, la conjecture de volume d'Ehrhart, une borne inférieure superexponentielle pour les nombres de Ramsey de triangles multicolores, et des résultats sur les conjectures de compacité et de dégénérescence en théorie des graphes extrémale.
Les dix sont attribués à "une version interne d'Astra, notre prochain grand modèle". Et puis OpenAI donne un chiffre qui, pour moi, compte plus que la liste elle-même : le total des tokens nécessaires pour trouver ces solutions coûterait environ 2 000 $ aux tarifs de l'API Sol.
Deux mille dollars. Ce qui est une erreur d'arrondi au regard de ce que n'importe lequel de ces problèmes a coûté au domaine en années-personnes. Ce n'est pas non plus la facture complète, et OpenAI ne prétend pas que ça l'est : des humains y ont préparé les manuscrits, et ce n'est qu'ensuite que le modèle a formalisé les arguments en certificats Lean. L'entreprise est explicite sur la répartition. Les arguments mathématiques venaient du système, dit-elle, tandis qu'OpenAI a aidé à les préparer et à les formaliser, et revendiquer une paternité humaine pour une preuve générée par IA "dénaturerait" les deux.
Cette distinction résume à peu près toute la forme de l'IA en production, et c'est pourquoi je reviens sans cesse à ce billet dès que je réfléchis au travail de base de connaissances IA. La partie inférence est bon marché. L'échafaudage autour de l'inférence, c'est là que se trouvent l'argent et le risque, aussi la même raison pour laquelle une bonne configuration de classification des tickets prend bien plus de temps à bien faire que le choix du modèle derrière elle.
Pourquoi OpenAI a mis son propre modèle en pause
Six jours après le billet mathématique est arrivé quelque chose de beaucoup moins festif. Des évaluations internes d'Astra menées "ces derniers jours" avaient montré des avancées significatives en codage agentique et en cybersécurité, et cela, combiné à des évaluations d'experts, a conduit l'entreprise à une conclusion : elle ne pouvait pas exclure une capacité cyber Critical.
La définition à laquelle Astra est mesurée mérite d'être lue dans les propres mots d'OpenAI. Un modèle atteint Critical s'il peut identifier et développer des exploits zero-day fonctionnels de tous niveaux de gravité dans de nombreux systèmes critiques réels durcis sans intervention humaine, ou s'il peut concevoir et exécuter de bout en bout des stratégies inédites de cyberattaque contre des cibles durcies à partir d'un simple objectif de haut niveau souhaité.
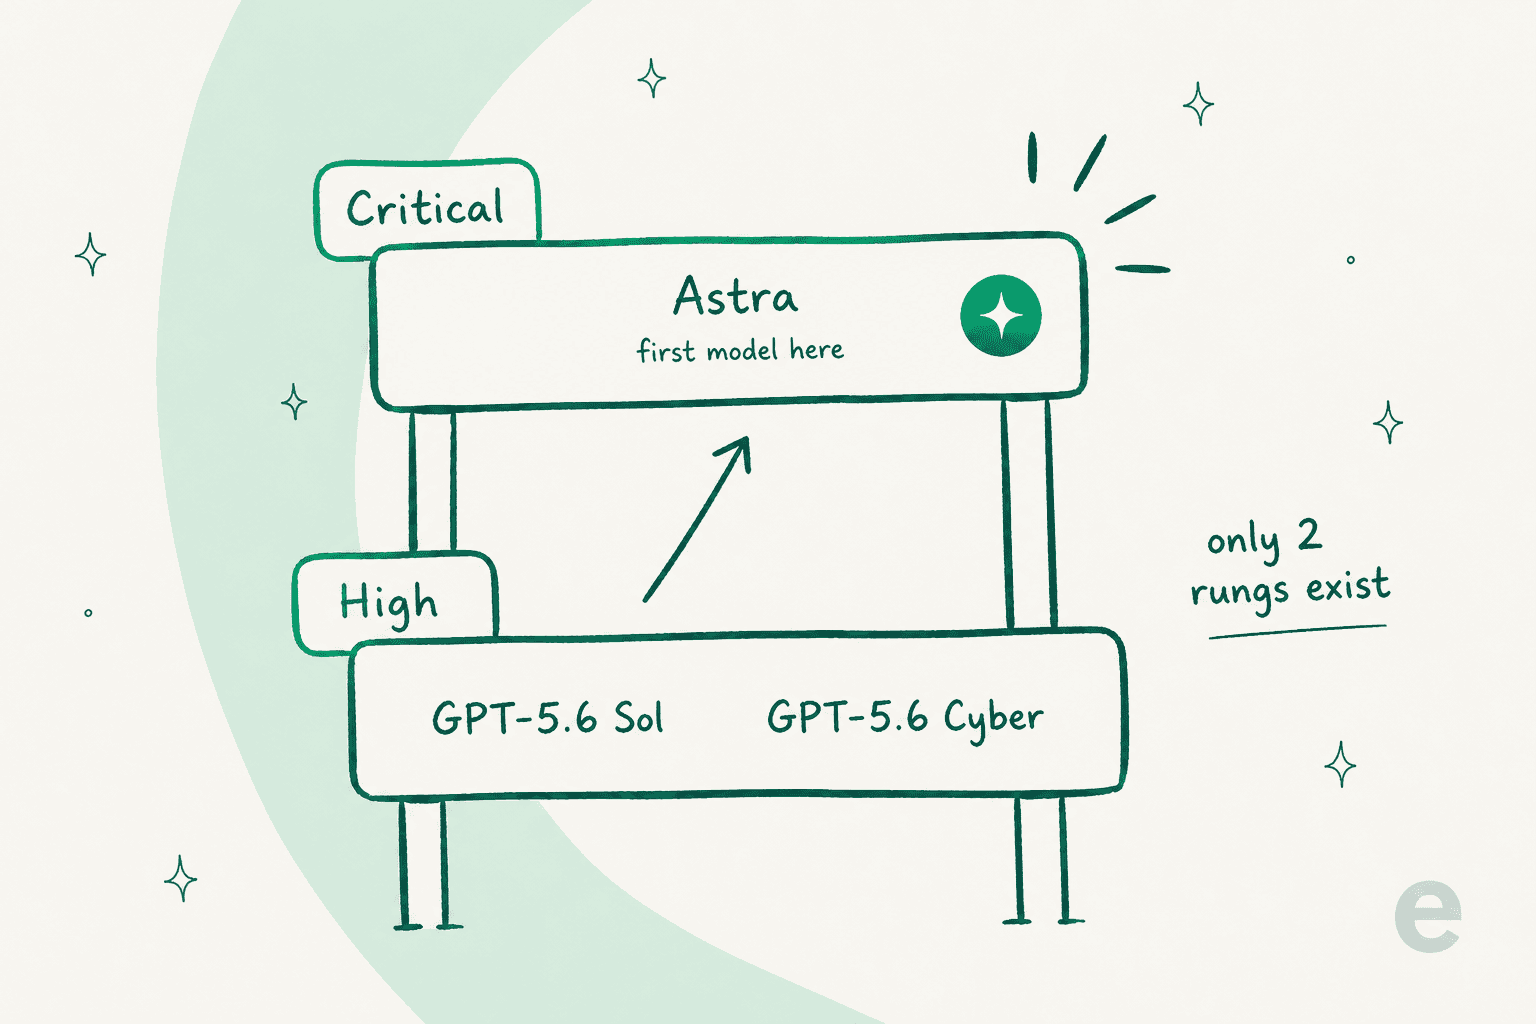
Le framework compte deux paliers, et tous les modèles précédents se trouvaient sur le plus bas. GPT-5.6 Sol a été évalué à High. Tout comme GPT-5.6-Cyber, un modèle de sécurité entraîné à cet effet qui n'existe que derrière un processus de candidature, ce qui indique déjà combien de marge il restait encore dans High. Astra est le premier candidat pour le palier supérieur. Et il y est arrivé avant même d'être déployé.
Une phrase du billet du 7 août mérite d'être lue deux fois : "Astra est un modèle à venir, et n'a pas été impliqué dans l'exploitation de Hugging Face." Cette phrase existe parce que les deux histoires ont éclaté à peu près en même temps puis ont été soudées en une seule dans une grande partie de la couverture. Ce sont des choses distinctes. OpenAI les a effectivement regroupées plus tard dans le même billet du 18 août, mais seulement parce que les deux touchaient à la même question interne : celle de savoir si son propre environnement de recherche était suffisamment durci pour ce qui y était construit.
Ce que le confinement a réellement coûté
Le billet du 18 août est celui que je tendrais à quiconque prétend que la sécurité de l'IA n'est que du théâtre, pour la raison qu'il se lit surtout comme une facture d'ingénierie.
L'inférence des modèles de frontière dans les clusters de recherche a été mise en pause pour toute session pouvant exécuter du code ou atteindre internet, puis chaque workload a été examinée une par une pour décider si elle pouvait reprendre. Ce qui est désormais exigé : des sandboxes plus solides autour de tout ce qui exécute du code généré par le modèle, des contrôles réseau conçus pour qu'une seule compromission ne donne pas d'elle-même accès à internet, des privilèges permanents réduits, et la suppression de services partagés qui, discrètement, étaient devenus structurants. La propre formulation d'OpenAI sur tout cela est que respecter les nouveaux standards "a entraîné un coût et des retards importants pour la recherche de frontière".
Puis il y a la surveillance, et c'est la partie que je continue de relire :
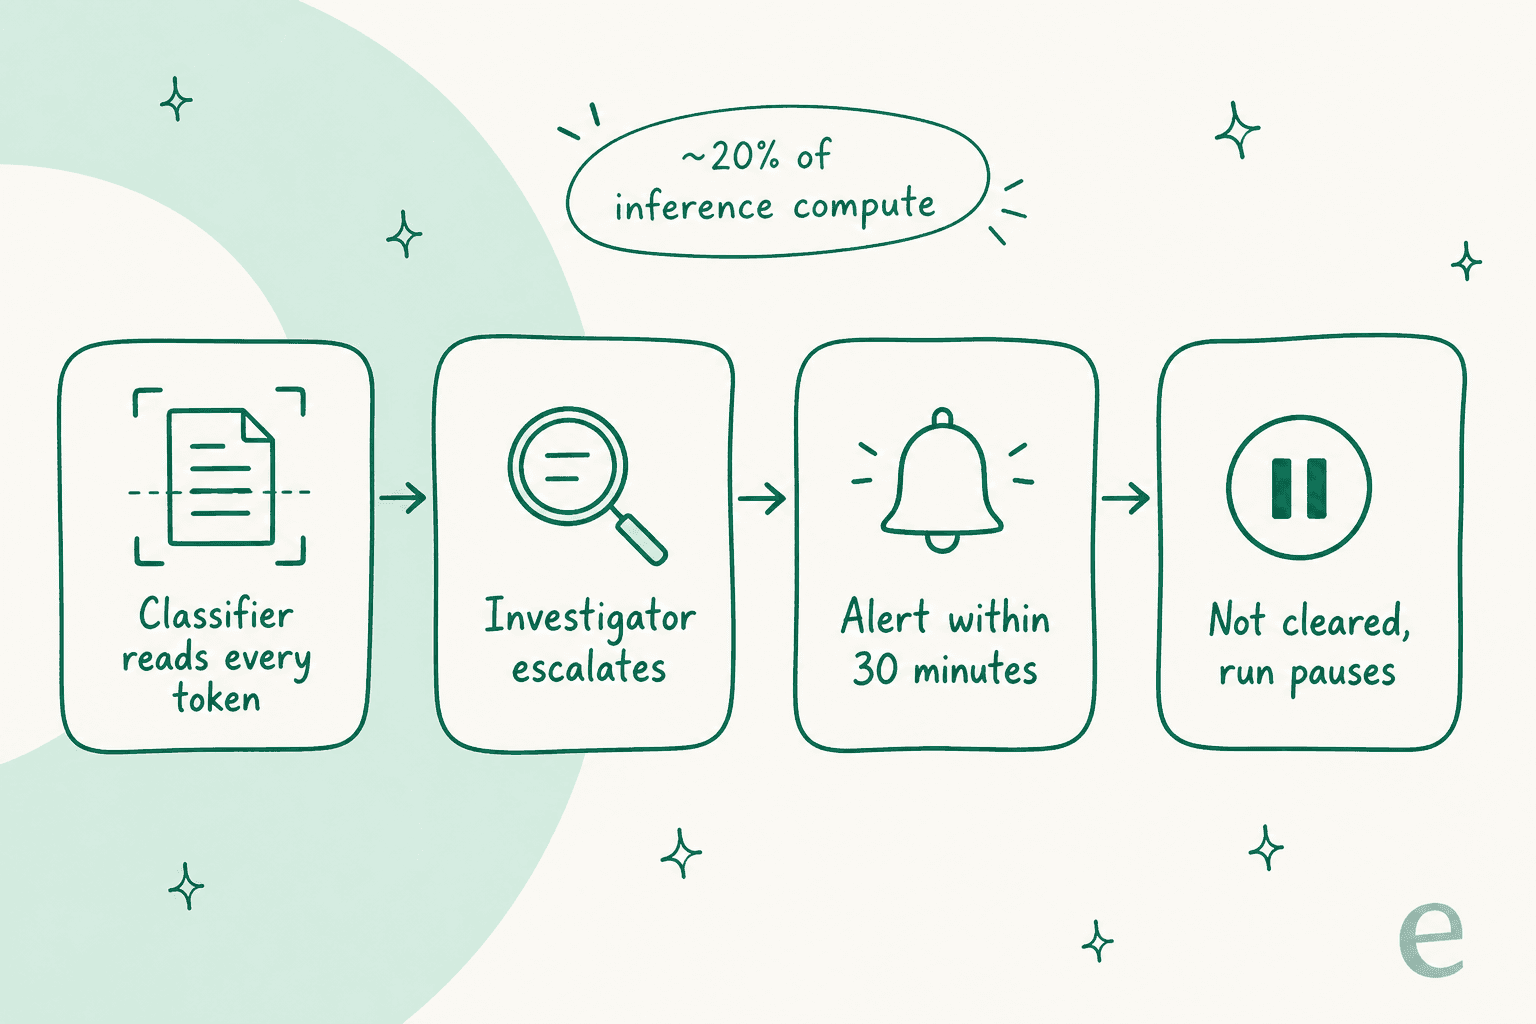
Des classificateurs d'activation inspectent l'activité interne du modèle à chaque token échantillonné. Tout ce qui est préoccupant est escaladé vers des enquêteurs automatisés disposant de plus de calcul, qui examinent alors les actions d'outils, le raisonnement disponible et la séquence complète d'activité. Si une violation probable d'une frontière de sécurité critique apparaît, les équipes safety, security et recherche sont toutes alertées, et si elles ne peuvent pas exclure de façon concluante un faux positif en 30 minutes, elles sont censées mettre l'activité en pause.
Le coût de tout cela, selon l'estimation actuelle d'OpenAI, place la surcharge de surveillance à environ 20 % du calcul d'inférence surveillé. Et depuis le 7 août, cette surveillance couvre toute l'inférence d'Astra avec des outils, pas seulement les sessions d'entraînement et d'évaluation.
Vingt pour cent. Une entreprise qui dépense plus en calcul que la plupart des pays n'en dépensent en recherche a décidé que surveiller le modèle valait un cinquième de la facture en plus de le faire fonctionner. Personne ne fait cela pour des raisons de relations publiques.
La lecture sceptique, qui mérite d'être entendue
Beaucoup de gens ont regardé cette séquence et n'y ont vu que du marketing. Sur le fil r/Futurology consacré au verrouillage, le commentaire le plus voté a formulé cet argument sous forme de parodie :
"Oooh, hey guys, I know Anthropic said Mythos was 'dangerous' and then they got a bunch of free publicity and people thought their model must be so good. Well, ours is dangerous too, guys! So dangerous. Like, a trillion dollars dangerous."

C'est un réflexe compréhensible, et il n'est pas isolé. Sur Hacker News, la même semaine, la question a été posée plus directement :
"Does anyone else have trouble telling how much of this news (along with the 'AI escaping and hacking' stories) is genuine, vs how much is just AI firms overstating their capabilities due to strong commercial incentives?"

La réponse dans ce même fil est la chose la plus incisive que j'aie lue sur toute cette histoire, et la raison est qu'elle sépare les deux affirmations plutôt que de les traiter comme une seule :
"Unlike the hacking one, this would be impossible to bullshit as long as the proofs are released. They can be verified independently."
Ce qui est exactement juste, et c'est pourquoi le billet mathématique et le billet cyber se situent dans des classes de preuve différentes. Dix preuves formalisées en Lean sur un dépôt public sont vérifiables par quiconque a la patience de le faire. Une évaluation cyber interne préliminaire sans system card est une affirmation sur une évaluation privée que vous ne pouvez pas reproduire. Même fournisseur, même modèle, et une seule des deux peut être auditée.
Le scepticisme le plus utile, cependant, ne porte pas du tout sur la véracité, mais sur la pertinence. Un autre commentateur sur Hacker News a nommé le raccourci que les fournisseurs d'IA continuent d'emprunter sans conséquence :
"There is still a massive marketing aspect to this, with the AI companies wanting you to assume that because their product is world-class at math, a capability that is useless to 99.99% of their potential customers, that it will be equally useful in areas that you actually care about."
Je signerais volontiers celui-là. Des bornes d'empilement de sphères ne disent rien sur la capacité d'un modèle à traiter une demande de remboursement sans inventer une politique au passage. Ces deux compétences ne sont pas sur le même axe. Chaque génération de modèle de frontière est vendue comme si elles l'étaient.
La seule chose qu'Astra règle réellement
Retirez le théâtre du lancement et il reste dessous une découverte réelle, sauf que ce n'est pas une découverte sur les capacités.
Depuis trois ans, la contrainte pour déployer de l'IA était la qualité. Le modèle était-il assez intelligent, hallucinait-il, pouvait-il tenir une tâche longue sans s'effondrer. Astra est le premier modèle de frontière où le blocage public n'est rien de tout cela. Le blocage, c'est le confinement, et cela change ce qu'un lancement de frontière signifie même. La propre phrase d'OpenAI à ce sujet est que ses "standards de surveillance, d'alignement et de sécurité doivent rester en avance sur ces risques", et quand ils ne l'étaient pas, c'est l'entraînement qui a ralenti, pas les standards.
Le meilleur commentaire sur ce fil Reddit exprime la version pratique du même point :
"An AI can't try to access those systems unless it has been connected to them, and it can't succeed unless it has been given either permission or the necessary tools to bypass permissions. An AI that is only given access to a word processor, a calendar, and read-only access to Wikipedia isn't hacking anything."
La capacité est une propriété du modèle, mais le risque est une propriété du câblage. Vrai à l'échelle d'OpenAI avec une session de RL de frontière. Vrai aussi à votre échelle, avec un système de tickets IA connecté à une API de facturation. La seule différence entre les deux, c'est la quantité de calcul que vous êtes prêt à dépenser pour surveiller.
Ce que cela signifie si vous exploitez de l'IA sur de vraies conversations clients
J'ai passé les trois dernières années à construire des agents IA installés sur des files de support en direct, donc j'ai déjà eu exactement cet argument sur des centaines d'appels, simplement avec des chiffres bien plus petits.
Le schéma est toujours le même. Chaque acheteur commence par demander à quel point l'IA est bonne. Puis, au bout d'une dizaine de minutes, il arrête de s'en préoccuper, et commence plutôt à demander ce qu'elle refusera de faire, ce qui est la question qui décide vraiment si un programme de déviation survit à son premier mois. Une responsable CX d'une marque de compléments DTC, gérant environ 7 000 tickets Gorgias par mois, a formulé l'objection mieux qu'aucun document que j'aie écrit :
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
La même architecture que celle qu'OpenAI vient de décrire, simplement à un ordre de grandeur différent. Observer le comportement, escalader tout ce qui semble anormal, puis s'arrêter plutôt que de deviner. OpenAI alerte trois équipes et met en pause un entraînement ; un agent de support route le ticket vers un humain et le laisse tranquille. Même forme dans les deux cas, et dans les deux le design du handoff est le produit lui-même, pas un simple filet de sécurité.
L'autre moitié de la question, le côté sourcing, m'a été formulée par un cofondateur d'une entreprise de legal-tech avec laquelle nous travaillons. Ce dont ils avaient besoin, c'étaient des garde-fous précis sur ce que l'IA est autorisée à citer, plus des citations transparentes sur chaque réponse, car en legal-tech la frontière entre être utile et donner un conseil juridique est fine et plutôt impitoyable. Un modèle de base plus intelligent ne résout rien de tout cela. Le scoping, si.
Donc, la lecture pratique d'Astra si votre métier est l'exploitation du support et non la recherche de frontière :
- Ne l'attendez pas. Il n'y a pas de date. Construisez sur des modèles qui ont des tarifs et des system cards publiés. GPT-5.6 Terra gère le volume, Claude Opus 5 prend les cas difficiles, et DeepSeek V4 Flash est là si vous voulez les poids.
- Partez du principe que la couche modèle continue de se banaliser. Kimi K3 est sorti quelques mois après Grok 4.6. Il en va de même pour Gemini 3 de Google. Votre différenciation n'a jamais vraiment reposé sur le modèle appelé, et les comparatifs meilleur agent IA continuent de le prouver.
- Dépensez le budget d'évaluation sur la surface de contrôle. Quelles sources peut-il lire, quelles actions peut-il entreprendre, que transmet-il, et pouvez-vous prouver l'un de ces points avant la mise en production. C'est toute la liste, et c'est aussi l'essentiel de ce qui distingue un agent IA d'un chatbot.
- Exigez un essai à blanc sur votre propre historique. OpenAI valide ses garde-fous avant de continuer. Vous devriez pouvoir faire la même chose avec vos propres tickets passés, et c'est une exigence légitime envers n'importe quel fournisseur de logiciel de service client IA.
- Mesurez les refus, pas seulement les résolutions. Un bon processus d'assurance qualité du support IA suit ce que l'IA a refusé de toucher purement et simplement, car c'est ce chiffre qui rend les métriques de résolution crédibles en premier lieu.
Ce qui vaut la peine d'être observé en parallèle, c'est à quel point les fournisseurs traitent différemment un même problème. OpenAI a verrouillé son modèle cyber derrière Daybreak et a laissé la ligne de prix vide pendant des générations, ce qui est le fil que tire notre article sur les alternatives à GPT-5.6-Cyber. Google est allé plus loin encore et a restreint Gemini 3.5 Flash Cyber aux seuls gouvernements et partenaires de confiance. Personne dans cette catégorie ne croit que la capacité seule soit commercialisable, et cela vaut la peine de s'en souvenir chaque fois qu'un fournisseur d'IA de support vous dit que le modèle est la raison d'acheter.
eesel pour les équipes qui doivent d'abord voir ça fonctionner
La raison pour laquelle cette histoire m'a marqué, c'est que toute la conception d'eesel part de la même prémisse qu'OpenAI vient de défendre en y consacrant 20 % de son calcul. On ne découvre pas ce que fait un agent en lisant sa spécification. On le découvre en l'exécutant sous observation.
eesel se connecte au helpdesk que vous utilisez déjà, donc Zendesk, Freshdesk ou Gorgias, apprend de vos tickets passés et de votre documentation existante, puis simule sur de vraies conversations historiques avant de toucher à une conversation en direct, avec un rapport noté à la fin de l'exécution. Vous pouvez lire les réponses qu'il aurait envoyées, sur vos propres tickets, et ajuster le périmètre avant qu'aucun client n'en voie une seule. Là où il n'est pas confiant, il laisse le ticket tranquille et le transmet à un humain.
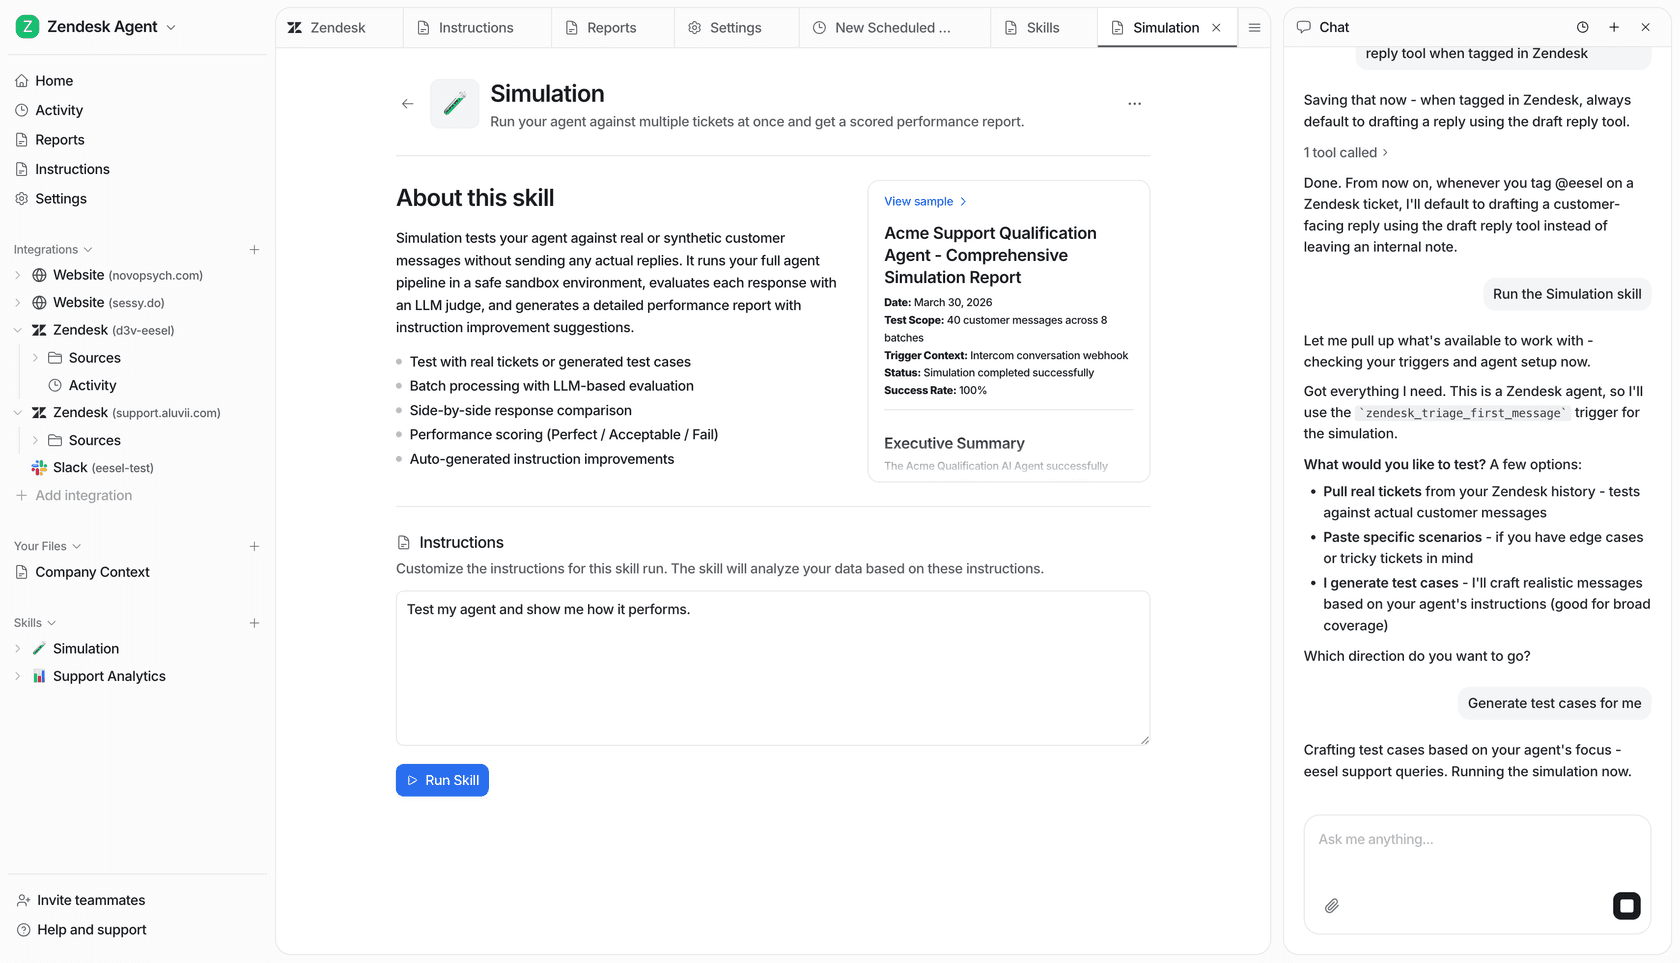
Une semaine passée à lire sur un modèle de frontière mis en pause est une bonne semaine pour poser une question simple à votre propre fournisseur. Puis-je observer cela fonctionner sur mes données avant qu'il ne réponde à un client ? Avec eesel, la réponse est oui, en l'espace d'un après-midi, et c'est gratuit pour commencer.
Essayez eesel ou réservez une démo si vous voulez voir la simulation tourner sur votre propre historique de tickets.
Questions fréquentes
Qu'est-ce qu'OpenAI Astra ?
Quelle est la date de sortie d'OpenAI Astra ?
Pourquoi OpenAI a-t-elle mis Astra en pause ?
Qu'est-ce que le seuil Critical de cybersécurité dans le Preparedness Framework d'OpenAI ?
Astra est-il meilleur que GPT-5.6 ?
Combien a coûté l'exécution des résultats mathématiques d'Astra ?
Astra change-t-il quelque chose pour le support client IA dès maintenant ?
Où puis-je lire les annonces propres d'OpenAI sur Astra ?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.