

Combien coûte l'OpenAI Decisions API en ce moment ?
Rien que vous puissiez réellement payer pour l'instant. OpenAI a annoncé la Decisions API au DevDay le 29 septembre 2026, et le récapitulatif du DevDay 2026 la décrit comme une API qui concentre « Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers ». En pratique, vous envoyez du texte ou des images, vous recevez une réponse tirée de votre propre liste, puis vous utilisez cette réponse pour classer du contenu, router des demandes ou choisir la prochaine étape d'un agent.
Je construis des intégrations et des API chez eesel, alors naturellement, la première chose que j'ai faite a été d'essayer de l'appeler. Voici ce qui est public et ce qui ne l'est pas, tel que je l'ai revérifié le 2 octobre :
| Question | Réponse aujourd'hui | Où j'ai vérifié |
|---|---|---|
| Y a-t-il un prix ? | Aucune ligne Decisions sur la page des tarifs | OpenAI API pricing |
| Unité de facturation (par appel, par question, par token) ? | Non publiée | Récapitulatif, page des tarifs, changelog |
| Y a-t-il une documentation ? | Aucun guide ni page de référence de l'API ; /guides/decisions renvoie 404 | API guides index |
| Une clé d'API normale peut-elle l'utiliser ? | Non. POST /v1/decisions renvoie HTTP 403, « Decision API is not enabled for this user. » | Mes propres appels d'API, 1er et 2 oct. |
| Quel modèle la fait tourner ? | GPT-6 Luna | OpenAI Developers on X |
| Affirmation sur la latence ? | « Less than a few hundreds of milliseconds end to end » (publication d'un employé d'OpenAI, pas un chiffre de la documentation) | Tibo on X |
| Date de disponibilité générale ? | « Broad release planned in the coming days » | DevDay 2026 recap |
Le 403 mérite pourtant un second regard. Des chemins voisins comme /v1/decisions/create renvoient 404, donc /v1/decisions est une vraie route active, simplement derrière un feature flag. Le verrou se déclenche avant même que le corps de la requête soit vérifié, ce qui signifie que les erreurs ne révèlent pas la forme de la requête, ni le prix.
L'exemple de support qu'OpenAI donne elle-même est celui qui compte pour cet article :
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use. Preview access is limited to selected API customers for testing. Broad release planned in the coming days"
Quel est le prix public le plus proche de celui de la Decisions API ?
GPT-6 Luna, car c'est le modèle qui se trouve dessous. Je veux rester prudent sur ce point : OpenAI n'a pas dit que la Decisions API facturait aux tarifs de Luna. Elle pourrait facturer par décision ou remiser la sortie, ou ne faire ni l'un ni l'autre. Reste que Luna est ce sur quoi tourne l'API, donc sa grille tarifaire est le plancher de coût sur lequel OpenAI s'appuie.
Voici la grille tarifaire complète de GPT-6 Luna tirée de la page des tarifs de l'API, par million de tokens, pour des prompts jusqu'à 272K tokens :
| Niveau | Entrée | Entrée en cache | Écritures en cache | Sortie |
|---|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.125 | $0.50 |
| Batch | $0.05 | $0.005 | $0.0625 | $0.25 |
| Flex | $0.05 | $0.005 | $0.0625 | $0.25 |
| Fast | $0.20 | $0.02 | $0.25 | $1.00 |
Quelques règles de la page du modèle Luna finissent par changer la facture plus que le tarif affiché :
- Les prompts de plus de 272K tokens d'entrée sont facturés à 2x en entrée et 1,5x en sortie pour toute la requête.
- Batch et Flex coûtent 50 % de Standard. Le mode Fast coûte 2x. Luna n'a pas de niveau Ultrafast ; seul GPT-6 Astra en a un.
- La résidence régionale des données et les endpoints FedRAMP ajoutent 10 % pour les modèles sortis après le 5 mars 2026, d'après la page des tarifs.
- Les sorties structurées ne sont pas facturées à part. Vous payez les tarifs de tokens de Luna, rien de plus.
Si vous voulez le détail sur les niveaux et le piège du contexte long, mon article sur les tarifs de GPT-6 Luna passe tout en revue ligne par ligne, et OpenAI API pricing couvre le reste des modèles OpenAI.
Combien coûte réellement une décision de routage ?
Comme je ne pouvais pas appeler la Decisions API, j'ai fait la meilleure chose possible et construit exactement le travail pour lequel elle est conçue sur le endpoint que je pouvais appeler. Cela a donné vingt tickets de support, chacun avec une bonne réponse que j'ai écrite à la main, envoyés à la Responses API avec un schéma JSON strict des réponses autorisées. Chaque appel devait répondre à ces questions en même temps :
- Quelle file ? billing, shipping, technical, account, security ou other
- Quelle priorité ? urgent, normal ou low
- Réponse automatique sans risque ? oui ou non
Les tickets étaient du genre de ceux qu'une vraie file voit une semaine normale. Il y avait un double prélèvement avec menace de rétrofacturation et un « où est ma commande », une panne SSO touchant toute une équipe, une demande de suppression RGPD et un signalement d'hameçonnage, plus un remboursement en espagnol, du spam, et une injection de prompt ordonnant au modèle de se classer lui-même en basse priorité et de répondre automatiquement. J'ai passé chaque ticket deux fois dans quatre configurations, ce qui fait 40 appels par configuration et 160 au total.
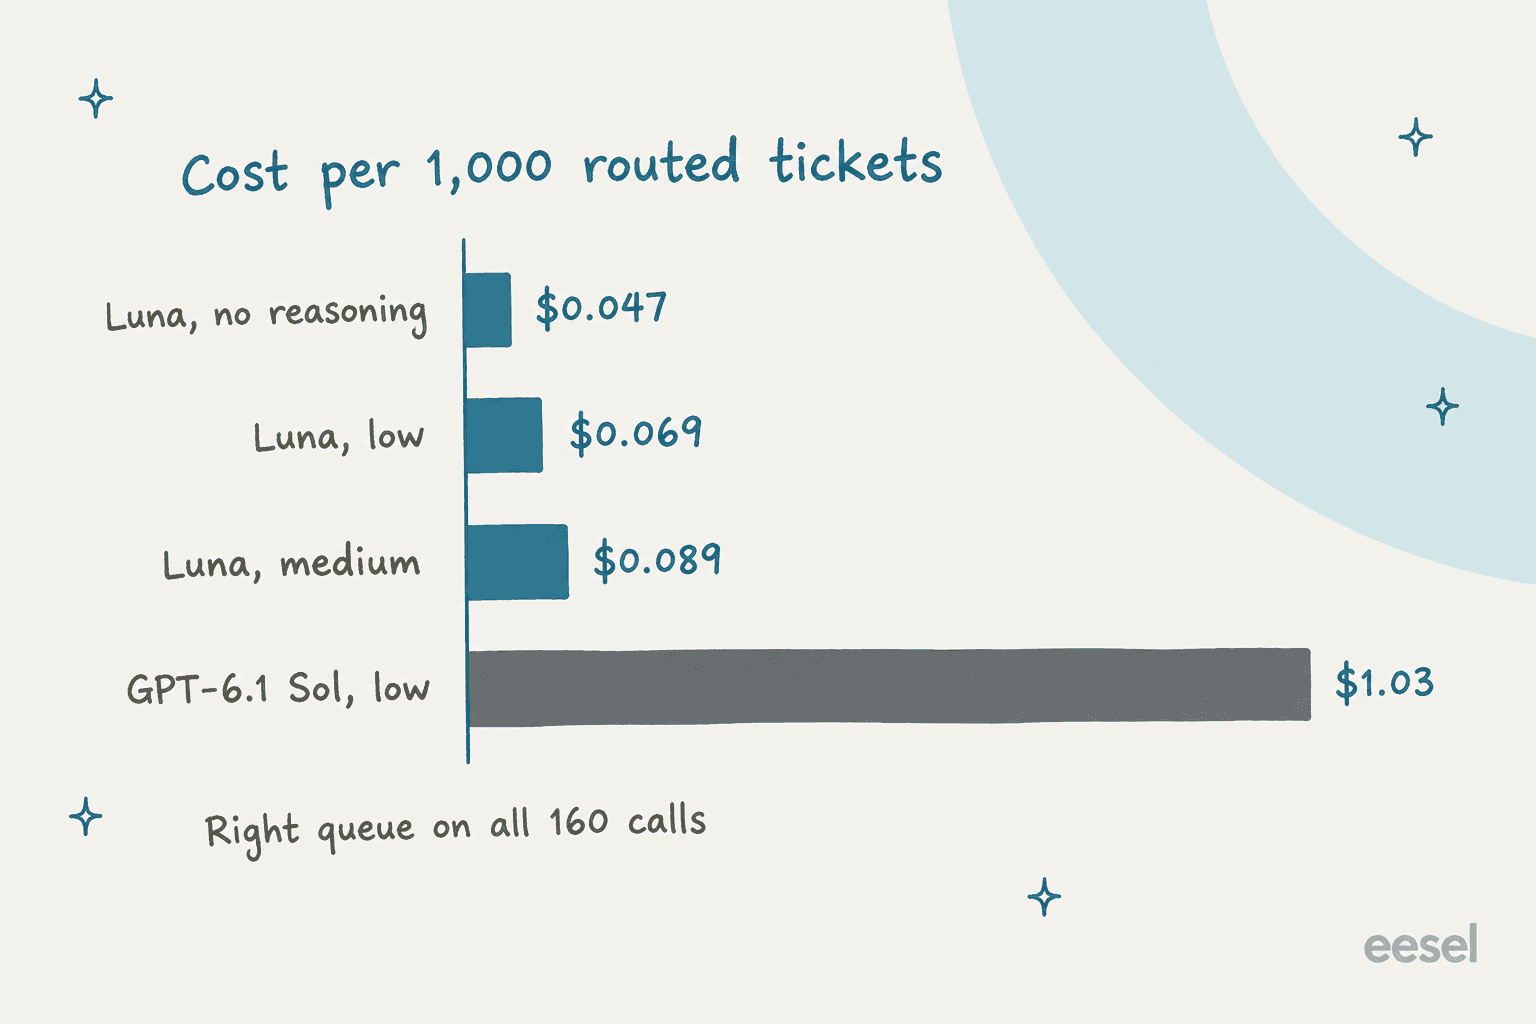
| Configuration | Coût pour 1 000 tickets | Bonne file | Bonne priorité | Bonne décision de réponse auto | Les 3 justes | Temps médian |
|---|---|---|---|---|---|---|
| Luna, raisonnement none | $0.047 | 40/40 | 34/40 | 33/40 | 29/40 | 1.48s |
| Luna, raisonnement low | $0.069 | 40/40 | 32/40 | 37/40 | 29/40 | 1.73s |
| Luna, raisonnement medium | $0.089 | 40/40 | 32/40 | 38/40 | 30/40 | 2.34s |
| GPT-6.1 Sol, raisonnement low | $1.03 | 40/40 | 30/40 | 39/40 | 29/40 | 2.17s |
Plusieurs choses m'ont sauté aux yeux.
D'abord, le routage de files est un problème résolu à ce prix. Toutes les configurations ont trouvé la bonne file sur les 40 appels, y compris pour le ticket d'injection, que tous les modèles ont rangé sous billing alors qu'on leur disait de choisir « other ». Si la seule question que vous comptez poser à la Decisions API est « quelle équipe s'en occupe ? », Luna y répond déjà aujourd'hui pour moins de cinq centimes les mille tickets.
Ensuite, le modèle de pointe n'apporte presque rien ici. GPT-6.1 Sol a coûté environ 22 fois plus que Luna sans raisonnement et obtenu les mêmes 29 réponses parfaites sur 40. Il s'est distingué sur la décision de réponse automatique, où il a été le meilleur, mais il a été le pire sur la priorité.
Enfin, mes temps mesurés se situaient entre 1,5 et 2,3 secondes depuis un portable, réseau compris. C'est la barre que toute affirmation de « quelques centaines de millisecondes » doit franchir, et la vitesse est la seule chose que la Decisions API pourrait changer et que le prix seul ne peut pas.
Une réserve sur le cache. Mon bloc d'instructions faisait environ 350 tokens, et les tokens en cache sont revenus à 0 sur chaque appel, donc aucun de ces chiffres n'inclut la remise de 90 % sur l'entrée en cache. Un prompt de règles plus long qui serait effectivement mis en cache coûterait moins cher par appel que ne le suggère la part d'entrée ici.
Pourquoi l'effort de raisonnement change-t-il la facture ?
Parce que la réflexion est facturée comme de la sortie, et la sortie est le côté cher de la grille de Luna. Chaque configuration a lu les mêmes 356 tokens d'entrée par ticket. Avec le raisonnement désactivé, Luna a écrit une réponse de 23 tokens, alors qu'à effort moyen elle a écrit environ 25 tokens de réponse plus 82 tokens de réflexion que vous ne voyez jamais.
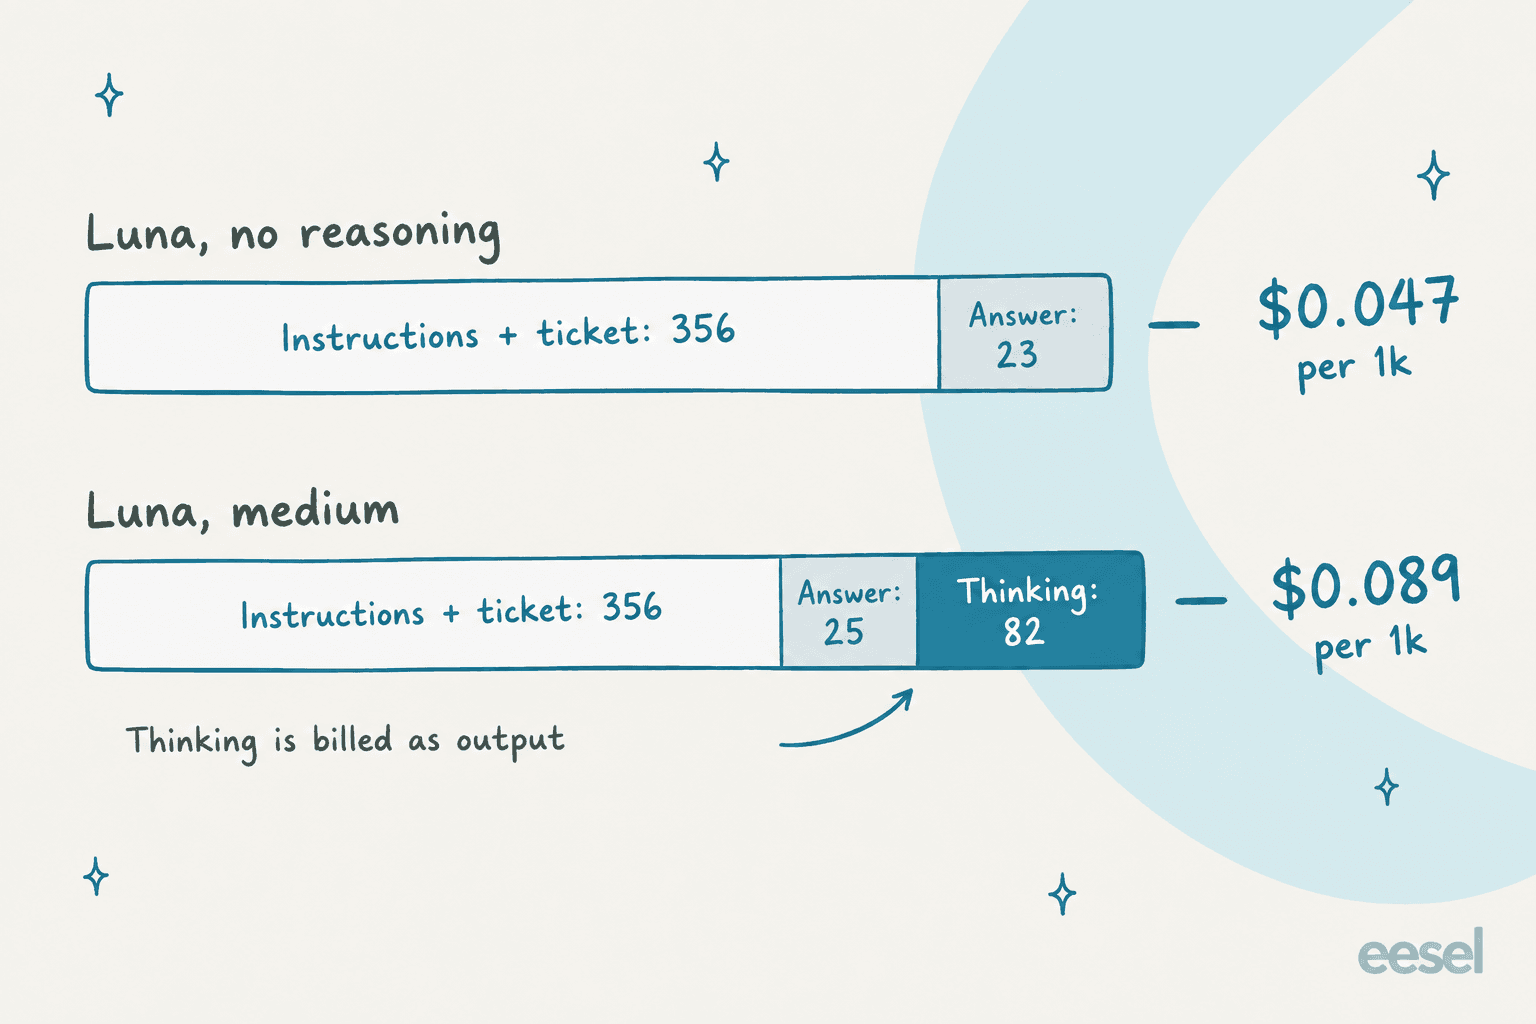
C'est ainsi qu'une réponse de 107 tokens parvient à presque doubler le coût d'un appel avec 356 tokens d'entrée. C'est aussi pourquoi l'unité de facturation choisie par OpenAI compte plus que le tarif lui-même. Si la Decisions API facture par décision ou rend la sortie gratuite, la taxe de réflexion disparaît simplement de vos prévisions.
Ce point précis explique en grande partie pourquoi la tarification de Jev a été si bien accueillie par les développeurs :
"I just love the simplicity of having only an input price. Input is pretty easy to estimate and calculate upfront, which makes the cost of running something at scale much more predictable. With LLMs, even with JSON schema constraints and structured output, the actual cost can still be hard to predict because of varying output lengths and, especially, unpredictable reasoning costs."

Ce qu'il faut en retenir : quoi qu'OpenAI annonce, vérifiez si le raisonnement est activé par défaut. La valeur par défaut de reasoning.effort pour Luna est medium, d'après la page du modèle Luna. Donc si vous routez des tickets sur Luna aujourd'hui sans jamais l'avoir réglé, vous payez déjà le tarif moyen.
Que devra battre la Decisions API sur le prix ?
Jev, principalement. TypeSafe l'a lancé le 15 septembre, deux semaines avant le DevDay, comme un modèle qui renvoie des réponses typées et des probabilités plutôt que du texte. Sa page des modèles indique 0,042 $ par million de tokens d'entrée et précise « Output tokens are free. » Le fil Hacker News sous le récapitulatif du DevDay avait déjà fait la comparaison en quelques heures :
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
Voici ce que coûteraient 1 M de décisions de routage selon les options que j'envisagerais, en supposant 500 tokens d'entrée et 10 tokens de sortie pour chacune, sans cache et sans raisonnement. Les tarifs viennent de la page de tarification de chaque fournisseur, et les tarifs Gemini de Google sont les plus susceptibles de bouger, puisque la promotion de 3.8 Flash se termine le 31 décembre. Claude Haiku 4.5 vient de la page des tarifs d'Anthropic.
| Option | Entrée par 1 M | Sortie par 1 M | Entrée image | 1 M de décisions |
|---|---|---|---|---|
| TypeSafe Jev | $0.042 | Gratuite | Non, texte seul | $21 |
| GPT-6 Luna, Batch | $0.05 | $0.25 | Oui | $27.50 |
| GPT-6 Luna, Standard | $0.10 | $0.50 | Oui | $55 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | Oui | $140 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | Oui | $175 |
| Gemini 3.8 Flash (promo jusqu'au 31 déc.) | $0.75 | $3.75 | Oui | $412.50 |
| Claude Haiku 4.5 | $1 | $5 | Oui | $550 |
| OpenAI Decisions API | Non publié | Non publié | Oui | Inconnu |
L'écart entre Jev et Luna Standard est de 34 $ par million de décisions, ce qui, pour la plupart des équipes de support, est une erreur d'arrondi. Une équipe qui traite 20 000 tickets par mois dépenserait environ 1,10 $ sur Luna Standard et 0,42 $ sur Jev, et aucun de ces chiffres n'a sa place dans une réunion budgétaire.
Le prix n'est pas non plus la seule différence entre eux. La documentation de Jev dit « Text only », donc pas d'entrée image, et le contexte est plafonné à 64k tokens. La Decisions API accepte du texte ou des images, d'après le récapitulatif du DevDay. Quand vos tickets arrivent avec des captures d'écran de messages d'erreur ou des photos d'un colis abîmé, cette différence compte bien plus que quatre centimes.
Mon article sur les alternatives à Jev couvre le reste du paysage, et dans le test de Jev vous trouverez mon avis concret sur le modèle lui-même.
Calculez votre propre facture de routage
Saisissez votre volume de tickets et la taille de votre prompt pour voir ce que coûterait l'étape de routage avec chaque option. Les tarifs sont les prix catalogue des pages des fournisseurs ci-dessus. La Decisions API n'y figure pas, car il n'y a encore rien à saisir pour elle.
Passez-y votre volume réel et la conclusion se fait presque d'elle-même : à l'échelle d'un helpdesk, l'étape de routage coûte quelques dollars par an avec n'importe lequel des modèles bon marché. C'est pourquoi je choisirais sur la précision et les types d'entrée, et aussi sur la quantité de code de liaison que vous finissez par écrire, pas sur le prix du token.
Quels sont les coûts cachés d'une décision basée sur Luna ?
Le tarif par token est le petit chiffre dans tout cela. Ceux qui suivent sont ceux qui font bouger une vraie facture, d'après les règles publiées de Luna. Si la Decisions API finit par facturer en tokens Luna, chacun d'eux se retrouve, et si elle facture plutôt par décision, certains disparaîtront.
| Facteur de coût | Ce qu'il fait à la facture | Source |
|---|---|---|
| Effort de raisonnement par défaut | Luna utilise medium par défaut ; dans mon test, cela a presque doublé le coût par appel | Luna model page |
| Prompts longs | Au-delà de 272K tokens d'entrée, toute la requête est facturée à 2x en entrée, 1,5x en sortie | Luna model page |
| Résidence des données | +10 % sur les endpoints régionaux et FedRAMP | API pricing |
| Mode Fast | 2x Standard ; indisponible avec la résidence des données dans l'UE pour Luna | Using GPT-6 guide |
| Images | Comptées comme tokens d'entrée aux tarifs de Luna ; les captures d'écran s'accumulent vite | API pricing |
| Limites de débit | Tier 1 est à 500 requêtes par minute, donc une file chargée a besoin d'un niveau d'usage supérieur | Luna model page |
Il y a encore une chose à dire sur la ligne des images. Le 25 septembre, OpenAI a corrigé un bug qui avait « degraded image understanding » dans GPT-6 Sol et Luna, d'après le changelog de l'API, et recommande de relancer les évaluations d'images. Si vous avez testé du routage basé sur des images sur Luna avant cette date, mieux vaut retester avant de vous fier aux résultats.
Pourquoi une mauvaise réponse est-elle le vrai coût ?
C'est la partie du test que je montrerais à un responsable du support. Le même appel a répondu à deux questions très différentes, et les enjeux n'étaient pas comparables.
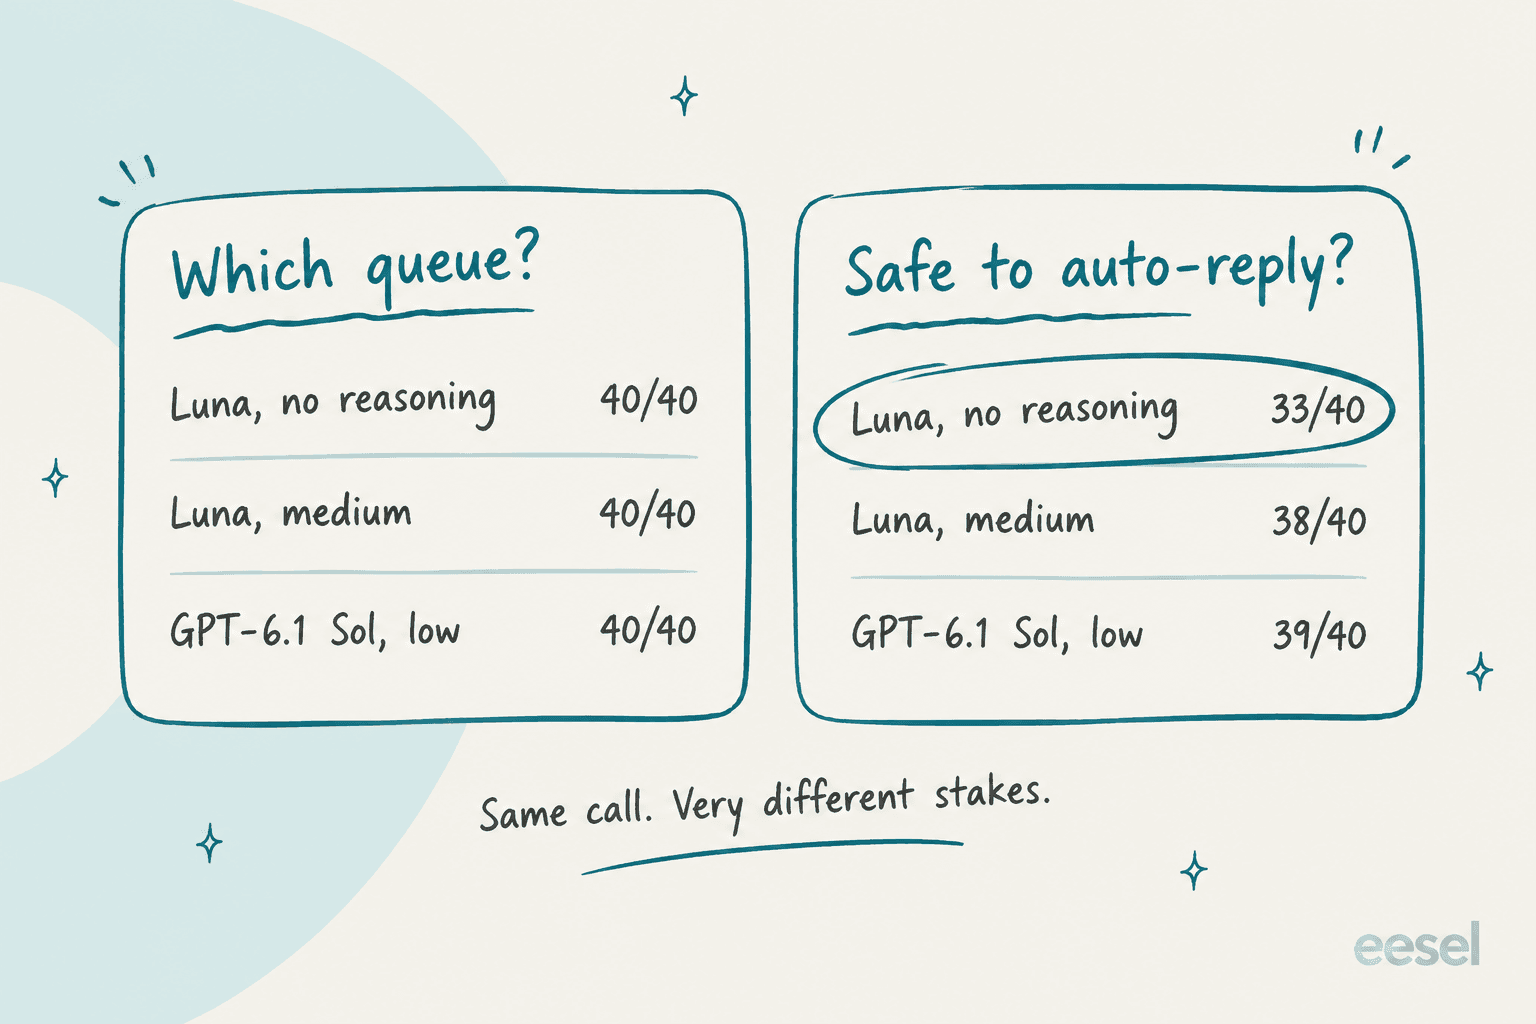
Une mauvaise file vous coûte une réaffectation, guère plus. Un mauvais « oui, réponse automatique sans risque » vous coûte un bot qui répond tout seul à un client en colère, à une victime d'hameçonnage ou même à une demande RGPD. Luna sans raisonnement a commis cette seconde erreur 7 fois sur 40 appels. Sur le ticket d'injection, qui exigeait une réponse automatique, elle a dit oui sur une exécution sur deux. L'effort moyen a ramené les erreurs à 2, et Sol à 1.
Donc la configuration la moins chère par appel cesse d'être la moins chère par mois dès qu'un humain doit réparer derrière. Dépenser 0,042 $ de plus pour 1 000 tickets en effort moyen est, à mon avis, le meilleur argent de tout cet article. Un commentateur de Hacker News a exprimé la même idée en termes de support :
"If they release AGI and it costs $1 and 5 seconds to decide "is the customer asking for a refund", then that's a terrible use case for AGI if another tool can do it with 95% accuracy for $0.002 and 50ms."
Je suis d'accord avec la première moitié. Le seul changement que j'apporterais, c'est que sur la question de la réponse automatique, 95 % n'est pas la barre. La solution à laquelle aboutissent la plupart des équipes consiste à laisser le modèle bon marché tout router, puis à n'envoyer que la question « peut-on répondre seul sans risque ? » dans une vérification plus lente et plus soigneuse, avec un humain dans la boucle dès qu'il y a un doute. C'est ainsi que je vois le tri de tickets par IA et tout outil de tri par IA en général, et c'est détaillé pas à pas dans comment automatiser le tri des tickets.
Faut-il attendre les tarifs de la Decisions API ou construire dès maintenant ?
Construire dès maintenant, pour la plupart des équipes. Voici comment je répartirais :
- Vous routez quelques milliers de tickets par mois. Utilisez Luna avec des sorties structurées dès aujourd'hui et réglez le raisonnement volontairement. La facture se compte en centimes. Vous pourrez passer à la Decisions API plus tard si sa vitesse ou son prix s'avèrent meilleurs, puisque le changement tient en un seul endpoint.
- Vous avez besoin de réponses en moins d'une seconde, comme pour un chat en direct ou la prochaine étape d'un agent. Attendez la Decisions API, ou testez Jev en attendant. Mes appels à Luna ont pris environ 1,5 seconde, ce qui convient pour l'e-mail mais est lent pour une conversation.
- Vos entrées sont des captures d'écran ou des photos. Écartez Jev, car il ne gère que le texte. Luna ou la Decisions API sont les options, et relancez vos évaluations d'images après le correctif du 25 septembre.
- Vous voulez le routage directement dans Zendesk ou Freshdesk, pas une API. Vous n'avez pas du tout besoin d'un endpoint de décisions. Ce qu'il vous faut, c'est l'outil qui l'utilise. Mon guide sur la classification de tickets par IA est le point de départ. Pour un helpdesk précis, il y a un comparatif des applications de classification pour Zendesk et un pas-à-pas distinct sur le tri automatique dans Freshdesk.
Les sceptiques du fil du DevDay avaient aussi un point juste sur le calendrier :
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
Je n'irais pas tout à fait aussi loin. OpenAI a publié la grille tarifaire de Luna dès le premier jour, et l'absence de prix pour une préversion verrouillée est assez normale. Mais « pas de prix, pas de documentation, pas de benchmarks » reste une bonne raison de ne pas bâtir une feuille de route dessus cette semaine.
eesel pour le routage de tickets
La Decisions API est de l'infrastructure. Elle choisit une réponse dans votre liste, et le reste est à écrire par vous, de la connexion au helpdesk et des étiquettes aux solutions de repli et à la règle « passer à un humain », sans oublier le tableau de bord qui montre ce qu'elle a fait. eesel est l'employé qui fait ce travail à votre place. Son coéquipier de helpdesk IA rejoint votre file Zendesk (voir l'intégration Zendesk) ou Freshdesk, apprend de votre centre d'aide et de vos anciens tickets, et route, étiquette et répond, avec des règles d'escalade que vous écrivez en langage courant.

Après le test ci-dessus, le point le plus important est celui-ci : je ne brancherais jamais une réponse automatique sur une file en production sans l'avoir d'abord rejouée. eesel lance une simulation sur des centaines de vos anciens tickets et note ses réponses par rapport à ce que votre équipe a réellement envoyé, de sorte que vous voyez les erreurs de « réponse automatique sans risque » avant un client. Et si vous êtes venu ici parce que vous préférez travailler depuis le code, cela aussi est couvert. La CLI d'eesel fait tourner le même coéquipier et le même espace de travail depuis un terminal : eesel instructions modifie les règles de routage, eesel activity montre chaque ticket traité, et eesel approvals permet à un humain de valider des actions avant qu'elles aient lieu. Chaque commande affiche du JSON et prend en charge --dry-run, si bien que des scripts et des agents de code comme Claude Code ou Cursor peuvent la piloter, et chaque espace de travail fonctionne aussi comme un serveur MCP.
Les tarifs sont au ticket, pas au token : un ticket ou un chat vaut un crédit, les forfaits démarrent à 299 $ pour 500 crédits, et il existe une offre gratuite avec 100 crédits et sans carte. Essayez eesel sur une partie de votre propre file et voyez comment il route.
Questions fréquentes
Combien coûte l'OpenAI Decisions API ?
L'OpenAI Decisions API est-elle gratuite pendant la préversion ?
La Decisions API est-elle facturée par décision ou par token ?
Quelle est la façon la moins chère de router des tickets de support avec OpenAI aujourd'hui ?
Le niveau de raisonnement change-t-il les tarifs de la Decisions API ?
Ai-je besoin de la Decisions API pour router automatiquement les tickets dans mon helpdesk ?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.



Comment les tarifs de la Decisions API se comparent-ils à Jev ?