Pourquoi on cherche une alternative à GPT-6 Luna
Commençons par être juste envers Luna, car il le mérite. Quand OpenAI a lancé Sol et Luna le 23 septembre 2026, le titre était une baisse de prix à plat de 50 % par rapport à la génération GPT-5.6. Simon Willison a résumé l'ambiance du fil de lancement :
"GPT-6 Luna being half the price of GPT-5.6 Luna is a really big deal."

À $0.10/$0.50 par 1M de tokens, avec une fenêtre de contexte de 1,05M de tokens et des entrées image, Luna est beaucoup de modèle pour le prix. C'est aussi le modèle bon marché par défaut pour des millions de personnes, puisque c'est le seul modèle GPT-6 sur ChatGPT Free et Go. Un autre commentateur a résumé la valeur simplement :
"6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model."
Alors pourquoi comparer ? Trois vraies raisons reviennent sans cesse :
- Le prix en volume. Si vous faites passer des millions de tokens par jour dans un classificateur, un résumeur ou un pipeline par lots, même le minuscule tarif de sortie de Luna finit par s'accumuler, et quelques modèles affichent des prix plus bas.
- Les poids ouverts. Luna est fermé et accessible uniquement par API. Si vous devez auto-héberger pour des raisons de confidentialité, de souveraineté ou de contrôle des coûts, vous devez quitter OpenAI entièrement.
- Un atout précis. Des entrées multimodales plus riches (audio, vidéo, PDF), des temps de réponse plus rapides pour un widget de chat en direct, ou une politique de données qui garde tout sur une infrastructure occidentale. Luna est un généraliste solide, pas le leader sur aucun de ces points.
Voici où se situent réellement les huit alternatives sur le chiffre par lequel la plupart des gens commencent : le prix de sortie par 1M de tokens.
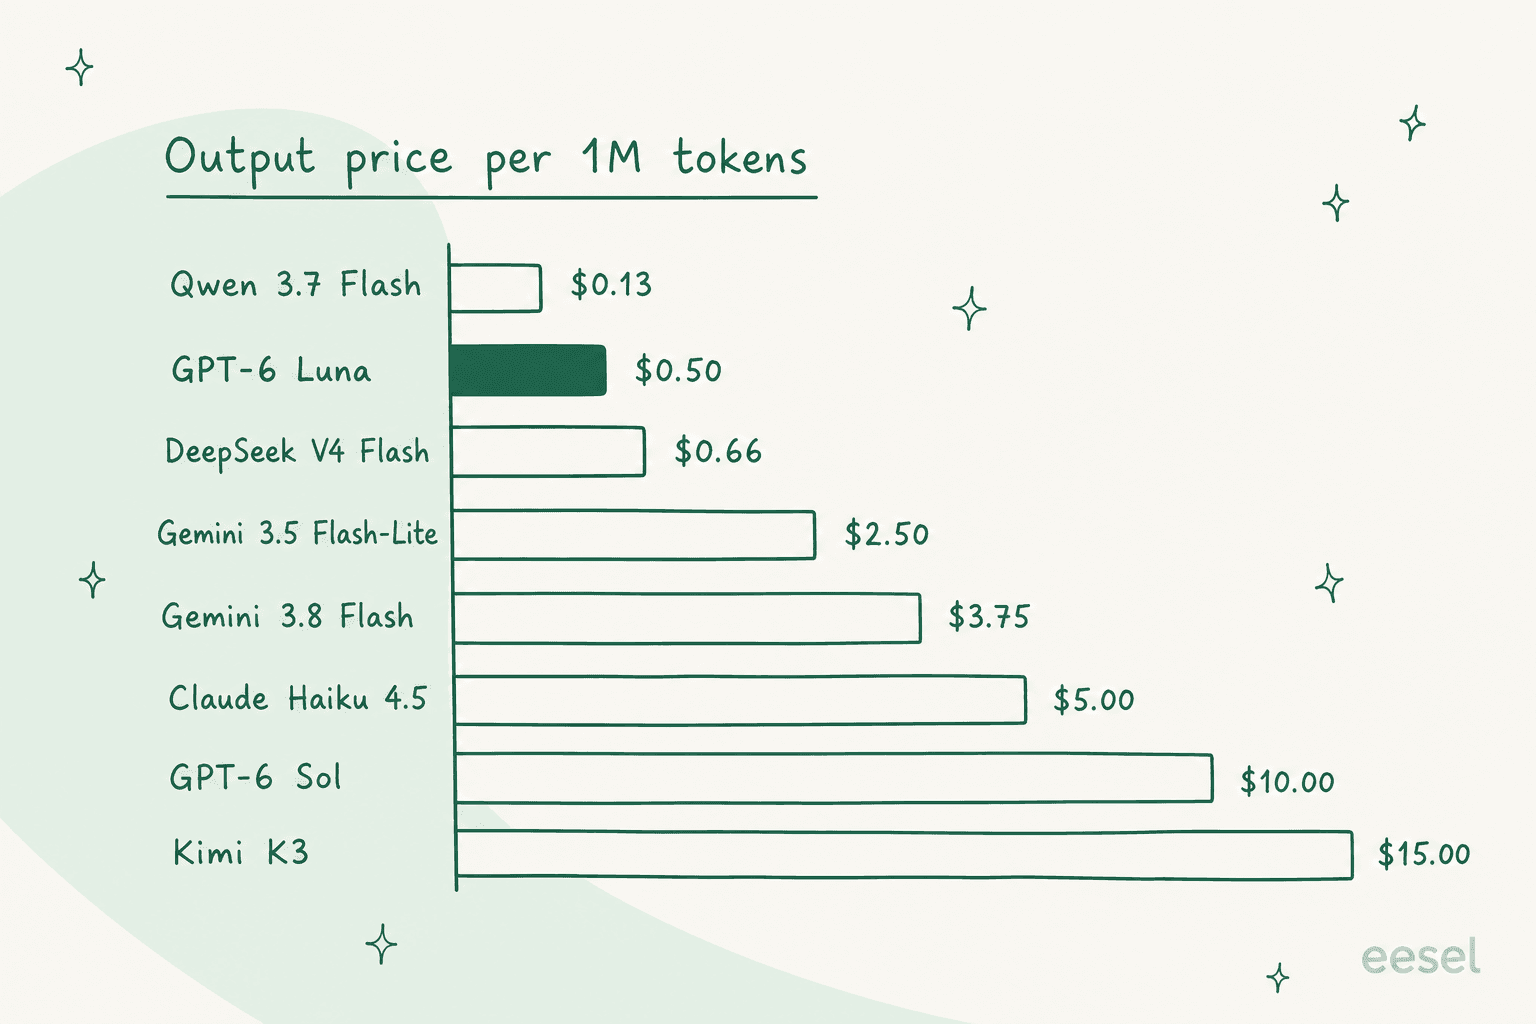
Comment j'ai choisi ces alternatives
J'ai limité la liste aux modèles qui sont vraiment dans la même catégorie de poids que Luna : bon marché, rapides et conçus pour un travail à haut volume ou léger, pas les fleurons de pointe de la liste des modèles OpenAI vers lesquels vous vous tourneriez pour coder toute la journée. Je n'ai pas inclus GPT-6 Astra ni Claude Opus ici, car un modèle à 20 à 100 fois le prix de sortie de Luna n'est pas une « alternative », c'est un budget différent. (Si c'est un moteur de pointe que vous cherchez vraiment, mon tour d'horizon des alternatives à GPT-6 Astra est une meilleure lecture.)
Pour chaque modèle, j'ai examiné le vrai prix par token selon la grille tarifaire du fournisseur lui-même, la fenêtre de contexte, si les poids sont ouverts, ce qu'il peut prendre en entrée, et où il brille vraiment ou faiblit. Tout ce qui suit est au prix des sources primaires, et là où la tarification d'un modèle est inhabituelle (paliers, surcoûts heures de pointe/creuses, une hausse programmée), je l'ai signalé, car ces bizarreries sont exactement ce qui transforme un modèle « moins cher » en facture surprise.
Voici tout le paysage en un coup d'œil.
| Modèle | Idéal pour | Entrée $/1M | Sortie $/1M | Contexte | Poids ouverts | Entrée image |
|---|---|---|---|---|---|---|
| GPT-6 Luna (en place) | Le choix équilibré par défaut | $0.10 | $0.50 | 1.05M | Non | Oui |
| Gemini 3.8 Flash | Travail multimodal par lots | $0.75 | $3.75 | 1M | Non | Oui |
| Gemini 3.5 Flash-Lite | Le moins cher en multimodal | $0.30 | $2.50 | 1M | Non | Oui |
| Claude Haiku 4.5 | Fiabilité par dollar | $1.00 | $5.00 | 200K | Non | Oui |
| DeepSeek V4 Flash | Les poids ouverts les moins chers | $0.22 (off-peak) | $0.66 (off-peak) | 1M | Oui (MIT) | Non |
| Qwen 3.7 Flash | Le tarif le plus bas sur petits prompts | $0.03-$0.20 | $0.13-$0.80 | 1M | Non | Oui |
| Kimi K3 | Poids lourd à poids ouverts | $3.00 | $15.00 | 1M | Oui | Oui |
| GPT-6 Sol | Rester chez OpenAI, plus de marge | $2.00 | $10.00 | 1.05M | Non | Oui |
| Grok 4.7 | Boucles d'agents et temps réel | $2.00 | $6.00 | 500K | Non | Oui |
Passons maintenant aux modèles eux-mêmes.
1. Gemini 3.8 Flash
Idéal pour : les équipes qui veulent des entrées multimodales et un débit énorme pour du travail nocturne non interactif.
Gemini 3.8 Flash est le modèle Flash le plus récent de Google, et le cadrage honnête est celui que Google lui-même donne : il est construit directement sur Gemini 3.7 Flash, pas sur une nouvelle base. La fiche du modèle le dit noir sur blanc, dans quatre sections distinctes. Ce que vous obtenez au même prix que 3.7 est un modèle qui « travaille plus dur », exécutant des étapes de raisonnement supplémentaires et appelant des outils plus souvent, ce qui est excellent pour les tâches difficiles et un gaspillage pour les tâches faciles.
Là où il bat clairement Luna, c'est sur les entrées : texte, image, audio, vidéo et PDF passent tous, contre texte-et-image pour Luna. Il affiche aussi un solide indice d'intelligence Artificial Analysis de 59, bien au-dessus de la médiane de sa catégorie.
Avantages :
- Entrées entièrement multimodales (audio, vidéo, PDF), que Luna ne prend pas.
- Débit brut vraiment rapide : 302 tokens/s, proche du sommet du tableau de vitesse d'Artificial Analysis.
- Un forfait gratuit et une fenêtre de contexte de 1M de tokens.
Inconvénients :
- Le chiffre sous-estimé est le délai avant le premier token : Artificial Analysis a mesuré
13.3scontre une médiane de catégorie d'environ3s. Cela le disqualifie pour tout ce qu'un humain attend, comme une réponse de chat, et est sans importance pour un travail par lots nocturne. - Le prix double le 1er janvier 2027, à
$1.50/$7.50. Google lui-même dit aux développeurs soucieux d'efficacité de rester sur 3.7 Flash.
Tarifs : $0.75 en entrée / $3.75 en sortie par 1M jusqu'au 31 décembre 2026, puis exactement 2x à partir de janvier 2027. Batch et Flex bénéficient de 50 % de réduction. Voir le détail complet des tarifs Gemini pour les paliers.
Mon avis : choisissez Gemini 3.8 Flash plutôt que Luna quand vous devez lui donner de l'audio ou de la vidéo et que le travail n'est pas interactif. Pour un widget de chat en direct, ce chiffre de délai avant le premier token l'exclut, et je regarderais plutôt Flash-Lite ou Luna.
2. Gemini 3.5 Flash-Lite
Idéal pour : le moyen le moins cher d'obtenir les entrées multimodales de Google à haut volume.
Si Gemini 3.8 Flash est le modèle qui « travaille plus dur », Flash-Lite est celui qui veut « simplement être bon marché et rapide ». C'est le membre économique et à haut débit de la gamme Gemini 3.5, et c'est la réponse la plus directe de Google à Luna. Il prend le même ensemble riche d'entrées (texte, image, vidéo, audio, PDF) et renvoie du texte, avec une fenêtre de contexte d'environ 1M de tokens. Le champ plus large des alternatives à Gemini vaut le coup d'œil si vous voulez plus d'options Google.
La caractéristique qui se démarque est la vitesse : Artificial Analysis le classe près du sommet du champ en vitesse de sortie, environ 490 tokens/s, un monde différent du problème de latence de 3.8 Flash. Le compromis est l'intelligence : son indice d'intelligence se situe à 36, donc c'est un cheval de trait pour la classification, l'extraction et le routage, pas pour les tâches exigeantes en raisonnement.
Avantages :
- Entrées multimodales à un prix vraiment bas.
- Sortie très rapide, ce qui le rend viable pour un usage interactif là où 3.8 Flash ne l'est pas.
- Moins cher que Claude Haiku 4.5 sur les deux compteurs, selon la comparaison de Google lui-même.
Inconvénients :
- Une vraie lacune fonctionnelle à connaître : la page du modèle indique que l'utilisation d'ordinateur n'est pas prise en charge, donc ce n'est pas celui avec lequel construire un agent qui pilote un navigateur.
- Intelligence brute inférieure à Luna, donc un outil plus restreint.
Tarifs : $0.30 en entrée / $2.50 en sortie par 1M (Standard). Batch et Flex divisent cela par deux, à $0.15/$1.25. Le forfait gratuit s'entraîne sur votre contenu, donc ce n'est pas pour des données sensibles.
Mon avis : c'est le Gemini que j'opposerais vraiment à Luna pour du travail texte-et-image bon marché à haut volume. Son prix de sortie est plus élevé que celui de Luna, mais pour tout ce qui contient une image, le support multimodal et la vitesse peuvent valoir la différence.
3. Claude Haiku 4.5
Idéal pour : les équipes qui veulent la fiabilité et le respect des instructions de la famille Claude à un prix de niveau rapide.
Claude Haiku 4.5 est le modèle petit et rapide d'Anthropic, et c'est le plus cher du véritable niveau « bon marché » ici, à $1.00/$5.00. Ce que vous payez, c'est la réputation d'Anthropic pour un suivi rigoureux des instructions et une moindre tendance à dérailler, ce qui compte beaucoup quand la sortie du modèle alimente quelque chose d'automatisé.
Sa fenêtre de contexte est plus petite que le reste (200K plutôt que 1M), ce qui convient pour la plupart des tâches et représente une vraie contrainte pour qui veut fourrer toute une base de code ou une base de connaissances dans un seul prompt.
Avantages :
- Suivi des instructions solide et prévisible, dans le style Claude.
- Réponses rapides, donc fonctionne pour des usages interactifs.
- L'écosystème, les outils et la documentation de Claude sont excellents.
Inconvénients :
- Dix fois le tarif de sortie de Luna, donc en pur volume c'est le choix cher de ce groupe.
- 200K de contexte, le plus petit ici.
- Pas de poids ouverts, et aucune option de contexte géant comme les modèles à 1M de tokens.
Tarifs : $1.00 en entrée / $5.00 en sortie par 1M de tokens. Le cache de prompts et les remises par lots s'appliquent et réduisent le tarif effectif pour les charges de travail répétitives.
Mon avis : si la fiabilité est ce qui vous empêche de dormir, et que vos prompts tiennent dans 200K, Haiku vaut la prime par rapport à Luna. Si vous cherchez la facture la plus basse, ce n'est pas le bon choix, et l'un des modèles ouverts chinois ci-dessous fera le même travail de routine pour une fraction du coût.
4. DeepSeek V4 Flash
Idéal pour : l'option la moins chère avec des poids ouverts que vous pouvez vraiment télécharger et auto-héberger.
DeepSeek V4 Flash est le choix champion du budget, et celui où les notes de bas de page sur les prix comptent le plus. C'est un modèle de mélange d'experts à 284 Md de paramètres totaux / 13 Md actifs, publié sous licence MIT avec des poids téléchargeables, donc vous pouvez le faire tourner sur votre propre matériel.
Deux choses à savoir avant de vous emballer sur le prix affiché. D'abord, il est uniquement textuel, donc aucune entrée image n'est documentée. Ensuite, l'API de premier niveau utilise une tarification heures de pointe/creuses : $0.22/$0.66 par 1M hors pointe, montant à $0.44/$1.32 en pointe. Les heures de pointe vont de 01h00 à 10h00 UTC (heures ouvrées chinoises), donc une file d'attente américaine ou européenne est facturée en majorité au tarif creux moins cher, ce qui est une bizarrerie à la fois pratique et fragile.
Il existe aussi un piège de coût plus subtil qui est apparu directement dans le fil de lancement de Luna. Un commentateur a comparé ses propres factures DeepSeek et Luna, et quelqu'un a répliqué :
"This isn't right. You're comparing cost per token, but DeepSeek V4 Flash uses more tokens. Artificial Analysis found GPT 6 Luna to be significantly cheaper than DeepSeek."
Voilà toute la catégorie en un seul échange : DeepSeek est verbeux, et un modèle bavard consomme plus de tokens pour finir le même travail, donc le tarif par token plus bas ne signifie pas toujours une facture plus basse.
Avantages :
- Poids ouverts MIT, donc vous pouvez auto-héberger et garder les données en interne.
- Le tarif par token publié le plus bas parmi les modèles capables ici (hors pointe).
- Contexte énorme de 1M de tokens et raisonnement intégré.
Inconvénients :
- Uniquement textuel, pas d'entrée image documentée.
- Une sortie verbeuse peut effacer les économies par token sur des tâches réelles.
- Les conditions de l'API payante sont silencieuses, pas explicitement permissives, sur l'usage pour l'entraînement, et les données relèvent du droit chinois, donc ce n'est pas un remplacement direct pour des données clients.
Tarifs : hors pointe $0.22 en entrée / $0.66 en sortie, en pointe $0.44/$1.32, le tout par 1M. Les tokens de raisonnement sont facturés au tarif de sortie, et le « thinking » est activé par défaut, donc il faut le budgétiser.
Mon avis : si vous voulez des poids ouverts et le plancher absolu du coût, DeepSeek V4 Flash est celui à tester, mais testez-le avec vos propres prompts et mesurez le nombre de tokens, pas seulement le tarif. Pour des données clients, considérez la politique d'entraînement « silencieuse » comme une raison d'auto-héberger plutôt que d'utiliser l'API de premier niveau.
5. Qwen 3.7 Flash
Idéal pour : le tarif affiché le plus bas sur les petits prompts, si vous pouvez vivre avec une documentation légère.
Le Qwen 3.7 Flash d'Alibaba a le chiffre le plus bas de tout le tableau, $0.03/$0.13 par 1M, mais il y a un astérisque qu'on ne peut pas ignorer : le prix est échelonné par taille de prompt. Ce tarif bon marché ne tient que sous 32K tokens. Il monte à $0.10/$0.40 de 32K à 256K, et $0.20/$0.80 de 256K à 1M. Donc le tarif « modèle de vision le moins cher » et le « contexte de 1M » ne peuvent pas être vrais tous les deux dans le même appel.
L'autre remarque honnête est que presque rien sur ce modèle n'est vérifié de façon indépendante. Alibaba n'a publié aucun benchmark, aucune architecture, aucun nombre de paramètres, et les poids sont fermés. La seule évaluation tierce, le test de vision de Roboflow, le classe 22e sur 23 dans l'ensemble, mais 1er sur 23 en coût. Et « Flash » ici signifie bon marché, pas rapide : il tourne à environ 59 tokens/s, bien plus lent que Flash-Lite de Gemini.
Avantages :
- Le tarif d'entrée par token le plus bas ici, sur les petits prompts.
- Accepte l'entrée image, contrairement à DeepSeek.
- Contexte de 1M de tokens disponible (au palier de prix le plus élevé).
Inconvénients :
- Le prix échelonné signifie que le tarif bon marché s'évapore sur les gros prompts (6,7 fois plus cher en entrée au palier le plus élevé).
- Sortie lente et documentation légère et non vérifiée.
- Poids fermés, fournisseur unique, donc pas d'auto-hébergement ni de routage de secours.
Tarifs : trois paliers selon la taille du prompt, de $0.03/$0.13 sous 32K jusqu'à $0.20/$0.80 à 256K-1M. Comparez avec le panorama complet des tarifs Qwen avant de vous décider.
Mon avis : Qwen 3.7 Flash convient parfaitement aux tâches de vision à haut volume et prompt court où le coût est primordial et où vous pouvez valider la qualité vous-même. Pour tout ce qui nécessite un grand contexte ou des benchmarks documentés, je passerais mon chemin. Mon article sur les alternatives à Qwen présente la famille Qwen plus large si vous voulez plus de marge.
6. Kimi K3
Idéal pour : les équipes qui veulent un poids lourd vraiment à poids ouverts et sont prêtes à payer pour cela.
Kimi K3 est l'exception de cette liste, et je l'ai inclus délibérément. À $3/$15 par 1M, il n'est pas bon marché ; il est dans la même tranche que Claude Sonnet, environ 30 fois le tarif de sortie de Luna. Alors pourquoi est-il là ? Parce que c'est le modèle à poids ouverts vers lequel les gens se tournent quand ils veulent posséder un modèle capable en propre, et ses poids sont vraiment sortis sur Hugging Face à temps.
C'est un modèle de mélange d'experts à 2,8 Bn de paramètres totaux / 104 Md actifs, avec vision native, un contexte de 1M de tokens, et un indice d'intelligence Artificial Analysis de 57, ce qui le place près du sommet de tout le champ, pas seulement du côté bon marché.
Avantages :
- Poids ouverts sortis comme promis, vérifiables sur Hugging Face.
- Intelligence élevée, bien au-dessus du reste de cette liste.
- Vision native et contexte de 1M de tokens.
Inconvénients :
- Ce n'est pas un modèle économique. C'est une alternative à Luna uniquement au sens « ouvert et capable », pas au sens « bon marché ».
- Le raisonnement ne peut pas être désactivé, et il passe par défaut à l'effort maximal, donc la latence et la consommation de tokens sont élevées.
Tarifs : $3 en entrée / $0.30 en cache-hit / $15 en sortie par 1M. Les paliers de l'appli grand public vont d'un plan gratuit jusqu'à $199/mois. Mon tour d'horizon des alternatives à Kimi K2.5 couvre le champ plus large des modèles ouverts.
Mon avis : si ce que vous vouliez vraiment d'une « alternative à Luna » était un modèle ouvert et capable à auto-héberger, Kimi K3 est le choix, et DeepSeek V4 Flash le cousin moins cher. Si vous vouliez la facture la plus basse, Kimi est carrément le mauvais arbre.
7. GPT-6 Sol
Idéal pour : rester chez OpenAI quand la marge de Luna s'épuise.
Parfois, la meilleure alternative à Luna est le modèle un cran au-dessus dans la même famille. GPT-6 Sol est le modèle GPT-6 de milieu de gamme d'OpenAI, à $2/$10, et il existe exactement pour le moment où les réponses de Luna cessent d'être assez bonnes mais où vous ne voulez pas changer de fournisseur, de SDK ni d'accords sur les données.
Le cadrage même d'OpenAI est « construisez avec Sol, passez à l'échelle avec Luna », et l'histoire des benchmarks est honnête : les indices d'intelligence et de codage de Sol sont à peu près au niveau de GPT-5.6, donc c'est plus une baisse de prix qu'un saut de capacité, avec une vraie victoire en factualité (OpenAI rapporte environ la moitié des erreurs du précédent Sol).
Avantages :
- Même API, mêmes outils et mêmes conditions de données que Luna, donc changer est une modification d'une ligne.
- Ensemble complet d'outils de la Responses API : recherche web, interpréteur de code, shell hébergé, utilisation d'ordinateur, MCP.
- Nettement plus capable que Luna sur les tâches difficiles, avec un gros gain de factualité.
Inconvénients :
- 20 fois le prix de sortie de Luna, donc c'est une hausse de coût, pas une économie.
- Pas sur les forfaits Free ou Go ; il faut Plus, Pro, Business ou l'API.
Tarifs : $2 en entrée / $10 en sortie par 1M en standard, avec Batch et Flex à 50 % de réduction. La page complète des tarifs de GPT-6 Sol donne les tarifs de contexte long et du mode rapide.
Mon avis : Sol n'est pas une alternative pour qui compare sur le prix, c'est le chemin naturel de montée en gamme quand la qualité de Luna est le goulot d'étranglement. Tournez-vous vers lui quand le défaut que vous essayez de corriger est la précision, pas le coût.
8. Grok 4.7
Idéal pour : faire tourner des boucles d'agents à grand volume et des tâches qui veulent des données en temps réel ou de X.
Grok 4.7 de xAI est la plus chère des options de milieu de gamme, à $2/$6, mais elle est conçue pour un travail précis : des tâches agentiques longues de plusieurs heures. Elle tourne sur un modèle de base nouveau et plus grand que 4.6, avec un entraînement par renforcement plus long pondéré vers le travail multi-étapes, et elle comprend nativement le harnais d'agents propre à xAI.
L'argument de vente est « proche de la pointe à un prix adapté au volume ». Sur les propres tableaux de xAI, elle affiche de solides scores agentiques et de terminal, même si les couronnes du meilleur codage et du meilleur terminal appartiennent encore à des modèles comme Fable 5.1. Il est juste de noter qu'elle perd aussi sur certains benchmarks, comme HealthBench, où GPT-6 Sol et Fable la devancent tous les deux.
Avantages :
- Solide sur les tâches agentiques de longue haleine, avec une API de compactage de contexte pour les exécutions très longues.
- Accès aux données en temps réel et de X via les outils de xAI.
- Un modèle capable au prix de Grok 4.6.
Inconvénients :
- L'option de milieu de gamme la plus chère ici, et le tarif de contexte long (
$4/$12au-delà de 200K tokens de prompt) s'applique à chaque token de la requête, pas seulement au dépassement. - Contexte de 500K, plus petit que les modèles à 1M de tokens.
- Les compteurs hors token (recherche, exécution de code) s'accumulent dans les boucles d'agents.
Tarifs : $2 en entrée / $6 en sortie sous 200K tokens de prompt, $4/$12 au-delà, le tout par 1M. Les appels d'outils sont facturés séparément, par exemple la recherche web et X à $5/1 000 appels.
Mon avis : Grok 4.7 n'est pas vraiment un concurrent de Luna pour les tâches textuelles bon marché. C'est le choix quand le travail est une longue exécution agentique, surtout une qui nécessite des données en direct. Pour du résumé ou de la classification simple à haut volume, c'est excessif et surpayé face à Luna.
Les deux questions qui tranchent vraiment
Enlevez les noms des modèles et toute cette comparaison se résume à deux questions.
La première est ouvert ou fermé. La plupart de ces modèles sont fermés, accessibles uniquement par API. Si l'auto-hébergement est une exigence stricte, votre liste restreinte fond rapidement.
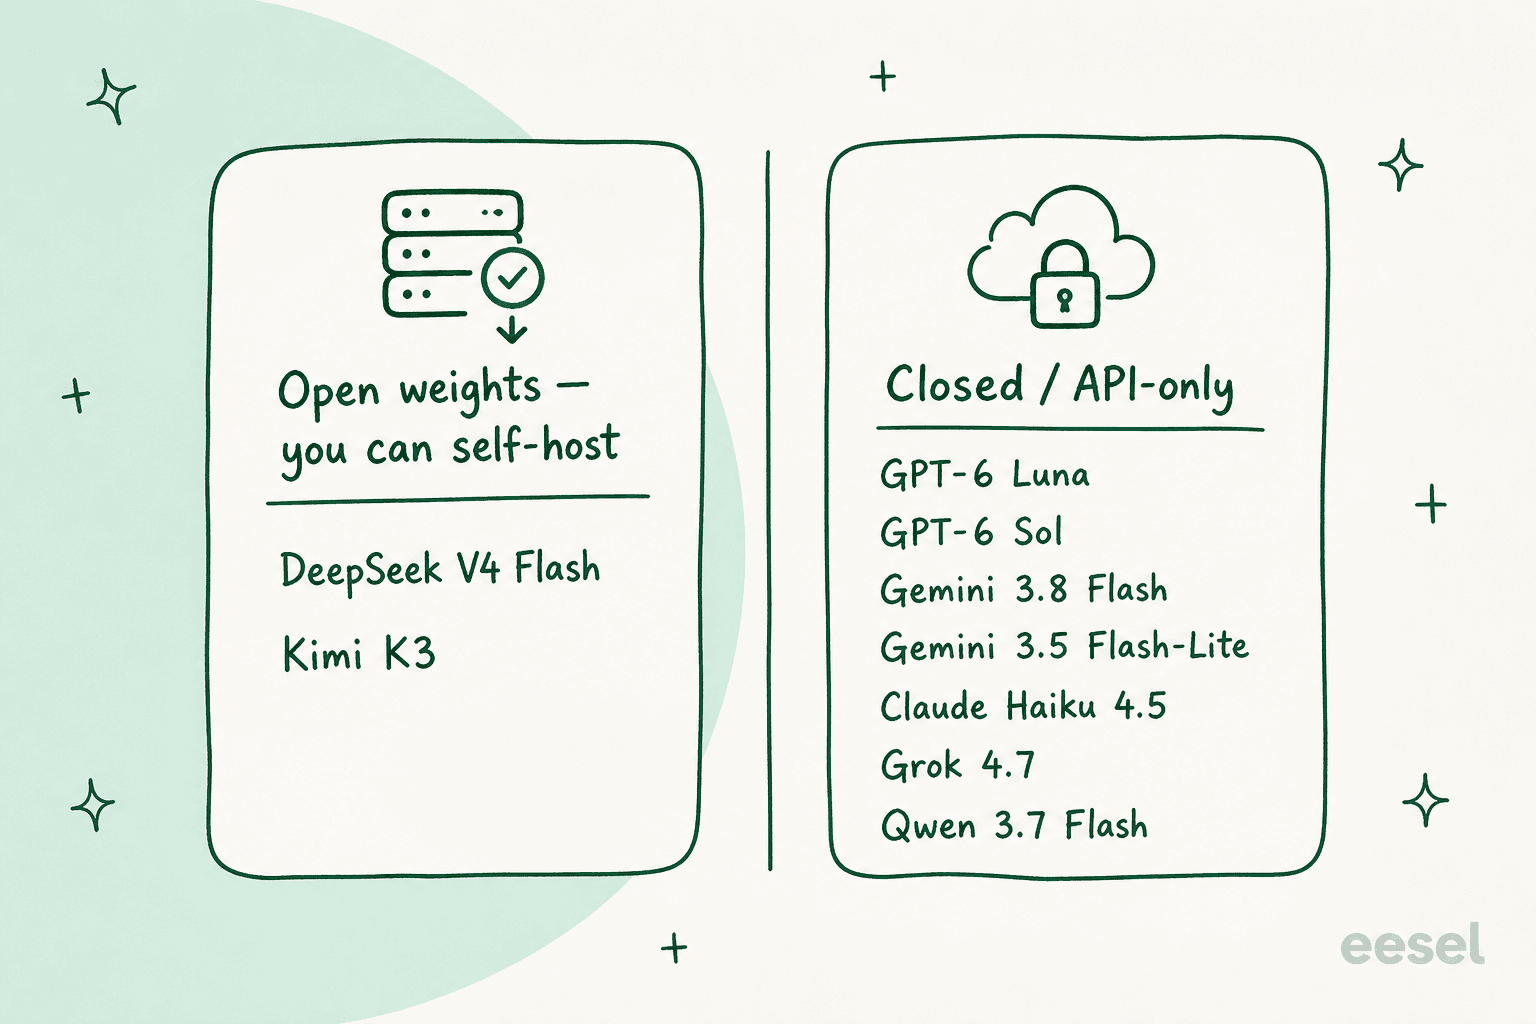
Ce même compromis apparaît chaque fois que vous comparez les meilleurs agents IA : la licence décide de votre architecture avant les benchmarks. La seconde question est celle qui fait trébucher chaque tableur : le moins cher par token n'est pas le moins cher par tâche. Un modèle affiché au tiers du prix de Luna mais qui écrit deux fois plus de tokens pour finir le même travail ne vous fait rien économiser. La seule façon de le savoir est de faire passer vos vrais prompts par deux ou trois candidats et de comparer la facture réelle, pas la grille tarifaire. C'est aussi pourquoi l'abonnement ChatGPT peut discrètement battre tous ces tarifs d'API pour un usage individuel, puisqu'un forfait mensuel fixe contourne entièrement la tarification par token.
La partie que le modèle ne résout pas
Voici ce que j'aimerais entendre si c'était moi qui lisais ceci. Si vous choisissez un modèle bon marché pour faire tourner un vrai travail récurrent, et pour la plupart des équipes qui lisent un article comme celui-ci ce travail est le service client, alors choisir le modèle, c'est les 10 % faciles du travail.
J'ai passé ces dernières années à regarder des équipes mettre de l'IA sur des files d'attente de support en direct, et le schéma est toujours le même. Le modèle brut, ce sont des tokens en entrée, du texte en sortie. Avant qu'il puisse répondre en toute sécurité à un client, quelqu'un doit encore construire la récupération d'information pour qu'il connaisse votre centre d'aide, les garde-fous pour qu'il n'invente pas avec assurance une politique de remboursement, les intégrations pour qu'il puisse consulter une commande, les tests pour que vous découvriez son comportement avant qu'un client ne le fasse, et le chemin d'escalade pour le moment où il doit passer la main à un humain. Un copilote IA pour le service client doit résoudre chacun de ces points. Ce sont les 90 %.
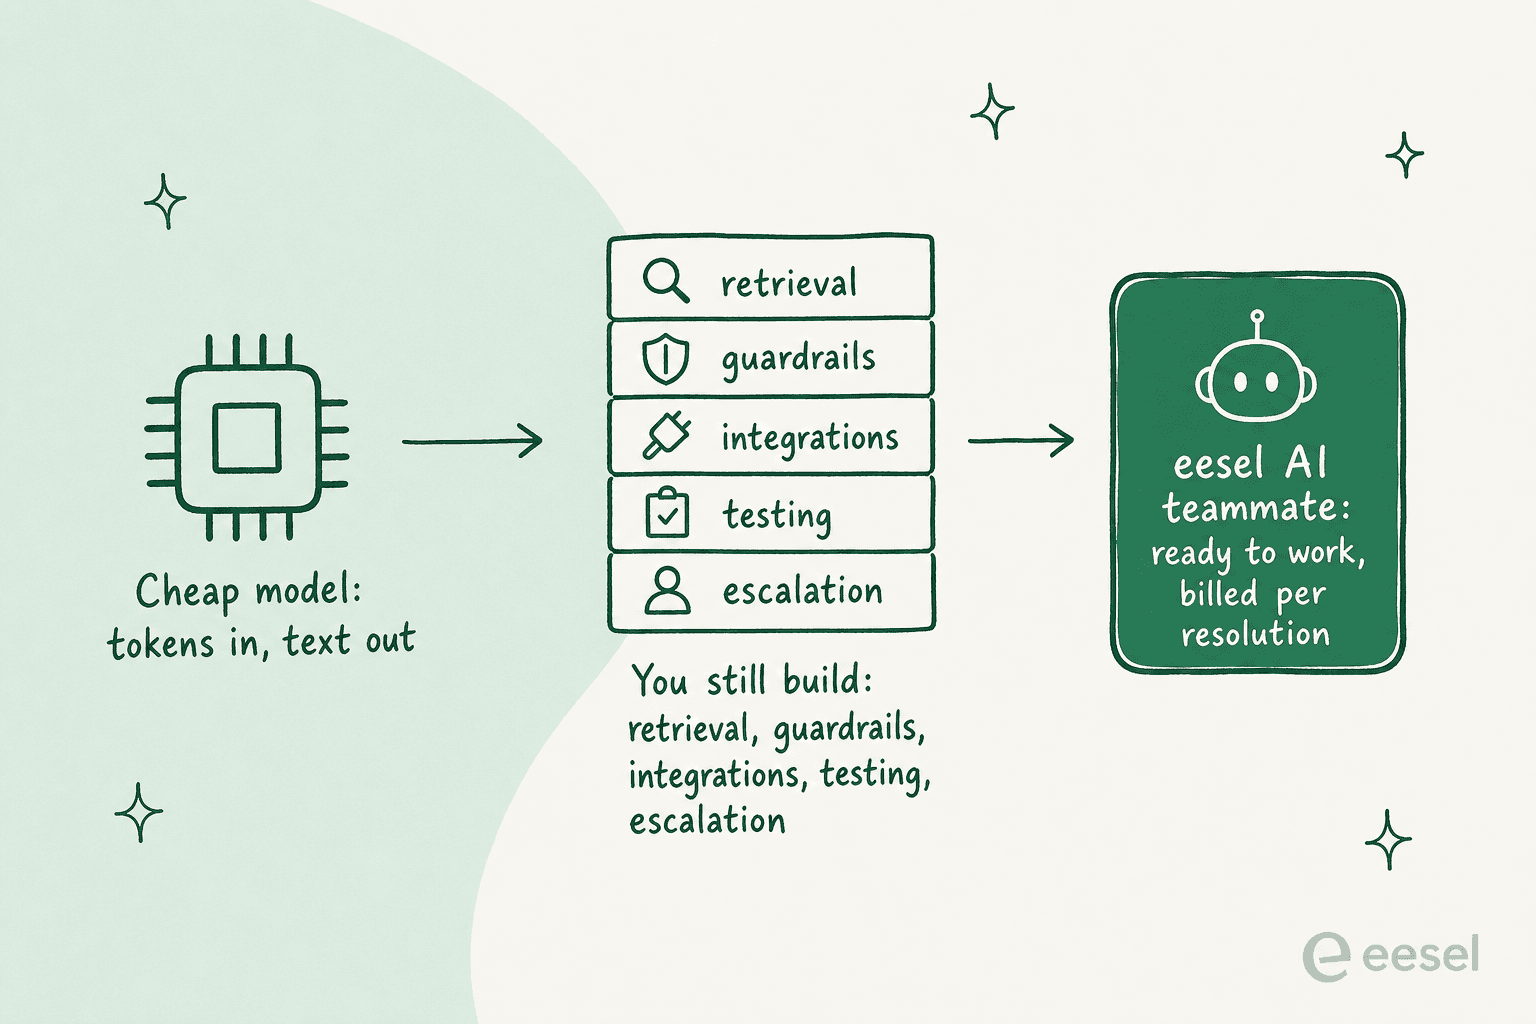
L'erreur la plus coûteuse que je vois, c'est une équipe qui met un modèle bon marché directement en file d'attente, le regarde donner une réponse fausse avec assurance à un vrai client, et seulement alors part à la recherche des 90 % manquants. C'est pourquoi tout déploiement auquel je ferais confiance est d'abord simulé sur des tickets historiques, pour que vous voyiez les mauvaises réponses avant qu'elles n'atteignent jamais une personne.
Essayez eesel AI
C'est ici que je peux être direct sur ce que je construis. Les modèles ci-dessus sont de l'infrastructure. eesel AI est l'employé qui tourne dessus. Plutôt que de vous vendre un modèle et un tas de pièces détachées, nous livrons des coéquipiers IA prêts à travailler pour des tâches spécifiques, et celui que la plupart des lecteurs veulent ici est le coéquipier IA pour le helpdesk.

Il rejoint votre file d'attente existante, apprend de vos anciens tickets et de votre centre d'aide, et est facturé à la résolution, donc vous payez pour du travail effectué plutôt que pour des tokens brûlés. Et parce que vous pouvez le simuler sur vos propres tickets historiques avant qu'il ne touche une file en direct, vous pouvez voir exactement comment il aurait traité de vrais clients au préalable.
Si vous préférez piloter tout cela depuis un terminal ou un script, il y a aussi la CLI eesel. C'est une façon adaptée aux agents d'exploiter le même coéquipier et le même espace de travail : une personne peut l'exécuter à la main, des scripts peuvent l'automatiser, et des agents de codage comme Claude Code, Codex et Cursor peuvent la piloter directement. Vous pouvez connecter une source, pousser des instructions, lancer une simulation, déclencher une exécution et relire l'activité, le tout sans ouvrir le tableau de bord. Si la raison pour laquelle vous comparez des API de modèles bruts est que vous voulez un contrôle programmatique et sans interface, c'est la surface conçue pour cela, adossée à un coéquipier qui gère déjà les 90 % que le modèle ne résout pas.
Vous pouvez essayer eesel AI gratuitement, et si le support est le travail à faire, c'est un chemin bien plus court que de connecter vous-même un modèle bon marché.
Questions fréquentes
Quelles sont les meilleures alternatives à GPT-6 Luna en 2026 ?
Existe-t-il une alternative moins chère à GPT-6 Luna ?
Quel est le modèle GPT-6 le moins cher ?
Quelle alternative à GPT-6 Luna est la meilleure pour le service client ?
Les alternatives à GPT-6 Luna ont-elles des poids ouverts ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.