

Ce qu'est vraiment GPT-6 Sol
Posons le cadre avant les benchmarks. OpenAI a lancé GPT-6 Sol et GPT-6 Luna ensemble le 22 septembre, en les plaçant sous le vaisseau amiral Astra arrivé le 3 septembre. La formule employée par OpenAI est « construisez avec Sol, passez à l'échelle avec Luna » : Sol est le modèle intermédiaire performant contre lequel on développe, Luna est le niveau ultra-économique vers lequel on bascule à gros volume.
Si vous voulez juste le résumé des specs et du prix sans verdict, mes articles aperçu de GPT-6 Sol et tarifs de GPT-6 Sol couvrent ça. Cet avis, lui, porte sur la question de savoir s'il est vraiment bon.
Sur le papier, Sol est un modèle sérieux. Il dispose d'une fenêtre de contexte de 1 050 000 tokens, d'une sortie maximale de 128K, d'une date de coupure des connaissances en avril 2026, et de la panoplie complète d'outils de la Responses API : recherche web et fichiers, interpréteur de code, un shell hébergé, l'utilisation d'ordinateur et MCP. L'effort de raisonnement se décline en six niveaux, de none à max, avec medium par défaut. Il prend du texte et de l'image en entrée, et sort du texte.
Je construis des agents IA pour gagner ma vie, donc la spécification qui m'importe le plus n'est pas le chiffre de contexte qui fait la une, mais le comportement du modèle une fois intégré dans une boucle d'agent. Et c'est là que se trouve la partie intéressante de cet avis, car l'histoire des benchmarks et celle du comportement pointent dans des directions légèrement différentes.
J'ai passé les trois dernières années et quelques à déployer de l'IA sur des files de support réelles, en observant modèle après modèle arriver en production. Le schéma ne change presque jamais : le graphique du lancement dit une chose, et l'expérience réelle en dit une autre. Alors plutôt que de prendre le discours « nouvelle génération » au pied de la lettre, je lis GPT-6 Sol comme deux choses distinctes regroupées dans un seul lancement : une petite mise à jour d'intelligence et une grosse mise à jour tarifaire.
Les deux histoires d'une seule sortie
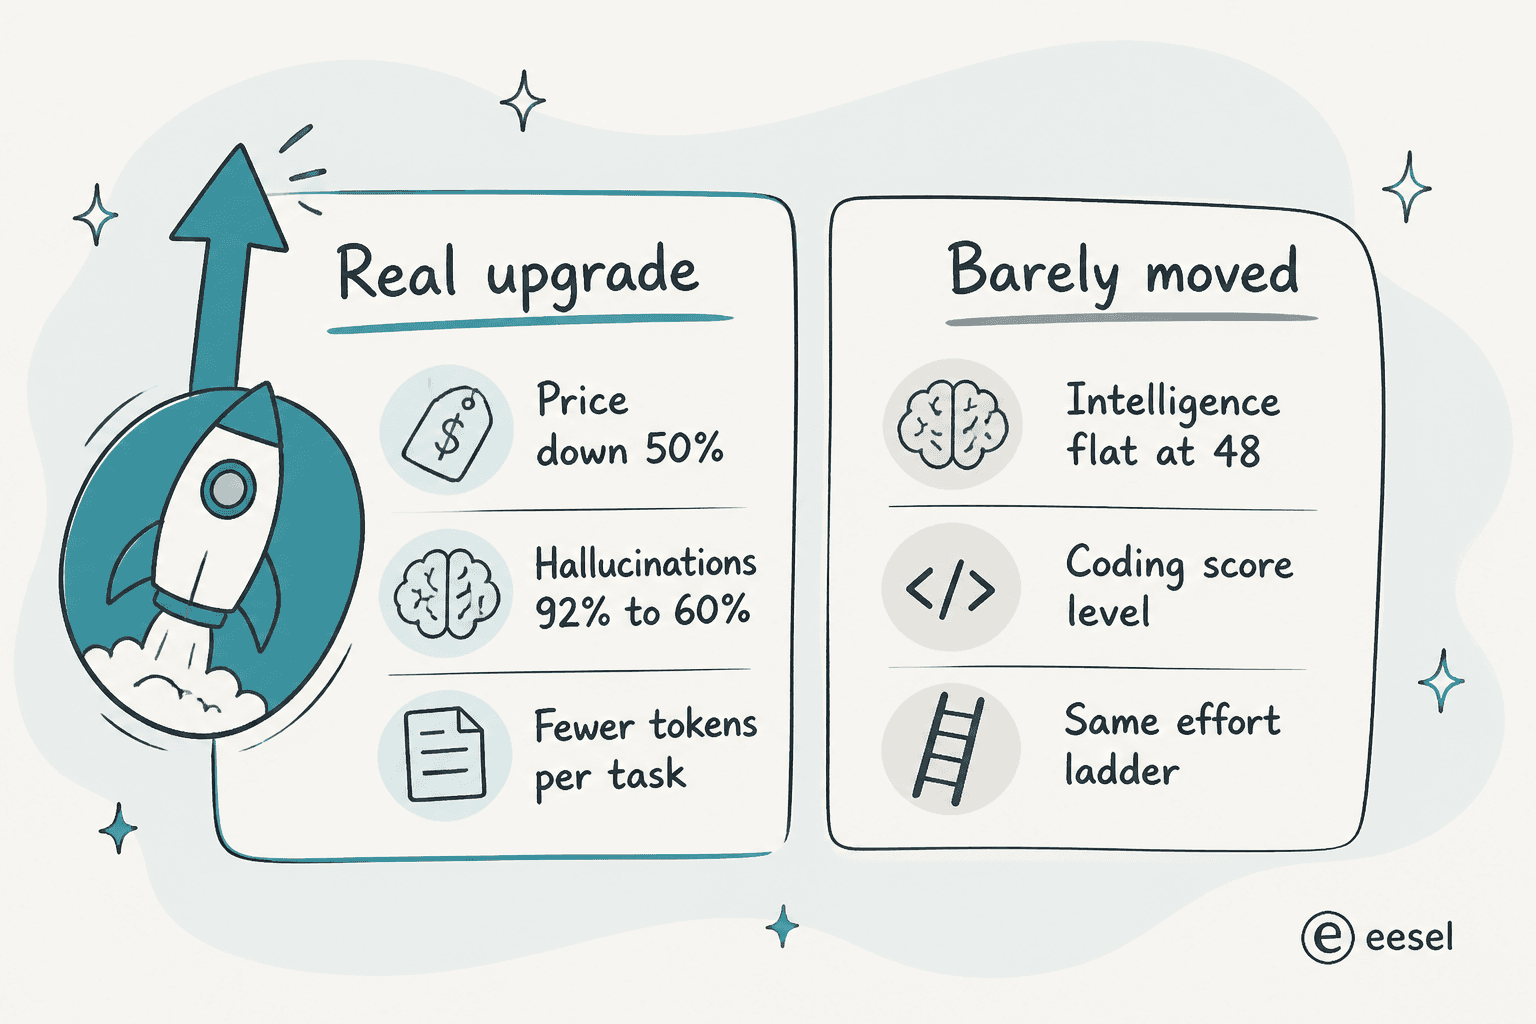
La première histoire est celle qu'OpenAI met en avant : Sol est devenu nettement moins cher. À 2 $/10 $, il coûte deux fois moins que GPT-5.6 Sol, et Artificial Analysis a mesuré le coût pour faire tourner tout l'Intelligence Index à 1,06 $ par tâche, soit environ 50 % de moins que les 1,99 $ de GPT-5.6 Sol. L'entrée en cache descend à 0,20 $, une remise de 90 %. Pour quiconque traite un vrai volume, c'est tout l'argument de vente, et il est solide.
La deuxième histoire est enfouie dans le même tableau de benchmarks : l'intelligence n'a pas vraiment bougé. Sur l'AA Intelligence Index, GPT-6 Sol en effort maximal obtient 48 points, ce qu'AA décrit comme au même niveau que GPT-5.6, « des progrès sur certaines évaluations, des reculs sur d'autres ». Le Coding Agent Index raconte la même histoire : globalement stable, pour un prix plus bas.
Il y a néanmoins un vrai gain de capacité, qui mérite d'être nommé clairement car on peut facilement passer à côté : la fiabilité factuelle. OpenAI affirme que Sol commet environ deux fois moins d'erreurs que GPT-5.6 Sol, et le taux d'hallucination en effort maximal mesuré par AA le confirme, chutant d'environ 92 % à 60 %. Pour quiconque utilise le modèle pour répondre à de vraies questions plutôt que pour écrire du code jetable, moins de réponses fausses données avec assurance vaut sans doute plus qu'un point ou deux de raisonnement brut supplémentaire.
« Dans l'ensemble, je pense que pour la plupart des gens, le gagnant d'aujourd'hui est Anthropic. Je préfère personnellement Opus 5.5 en medium à GPT-6 Sol Max, dans des tests très, très préliminaires. Gamme de prix similaire, plus de capacités. »

Ce commentaire est juste, et c'est le contrepoint honnête à Sol : si vous avez le budget, un modèle plus intelligent existe. Mais il compare aussi Sol en effort maximal à Opus en medium, et comme l'a fait remarquer un autre lecteur en réponse, ce ne sont pas des réglages équivalents. Ce qui m'amène à la partie de cet avis que je juge la plus importante.
Comment il se comporte vraiment dans un agent
Les scores bruts ne captent pas ce que c'est que de travailler avec un modèle. Deux comportements sont revenus sans cesse dans les réactions des développeurs, et les deux correspondent à ce que j'ai observé en intégrant des modèles OpenAI dans des boucles d'agent.
Le premier est l'efficacité en tokens. GPT-6 Sol utilise environ 31 000 tokens de sortie par tâche sur l'index AA, contre environ 119 000 pour Opus 5.5. C'est près de 4 fois moins de tokens pour arriver à une réponse de qualité comparable, ce qui explique en grande partie pourquoi il paraît rapide et pourquoi la facture reste basse. C'est aussi la raison discrète pour laquelle un modèle « moins cher au token » peut se révéler encore moins cher par tâche terminée que ne le laisse penser le prix affiché.
Le deuxième est le zèle excessif, et là, Sol présente un vrai inconvénient :
« Les modèles OpenAI sont aussi beaucoup plus enthousiastes que ceux d'Anthropic, qui sont plutôt du genre paresseux. Livrés à eux-mêmes, Sol/Astra tenteront de construire une fusée vérifiée en sha256 si vous leur demandez de corriger une condition de concurrence dans votre appli de liste de tâches. »
J'ai ri en lisant ça, parce que c'est exact. Donnez à Sol une petite tâche sans cadrage serré, et il ira allègrement sur-ingénierer la solution. Dans un agent, cela signifie que vous devez vous appuyer davantage sur vos instructions et vos garde-fous qu'avec un modèle plus paresseux. Ce n'est pas vraiment un défaut, c'est une personnalité, mais c'en est une qu'il faut concevoir en conséquence.
L'autre facette de cette personnalité, c'est la prose. Dan Shipper d'Every a résumé clairement la différence d'écriture :
« Sol progresse par rapport à GPT-5.6 — notamment avec un meilleur code Ruby dans les tests de @kieranklaassen —, mais Opus 5.5 a le plafond le plus élevé pour les builds longs et autonomes. »
Son avis complet est le résumé le plus clair de toute cette confrontation que j'aie lu : Sol écrit une prose propre et minimale et met l'idée importante en premier, tandis qu'Opus a le plafond le plus élevé pour le travail autonome long. C'est le compromis résumé en une phrase.
L'échelle d'effort est la vraie décision
Voici ce que la plupart des avis sur Sol passent sous silence : avec six niveaux de raisonnement, « GPT-6 Sol est-il bon » est la mauvaise question. La bonne est « bon à quel niveau d'effort, pour quel prix ».
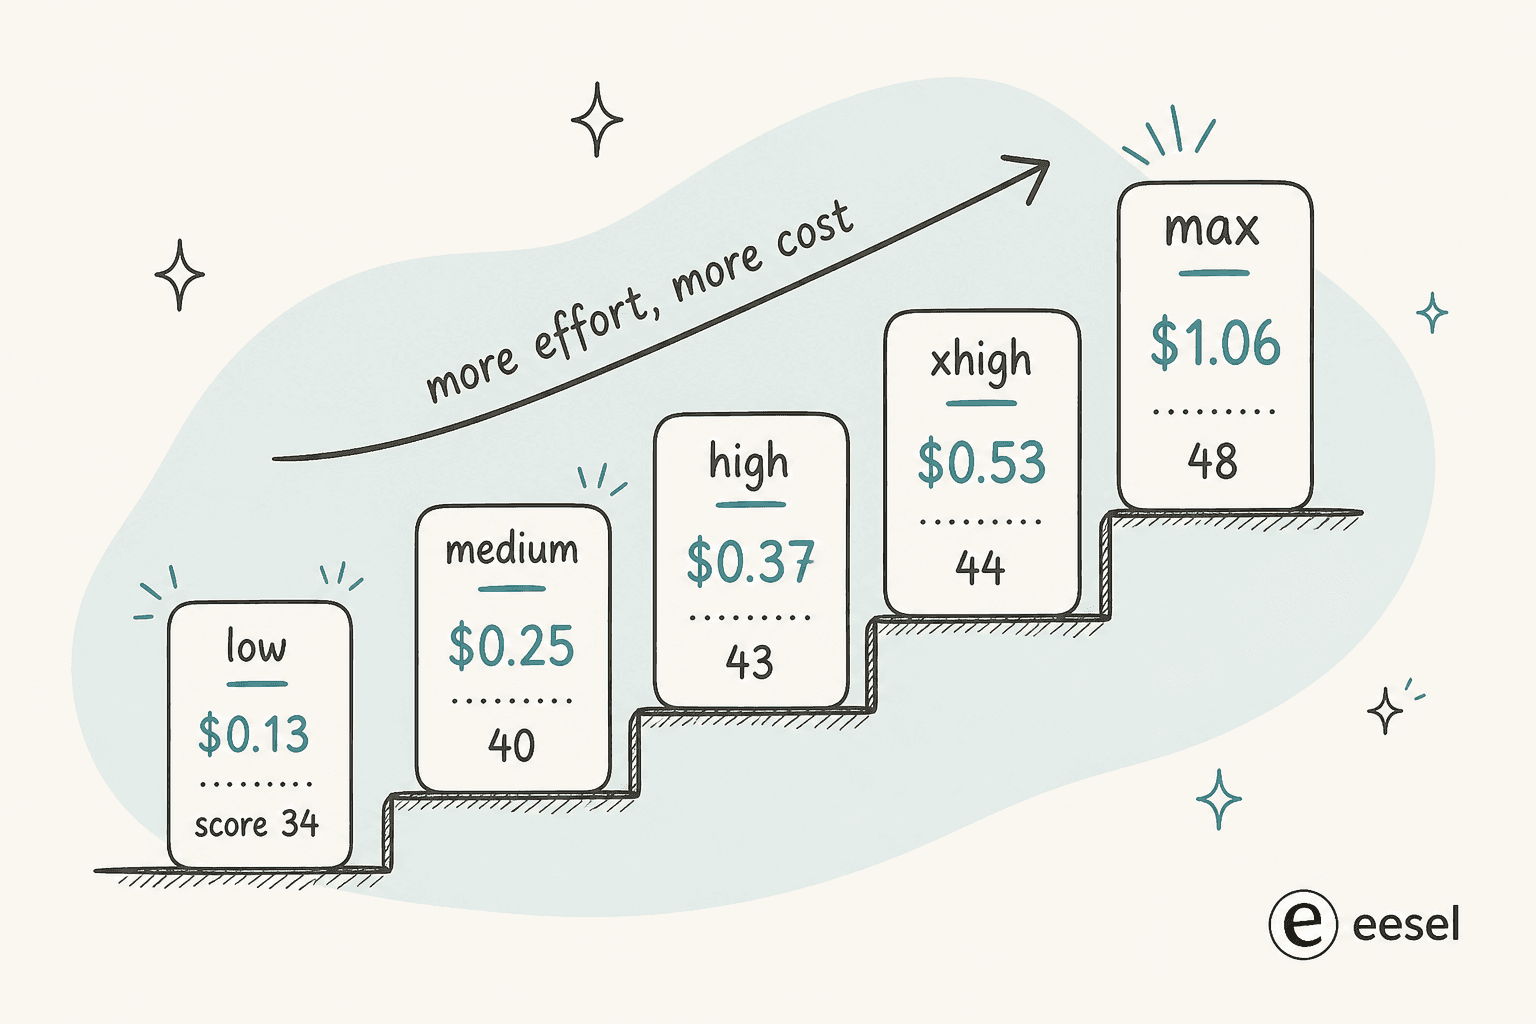
AA a publié la courbe d'effort complète, et l'écart est large. L'effort faible obtient 34 points à 0,13 $ par tâche ; l'effort maximal obtient 48 points à 1,06 $. C'est une variation de coût de 8x pour 14 points d'index. Pour une grande partie du travail réel, le milieu de cette échelle est le point idéal, pas le sommet. Le sélecteur ci-dessous est le modèle mental que j'utilise pour décider quel niveau choisir.
Quel niveau d'effort pour GPT-6 Sol ?
Choisissez la tâche. Les scores et le coût par tâche viennent de l'Artificial Analysis Intelligence Index.
C'est aussi là que se situe la réserve honnête sur le plafond. Même au maximum, le 48 de Sol reste en dessous du 58 d'Opus 5.5 et en dessous de l'Astra d'OpenAI lui-même. Si votre travail a vraiment besoin du sommet du marché, Sol n'est pas le bon choix. Mais la plupart des travaux n'en ont pas besoin, et cet écart est exactement ce que vous économisez à moitié prix.
Tarifs : la vraie raison de s'y intéresser
Je vais être direct : le prix, c'est tout l'avis. Voici comment Sol se positionne face à ses frères et à son rival le plus proche.
| Modèle | Entrée/sortie (par 1M) | Entrée en cache | AA Intelligence | Coût par tâche AA |
|---|---|---|---|---|
| GPT-6 Luna | 0,10 $ / 0,50 $ | 0,01 $ | non répertorié | n/a |
| GPT-6 Sol | 2 $ / 10 $ | 0,20 $ | 48 | 1,06 $ |
| GPT-6 Astra | 10 $ / 50 $ | 1,00 $ | ~61 | plus élevé |
| Claude Opus 5.5 | 4 $ / 20 $ | 0,20 $ | 58 | 5,98 $ |
Deux choses ressortent. D'abord, Sol coûte moitié moins cher qu'Opus 5.5 au token, ce qu'un lecteur a utilisé pour affirmer qu'ils ne sont même pas dans la même catégorie. Ensuite, et c'est ce qui m'a surpris : comme Sol consomme tellement moins de tokens en sortie, son coût par tâche terminée (1,06 $) est plus proche d'un cinquième d'Opus 5.5 (5,98 $) que de la moitié. L'écart au token sous-estime l'écart réel.
Deux réserves gardent ce constat honnête. Le mode Fast double le tarif à 4 $/20 $, et les entrées au-delà de 272K tokens subissent une surtaxe de contexte long, qui, comme l'a noté un lecteur, réduit l'avantage tarifaire de Sol dès qu'on lui fournit d'énormes contextes. Si votre workflow est vraiment gourmand en contexte long, refaites le calcul. Mon article sur les tarifs de GPT-6 Sol contient le tableau complet par niveau, et le guide des tarifs de Codex explique comment cela se traduit dans l'abonnement plutôt que dans l'API.
Qui devrait vraiment l'utiliser
Après tout ça, voici ma recommandation claire.
Utilisez GPT-6 Sol si vous passez vos journées dans Codex ou l'API à faire du codage quotidien, de la rédaction et des questions-réponses, et que vous voulez un modèle rapide, bon marché et prévisible qui ne gaspille pas de tokens. Si vous étiez sur GPT-5.6 Sol, c'est une mise à niveau directe : même intelligence, coût divisé par deux, moins d'hallucinations. C'est mon choix par défaut pour un usage à fort volume.
Cherchez ailleurs si vous avez besoin du plafond le plus élevé pour des builds longs, autonomes et de plusieurs heures, auquel cas Opus 5.5 ou Astra méritent leur prime, ou si votre travail est fortement orienté contexte long, où la surtaxe grignote les économies. Et si vous construisez des agents IA, gardez à l'esprit que le zèle excessif de Sol appelle un cadrage et des garde-fous plus stricts, pas moins.
Pour un comparatif complet sur la question de pointe, mon article GPT-6 Sol vs Opus 5.5 et l'avis critique sur GPT-6 Astra vont plus loin que je ne peux le faire ici, et la liste des modèles OpenAI cartographie toute la gamme.
L'écart entre un modèle et une recrue
Voici le piège dans lequel je vois les équipes tomber à chaque semaine de lancement, et ça vaut la peine de terminer là-dessus. Un modèle qui domine les benchmarks n'est pas un coéquipier opérationnel. GPT-6 Sol est un moteur rapide, bon marché et capable, mais ce n'est encore qu'un moteur : branchez l'API brute sur votre file de support, et vous héritez de la recherche documentaire, des garde-fous, de l'intégration au helpdesk, des tests, et de chaque mauvaise réponse qu'il livre avec assurance le premier jour.
Ce dernier point, c'est là que j'ai gagné mes cicatrices. Nous avons vu un bot à l'air sûr de lui donner discrètement de mauvaises réponses sur une file en production, ce qui explique exactement pourquoi chaque déploiement est aujourd'hui simulé sur des milliers de tickets historiques avant de toucher un vrai client. Un modèle brut ne vous offre rien de tout ça.
C'est la distinction sur laquelle repose eesel : un modèle est une infrastructure, eesel est l'employé. eesel est une plateforme de coéquipiers IA, et vous embauchez des coéquipiers prêts à l'emploi pour des postes précis. L'effectif actuel comprend un coéquipier IA pour le helpdesk et un rédacteur de blog IA, chacun arrivant avec les compétences, les intégrations et le contexte de l'entreprise pour son poste. Le coéquipier helpdesk rejoint votre file existante, apprend de vos tickets passés et facture à la résolution, pour que vous puissiez le comparer au coût d'un agent humain au lieu de deviner. C'est la différence entre une expérimentation brute d'IA conversationnelle et de vraies économies de coûts de support que vous pouvez chiffrer.

Et si vous êtes le genre de développeur qui a apprécié Sol précisément parce qu'il vit dans un terminal, eesel vous y retrouve aussi. La CLI eesel pilote le même coéquipier et le même espace de travail depuis la ligne de commande : une personne peut l'utiliser de manière interactive, des scripts peuvent l'automatiser, et des agents de code comme Claude Code, Codex ou Cursor peuvent l'exploiter en mode headless. Vous pouvez connecter des sources, transmettre des instructions, lancer une simulation sur des tickets historiques et vérifier l'activité, le tout sans ouvrir le tableau de bord. C'est la même surface adaptée aux agents et compatible MCP que vous voudriez si vous construisiez vous-même sur Sol, sauf que la recherche documentaire et les garde-fous sont déjà en place. Vous pouvez essayer eesel gratuitement.
Questions fréquentes
Le bloc de questions fréquentes ci-dessus répond aux questions les plus courantes sur l'avis GPT-6 Sol, du prix à la comparaison avec Astra et Opus 5.5. Si vous hésitez entre plusieurs modèles, commencez par le comparatif GPT-6 Sol vs Opus 5.5, puis par le classement des meilleurs agents IA si vous construisez quelque chose qui résout vraiment des tickets plutôt que de simplement répondre à des prompts.