Pourquoi regarder au-delà de GPT-6 Sol
Soyons d'abord justes envers Sol, car il le mérite. Il est sorti le 23 septembre 2026 comme le niveau intermédiaire de la famille GPT-6, entre GPT-6 Luna et le porte-étendard GPT-6 Astra. Le message d'OpenAI est simple et honnête : la même intelligence générale que GPT-5.6 Sol, environ deux fois moins d'erreurs factuelles, pour moitié moins cher côté API. Il dispose d'une fenêtre de contexte de 1 050 000 tokens, de la recherche web, d'un interpréteur de code, d'un shell hébergé, de l'utilisation d'ordinateur et d'un support MCP intégré. Pour la plupart des échanges quotidiens, de l'extraction et de la rédaction, il donne une très bonne réponse pour un prix raisonnable.
Alors pourquoi chercher ailleurs ? Quelques raisons concrètes reviennent sans cesse.
D'abord, le prix à volume. Les 2 $ d'entrée et 10 $ de sortie par million de tokens de Sol se situent dans la moyenne, pas dans le bon marché. Quand vous faites tourner un modèle dans une boucle d'agent qui l'appelle des milliers de fois par jour, le prix de sortie est le chiffre qui décide de votre facture, et plusieurs modèles ci-dessous facturent une fraction des 10 $ de Sol.
Ensuite, il est verrouillé sur OpenAI. Sol a des poids fermés et, sur l'API, n'est sur aucun palier gratuit, donc le Tier 1 est votre plancher. Si votre conformité exige l'auto-hébergement, ou si vous voulez simplement éviter le risque de dépendre d'un seul fournisseur, Sol ne peut pas vous aider ici.
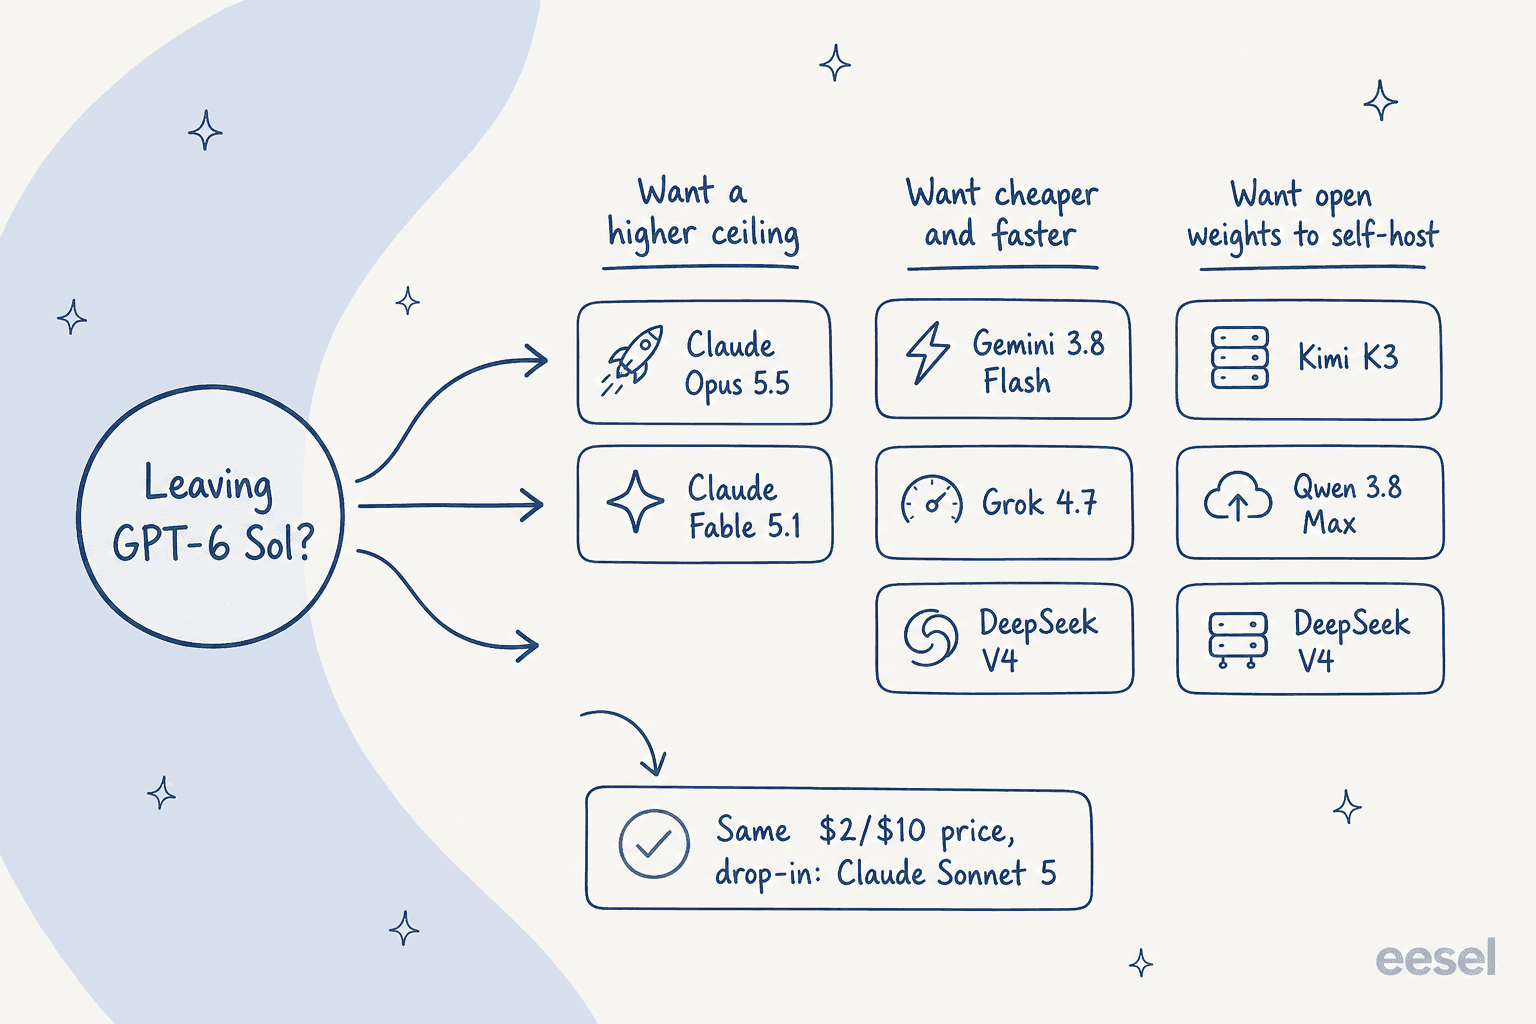
Enfin, c'est une sortie orientée rapport qualité-prix, pas un saut de capacité. En intelligence générale, il est à peu près au niveau du modèle qu'il remplace. Si vous avez vraiment besoin d'un modèle plus intelligent pour du code difficile ou du travail d'agent à long terme, il faut regarder plus haut dans la gamme, pas sur le côté.
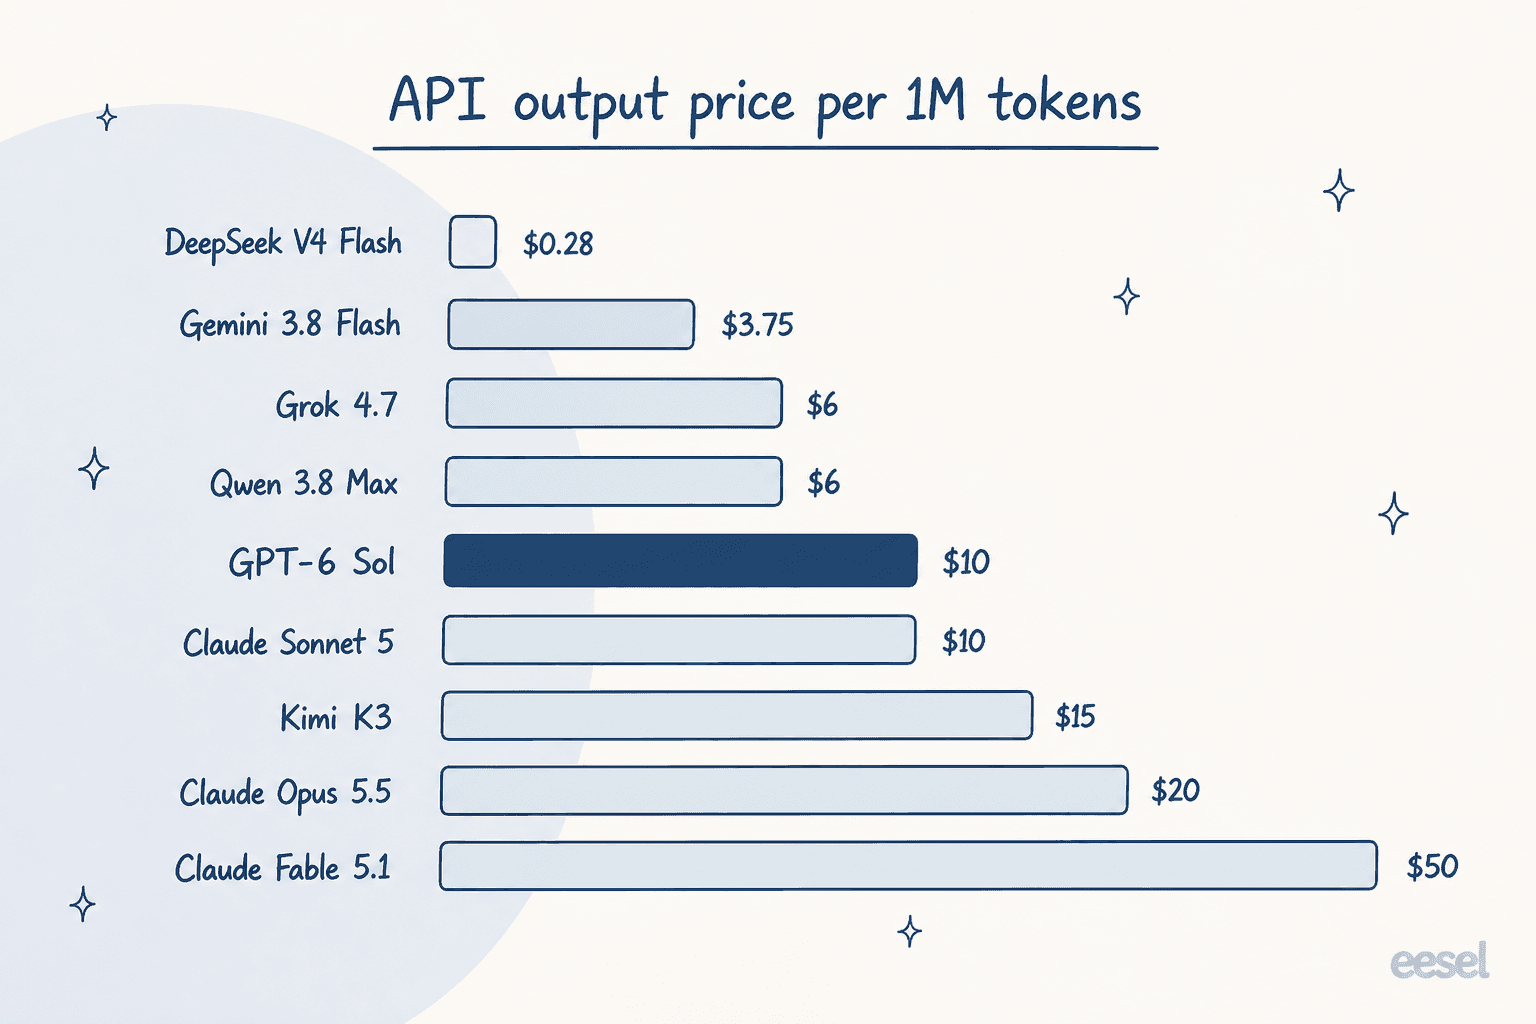
Cet écart de prix de sortie raconte toute l'histoire en une image. Les 10 $ de Sol se situent juste au milieu, avec des modèles économiques un ordre de grandeur moins chers d'un côté et des modèles de pointe cinq fois plus chers de l'autre. La direction dans laquelle vous allez dépend entièrement du travail à faire.
Comment j'ai choisi ces alternatives
J'ai limité la liste aux modèles réels, généralement disponibles, qu'une équipe pourrait vraiment mettre en production aujourd'hui. J'ai pesé quatre critères :
- Le prix, honnêtement. Les tarifs réels d'entrée et de sortie par million de tokens, plus les pièges (surcoûts de contexte long, prix du cache, tarifs promotionnels qui expirent).
- La capacité pour le prix. Où se situe le modèle sur les benchmarks publics et les mesures indépendantes comme Artificial Analysis, pas seulement sur le graphique du fournisseur lui-même.
- L'ouverture. API fermée uniquement, ou poids ouverts que vous pouvez télécharger et héberger.
- L'adéquation au travail. Cheval de bataille équilibré, plafond de pointe, budget-et-vitesse, ou auto-hébergement. Personne n'a besoin de huit modèles ; il faut le bon pour sa situation.
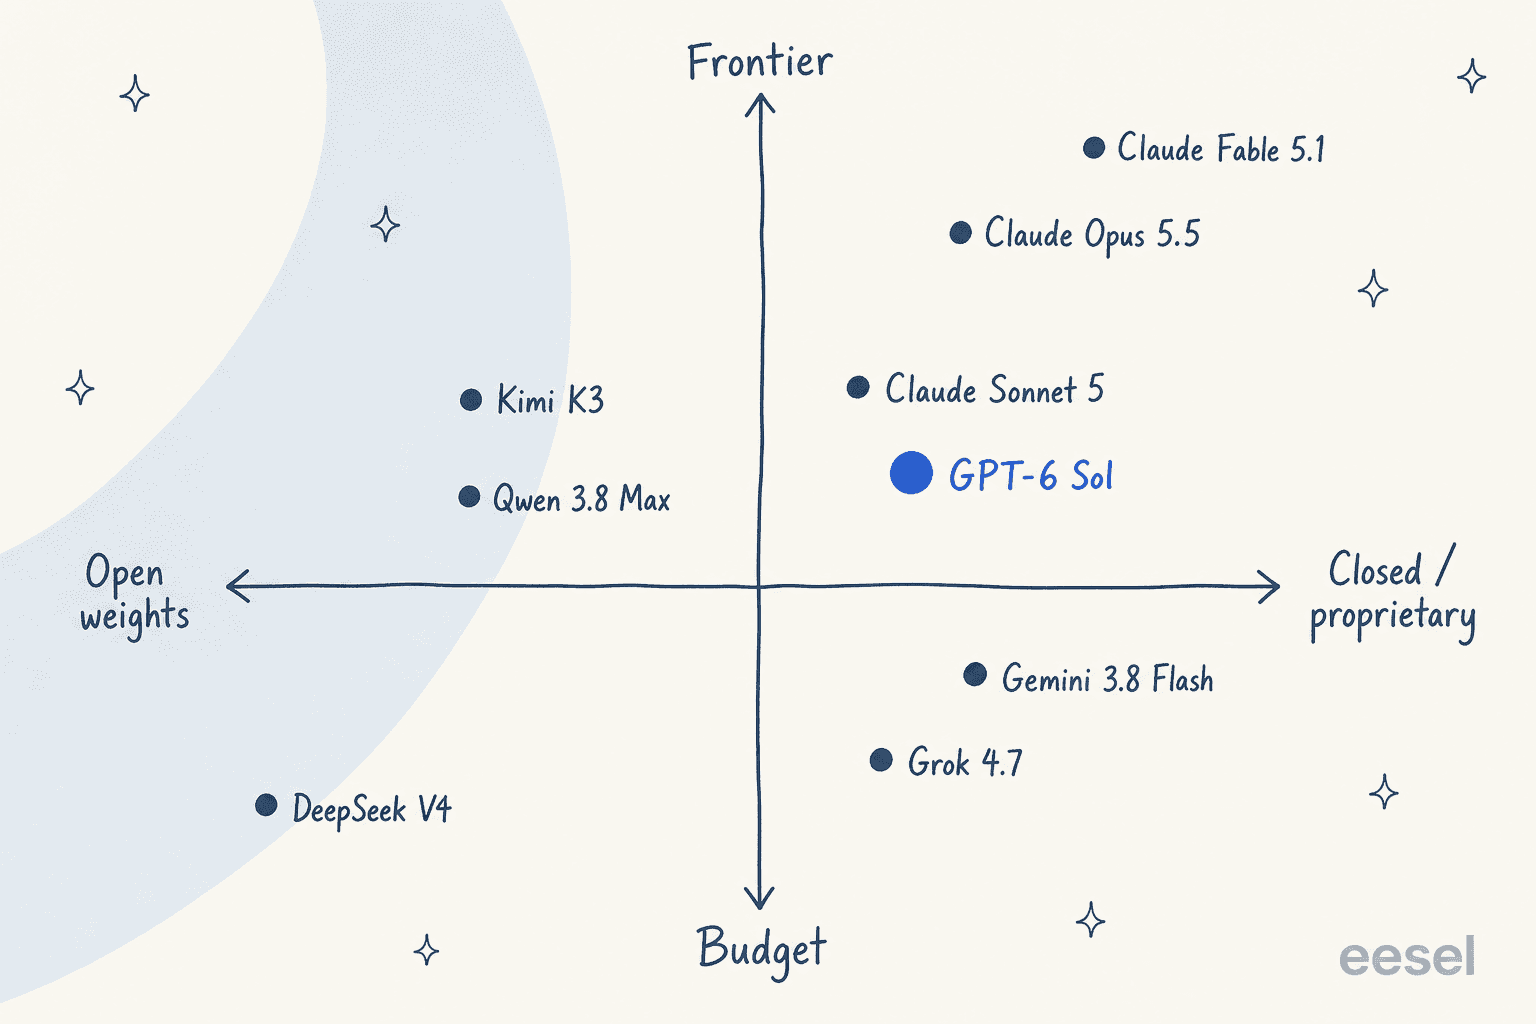
Voici tout le paysage en un coup d'œil avant de les passer en revue un par un.
| Modèle | Idéal pour | Prix API (entrée / sortie par 1M) | Contexte | Poids |
|---|---|---|---|---|
| Claude Sonnet 5 | Remplacement direct au même prix | $2 / $10 | 1M | Fermé |
| Claude Opus 5.5 | Un plafond plus élevé, ajustable par l'effort | $4 / $20 | 1M | Fermé |
| Google Gemini 3.8 Flash | Option rapide la moins chère à grande échelle | $0.75 / $3.75 | 1M | Fermé |
| Grok 4.7 | Sortie moins chère dans les boucles d'agents | $2 / $6 | 500K | Fermé |
| Kimi K3 | Modèle phare à poids ouverts | $3 / $15 | 1M | Ouvert |
| DeepSeek V4 | Budget minimal + auto-hébergement | $0.14 / $0.28 (Flash) | ~1M | Ouvert |
| Qwen 3.8 Max | Écosystème ouvert, multilingue | $2 / $6 | 1M | Ouvert (base) |
| Claude Fable 5.1 | Plafond de pointe pour le travail difficile | $10 / $50 | 1M | Fermé |
Une note rapide sur cette question du « plus intelligent », puisqu'elle revient immédiatement. Sur l'instantané de l'Artificial Analysis Intelligence Index pris le jour où Sol et Opus 5.5 sont sortis tous les deux, Opus 5.5 se situait à 58 (premier sur 212 modèles) contre 48 pour Sol. C'est un écart réel. Mais AA rééchelonne son index périodiquement, donc j'ai évité de coller un seul chiffre d'index à côté de chaque modèle ici ; comparer le score d'un instantané d'une semaine à celui d'une autre est exactement la façon dont on publie du n'importe quoi par accident. Là où je cite un benchmark plus bas, c'est sur une base en laquelle j'ai confiance.
1. Claude Sonnet 5 – le remplacement au même prix
Idéal pour : les équipes qui veulent un cheval de bataille équilibré au prix exact de Sol, sans dépendance à OpenAI.
Si Sol est le modèle équilibré du quotidien, Claude Sonnet 5 occupe la même place, venant de l'autre grand laboratoire. Et le tarif n'est pas seulement proche, il est identique : 2 $ d'entrée et 10 $ de sortie par million de tokens, avec des lectures de cache à 0,20 $. Ce 2 $/10 $ a brièvement été un tarif de lancement censé passer à 3 $/15 $, mais Anthropic a annulé la hausse en août 2026, ce qui en fait désormais le tarif standard permanent, pas une promo qui va expirer.
Ce que vous obtenez pour le même prix, c'est un ensemble de forces différent. Sonnet 5 a une fenêtre de contexte de 1M de tokens et une réputation de prose longue plus propre et de sessions de code longues plus stables. Là où il traîne, c'est sur la fraîcheur des connaissances : sa date limite d'entraînement est janvier 2026, plus ancienne que celle de Sol, et Anthropic a publié moins de chiffres de benchmarks tête-à-tête en texte brut qu'OpenAI.
Avantages : tarif identique de 2 $/10 $ ; écriture et code solides ; contexte de 1M ; une couverture de second fournisseur contre le risque de ne dépendre que d'OpenAI.
Inconvénients : date limite de connaissances plus ancienne ; moins de benchmarks publiés à vérifier ; pas de palier gratuit intégré sur l'API.
Mon avis : si la seule raison pour laquelle vous restez sur Sol est « c'était le choix par défaut sensé », Sonnet 5 est la première alternative à essayer, car le changement ne vous coûte rien côté prix et vous achète de la flexibilité. Choisissez-le si vous valorisez la qualité de la prose ou voulez éviter de dépendre d'un seul fournisseur ; restez sur Sol si vous dépendez fortement de l'écosystème d'outils d'OpenAI.
2. Claude Opus 5.5 – un vrai bond en plafond
Idéal pour : les équipes qui ont besoin de plus de capacité brute que Sol et sont prêtes à ajuster l'effort pour maîtriser les coûts.
Opus 5.5 est le cas intéressant, car la lecture naïve se trompe. Sur le papier, il coûte plus cher que Sol : 4 $ d'entrée, 20 $ de sortie par million, le double du tarif par token de Sol. Il a aussi dominé cet index Artificial Analysis du jour de sortie avec 58 contre 48 pour Sol. Il est donc plus intelligent et plus cher, et on supposerait que le calcul par tâche suit l'étiquette de prix.
Ce n'est pas le cas, et c'est la partie non évidente qui mérite d'être intégrée. Comme vous ajustez Opus 5.5 par l'effort de raisonnement, le coût ajusté à l'effort peut inverser la comparaison. Dans le face-à-face, Opus 5.5 en effort moyen a obtenu 51 points pour environ 1,34 $ par tâche, battant Sol en effort maximal qui obtient 48 pour 1,06 $, avec une marge de qualité large pour une petite prime de coût. Au tout sommet, Sol est bien moins cher par tâche (1,06 $ contre 5,98 $ pour Opus au maximum), car Opus consomme beaucoup plus de tokens de sortie. La durée de la tâche et l'effort sont le point charnière, pas le nom du modèle.
Opus 5.5 est aussi le premier Opus d'Anthropic à devenir moins cher que son prédécesseur, une baisse de 20 %, et Anthropic recommande désormais de commencer par lui pour la plupart des travaux. La lecture de la communauté est plus partagée sur la verbosité :
writes like gemini, a drastic improvement over the opus 5.1 claudeisms

Avantages : saut de capacité net par rapport à Sol ; le curseur d'effort permet d'acheter de la qualité à bas prix sur les tâches courtes ; baisse de prix de 20 % par rapport à Opus 5 ; date limite de juin 2026.
Inconvénients : cher par tâche en effort maximal ; peut encore être verbeux ; excessif pour de l'extraction simple ou du chat.
Mon avis : choisissez Opus 5.5 quand les réponses de Sol ne sont pas tout à fait assez bonnes et que vous allez réellement ajuster le niveau d'effort. Si vous comptez de toute façon tout faire tourner au maximum sans jamais toucher au curseur, vous paierez pour une capacité que vous n'utilisez pas.
3. Google Gemini 3.8 Flash – le rapide et pas cher
Idéal pour : les charges de travail à fort volume où le coût et le débit priment sur tout le reste.
Si votre goulot d'étranglement est le budget, Gemini 3.8 Flash est le choix évident. Il coûte 0,75 $ d'entrée et 3,75 $ de sortie par million jusqu'au 31 décembre 2026, puis exactement le double à partir du 1er janvier 2027 (1,50 $/7,50 $). Même au tarif 2027, il reste en dessous du prix de sortie de Sol. Il a une fenêtre d'entrée de 1M de tokens, un palier gratuit, et sur Artificial Analysis il se classe troisième sur 196 modèles en vitesse de sortie brute.
Deux mises en garde honnêtes. D'abord, ce n'est pas un nouveau modèle de base ; la fiche modèle de Google elle-même dit à quatre reprises qu'il est « basé sur Gemini 3.7 Flash », et Google dit littéralement aux développeurs soucieux d'efficacité de rester sur 3.7. Ensuite, le débit n'est pas la même chose que la réactivité : AA a mesuré son temps jusqu'au premier token à 13,3 secondes contre une médiane de classe de 3 secondes. C'est très bien pour un traitement par lots nocturne et c'est un vrai problème pour tout ce qu'un humain attend, comme une réponse de chat en direct.
Avantages : l'option rapide la moins chère ici ; contexte énorme ; palier gratuit ; excellent débit.
Inconvénients : latence lente du premier token ; pas un modèle véritablement nouveau ; peut être verbeux et consommer des tokens supplémentaires.
Mon avis : tournez-vous vers Gemini 3.8 Flash pour les gros traitements par lots et les tâches en arrière-plan où le coût par token domine. Pour tout ce qui est sensible à la latence, son premier token lent le disqualifie, et je regarderais plutôt Grok ou Sonnet.
4. Grok 4.7 – une sortie moins chère pour les boucles d'agents
Idéal pour : les charges de travail agentiques qui appellent le modèle en continu et se soucient du prix de sortie.
Grok 4.7 de xAI est arrivé le 21 septembre 2026 et égale Sol en entrée (2 $) tout en étant moins cher en sortie : 6 $ par million contre 10 $ pour Sol, en dessous d'un prompt de 200K tokens. Il repose sur un nouveau modèle de base plus grand que Grok 4.6, avec un entraînement par renforcement plus long orienté vers des tâches agentiques de plusieurs heures, et affiche un vrai bond sur les benchmarks d'agents, quasiment doublant son score Terminal-Bench 4.0 par rapport à 4.6.
Surveillez deux choses. Le tarif du contexte long est un piège qui mérite d'être lu deux fois : au-delà de 200K tokens de prompt, le tarif passe à 4 $/12 $ et s'applique à tous les tokens de la requête, pas seulement au dépassement. Et sur certaines évaluations, Grok 4.7 perd réellement face à Sol ; sur HealthBench Professional, il obtient 56,7 contre 60,5 pour Sol, donc ce n'est pas une victoire nette partout.
Avantages : sortie moins chère que Sol ; grosse amélioration agentique par rapport à 4.6 ; pile de sécurité solide ; contexte de 500K.
Inconvénients : une falaise tarifaire punitive sur le contexte long ; perd face à Sol sur certains domaines ; la variante « Fast » est réservée à Cursor et Grok Build, pas à l'API publique.
Mon avis : Grok 4.7 a un tarif pensé pour tourner à fort volume dans des boucles d'agents, et c'est exactement là que je l'utiliserais. Gardez simplement les requêtes sous la limite de 200K tokens, sinon le tarif du contexte long efface les économies.
5. Kimi K3 – le modèle phare à poids ouverts
Idéal pour : les équipes qui veulent un modèle de classe frontière qu'elles peuvent réellement télécharger.
Kimi K3 de Moonshot AI se distingue si l'ouverture compte. C'est un modèle à mélange d'experts de 2,8 billions de paramètres (104 Md actifs), avec un contexte de 1M de tokens, et surtout, les poids sont sortis dans les temps sur Hugging Face, où l'index safetensors confirme le total de 2,8 billions indépendamment du communiqué de presse. Vous pouvez l'exécuter vous-même.
Sur l'API hébergée, il coûte 3 $ d'entrée et 15 $ de sortie par million, dans la même fourchette que Claude Sonnet, donc ce n'est pas la bonne affaire qu'était K2 ; la valeur est dans les poids ouverts, pas dans le tarif de l'API. Sur les benchmarks, il bat la génération précédente de modèles de pointe et reste derrière la classe supérieure actuelle comme Fable 5.1 et GPT-5.6 Sol. Une particularité à connaître : le raisonnement ne peut être désactivé à aucun niveau, donc son réglage le moins cher est un contrôle de latence, pas un vrai palier de coût.
Avantages : poids vraiment ouverts, vérifiés sur Hugging Face ; qualité proche de la pointe ; contexte de 1M ; vision native.
Inconvénients : le tarif API est de milieu de gamme, pas bon marché ; le raisonnement est toujours actif ; les URLs d'images publiques ne sont pas acceptées (base64 uniquement).
Mon avis : si votre raison de quitter Sol est qu'il est fermé, Kimi K3 est le modèle phare à poids ouverts le plus solide à auto-héberger. Si vous voulez juste une API hébergée moins chère, ses 3 $/15 $ ne le sont pas, et je regarderais plutôt DeepSeek.
6. DeepSeek V4 – le roi du budget que vous pouvez héberger
Idéal pour : l'option par token absolument la moins chère, avec le bonus des poids ouverts.
C'est avec DeepSeek V4 que la courbe des prix s'effondre. Le palier Flash coûte 0,14 $ d'entrée et 0,28 $ de sortie par million, environ un trente-cinquième du prix de sortie de Sol, avec des poids ouverts en prime. Il y a un rebondissement vraiment étrange à connaître : après un réentraînement fin juillet, le palier Flash, moins cher, dépasse actuellement le palier Pro, plus cher, sur les neuf benchmarks agentiques que DeepSeek publie, et Artificial Analysis place Flash devant Pro dans son propre index. Le palier cher est simplement la version la plus ancienne pour l'instant.
Là où Pro se justifie encore, c'est sur le rappel et la recherche d'aiguilles en contexte long, sur des choses comme SimpleQA-Verified et la récupération à 1M de tokens. Et une mise en garde équitable : sur le classement de préférence humaine de LMArena, Pro reste devant Flash, donc l'index automatisé et les votants humains ne sont pas d'accord. Lisez les deux avant de vous engager.
Avantages : de loin le moins cher ici ; poids ouverts ; Flash frappe bien au-dessus de son prix.
Inconvénients : la nomenclature des paliers est vraiment déroutante en ce moment ; le raisonnement de Pro ne peut pas être réduit à bas coût ; écosystème plus petit que celui des grands laboratoires.
Mon avis : pour un travail sensible aux coûts et à fort volume, DeepSeek V4 Flash est imbattable sur le prix et étonnamment capable. Commencez par Flash, pas par Pro, malgré les noms, et faites vos propres benchmarks sur votre tâche avant de supposer que le palier bon marché est moins bon.
7. Qwen 3.8 Max – le pari de l'écosystème ouvert
Idéal pour : les équipes qui veulent une base ouverte, de solides performances multilingues et un grand cloud derrière.
Qwen 3.8 Max d'Alibaba est devenu disponible de façon générale le 2 août 2026. C'est un modèle à mélange d'experts de 2,4 billions de paramètres (95 Md actifs) avec un contexte de 1M, au tarif de 2 $ d'entrée et 6 $ de sortie par million, égalant Sol en entrée et le battant en sortie. Sur LMArena, il est solide : cinquième au classement Texte et deuxième en Vision au moment de la vérification.
L'histoire de l'ouverture comporte un astérisque. Les poids de base sont bien sortis sous le nom Qwen3.8-2.4T-A95B, mais sous une licence personnalisée qwen3.8-max, pas Apache 2.0, et la base ouverte n'est pas équivalente en fonctionnalités au Max hébergé (qui ajoute la vision, le mode sans réflexion et des outils intégrés). Si vous voulez un Qwen sous licence permissive, le plus petit Qwen3.8-27B est celui sous Apache 2.0. Lisez donc la licence avant de construire dessus.
Avantages : sortie moins chère que Sol ; solide sur LMArena, en particulier en vision et en multilingue ; poids de base ouverts disponibles.
Inconvénients : la licence de Max est personnalisée, pas Apache ; la base ouverte manque des fonctionnalités hébergées ; les classements automatisés et humains pointent dans des directions différentes.
Mon avis : Qwen 3.8 Max est un bon choix si vous voulez vivre dans un écosystème ouvert et valorisez le travail multilingue et de vision. Ne présumez simplement pas que « ouvert » signifie « remplacement sous licence Apache pour le Max hébergé », parce que ce n'est pas le cas.
8. Claude Fable 5.1 – le plafond de pointe
Idéal pour : le code le plus difficile et le travail d'agent à long terme, là où la qualité prime carrément sur le coût.
Quand Sol n'est pas assez intelligent et que le curseur d'effort d'Opus 5.5 ne suffit toujours pas, Fable 5.1 est le sommet de la famille Claude 5 d'Anthropic. Il est cher, 10 $ d'entrée et 50 $ de sortie par million, cinq fois le prix de sortie de Sol, et il ne prétend pas le contraire. Ce que vous achetez, c'est le plafond : il domine le peloton sur Terminal-Bench-Science (52,6 %), CursorBench (73,4 %) et HLE-with-tools (65 %), et il a dominé le propre tableau Elo GDPval de l'équipe Grok, devant tous les rivaux qu'ils ont listés.
Les usages en conditions réelles sont ce qui marque le plus : Anthropic cite une session d'agent sans surveillance de 38 heures chez Ramp, et une équipe de recherche qui a résolu un problème vieux de plusieurs années. Le seul changement qui adoucit le prix est la baisse des lectures de cache à 0,25 $ par million, moins cher par token en cache qu'Opus 5.5. À savoir avant de construire dessus : Fable 5.1 a supprimé l'utilisation forcée d'outils (tool_choice any/tool renvoie désormais des erreurs 400) et ajoute un filigrane statistique de texte à toute la sortie pour la conformité à l'AI Act de l'UE.
Avantages : qualité vraiment de pointe ; d'énormes usages agentiques en conditions réelles ; lectures de cache bon marché ; contexte de 1M.
Inconvénients : de loin le modèle le plus cher ici ; le filigrane et les faux positifs de refus frustrent certains développeurs ; excessif pour les tâches quotidiennes.
Mon avis : Fable 5.1 n'est pas un remplacement de Sol pour la plupart des charges de travail, c'est le modèle vers lequel vous escaladez pour les 5 % de travaux vraiment difficiles. Dirigez votre trafic facile vers quelque chose de bon marché et réservez Fable au travail qui en a vraiment besoin.
Ce que personne ne se demande vraiment en changeant de modèle
Voici ce sur quoi je bute sans arrêt, et c'est pour ça que j'ai écrit la fin avant la liste. La plupart des gens qui comparent des alternatives à GPT-6 Sol pour un vrai produit, en particulier le support client, se posent la mauvaise question. Ils optimisent le moteur alors que ce qui décide si ça fonctionne, c'est tout ce qui enveloppe le moteur.
J'ai passé ces dernières années à mettre des agents IA sur des files de support en direct dans des milliers d'entreprises, et le schéma ne change jamais. Le modèle est rarement le goulot d'étranglement. Le goulot d'étranglement, c'est : a-t-il le vrai contexte de votre entreprise, peut-il effectuer de vraies actions dans votre helpdesk, et pouvez-vous lui faire confiance avant qu'il ne touche un client réel ? Nous l'avons appris à nos dépens, c'est pourquoi chaque déploiement eesel simule maintenant sur vos tickets historiques d'abord, pour que vous voyiez le taux de résolution et les réponses exactes sur de vrais tickets passés avant que quoi que ce soit ne passe en production. Une API de modèle brut ne vous donne rien de tout ça. Elle vous donne un point de terminaison de complétion de texte très intelligent et une facture.
Remplacer Sol par Sonnet 5 ou Gemini Flash change votre coût par token. Cela ne vous donne pas, en soi, un agent de support. C'est une couche différente, et c'est celle sur laquelle je concentrerais vraiment la décision.
Essayer eesel

Voici comment je vois les choses : un modèle est une infrastructure, et eesel est l'employé que vous embauchez pour tourner dessus. Vous ne choisissez pas eesel à la place de GPT-6 Sol, Claude ou Gemini ; vous choisissez le coéquipier, et il utilise le modèle adapté au travail en coulisses. Aujourd'hui, cette équipe est un coéquipier IA pour helpdesk prêt à l'emploi qui rejoint votre file de support existante en connaissant déjà votre centre d'aide et vos tickets passés, ainsi qu'un rédacteur de blog IA pour le contenu. Chacun arrive avec les compétences, les intégrations et le contexte d'entreprise propres à son rôle, et il est facturé à la résolution, pas au token, donc un modèle bavard ne fait pas exploser votre facture.
Si vous êtes du genre à comparer des API de modèles, la CLI eesel est probablement le moyen le plus rapide de le voir. C'est une surface adaptée aux agents sur ce même coéquipier et cet espace de travail : vous pouvez la piloter depuis un terminal, l'automatiser dans des scripts, et laisser des agents de code comme Claude Code, Codex et Cursor l'opérer directement, aux côtés du serveur MCP, des webhooks et des contrôles d'accès réseau. Le même agent que le tableau de bord, en mode sans interface. Vous pouvez essayer eesel gratuitement et le simuler sur vos propres tickets avant de vous engager sur quoi que ce soit.
Questions fréquentes
Quelle est la meilleure alternative à GPT-6 Sol en 2026 ?
Existe-t-il une alternative moins chère à GPT-6 Sol ?
Quelle est une bonne alternative à poids ouverts à GPT-6 Sol ?
GPT-6 Sol est-il meilleur que Claude Sonnet 5 ?
Les alternatives à GPT-6 Sol fonctionnent-elles pour l'automatisation du support client ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.