En bref
GPT-6 Sol d'OpenAI a été lancé le 23 septembre 2026 comme palier intermédiaire de la famille GPT-6, et la grande nouvelle est une baisse de prix, pas une montée en gamme technique : 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie sur l'API standard. C'est exactement la moitié des 4 $/20 $ de GPT-5.6 Sol, et un cinquième du prix du fleuron GPT-6 Astra.
Ce qui est intéressant, c'est ce que l'on obtient pour cette baisse. Les détails qui influencent vraiment votre facture :
- Même intelligence, prix divisé par deux. Artificial Analysis a constaté que l'Intelligence Index reste à peu près au niveau de GPT-5.6 Sol, avec une fiabilité factuelle en amélioration. Vous achetez la même classe de modèle moins cher, pas un bond en avant.
- Les paliers de service font varier le coût de 4x. Batch et Flex font tourner Sol à 1 $/5 $, le mode Fast à 4 $/20 $. Même modèle, calcul radicalement différent.
- Ce n'est pas gratuit. Pas de palier gratuit sur l'API, et dans ChatGPT, cela démarre avec le forfait Plus à 20 $/mois. Seul GPT-6 Luna est accessible en Free et Go.
Si vous êtes développeur, la section ci-dessous propose le tableau complet par palier ainsi qu'un calculateur pour votre propre volume. Si vous dirigez une équipe de support ou d'ops et que votre vraie question est « combien une IA va-t-elle me coûter par ticket », le prix au token est la mauvaise unité. C'est pourquoi un agent IA pour le support comme eesel facture au ticket résolu, un point que j'aborde à la fin.
Tarifs de l'API GPT-6 Sol : le palier standard
Voici le chiffre que la plupart des gens sont venus chercher. Sur la page des tarifs de l'API, le tarif standard de GPT-6 Sol est de 2,00 $ par million de tokens en entrée et 10,00 $ par million de tokens en sortie. L'entrée en cache descend à 0,20 $, et les écritures de cache coûtent 2,50 $ par million.
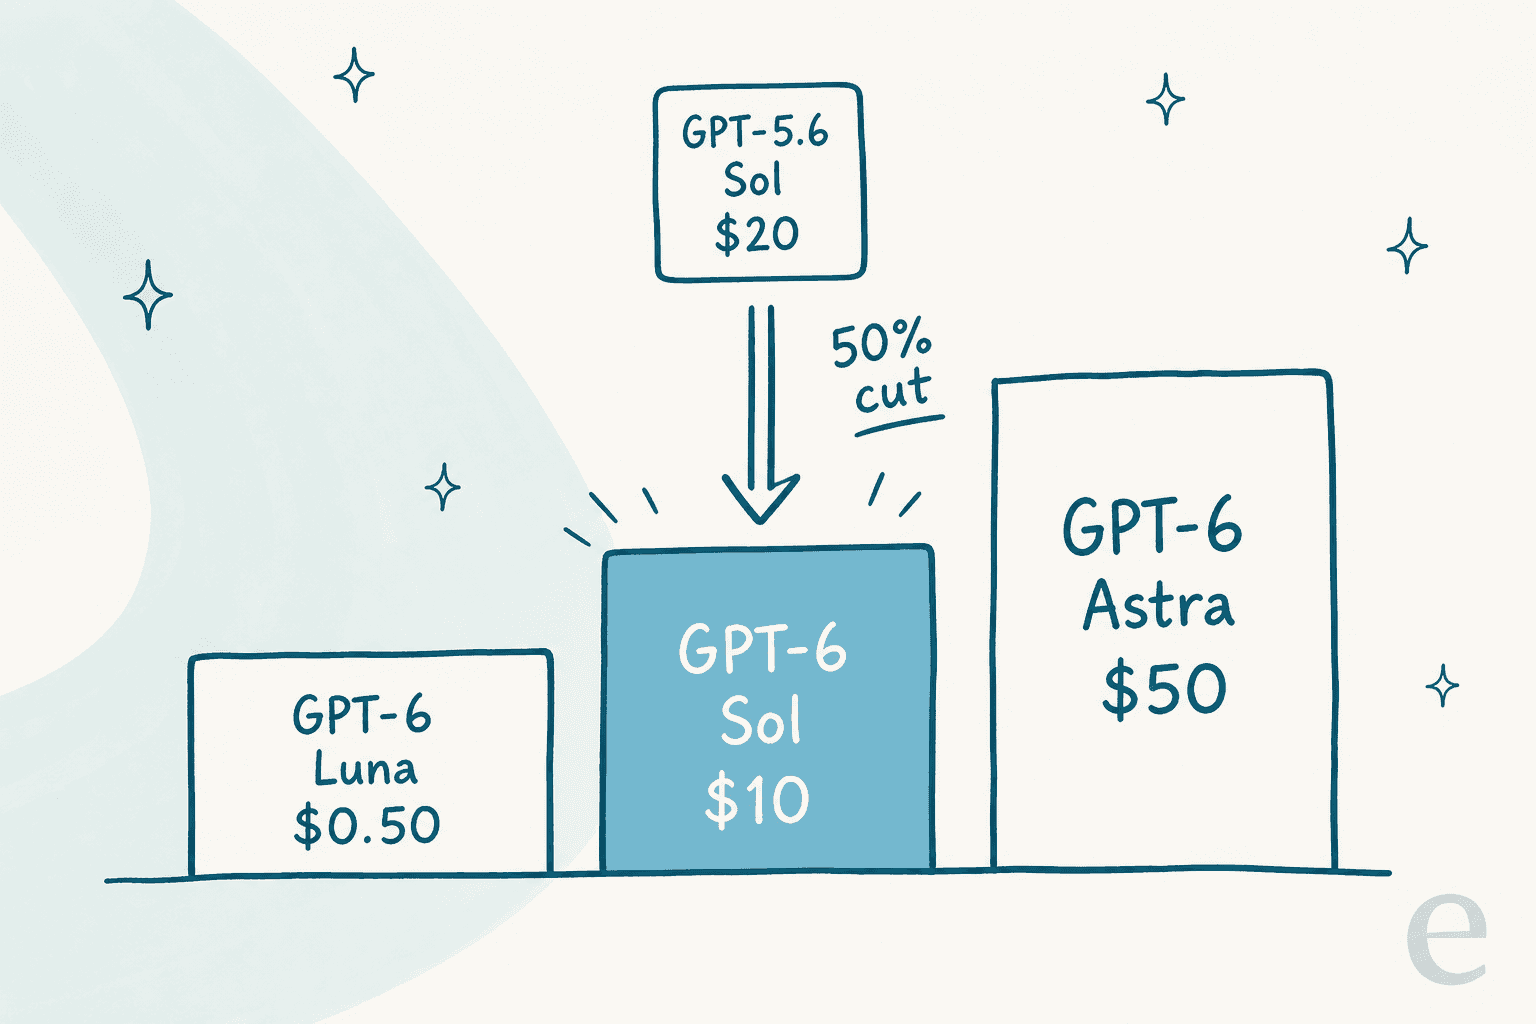
Cela place Sol en plein milieu de la gamme de modèles OpenAI : bien au-dessus du poids plume Luna, et bien en dessous du fleuron Astra. Voici où se situe la famille GPT-6 sur le palier standard à contexte court, avec l'ancien GPT-5.6 Sol pour référence :
| Modèle | Entrée (par 1M) | Entrée en cache | Sortie (par 1M) | Position |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Fleuron |
| gpt-6-sol | $2.00 | $0.20 | $10.00 | Palier intermédiaire (nouveau) |
| gpt-6-luna | $0.10 | $0.01 | $0.50 | Le moins cher |
| gpt-5.6-sol | $4.00 | $0.40 | $20.00 | Ancien palier intermédiaire |
Source : Tarifs de l'API OpenAI. L'histoire que raconte le tableau est simple : GPT-6 Sol est l'ancien GPT-5.6 Sol à moitié prix. OpenRouter a confirmé les mêmes tarifs le jour du lancement, avec Sol à « 2 $/M en entrée et 10 $/M en sortie ». Le positionnement d'OpenAI lui-même dans le billet de lancement est « Build with Sol. Scale with Luna », ce qui indique où chaque modèle est censé se situer.
La baisse de 50 % : ce qui a changé, et ce qui n'a pas changé
Une baisse de prix de cette ampleur s'accompagne généralement d'une histoire de nouvelles capacités. Ce n'est majoritairement pas le cas ici, et il vaut mieux l'admettre franchement.
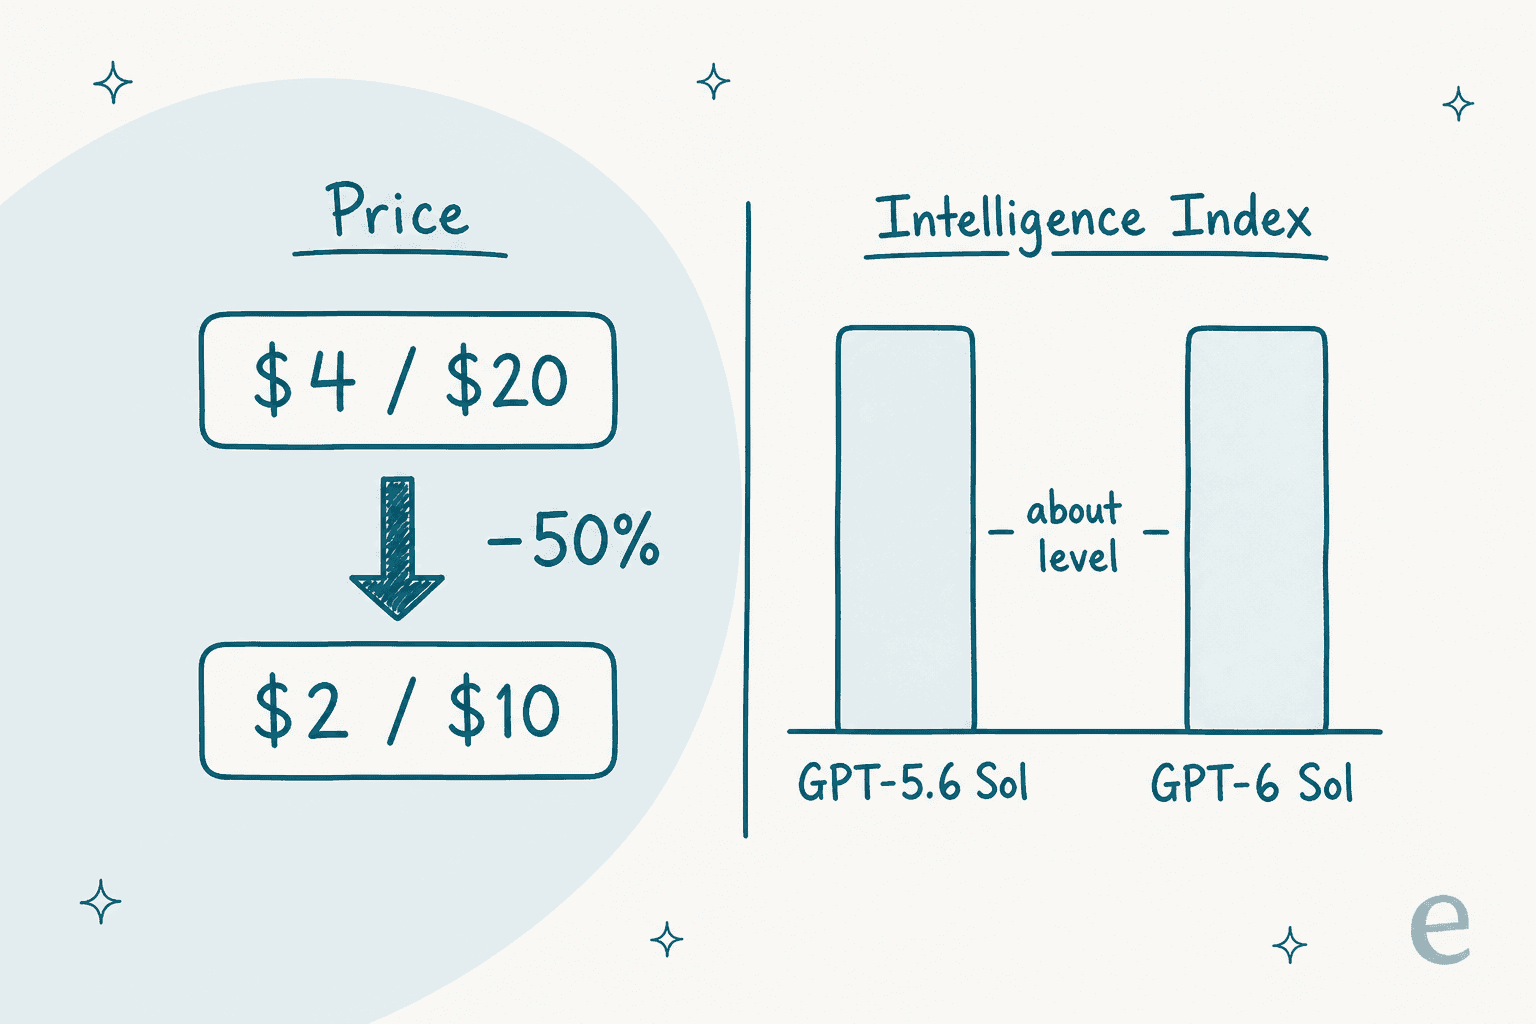
Sur la mesure brute d'intelligence, Artificial Analysis a rapporté que GPT-6 Sol et Luna « repoussent la frontière de l'efficacité coût en divisant le coût par deux », tandis que l'Intelligence Index et le Coding Agent Index « restent au niveau de GPT-5.6, avec des progrès sur certaines évaluations et des reculs sur d'autres ». Le constat est donc le suivant : le prix a beaucoup bougé, l'intelligence à peine.
Là où Sol s'est vraiment amélioré, c'est sur la fiabilité et le débit en code, et OpenAI a mis l'accent sur les deux :
- Fiabilité factuelle. OpenAI rapporte que GPT-6 Sol commet environ deux fois moins d'erreurs factuelles que GPT-5.6 Sol, s'approchant de la fiabilité d'Astra pour une fraction du coût. Artificial Analysis a mesuré une baisse du taux d'hallucination en effort maximal de 92 % à 60 %.
- Code. OpenAI annonce 68,8 % sur DeepSWE v1.1, à environ un point du meilleur score de Claude Fable 5, pour un coût par tâche environ 80 % plus faible.
- Évaluations agentiques. Artificial Analysis a noté de légers gains sur AutomationBench (62 % contre 60 %) et Terminal-Bench 4.0 (44 % contre 40 %), ainsi qu'un bond sur l'AA-Omniscience Index de 22 à 27.
La communauté a interprété cela de la même façon. Dans la discussion de lancement, un développeur a résumé le compromis sans détour :
"I'd have loved improved performance for 2x the price than ~equal performance for 0.5x the price."

C'est le cadre honnête pour les tarifs de GPT-6 Sol. Si vous utilisiez déjà GPT-5.6 Sol, c'est une baisse de facture que vous obtenez gratuitement. Si vous espériez que le « 6 » signifie un saut d'intelligence brute, les scores de benchmark invitent à tempérer cette attente.
Paliers de service : la variation de 4x que la plupart des gens ratent
Le tarif standard est un point de départ, pas toute l'histoire. GPT-6 Sol fonctionne sur les mêmes paliers de service que le reste de la famille, et l'écart entre le moins cher et le plus cher est de 4x pour exactement le même modèle. C'est le levier le plus important dont vous disposez sur le coût.
| Palier | Entrée (par 1M) | Entrée en cache | Sortie (par 1M) | Compromis |
|---|---|---|---|---|
| Batch | $1.00 | $0.10 | $5.00 | 50 % de réduction, asynchrone, jusqu'à 24h |
| Flex | $1.00 | $0.10 | $5.00 | 50 % de réduction, plus lent, peut être mis en file d'attente |
| Standard | $2.00 | $0.20 | $10.00 | Latence par défaut |
| Fast mode | $4.00 | $0.40 | $20.00 | 2x, latence la plus faible |
Source : Tarifs de l'API OpenAI. Quelques points à connaître avant de choisir :
- Batch et Flex ont le même prix, mais servent des usages différents. Batch convient au travail asynchrone que vous soumettez et récupérez plus tard ; Flex convient aux requêtes interactives que vous acceptez de laisser tourner plus lentement ou en file d'attente. Les deux divisent votre facture par deux.
- Le mode Fast double le tarif pour la latence la plus faible, et accepte soit
service_tier: "priority", soitservice_tier: "fast". - Le mode Fast comporte un piège régional. Pour la résidence des données dans l'UE, il peut retomber sur le standard, donc ne le présumez pas disponible partout.
Si une charge de travail tolère la latence, la basculer par défaut vers Batch ou Flex divise à nouveau par deux votre dépense sur Sol, en plus des 50 % déjà économisés en quittant GPT-5.6. Cela se cumule : une tâche adaptée au batch sur GPT-6 Sol tourne à 1 $/5 $, soit un quart de la facture standard GPT-5.6 Sol du mois dernier.
Les pièges : contexte long et fiche technique
Deux détails se cachent dans les petites lignes de la page du modèle, et tous deux peuvent discrètement bouleverser un budget.
Premièrement, le contexte long est facturé à un tarif plus élevé pour l'ensemble de la requête. La fenêtre de contexte de Sol est large, avec 1 050 000 tokens, mais tout prompt dépassant 272K tokens en entrée fait basculer l'intégralité de la requête au tarif de contexte long : 4 $ par million en entrée et 15 $ par million en sortie au palier standard. Cela représente 2x pour l'entrée et 1,5x pour la sortie, appliqué à chaque token de la requête, pas seulement à ceux qui dépassent le seuil.
| Palier standard | Contexte court (≤272K) | Contexte long (>272K) |
|---|---|---|
| Entrée (par 1M) | $2.00 | $4.00 |
| Entrée en cache | $0.20 | $0.40 |
| Sortie (par 1M) | $10.00 | $15.00 |
Deuxièmement, il vaut la peine de connaître la fiche technique avant de vous engager. GPT-6 Sol accepte jusqu'à 922 000 tokens en entrée et en retourne jusqu'à 128 000, avec une date limite de connaissances au 20 avril 2026. Il accepte du texte et des images en entrée, du texte en sortie, et expose un niveau d'effort de raisonnement allant de none jusqu'à max, avec medium par défaut. Il embarque aussi l'ensemble complet des outils de la Responses API : recherche web, interpréteur de code, shell hébergé, utilisation d'ordinateur et MCP. Et un plancher à retenir : Sol n'est pas inclus dans le palier gratuit, donc le Tier 1 est le point d'entrée pour les développeurs.
Estimez votre facture API GPT-6 Sol
Les prix affichés restent abstraits tant que vous n'y insérez pas vos propres chiffres. Indiquez les millions de tokens en entrée et en sortie que vous prévoyez par mois, choisissez un palier de service, et cet outil calcule le coût mensuel. Il tient compte automatiquement du surcoût de contexte long.
Le schéma que la plupart des équipes observent, c'est que les tokens de sortie dominent la facture, puisque la sortie coûte 5x le tarif d'entrée. Si votre charge de travail génère de longues réponses, c'est là que va l'argent, et c'est là que basculer une tâche adaptée au batch vers Batch rapporte le plus vite.
Tarifs de GPT-6 Sol dans ChatGPT et Codex
Si vous n'appelez pas l'API, GPT-6 Sol vous parvient via ChatGPT Work et Codex, et le forfait sur lequel vous êtes trace une ligne claire sur qui y a accès.
| Forfait | Prix | Accès à GPT-6 Sol |
|---|---|---|
| Free | $0 | Non (Luna uniquement) |
| Go | $8/mo | Non (Luna uniquement) |
| Plus | $20/mo | Oui |
| Pro | From $100/mo | Étendu |
| Business / Enterprise / Edu | Per seat | Oui |
Source : Annonce de lancement d'OpenAI. Quelques points à noter :
- Sol démarre avec Plus. Le forfait Plus à 20 $/mois est le point d'entrée pour les utilisateurs ChatGPT qui souhaitent Sol. Ni Free ni le forfait Go à 8 $ ne l'incluent ; ils obtiennent GPT-6 Luna dans l'application de bureau.
- Codex a aussi accès à Sol. OpenAI a déployé les deux modèles dans Codex aux mêmes paliers, donc les utilisateurs d'agents de code sur Plus et au-delà peuvent sélectionner Sol directement.
- L'Enterprise est facturé par siège. Sur Business et Enterprise, Sol est disponible par siège aux côtés de l'accès Edu, ce qui suit le même schéma que le reste de la gamme OpenAI.
Tout le monde n'a pas été convaincu que les économies d'abonnement correspondent à la baisse de l'API. Un développeur a noté que les changements de limites de messages suggéraient que la baisse de 50 % sur l'API se traduisait, dans les forfaits ChatGPT, par quelque chose de plus proche d'une baisse d'un tiers — vérifiez donc votre propre quota plutôt que de supposer que la remise affichée se répercute intégralement.
Comment se comparent les tarifs de GPT-6 Sol
En prenant du recul, où se situe Sol par rapport au reste de la frontière technologique ? En résumé, OpenAI a utilisé Sol pour se battre fort sur le prix au milieu du marché.
- Face à sa propre gamme : à 2 $/10 $, Sol coûte un cinquième du prix de GPT-6 Astra (10 $/50 $) et 20x le prix de Luna (0,10 $/0,50 $). Pour la plupart des tâches quotidiennes, Sol est le point d'équilibre idéal ; pour le travail agentique à long terme ou la sécurité, la prime d'Astra peut encore se justifier.
- Face à Anthropic : Sol est nettement moins cher que Fable 5.1 à 10 $/50 $, tandis qu'OpenAI revendique des scores de code à un point d'écart au sommet.
- Face à Google : il se situe au-dessus des options Gemini les plus légères comme Gemini 3 Flash, mais rivalise directement avec les paliers intermédiaires sur un rapport prix/intelligence.
Le constat plus large sur le fil de lancement était que les modèles fermés continuent de devenir moins chers sans devenir beaucoup plus intelligents, ce que plusieurs développeurs ont qualifié de course vers le bas sur les prix. C'est une bonne nouvelle si vous achetez des tokens. C'est en revanche un rappel qu'un modèle moins cher ne change rien à la partie la plus difficile du déploiement de l'IA dans un flux de travail réel, à savoir tout ce qui entoure le modèle.
Ce que signifient les tarifs de GPT-6 Sol si vous dirigez une équipe de support
Voici où je veux être utile plutôt que de simplement additionner des tarifs, car je passe mon temps à observer comment ces modèles sont réellement utilisés, et la réponse honnête est un peu contre-intuitive.
Si vous dirigez le support client ou les opérations internes, un modèle de pointe moins cher change moins de choses que ne le suggère le titre. Un modèle brut comme Sol est de l'infrastructure. C'est un moteur performant, mais dès la sortie de la boîte, il ne connaît pas votre politique de remboursement, ne peut pas voir vos 50 000 derniers tickets, n'a aucun accès à votre système de commandes, et n'a aucun moyen sûr d'être testé sur votre file d'attente réelle avant de commencer à répondre aux clients. Il est facturé au token pour réfléchir, pas au problème résolu. Une baisse de 50 % sur les tokens est réelle, mais c'est une remise sur la partie la moins chère du projet.
L'unité qui compte vraiment pour une équipe de support est le coût par résolution, pas le coût par token. Une facture de tokens est imprévisible : elle varie selon la longueur des prompts, les nouvelles tentatives, et le degré de bavardage du modèle un jour donné. J'ai vu des bots au ton assuré donner tranquillement de mauvaises réponses sur des files d'attente en direct, ce qui explique exactement pourquoi tout déploiement devrait être simulé sur vos propres tickets historiques avant d'approcher un client. C'est l'écart entre un modèle et un système construit autour de lui : votre connaissance, vos intégrations, des actions sûres, et un moyen de le tester d'abord sur votre historique.
C'est aussi pourquoi je ne changerais pas de plateforme pour votre automatisation du support la semaine où un nouveau modèle sort. Les meilleurs agents IA pour le support et outils de service client sont conçus pour être flexibles quant au modèle, si bien que lorsqu'un modèle moins cher ou plus intelligent arrive, vous héritez de la mise à niveau sans rien reconstruire, et sans renégocier votre budget autour d'un nouveau tarif de tokens.
Essayez eesel
Si votre intérêt pour le prix de Sol se résume en réalité à « combien une IA va-t-elle me coûter pour vraiment résoudre des tickets », c'est exactement la mission pour laquelle un coéquipier IA est conçu, et c'est là qu'intervient eesel. GPT-6 Sol est le moteur ; eesel est l'employé que vous embauchez pour le conduire. L'agent IA pour le support s'entraîne sur vos tickets passés et votre centre d'aide, se connecte au helpdesk que vous utilisez déjà au lieu de le remplacer, et vous permet de le simuler sur des milliers de vos tickets historiques réels afin de voir comment il va performer, et combien cela va coûter, avant même qu'il ne touche à une conversation en direct.
La facturation raconte une histoire qu'un tarif au token ne peut pas raconter. Plutôt que de payer au token pour réfléchir, vous payez 40 cents par ticket réellement traité, sans frais par siège et sans minimum de plateforme, de sorte que le coût suit les résultats plutôt que le bavardage du modèle. Vous pouvez démarrer gratuitement avec 50 $ d'utilisation et sans carte bancaire.

Et comme il s'agit d'une question de tarification orientée développeurs, il vaut la peine de savoir que l'ensemble de l'espace de travail eesel peut être piloté depuis le terminal, pas seulement depuis un tableau de bord. La CLI eesel (npx @eesel/cli) permet à une personne, un script, ou un agent de code comme Claude Code, Codex ou Cursor d'opérer le même coéquipier : connecter un helpdesk, lire et modifier les instructions permanentes, exécuter eesel activity pour inspecter les exécutions passées, et verrouiller les changements derrière eesel approvals. Chaque commande affiche du JSON, et --dry-run montre l'appel serveur exact qu'une écriture effectuerait avant de l'envoyer. Ainsi, la même facturation à la résolution que vous modéliseriez dans ce calculateur peut être intégrée à vos propres outils, pas seulement parcourue dans une interface.
Les tarifs de GPT-6 Sol représentent une vraie bonne affaire sur les tokens, et pour le code et le travail quotidien, la baisse de 50 % vaut la peine d'être saisie. Mais pour la plupart des équipes de support, le tarif au token n'a jamais été le chiffre qui comptait. Faire entrer dans votre flux de travail existant un coéquipier testé, connecté et responsable, facturé au résultat, c'est là qu'il vaut la peine d'investir votre budget.
Questions fréquentes
Combien coûte GPT-6 Sol sur l'API ?
GPT-6 Sol est-il moins cher que GPT-5.6 Sol ?
Qu'est-ce que le surcoût de contexte long de GPT-6 Sol ?
Combien coûte GPT-6 Sol dans ChatGPT et Codex ?
Qu'est-ce que Batch et le mode Fast changent aux tarifs de GPT-6 Sol ?
GPT-6 Sol vs tarifs de GPT-6 Astra : lequel utiliser ?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.