
En bref
GPT-6.1 Sol a été lancé lors de la DevDay d'OpenAI le 29 septembre 2026, exactement une semaine après GPT-6 Sol. Le Sol de la semaine dernière était une baisse de prix déguisée en nouveau numéro de version. Celui-ci est l'inverse : même prix de $2/$10, un vrai saut de capacité.
- Il se rapproche d'Astra. OpenAI annonce qu'il égale GPT-6 Astra en codage sur DeepSWE pour environ un cinquième du coût, et qu'il se place à 2.1 points d'Astra sur OSWorld 2.0 (utilisation de l'ordinateur) pour environ un septième du coût par tâche.
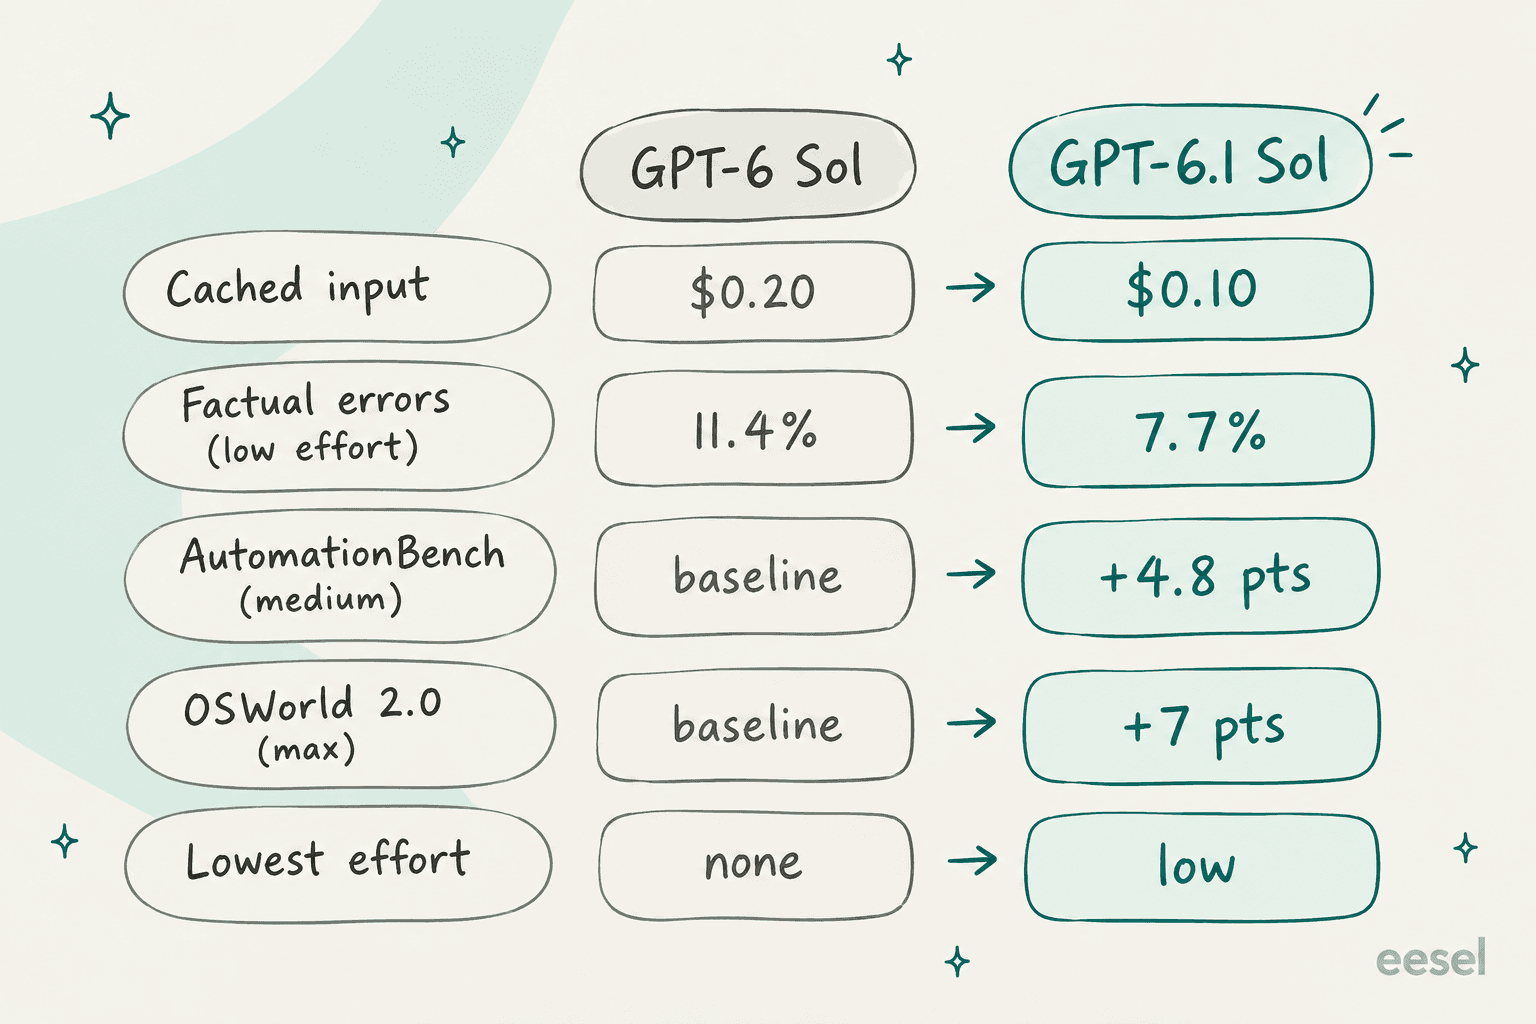
- Le prix a à peine bougé, et une partie est devenue moins chère. Le tarif standard de l'API reste à $2 en entrée et $10 en sortie par million de tokens, mais l'entrée en cache est divisée par deux, à $0.10 par million.
- Les pièges sont petits mais réels. L'effort de raisonnement
nonea disparu, Chat Completions fonctionne sans appel d'outils, il n'est pas encore dans le Chat classique de ChatGPT et le niveau Ultrafast arrive « bientôt ».
Mon avis : pour la plupart des équipes, GPT-6.1 Sol fait d'Astra un outil de spécialiste, pas le choix par défaut. Si vous gérez une file de support, un modèle plus intelligent ne connaîtra toujours pas votre politique de remboursement. Ce qui fait bouger le taux de résolution, c'est l'agent IA de helpdesk construit autour, qui est le travail d'eesel, testé d'abord sur vos propres anciens tickets.
Ce qu'est vraiment GPT-6.1 Sol
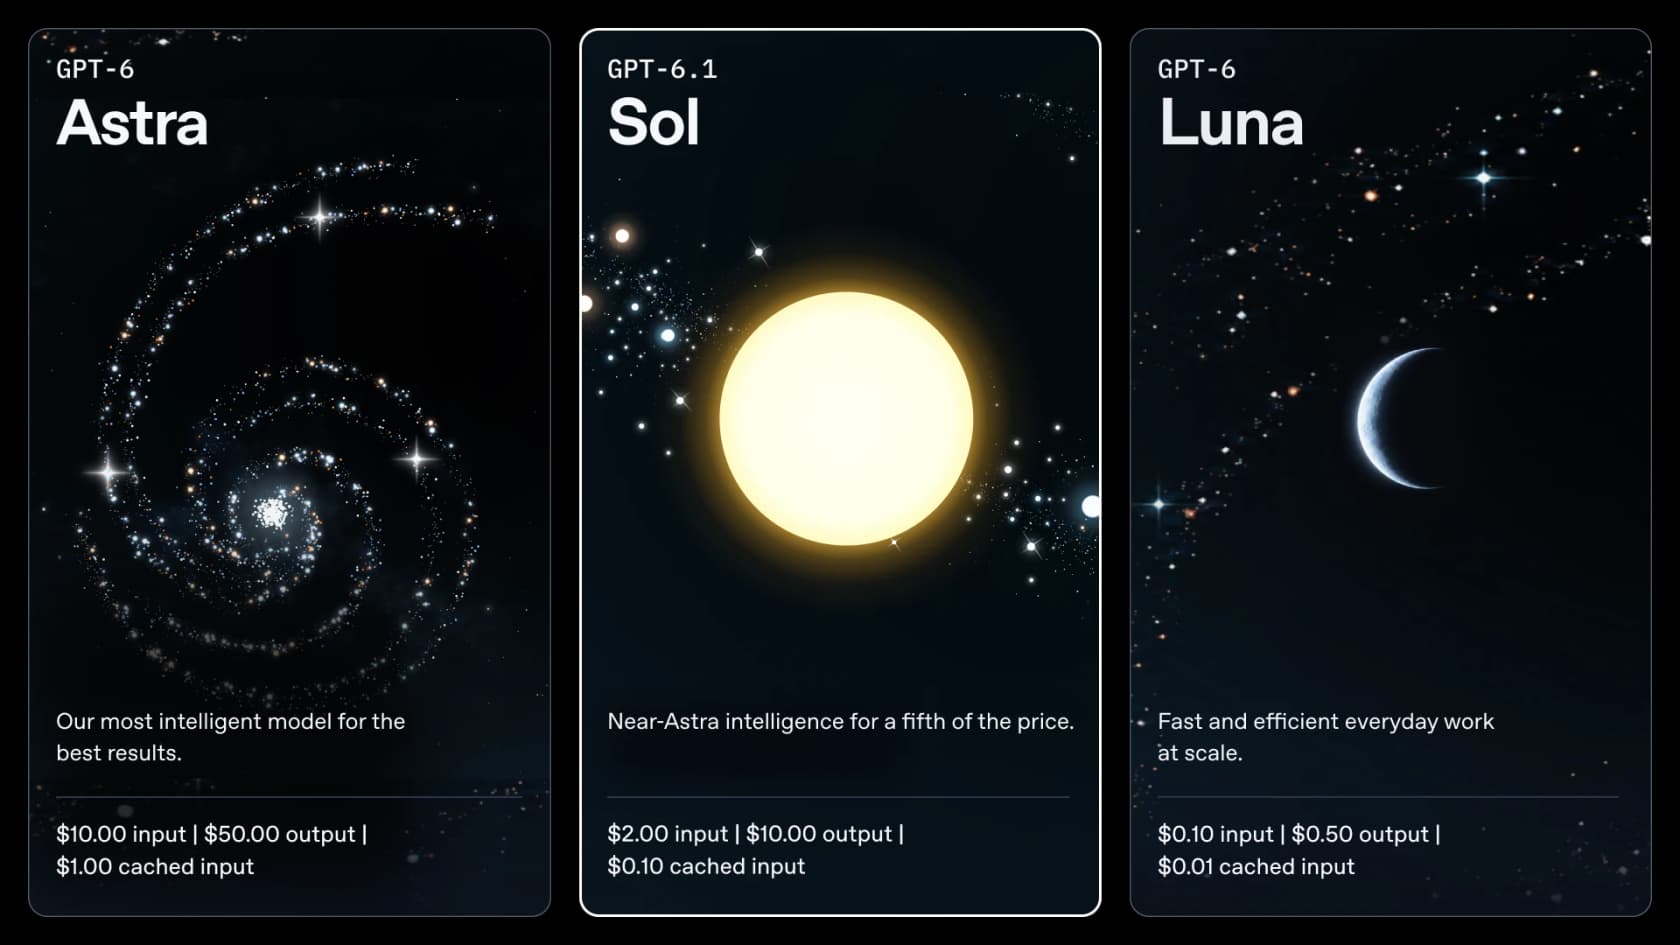
GPT-6.1 Sol est une mise à jour du modèle de milieu de gamme de la famille GPT-6 d'OpenAI. La famille se présente donc ainsi : Astra tout en haut, 6.1 Sol au milieu et GPT-6 Luna tout en bas. Le slogan choisi par OpenAI est « Une intelligence proche d'Astra pour un cinquième du prix », et cette phrase est imprimée directement sur les cartes de prix du lancement.
Une bonne part de ce que j'écris sur les modèles d'IA vient du côté de la recherche, et l'intention de recherche ici est facile à lire. Quelqu'un qui cherche « GPT-6.1 Sol » un jour après le lancement ne demande pas ce qu'est un modèle de langage, il pose une seule question : dois-je encore payer pour Astra ? C'est donc autour de cette question que j'ai construit cet article.
Sur la page du modèle, la fiche technique est presque identique à celle de son prédécesseur. L'identifiant du modèle est gpt-6.1-sol, avec une fenêtre de contexte de 1,050,000 tokens, 128,000 tokens de sortie maximum et une date limite de connaissances au 30 avril 2026 (dix jours après le 20 avril de GPT-6 Sol). L'entrée peut être du texte ou des images, et la sortie est du texte. Sur la Responses API, il prend en charge la recherche web, la recherche de fichiers, un interpréteur de code, un shell hébergé, apply patch, les skills, l'utilisation de l'ordinateur, la recherche d'outils et MCP. Il existe aussi une résidence des données aux États-Unis et dans l'UE, même si le mode Fast n'est pas disponible avec la résidence UE.
Ce qui a changé par rapport à GPT-6 Sol, une semaine plus tard
Quand GPT-6 Sol est sorti le 22 septembre, le résumé honnête était « la même intelligence que GPT-5.6 Sol pour moitié prix ». Artificial Analysis ne l'avait placé qu'environ un point au-dessus de GPT-5.6 Sol sur son Intelligence Index, pas beaucoup plus. GPT-6.1 Sol est la version où la capacité commence vraiment à bouger.
D'après l'article de lancement d'OpenAI, voici les écarts par rapport à GPT-6 Sol :
- Codage : sur DeepSWE v1.1, il dépasse le meilleur score de GPT-6 Sol de 6.4 points de pourcentage, avec un effort de raisonnement et un coût plus faibles.
- Flux de travail métier : sur AutomationBench, il gagne 4.8 points par rapport à GPT-6 Sol à effort moyen.
- Utilisation de l'ordinateur : sur le jeu hors ligne d'OSWorld 2.0, il bat GPT-6 Sol de 7 points à effort maximal, pour moins de la moitié du coût.
- Science : sur Terminal-Bench Science 0.1, il plus que double le score de GPT-6 Sol à effort maximal.
- Factualité : à faible effort, la part de réponses contenant une erreur factuelle passe de 11.4% à 7.7%, soit environ 32% de réduction.
Quelque chose a aussi bougé côté sécurité. L'addendum à la fiche système indique que lorsqu'un outil de recherche est en panne, GPT-6.1 Sol omet de le dire à l'utilisateur dans 2.08% des cas, contre 4.92% pour GPT-6 Sol. Si ce que vous construisez est destiné aux clients, un modèle qui « admet quand il ne peut pas chercher quelque chose » vaut plus que quelques points de benchmark.
Une petite chose a bien reculé, j'y reviens dans la section des pièges : le réglage de raisonnement le plus bas est maintenant low, et non none.
À quel point se rapproche-t-il d'Astra ?
C'est cette partie qui décide si vous continuez à payer pour le modèle phare ou non. OpenAI parle de « quasi-égalité », et la plupart du temps les chiffres le confirment.
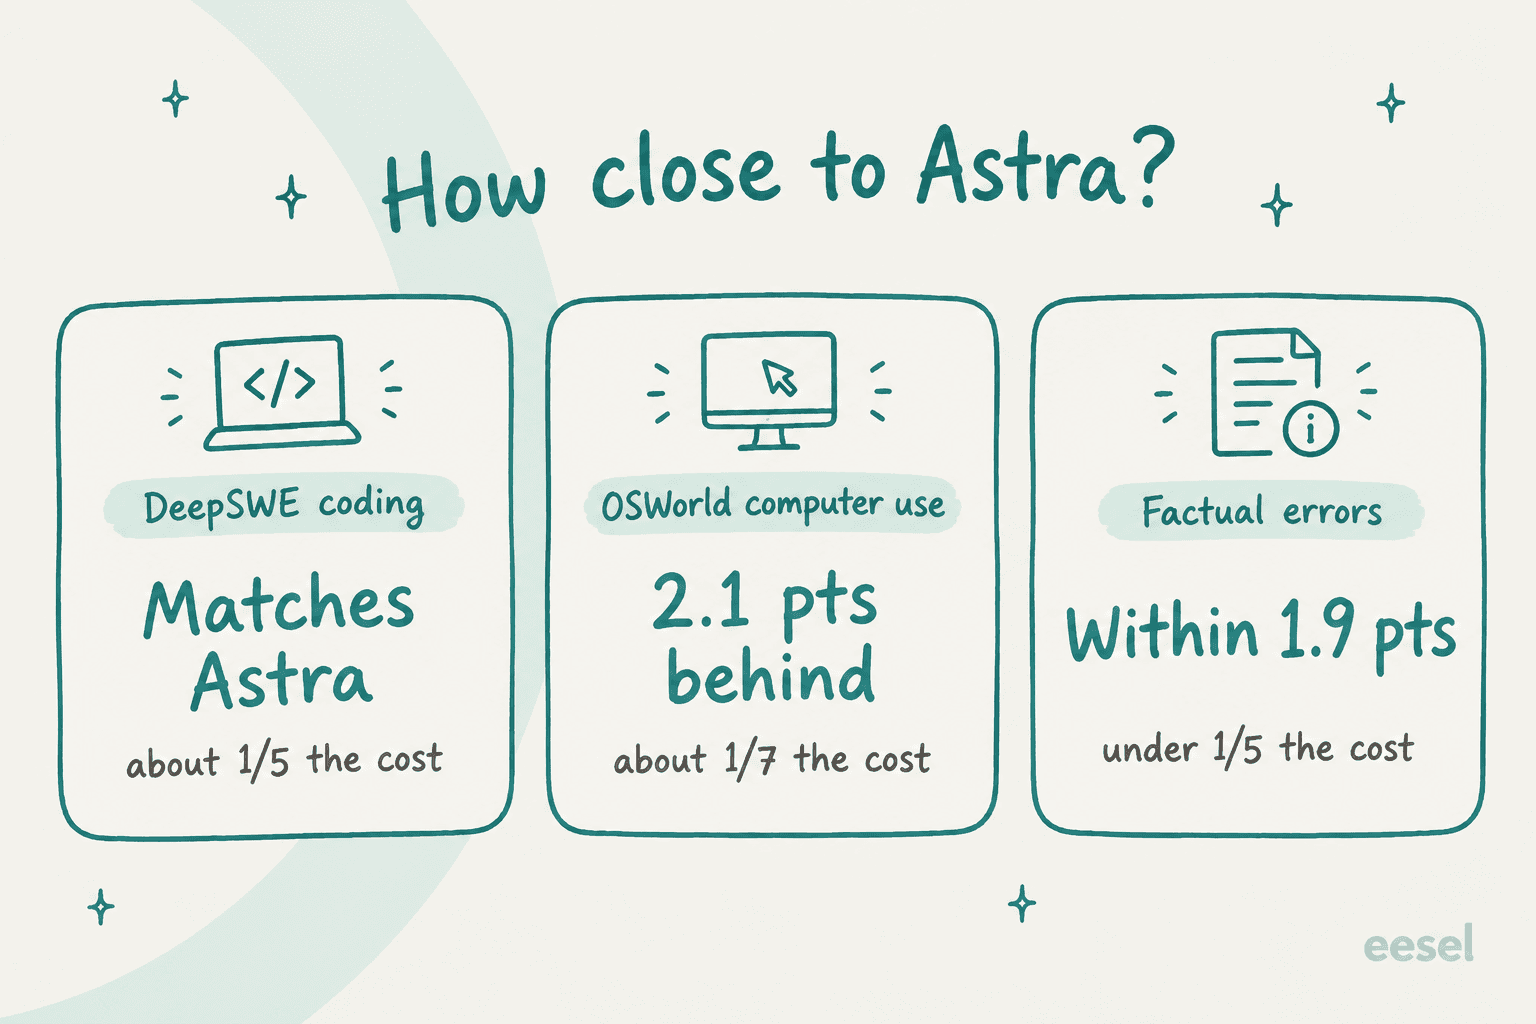
Sur DeepSWE v1.1, OpenAI affirme que 6.1 Sol égale GPT-6 Astra pour environ un cinquième du coût. Sur OSWorld 2.0, il reste à 2.1 points d'Astra à effort maximal pour environ un septième du coût par tâche. Et sur tous les réglages de raisonnement testés, le taux d'erreur factuelle reste à moins de 1.9 point de celui d'Astra, pour moins d'un cinquième du coût par tâche.
Face à Anthropic, il se place bien aussi. Sur GDP.pdf, un test de réponse à des questions professionnelles à partir de PDF complexes, OpenAI indique que 6.1 Sol score plus haut que Claude Opus 5.5 avec solutions de repli, pour moins de la moitié du coût par tâche. Puis sur AutomationBench, il est 2.2 points au-dessus d'Opus 5.5 à effort moyen, pour environ un tiers du coût.
C'est sur le travail scientifique que l'écart de coût est le plus grand. À effort maximal sur Terminal-Bench Science, OpenAI situe 6.1 Sol à $5.47 par tâche en moyenne, contre $23.21 pour Opus 5.5 et $23.80 pour Astra.
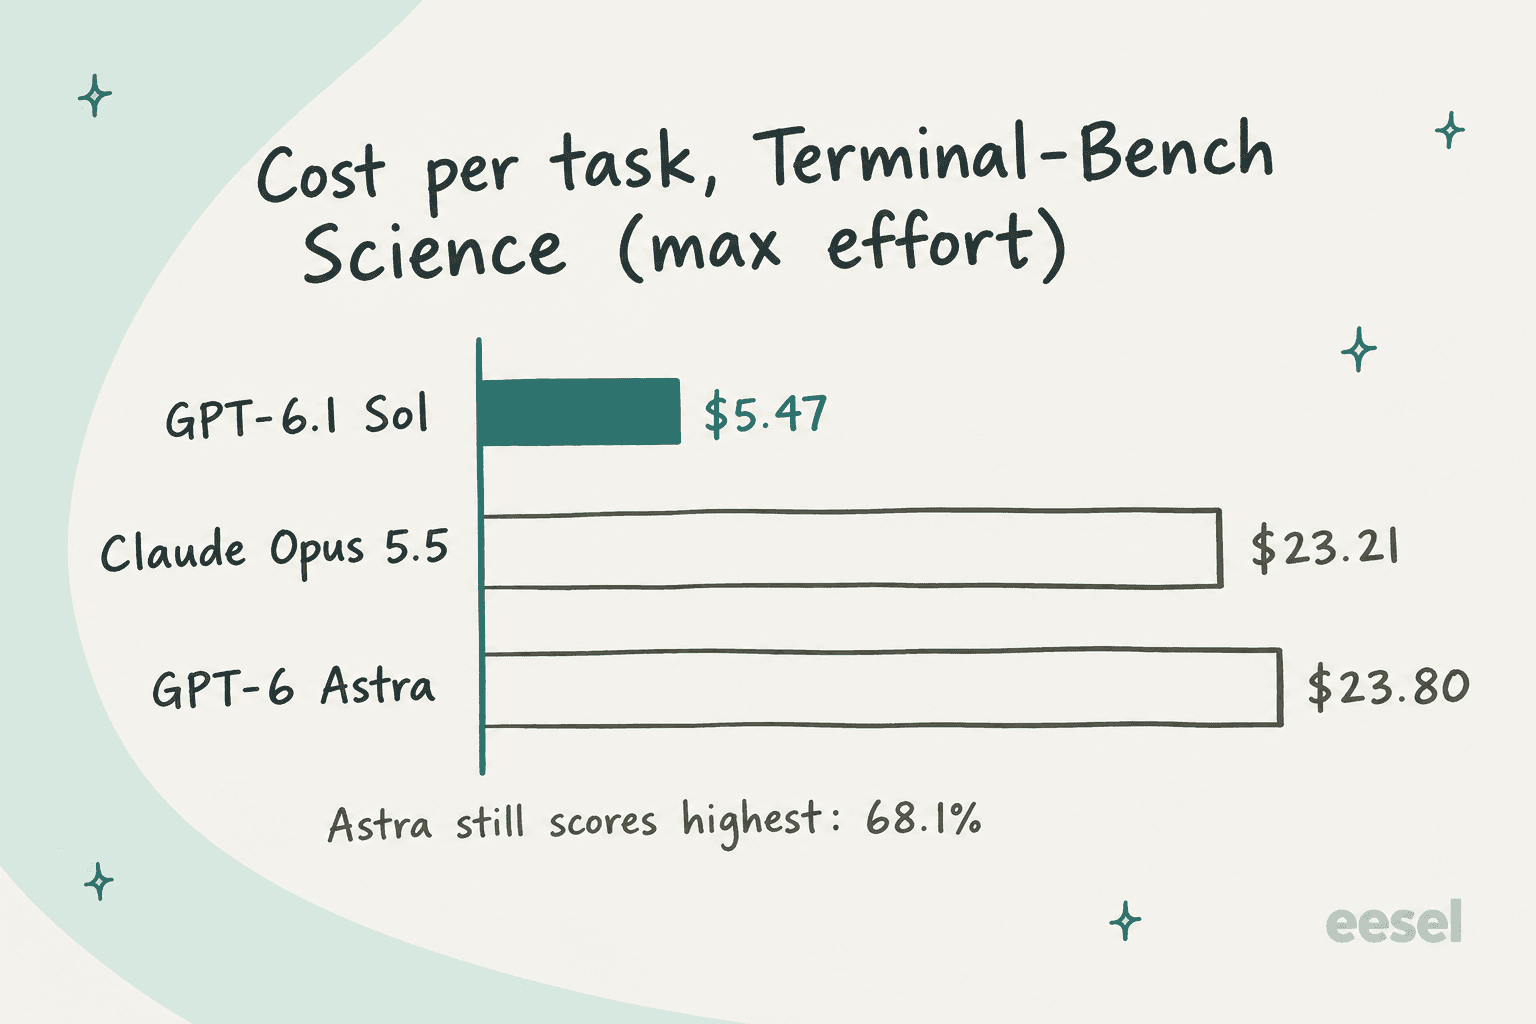
Il faut ajouter une réserve légitime à tout cela. Chaque chiffre ci-dessus est une évaluation d'OpenAI lui-même, et les chiffres des concurrents proviennent de « rapports publics », selon la note de bas de page de l'article de lancement. OpenAI dit aussi qu'Astra affiche encore le meilleur score scientifique, 68.1%, et « doit être utilisé pour les tâches de recherche scientifique les plus difficiles ». L'écart est donc petit, mais pas nul. La bonne nouvelle, c'est que les chiffres indépendants ci-dessous racontent à peu près la même histoire.
Ce que disent les tests indépendants et les premiers utilisateurs
Artificial Analysis avait des chiffres dès le jour du lancement et, honnêtement, ils confirment le message d'OpenAI plus que je ne m'y attendais. À effort maximal, GPT-6.1 Sol obtient 51.8 sur l'Intelligence Index, contre 47.5 pour GPT-6 Sol et 52.7 pour GPT-6 Astra. Il y arrive à $0.72 par tâche contre $3.26 pour Astra, soit environ 22% du coût du modèle phare pour environ un point de moins.
"GPT-6.1 Sol replaces GPT-6 Sol after just 7 days. It scores 1 point below GPT-6 Astra in the Intelligence Index at less than one quarter of the Cost per Task"
Pour moi, l'élément le plus utile de leurs données est le tableau par niveau d'effort, car la courbe s'aplatit fortement une fois en haut :
| Effort | Intelligence Index | Coût par tâche | Temps par tâche |
|---|---|---|---|
| low | 42.1 | $0.13 | 56s |
| medium | 47.8 | $0.21 | 131s |
| high | 50.2 | $0.32 | 205s |
| xhigh | 51.0 | $0.39 | 271s |
| max | 51.8 | $0.72 | 569s |
Source : Artificial Analysis. Avec xhigh, vous êtes à un point de max pour environ la moitié du coût, et la moitié de l'attente aussi. Artificial Analysis a aussi constaté que xhigh battait max de 3 points sur son Coding Agent Index, se plaçant 1 point au-dessus d'Astra « for less than 15% of the Cost per Task ». Si vous faites tourner des agents de codage, xhigh semble donc le bon compromis.
Les mêmes données contiennent aussi deux réserves honnêtes. D'abord, il est plus lent que GPT-6 Sol : 67 contre 76 tokens par seconde, et 569 contre 408 secondes par tâche au maximum, parce qu'il écrit plus de tokens de sortie. Ensuite, son taux d'hallucination est passé de 60% à 54%, ce qui est mieux, mais encore loin des 51% du modèle phare.
Dans le fil de lancement de Hacker News, les gens étaient surtout positifs sur le coût et plus partagés sur la finition, le prix du cache provoquant la réaction la plus forte :
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

Un développeur a lancé la même tâche image vers HTML sur 6.1 Sol et sur Claude Opus 5.5, puis est revenu avec un verdict juste et partagé :
"Overall, opus executes a bit better than 6.1 sol, which surprises me. [...] It's not bad by any means, but I think where Opus really wins is the motion animation of the svgs / final polish [...] Still, it executed quick and was quite cheap to run."
Sur X, l'avis que j'ai vu le plus souvent était plus tranché :
"OpenAI just launched GPT-6.1 Sol, and for coding it can replace Astra outright at 1/5 the price."
La seule note aigre concernait davantage les abonnements que le modèle lui-même. Un commentateur sur Hacker News a dit que les quotas des forfaits ChatGPT avaient été réduits en même temps, donc « even in the best case scenario it's about 2.5 times cheaper for Codex users. » C'est l'affirmation d'un utilisateur et non un chiffre d'OpenAI, mais si vous utilisez Sol via un forfait plutôt que l'API, mieux vaut vérifier votre propre compteur d'usage avant de supposer une économie de 5x.
Tarifs de GPT-6.1 Sol
L'essentiel est simple : rien n'a augmenté. Sur la page de tarifs de l'API, GPT-6.1 Sol remplace GPT-6 Sol dans le tableau principal au même tarif standard de $2/$10. Une seule ligne a changé, l'entrée en cache, qui passe de $0.20 à $0.10 par million, soit 5% du tarif hors cache.
| Niveau | Entrée | Entrée en cache | Écritures en cache | Sortie |
|---|---|---|---|---|
| Standard (jusqu'à 272K en entrée) | $2.00 | $0.10 | $2.50 | $10.00 |
| Standard (plus de 272K en entrée) | $4.00 | $0.20 | $5.00 | $15.00 |
| Batch / Flex | $1.00 | $0.05 | $1.25 | $5.00 |
| Fast | $4.00 | $0.20 | $5.00 | $20.00 |
| Ultrafast | Bientôt |
Tous les prix par 1M de tokens. Source : tarifs de l'API OpenAI. Le traitement régional (résidence des données) ajoute une surcharge de 10%.
Cette baisse de l'entrée en cache compte plus qu'il n'y paraît. Un agent réutilise le même long prompt système et les mêmes définitions d'outils à chaque appel, plus l'historique de la conversation par-dessus, donc la part mise en cache de l'entrée a tendance à être importante. OpenAI le souligne directement dans l'article : la baisse donne aux développeurs « more room to build and run capable agents that reuse context across requests. »
Sur l'ensemble de la famille, la sortie est multipliée par 20 de Luna à Sol et par 5 de Sol à Astra :
| Modèle | Entrée / Sortie (par 1M) | Entrée en cache | Idéal pour |
|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | Tâches à gros volume et faible enjeu |
| GPT-6.1 Sol | $2.00 / $10.00 | $0.10 | Le nouveau choix par défaut pour le vrai travail |
| GPT-6 Astra | $10.00 / $50.00 | $1.00 | La recherche la plus difficile et les tâches de longue haleine |
Source : tarifs de l'API OpenAI. Pour le catalogue complet, y compris les modèles d'image et audio, le guide des tarifs de l'API OpenAI a tout.
Sol ou Astra : lequel utiliser ?
Quand vous choisissez entre les deux pour un vrai projet, la réponse dépend de la difficulté du travail et de sa durée, pas du modèle le plus récent. Choisissez l'option la plus proche de votre cas.
Quel est le travail ?
Les pièges dont personne ne parle dans le titre
Le lancement est solide, mais quatre détails vont faire trébucher quiconque migre une intégration existante.
- Pas d'effort de raisonnement
none. La page du modèle indique que l'effort prend en chargelow,medium(la valeur par défaut),high,xhighetmax, et quenoneetminimalne sont pas pris en charge. GPT-6 Sol prenait en chargenone. Si vous avez bâti un chemin critique en latence sur un raisonnement nul, testez-le avant de basculer. - Chat Completions n'a pas d'appel d'outils. OpenAI dit d'utiliser la Responses API pour les appels d'outils ; Chat Completions est pris en charge sans eux. Tout ancien code d'agent qui vit sur Chat Completions devra être déplacé.
- Pas encore dans le Chat classique de ChatGPT. Il est dans ChatGPT Work et Codex pour Plus, Pro, Business, Enterprise et Edu, mais OpenAI indique « not yet available in Chat. » Les utilisateurs Free et Go ne l'ont pas.
- Ultrafast est une promesse, pas un produit. Le récapitulatif de la DevDay dit qu'Ultrafast va jusqu'à 8x plus vite (300 tokens par seconde) dans Codex et jusqu'à 6x sur l'API, et que « GPT-6.1 Sol Ultrafast is coming soon. » Aujourd'hui, seul Astra a un prix Ultrafast.
Aucun de ces points n'est rédhibitoire seul. Ce sont le genre de petits changements qui transforment une migration « il suffit de changer l'identifiant du modèle » en une demi-journée de débogage, si personne ne vous a prévenu.
Comment y accéder
- API : utilisez l'identifiant de modèle
gpt-6.1-solsur la Responses API. Il n'y a pas de niveau gratuit, donc le Tier 1 est le plancher, avec 500 requêtes et 500,000 tokens par minute, jusqu'à 15,000 requêtes et 40 millions de tokens par minute au Tier 5. Le guide des limites de débit explique comment les niveaux montent. - ChatGPT Work et Codex : disponible pour les utilisateurs Plus, Pro, Business, Enterprise et Edu dès le jour du lancement. Si vous vivez dans Codex pour le codage agentique, c'est le modèle vers lequel basculer, et le détail des tarifs de Codex couvre les quotas des forfaits.
- Business et Enterprise : les espaces de travail ChatGPT Enterprise et Business l'obtiennent dans ChatGPT Work et Codex dès le premier jour, comme Plus et Pro.
Ce que cela signifie pour qui construit
Si vous utilisez déjà GPT-6 Sol, c'est la mise à niveau la plus simple de l'année : le prix reste le même et vous obtenez plus de capacité, plus un contexte en cache moins cher. Vérifiez d'abord les quatre pièges ci-dessus, puis pointez votre intégration vers gpt-6.1-sol.
La décision la plus importante concerne Astra. Il y a une semaine, recourir à Astra pour des agents de codage était encore facile à défendre. Aujourd'hui, avec Sol qui l'égale sur DeepSWE, la plupart des équipes qui paient 5x pour Astra devraient lancer leur propre jeu de tests sur les deux et voir où Sol se révèle vraiment insuffisant. Sur les longues tâches, le coût d'un agent IA est surtout fait de tokens de sortie, et la sortie est justement là où se situe l'écart de 5x.
Si vous préférez piloter ce type de flux de travail depuis un terminal, la CLI eesel mérite d'être connue. Elle fait fonctionner le même collègue eesel et le même espace de travail que le tableau de bord : vous pouvez lancer eesel chat à la main, scripter eesel activity pour relire ce que l'agent a fait à chaque exécution, utiliser --dry-run pour voir exactement ce qu'une écriture enverrait avant de l'envoyer, et laisser des agents de codage comme Claude Code, Codex et Cursor l'appeler directement. De plus, chaque espace de travail expose un serveur MCP, ce qui signifie qu'une session Codex utilisant GPT-6.1 Sol peut piloter votre collègue de support comme un outil, au lieu que vous cliquiez dans une interface.
Ce que cela signifie si vous dirigez une équipe de support
Voici maintenant le point contre-intuitif. Qu'un modèle soit proche d'Astra sur des benchmarks de codage change moins pour une file de support que ce que laisse penser le lancement.
Une meilleure factualité est réelle et bienvenue, car moins de réponses fausses énoncées avec aplomb, c'est exactement ce dont le support a besoin. Mais en support, la plupart des mauvaises réponses ne viennent pas du modèle qui invente, elles viennent des connaissances qu'on lui a données au départ. Une équipe de support B2B de télématique automobile qui configurait eesel sur Zendesk s'est heurtée tôt à ce problème : son bot répondait oui à « prenez-vous en charge le modèle de ma voiture ? » pour des marques absentes de leur base, parce que le centre d'aide disait « nous prenons en charge tous les modèles ». Le modèle avait lu la source fidèlement, c'est la source qui était fausse. Aucune mise à niveau de modèle ne corrige cela, et l'équipe a décrit la mise en place initiale comme des essais et des erreurs.
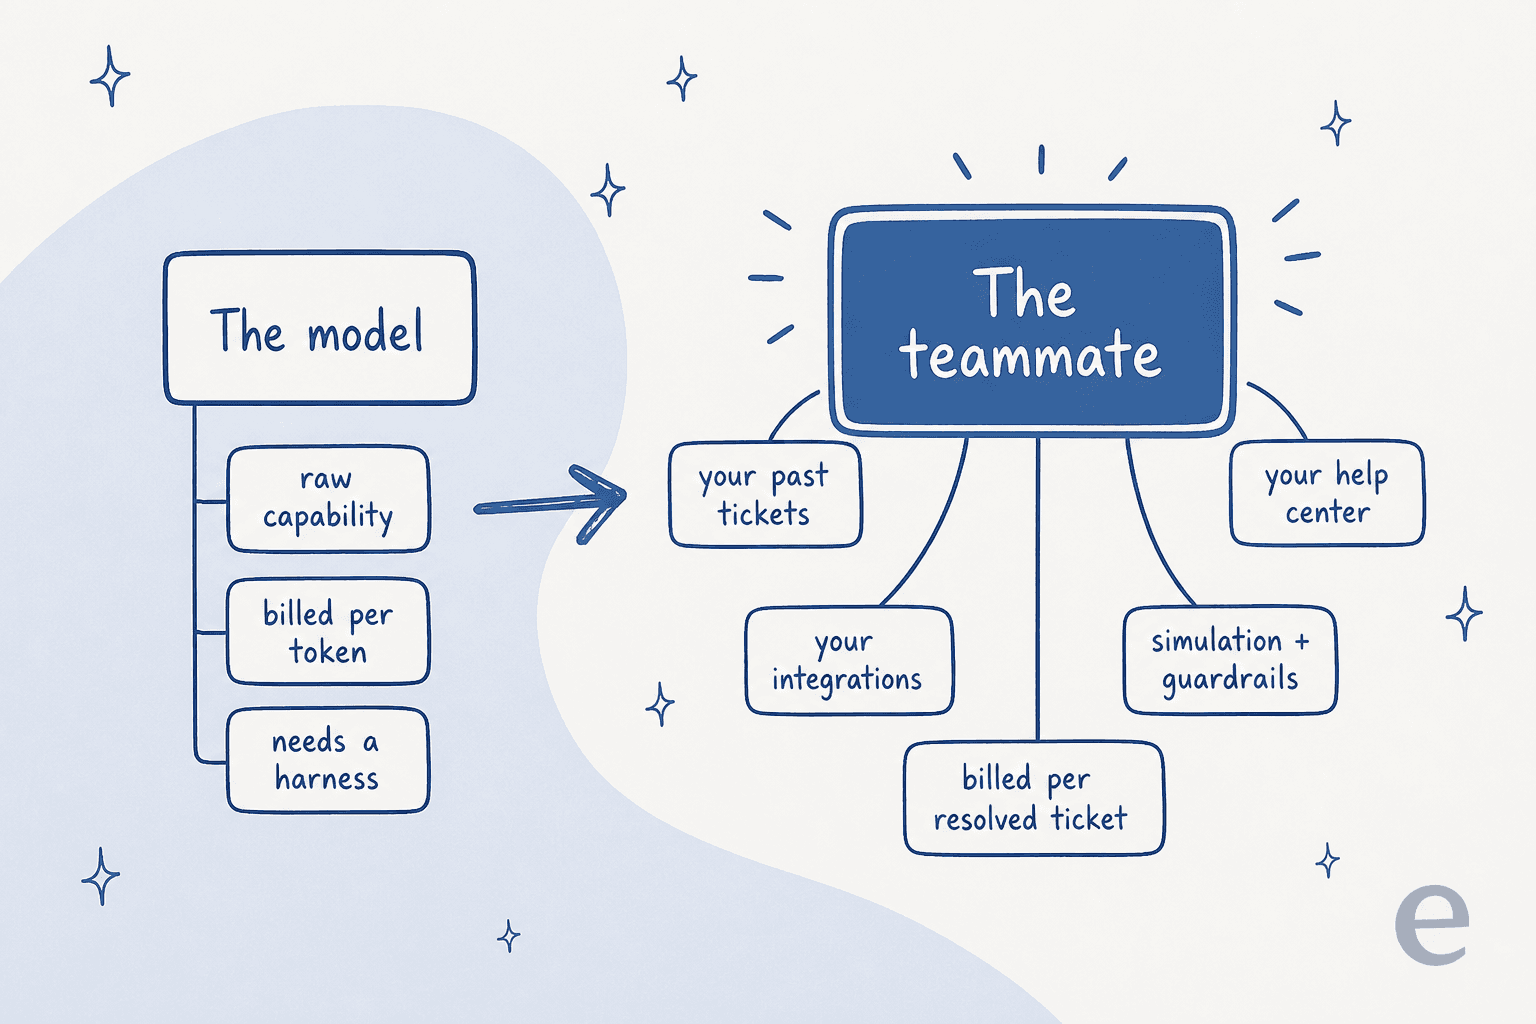
C'est pourquoi je placerais un nouveau modèle tout en bas des priorités d'une équipe de support. Ce qui fait bouger le taux de résolution, c'est la couche autour du modèle, c'est-à-dire l'entraînement sur vos anciens tickets, la connexion au helpdesk que vous utilisez déjà, puis le test des réponses sur votre propre historique avant la mise en production. Si les hallucinations vous inquiètent, la solution se trouve elle aussi surtout dans cette couche. Les meilleurs agents IA sont flexibles sur le modèle, donc quand un meilleur modèle comme GPT-6.1 Sol sort, vous en héritez au lieu de changer de plateforme.
Essayer eesel
Si ce que vous voulez vraiment de GPT-6.1 Sol, c'est moins de tickets dans la file, inutile de construire vous-même l'infrastructure. GPT-6.1 Sol est une infrastructure ; eesel est l'employé. Le collègue IA de helpdesk d'eesel apprend de vos anciens tickets et de votre centre d'aide, se branche sur Zendesk, Freshdesk, Gorgias et les autres helpdesks que vous utilisez déjà, et lance une simulation sur vos vrais anciens tickets pour que vous puissiez comparer ses réponses à ce que votre équipe a réellement envoyé avant qu'il ne réponde à un seul client.
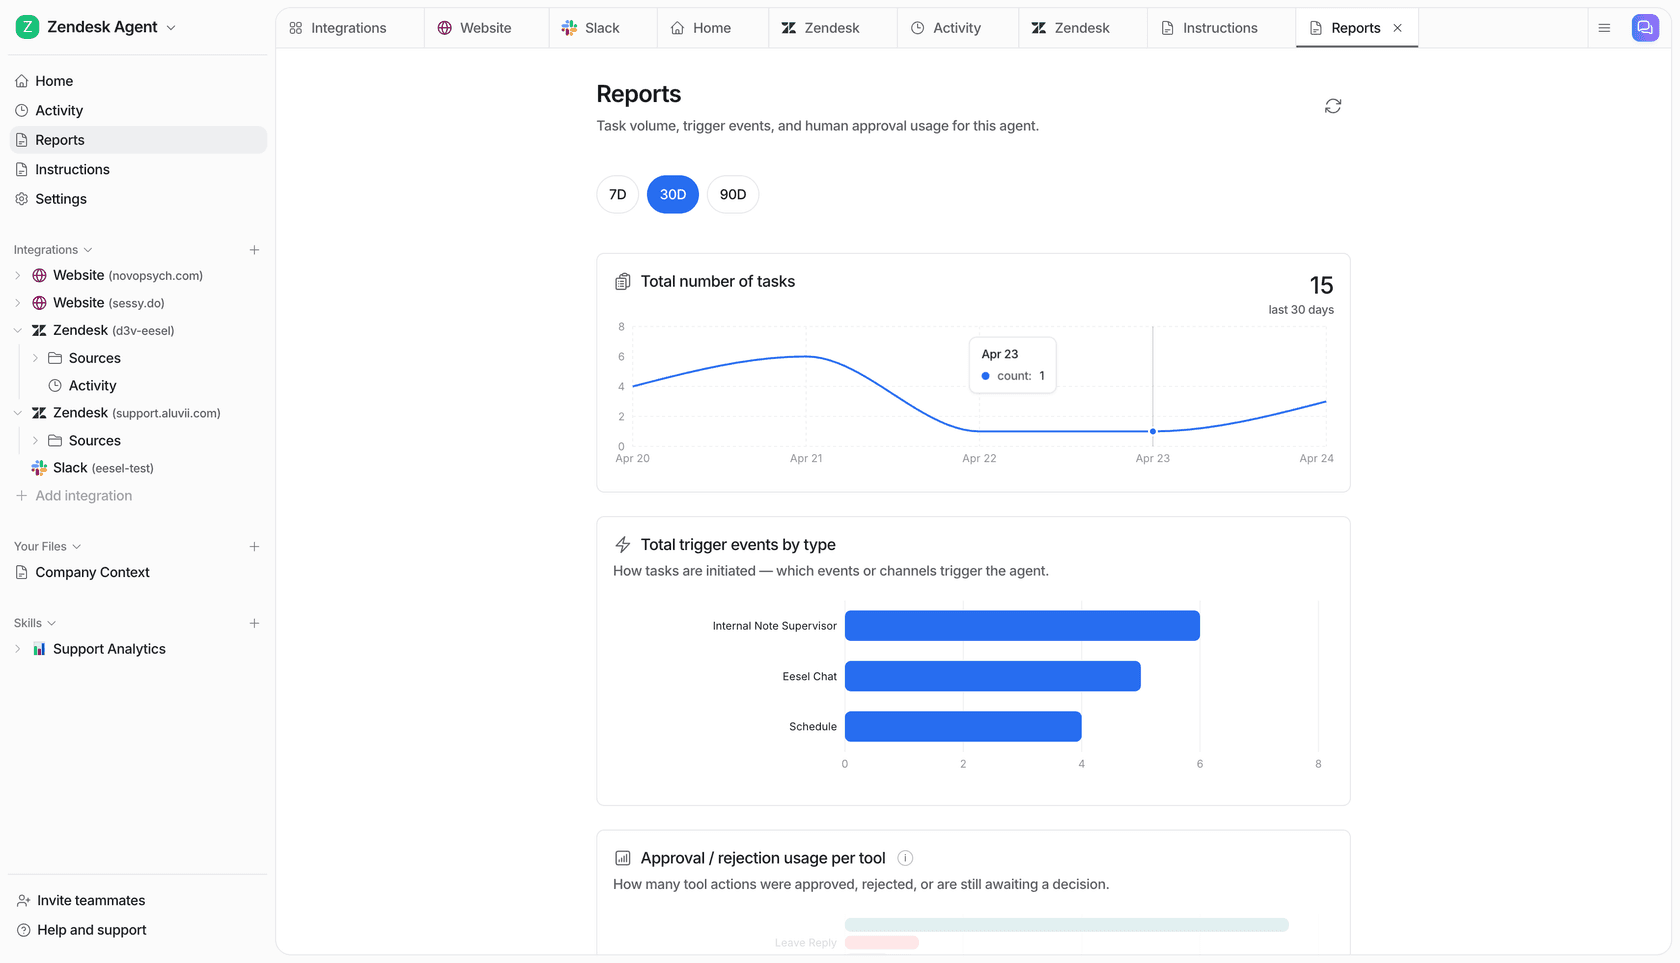
La tarification est un forfait de crédits mensuel fixe où un ticket ou un chat vaut un crédit, avec toutes les fonctionnalités et des utilisateurs illimités inclus, et un forfait gratuit de 100 crédits sans carte. Il n'y a pas de facturation au token, donc que le modèle en dessous soit GPT-6.1 Sol ou la prochaine version, la facture reste prévisible. Essayez eesel sur une partie de votre file et voyez les réponses sur vos propres tickets.
Questions fréquentes
Qu'est-ce que GPT-6.1 Sol ?
Combien coûte GPT-6.1 Sol ?
Quelle est la différence entre GPT-6 Sol et GPT-6.1 Sol ?
none disparaît, donc low est désormais le plancher. L'article d'origine sur GPT-6 Sol couvre le modèle précédent.GPT-6.1 Sol est-il aussi bon que GPT-6 Astra ?
GPT-6.1 Sol est-il disponible dans ChatGPT ?
gpt-6.1-sol, sans accès au niveau gratuit.GPT-6.1 Sol a-t-il un mode Ultrafast ?
Quelles sont les limites de débit de GPT-6.1 Sol ?
Dois-je utiliser GPT-6.1 Sol pour automatiser le support client ?

Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.