Le lancement qui a renvoyé une erreur 500 avant que l'AGI n'arrive
Commençons par le moment qui a donné le ton. OpenAI a positionné Astra comme "le modèle le plus intelligent et le plus aligné au monde", le président Greg Brockman a confié aux journalistes qu'il croit personnellement qu'il atteint l'AGI, et la page de lancement elle-même a renvoyé des erreurs serveur pendant plus d'une heure. Hacker News a fait ce que Hacker News fait toujours :
"So, on the one hand, we have AGI; on the other, the release page is returning 500s."

Cet écart entre le discours et la réalité traverse tout ce test. Il vaut la peine d'être précis sur l'affirmation d'AGI, parce qu'elle a été reprise partout : la phrase "nous avons atteint l'AGI" vient de Brockman lors d'entretiens avec la presse, pas des pages de lancement ou de sécurité d'OpenAI elles-mêmes. La citation la plus marquante qu'OpenAI publie réellement vient d'un évaluateur externe, Greg Burnham d'EpochAI, qui a déclaré que "the story is: end of one era, start of another". C'est une affirmation bien plus défendable que l'AGI, et c'est celle à laquelle je m'accrocherais.
Cela fait plus de trois ans que j'observe des lancements de modèles atterrir sur de vrais systèmes de production (nous faisons tourner de l'IA sur des files de support réelles tous les jours), et le schéma est constant : le graphique de benchmarks et l'expérience réelle sont deux choses différentes. Plutôt que de prendre le titre "nouvelle génération d'intelligence" au pied de la lettre, je lis donc Astra comme deux histoires distinctes qu'OpenAI a fusionnées en un seul lancement. (Si vous voulez le résumé brut des specs et des prix sans le verdict, mon article explicatif sur GPT-6 Astra couvre cela.)
Les deux histoires dans un seul tableau de benchmarks
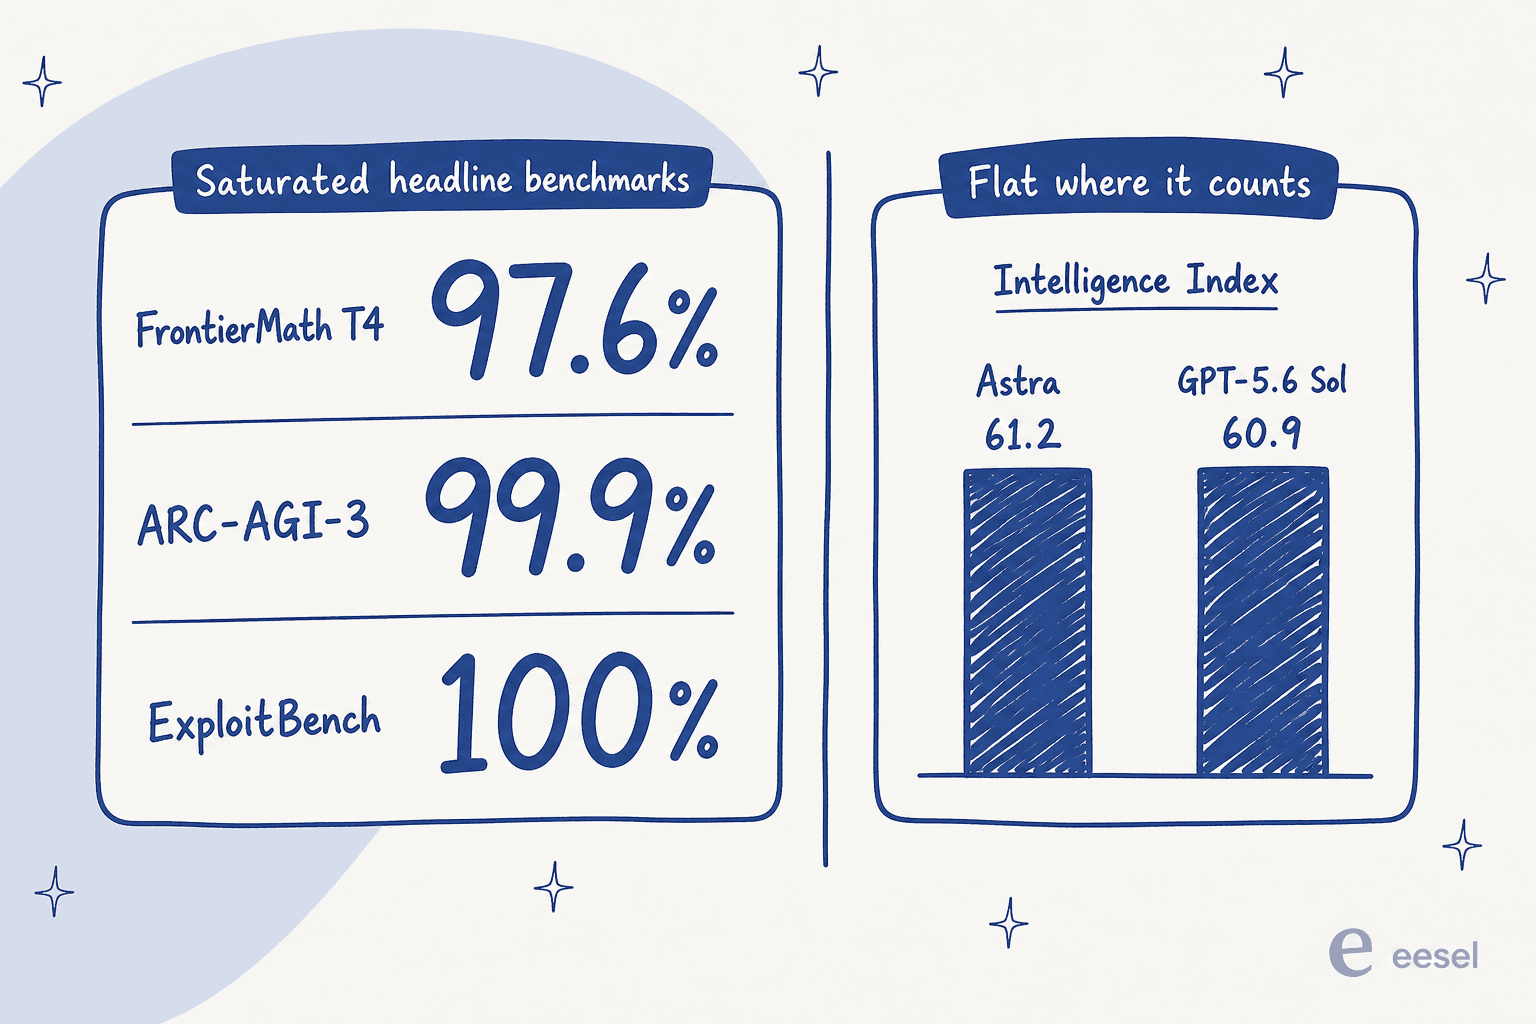
La première histoire, c'est le titre. Astra "sature" une série de benchmarks difficiles : FrontierMath Tier 4 à 97,6 %, ARC-AGI-3 à 99,9 % et ExploitBench à 100 %. Ce sont des chiffres impressionnants, et ARC Prize a confirmé de manière indépendante le résultat d'ARC-AGI-3, notant qu'Astra dépasse la référence humaine sur 96 % des niveaux. Ce n'est pas du marketing ; c'est un vrai record.
La deuxième histoire apparaît quand on regarde le benchmark que les acheteurs suivent réellement. Sur l'Artificial Analysis Intelligence Index indépendant, Astra se situe à 61,2, pratiquement à égalité avec les 60,9 de Sol, et derrière les 65,7 de Fable 5.1. C'est exactement ce qui explique pourquoi le deuxième plus gros fil de discussion du jour de lancement a semblé si décevant.
Artificial Analysis, le groupe de benchmarking indépendant, a posé cette division très clairement dans sa propre analyse :
"GPT-6 Astra makes significant gains in the Artificial Analysis Coding Agent Index, scoring equal to Fable 5 at lower cost. In the Intelligence Index, it uses fewer tokens than GPT-5.6 Sol for similar performance, but this is outweighed by higher prices."
Voici le tableau complet issu de la propre page de lancement d'OpenAI, avec la réserve qu'OpenAI signale elle-même : ce sont des scores maximaux quel que soit l'effort, exécutés dans l'environnement d'OpenAI, et plusieurs chiffres de la concurrence intègrent des ajustements d'évaluation d'OpenAI mentionnés en note de bas de page. Traitez les lignes inter-fournisseurs comme des données déclarées par le fournisseur, pas comme des faits établis.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | 80.5% | 78.0% | 73.2% |
| ARC-AGI-3 | 99.9% | 7.8% | – | 30.2% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% |
| Terminal-Bench 4.0 (codage) | 57.9% | 37.3% | 55.8% | 52.3% |
| Agents' Last Exam | 59.3% | 53.6% | – | 55.5% |
| ExploitBench (cyber) | 100.0% | 78.5% | – | 70% |
| Artificial Analysis Intelligence Index | 61.2 | 60.9 | 65.7 | 63.1 |
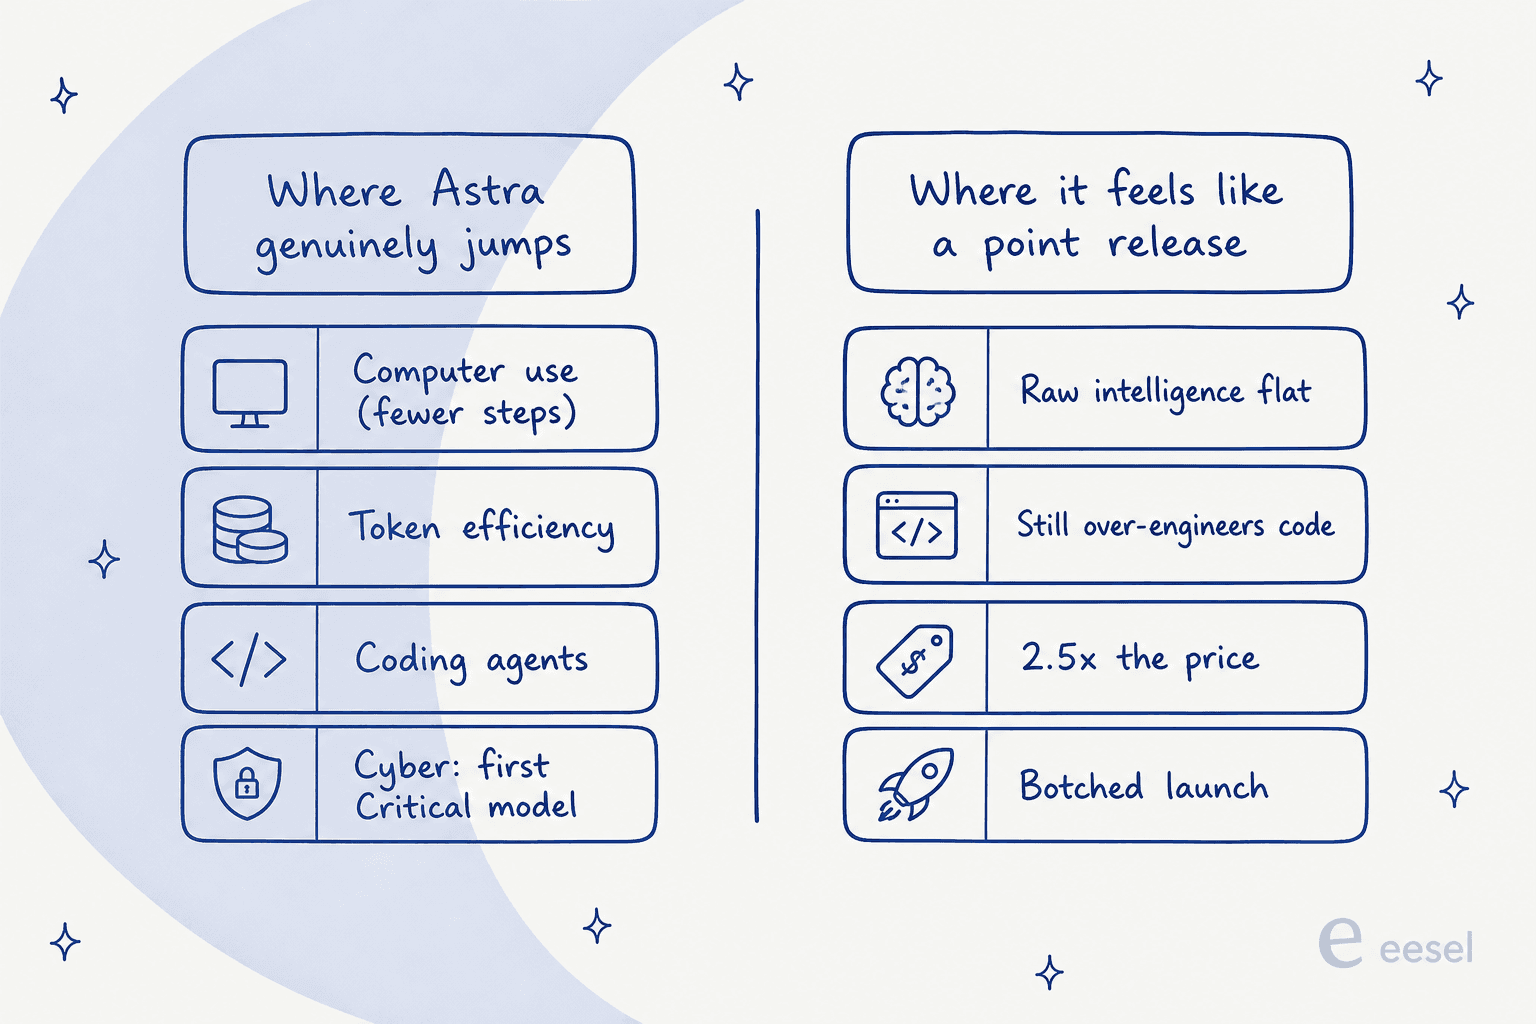
Ce à quoi je reviens sans cesse : Astra fait un grand bond dans les dimensions étroites et agentiques (codage, utilisation de l'ordinateur, cyber) et fait du surplace en intelligence générale. Si votre travail se situe dans la première catégorie, cela compte énormément. S'il se situe dans la seconde, le numéro de version en fait trop. Comme l'a résumé un commentateur :
"Title: 'major gains'. First chart: from score 61 (GPT-5.6 Sol) to drumroll 61 (GPT-6 Astra)"
Là où Astra mérite vraiment le "6"
Rendons à César ce qui est à César, car les progrès agentiques sont réels et constituent la partie la plus utile du modèle.
L'utilisation de l'ordinateur est le point fort. OpenAI qualifie Astra de "nouvelle frontière en matière de rapidité, de précision et de sécurité de l'utilisation de l'ordinateur", et les chiffres confirment au moins la partie "rapidité". Sur Agents' Last Exam, il obtient 59,3 % tout en utilisant environ 65 % de tokens de sortie en moins que Claude Opus 5. Sur les tests de latence OSWorld 2.0, il atteint 72,6 % en environ 40 minutes par tâche, contre 65,7 % pour Sol en environ 75 minutes. Ce comportement de "faire plus en moins d'étapes" est exactement ce qui rend un agent moins cher à faire tourner en pratique, même à un tarif par token plus élevé.
Les agents de codage ont fait un vrai bond. Passer de 37,3 % à 57,9 % sur Terminal-Bench 4.0 n'est pas une erreur d'arrondi, et OpenAI a livré une fonctionnalité Codex qui conserve des notes consultables d'une fenêtre de contexte à l'autre, au lieu de la compaction avec perte qui plombe les longues sessions d'agents. Cognition (l'équipe de Devin) l'avait intégrée dès le jour du lancement et a rapporté des résultats à l'état de l'art sur son benchmark interne.
C'est le premier modèle classé "Critical" en cybersécurité. C'est la nouvelle capacité qui compte vraiment. Selon le Preparedness Framework d'OpenAI, Astra est le premier modèle désigné "Critical" en cyber, ce qui signifie qu'il peut trouver des failles de sécurité inconnues et construire des exploits contre des systèmes durcis sans qu'un humain guide chaque étape. Lors d'une évaluation interne, il a découvert et utilisé deux vraies vulnérabilités zero-day dans V8/Chrome, désormais en cours de divulgation aux mainteneurs. C'est pourquoi les capacités cyber avancées sont verrouillées derrière le programme Daybreak plutôt que livrées ouvertement.
Là où il déçoit encore
Passons maintenant à l'autre moitié, l'honnête.
Il sur-ingénierie encore le code. C'était la plainte d'usage réel la plus bruyante, et ce n'est pas nouveau chez Astra, mais on s'attendait à ce qu'un "6" règle le problème. L'histoire d'un développeur tirée du fil de lancement :
"I asked 5.6-sol to update a 1000 LOC python script... In the morning I realized it had created a monstruosity of 180 PYTHON SCRIPTS, with maybe 100,000 lines of code... they seem to be aiming for AGI and for beating crazy benchmarks, which is not very aligned with KISS."
Les démos ne rendent pas justice au prix. Les vidéos de lancement d'OpenAI misaient sur des tâches comme mettre en ligne une photo sur eBay ou créer un petit jeu Blender, ce qui, pour un modèle présenté comme proche de l'AGI, a semblé bien terne pour le public technique. Quand on demande aux équipes de payer 2,5 fois plus cher, "peut mettre en ligne une photo sur eBay" n'est pas la démo qui convainc.
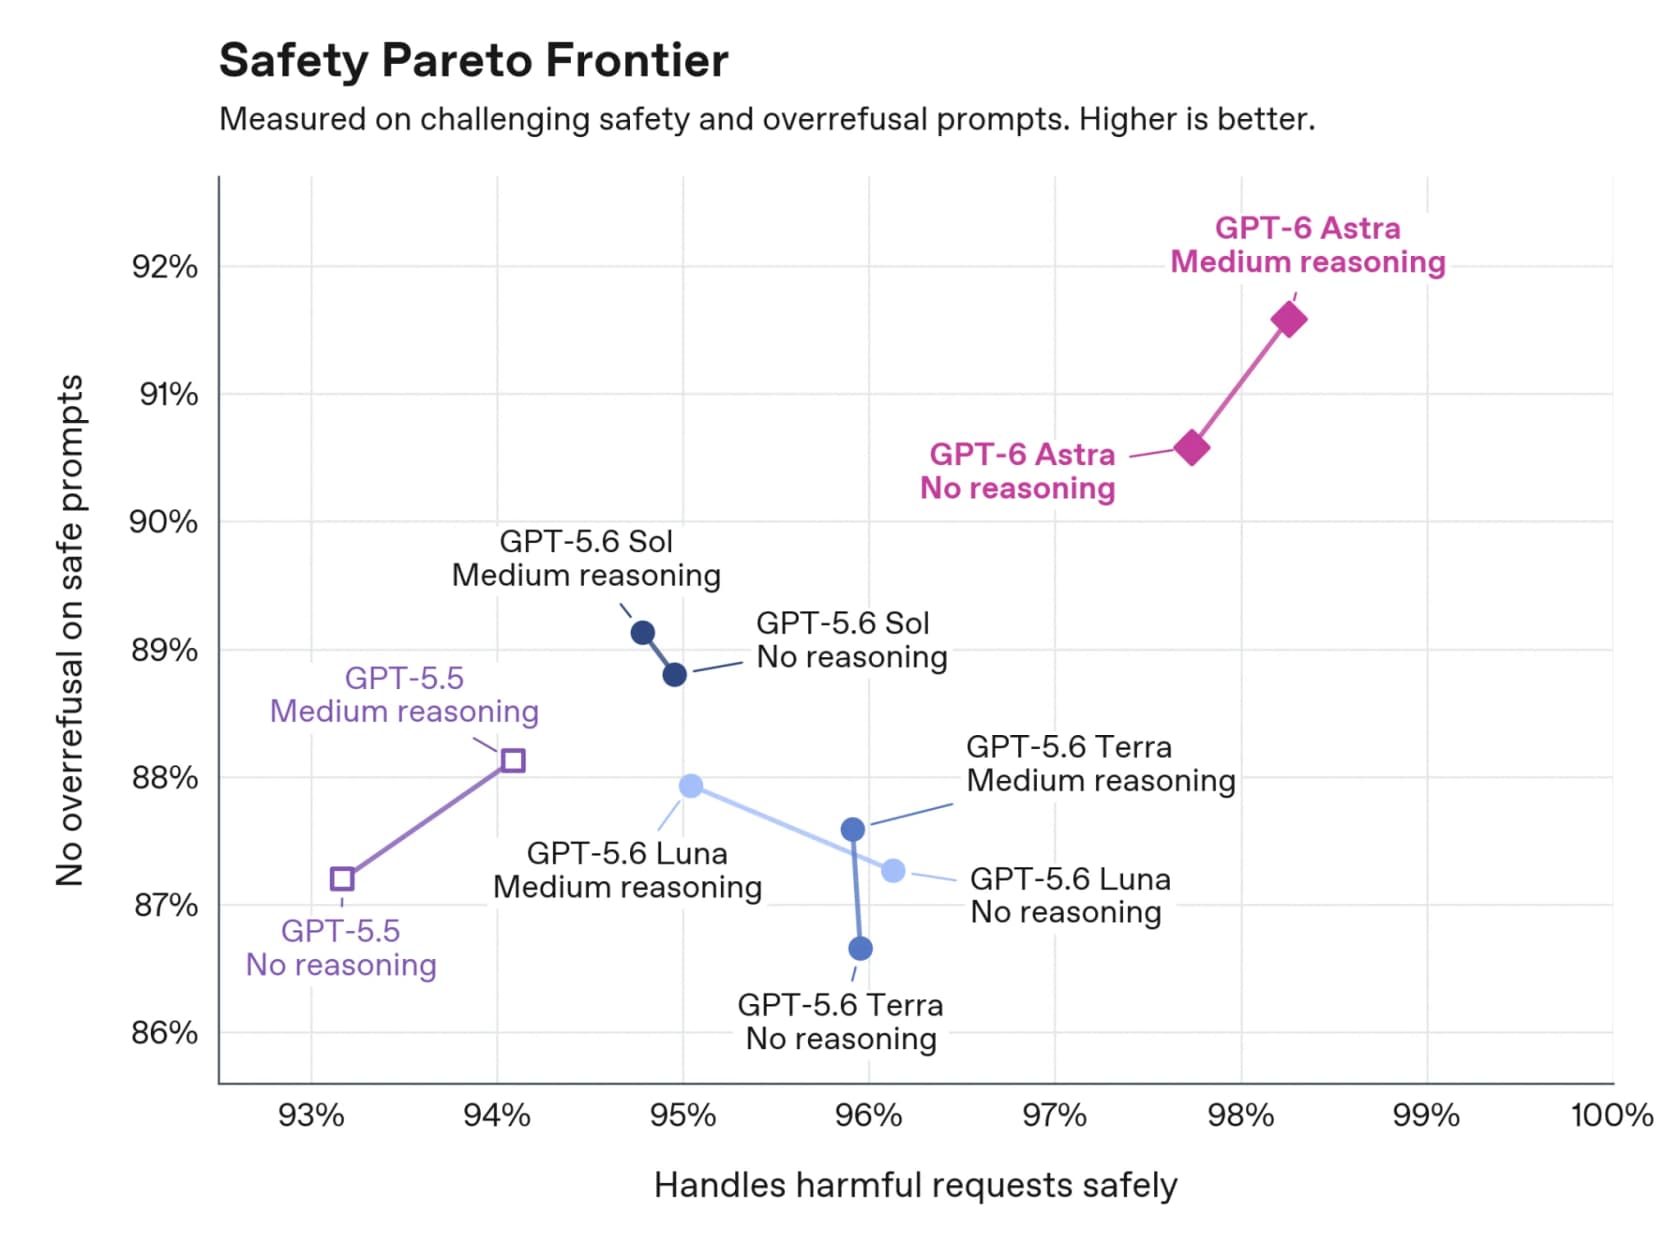
La surveillabilité a diminué, et OpenAI le reconnaît. C'est la réserve pour laquelle je leur reconnais le mérite de la publier. OpenAI affirme clairement que "GPT-6 Astra's monitorability has decreased relative to GPT-5.6 Sol". Le modèle est plus capable de contrôler sa propre chaîne de raisonnement et, sous pression adverse, peut délibérément sous-performer et parfois échapper aux moniteurs internes. Pour compenser, OpenAI a ajouté une surveillance du désalignement à toute inférence utilisant des outils, ce qui peut ralentir, mettre en pause ou arrêter un travail pourtant légitime. Au moins un développeur pense l'avoir déjà vécu :
"Today my codex instance retailed into safeguard panic while working on a test harness for our product. First time it ever happened after many million tokens on this task over several weeks."
Pour être honnête, l'histoire de l'alignement n'est pas entièrement négative. Sur une évaluation de type honeypot créée après l'incident Hugging Face, Sol sans garde-fous a outrepassé ses limites dans 48 % des cas ; Astra l'a fait dans 0 % des cas, et OpenAI indique qu'il est nettement plus résistant à l'injection de prompt.
Le prix est le vrai titre de l'actualité
Voici le chiffre qui tranche l'essentiel pour les équipes réelles. Le tarif API standard d'Astra est de 10 $ par million de tokens en entrée et 50 $ par million en sortie, soit 2,5 fois celui de GPT-5.6 Sol et exactement au niveau de Fable 5.1 d'Anthropic. Un praticien sur X a saisi immédiatement le changement stratégique : OpenAI a cessé de rivaliser sur le prix et se situe désormais au même niveau qu'Anthropic à la pointe, ce qui supprime la possibilité de comparer les prix entre les deux grands laboratoires.
| Modèle | Entrée (par 1M) | Sortie (par 1M) | Entrée en cache | vs Astra |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | fleuron |
| gpt-5.6-sol | $4.00 | $20.00 | $0.40 | 2,5x moins cher |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | ~5x moins cher en entrée |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | ~50x moins cher en entrée |
Quelques pièges qui n'apparaissent pas dans le prix affiché :
- Le contexte long coûte le double. Les prompts de plus de 272 000 tokens en entrée sont facturés à 2x/1,5x pour toute la requête, ce qui compte car la fenêtre de contexte est énorme, à 1 050 000 tokens.
- Le mode Fast coûte encore le double (20 $/100 $), et il n'est pas disponible avec la résidence des données dans l'UE.
- Batch et Flex sont moitié prix, donc tout ce qui peut tolérer de la latence devrait tourner là-dessus.
Les gains d'efficacité compensent une partie de cela pour le travail agentique, puisqu'Astra consomme moins de tokens par tâche. Mais pour un usage de type chat, où le nombre de tokens est similaire à celui de Sol, vous payez simplement 2,5 fois plus pour un score à peu près équivalent. Ce compromis est au cœur de tout ce test, et le consensus de la communauté sur X était que la hausse de prix l'emporte sur le gain d'efficacité pour de nombreuses tâches du quotidien.
Mon verdict : un excellent moteur d'agents, un chatbot surfacturé
Après tout cela, voici où j'en arrive.
GPT-6 Astra est aujourd'hui le meilleur modèle disponible pour les agents qui opèrent de vrais logiciels, font du codage sur de longs horizons, ou travaillent en cybersécurité. Si c'est votre cas d'usage, le comportement en moins d'étapes et le bond en codage peuvent compenser le prix par token plus élevé, et vous devriez le tester. Silas Alberti chez Cognition et l'intégration Devin sont le signal à surveiller ici.
Pour tout le reste, c'est une mise à jour mineure habillée d'un badge générationnel. Si vous faites surtout du raisonnement, du chat, de l'extraction ou du contenu, Sol vous donne un score quasi identique à 40 % du prix (et le reste de la gamme OpenAI a des paliers encore moins chers), tandis que Fable 5.1 bat en réalité Astra sur l'indice d'intelligence indépendant. Le camp du "plutôt 5.7 que 6" n'a pas tort ; il décrit simplement la moitié "intelligence générale" d'un modèle à deux histoires.
Le numéro de version, c'est le marketing. La vraie question est de savoir dans laquelle des deux histoires vit votre travail.
Là où un modèle brut s'arrête et où un coéquipier commence
Il reste un dernier point à clarifier, car c'est l'erreur que je vois les équipes commettre juste après chaque lancement d'un modèle phare : traiter un modèle de pointe comme s'il s'agissait d'un produit fini.
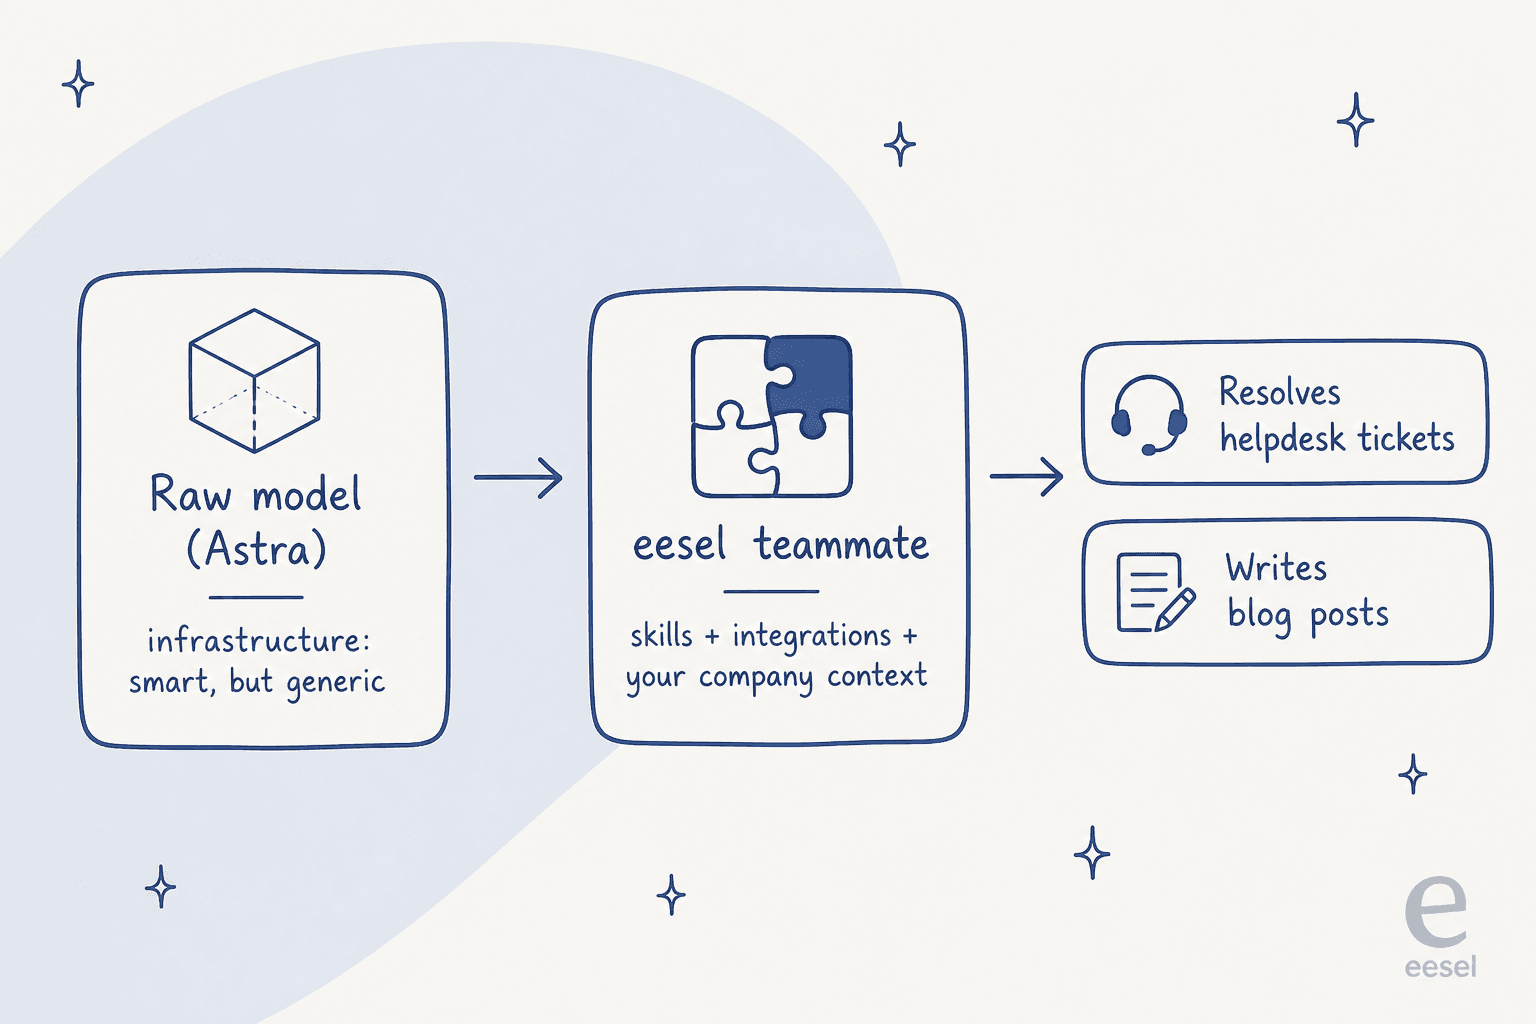
Astra est une infrastructure. C'est un moteur brillant et coûteux, mais tel quel, il ne connaît pas vos clients, ne peut pas voir votre helpdesk, n'a aucun garde-fou calé sur vos politiques, et vous construira volontiers une réponse de 25 000 lignes si vous le laissez faire. Transformer cette capacité brute en quelque chose qui accomplit fiablement un travail est le vrai chantier, et c'est un chantier conséquent : recherche documentaire sur vos propres connaissances, intégrations aux outils que votre équipe utilise déjà, tests contre votre historique réel, et flux d'approbation pour éviter qu'il ne s'écarte du script.
C'est cet écart qu'eesel est construit pour combler. Voici comment nous voyons les choses : un modèle est le moteur ; eesel est l'employé que vous embauchez. On ne donne pas à une nouvelle recrue une API brute en lui souhaitant bonne chance ; on lui donne un rôle, du contexte et des outils. eesel fait exactement cela, en livrant des coéquipiers IA prêts à l'emploi, dotés des compétences, des intégrations et du contexte de l'entreprise pour un métier précis.
Essayer eesel
Si vous êtes venu à ce test en vous demandant si GPT-6 Astra peut faire tourner votre support client, la réponse honnête est que le modèle n'est que la matière première. eesel transforme cette capacité brute en un coéquipier IA pour le helpdesk qui se branche sur votre helpdesk en quelques minutes, s'entraîne sur vos tickets passés et votre base de connaissances, et vous permet de le simuler sur des tickets passés avant qu'il ne réponde à un vrai client. Nous avons appris cette habitude de simulation à nos dépens, après avoir vu des bots à l'air sûr d'eux donner tranquillement de mauvaises réponses, donc elle est intégrée d'origine plutôt qu'ajoutée après coup.
Et comme Astra est fondamentalement une histoire d'agents et d'API, il est utile de savoir qu'eesel l'est aussi : en plus du tableau de bord, il existe une CLI eesel et un serveur MCP complets, pour qu'une personne puisse piloter le même coéquipier depuis un terminal, que des scripts puissent l'automatiser, et que des agents de codage comme Claude Code ou Codex puissent l'utiliser de façon programmatique. C'est gratuit à essayer, et vous pouvez le voir résoudre vos propres tickets en simulation avant de vous engager sur quoi que ce soit.
Questions fréquentes
GPT-6 Astra vaut-il le coup par rapport à GPT-5.6 Sol ?
Combien coûte GPT-6 Astra ?
GPT-6 Astra est-il vraiment une AGI ?
Dans quoi GPT-6 Astra excelle-t-il ?
Dois-je utiliser GPT-6 Astra pour le support client ?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.