Tarifs API de GPT-6 Astra : le palier standard
Voici le chiffre pour lequel la plupart des gens sont venus. Sur la page tarifaire de l'API, le tarif standard de GPT-6 Astra est de $10,00 par million de tokens en entrée et $50,00 par million de tokens en sortie. L'entrée en cache tombe à $1,00, et les écritures de cache coûtent $12,50 par million.
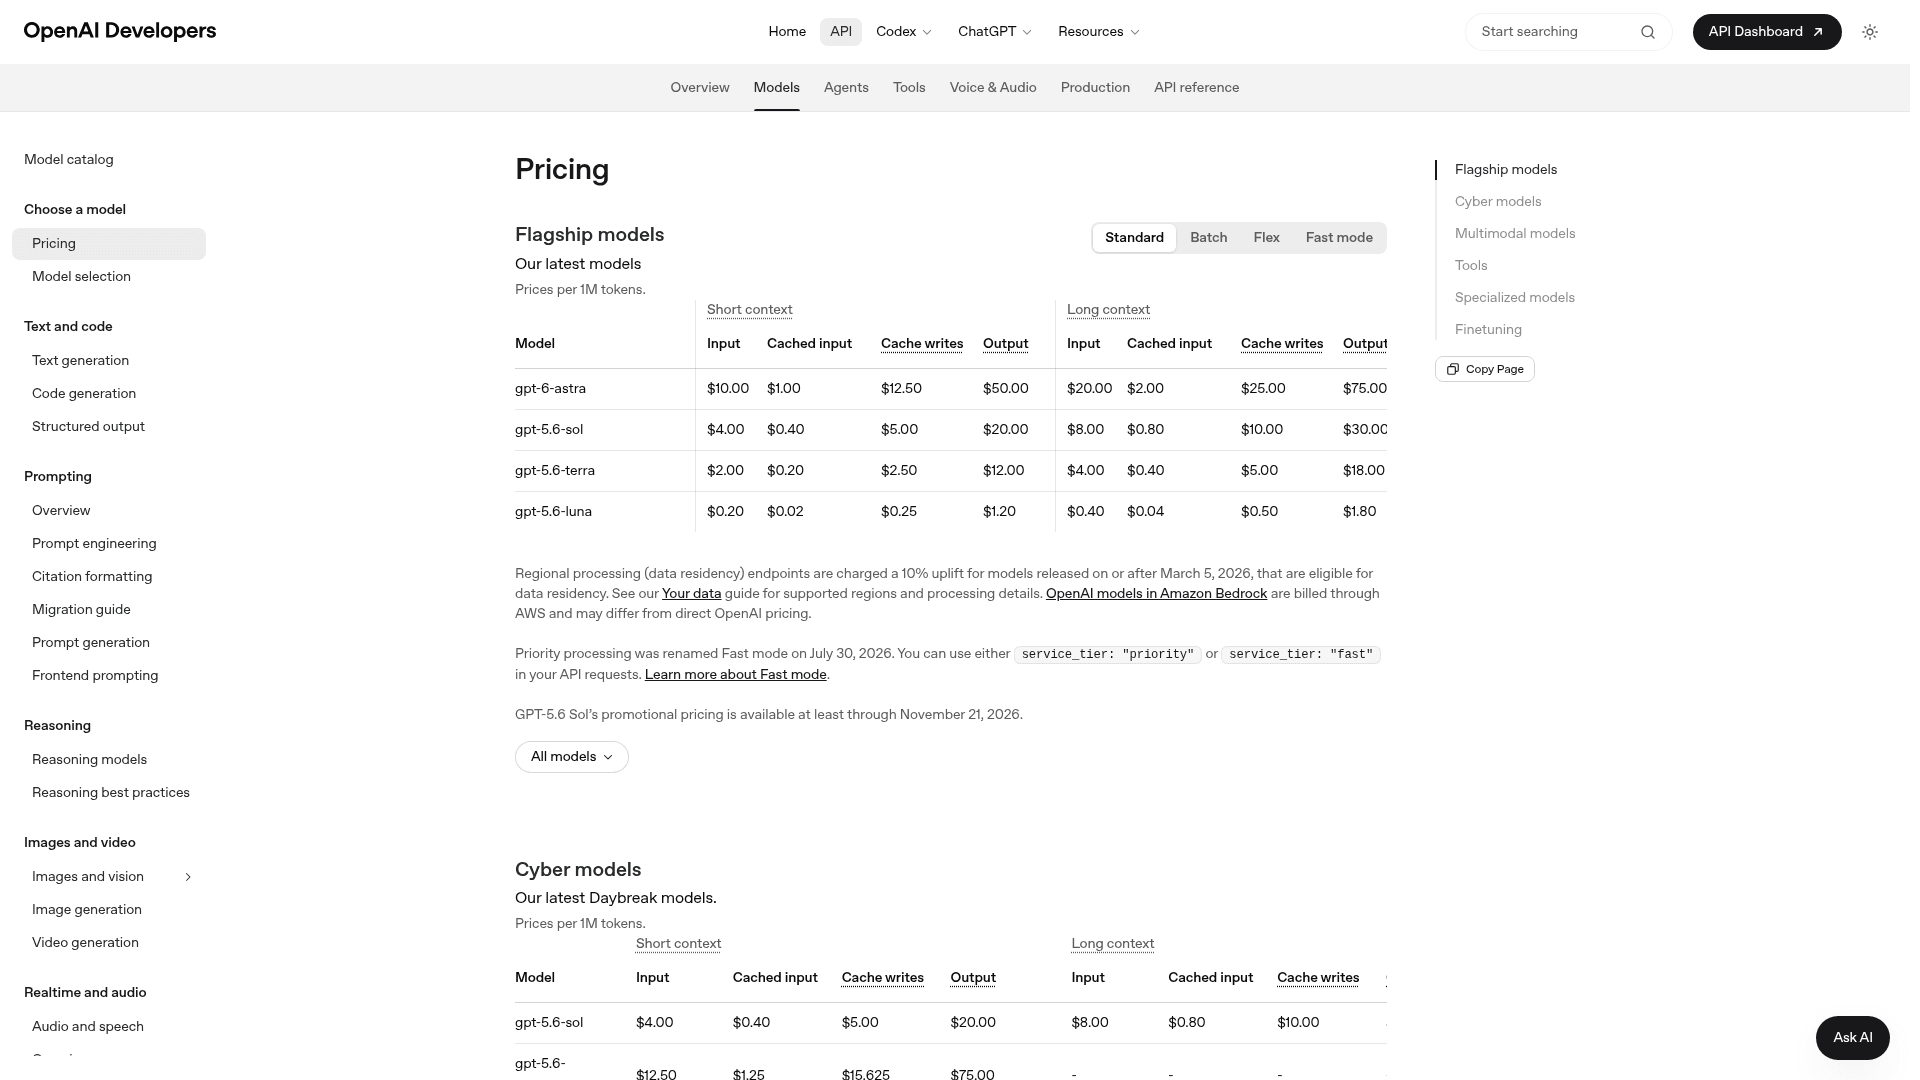
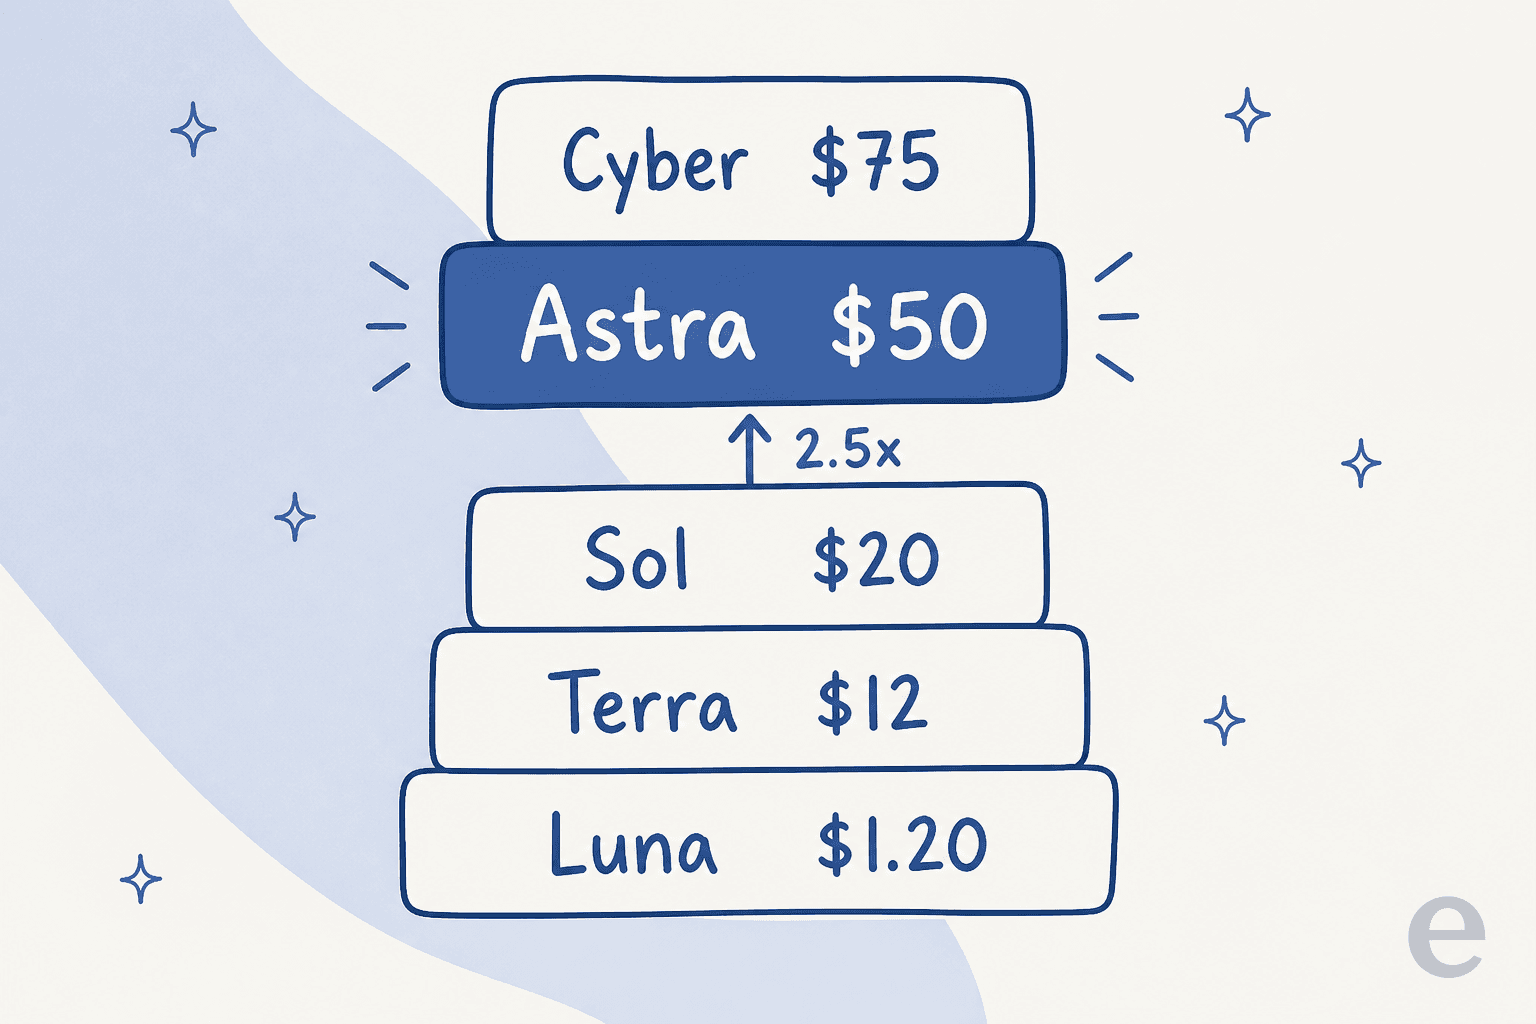
Pour situer les choses, c'est un vrai bond par rapport au reste de la gamme de modèles OpenAI. Astra est désormais le deuxième modèle le plus cher vendu par OpenAI, juste derrière le spécialiste gpt-5.6-cyber. Voici où se positionne chaque modèle phare au palier standard, contexte court :
| Modèle | Entrée (par 1M) | Entrée en cache | Sortie (par 1M) | Position |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Nouveau modèle phare |
| gpt-5.6-sol | $4.00 | $0.40 | $20.00 | Ancien modèle phare (promo) |
| gpt-5.6-terra | $2.00 | $0.20 | $12.00 | Milieu de gamme |
| gpt-5.6-luna | $0.20 | $0.02 | $1.20 | Le moins cher |
| gpt-5.6-cyber | $12.50 | $1.25 | $75.00 | Spécialiste (Daybreak) |
Source : Tarifs API OpenAI. Un détail daté qui mérite d'être précisé : le $4/$20 de GPT-5.6 Sol est un tarif promotionnel maintenu au moins jusqu'au 21 novembre 2026, donc l'écart « 2,5x » se mesure par rapport à une remise qui pourrait ne pas durer.
Cette parité tarifaire avec Fable 5.1 d'Anthropic n'a pas échappé aux praticiens. Comme l'a formulé un commentateur de Hacker News, OpenAI « a enfin trouvé un moyen d'arrêter de vendre bon marché et de gagner de l'argent avec les clients à forte demande, comme le fait Anthropic ». La conséquence plus discrète relevée par certains : avec les deux laboratoires de pointe désormais à $10/$50, la possibilité de comparer les prix entre eux a tout simplement disparu.
Paliers de service : la variation de 4x que presque tout le monde manque
Le tarif standard est un point de départ, pas toute l'histoire. GPT-6 Astra fonctionne sur quatre paliers de service, et l'écart entre le moins cher et le plus cher est de 4x pour exactement le même modèle. C'est le plus gros levier que vous ayez sur le coût, plus important que n'importe quelle optimisation de prompt.
| Palier | Entrée (par 1M) | Entrée en cache | Sortie (par 1M) | Compromis |
|---|---|---|---|---|
| Batch | $5.00 | $0.50 | $25.00 | 50 % moins cher, asynchrone, jusqu'à 24h |
| Flex | $5.00 | $0.50 | $25.00 | 50 % moins cher, plus lent, peut être mis en file |
| Standard | $10.00 | $1.00 | $50.00 | Latence par défaut |
| Fast mode | $20.00 | $2.00 | $100.00 | 2x, latence la plus faible |
Source : Tarifs API OpenAI. Quelques points à connaître avant de choisir :
- Batch et Flex coûtent le même prix, mais servent des usages différents. Batch convient aux charges asynchrones que vous soumettez et récupérez plus tard ; Flex convient aux requêtes interactives que vous acceptez de voir tourner plus lentement ou mises en file. Les deux réduisent votre facture de moitié.
- Le mode Fast a été renommé depuis Priority le 30 juillet 2026. Vous pouvez toujours passer
service_tier: "priority"ouservice_tier: "fast". Il double le tarif pour la latence la plus faible. - Le mode Fast a un piège régional. Il est indisponible pour GPT-6 Astra avec la résidence des données UE ; ces requêtes retombent sur le standard.
Si une charge de travail peut tolérer de la latence, la faire basculer par défaut vers Batch ou Flex réduit effectivement de moitié votre dépense Astra sans changer la qualité de sortie. C'est la première chose que je vérifierais sur tout pipeline à fort volume.
Les pièges : contexte long et majoration régionale
Deux surcoûts se cachent dans les petites lignes de la page du modèle, et tous deux peuvent discrètement redessiner un budget.
D'abord, le contexte long est facturé à un tarif plus élevé pour toute la requête. La fenêtre de contexte d'Astra est immense, 1 050 000 tokens, mais tout prompt dépassant 272K tokens en entrée fait basculer la requête entière au tarif contexte long : $20 par million en entrée et $75 par million en sortie au palier standard. C'est 2x l'entrée et 1,5x la sortie, et cela s'applique à chaque token de la requête, pas seulement à ceux au-delà du seuil.
| Palier standard | Contexte court (≤272K) | Contexte long (>272K) |
|---|---|---|
| Entrée (par 1M) | $10.00 | $20.00 |
| Entrée en cache | $1.00 | $2.00 |
| Sortie (par 1M) | $50.00 | $75.00 |
Ensuite, le traitement régional entraîne une majoration de 10 %. Les endpoints à résidence des données pour les modèles sortis à partir du 5 mars 2026 sont facturés 10 % plus cher. Si vous êtes contraint à une région spécifique pour la conformité, intégrez ce facteur en plus du reste.
Et un plancher à retenir : Astra n'est disponible sur aucun palier gratuit, donc l'usage Tier 1 est le point d'entrée pour les développeurs.
Estimez votre facture API GPT-6 Astra
Les prix affichés restent abstraits tant que vous n'y injectez pas vos propres chiffres. Renseignez les millions de tokens en entrée et en sortie que vous prévoyez par mois, choisissez un palier de service, et cela calcule le coût mensuel. Le surcoût de contexte long est pris en compte automatiquement.
Le schéma que la plupart des équipes constatent, c'est que les tokens de sortie dominent la facture, la sortie coûtant 5 fois le tarif d'entrée. Si votre charge génère des réponses longues, c'est là que va l'argent, et c'est là que basculer un job compatible batch vers le palier Batch rapporte le plus vite.
Tarifs de GPT-6 Astra sur ChatGPT
Si vous n'appelez pas l'API, GPT-6 Astra vous parvient plutôt via les forfaits ChatGPT, et la page tarifaire trace une ligne claire sur qui y a accès.
| Forfait | Prix | Accès GPT-6 Astra |
|---|---|---|
| Free | $0 | Non (Luna uniquement) |
| Go | $8/mois | Non |
| Plus | $20/mois | Oui |
| Pro | À partir de $100/mois | Élargi, plus une variante Pro |
| Business / Enterprise | Par siège | Oui (Enterprise désactivé par défaut) |
Source : Tarifs ChatGPT. Quelques points à noter :
- Astra commence avec Plus. Le forfait Plus à $20/mois est le point d'entrée pour les utilisateurs de ChatGPT. Ni Free ni le forfait Go à $8 ne l'incluent, et les utilisateurs de Free sont limités à GPT-5.6 Luna.
- Pro ajoute de la marge. Pro, à partir de $100/mois, donne 5x ou 20x plus d'usage et un mode de raisonnement Pro à effort supérieur alimenté par Astra.
- Enterprise a un interrupteur. Sur Business et Enterprise, Astra est disponible par siège, mais désactivé par défaut au lancement pour chaque espace de travail, un administrateur doit donc l'activer. Les associations à but non lucratif peuvent obtenir jusqu'à 75 % de réduction sur Business ou Enterprise.
Comment se compare le tarif de GPT-6 Astra
En prenant du recul, où se situe Astra face au reste de la frontière technologique ? En résumé, OpenAI a arrêté de concurrencer sur les prix au sommet du marché.
- Face à sa propre gamme : à $10/$50, Astra coûte 2,5 fois plus cher que GPT-5.6 Sol et environ 4 fois plus cher que GPT-5.6 Terra. Pour la plupart des tâches courantes, Terra ou Luna offrent l'essentiel de la valeur pour une fraction du coût.
- Face à Anthropic : Astra rejoint exactement Fable 5.1 à $10/$50, si bien que les deux modèles phares sont désormais au même prix.
- Face à Google : il se situe bien au-dessus des tarifs de Gemini pour des paliers comparables, et bien plus encore au-dessus d'options plus légères comme Gemini 3 Flash.
L'inquiétude tarifaire de la communauté portait moins sur le prix affiché que sur la consommation. Un utilisateur abonné à Codex a averti que Sol est déjà « un modèle vorace en tokens » et craignait qu'Astra, à 2,5 fois le tarif, n'épuise les quotas plus vite. La nuance : Astra utilise moins de tokens par tâche agentique, donc les deux effets s'annulent en partie. C'est exactement pourquoi le coût d'un agent IA n'est jamais seulement le tarif au token. La consommation est l'autre moitié de l'équation, et vous ne pouvez la voir que sur votre propre trafic.
Ce que le tarif de GPT-6 Astra signifie si vous dirigez une équipe support
C'est ici que je veux être utile plutôt que simplement lister des tarifs, parce que je construis des produits dans ce domaine, et la réponse honnête est un peu contre-intuitive.
Si vous dirigez le support client ou des opérations internes, l'arrivée d'un modèle de pointe plus puissant et plus cher change moins de choses que ne le suggèrent les gros titres. Un modèle brut comme Astra, c'est de l'infrastructure. C'est un moteur spectaculaire, mais tel quel il ne connaît pas votre politique de remboursement, ne peut pas voir vos 50 000 derniers tickets, n'a pas accès à votre système de commandes, et n'a aucun moyen sûr d'être testé sur votre véritable file avant de commencer à répondre aux clients. Il est facturé au token pour réfléchir, pas au problème résolu. La plupart des gens confondent « le modèle est devenu plus intelligent et plus cher » avec « mes comptes de support ont changé », et ce sont deux projets différents.
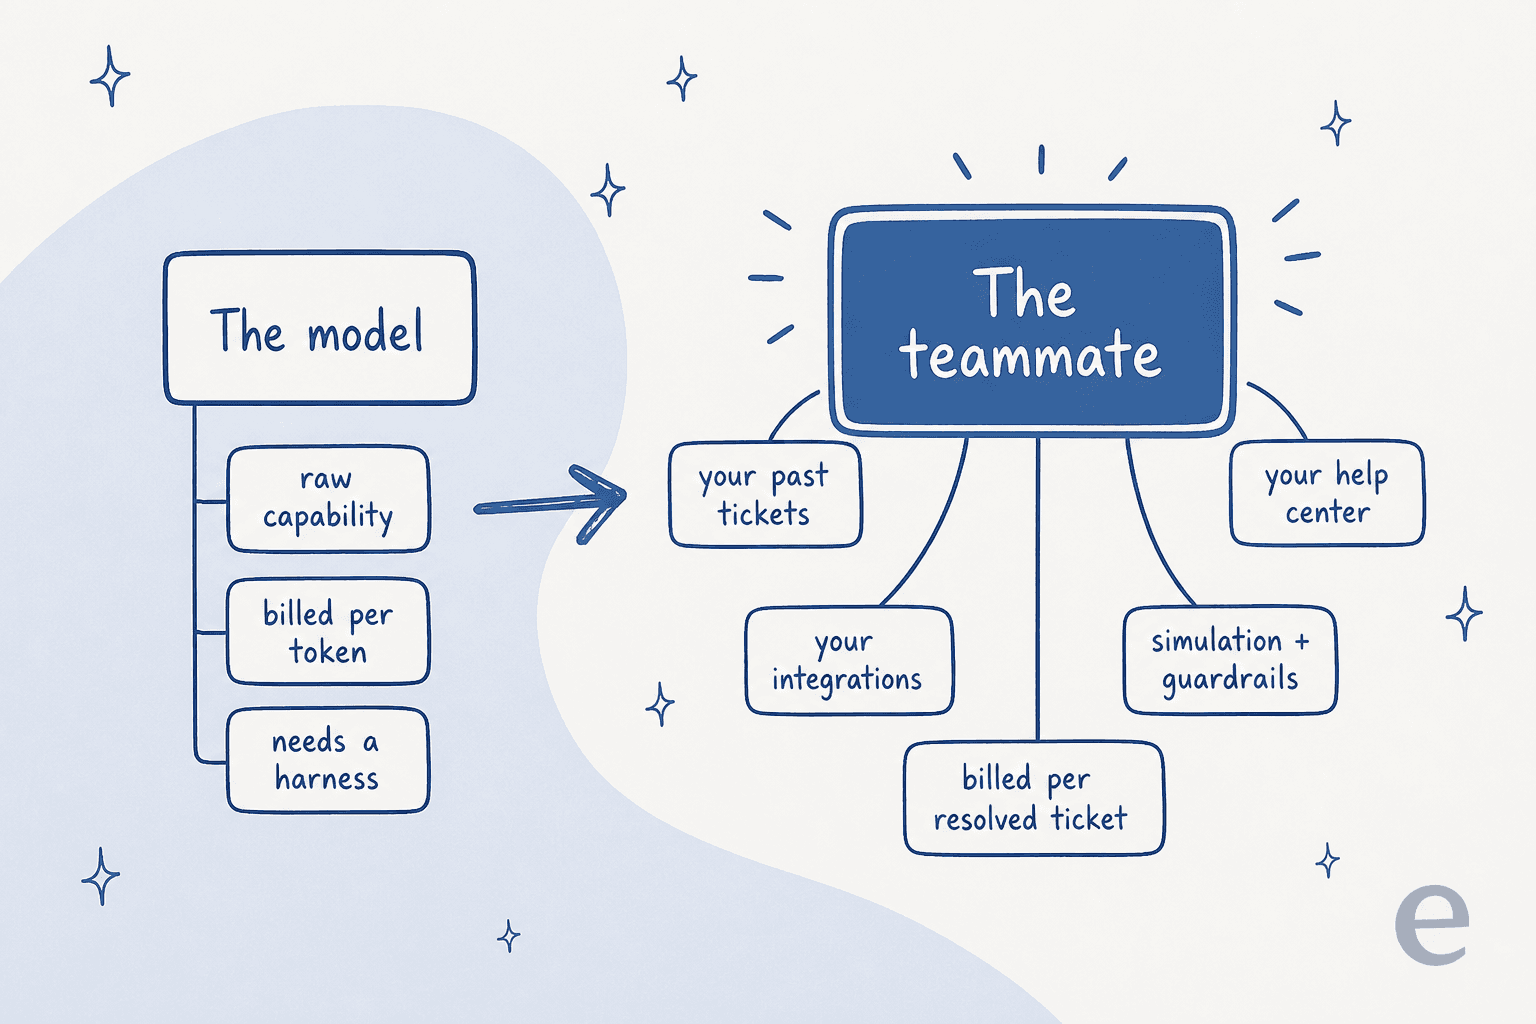
L'unité qui compte vraiment pour une équipe support est le coût par résolution, pas le coût par token. Une facture de tokens est imprévisible : elle varie selon la longueur des prompts, les relances, et à quel point le modèle est bavard un jour donné. Nous avons passé des années à déployer des agents IA sur des files de support en direct, et la leçon qui revient sans cesse est que les équipes veulent savoir ce que coûte le traitement d'un ticket, point final, pas ce que coûte un million de tokens de sortie avant même d'avoir déterminé combien de tokens un ticket consomme réellement. C'est l'écart entre un modèle et un système construit autour de lui : votre base de connaissances, vos intégrations, des actions sûres, et un moyen de le simuler sur votre historique avant la mise en production.
C'est aussi pourquoi je ne changerais pas de plateforme pour votre automatisation du support la semaine où un nouveau modèle sort. Les meilleurs agents de helpdesk IA et outils de service client sont conçus pour être flexibles vis-à-vis du modèle, si bien que lorsqu'un modèle réellement meilleur arrive, vous héritez de l'amélioration sans rien reconstruire, ni renégocier votre budget autour d'un nouveau tarif au token.
Essayez eesel
Si votre intérêt pour le prix d'Astra se résume en réalité à « combien va me coûter une IA pour vraiment résoudre des tickets », c'est exactement le rôle pour lequel un coéquipier IA est conçu, et c'est là qu'intervient eesel. GPT-6 Astra est le moteur ; eesel est l'employé que vous embauchez pour le conduire. L'agent de helpdesk IA s'entraîne sur vos tickets passés et votre centre d'aide, se branche sur le helpdesk que vous utilisez déjà plutôt que de le remplacer, et vous permet de le simuler sur des milliers de vos tickets historiques réels afin que vous voyiez précisément comment il va performer, et ce qu'il va coûter, avant qu'il ne touche une conversation en direct.
La facturation raconte l'histoire que le tarif au token d'Astra ne peut pas raconter. Au lieu de payer au token pour réfléchir, vous payez 40 cents par ticket réellement traité, sans frais par siège et sans minimum de plateforme, si bien que le coût suit les résultats plutôt que le bavardage du modèle. Vous pouvez commencer gratuitement avec $50 d'usage et sans carte bancaire, le pointer sur une partie de votre file, et voir les chiffres de résolution sur vos propres tickets, ce qui est bien plus utile pour décider que n'importe quel graphique de prix par million de tokens.

Le tarif de GPT-6 Astra est un vrai bond, et pour l'usage autonome d'ordinateur et le travail lié à la sécurité, la prime peut en valoir la peine. Mais pour la plupart des équipes support, le tarif au token n'a jamais été le chiffre qui comptait. Faire entrer un coéquipier testé, connecté et responsable dans votre flux de travail existant, facturé au résultat, voilà ce qui mérite votre budget.
Questions fréquentes
Combien coûte GPT-6 Astra sur l'API ?
Pourquoi les tarifs de GPT-6 Astra sont-ils plus élevés que ceux de GPT-5.6 Sol ?
GPT-6 Astra est-il disponible sur le palier gratuit ?
Qu'est-ce que le surcoût de contexte long de GPT-6 Astra ?
Combien coûte GPT-6 Astra sur ChatGPT ?
Que changent Batch, Flex et le mode Fast aux tarifs de GPT-6 Astra ?
GPT-6 Astra vs GPT-5.6 Sol côté tarifs : lequel utiliser ?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.