
En bref
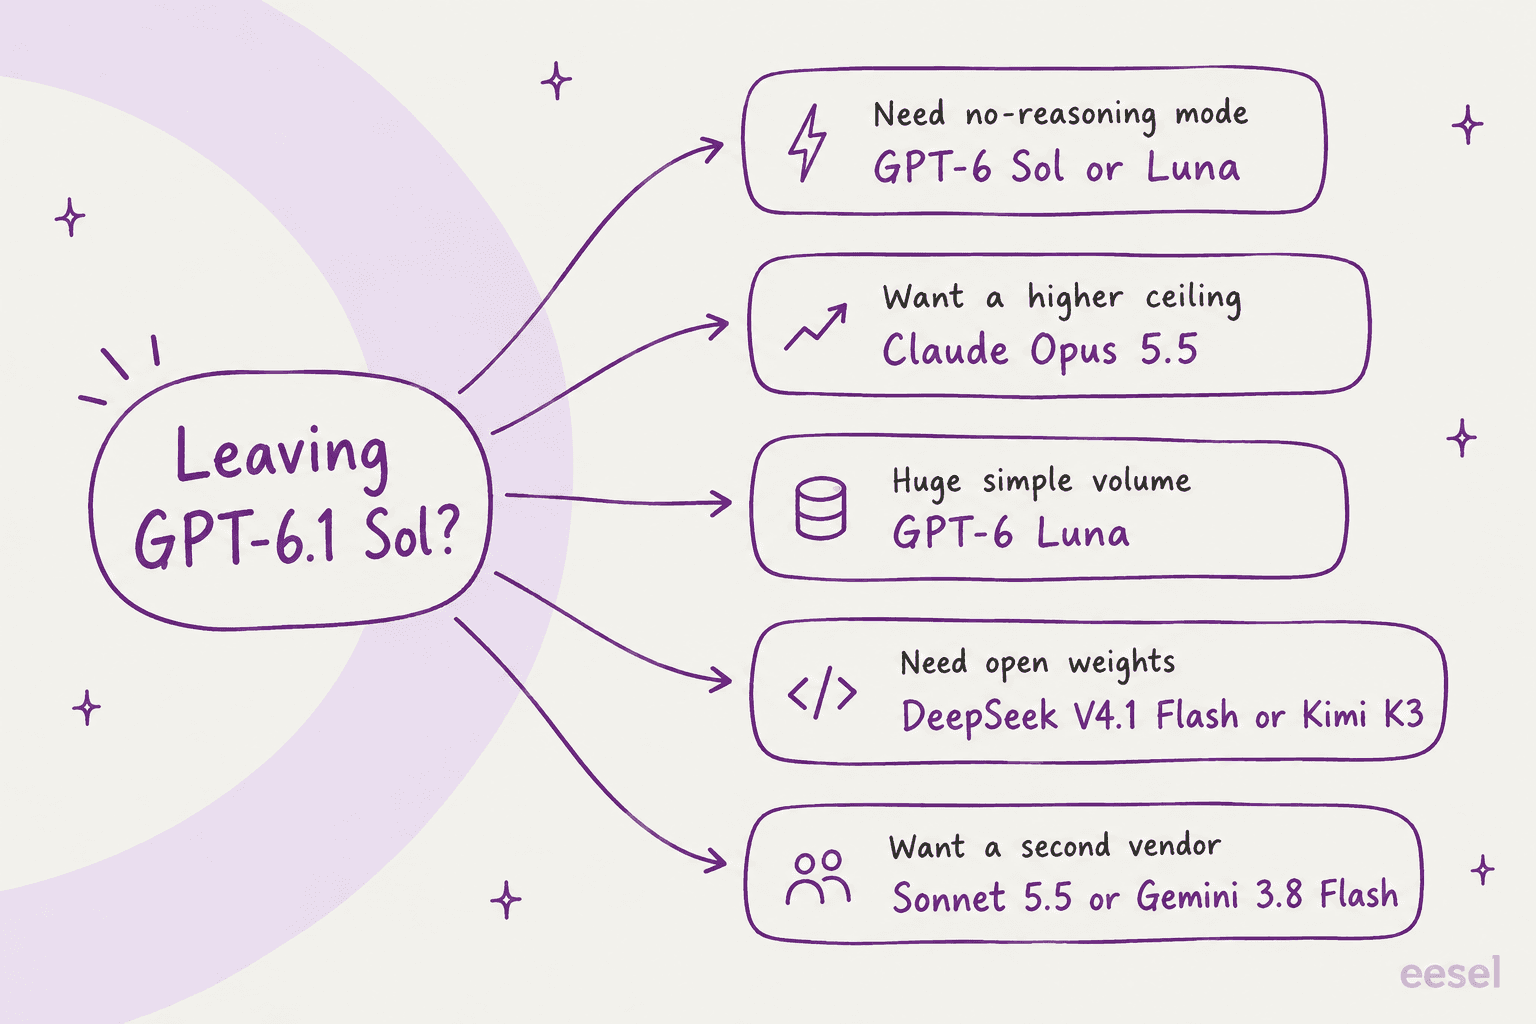
GPT-6.1 Sol est difficile à battre sur le prix. Il coûte 2 $/10 $ par million de tokens, et sur Artificial Analysis aucun modèle au score proche n'est moins cher par tâche (0,21 $ à effort moyen). Vous ne devriez donc changer que pour une raison précise, et il y en a cinq : vous avez besoin d'un mode sans raisonnement, vous voulez un plafond plus élevé, vous traitez d'énormes volumes de tâches simples, vous avez besoin de poids ouverts, ou vous voulez un second fournisseur.
Mes choix, en vitesse. Pour du travail simple de type support, GPT-6 Luna a réussi mes 15 tickets de test pour 0,11 $ les 1 000 tickets, soit environ 16 fois moins cher que 6.1 Sol. Si votre code repose sur l'effort none ou sur les appels d'outils de Chat Completions, l'ancien GPT-6 Sol est toujours disponible et prend toujours les deux en charge. Pour un plafond plus élevé, Claude Opus 5.5. Pour des poids ouverts, DeepSeek V4.1 Flash ou Kimi K3.
Je travaille chaque jour sur la file de support chez eesel, j'ai donc fait passer quatre de ces alternatives par le même test de 15 tickets que pour mon test de GPT-6.1 Sol. Le constat honnête : le choix du modèle a beaucoup fait varier la facture et très peu les réponses. Les échecs étaient des problèmes d'instructions et de passage de relais, c'est-à-dire la partie que gère un coéquipier IA de helpdesk comme eesel par-dessus le modèle que vous choisissez.
Pourquoi regarder au-delà de GPT-6.1 Sol
Je veux d'abord être juste envers 6.1 Sol. Il l'a mérité. OpenAI l'a lancé au DevDay le 29 septembre 2026, seulement sept jours après GPT-6 Sol, et il a remplacé l'ancien modèle dans la grille tarifaire principale d'OpenAI. Le tarif affiché est resté à 2 $/10 $. En revanche, l'entrée en cache est tombée à 0,10 $ par million, soit la moitié de ce que facturait GPT-6 Sol. Artificial Analysis lui donne 51,8 à effort max pour 0,72 $ la tâche, soit environ 1 point de moins que GPT-6 Astra pour 22 % du coût d'Astra.
C'est une position solide, et Artificial Analysis l'a dit assez franchement le jour du lancement :
"All effort levels of GPT-6.1 Sol push out the cost efficiency Pareto frontier: for a given level of intelligence, there is no cheaper model."
Alors pourquoi comparer malgré tout ? En lisant les fils de discussion du lancement et en faisant mes propres tests, trois raisons revenaient sans cesse.
Il a changé l'API sous vos pieds. 6.1 Sol n'accepte que les efforts low, medium, high, xhigh et max. J'ai essayé de lui envoyer none le 1er octobre et j'ai reçu : "Unsupported value: 'none' is not supported with the 'gpt-6.1-sol' model." L'appel de fonctions dans Chat Completions ne fonctionne qu'avec l'effort none, ce qui laisse à tout bot construit sur les appels d'outils de Chat Completions deux options : passer à l'API Responses, ou rester sur un modèle plus ancien.
Il est plus lent. Artificial Analysis a mesuré 67 tokens par seconde contre 76 pour GPT-6 Sol, et dans mon propre test il a pris 4,1 s par ticket à effort moyen contre 3,5 s pour l'ancien modèle. Cet écart semble faible. Il cesse de l'être quand un client attend la réponse.
C'est toujours un seul fournisseur, des poids fermés, pas d'offre gratuite. Si la conformité vous oblige à auto-héberger, ou si vous voulez simplement un second fournisseur, 6.1 Sol ne peut pas vous aider.
Quelqu'un sur Hacker News a repéré le changement d'API dès le premier jour :
"That seems likely, in the API GPT-6.1 Sol requires reasoning, just like Astra, whereas GPT-6 Sol (and Luna) allow "none""

À quoi ressemble vraiment le coût par tâche
Avant la liste, un graphique mérite un coup d'œil, car il change la façon de lire chaque tarif affiché ci-dessous. J'ai récupéré les pages de modèles d'Artificial Analysis pour chaque alternative le 1er octobre 2026, ce qui signifie que chaque score ici provient d'un seul indice, un seul jour. On mélange tout le temps des instantanés d'indice de semaines différentes et on finit par publier n'importe quoi. Je ne voulais pas faire ça.
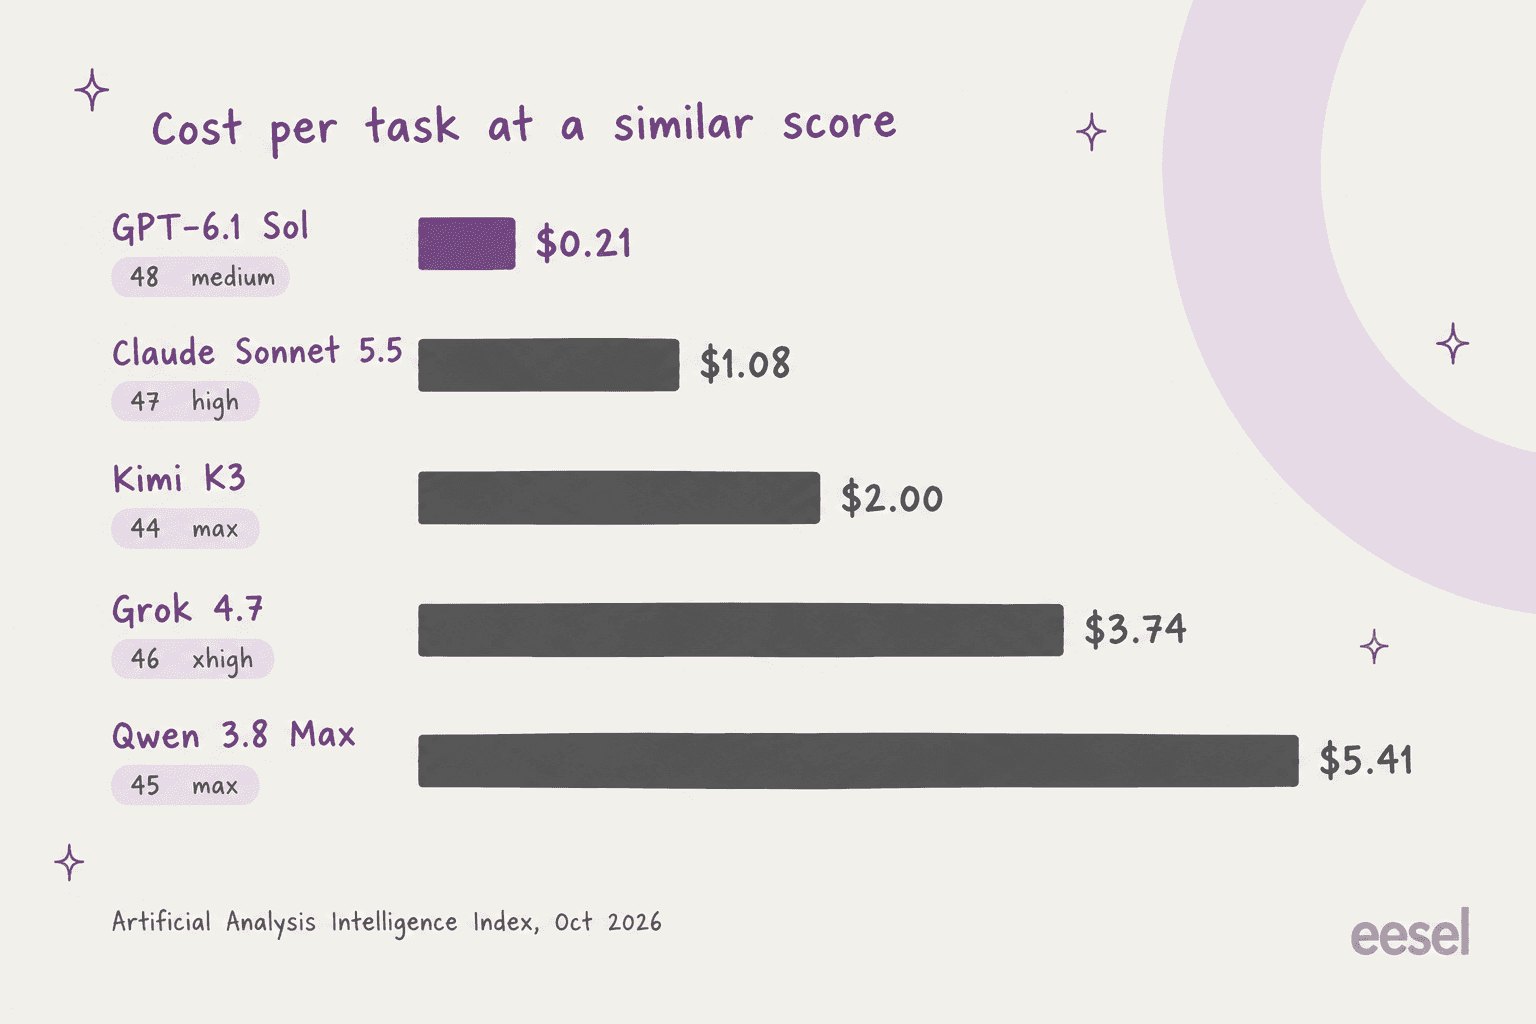
Chaque modèle de ce graphique obtient un score à moins de 4 points de 6.1 Sol à effort moyen. Chacun coûte de 5 à 26 fois plus cher par tâche. Prenez Grok 4.7. Son prix de sortie est inférieur à celui de Sol (6 $ contre 10 $), et pourtant il coûte 3,74 $ la tâche, car il écrit bien plus de tokens pour y arriver. Un commentateur de Hacker News a fait la même remarque sur les modèles chinois bon marché, avec plus de couleur que moi :
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens"
La question utile n'est donc pas « quel modèle est moins cher que Sol ». Par tâche, presque aucun. La meilleure question est « laquelle de mes cinq raisons s'applique à moi ».
Comment j'ai choisi et testé ces alternatives
Tous les modèles ici sont aujourd'hui en disponibilité générale sur une API publique. À partir de là, j'ai pesé quatre éléments : les vrais prix par token tirés de la page tarifaire de chaque éditeur, ainsi que le coût par tâche et le score du même instantané Artificial Analysis. J'ai aussi regardé si les poids sont ouverts, et dans quelle mesure chaque modèle correspond à une raison précise de quitter 6.1 Sol.
Ensuite, les quatre options les moins chères ou les plus pertinentes ont passé mon test de support. C'est le même banc que pour mon test de GPT-6.1 Sol : 15 tickets face à une courte politique de remboursement et de livraison pour une entreprise SaaS fictive, avec un outil de recherche de commande qui échoue parfois volontairement. Les tickets sont variés : délais de remboursement et calculs au prorata, une injection de prompt, un double prélèvement avec un client en colère, des demandes en espagnol et en allemand, un outil en panne, et un numéro de commande contenant une faute de frappe.
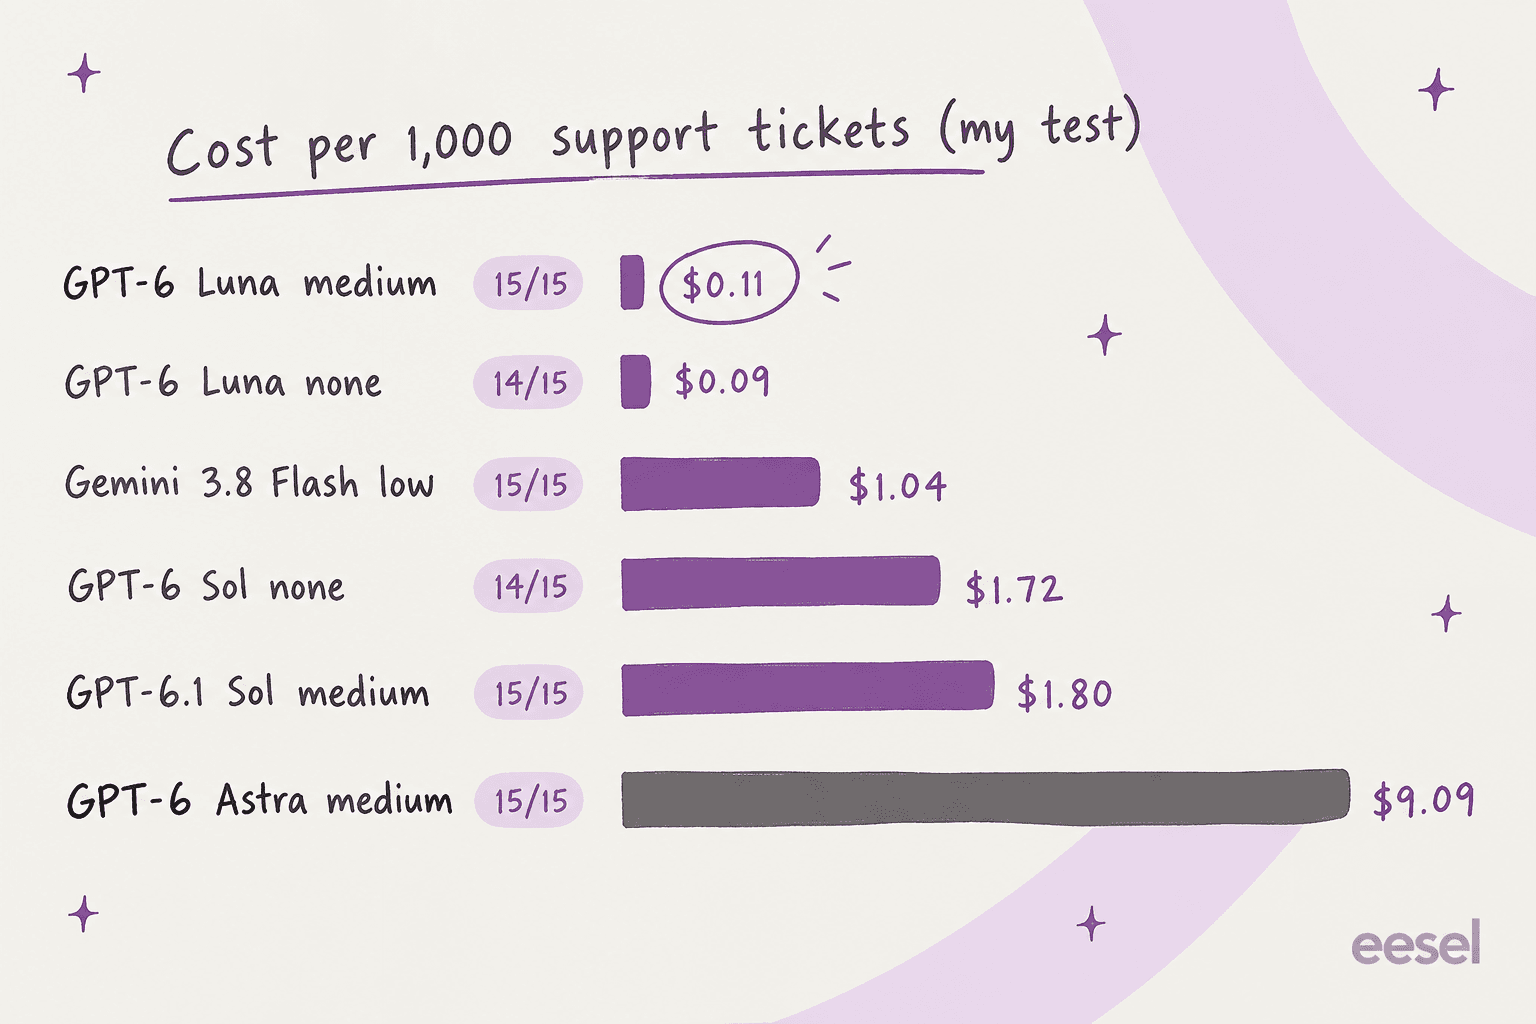
Deux choses m'ont surpris. D'abord, le modèle le moins cher de la gamme d'OpenAI a égalé le 15/15 de 6.1 Sol. Ensuite, les deux seuls échecs viennent des exécutions en effort none, et c'était le même ticket : le calcul de remboursement au prorata. Sans raisonnement, GPT-6 Sol comme GPT-6 Luna ont dit ne pas pouvoir calculer le montant et l'ont transmis à un humain. Pourtant, en passant Luna à l'effort medium, il est arrivé à 990 $, la bonne réponse.
Une réserve, parce que je la voudrais si j'étais à la place du lecteur : 15 tickets sur une politique propre, c'est un test petit et plutôt clément. Il montre que ces modèles savent suivre des règles et utiliser un outil. Il ne montre pas comment ils gèrent vos macros désordonnées, votre centre d'aide de 400 articles, ou un client qui écrit trois paragraphes sur autre chose avant d'en venir au fait.
Voici tout le panel côte à côte.
| Modèle | Meilleure raison de changer | Prix API (entrée / cache / sortie par 1M) | Score AA / coût par tâche | Contexte | Poids | Mon test |
|---|---|---|---|---|---|---|
| GPT-6.1 Sol (référence) | - | 2 $ / 0,10 $ / 10 $ | 47,8 / 0,21 $ (medium) | 1,05M | Fermés | 15/15, 1,80 $ les 1k |
| GPT-6 Luna | Énorme volume simple | 0,10 $ / 0,01 $ / 0,50 $ | 29,5 / 0,018 $ (medium) | 1,05M | Fermés | 15/15, 0,11 $ les 1k |
| GPT-6 Sol | Besoin de l'effort none | 2 $ / 0,20 $ / 10 $ | 39,8 / 0,25 $ (medium) | 1,05M | Fermés | 14/15, 1,72 $ les 1k |
| Claude Opus 5.5 | Plafond plus élevé | 4 $ / 0,20 $ / 20 $ | 57,6 / 5,98 $ (max) | 1M | Fermés | - |
| Claude Sonnet 5.5 | Second fournisseur, même prix | 2 $ / 0,20 $ / 10 $ | 46,7 / 1,08 $ (high) | 1M | Fermés | - |
| GPT-6 Astra | Ultrafast dès maintenant | 10 $ / 1 $ / 50 $ | 52,7 / 3,26 $ (max) | 1,05M | Fermés | 15/15, 9,09 $ les 1k |
| Gemini 3.8 Flash | Offre gratuite, écosystème Google | 0,75 $ / 0,075 $ / 3,75 $ | 40,9 / 1,24 $ (high) | 1M | Fermés | 15/15, 1,04 $ les 1k |
| Grok 4.7 | Tarif de sortie plus bas | 2 $ / 0,50 $ / 6 $ | 46,4 / 3,74 $ (xhigh) | 500K | Fermés | - |
| DeepSeek V4.1 Flash | Poids ouverts, MIT | 0,15 $ / 0,003 $ / 0,60 $ (heures creuses) | 39,5 / 0,27 $ (max) | 1M | Ouverts | - |
| Kimi K3 | Poids ouverts de pointe | 3 $ / 0,30 $ / 15 $ | 43,6 / 2,00 $ (max) | 1M | Ouverts | - |
Pourquoi quittez-vous GPT-6.1 Sol ?
Choisissez la raison qui vous correspond le mieux.
none et autorisent l'appel de fonctions dans Chat Completions. 6.1 Sol rejette les deux. Prévoyez quand même de passer à l'API Responses, car GPT-6 Sol a déjà été remplacé dans la grille tarifaire principale.1. GPT-6 Luna : celui que j'essaierais en premier pour le volume de support
Idéal pour : le travail à gros volume et basé sur des règles, comme les réponses aux tickets, l'étiquetage et le routage, où la vitesse et le coût comptent plus que le raisonnement de pointe.
Celui-ci a changé mon propre choix par défaut. GPT-6 Luna est le modèle GPT-6 le moins cher d'OpenAI, 0,10 $ en entrée et 0,50 $ en sortie par million de tokens, et à effort medium il a fait 15 sur 15 sur mes tickets de support. Il a consulté l'outil de commande et refusé l'injection de prompt. Sur le double prélèvement, il a cité la règle des 5 jours ouvrés au lieu de promettre « aujourd'hui ». Il a aussi répondu en espagnol et en allemand, puis calculé le remboursement au prorata de 990 $. L'ensemble a coûté 0,11 $ les 1 000 tickets, contre 1,80 $ pour 6.1 Sol à medium.
Rien de ce que j'ai testé n'était plus rapide : 3,0 s par ticket à effort medium et 2,3 s à none. Sa page de modèle indique la même fenêtre de contexte de 1 050 000 tokens que Sol, une date limite de connaissances en mai 2026, et toute la plage d'effort de none à max.
Là où Luna est en retrait, c'est sur l'indice Artificial Analysis, pas dans mon test. Luna obtient 29,5 à medium et 37,3 à max, contre 47,8 à medium pour 6.1 Sol. Mes tickets étaient courts et la politique bien rangée, cet écart n'a donc jamais eu l'occasion d'apparaître. Mettez Luna face à une base de connaissances plus brouillonne ou à une tâche d'agent en plusieurs étapes, et il apparaîtra.
Avantages : environ 16 fois moins cher que 6.1 Sol par ticket dans mon test ; réponses les plus rapides ; conserve l'effort none et les appels d'outils de Chat Completions ; même fenêtre de contexte.
Inconvénients : score bien plus bas en raisonnement difficile ; à l'effort none il a sauté le calcul au prorata ; poids fermés, un seul fournisseur.
Tarifs : 0,10 $ en entrée, 0,01 $ en cache, 0,50 $ en sortie par 1M de tokens ; Batch et Flex à -50 %. Détail complet dans tarifs de GPT-6 Luna.
Mon avis : pour une file de support, commencez avec Luna à effort medium et envoyez à 6.1 Sol tout ce qu'il escalade. L'essentiel de votre volume repose alors sur un modèle qui ne coûte presque rien, et vous ne payez le tarif de Sol que pour les tickets qui en ont vraiment besoin.
2. GPT-6 Sol : celui qui gère encore none
Idéal pour : les équipes dont le code de production dépend de l'effort none ou de l'appel de fonctions dans Chat Completions, et qui ont besoin d'un modèle équivalent le temps de migrer.
Pour certaines équipes, la meilleure alternative à 6.1 Sol est tout simplement le modèle qu'il a remplacé. GPT-6 Sol a disparu de la grille tarifaire principale, mais sa page de modèle est toujours en ligne, toujours à 2 $/10 $, et indique toujours "reasoning.effort supports none." Elle indique aussi "Chat Completions supports function calling only with reasoning_effort set to none," et c'est exactement la combinaison que 6.1 Sol a abandonnée. Quand j'ai consulté la page des dépréciations d'OpenAI le 1er octobre, aucune date d'arrêt n'était indiquée pour GPT-6 Sol.
Dans mon test à effort none, il a obtenu 14/15 à 1,72 $ les 1 000 tickets et 3,6 s par ticket, un peu plus rapide que 6.1 Sol. L'échec concernait le calcul au prorata : il a dit "the policy doesn't specify how to count unused full months" et a escaladé. C'est un échec sans danger plutôt qu'une mauvaise réponse. Mais c'est un ticket de plus qu'un humain doit désormais traiter.
Sur la qualité, 6.1 Sol l'emporte. Artificial Analysis donne 39,8 à GPT-6 Sol pour 0,25 $ la tâche à medium, contre 47,8 pour 0,21 $ avec 6.1 Sol. L'entrée en cache coûte aussi le double, à 0,20 $. Pour aller plus loin, le test de GPT-6 Sol de mon collègue détaille tout cela.
Avantages : conserve l'effort none ; le seul modèle GPT-6 à 2 $/10 $ avec appels d'outils Chat Completions ; aucun changement de code nécessaire.
Inconvénients : scores inférieurs à 6.1 Sol à chaque niveau d'effort ; l'entrée en cache coûte le double ; déjà remplacé dans la grille tarifaire, donc à considérer comme une solution de transition.
Tarifs : 2 $ en entrée, 0,20 $ en cache, 10 $ en sortie par 1M de tokens ; les prompts de plus de 272K tokens en entrée facturent toute la requête à 2x en entrée et 1,5x en sortie. Plus de détails dans tarifs de GPT-6 Sol.
Mon avis : ne restez sur GPT-6 Sol que le temps de migrer vos appels d'outils vers l'API Responses. Pour none sur le long terme, Luna est le choix le plus sûr. C'est le modèle bon marché actuel, pas celui qui a été remplacé.
3. Claude Opus 5.5 : un vrai cran de plafond en plus
Idéal pour : le code difficile et les longues tâches d'agent, quand les réponses de 6.1 Sol sont bonnes mais pas tout à fait suffisantes.
Vous quittez 6.1 Sol parce que vous voulez un modèle plus intelligent ? C'est alors vers Claude Opus 5.5 que je regarderais. Il obtient 57,6 à effort max sur Artificial Analysis, environ 6 points au-dessus du meilleur score de 6.1 Sol, et affiche 66,4 % sur Terminal-Bench 4.0 selon l'article de lancement d'Anthropic. C'est aussi le premier Opus à être moins cher que le précédent, à 4 $/20 $ par million.
Le piège, comme d'habitude, c'est le coût par tâche. À effort max, il revient à 5,98 $ la tâche, huit fois les 0,72 $ de 6.1 Sol à max. L'effort medium est la meilleure affaire : 51,2 pour 1,34 $, soit le score max de 6.1 Sol pour environ deux fois le prix. La comparaison GPT-6 Sol contre Opus 5.5 détaille ce calcul d'effort.
La plupart des retours pratiques que j'ai trouvés sur HN penchent pour Opus quand le code se complique :
"I've implemented multiple features side by side with Opus 5.5 and 6 Sol, and the Opus 5.5 results always have fewer high severity bugs and require fewer rounds of fixes to get it over the finish line."
Ce commentaire compare Opus à GPT-6 Sol, pas à 6.1, et le même fil dit que 6.1 comble une partie de l'écart. Cela correspond néanmoins à ce que me disent les ingénieurs ici.
Avantages : meilleur score de cette liste ; solide sur les benchmarks de terminal et de code ; lectures en cache à 0,20 $ ; contexte de 1M sans supplément pour contexte long.
Inconvénients : le plus cher par tâche à max ; excessif pour du simple chat ou de l'extraction ; un fournisseur de plus à gérer.
Tarifs : 4 $ en entrée, 0,20 $ en lecture de cache, 20 $ en sortie par 1M de tokens ; Batch à -50 %, selon la documentation tarifaire d'Anthropic. Voir tarifs de Claude Opus 5.5.
Mon avis : choisissez Opus 5.5 à effort medium quand 6.1 Sol rate sans cesse vos tâches les plus difficiles. Ne le laissez simplement pas sur max par défaut. Vous finiriez par payer des tokens dont vous n'aviez jamais besoin.
4. Claude Sonnet 5.5 : même tarif, autre fournisseur
Idéal pour : les équipes qui veulent un modèle à 2 $/10 $ d'un second laboratoire, surtout pour le code et le travail d'agent.
Claude Sonnet 5.5 est sorti le 28 septembre 2026, un jour avant 6.1 Sol, au même tarif de 2 $ en entrée et 10 $ en sortie. D'après les chiffres d'Anthropic eux-mêmes, il bat même Opus 5.5 sur Terminal-Bench 4.0 (70,6 % contre 66,4 %). Sur Artificial Analysis, il atteint 56,0 à effort max, bien au-dessus des 51,8 de 6.1 Sol.
C'est sur le coût par tâche qu'il faut être attentif. À effort max, Sonnet 5.5 coûte 7,60 $ la tâche, plus qu'Opus 5.5. À effort high, il obtient 46,7 pour 1,08 $, soit à peu près le score de 6.1 Sol à medium pour cinq fois le coût. Anthropic dit lui-même que les économies se trouvent à effort low. Le test de Sonnet 5.5 de mon collègue arrive à la même conclusion.
Les bots de support ont un piège supplémentaire ici. Sonnet 5.5 renvoie une erreur 400 sur un tool_choice forcé (n'importe quel outil ou un outil nommé), donc un bot qui force une recherche de commande sur chaque ticket doit être réécrit. C'est le même genre de changement cassant qui pousse les gens hors de 6.1 Sol, mais à un autre endroit.
Dans le fil sur 6.1 Sol, certains développeurs pensent qu'Anthropic a pris de l'avance cette fois :
"I suspect they didn't show the benchmarks and test results because it would have been embarrassing to reveal that their flagship model can't compete with the capabilities of Sonnet 5.5."
Avantages : même tarif de 2 $/10 $ chez un second fournisseur ; score maximal supérieur à 6.1 Sol ; très solide en code de terminal ; contexte de 1M.
Inconvénients : bien plus cher par tâche à scores égaux ; le choix d'outil forcé renvoie désormais une erreur ; l'effort max peut consommer d'énormes quantités de tokens.
Tarifs : 2 $ en entrée, 0,20 $ en lecture de cache, 10 $ en sortie par 1M de tokens ; Batch 1 $/5 $. Voir tarifs de Claude Sonnet 5.5.
Mon avis : Sonnet 5.5 est le bon choix si vous voulez un second fournisseur pour le code et que vous gardez l'effort à low ou medium. Si vous faites des réponses de support à volume, 6.1 Sol ou Luna coûteront moins cher par ticket.
5. GPT-6 Astra : seulement si vous avez besoin d'Ultrafast maintenant
Idéal pour : les équipes déjà chez OpenAI qui ont besoin du mode de génération le plus rapide dès aujourd'hui, ou du dernier point de score.
GPT-6 Astra est le modèle phare d'OpenAI. Le problème, c'est que 6.1 Sol a rendu sa justification difficile. Artificial Analysis donne à Astra 52,7 pour 3,26 $ la tâche, contre 51,8 pour 0,72 $ avec 6.1 Sol. Dans mon test de support, Astra a égalé le 15/15 de 6.1 Sol à cinq fois le coût, 9,09 $ les 1 000 tickets contre 1,80 $. Il était aussi plus lent, à 5,2 s par ticket.
Ce mois-ci, il n'y a vraiment qu'une raison de le choisir, et c'est Ultrafast. La page tarifaire d'OpenAI ne liste des tarifs Ultrafast que pour Astra, à 60 $ en entrée et 300 $ en sortie par million, avec 6.1 Sol "coming soon." Besoin de ce palier de vitesse tout de suite ? Astra est le seul modèle GPT-6 à l'avoir.
Avantages : meilleur score d'OpenAI ; Ultrafast disponible maintenant ; plus faible taux d'hallucination de la famille GPT-6 sur AA.
Inconvénients : environ 4,5 fois le coût par tâche de 6.1 Sol pour 1 point de plus ; plus lent dans mon test ; Ultrafast est très cher.
Tarifs : 10 $ en entrée, 1 $ en cache, 50 $ en sortie par 1M de tokens ; Batch et Flex à -50 %. Voir tarifs de GPT-6 Astra.
Mon avis : pour la plupart des équipes, 6.1 Sol a remplacé Astra, et non l'inverse. Je garderais Astra pour les rares tâches où un point de plus compte, ou quand attendre qu'Ultrafast arrive sur Sol n'est pas envisageable.
6. Gemini 3.8 Flash : l'option Google avec offre gratuite
Idéal pour : les équipes dans l'écosystème Google Cloud, les prototypes sur l'offre gratuite et les traitements par lots où le prix par token compte.
Gemini 3.8 Flash a réussi mon test 15/15 à effort low pour 1,04 $ les 1 000 tickets, et il a trouvé le 990 $ au prorata en montrant son calcul. Les réponses ont pris en moyenne 3,0 s. C'est aussi lui qui a utilisé le plus de mise en forme de tout ce que j'ai testé. Une réponse de statut de commande qui demandait deux lignes est revenue avec des listes à puces et des libellés en gras.
Côté prix, lisez les petites lignes. La page tarifaire de Gemini indique 0,75 $ en entrée et 3,75 $ en sortie "through December 31, 2026," puis 1,50 $ et 7,50 $ à partir du 1er janvier 2027. Les acheteurs se souviennent de ce genre de doublement. Lors d'un appel commercial avec eesel, un acheteur soucieux de son budget a dit que le prix d'un fournisseur précédent avait "more than doubled" et a demandé un gel de prix contractuel avant toute autre chose.
Sur Artificial Analysis, Gemini 3.8 Flash à effort high obtient 40,9 pour 1,24 $ la tâche, en dessous de 6.1 Sol et à six fois son coût par tâche. Ce n'est pas non plus un nouveau modèle de base. La fiche de modèle de Google indique qu'il est basé sur Gemini 3.7 Flash.
Avantages : offre gratuite ; a réussi mon test avec des calculs corrects ; bon débit ; Batch et Flex à -50 %.
Inconvénients : le prix double le 1er janvier 2027 ; plus cher par tâche que 6.1 Sol sur AA ; réponses verbeuses.
Tarifs : 0,75 $ en entrée, 0,075 $ en lecture de cache, 3,75 $ en sortie par 1M de tokens jusqu'au 31 décembre 2026, puis 1,50 $/0,15 $/7,50 $. Voir tarifs de Gemini 3.8 Flash.
Mon avis : si vous êtes déjà sur Google Cloud, c'est un second fournisseur raisonnable. Calculez-le au tarif de 2027, pas au tarif actuel, pour que la facture ne vous surprenne pas en janvier.
7. Grok 4.7 : tarif de sortie plus bas, pas des tâches moins chères
Idéal pour : les boucles d'agent qui restent sous 200K tokens par requête et les équipes qui construisent déjà sur xAI.
Grok 4.7 affiche un tarif qui ressemble, au premier regard, à un tueur de Sol : 2 $ en entrée et 6 $ en sortie par million, 40 % sous le tarif de sortie de Sol, d'après la page des modèles de xAI. Il repose sur un modèle de base plus grand que Grok 4.6, avec un entraînement plus long visant des tâches d'agent de plusieurs heures, et sa date limite de connaissances est mai 2026.
Le graphique du coût par tâche dit autre chose. Artificial Analysis donne à Grok 4.7 à effort xhigh un score de 46,4 pour 3,74 $ la tâche, un score légèrement inférieur à 6.1 Sol à medium pour environ 18 fois le coût. La raison est simple : il écrit beaucoup de tokens. Surveillez aussi la tarification du contexte long : au-delà de 200K tokens de prompt, le tarif passe à 4 $/12 $ pour chaque token de la requête, pas seulement pour le dépassement.
Avantages : tarif de sortie inférieur à Sol ; gros gains agentiques par rapport à Grok 4.6 ; contexte de 500K ; un outil Grok Build gratuit pour le code.
Inconvénients : coût par tâche bien supérieur à 6.1 Sol sur AA ; falaise du contexte long à 200K ; Grok 4.7 Fast n'est que dans Cursor et Grok Build, pas dans l'API publique.
Tarifs : 2 $ en entrée, 0,50 $ en cache, 6 $ en sortie par 1M de tokens sous 200K ; 4 $/1 $/12 $ au-dessus. Voir le test de Grok 4.7 pour des notes pratiques.
Mon avis : Grok 4.7 a du sens si vous vivez déjà dans les outils de xAI. Mais si le tarif de sortie plus bas est votre seule raison, faites d'abord votre propre test de coût par tâche. Sur l'indice, le résultat va dans l'autre sens.
8. DeepSeek V4.1 Flash : poids ouverts et facture minuscule
Idéal pour : les équipes qui ont besoin de poids sous licence MIT à auto-héberger, ou du prix d'API le plus bas pour du travail en arrière-plan.
DeepSeek V4.1 Flash est le modèle capable le moins cher de cette liste et le plus facile à posséder pleinement. Les poids sont sur Hugging Face sous licence MIT. L'API utilise le nom de modèle deepseek-flash, et l'ancien nom deepseek-v4-flash pointe désormais vers V4.1. Il prend en charge la vision, les appels d'outils, une fenêtre de contexte de 1M et jusqu'à 384K tokens en sortie, selon la page tarifaire de DeepSeek.
Il y a une particularité de fuseau horaire dans la tarification. En heures creuses, c'est 0,15 $ en entrée et 0,60 $ en sortie par million ; en heures de pointe, exactement le double. Les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine, donc une file de support américaine est surtout facturée au tarif creux, et une file aux heures de l'Asie, plutôt pas.
Par tâche, il est plus proche de 6.1 Sol que ne le laisse penser le tarif affiché. Artificial Analysis donne à V4.1 Flash à effort max un score de 39,5 pour 0,27 $ la tâche, contre 47,8 pour 0,21 $ avec 6.1 Sol à medium. Si des données clients sont concernées, vérifiez aussi où il s'exécute : l'API de DeepSeek est hébergée en Chine et ses conditions d'utilisation ne disent rien sur l'usage pour l'entraînement, de sorte que beaucoup d'équipes auto-hébergent ou passent par un hébergeur tiers avec un accord sur les données.
Avantages : poids ouverts MIT ; prix d'API par token le plus bas ici ; accepte désormais les images ; contexte de 1M.
Inconvénients : score inférieur à 6.1 Sol et coût par tâche légèrement plus élevé ; tarification aux heures de pointe ; l'hébergement par l'éditeur est difficile à défendre pour des données clients.
Tarifs : 0,003 $ en cache, 0,15 $ en entrée, 0,60 $ en sortie par 1M de tokens en heures creuses ; le double en heures de pointe. Voir tarifs de DeepSeek V4.1 Flash.
Mon avis : choisissez V4.1 Flash pour l'auto-hébergement ou le traitement par lots de nuit. Comme remplaçant direct de 6.1 Sol sur un bot interactif, en revanche, il ne vous fera pas économiser par tâche.
9. Kimi K3 : poids ouverts de pointe
Idéal pour : les équipes qui ont besoin du modèle à poids ouverts le plus puissant qu'elles puissent télécharger et exécuter.
Kimi K3 de Moonshot AI est un modèle à mélange d'experts de 2,8 billions de paramètres dont 104B actifs, avec une fenêtre de contexte de 1M et la vision native. Les poids complets sont sur Hugging Face sous une licence personnalisée, vous pouvez donc l'exécuter vous-même, si vous avez le matériel pour cela.
Sur l'API hébergée, c'est 3 $ en entrée, 0,30 $ en cache et 15 $ en sortie par million, selon la page tarifaire de Kimi. C'est plus que Sol en entrée comme en sortie. Artificial Analysis lui donne 43,6 à effort max pour 2,00 $ la tâche. Le raisonnement ne peut être désactivé à aucun niveau, ce qui fait de son réglage le plus bas un contrôle de vitesse plutôt qu'un palier moins cher.
Avantages : poids téléchargeables les plus puissants de cette liste ; contexte de 1M ; entrée image et vidéo.
Inconvénients : l'API hébergée coûte plus cher que 6.1 Sol par token et par tâche ; licence personnalisée, ni MIT ni Apache ; le raisonnement est toujours activé.
Tarifs : 3 $ en entrée, 0,30 $ en cache, 15 $ en sortie par 1M de tokens. Voir tarifs de Kimi K3.
Mon avis : Kimi K3 est un choix d'auto-hébergement. Si vous voulez seulement une API hébergée, 6.1 Sol est moins cher et obtient un meilleur score.
Ce que mon test dit sur le changement de modèle pour le support
C'est la partie à laquelle je reviens sans cesse. Sur 135 exécutions et neuf configurations, de 0,09 $ à 9,09 $ les 1 000 tickets, les échecs étaient du même type à chaque fois. Chaque configuration, Astra compris, a escaladé le numéro de commande contenant une faute de frappe ("A1O43") au lieu de demander au client de le vérifier. Les exécutions none ont renoncé à des calculs qu'elles auraient pu faire. Monter d'un cran n'a rien réglé. Ce qui règle le problème (ou l'aurait réglé), c'est une ligne dans les instructions, plus des tests sur de vrais tickets.
Cela correspond à ce que j'entends des acheteurs. Un responsable CX traitant environ 7 000 tickets par mois a dit à l'équipe eesel lors d'un appel commercial que l'IA ne devrait répondre qu'aux tickets dont elle est sûre et laisser discrètement les autres aux humains. C'est une règle de passage de relais, pas une fonctionnalité du modèle. Vous définissez cette règle dans la couche autour du modèle, puis vous la vérifiez sur votre propre historique avant qu'un client ne la voie.
Donc si vous remplacez 6.1 Sol par Luna pour économiser sur une file de support, je pense que c'est un choix judicieux. Testez-le d'abord sur vos anciens tickets, cependant, et gardez un chemin clair vers un humain pour tout ce dont il n'est pas sûr. Le guide sur l'escalade par IA explique comment la mettre en place.
Essayer eesel

Si vous comparez les alternatives à GPT-6.1 Sol parce que vous voulez automatiser le support, le modèle est le moteur, et eesel est le coéquipier que vous embauchez pour le conduire. L'agent IA de helpdesk rejoint votre file existante dans Zendesk, Freshdesk ou Gorgias, apprend de votre centre d'aide et de vos anciens tickets, et lance une simulation sur l'historique de vos tickets pour que vous voyiez ses réponses et son taux de résolution avant qu'il ne réponde à qui que ce soit. Cette erreur de numéro de commande de mon test ? C'est exactement le genre de lacune que la simulation détecte.
Si vous travaillez depuis un terminal, la CLI eesel pilote le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez scripter un test sur un lot d'anciens tickets, récupérer les résultats dans vos propres outils, ou laisser un agent de code comme Claude Code, Codex ou Cursor gérer la configuration pour vous. C'est le même coéquipier dans les deux cas, simplement sans interface. Vous pouvez essayer eesel gratuitement et le lancer sur vos propres tickets avant de choisir un modèle ou une offre.
Questions fréquentes
Quelle est la meilleure alternative à GPT-6.1 Sol en 2026 ?
Existe-t-il une alternative moins chère à GPT-6.1 Sol ?
Pourquoi GPT-6.1 Sol a-t-il supprimé l'effort de raisonnement none ?
none renvoie une erreur. GPT-6 Sol et GPT-6 Luna prennent toujours en charge none, et ce sont les seuls modèles GPT-6 qui autorisent l'appel de fonctions dans Chat Completions. Mon test de GPT-6.1 Sol détaille les changements d'API.GPT-6.1 Sol est-il meilleur que Claude Sonnet 5.5 ?
Quelle est une bonne alternative à poids ouverts à GPT-6.1 Sol ?
Dois-je passer de GPT-6.1 Sol à GPT-6 Astra ?
Les alternatives à GPT-6.1 Sol fonctionnent-elles pour le support client ?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.