
En bref
GPT-6.1 Sol coûte 2 $ par million de tokens d'entrée et 10 $ par million de tokens de sortie sur l'API standard, soit le même prix affiché que GPT-6 Sol, qu'il a remplacé au bout de sept jours. La seule ligne qui a bougé est l'entrée en cache, divisée par deux à 0,10 $ par million. Batch et Flex tournent à 1 $/5 $, le mode Fast à 4 $/20 $, et tout prompt de plus de 272K tokens retarife toute la requête à 4 $/15 $.
Le prix affiché est le chiffre le moins utile ici. Ce qui fixe vraiment votre facture, c'est la part de chaque prompt qui vient du cache (à 80 % en cache, l'entrée revient en pratique à 0,48 $, pas à 2 $) et le nombre de tokens de raisonnement qu'une tâche consomme. Sur les exécutions d'Artificial Analysis, GPT-6.1 Sol coûte 0,72 $ par tâche à effort maximal contre 3,26 $ pour GPT-6 Astra, et 0,39 $ à xhigh pour un score presque identique.
Dans ChatGPT, il démarre avec l'offre Plus à 20 $, et Free et Go n'y ont pas accès. Si ce que vous cherchez vraiment à chiffrer, c'est « ce que l'IA coûtera par ticket », un prix par token est la mauvaise unité. eesel vend le coéquipier IA de helpdesk avec un forfait mensuel fixe de crédits.
Les tarifs de GPT-6.1 Sol en un coup d'œil
GPT-6.1 Sol a été lancé lors du DevDay d'OpenAI le 29 septembre 2026, et sur la page tarifaire de l'API, il a simplement repris la ligne de GPT-6 Sol. Je construis des intégrations chez eesel. À chaque sortie de modèle, c'est moi qui finis par refaire le même tableur de coûts pour un client, alors cette fois j'ai simplement transformé le tableur en article.
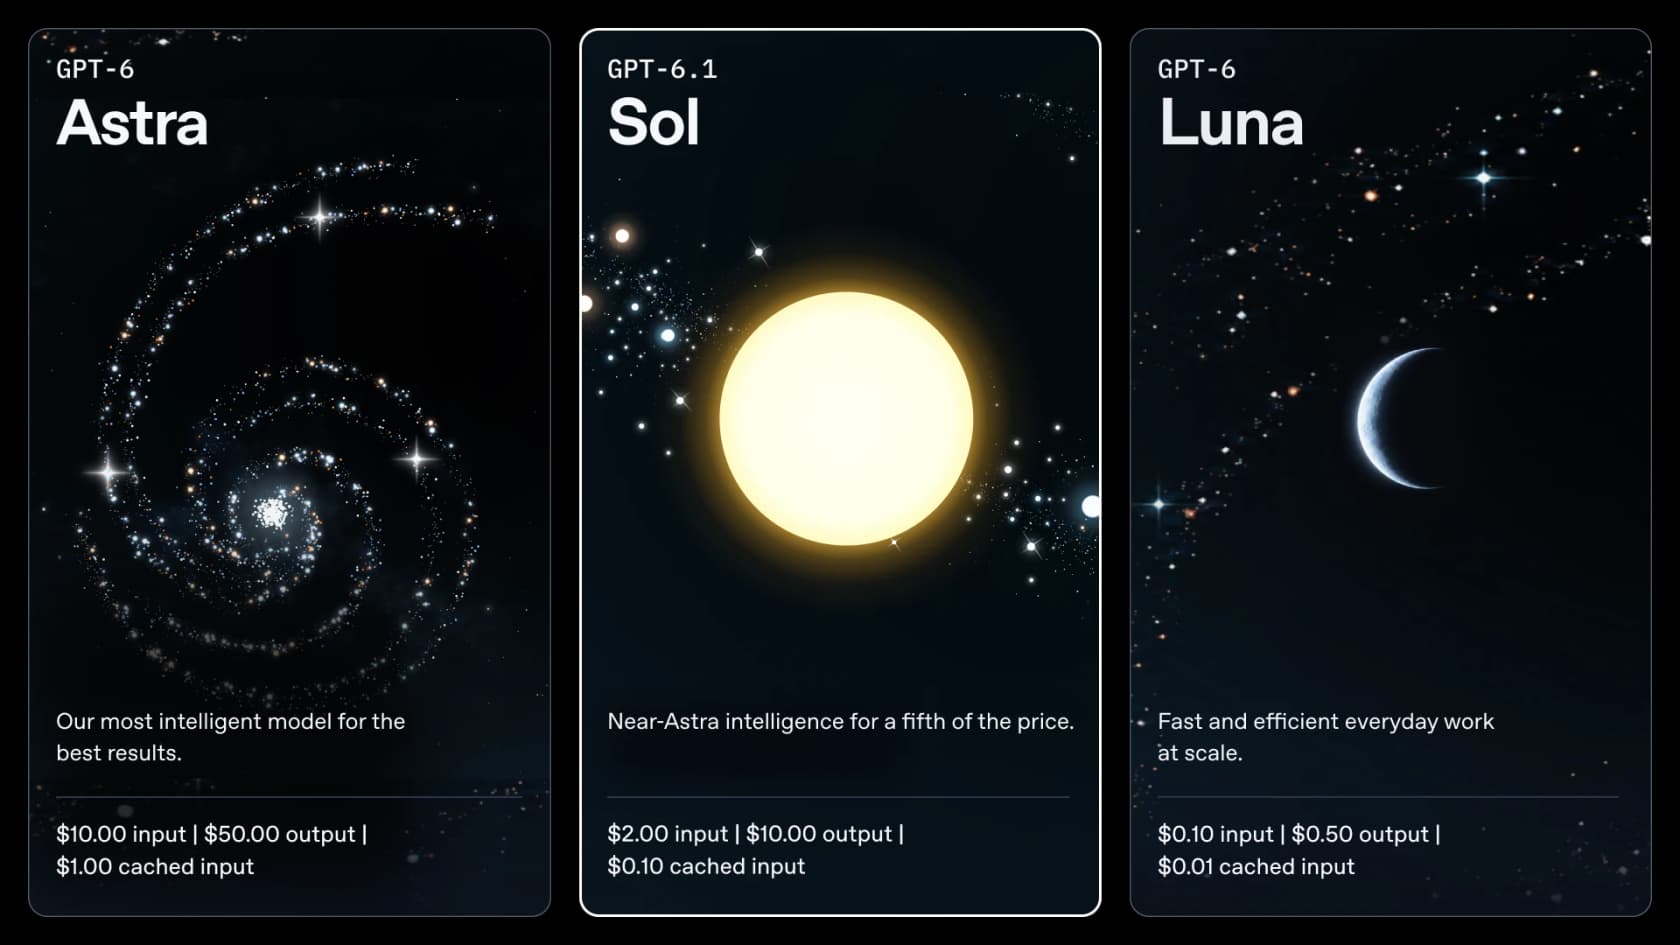
Voici la grille complète du niveau standard, avec les deux tranches de contexte :
| Niveau standard (par 1M de tokens) | Contexte court (jusqu'à 272K en entrée) | Contexte long (plus de 272K en entrée) |
|---|---|---|
| Entrée | 2,00 $ | 4,00 $ |
| Entrée en cache | 0,10 $ | 0,20 $ |
| Écritures en cache | 2,50 $ | 5,00 $ |
| Sortie (raisonnement inclus) | 10,00 $ | 15,00 $ |
Source : tarifs de l'API OpenAI, revérifiés le 1er octobre 2026. La page du modèle détaille les ratios derrière ces chiffres : l'entrée en cache vaut 5 % du tarif sans cache, les écritures en cache valent 1,25x, et les longs prompts coûtent "2x input and cache rates and 1.5x output for the full request."
C'est le modèle intermédiaire de la gamme de modèles OpenAI, et quelques détails techniques comptent dès qu'on établit un budget. L'identifiant du modèle est gpt-6.1-sol, avec une fenêtre de contexte de 1 050 000 tokens et 128 000 tokens de sortie maximum. L'API n'a pas d'offre gratuite : le Tier 1 (500 requêtes et 500 000 tokens par minute) est donc le minimum.
Ce qui change par rapport aux tarifs de GPT-6 Sol
Sur le papier, presque rien. Voici toute la différence :
| Poste | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| Entrée (par 1M) | 2,00 $ | 2,00 $ |
| Entrée en cache | 0,20 $ | 0,10 $ |
| Sortie | 10,00 $ | 10,00 $ |
| Effort de raisonnement le plus bas | none | low |
| Tokens de sortie par tâche (AA, max) | 31,1K | 38,1K |
| Coût par tâche (AA, max) | 1,05 $ | 0,72 $ |
Sources : tarifs de l'API OpenAI, Artificial Analysis. L'article sur les tarifs de GPT-6 Sol couvre le tableau complet de la semaine dernière.
Deux de ces chiffres tirent dans des sens opposés. GPT-6.1 Sol écrit plus de sortie. Artificial Analysis a mesuré "~10-30% more output tokens than GPT-6 Sol" selon les niveaux d'effort. Pourtant, il revient 31 % moins cher par tâche à effort maximal, car il termine le travail avec moins d'exécutions ratées, et son entrée en cache coûte moitié moins. La parité par token n'est pas la parité par tâche. Ici, au moins, le chiffre par tâche a évolué en votre faveur.
Le changement qui peut vraiment faire monter une facture est le plancher de raisonnement. GPT-6 Sol permettait de tourner avec l'effort none, ce qui voulait dire zéro token de raisonnement. Sur 6.1 Sol, la page du modèle indique que none et minimal "are not supported", donc low est le réglage le moins cher. Si vous aviez un classifieur à gros volume sur none, il facturera désormais un peu de sortie de raisonnement à chaque appel : je le testerais avant de changer l'identifiant du modèle.
La baisse de l'entrée en cache est le vrai changement de prix
C'est la partie des tarifs de GPT-6.1 Sol qui aurait dû faire la une, et les gens du fil de discussion du jour du lancement l'ont repérée tout de suite :
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

La raison est simple. Les agents renvoient le même contenu à chaque appel : le prompt système, les définitions d'outils, et un historique de conversation qui ne cesse de grandir. Ce préfixe répété est mis en cache. Pour un agent qui tourne longtemps, la majeure partie de l'entrée est alors facturée au tarif du cache plutôt qu'au prix affiché de 2 $. Votre prix d'entrée réel est donc un mélange, et ce mélange dépend surtout de votre taux de réussite du cache.
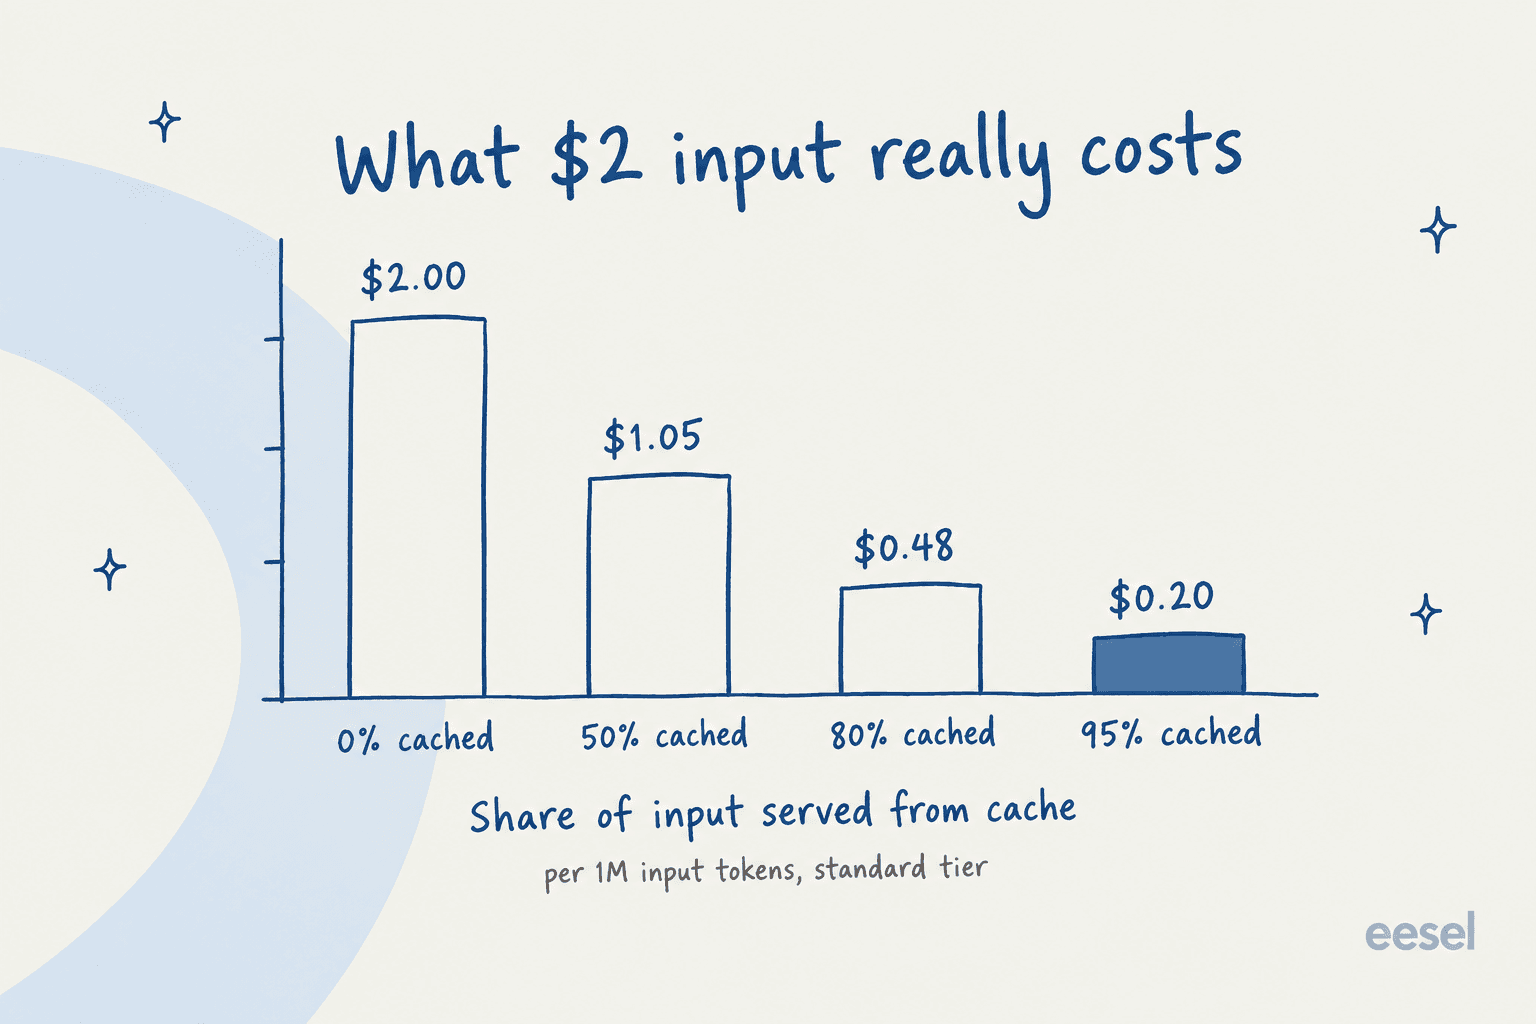
Faites le même calcul sur toute la famille et vous voyez de combien la baisse du cache a élargi l'écart avec le modèle phare :
| Part de l'entrée en cache | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 0 % | 2,00 $ | 2,00 $ | 10,00 $ |
| 50 % | 1,05 $ | 1,10 $ | 5,50 $ |
| 80 % | 0,48 $ | 0,56 $ | 2,80 $ |
| 95 % | 0,20 $ | 0,29 $ | 1,45 $ |
Prix d'entrée effectif par 1M de tokens, niveau standard, calculé à partir de la grille d'OpenAI. Avec 80 % de réussite du cache, l'entrée de GPT-6.1 Sol coûte environ un sixième de celle d'Astra, et l'article sur les tarifs de GPT-6 Astra donne la grille complète du modèle phare. Deux réserves, cependant. Les écritures en cache coûtent 2,50 $ par million, soit 1,25x le tarif d'entrée normal : le premier appel qui stocke un préfixe coûte donc un peu plus qu'un appel sans cache. De plus, le cache n'aide que tant que le préfixe reste identique à l'octet près. Mettez un horodatage en haut de votre prompt système et la remise tombe discrètement à zéro.
Niveaux de service : Batch, Flex, Fast et l'Ultrafast manquant
Un seul modèle, quatre prix, et le niveau que vous choisissez fait plus bouger la facture que n'importe quel ajustement de prompt :
| Niveau (par 1M, contexte court) | Entrée | Entrée en cache | Écritures en cache | Sortie | Entrée / sortie en contexte long |
|---|---|---|---|---|---|
| Batch | 1,00 $ | 0,05 $ | 1,25 $ | 5,00 $ | 2,00 $ / 7,50 $ |
| Flex | 1,00 $ | 0,05 $ | 1,25 $ | 5,00 $ | 2,00 $ / 7,50 $ |
| Standard | 2,00 $ | 0,10 $ | 2,50 $ | 10,00 $ | 4,00 $ / 15,00 $ |
| Fast | 4,00 $ | 0,20 $ | 5,00 $ | 20,00 $ | 8,00 $ / 30,00 $ |
| Ultrafast | Bientôt disponible |
Source : tarifs de l'API OpenAI. Ce que chacun signifie en pratique :
- Batch et Flex coûtent tous deux la moitié du standard. Batch sert aux tâches que vous soumettez et récupérez plus tard ; Flex sert aux requêtes que vous acceptez de laisser tourner plus lentement. Si une tâche n'a pas besoin de réponse en quelques secondes, c'est sa place.
- Fast double le prix pour une latence plus faible. La page tarifaire précise que le traitement prioritaire "was renamed Fast mode on July 30, 2026."
- Ultrafast n'est pas encore disponible pour Sol. Le récapitulatif du DevDay indique "GPT-6.1 Sol Ultrafast is coming soon." Aujourd'hui, seul GPT-6 Astra a un tarif Ultrafast, à 60 $/300 $ par million.
- La résidence des données ajoute 10 %. Les points de terminaison de traitement régionaux appliquent une majoration de 10 % pour les modèles sortis après le 5 mars 2026, et la page du modèle ajoute que le mode Fast n'est pas disponible avec la résidence des données dans l'UE.
C'est en les combinant que les économies s'accumulent vraiment. Une tâche pouvant passer en batch avec un gros préfixe en cache tourne à 1 $ en entrée, 0,05 $ en cache et 5 $ en sortie. Comparé au tarif standard d'Astra, cela fait déjà 90 % de baisse sur la sortie.
Le seuil des 272K
La règle du long contexte est la ligne de la grille la plus facile à manquer. C'est aussi la plus coûteuse quand on la franchit. Quand un prompt dépasse 272K tokens d'entrée, toute la requête est facturée au tarif long, pas seulement les tokens au-delà du seuil.
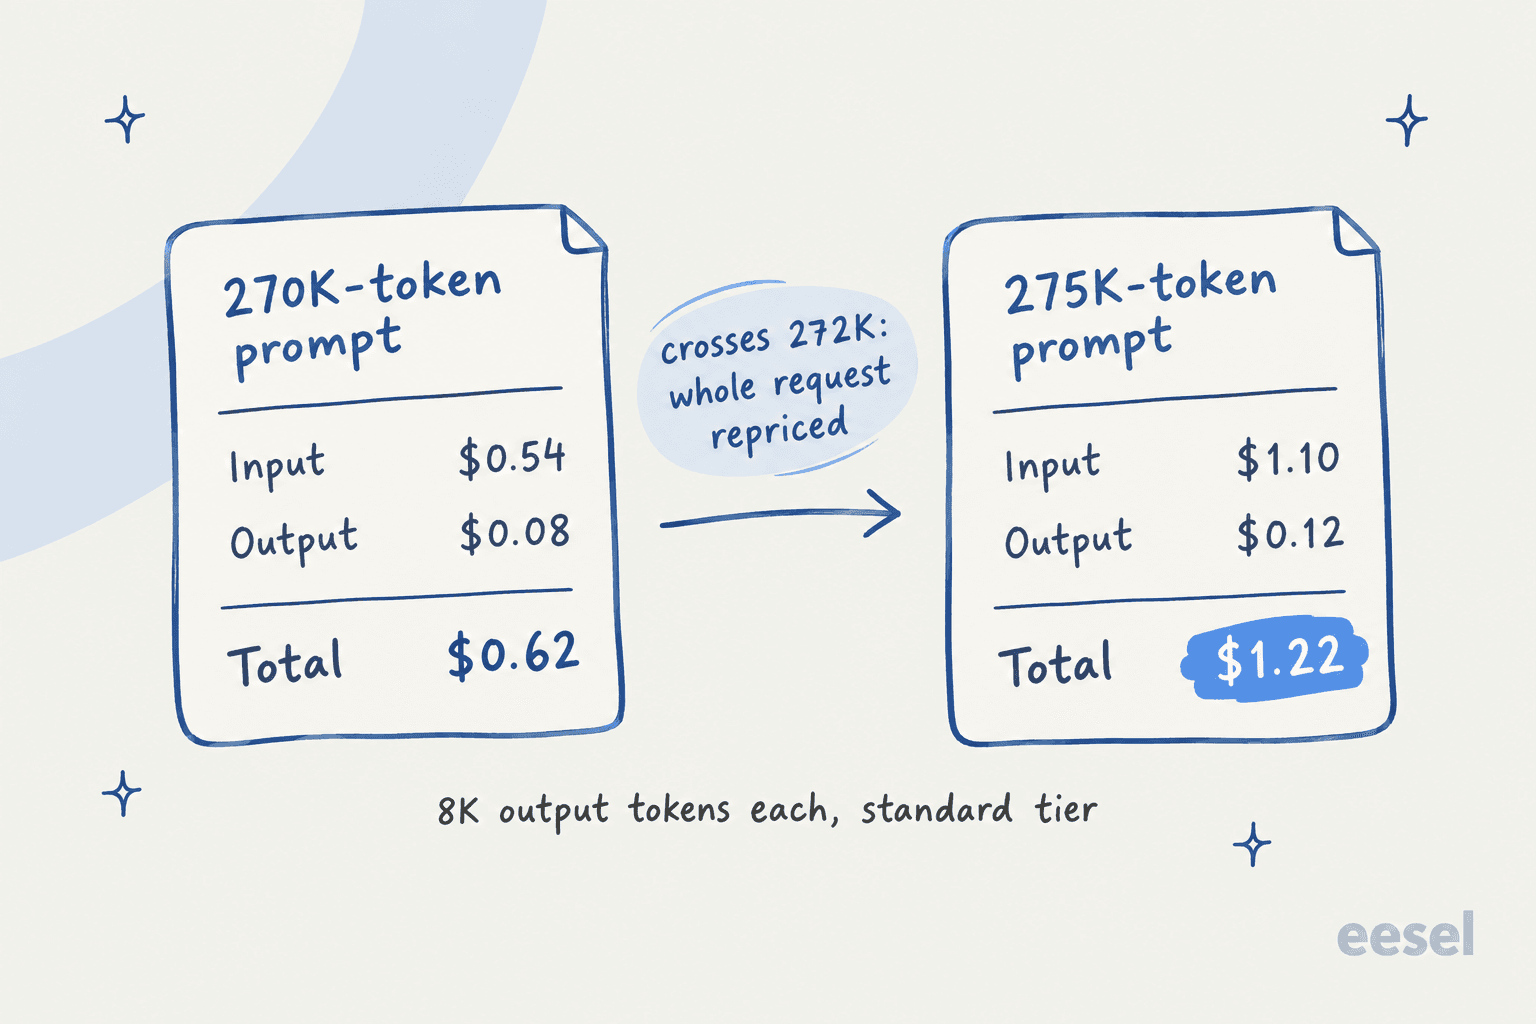
Cette image résume tout le piège : 5 000 tokens d'entrée de plus font presque doubler la requête, de 0,62 $ à 1,22 $. La fenêtre de 1 050 000 tokens est bien réelle. Elle a simplement une marche de prix à environ un quart du chemin. Quiconque fait de l'analyse de documents ou des tâches de code à l'échelle d'un dépôt devrait vérifier où tombent ses prompts. Découper une tâche de 400K en deux appels de 200K coûte souvent moins cher que de l'envoyer d'un bloc. Une récupération qui n'envoie que les passages pertinents fait mieux que les deux.
Coût par tâche : le chiffre qui compte vraiment
Un prix par token donne le prix du carburant. Il ne dit pas combien de carburant le trajet exige. Avec les modèles de raisonnement, ce deuxième chiffre peut varier de plus de 5x selon l'effort, et c'est pourquoi je budgétise à partir de lui.
Artificial Analysis a fait tourner son Intelligence Index complet une fois par niveau d'effort :
| Effort | Intelligence Index | Coût par tâche | Tokens de sortie par tâche | Durée par tâche |
|---|---|---|---|---|
| low | 42,1 | 0,13 $ | 4,0K | 56 s |
| medium | 47,8 | 0,21 $ | 8,1K | 131 s |
| high | 50,2 | 0,32 $ | 13,2K | 205 s |
| xhigh | 51,0 | 0,39 $ | 17,6K | 271 s |
| max | 51,8 | 0,72 $ | 38,1K | 569 s |
Source : Artificial Analysis. Près du sommet, la courbe devient presque plate. Passer de xhigh à max double presque le coût, pour 0,8 point gagné.
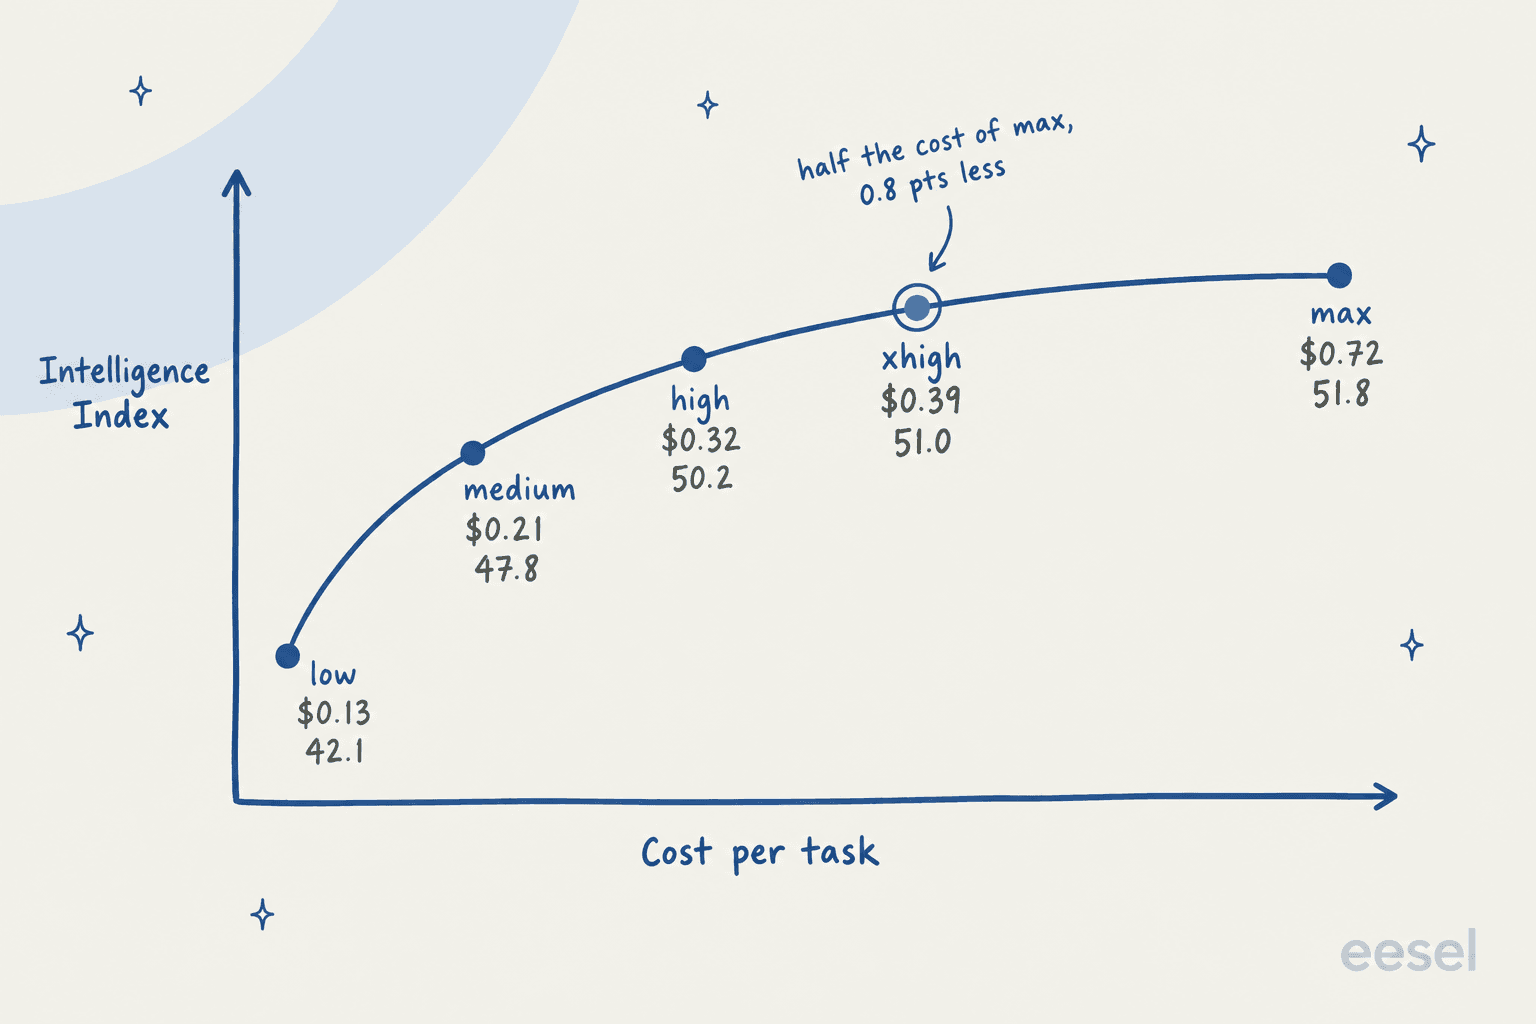
Pour le code, xhigh est encore plus intéressant. Artificial Analysis a rapporté que xhigh surpassait max de 3 points sur son Coding Agent Index, se plaçant 1 point au-dessus de GPT-6 Astra "for less than 15% of the Cost per Task." Mon réglage par défaut est medium pour le travail courant et xhigh pour les agents de code. Je ne passe à max que lorsqu'un test montre que le surcoût en vaut la peine.
Raisonner par tâche rebat aussi les cartes entre les modèles qui paraissent bon marché. Un développeur du fil de lancement l'a souligné à partir des chiffres d'Artificial Analysis :
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens, making the Chinese models come out costlier and slower per actual task performed end-to-end."
J'ai vérifié les chiffres de ce commentaire auprès d'Artificial Analysis, et ils tiennent : 6.1 Sol à effort moyen revient à 0,21 $ par tâche avec 8,1K tokens de sortie, tandis que le commentateur cite DeepSeek V4.1 Flash à effort maximal à 0,27 $ avec 89K tokens générés.
Les postes qui ne figurent pas dans la grille tarifaire
Certains coûts se trouvent hors du tableau par token, et chacun apparaît sur de vraies factures :
- Les tokens de raisonnement sont de la sortie. Chaque token de raisonnement est facturé au tarif de sortie de 10 $. À
max, Artificial Analysis a mesuré 38,1K tokens de sortie par tâche, dont l'essentiel est de la réflexion plutôt que la réponse. - Les outils intégrés ont leurs propres prix. Sur la page tarifaire, la recherche web coûte 10 $ pour 1 000 appels plus les tokens de contenu de recherche aux tarifs du modèle, les appels de l'outil de recherche de fichiers coûtent 2,50 $ pour 1 000, et les conteneurs hébergés de shell ou d'interpréteur de code vont de 0,03 $ par session de 20 minutes (1 Go) à 1,92 $ (64 Go).
- L'appel d'outils exige l'API Responses. La page du modèle indique que Chat Completions fonctionne "without tool calling." Ce n'est pas une ligne de la facture, mais migrer du code d'agent plus ancien coûte quand même du temps d'ingénierie.
- Les places de marché cloud facturent séparément. Si vous utilisez les modèles OpenAI via Amazon Bedrock ou Microsoft Azure, ces services fixent et facturent le tarif, selon la page tarifaire d'OpenAI.
Estimez votre facture GPT-6.1 Sol
Entrez ici la forme de votre propre trafic, des requêtes par mois et tokens par requête jusqu'à votre taux de réussite du cache et votre niveau. Si une requête dépasse 272K, l'estimateur bascule de lui-même sur le tarif long contexte. Il montre aussi ce que coûterait le même trafic sur GPT-6 Astra et GPT-6 Luna.
Par défaut, les valeurs modélisent un agent de code avec un gros préfixe en cache. Faites descendre le curseur du cache à zéro et la ligne d'entrée bondit. Ensuite, réglez les tokens de sortie à 20 000 et vous verrez ce que coûte une habitude d'effort max. La plupart du temps, c'est la sortie qui absorbe l'argent. Pour les images, l'audio et les anciens modèles, le guide des tarifs de l'API OpenAI couvre le reste du catalogue.
Exemples chiffrés à trois échelles
Les prix affichés prennent plus de sens une fois rattachés à un vrai profil de trafic. En voici trois que je croise souvent, tous calculés à partir de la grille. Les nombres de tokens sont mes hypothèses à titre d'illustration, pas des mesures : mettez vos propres chiffres dans l'estimateur ci-dessus.
| Charge de travail | Profil de trafic | GPT-6.1 Sol | Comparaison |
|---|---|---|---|
| Boucle d'agent de code | 30 000 appels/mois, 60K en entrée (50K en cache), 3K en sortie, standard | 1 650 $/mois | Astra : 9 000 $. GPT-6 Sol : 1 800 $ |
| Extraction nocturne de documents | 20 000 documents/mois, 40K en entrée (rien en cache), 2K en sortie, Batch | 1 000 $/mois | Même tâche en standard : 2 000 $ |
| Tri des tickets de support | 100 000 tickets/mois, 2,5K en entrée (2K en cache), 600 en sortie, standard | 720 $/mois | Luna : 37 $. Astra : 3 700 $ |
Quelques points ressortent de ce tableau :
- L'agent de code est surtout une facture de sortie. Sur les 1 650 $, 900 $ sont de la sortie et seulement 150 $ correspondent aux 1,5 milliard de tokens d'entrée en cache. Par rapport à GPT-6 Sol, la baisse du cache a fait économiser 150 $ par mois. Le reste dépend du réglage de l'effort.
- Batch est la ligne la moins chère que vous modifierez jamais. Changez un paramètre et la tâche d'extraction coûte moitié moins, sans changement de qualité.
- Le tri est un travail pour Luna. Pour des étiquettes courtes et peu risquées à gros volume, GPT-6 Luna fait la même chose pour environ 5 % du prix. Je garderais Sol pour les réponses qui doivent être justes. L'article sur les tarifs de GPT-6 Luna donne sa grille complète.
Les tarifs de GPT-6.1 Sol dans ChatGPT et Codex
Utiliser GPT-6.1 Sol via un abonnement plutôt que l'API fonctionne autrement : vous payez un prix mensuel fixe et vous puisez dans une allocation. OpenAI indique qu'il est disponible "to all Plus, Pro, Business, Enterprise, and Edu users in ChatGPT Work and Codex," et "not yet available in Chat."
| Forfait | Prix mensuel | GPT-6.1 Sol | Remarques |
|---|---|---|---|
| Free | 0 $ | Non | GPT-5.6 Luna pour le chat courant |
| Go | 8 $ | Non | Peut inclure des publicités |
| Plus | 20 $ | Oui | Usage étendu de Codex |
| Pro 100 | 100 $ | Étendu | Pas d'Ultrafast |
| Pro 200 | 200 $ | Étendu | Plus d'usage que Pro 100 |
| Pro 500 | 500 $ | Étendu | Allocation la plus élevée, inclut Ultrafast |
| Business / Enterprise / Edu | Par siège | Oui | Dans ChatGPT Work et Codex |
Sources : tarifs de ChatGPT, À propos des niveaux ChatGPT Pro et l'annonce de lancement. Le guide des tarifs de ChatGPT couvre chaque forfait, les tarifs de ChatGPT Work détaillent Work, et ChatGPT Enterprise couvre les offres par siège.
Les abonnements comportent un piège que l'API n'a pas. La page d'aide de Pro d'OpenAI indique que les nouveaux abonnements Pro 200 "include a lower usage allowance than previously offered," les abonnés existants ne conservant l'ancienne allocation que jusqu'au 29 octobre 2026. Le récapitulatif du DevDay place Pro 500 à "25 times the ChatGPT Plus allowance." Une fois la limite atteinte, la même page d'aide précise que l'usage éligible de Codex et de ChatGPT Work peut puiser dans des crédits achetés.
Certains premiers utilisateurs ont calculé ce que cela donne pour Codex :
"They have also cut allowances for subscriptions in half. So even in the best case scenario it's about 2.5 times cheaper for Codex users."
C'est l'estimation d'un utilisateur, pas un chiffre d'OpenAI. Cela reste un avertissement justifié. Un modèle 5x moins cher qu'Astra sur l'API ne se traduit pas par 5x plus de travail dans un forfait. Si vous vivez dans Codex, je surveillerais votre propre compteur d'usage pendant une semaine avant de compter sur les économies.
Comment se situent les tarifs de GPT-6.1 Sol
Sur le prix affiché, GPT-6.1 Sol égale exactement Claude Sonnet 5.5 et se place bien en dessous de tout ce qui est au-dessus :
| Modèle | Entrée / Sortie (par 1M) | Entrée en cache | Coût par tâche (AA) | Intelligence Index (AA) |
|---|---|---|---|---|
| GPT-6 Luna | 0,10 $ / 0,50 $ | 0,01 $ | n/d | n/d |
| GPT-6.1 Sol (medium) | 2 $ / 10 $ | 0,10 $ | 0,21 $ | 47,8 |
| GPT-6.1 Sol (max) | 2 $ / 10 $ | 0,10 $ | 0,72 $ | 51,8 |
| Claude Sonnet 5.5 (high) | 2 $ / 10 $ | 0,20 $ | 1,08 $ | 47 |
| Claude Opus 5.5 (medium) | 4 $ / 20 $ | 0,20 $ | 1,34 $ | 51 |
| GPT-6 Astra (max) | 10 $ / 50 $ | 1,00 $ | 3,26 $ | 52,7 |
| Claude Opus 5.5 (max) | 4 $ / 20 $ | 0,20 $ | 5,98 $ | 58 |
Sources : tarifs OpenAI, tarifs Anthropic et Artificial Analysis pour le coût par tâche et les scores.
Mon analyse tient en deux parties. À score égal, GPT-6.1 Sol est bien moins cher par tâche : 47,8 pour 0,21 $ contre 47 pour 1,08 $ pour Sonnet 5.5, et 51,8 à max pour environ la moitié de ce que facture Opus 5.5 à medium pour 51. Artificial Analysis l'a dit sans détour : "for a given level of intelligence, there is no cheaper model."
Ce qu'il ne fait pas, c'est atteindre le sommet. Opus 5.5 et Sonnet 5.5 à max obtiennent plus, et dans une comparaison pratique du fil de lancement, un développeur a trouvé qu'Opus 5.5 "executes a bit better" sur la finition. Le choix porte donc sur le score dont vous avez besoin, pas sur le prix affiché. Si un score de 48 à 52 sur cet indice couvre votre cas, GPT-6.1 Sol est le moyen le moins cher d'y arriver. Besoin du haut du classement ? Vous le paierez ailleurs. La comparaison API OpenAI contre API Anthropic creuse davantage ce compromis.
Ce que les tarifs de GPT-6.1 Sol signifient pour une équipe support
Cette partie va à l'encontre de l'intuition. Dans une file de support, un modèle moins cher est la plus petite ligne du projet, alors que la facture de tokens est la plus difficile à prévoir.
Pensez à ce qui détermine les chiffres ci-dessus : longueur des prompts, taux de réussite du cache, effort de raisonnement, nouvelles tentatives, appels d'outils, et si un prompt a franchi 272K. Aucun de ces éléments ne correspond à « tickets traités ». Un responsable support ne peut pas remettre à la direction financière un budget qui dit « entre 400 $ et 2 000 $ selon le niveau de bavardage du modèle ». Cela revient dans de vraies évaluations d'eesel. Un acheteur sous Freshdesk a atteint 200 interactions en une seule journée de test et a aussitôt projeté le coût à 9 000 par mois. Ce qui l'inquiétait n'était pas le tarif. C'était de ne pas connaître le total.
Il y a ensuite la tentation de tout construire soi-même, qui se renforce chaque fois qu'un modèle devient moins cher. Un client de taille intermédiaire, parti vers un outil moins cher après une intégration défaillante, l'a formulé ainsi dans une réponse au fondateur d'eesel :
"We switched to a system [...] that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
C'est un plan raisonnable, et GPT-6.1 Sol à 2 $/10 $ rend bien la partie modèle moins chère. Mais le modèle n'a jamais été la partie coûteuse. Le travail, c'est la couche autour : l'entraînement sur vos tickets passés, la connexion au helpdesk que vous utilisez déjà, des actions sûres, et le test des réponses sur l'historique réel avant la mise en production. Si les hallucinations vous inquiètent, la solution se trouve elle aussi dans cette couche, pas dans la grille tarifaire. C'est aussi pourquoi les meilleurs agents IA pour le support sont flexibles sur le modèle : quand un modèle moins cher sort, vous en héritez au lieu de tout reconstruire. Le détail du coût d'un agent IA montre où va réellement cet argent.
Essayer eesel
Si ce que vous voulez vraiment de GPT-6.1 Sol, c'est moins de tickets dans la file, vous n'avez pas besoin de chiffrer des tokens. eesel est une plateforme de coéquipiers IA, et le coéquipier IA de helpdesk est celui qui convient à ce travail. GPT-6.1 Sol est de l'infrastructure ; eesel est l'employé. Il apprend de vos tickets passés et de votre centre d'aide, se branche à Zendesk, Freshdesk, Gorgias et aux autres helpdesks que vous utilisez déjà, et lance une simulation sur vos vrais tickets passés pour que vous puissiez comparer ses réponses avec ce que votre équipe a réellement envoyé.
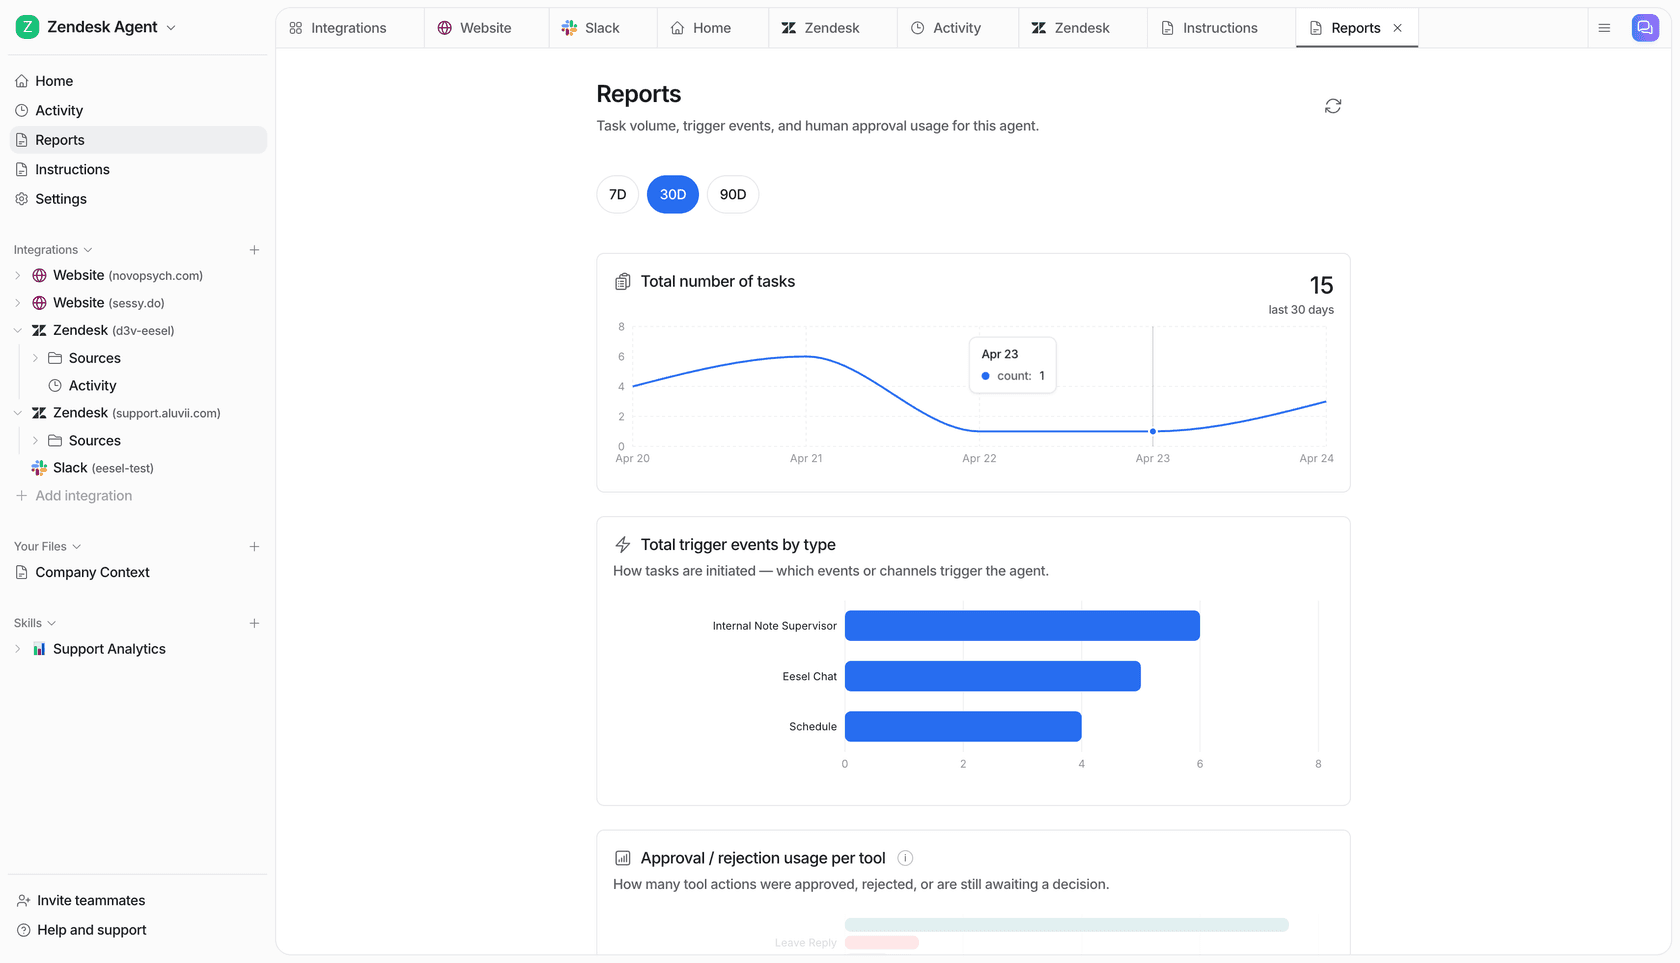
La facturation fonctionne à l'inverse d'un compteur de tokens. Les tarifs d'eesel sont un forfait mensuel fixe de crédits, à partir de 299 $ pour 500 crédits, où un ticket ou un chat traité vaut un crédit. Toutes les fonctionnalités et un nombre illimité de sièges sont inclus, et une offre gratuite donne 100 crédits sans carte. Quel que soit le modèle en dessous, votre facture d'automatisation du support reste le même chiffre chaque mois.
Comme il s'agit d'un article de tarifs pour développeurs, j'ajoute une dernière chose. La CLI eesel pilote depuis un terminal le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez connecter un helpdesk avec eesel integrations connect, relire chaque exécution avec eesel activity et soumettre les actions risquées à validation avec eesel approvals. Chaque commande affiche du JSON, et --dry-run montre l'appel exact qu'une écriture ferait avant de l'envoyer. Chaque espace de travail est aussi un serveur MCP : une session Codex qui exécute GPT-6.1 Sol peut donc piloter votre coéquipier de support comme un outil, selon le même schéma que n'importe quelle configuration de MCP pour le support. Vous obtenez le contrôle par script que vous attendez d'un agent à construire soi-même, avec une facturation au ticket que vous pouvez réellement inscrire dans un budget.
Questions fréquentes
Combien coûte GPT-6.1 Sol sur l'API ?
GPT-6.1 Sol est-il plus cher que GPT-6 Sol ?
Quel est le prix long contexte de GPT-6.1 Sol ?
GPT-6.1 Sol est-il gratuit dans ChatGPT ?
Combien coûte GPT-6.1 Sol dans Codex ?
Combien coûte GPT-6.1 Sol par tâche ?
GPT-6.1 Sol est-il moins cher que Claude Sonnet 5.5 ?
Que signifient les tarifs de GPT-6.1 Sol pour une équipe support ?

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.