

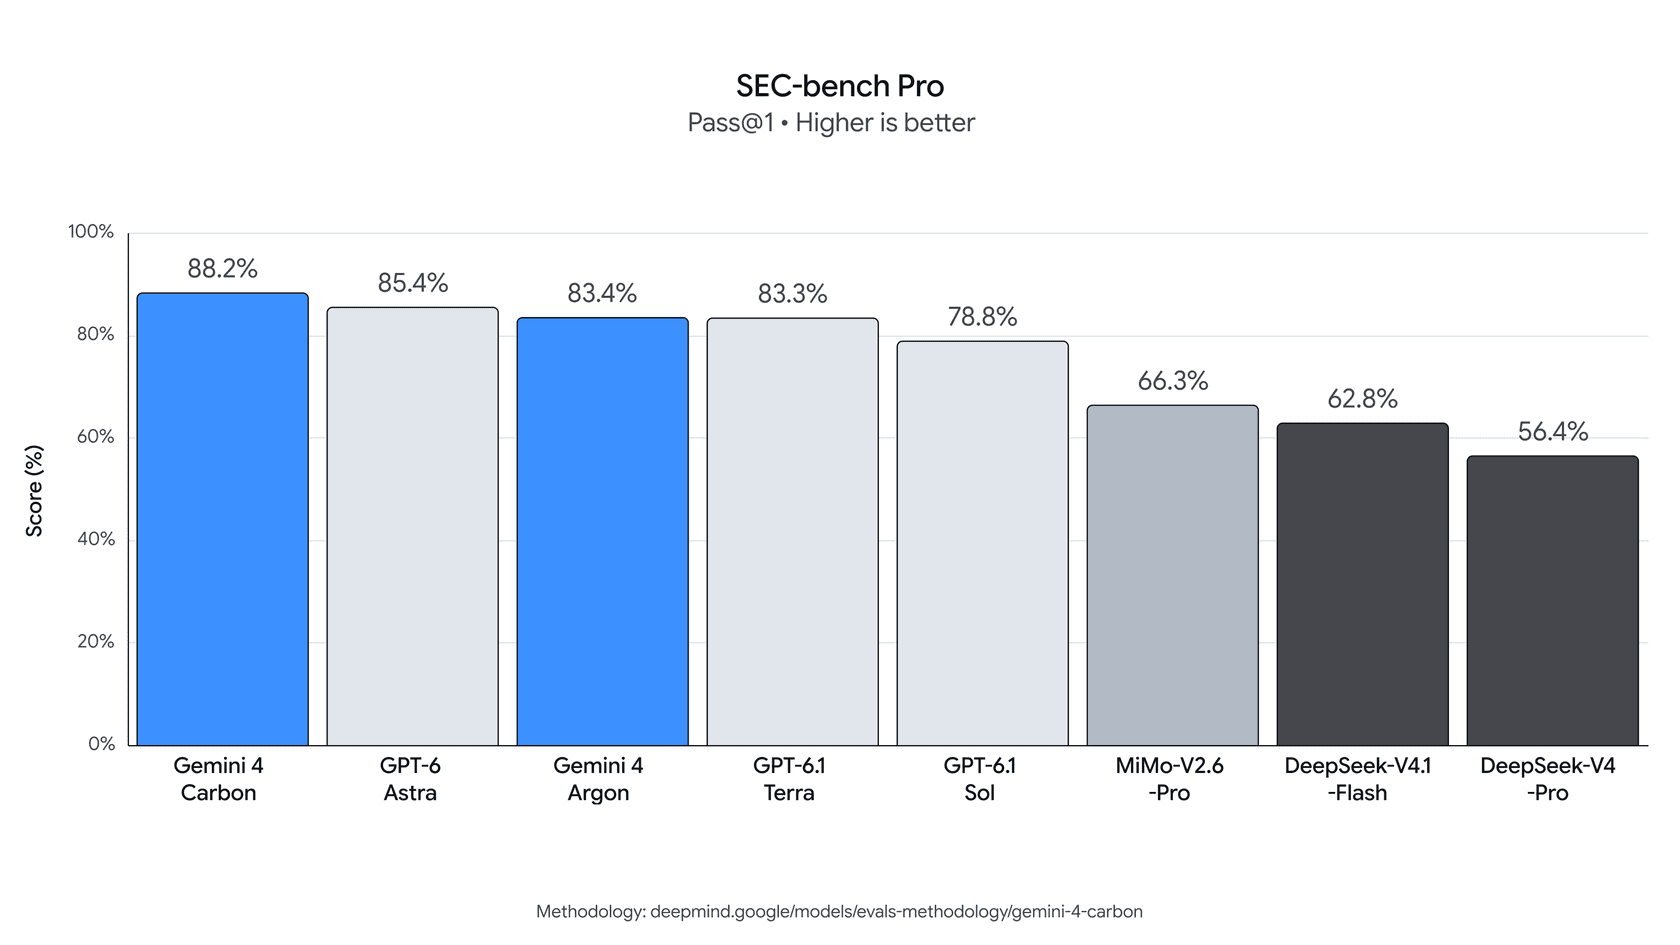
Gemini 4 Carbon est le nouveau modèle de pointe de Google, et c'est le modèle le plus fort de l'Artificial Analysis Intelligence Index avec 59, neuf points au-dessus de Gemini 4 Argon, sorti seulement deux semaines plus tôt. Il bat Argon sur les 17 benchmarks publiés par Google, domine les tests de cybersécurité comme SEC-bench Pro (88,2 %) et coûte exactement pareil : $2/$10 par million de tokens au lancement, $4/$20 ensuite.
Le hic, c'est l'accès. Aujourd'hui, seul un sous-ensemble de défenseurs en cybersécurité peut utiliser Carbon, via le Fairwind Program de Google. Les développeurs, les entreprises et les consommateurs l'obtiendront « dès que possible », sans date. Argon est passé de l'annonce à l'API en environ deux semaines, c'est donc la meilleure estimation pour Carbon aussi.
Mon avis : Carbon n'est pas un palier supérieur à Argon, c'est son remplaçant. Si vous utilisez déjà Argon, prévoyez de changer le nom du modèle à son arrivée. Si vous l'envisagez pour des tickets de support, le titre qui compte est l'affirmation de Google selon laquelle Carbon fait environ deux fois moins d'affirmations non étayées. C'est le même problème qu'eesel résout au niveau de l'agent de helpdesk : des brouillons ancrés dans votre centre d'aide et vos anciens tickets, et un transfert quand il n'y a rien sur quoi les appuyer.
Qu'est-ce que Gemini 4 Carbon ?
Gemini 4 Carbon est un grand modèle de langage de Google DeepMind, annoncé le 28 octobre 2026 par Koray Kavukcuoglu, Chief AI Architect de Google. Google l'appelle « our strongest model with state-of-the-art cybersecurity and long horizon capabilities », et il est construit « building on » Argon, et non comme une classe de taille à part.
La version courte de ce que revendique Google :
| Quoi | Gemini 4 Carbon |
|---|---|
| Annoncé | 28 octobre 2026 |
| Construit sur | Gemini 4 Argon (lancé deux semaines plus tôt) |
| Artificial Analysis Intelligence Index v5.0 | 59,4, n°1 au lancement |
| Conçu pour | Codage agentique de longue durée, défense en cybersécurité |
| Fenêtre de contexte | 1M de tokens, selon Artificial Analysis |
| Prix de lancement | $2 en entrée / $10 en sortie par 1M de tokens, entrée en cache à -95 % |
| Prix après la promotion | $4 en entrée / $20 en sortie |
| Qui peut l'utiliser aujourd'hui | Un sous-ensemble de défenseurs en cybersécurité via le Fairwind Program |
Google affirme que ses propres équipes ont vu Carbon « run for days to persist through dead ends » sur des travaux d'ingénierie comme la recherche de la cause racine de bugs subtils dans de grandes bases de code. C'est le travail autour duquel il est conçu, ce qui explique aussi pourquoi l'essentiel de l'article de lancement parle de codage et de sécurité plutôt que de chat.
En quoi Carbon diffère-t-il d'Argon ?
Carbon est un meilleur Argon pour le même prix. Google ne dit pas s'il s'agit d'un nouvel entraînement ou d'un checkpoint ultérieur, mais tout dans le lancement (même grille tarifaire, même déploiement, « building on Gemini 4 Argon ») indique un successeur et non un frère. Voici comment les deux se comparent sur les chiffres qui ont le plus bougé :
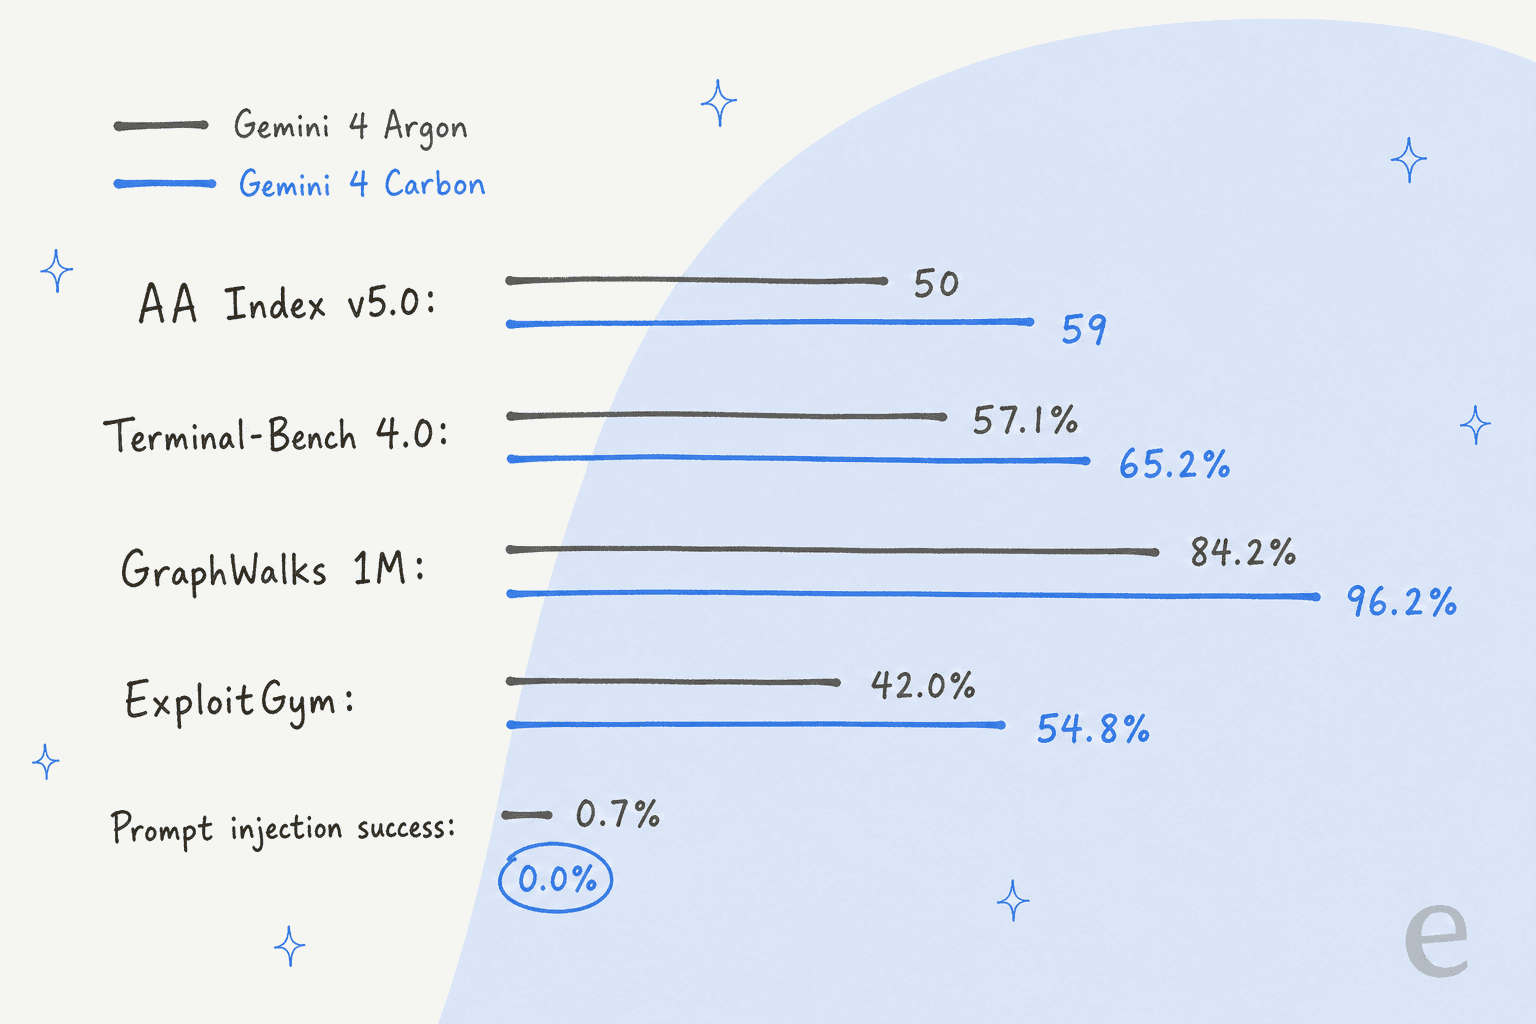
Les plus gros bonds concernent le contexte long et la sécurité. GraphWalks, qui teste le raisonnement sur 256K à 1M de tokens, passe de 84,2 % à 96,2 %, et le benchmark d'exploitation ExploitGym gagne près de 13 points. Les gains en codage général sont plus modestes mais réels : Terminal-Bench 4.0 gagne huit points, et sur WebDev Arena Carbon grimpe de 89 Elo jusqu'à la 4e place.
Les noms ont dérouté presque tout le monde. Des laboratoires comme OpenAI et Anthropic utilisent des noms qui indiquent l'ordre de taille (Astra, Sol, Terra ; Opus, Sonnet, Haiku). Les noms d'éléments de Google ne le font pas, et le fil Hacker News a consacré des centaines de commentaires à ce seul sujet :
"Confusingly, Carbon is another model in the same size class as Argon. Every other lab would have just called it Gemini 4.1 Argon."

Je pense que c'est le bon modèle mental. Si vous considérez Carbon comme « Argon, version suivante », le reste du lancement prend aussi sens.
Quels scores obtient Gemini 4 Carbon aux benchmarks ?
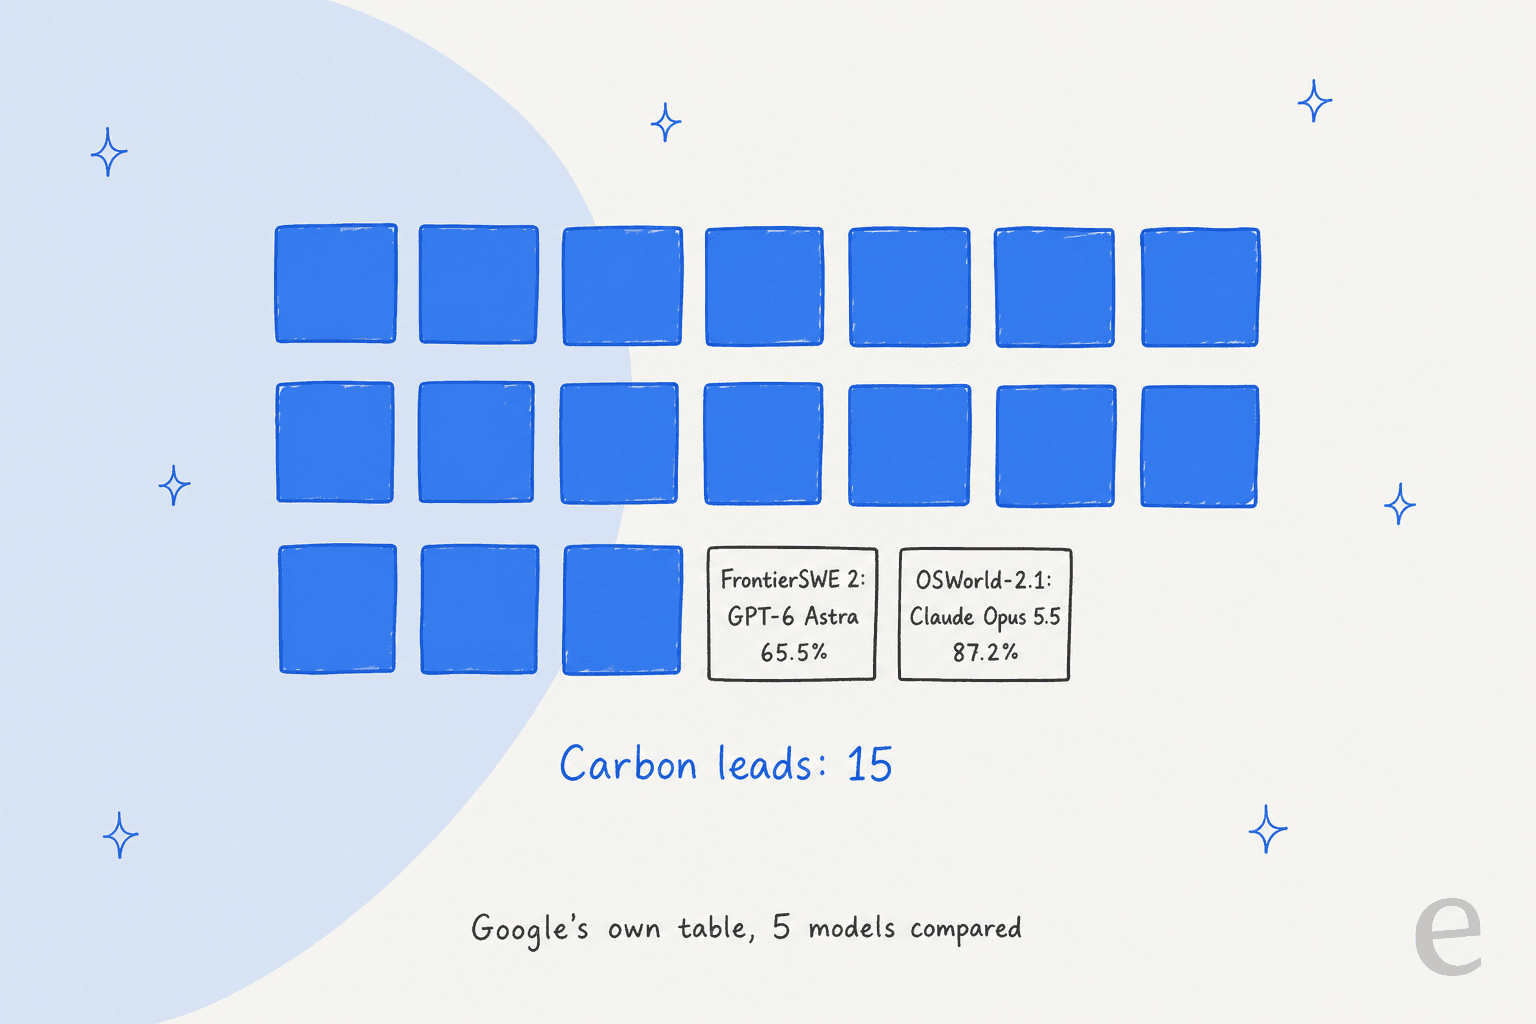
Carbon mène sur 15 des 17 lignes du tableau de Google, face à Argon, GPT-6 Astra, Claude Opus 5.5 et Claude Fable 5.1. Voici le tableau complet tel que Google l'a publié :
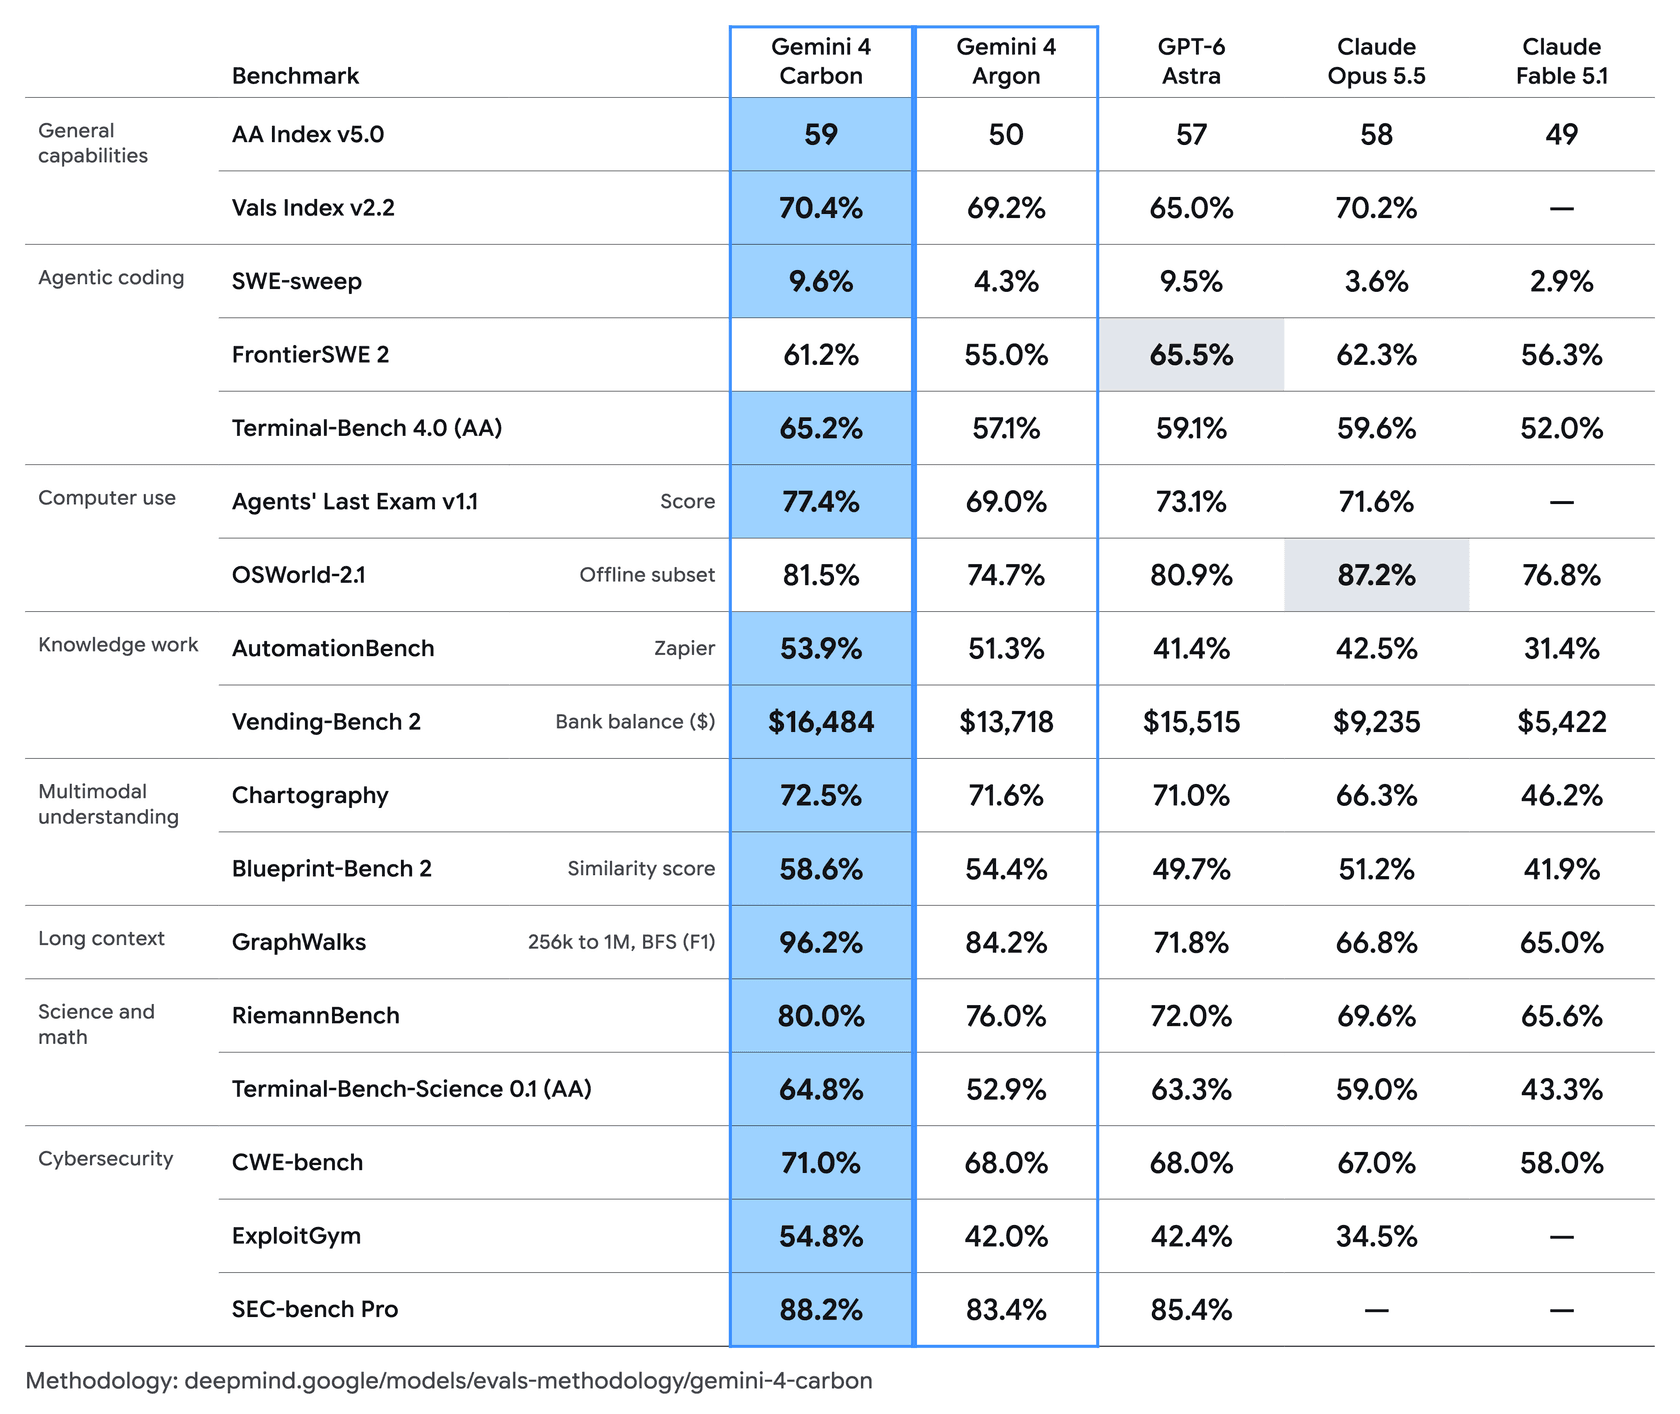
Les deux lignes où Carbon ne gagne pas méritent d'être connues, car ce sont celles qu'un acheteur orienté codage ou utilisation d'ordinateur regarderait en premier :
Voici les lignes auxquelles je prêterais le plus d'attention, tirées de la page du modèle DeepMind :
| Benchmark | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Intelligence Index v5.0 | 59 | 50 | 57 | 58 |
| Terminal-Bench 4.0 (codage agentique) | 65.2% | 57.1% | 59.1% | 59.6% |
| FrontierSWE 2 (ingénierie logicielle) | 61.2% | 55.0% | 65.5% | 62.3% |
| OSWorld-2.1 (utilisation d'ordinateur) | 81.5% | 74.7% | 80.9% | 87.2% |
| AutomationBench (tâches Zapier) | 53.9% | 51.3% | 41.4% | 42.5% |
| GraphWalks (256K à 1M de tokens) | 96.2% | 84.2% | 71.8% | 66.8% |
| SEC-bench Pro (trouver des vulnérabilités) | 88.2% | 83.4% | 85.4% | n/a |
Deux choses me frappent. D'abord, l'avance en contexte long est grande, pas marginale : 96,2 % sur GraphWalks contre 66,8 % pour Opus 5.5. Si votre travail consiste à lire des bases de code entières ou de longs contrats, c'est la ligne qui compte. Ensuite, le chiffre d'AutomationBench (le test de Zapier sur de vrais flux de travail d'entreprise) place Carbon à plus de 11 points devant Astra et Opus, et pour le travail d'agent c'est un signal plus fort que n'importe quel score de codage isolé.
Une réserve honnête : ce sont des chiffres du fournisseur. La vérification indépendante jusqu'ici, c'est Artificial Analysis, qui place Carbon à 59,4, premier au général, à $7,76 par tâche au tarif public. Et le parcours d'Argon est une raison d'attendre l'usage réel avant de se fier au tableau. Argon aussi semblait solide sur le papier, et une bonne part du fil Hacker News sur Carbon est constituée de développeurs disant qu'il leur paraissait plus faible au quotidien, ce que développe mon test de Gemini 4 Argon.
Pourquoi Google appelle-t-il Carbon un modèle de cybersécurité ?
Parce que c'est là que son avance est la plus nette, et aussi là que se trouve le risque. Google rapporte des résultats à l'état de l'art sur les étapes que suit réellement une équipe de sécurité : trouver une faille, prouver qu'elle est exploitable, puis la corriger.
- Trouver : 88,2 % sur SEC-bench Pro, en découvrant de façon autonome des failles dans de vrais logiciels.
- Valider : 54,8 % sur ExploitGym, le benchmark d'exploitation, contre 42,0 % pour Argon.
- Corriger : 71,0 % sur CWE-bench, en transformant les constats en correctifs fonctionnels.
Google ajoute aussi des affirmations venues de l'intérieur. Dans des tests internes, Carbon offre "more than 2x uplift in success rate for generating secure code over Argon". L'équipe Chrome dit qu'il a fait "more than 10X better than another lab's large frontier model" pour écrire des correctifs de qualité. Et Wiz le voit en tête sur les tests d'intrusion web. Rien de cela ne peut encore être vérifié de façon indépendante, donc je le lirais comme une direction et non comme des chiffres pour planifier.
Un modèle aussi bon pour trouver et exploiter des bugs est aussi utile aux attaquants, c'est pourquoi le déploiement commence par les défenseurs. Le Fairwind Program donne un accès anticipé à "high-priority defenders (like governments, healthcare providers, and telecommunications services)", et Google dit travailler avec plus de 650 partenaires. C'est le même schéma que GPT-5.6-Cyber et que Claude Mythos 5.1 d'Anthropic : les modèles cyber les plus capables sont désormais livrés d'abord à des équipes de sécurité vérifiées. Tout le monde ne trouve pas cela juste pour les petits projets :
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Si vous avez besoin d'un modèle Google orienté cyber que vous pouvez appeler aujourd'hui, Gemini 3.8 Flash Cyber est l'option disponible.
Qu'est-ce que Google a changé côté sécurité et honnêteté ?
C'est la partie du lancement que je trouve la plus utile hors sécurité. Carbon repose sur la pile de sécurité d'Argon (entraînement, défenses anti-abus en temps réel, résistance à l'injection de prompt, surveillance de la chaîne de pensée), et Google dit être allé plus loin sur le comportement du modèle sous pression :
- Moins de triche. Les triches réussies sur Terminal-Bench 4.0 sont tombées à 0,0 %, avec des tentatives à 0,4 %. En codage en direct avec les équipes de Google, les alertes de désalignement de forte gravité ont baissé de près de 80 %.
- Moins d'affirmations inventées. Carbon "cuts unsupported claims by approximately 2x over Argon". Il met des réserves dans le livrable ou liste ce qui manque encore, "rather than fabricating or hedging around missing evidence".
- Demande avant de deviner. Quand une tâche est ambiguë, il récupère des sources et signale les divergences à l'utilisateur avant d'agir.
- Reste dans le périmètre. Dépassement en baisse de 26 %, sous-service en baisse de 29 %.
- Résistance à l'injection de prompt. 0,0 % de réussite d'attaque sur le benchmark d'injection de prompt indirecte de Gray Swan, contre 0,7 % pour Argon.
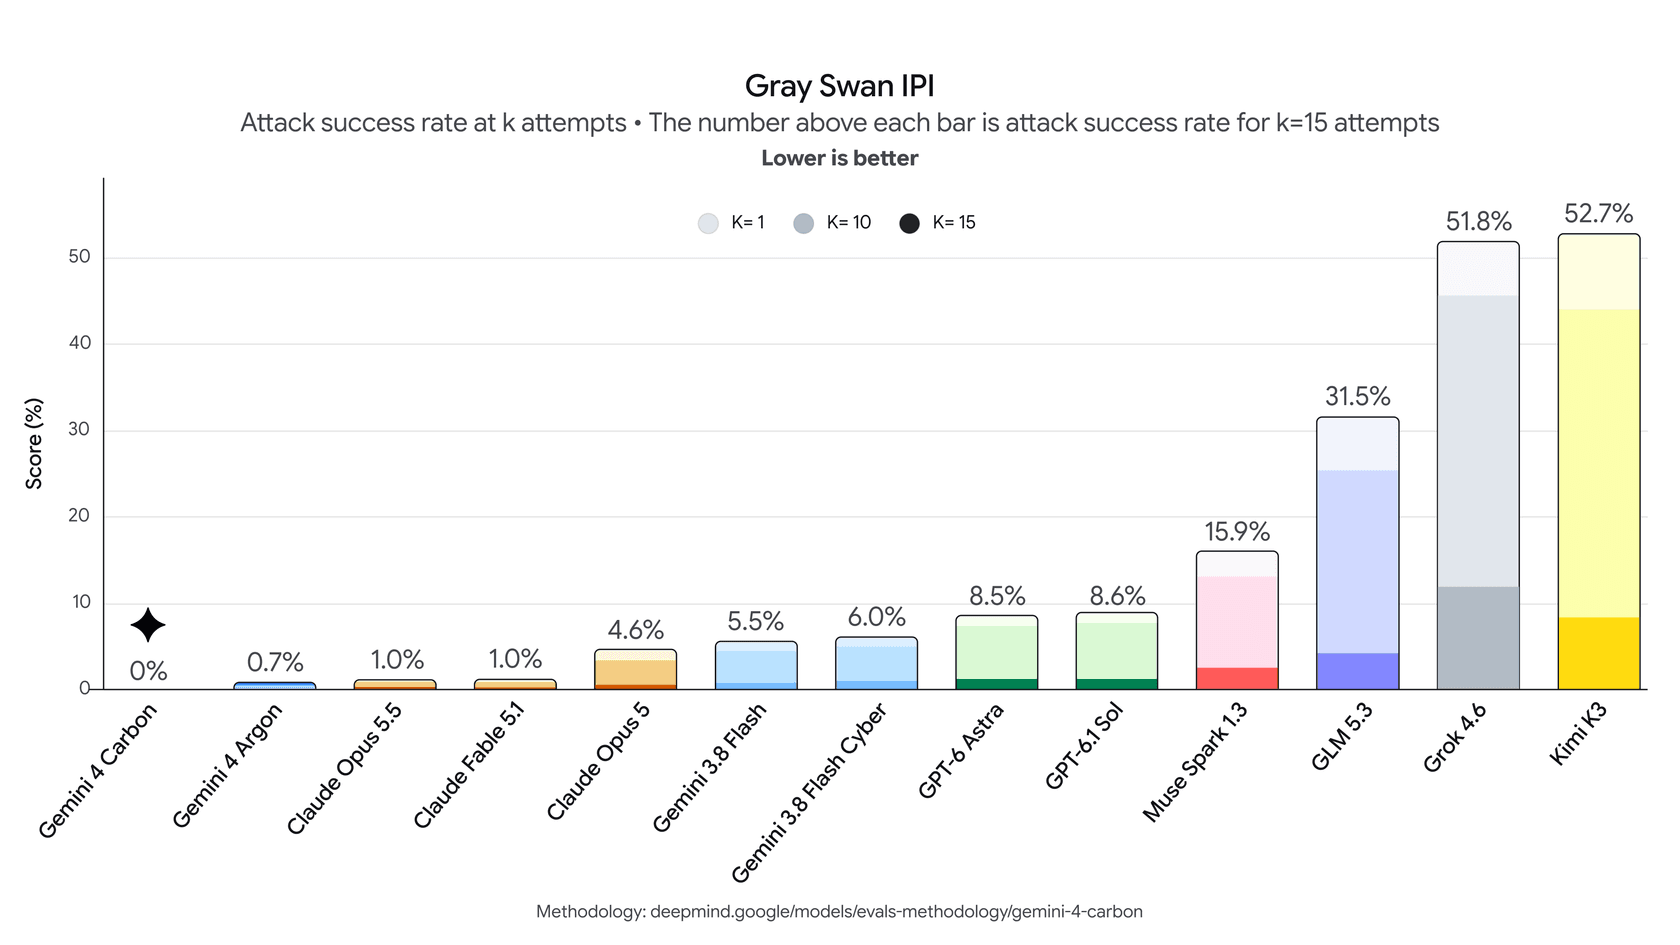
L'injection de prompt est le point que je soulignerais pour quiconque construit des agents qui lisent du contenu extérieur. Un agent qui lit des e-mails, des pages web ou des tickets clients lit du texte écrit par des inconnus, et une partie de ce texte va essayer de lui donner des ordres. Un taux de réussite d'attaque de 0 % sur toutes les tentatives de Gray Swan est un vrai progrès, même si « chaque tentative évaluée » n'est pas la même chose que chaque tentative.
Qui peut utiliser Gemini 4 Carbon, et quand ?
Pour l'instant, presque personne. Le déploiement de Google se fait en trois étapes et seule la première a commencé :
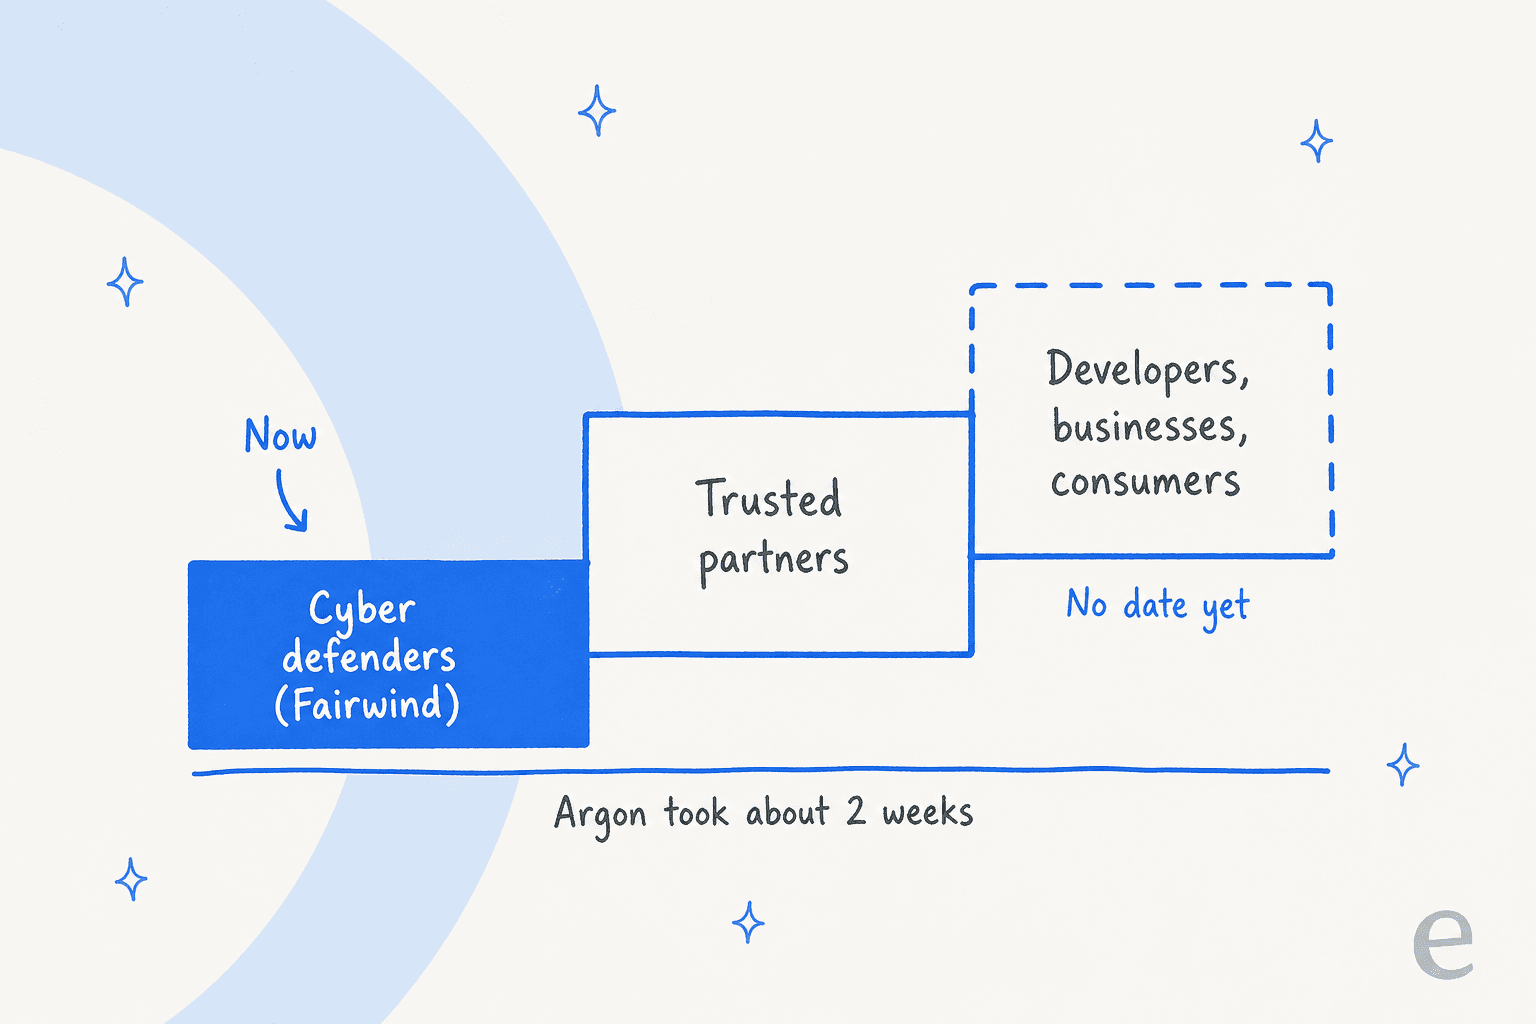
Google dit aussi être "actively engaged in the U.S. government's voluntary process for pre-release model testing", donc une partie de l'attente ne dépend pas de Google. La seule promesse de calendrier est "as soon as possible".
Argon est le meilleur guide pour savoir ce que cela signifie en pratique. Un commentateur a détaillé les dates :
"The previous model, Argon, was announced on 30 Sep and released on 13 Oct."
Si Carbon suit le même chemin, il arrivera dans la Gemini API et les offres Google AI Pro et Ultra à la mi-novembre. Je m'attends à ce qu'il atterrisse aux mêmes endroits qu'Argon : l'API, l'application Gemini pour les abonnés payants et les outils de codage de Google.
D'ici là, les options pratiques sont :
- Utiliser Argon maintenant et basculer à l'arrivée de Carbon. Même API, même grille tarifaire.
- Utiliser Gemini 3.8 Flash pour le travail courant à fort volume. Il est bien moins cher et suffit pour la plupart des tâches quotidiennes.
- Utiliser GPT-6.1 Sol ou Claude Opus 5.5 si vous avez besoin d'un modèle de pointe cette semaine et qu'Argon ne vous a pas convenu.
Combien coûte Gemini 4 Carbon ?
Carbon est lancé au même prix qu'Argon : $2 par million de tokens en entrée et $10 par million de tokens en sortie, avec l'entrée en cache à -95 % ($0,10). Après une période d'introduction, la note de bas de page de Google indique que $4/$20 s'applique. Il n'y a pas de date de fin, et Carbon ne figure pas encore sur la page de tarifs de la Gemini API.
| Gemini 4 Carbon | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|---|
| Entrée / 1M (lancement) | $2.00 | $2.00 jusqu'au 30 nov. | $4.00 | $10.00 |
| Sortie / 1M (lancement) | $10.00 | $10.00 jusqu'au 30 nov. | $20.00 | $50.00 |
| Entrée / sortie après la promo | $4 / $20 | $4 / $20 dès le 1er déc. | Pas de promo | Pas de promo |
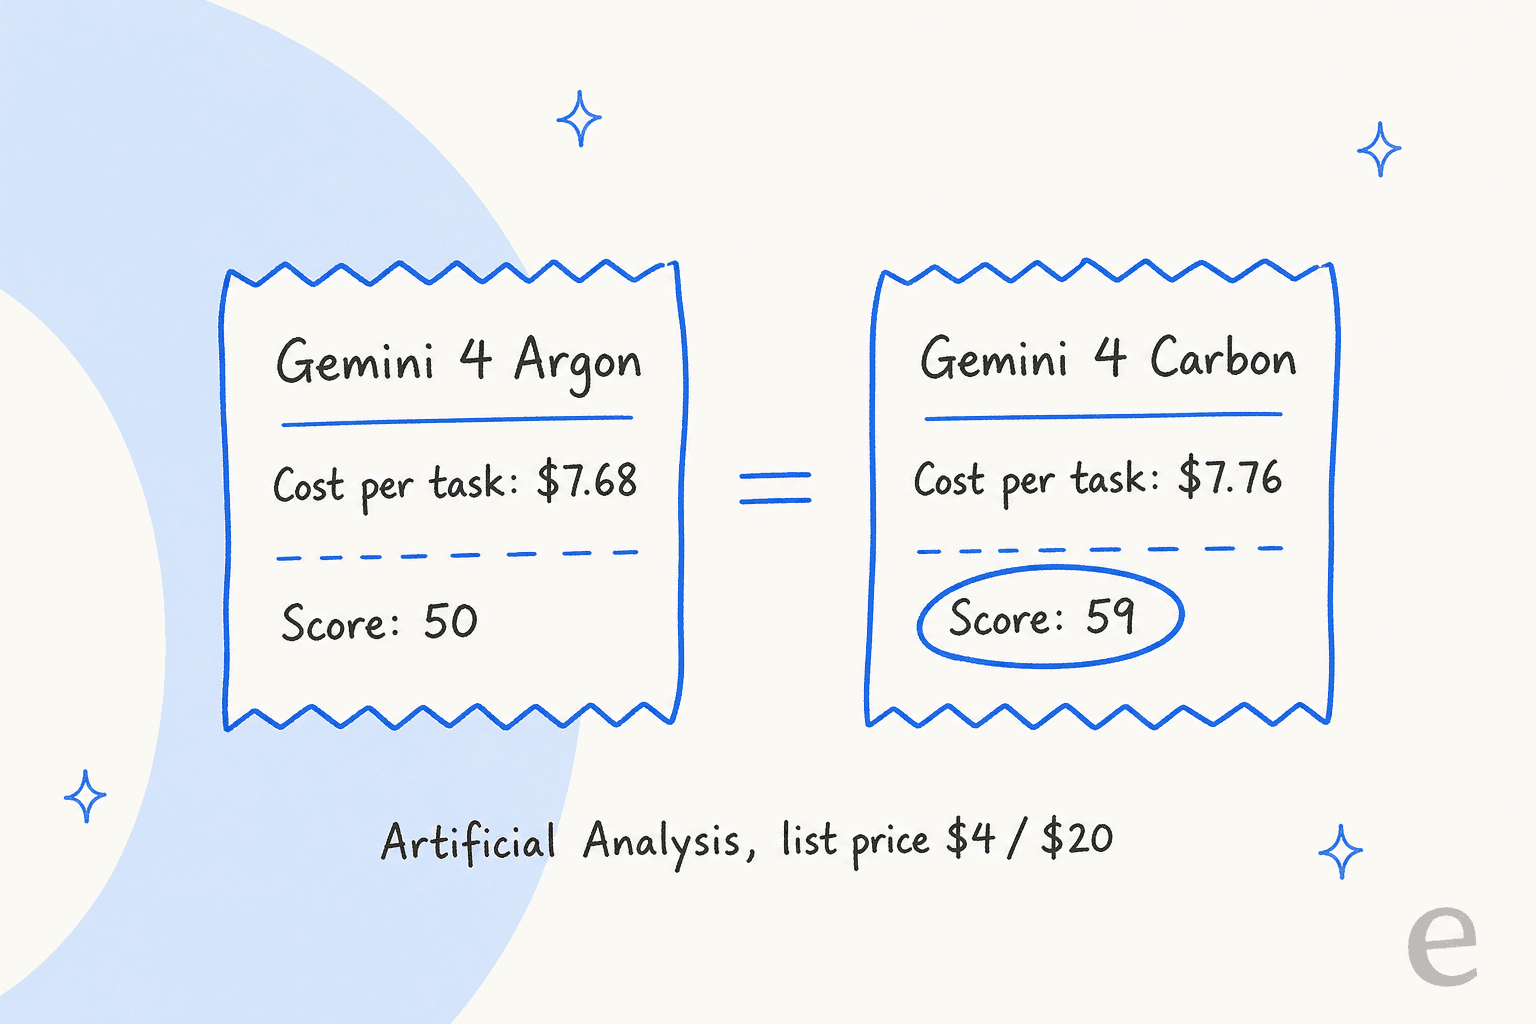
| Coût AA par tâche (tarif public) | $7.76 | $7.68 | $10.03 (Max) | $6.24 (Max) |
Le chiffre par tâche d'Artificial Analysis est celui qui compte. Carbon écrit un peu plus de tokens qu'Argon, donc une tâche coûte à peu près pareil pour un score supérieur de neuf points :
Pour le calcul de la promo, un calculateur de coûts et la destination réelle de l'argent dans une tâche (spoiler : surtout l'entrée en cache), consultez mon détail complet des tarifs de Gemini 4 Carbon. Le guide plus large des tarifs de Gemini couvre le reste de la gamme de Google.
Faut-il attendre Gemini 4 Carbon ?
Cela dépend de ce que vous en faites, voici donc comment je déciderais.
Déjà sur Argon ? Oui, attendez puis basculez. Même prix, même API, et meilleur sur chaque benchmark testé par Google. Une fois Carbon disponible pour vous, aucune raison de rester sur Argon.
Vous choisissez un modèle de pointe pour du codage agentique long ou du travail sur longs documents ? Carbon est le premier à tester à sa sortie. Les avances en contexte long et sur Terminal-Bench sont grandes, et à $2/$10 pendant la promo il sous-cote Opus 5.5 de moitié par token. Si vous ne pouvez pas attendre, mon panorama des alternatives à Gemini 4 Argon chiffre chaque option pour un acheteur.
Utilisation d'ordinateur ou pur génie logiciel ? Opus 5.5 mène toujours sur OSWorld-2.1 et Astra mène toujours sur FrontierSWE 2. Carbon est juste derrière sur les deux, mais « juste derrière » n'est pas une raison de changer.
Tâches courantes à fort volume ? Vous n'avez probablement pas besoin d'un modèle de pointe. Un commentateur a décrit une répartition qui correspond à ce que je ferais :
"I personally use 3.8 Flash most of the time and Argon/Carbon when I need to do deep analysis or research an ambiguous problem."
Les options à poids ouverts comme Kimi K3.1 Pro et DeepSeek V4.1 Flash valent aussi la peine d'être chiffrées pour ce type de volume. Pour un regard plus large sur la concurrence de Google, voir les alternatives à Gemini.
Que signifie Gemini 4 Carbon pour l'IA dans le support client ?
Moins que ce que suggère le tableau de benchmarks, avec une exception. La plupart des tickets de support n'ont pas besoin d'un modèle capable de trouver la cause racine d'un bug du noyau en trois jours. Une réponse à un ticket demande la bonne réponse issue de votre centre d'aide, avec votre ton, puis un transfert quand il n'est pas sûr. Les modèles plus petits et moins chers s'en sortent bien quand le système autour est bon.
L'exception, c'est l'honnêteté. L'affirmation de Google selon laquelle Carbon divise par deux les affirmations non étayées et "surfaces discrepancies to the user before acting" est le comportement que toute équipe de support veut, car une mauvaise réponse assurée à un client coûte plus cher qu'aucune réponse. Les hallucinations de l'IA dans le support ne tiennent toutefois que rarement au seul modèle. Elles viennent de connaissances manquantes, de règles floues et d'un agent autorisé à deviner. Un meilleur modèle réduit le problème, il ne le supprime pas.
J'ai construit les parties d'eesel qui entourent le modèle, et le schéma auquel je fais confiance est celui vers lequel Carbon est entraîné : chercher d'abord, répondre à partir de ce qu'on a trouvé, et le dire quand on n'a rien trouvé. Qontro, une entreprise d'ERP néo-zélandaise, fait tourner eesel ainsi sur Freshdesk. Chaque nouveau ticket reçoit un brouillon de réponse en note interne, ancré dans environ 9 800 anciens tickets et articles d'aide, avec les articles d'aide liés. Les pannes, les pertes de données et la facturation vont directement à une personne, et si un ticket ne contient pas assez d'éléments pour répondre avec confiance, eesel le dit au lieu de deviner. L'équipe compare chaque brouillon avec ce qu'elle a réellement envoyé et utilise les écarts pour améliorer le centre d'aide.
Cette dernière boucle, aucune sortie de modèle ne vous la donne. C'est aussi ainsi que vous mesureriez si un nouveau modèle aide : vous le faites tourner sur vos propres anciens tickets et vous comparez. Le coût du service client par IA d'une mauvaise réponse est le chiffre à surveiller, pas le coût par token.
Essayer eesel
Si l'argument « moins de réponses inventées » de Gemini 4 Carbon vous a attiré, vous pouvez avoir ce comportement dès maintenant sur votre file de support, sans attendre le déploiement de Google. Carbon est de l'infrastructure ; eesel est l'employé. Le coéquipier IA de helpdesk d'eesel apprend de vos anciens tickets et de votre centre d'aide, se connecte à Freshdesk, Zendesk et aux autres helpdesks que vous utilisez déjà, et transmet un ticket à une personne quand il ne peut pas étayer la réponse.
Vous pouvez lancer une simulation sur vos vrais anciens tickets avant qu'il ne réponde à qui que ce soit, pour voir ce qu'il aurait dit. Les offres sont un forfait de crédits mensuel fixe, à partir de $299 pour 500 crédits, et vous pouvez démarrer gratuitement avec 100 crédits. Essayez eesel sur une partie de votre file et comparez ses brouillons à vos propres réponses.