

Qu'est-ce qu'EmbeddingGemma 2 ?
EmbeddingGemma 2 est un modèle d'embeddings ouvert de Google DeepMind, annoncé le 6 octobre 2026.
Un modèle d'embeddings fait une seule chose : il transforme une entrée en une liste de nombres (un vecteur) pour que les éléments similaires se retrouvent proches. C'est le moteur de la recherche sémantique, du clustering et de la moitié « récupération » du RAG.
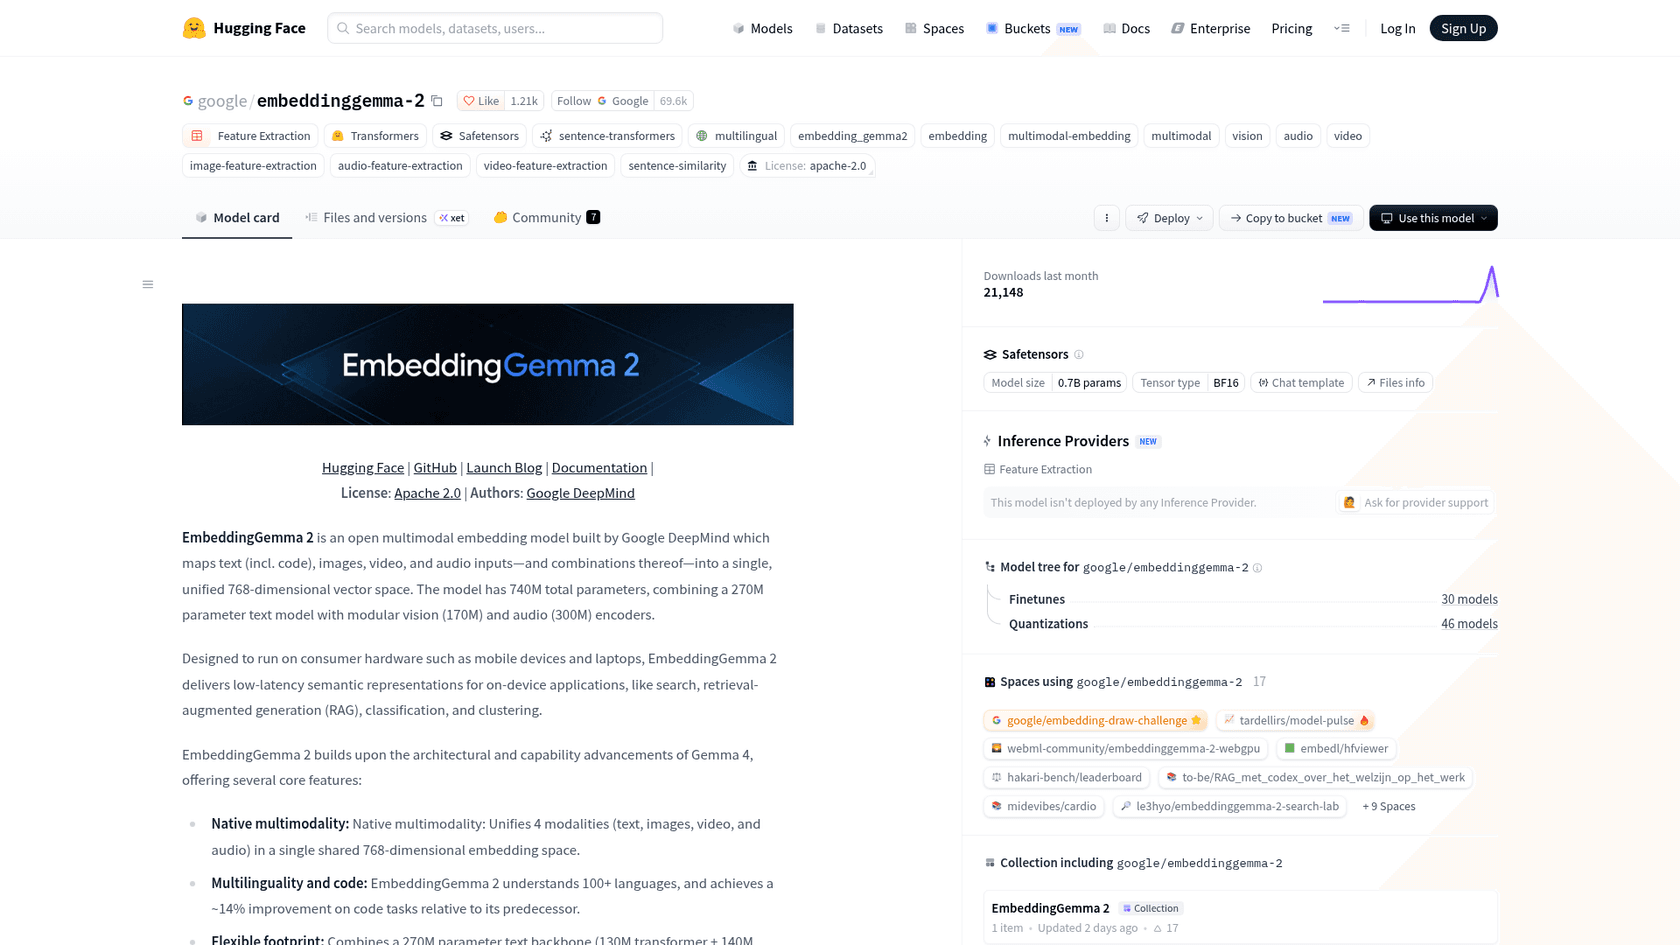
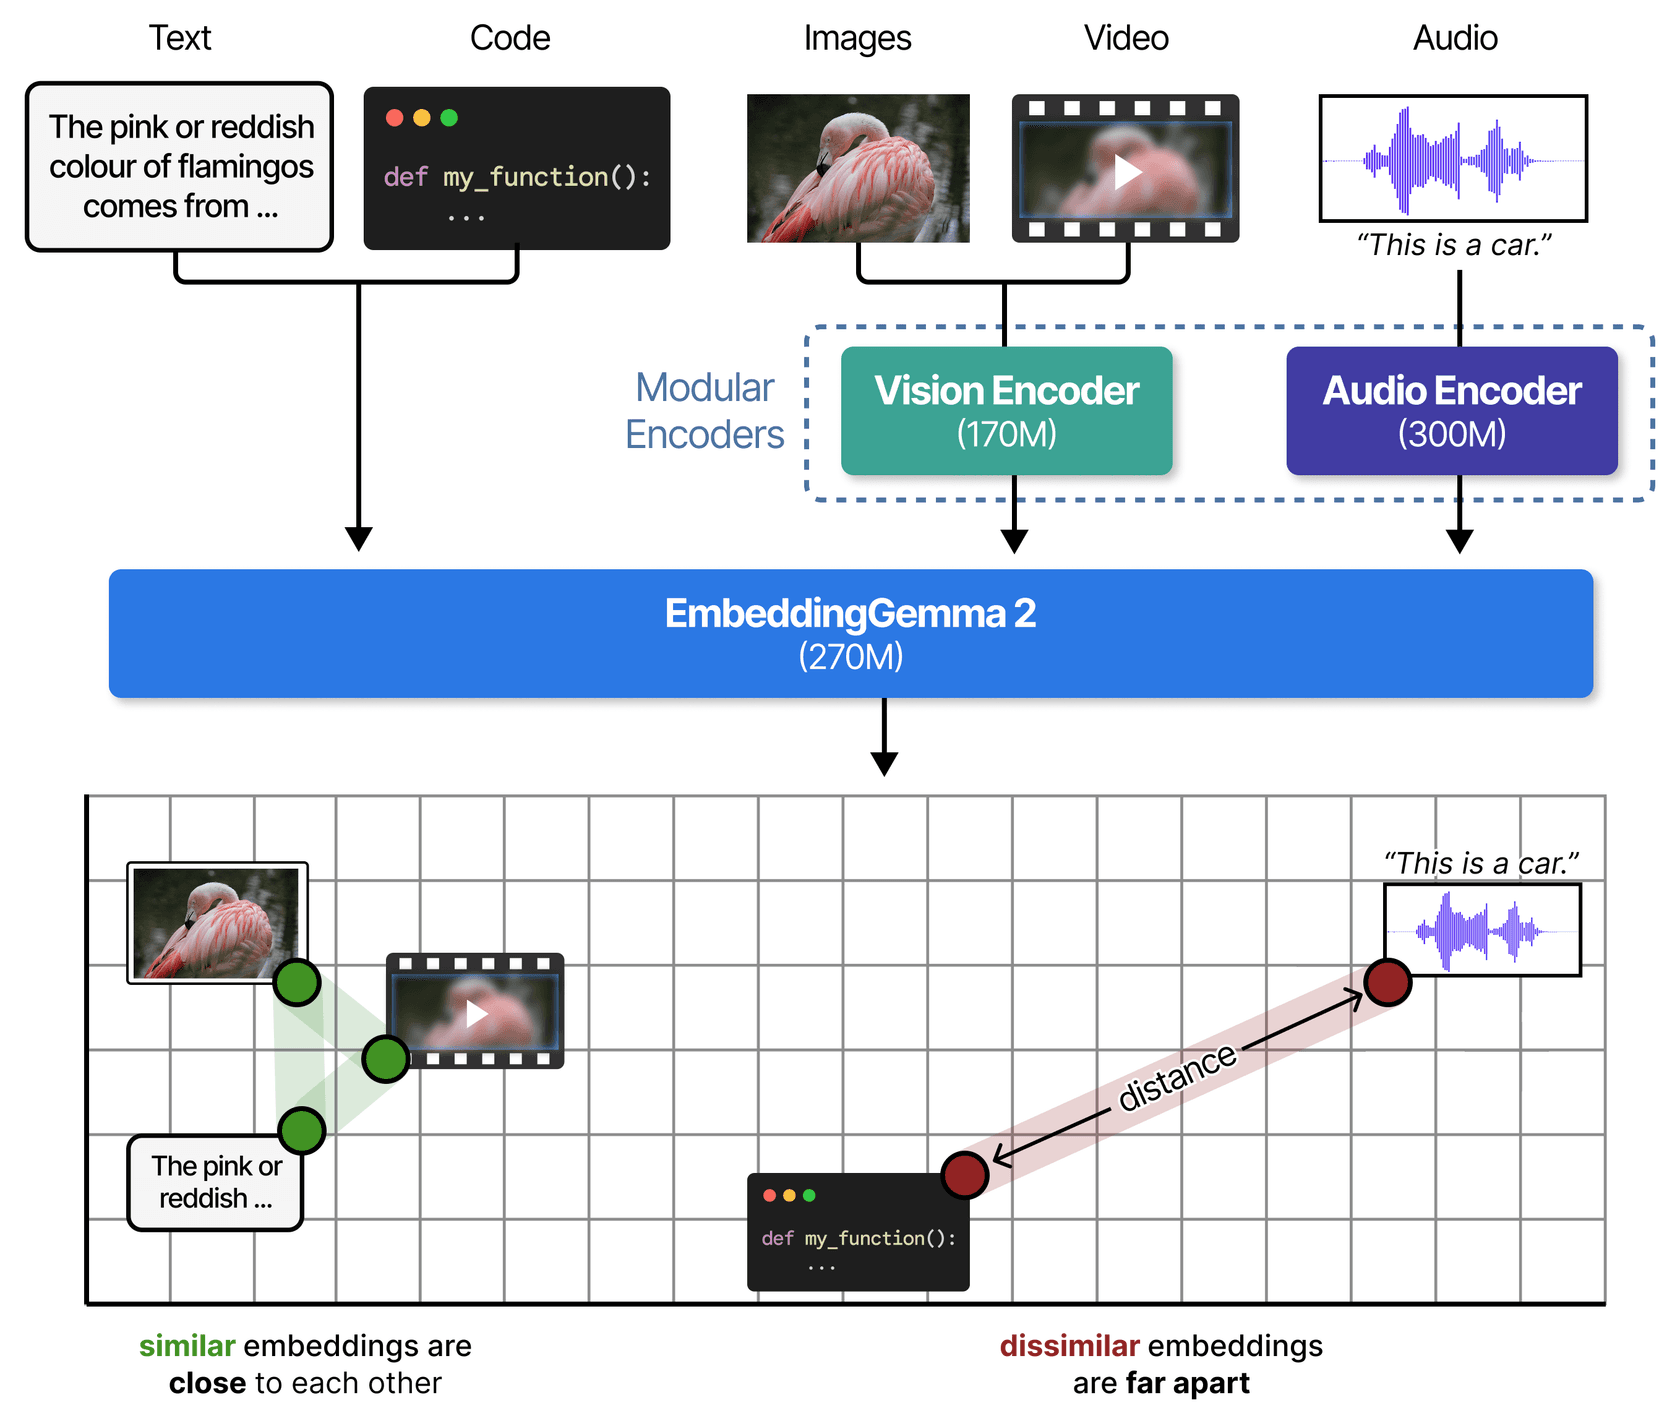
Le premier EmbeddingGemma, un modèle de 308M en texte seul, est sorti en 2025 et a dépassé les 20 millions de téléchargements, selon Google. La version 2 garde l'idée d'un petit modèle qui tourne partout et la rend multimodale avec quatre types d'entrée de plus. Selon la model card, elle projette le texte (code compris), les images, la vidéo et l'audio, ou n'importe quel mélange, dans un seul espace de 768 dimensions.
Un mot rapide sur mon point de vue. Je suis ingénieur logiciel chez eesel et je construis les agents IA qui interrogent le centre d'aide d'un client avant de répondre à un ticket. Quand je lis l'annonce d'un modèle d'embeddings, le classement m'intéresse moins que trois questions : qu'est-ce qu'il trouve que le précédent ratait, combien coûte son exécution et qu'est-ce qui casse. Je n'ai pas mis ce modèle en production. Mon avis vient de la model card et de la documentation de Google, du guide développeur et des trois premiers jours de retours pratiques sur Hacker News.
EmbeddingGemma 2 en un coup d'œil
| Spec | EmbeddingGemma 2 | Source |
|---|---|---|
| Publication | 6 octobre 2026 | Google blog |
| Paramètres | 740M au total : 270M texte, 170M vision, 300M audio | Model card |
| Entrées | Texte, code, images, vidéo, audio et mélanges entrelacés | Model card |
| Sortie | 768 dimensions, tronquables à 512, 256, 128 | Developer guide |
| Fenêtre de contexte | 8,192 tokens (v1 : 2,048) | Model card |
| Langues | Plus de 100 | Gemma docs |
| RAM, quantifié, Pixel 11 Pro | ~191MB texte seul, ~567MB complet | Google AI Edge |
| Licence | Apache 2.0 | Gemma docs |
| Prix | Poids gratuits ; vous payez le calcul | n/a |
| Base | Architecture de décodeur Gemma 4 | Gemma docs |
Comment fonctionne EmbeddingGemma 2 ?
Sous le capot, c'est un petit modèle de texte avec deux modules optionnels greffés à l'avant. Le cœur est un modèle de 270M de paramètres (un transformer de 130M plus un embedder de 140M) adapté du décodeur de Gemma 4. Un encodeur de vision de 170M gère les images, les images de vidéo et les documents visuels comme les PDF et les diapositives. Un encodeur audio de 300M prend la parole et le son bruts. Tout passe par le même socle et ressort sous la forme d'un seul vecteur de 768 nombres.
L'astuce, c'est que les modules sont optionnels au chargement. Vous mettez vision_config ou audio_config à None et cet encodeur n'est jamais chargé, ce qui économise disque et mémoire. Selon le guide développeur de Google, les quatre configurations se chargent depuis le même checkpoint et partagent un espace vectoriel. Une requête encodée avec la configuration texte seul de 270M peut correspondre à des documents encodés avec le modèle complet.
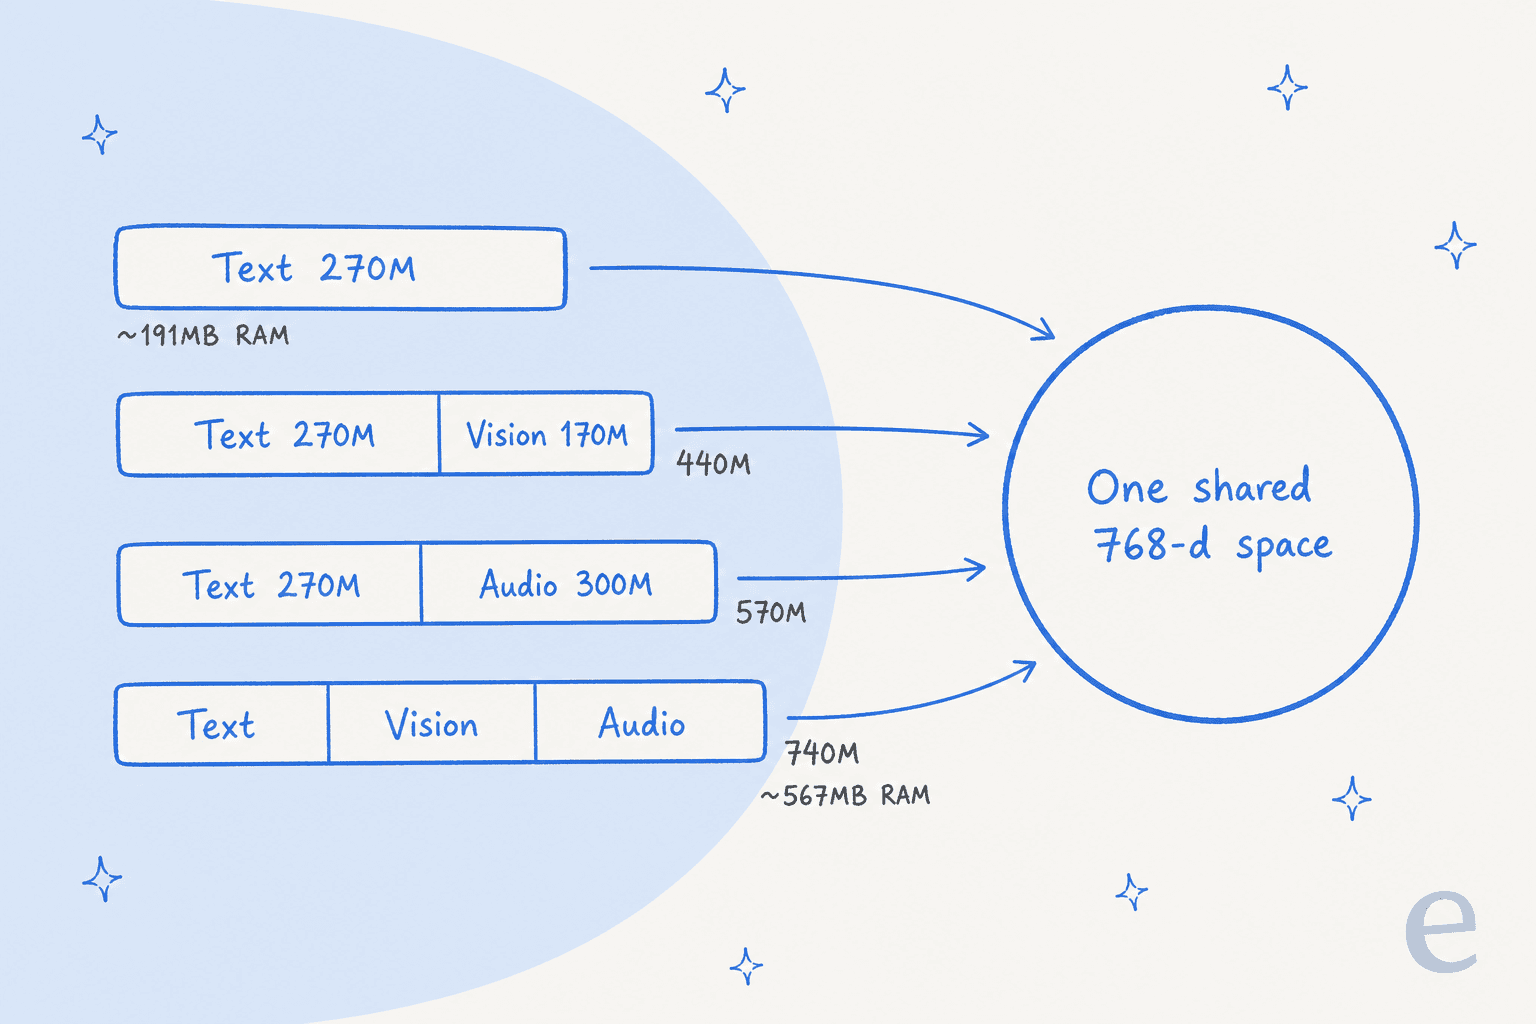
Cela a un avantage pratique que j'apprécie beaucoup. Vous pouvez commencer en texte seul et ajouter les images plus tard sans recalculer un seul vecteur existant, dit le guide. Si vous avez déjà dû régénérer les embeddings d'un million de documents parce que vous changiez de modèle, vous savez ce que cela vaut.
Les entrées se partagent la fenêtre de contexte de 8,192 tokens à des tarifs fixes, comptés en tokens. Une image coûte 280 tokens par défaut, une image de vidéo 140 et une seconde d'audio 25. Un seul appel peut donc contenir environ 29 images, 58 images de vidéo ou 327 secondes d'audio, selon la model card.
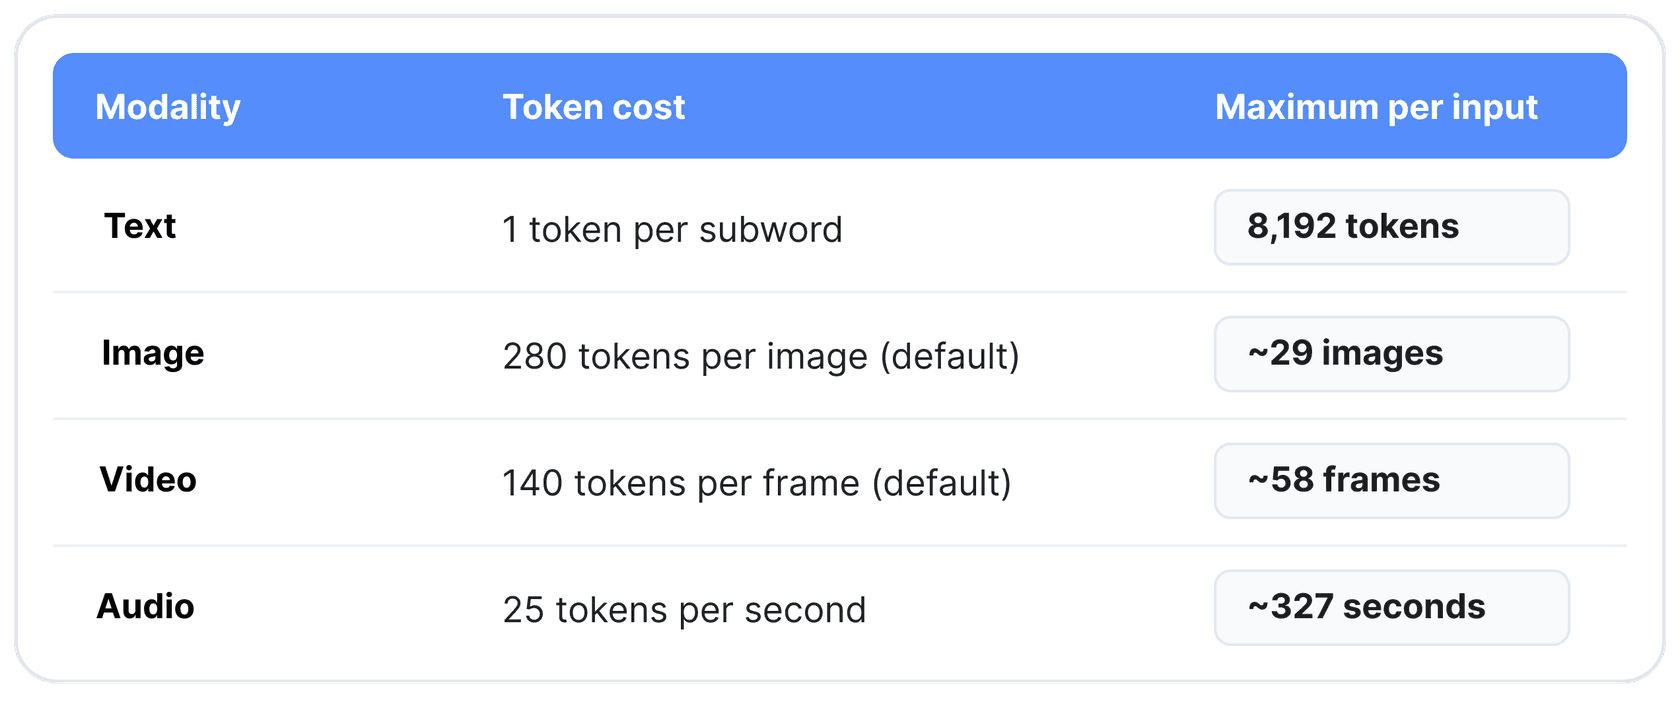
Quelques mécanismes à connaître avant d'écrire du code :
- La vidéo est échantillonnée à 1 image par seconde par défaut, et l'audio doit être en mono 16 kHz.
- Le niveau de détail d'une image est un réglage. La documentation multimodale liste cinq budgets par image : 70, 140, 280, 560 ou 1,120 tokens. Plus de tokens signifie plus de détail et des exécutions plus lentes.
- Vous pouvez entrelacer. Une entrée peut mêler du texte à des marqueurs
<|image|>,<|video|>et<|audio|>, comme une page produit avec une photo et un clip de démo, et elle ressort quand même sous la forme d'un seul vecteur. - Le texte reçoit un préfixe de tâche, pas les médias. Les requêtes ressemblent à
task: search result | query: ...et les documents àtitle: ... | text: .... Sauter le préfixe fonctionne, mais coûte en précision.
Qu'est-ce qui a changé par rapport à EmbeddingGemma 1 ?
C'est ici que je ralentirais, car le discours du lancement et les chiffres racontent des histoires légèrement différentes. L'annonce de Google dit que la v2 égale les performances multilingues de la v1 et bondit sur le code. C'est vrai. Mais la model card donne aussi MTEB anglais, et sur celui-ci la v2 est un peu en retrait.
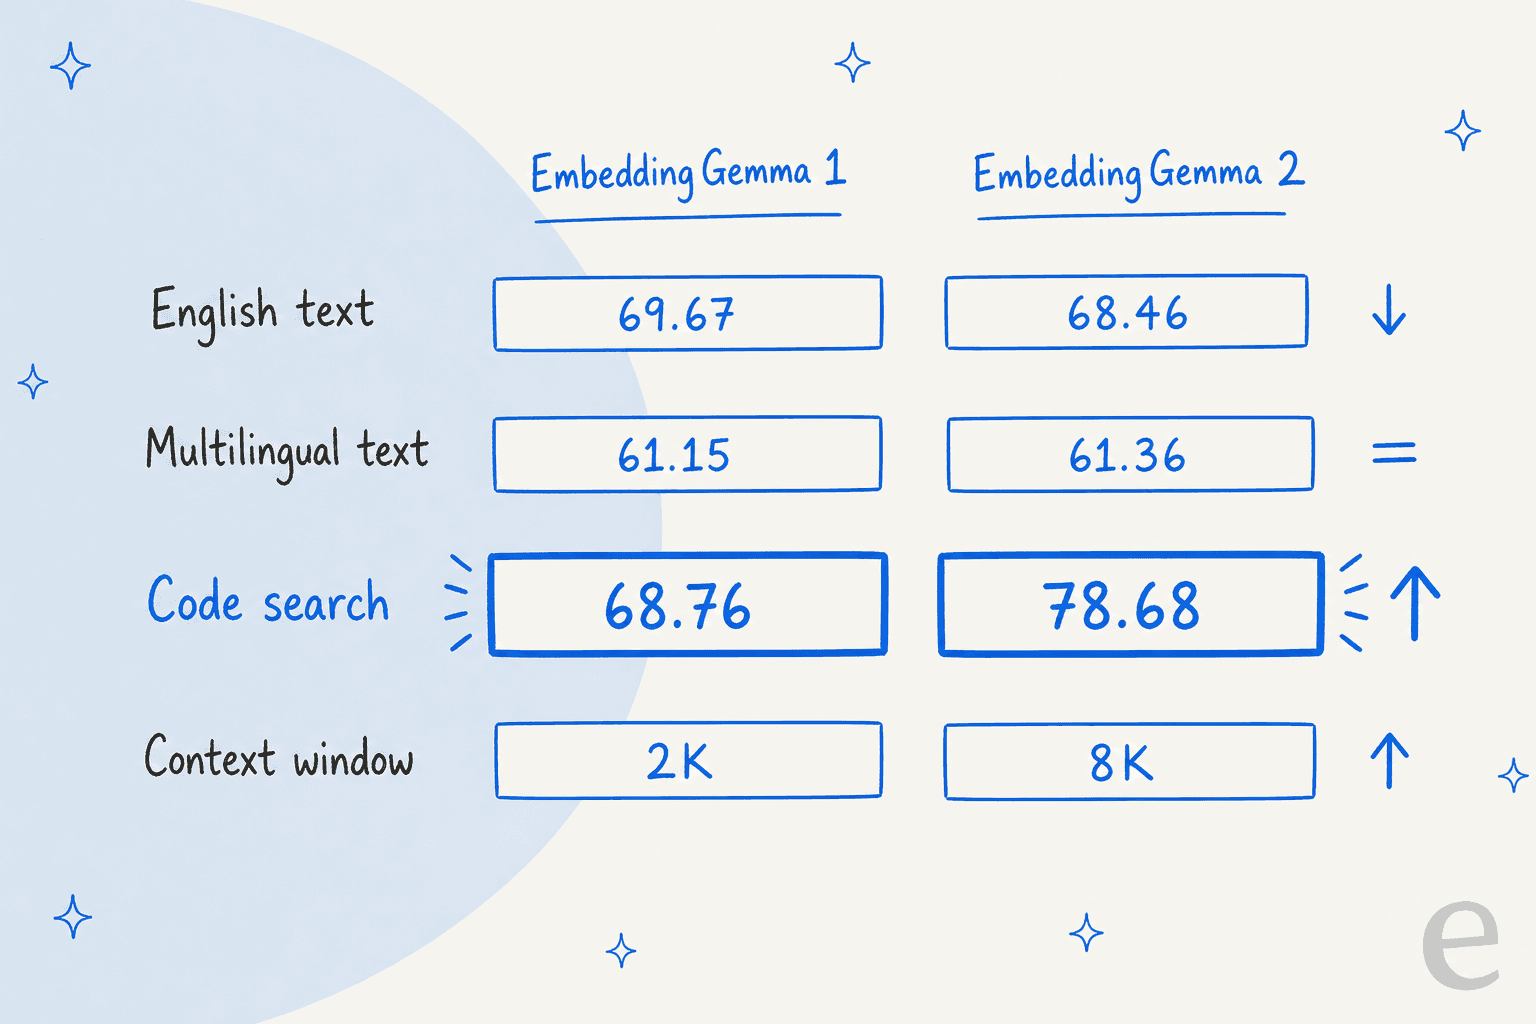
| Benchmark (768 dim.) | EmbeddingGemma 1 | EmbeddingGemma 2 | Écart |
|---|---|---|---|
| MTEB English v2 | 69.67 | 68.46 | -1.21 |
| MTEB Multilingual v2 | 61.15 | 61.36 | +0.21 |
| MTEB Code v1 | 68.76 | 78.68 | +9.92 |
| Fenêtre de contexte | 2,048 tokens | 8,192 tokens | 4x |
| Entrées | Texte | Texte, code, image, vidéo, audio | +4 |
| Licence | Conditions Gemma, téléchargement soumis à accès | Apache 2.0 | Ouverte |
Les chiffres de la v1 viennent de la card d'EmbeddingGemma 300M et ceux de la v2 de la card de la v2. Les premiers testeurs sont arrivés au même constat :
"for text, benchmarks are identical to the first EmbeddingGemma. but you can use this new one and enable/disable what you don't need. can keep only text for ex."

Ma lecture est simple. Si vous ne cherchez que du texte anglais, la v2 est un pas de côté, et la mise à niveau ne vaut le coup que si le contexte 4 fois plus long vous aide (moins de morceaux, mais plus gros) ou si la licence Apache débloque un produit. Si vous cherchez du code, ou autre chose que du texte, c'est un grand pas. Pour un centre d'aide fait surtout d'articles, mon avis sur RAG vs fine-tuning compte davantage que cette mise à niveau.
Ce que disent les nouveaux benchmarks
Pour les nouveaux types d'entrée, il n'y a pas de v1 à laquelle comparer, donc les scores de la model card parlent d'eux-mêmes. Google le qualifie de « best-in-class » parmi les modèles d'embeddings multimodaux de moins de 1B sur MTEB Code et MAEB, le benchmark audio. C'est une affirmation du fournisseur sans tableau comparatif direct sur la card, prenez-la donc comme point de départ.
| Entrée | Benchmark | Score |
|---|---|---|
| Image | MIEB lite | 64.64 |
| Image | MMEB v2 Image (Hit@1) | 57.28 |
| Documents visuels | MMEB v2 VisDoc (NDCG@5) | 67.84 |
| Vidéo | MMEB v2 Video (Hit@1) | 50.67 |
| Audio | MSEB Retrieval (MRR@10) | 69.54 |
| Audio | MAEB | 49.39 |
Deux choses que je soulignerais dans le fil HN. Un commentateur a demandé pourquoi il n'est pas comparé à SigLIP 2, le modèle image-texte de Google. Un autre l'a fait tourner en local et a constaté que l'exemple de classification zero-shot de la démo de Google elle-même se trompait :
"I got this running locally, and funnily enough the exact example they have for classifying "Cancel my flight and refund my credit card immediately." failed. It said the request does not involve a payment, charge, or refund, with a p(true) of 0.22 (where true means it is financial)."
Ça pique un peu pour qui envisage le routage de tickets, car « remboursement ou pas » est exactement le type d'étiquette que veut une équipe de support. Un seul exemple n'est pas un verdict, mais c'est une bonne raison de tester sur vos propres tickets avant de le brancher à quoi que ce soit.
Il y a aussi un piège plus discret dans la documentation multimodale : les scores de similarité ne sont pas calibrés d'une modalité à l'autre. Un tableau sans rapport a obtenu 0,585 face à une photo du Golden Gate, plus que des prompts texte sans rapport. Comparez le rang au sein d'une recherche, pas les scores bruts entre images et texte.
Quelle est vraiment sa vitesse et sa taille ?
C'est ici qu'EmbeddingGemma 2 mérite son étiquette « on-device ». L'équipe AI Edge de Google a publié des chiffres par appareil pour encoder une image avec un budget de 70 tokens :
| Appareil | Puce | Latence par image | Images/s |
|---|---|---|---|
| iPhone 18 Pro | CPU | 191 ms | 5.2 |
| iPhone 18 Pro | GPU | 69.8 ms | 14.3 |
| Pixel 11 Pro XL | NPU | 48.9 ms | 20.6 |
| MacBook M5 Pro | GPU | 37.3 ms | 26.9 |
| Dell XPS 16 | NPU | 49.8 ms | 20.1 |
| Raspberry Pi 5 | CPU | 1,761 ms | 0.6 |
Les chiffres réels d'un portable sont similaires. Un commentateur HN a partagé le débit sur un M3 Pro :
"Text: 78 embeddings/second on small texts - Image: 4 embeddings/second - Audio: 6 embeddings/second for 30 second chunks (which is how the encoder works) - Video: 0.2 embeddings/second per minute of video"
Notez l'écart. Une vidéo à 0,2 par minute de séquence signifie qu'une heure de vidéo prend environ cinq minutes à indexer sur ce portable. Très bien pour une bibliothèque de démos produit. Trop lent pour de la vidéo en direct à fort volume.
Le stockage est l'autre levier. Le modèle utilise l'entraînement Matryoshka : vous pouvez réduire les vecteurs de 768 nombres à 512, 256 ou 128 en conservant l'essentiel de la qualité. Selon le guide développeur, un million de vecteurs de 768 dimensions occupe environ 1,5GB en bfloat16, et environ 250MB à 128 dimensions.
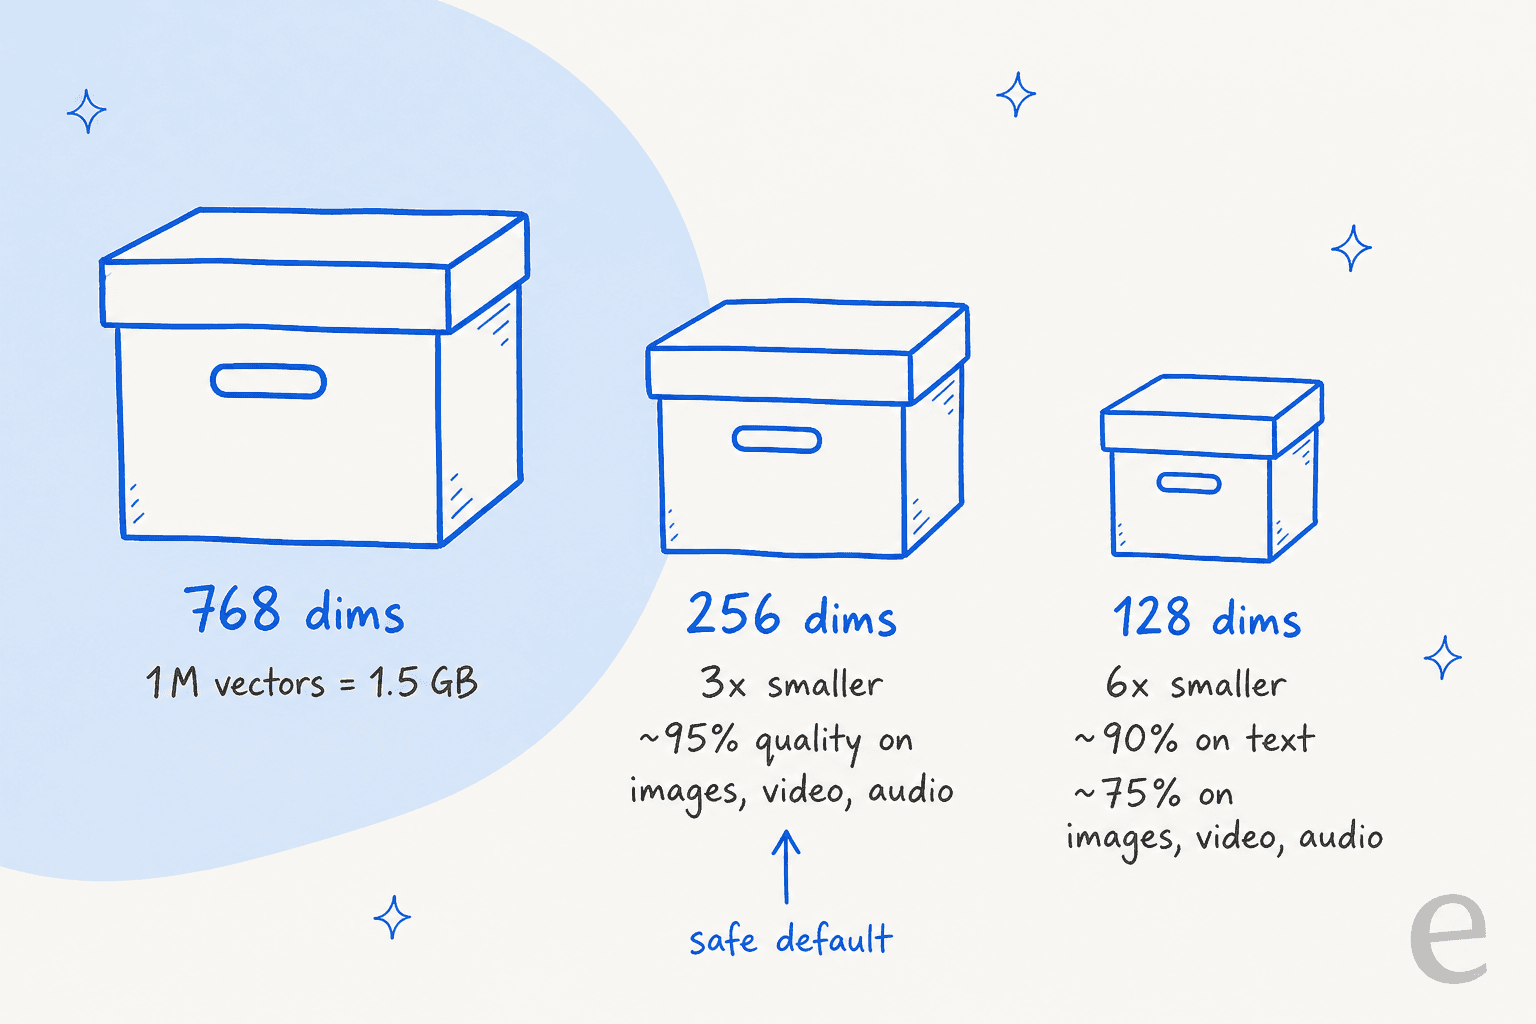
Le piège, c'est que les médias se dégradent plus vite que le texte quand on compresse. Sur la model card, MMEB v2 passe de 59,01 à 768 dimensions à 45,65 à 128. Pour un index mixte, je m'arrêterais à 256 dimensions et je n'irais à 128 que pour des présélections en texte seul que vous reclassez ensuite. Deux règles de la card qui vous mordront si vous les ignorez : renormalisez les vecteurs après troncature et ne le lancez jamais en float16. Les activations débordent et vous obtenez des NaN ou des vecteurs silencieusement moins bons, sans aucune erreur.
Quelle configuration d'EmbeddingGemma 2 faut-il charger ?
Comme vous ne payez la mémoire que pour les encodeurs chargés, la première décision est de savoir ce que contient réellement votre index. Choisissez l'option la plus proche :
Que contient votre index de recherche ?
Touchez une option pour voir la configuration avec laquelle je commencerais.
vision_config=None, audio_config=None. Remarque honnête : pour une recherche uniquement en anglais, la v1 a marqué un peu plus (69,67 contre 68,46). Changez si vous avez besoin du contexte de 8K ou d'Apache 2.0, pas pour la précision. 256 dimensions est une réduction de stockage sûre.CodeRetrieval pour les requêtes et mettez le nom du fichier dans le titre du document. Restez à 512 ou 768 dimensions ; le code perd de la qualité le plus vite à la troncature.audio_config=None. La vision couvre images, PDF, diapositives et graphiques (MMEB v2 VisDoc 67,84). Montez le budget d'image à 560 ou 1,120 tokens si vos captures contiennent du petit texte. Gardez 256 dimensions ou plus.vision_config=None. Rééchantillonnez l'audio en mono 16 kHz et découpez-le en segments ; un appel en contient environ 327 secondes. Il fait correspondre le contenu de la parole, pas seulement « ceci est de la parole », mais testez d'abord sur vos propres appels.Comment exécuter EmbeddingGemma 2 ?
Les poids sont sur Hugging Face et Kaggle (nouveau sur la plateforme ? commencez par mon explication de Hugging Face), et la prise en charge dès le premier jour est large : sentence-transformers (v6.1.0 ou ultérieure), Transformers, vLLM, SGLang, MLX, llama.cpp GGUF, Ollama, LM Studio et LiteRT, de Google, pour les téléphones. Le chemin le plus court, tiré de la model card :
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query_emb = model.encode("What causes the northern lights?", prompt_name="SearchQuery")
doc_emb = model.encode("The northern lights are caused by charged particles from the sun.", prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
Si vous préférez ne pas toucher à Python, la version Ollama s'intègre à la plupart des stacks RAG locales, et des frameworks comme LangChain et LlamaIndex le traiteront comme n'importe quel autre générateur d'embeddings.
Pour un exemple concret de support, voyez mon tutoriel sur le pipeline RAG de support ou ce guide de recherche sémantique dans Zendesk. Il vous faut toujours un endroit où stocker les vecteurs ; Qdrant a publié un guide le jour du lancement, et mon article sur RAG vs bases de données vectorielles explique comment choisir.
Sur téléphone, Google l'amène sur Android sous forme de service géré ML Kit « dans les semaines à venir », avec accélération NPU. D'ici là, l'application AI Edge Gallery est le moyen le plus simple de l'essayer. Sa démo Instant Media Search fouille votre pellicule pendant que vous tapez, hors ligne, et Video Moments Finder saute à des horodatages pour des requêtes comme « chien attrapant un frisbee » sans transcription.
Faut-il l'héberger soi-même ou utiliser Gemini Embedding 2 ?
C'est le deuxième recadrage que je propose. EmbeddingGemma 2 se télécharge gratuitement, et l'on suppose souvent que cela en fait l'option économique. Pour la plupart des équipes, elle n'est pas beaucoup moins chère, car le cousin hébergé de Google est déjà très bon marché.
Gemini Embedding 2 est l'API payante d'embeddings multimodaux de Google, et c'est le seul modèle d'embeddings de la grille tarifaire actuelle de l'API Gemini. (Si vous comparez l'API de Google plus largement, voyez API OpenAI vs API Gemini.) Mon article sur les tarifs de Gemini couvre le reste ; voici les tarifs des embeddings :
| Entrée | Standard (par 1M de tokens) | Batch | Par unité (standard) |
|---|---|---|---|
| Texte | $0.20 | $0.10 | n/a |
| Image | $0.45 | $0.225 | $0.00012 par image |
| Audio | $6.50 | $3.25 | $0.00016 par seconde |
| Vidéo | $12.00 | $6.00 | $0.00079 par image |
Voici un exemple chiffré pour une équipe de support de taille moyenne. Disons 2,000 articles d'aide d'environ 800 tokens chacun (1,6M de tokens), 10,000 captures d'écran produit et 100 heures d'appels enregistrés :
- Articles : 1,6M de tokens x $0.20 = $0.32
- Captures d'écran : 10,000 x $0.00012 = $1.20
- Appels : 360,000 secondes x $0.00016 = $57.60
Cela fait moins de $60 pour encoder toute la bibliothèque une fois au tarif standard, et la moitié en batch. Un GPU loué aux $1 à $2 de l'heure cités par un commentateur HN tournerait plus longtemps que ça rien que pour démarrer. Je formulerais donc le choix ainsi :
- Utilisez Gemini Embedding 2 si vos données peuvent aller vers l'API de Google et que vous voulez zéro configuration. Notez simplement que les données de l'offre gratuite peuvent servir à améliorer les produits de Google ; celles de l'offre payante, non.
- Utilisez EmbeddingGemma 2 si les données ne peuvent pas quitter l'appareil ou vos propres serveurs (santé, juridique, support interne), si vous en avez besoin hors ligne ou si vous encodez des requêtes sur un téléphone sans aller-retour. Ce sont de vraies raisons. Le coût seul n'en est généralement pas une.
Simon Willison a bien plaidé pour les modèles d'embeddings ouverts :
"I really appreciate that EmbeddingGemma 2 is under the Apache 2.0 license. For embedding models in particular, I don't think it makes sense to use a closed, proprietary, hosted-only model."
Son point concerne plus l'enfermement chez un fournisseur que le prix. Chaque vecteur de votre index est lié au modèle qui l'a produit. Si un modèle hébergé est retiré, vous devez tout régénérer. Avec des poids ouverts, le modèle avec lequel vous avez indexé reste disponible tant que vous en gardez une copie.
Pourquoi les équipes de support devraient s'intéresser à la partie multimodale
Voici l'angle que je n'ai pas vu dans la couverture du lancement. La plupart des écrits sur le RAG pour le service client supposent que la connaissance est du texte. En pratique, une bonne part ne l'est pas, et cela revient constamment dans les appels commerciaux d'eesel.
Une marque DTC de compléments alimentaires, avec environ 7,000 tickets par mois, a dit que ses réponses vivaient dans des SOP ClickUp, des vidéos Loom non transcrites et d'anciennes macros. Une société informatique du secteur public qui traite environ 3,000 tickets complexes par mois fonctionne sur Freshdesk avec une documentation technique riche en images. Les équipes de produits techniques réclament sans cesse une IA capable de lire les schémas dans leurs PDF et les photos que les clients joignent aux tickets. Les modèles d'embeddings en texte seul ne voient rien de tout cela tant que quelqu'un ne l'a pas transcrit ou légendé, ce qui explique pourquoi tant d'outils de base de connaissances pour le support traitent encore les médias comme une pièce jointe, pas comme une réponse.
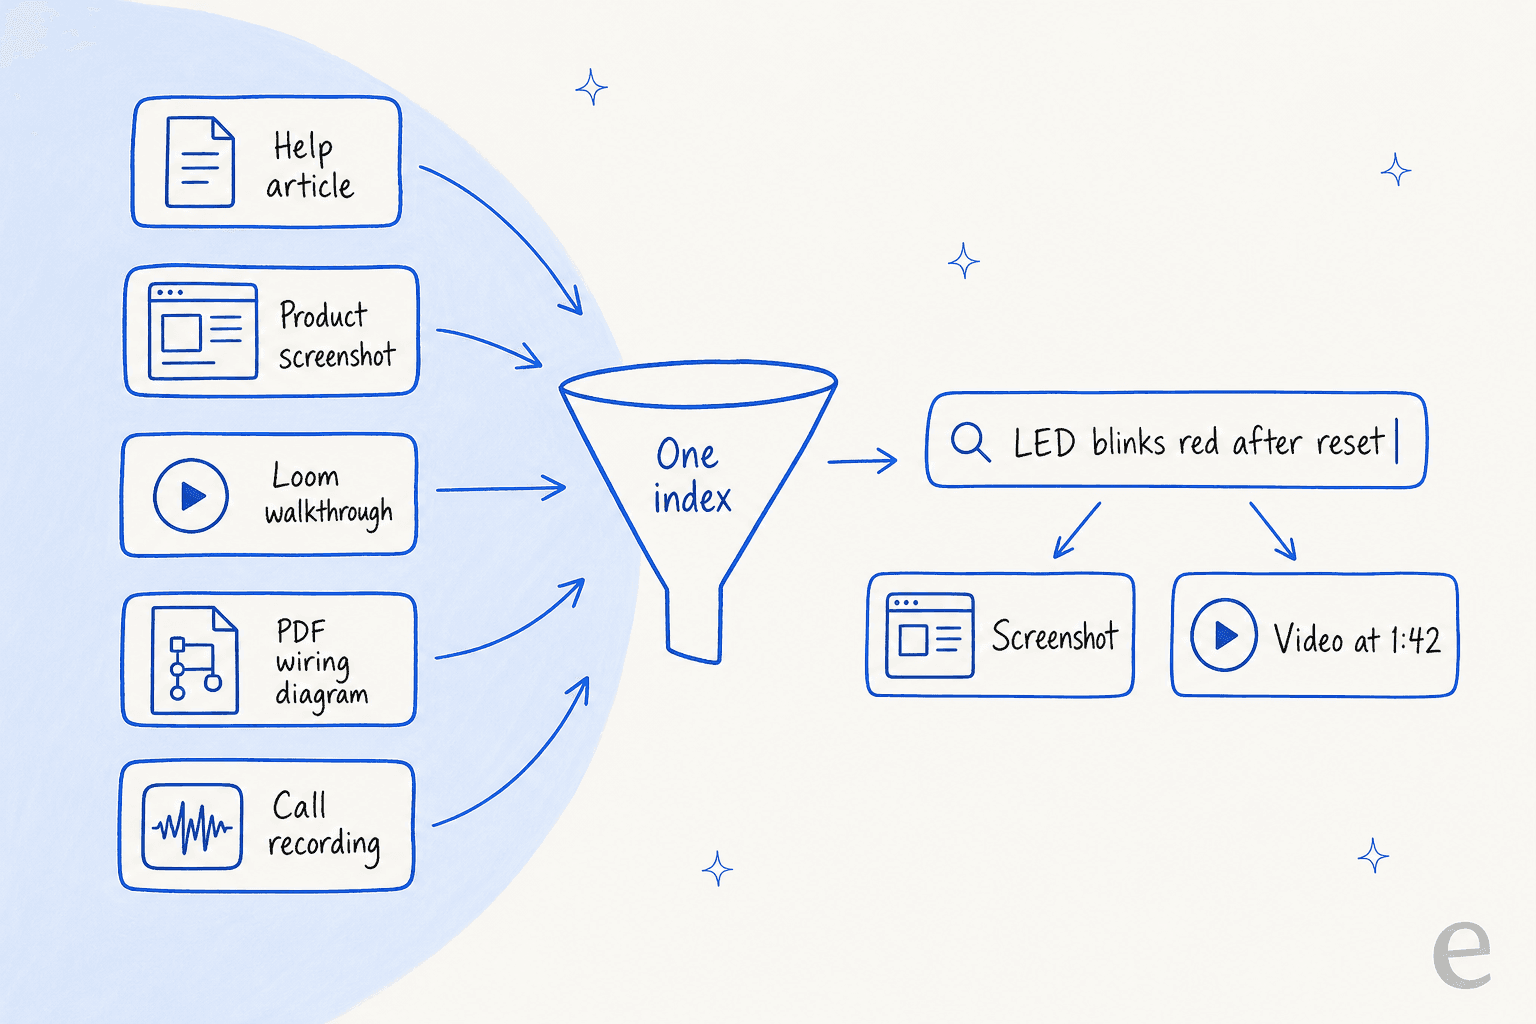
Un espace partagé est la solution. Indexez la capture, le tutoriel et l'article ensemble, et une requête texte comme « la LED clignote en rouge après la réinitialisation » peut ramener la bonne image de la bonne vidéo. Un lecteur de HN, avocat, a décrit la même idée pour des dossiers judiciaires :
"I could imagine using it to search a case file for "undamaged roof before Hurricane Katrina" and "damaged roof after Hurricane Katrina" and being able to locate both deposition testimony and pertinent photographs in the body of evidence."
Mais la récupération n'est que la moitié d'un bot de support, et d'après mon expérience ce n'est pas la moitié qui fait mal. Plus tôt cette année, quelques clients payants d'eesel, dont un fournisseur danois d'énergie solaire, ont vu leur bot inventer des réponses quand la recherche dans la base de connaissances revenait vide. Il comblait le vide avec les données d'entraînement du modèle, un cas d'école d'hallucination d'IA, et envoyait de faux détails d'abonnement à de vrais clients.
Un meilleur générateur d'embeddings n'aurait rien changé. Une règle stricte « pas de correspondance, on passe à un humain » l'a réglé, plus la simulation du bot sur d'anciens tickets avant la mise en ligne. Si vous construisez sur EmbeddingGemma 2, prévoyez cette couche dès le premier jour ; mon guide pour empêcher les hallucinations de l'IA couvre les schémas.
Qui devrait utiliser EmbeddingGemma 2 ?
| Vous êtes | Mon avis |
|---|---|
| En train de construire une recherche sur une base de code ou une mémoire pour agents de code | Utilisez-le. +9,92 points sur MTEB Code est le gain le plus net de cette version. |
| En train de chercher dans des photos, captures d'écran, PDF, audio ou vidéo | Utilisez-le, à 256 dimensions ou plus, et testez sur vos propres fichiers. |
| En train de livrer une recherche sur appareil ou hors ligne dans une application | Utilisez-le. 191MB pour le texte, c'est assez petit pour un téléphone, et la prise en charge d'Android ML Kit arrive. |
| Déjà sur EmbeddingGemma 1 pour du texte anglais seulement | Restez-y, sauf si vous avez besoin du contexte de 8K ou de la licence Apache. |
| En train d'exécuter la recherche de support dans le cloud sans limite de données | Gemini Embedding 2 demande moins de travail pour à peu près le même prix. |
| En quête d'un bot de support qui fonctionne, pas d'un pipeline | Sautez la construction. Le modèle n'est qu'une pièce sur cinq. |
Pour des comparaisons avec d'autres options, mes articles sur Cohere Embed 5 et l'API d'embeddings d'OpenAI couvrent les principales alternatives hébergées, et les petits modèles de langage approfondit la tendance on-device dont ce modèle fait partie.
Pour un tour d'horizon plus large, mon panorama des outils de récupération de connaissances compare les produits finis.
Le verdict
EmbeddingGemma 2 est une version bonne et honnête. La conception modulaire est maligne, la licence Apache lève un vrai blocage, et la recherche de code et multimodale fait un net progrès dans un format assez petit pour un téléphone. Si vos données ne sont pas que du texte, c'est le premier modèle ouvert que j'essaierais.
Lisez simplement au-delà du titre. Pour le texte anglais, il est au même niveau que le modèle qu'il remplace, les affirmations « best-in-class » viennent de Google et, pour la plupart des équipes dans le cloud, l'API hébergée coûte à peu près autant que de l'exécuter soi-même. Choisissez-le pour la confidentialité, l'usage hors ligne, le code ou les médias, et vous serez content. Choisissez-le en attendant un grand bond sur la recherche de texte brut, et vous n'en verrez pas.
Essayer eesel
Si vous êtes ici parce que vous pensez construire un bot de support sur un nouveau modèle d'embeddings, voici le raccourci : le modèle d'embeddings retrouve des passages, mais quelqu'un doit encore les lire, rédiger la réponse et savoir quand se taire. Le coéquipier IA de helpdesk d'eesel fait ce travail dans Zendesk, Freshdesk ou Gorgias. Il apprend de votre centre d'aide, de votre documentation dans des outils comme Confluence et Google Docs, et de vos anciens tickets, puis lance une simulation sur des centaines de vos vrais tickets pour que vous voyiez ses réponses avant un client. Quand la recherche revient vide, il confie le ticket à une personne au lieu de deviner.

Il existe un plan gratuit avec 100 crédits et sans carte, et les plans payants figurent sur la page des tarifs. Essayez eesel et rejouez les tickets du mois dernier avant de construire quoi que ce soit.
Comment EmbeddingGemma 2 se compare-t-il à Gemini Embedding 2 ?