

La meilleure alternative à Gemini 4 Carbon pour la plupart des équipes est Gemini 4 Argon, le modèle sur lequel Carbon est construit : il est disponible sur l'API aujourd'hui au même prix de lancement de $2/$10, et il a inventé des réponses dans 4% des cas contre 11% pour Carbon sur Artificial Analysis. Carbon lui-même est réservé aux défenseurs en cybersécurité via le Fairwind Program de Google, sans date pour tous les autres.
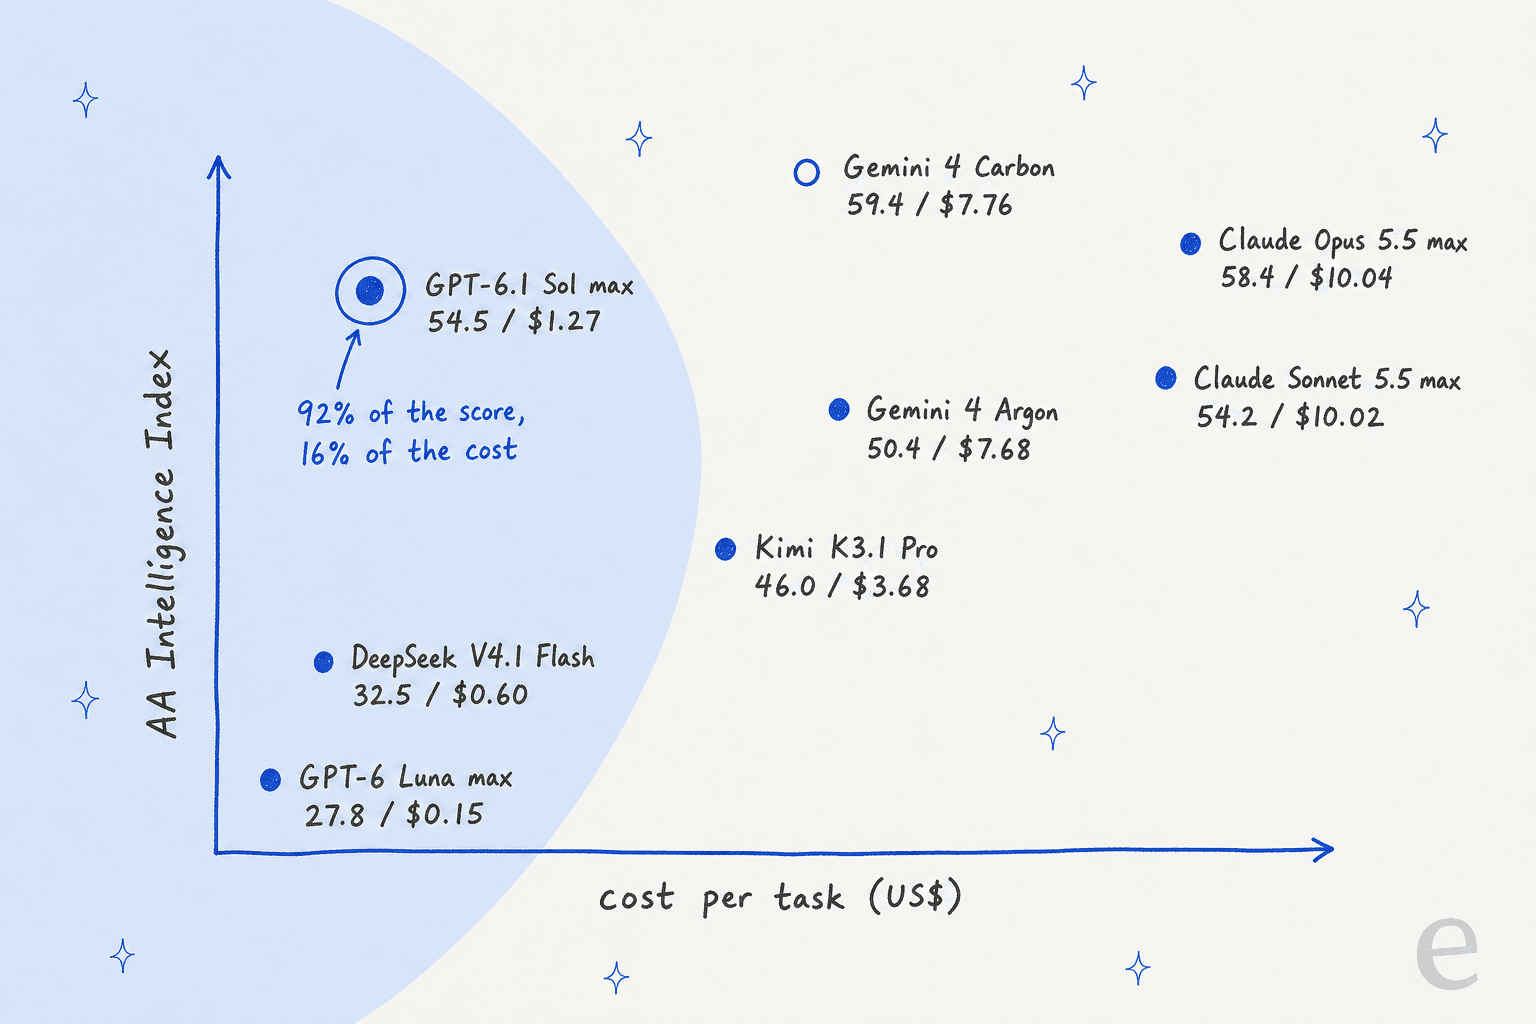
Si vous vouliez Carbon pour son score, GPT-6.1 Sol à effort maximal atteint 92% du score d'index de Carbon pour 16% du coût par tâche ($1,27 contre $7,76). Claude Opus 5.5 est le plus proche en score brut (58,4) mais le plus cher par tâche. Kimi K3.1 Pro, DeepSeek V4.1 Flash et GPT-6 Luna couvrent le contexte long, les poids ouverts et le tri à bas coût.
Si vous aviez Carbon en tête pour un agent de support, le modèle compte moins que ce qu'il lit. Je construis les intégrations derrière eesel, où un coéquipier helpdesk IA répond à partir de votre centre d'aide et de vos anciens tickets avec n'importe lequel de ces modèles ; SamCart fait tourner un agent sur les tickets Freshdesk et un autre sur le chat de son site, en répondant à partir de 280 articles d'aide.
Pourquoi cherche-t-on des alternatives à Gemini 4 Carbon ?
Parce que presque personne ne peut l'utiliser. Google a annoncé Gemini 4 Carbon le 28 octobre 2026 et a dit que "starting this week" il va à un sous-ensemble de défenseurs en cybersécurité, puis progressivement à davantage de partenaires de confiance, les développeurs, entreprises et consommateurs étant listés sous "coming soon". Il n'y a pas de date pour ce dernier groupe.
La porte d'entrée est le Fairwind Program, que Google décrit comme un accès anticipé pour des défenseurs prioritaires "like governments, healthcare providers, and telecommunications services". Il travaille avec plus de 650 partenaires et mène des vérifications d'antécédents sur les organisations candidates. Si vous dirigez une équipe de support ou un produit SaaS, ce n'est pas vous, du moins pour l'instant.
C'est un peu dommage, parce que Carbon est solide. Il domine l'Artificial Analysis Intelligence Index avec 59,4, bat Argon sur les 17 lignes du tableau de benchmarks de Google lui-même, et se lance au prix d'Argon : $2 par million de tokens en entrée et $10 par million en sortie, puis $4/$20 après la période de lancement. J'ai tout passé en revue dans mon explication de Gemini 4 Carbon.
Le fil Hacker News sur le lancement (735 points) a plutôt bien résumé l'humeur :
"I can't tell if they're withholding access to manufacture some sense of scarcity but the delays are really prolonged."

Le précédent d'Argon aide, un peu. Argon a été annoncé le 30 septembre et publié le 13 octobre, environ deux semaines plus tard, comme l'a souligné un commentateur de Hacker News. Mais Argon n'a jamais été réservé à un programme de sécurité, donc je ne planifierais pas le lancement d'un produit en comptant sur le même calendrier pour Carbon.
Comment j'ai choisi ces alternatives
Je suis parti de là où partirait un acheteur. J'ai demandé à ChatGPT, dans une nouvelle conversation, les meilleures alternatives pour un agent de support IA maintenant que Carbon est réservé à la cybersécurité. Il a présélectionné GPT-6.1 Sol, Gemini 4 Argon, Claude Sonnet 5.5 et GPT-6 Luna, et suggéré une configuration à deux modèles où un modèle bon marché fait le tri et un modèle plus fort prend les cas difficiles. Les quatre figurent dans cette liste, et cette idée de routage structure la dernière section.
Ensuite j'ai ajouté les modèles qui concurrencent Carbon sur ses propres benchmarks, et j'ai vérifié chaque prix sur la page tarifaire du fournisseur le 29 octobre 2026. Les données de notation viennent d'Artificial Analysis, qui a fait passer Carbon, Argon et les autres dans le même index au prix catalogue. J'ai relevé trois chiffres par modèle :
- Intelligence Index v5.0, le score phare que Carbon domine.
- Coût par tâche, ce qu'une tâche de l'index a réellement coûté au prix catalogue, tokens de raisonnement compris. C'est ce chiffre qui dit si une grille tarifaire bon marché l'est vraiment en pratique.
- Taux d'hallucination sur AA-Omniscience : à quelle fréquence le modèle donne une réponse fausse alors qu'il aurait dû dire qu'il ne savait pas. Pour tout ce qui fait face aux clients, c'est celui qui m'importe le plus.
eesel met des agents IA sur des files de support réelles depuis des années, et nous avons vu des bots à l'air sûr d'eux donner discrètement de mauvaises réponses. C'est pourquoi chaque déploiement eesel tourne désormais sur les tickets historiques d'une équipe avant de répondre à un vrai client, et pourquoi la colonne d'hallucination pèse ici autant que le score phare.
Les alternatives à Gemini 4 Carbon en un coup d'œil
Voici toute la liste dans un tableau. Les prix sont les tarifs d'API standard par million de tokens au 29 octobre 2026. Les chiffres AA correspondent au réglage d'effort le plus élevé de chaque modèle sauf mention contraire, au prix catalogue.
| Modèle | Utilisable aujourd'hui ? | Entrée / sortie (par 1M) | Entrée en cache | AA Index v5.0 | Coût AA par tâche | Taux de réponses inventées | Fenêtre de contexte | Poids ouverts | Idéal pour |
|---|---|---|---|---|---|---|---|---|---|
| Gemini 4 Carbon (référence) | Défenseurs en cybersécurité uniquement | $2 / $10 lancement, puis $4 / $20 | 95% de remise sur l'entrée | 59.4 | $7.76 | 11% | 1M | Non | Sécurité et code, si vous obtenez l'accès |
| Gemini 4 Argon | Oui, Gemini API | $2 / $10 jusqu'au 30 nov., puis $4 / $20 | $0.10, puis $0.20 | 50.4 | $7.68 | 4% | 1,048,576 | Non | Le moins de réponses inventées |
| GPT-6.1 Sol | Oui, OpenAI API | $2 / $10 | $0.10 | 54.5 | $1.27 | 52% | 1,050,000 | Non | Meilleur score par dollar |
| Claude Opus 5.5 | Oui, Claude API | $4 / $20 | $0.20 | 58.4 | $10.04 | 50% | 1M | Non | Score brut le plus proche |
| Claude Sonnet 5.5 | Oui, Claude API | $2 / $10 | $0.10 | 54.2 | $10.02 | 43% | 1M | Non | Qualité d'écriture, usage d'outils |
| Kimi K3.1 Pro | Oui, Kimi API | $2 / $10 | $0.20 | 46.0 | $3.68 | 37% | 1,048,576 | Pas encore | Contexte long, travail d'agent |
| DeepSeek V4.1 Flash | Oui, DeepSeek API | $0.15 / $0.60 heures creuses, $0.30 / $1.20 heures de pointe | $0.003 heures creuses | 32.5 | $0.60 | 64% | 1M | Oui | Auto-hébergement, facture la plus basse |
| GPT-6 Luna | Oui, OpenAI API | $0.10 / $0.50 | $0.01 | 27.8 | $0.15 | 79% | 1,050,000 | Non | Tri et routage à bas coût |
Deux choses ressortent. D'abord, cinq de ces modèles partagent la grille de $2/$10 de Carbon, donc le prix par token ne les distingue pas. Le coût par tâche, si, car il capture le nombre de tokens que chaque modèle brûle à réfléchir. Ensuite, la colonne des réponses inventées va de 4% à 79%, un écart bien plus grand que celui des scores d'index.
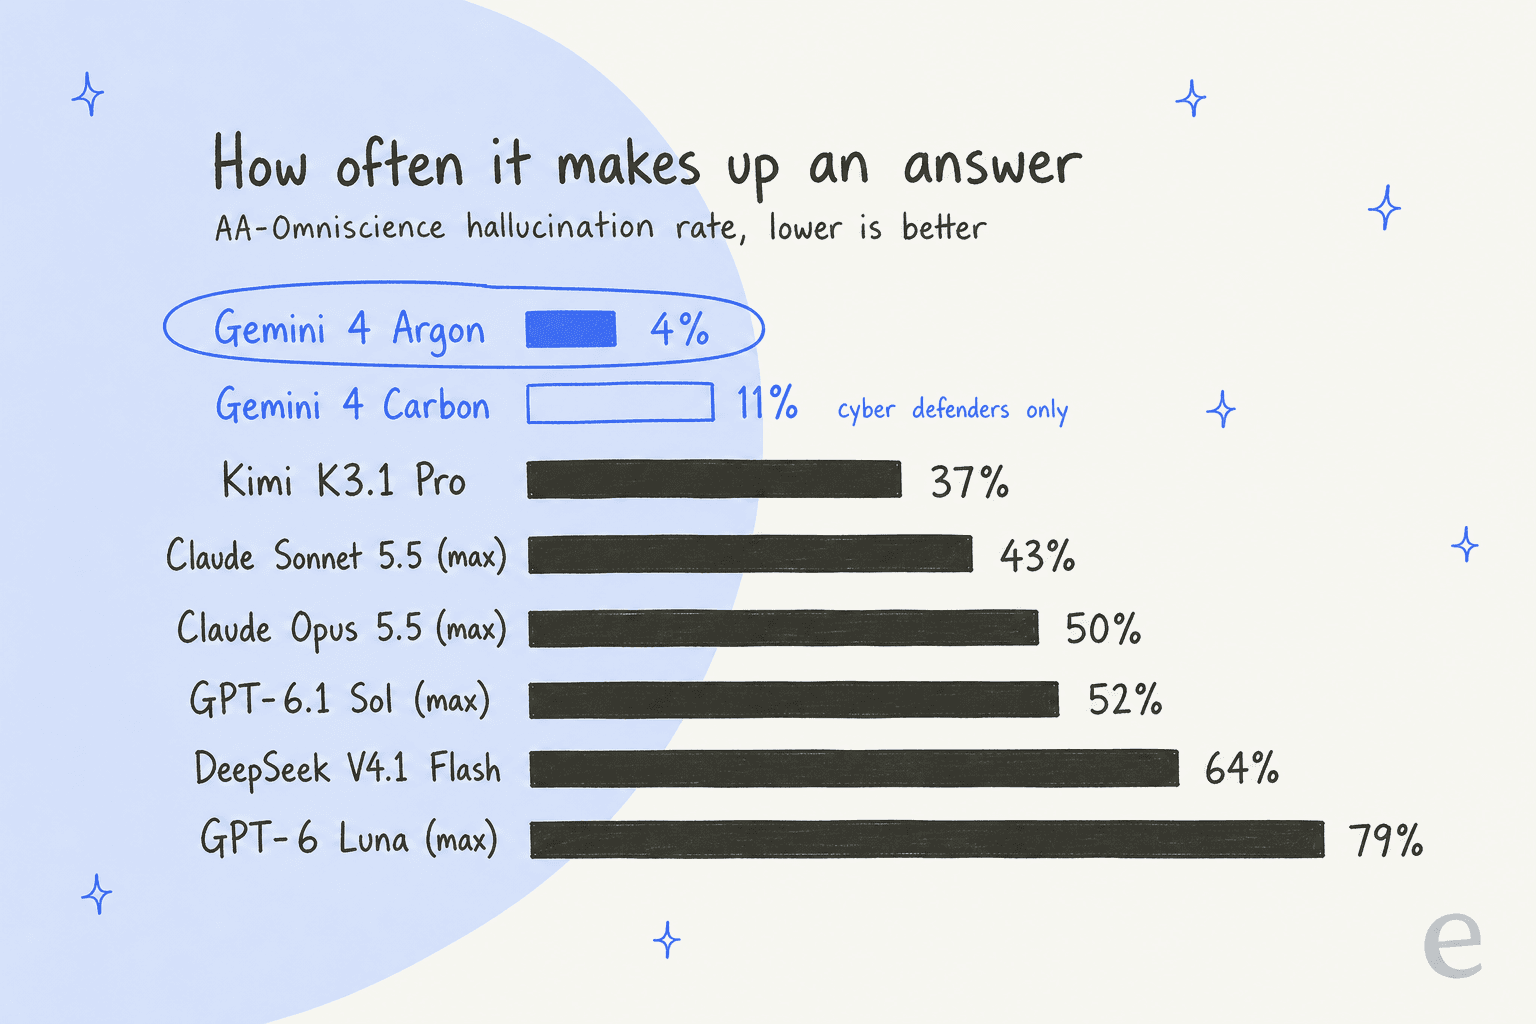
Ce graphique explique pourquoi mon premier choix n'est pas le modèle au score le plus proche. Si Carbon vous attirait parce que Google dit qu'il est plus honnête sur ce qu'il ne sait pas, Argon le devance déjà sur ce test précis.
1. Gemini 4 Argon
Idéal pour : les équipes qui voulaient Carbon pour un agent en contact avec les clients et qui ont besoin de moins de réponses inventées plus que d'un score plus élevé.
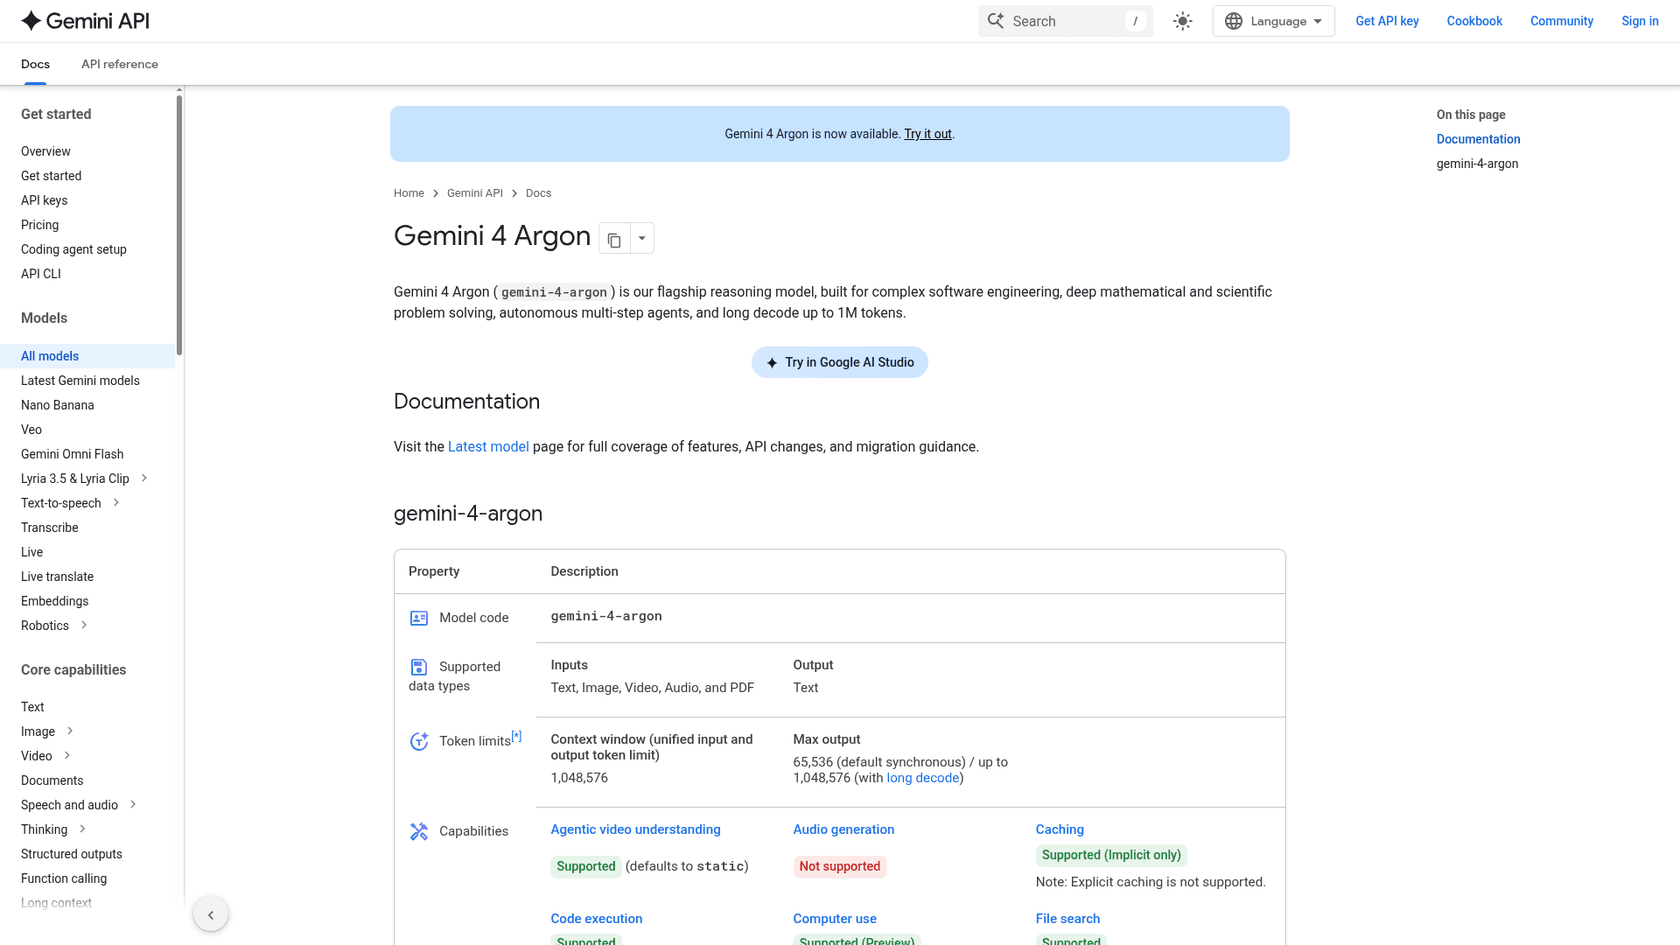
Argon est le modèle sur lequel Carbon est construit, c'est donc la première étape évidente. Il est disponible en général via l'API Gemini et Google AI Studio, avec une fenêtre de contexte de 1 048 576 tokens et jusqu'à 1M de tokens de sortie avec long decode. Si votre code appelle déjà Gemini, passer plus tard à Carbon est un simple changement de nom de modèle.
Sur Artificial Analysis, Argon obtient 50,4 contre 59,4 pour Carbon, donc Carbon est le modèle le plus intelligent. Mais le taux d'hallucination d'Argon est de 4% contre 11% pour Carbon, le plus bas de tous les modèles que j'ai vérifiés, et sur AutomationBench (flux de travail métier à plusieurs étapes) il a obtenu 77,5% contre 77,8% pour Carbon. Argon a même coûté légèrement moins par tâche d'index ($7,68 contre $7,76). Pour un agent de support, l'écart qui compte vraiment est assez faible.
"For what it's worth: Argon is a pretty good model, and this is coming from someone who just sticks with Opus 5.5 mostly across the board. For the current introductory price, it provides an exceptional value."
Avantages
- Même grille tarifaire que Carbon, donc votre modèle de coûts ne changera pas quand Carbon s'ouvrira.
- Le taux de réponses inventées le plus bas de cette liste, de loin.
- Le Google Search grounding inclut 5 000 requêtes gratuites par mois.
Inconvénients
- C'est un grand réfléchisseur : 116K tokens de sortie par tâche AA, donc la facture par tâche est élevée pour son score.
- Cache implicite uniquement. Vous ne pouvez pas épingler un cache explicitement comme sur Claude.
- Tout le monde ne l'apprécie pas. Un utilisateur de Hacker News l'a qualifié de "a clear tier below" par rapport aux modèles actuels de Claude et Sol.
Tarifs
| Niveau (par 1M de tokens) | Entrée | Sortie | Entrée en cache |
|---|---|---|---|
| Standard, jusqu'au 30 nov. 2026 | $2.00 | $10.00 | $0.10 |
| Standard, à partir du 1er déc. 2026 | $4.00 | $20.00 | $0.20 |
| Batch ou Flex, jusqu'au 30 nov. | $1.00 | $5.00 | $0.05 |
| Priority, jusqu'au 30 nov. | $3.60 | $18.00 | $0.18 |
Le grounding de recherche, c'est 5 000 requêtes gratuites par mois, puis $14 pour 1 000, selon la page tarifaire de Google. Il n'y a pas de niveau gratuit pour Argon. Mon article sur les tarifs de Gemini 4 Argon détaille la hausse de décembre.
Mon avis : commencez ici si vous construisez quoi que ce soit qui répond à des clients. Prévoyez le doublement de prix du 1er décembre, et si vous avez surtout besoin de vitesse et de coût, regardez plutôt Sol. J'ai couvert d'autres options dans mon tour d'horizon des alternatives à Gemini 4 Argon.
2. GPT-6.1 Sol
Idéal pour : les équipes qui voulaient l'intelligence de Carbon mais surveillent la facture.
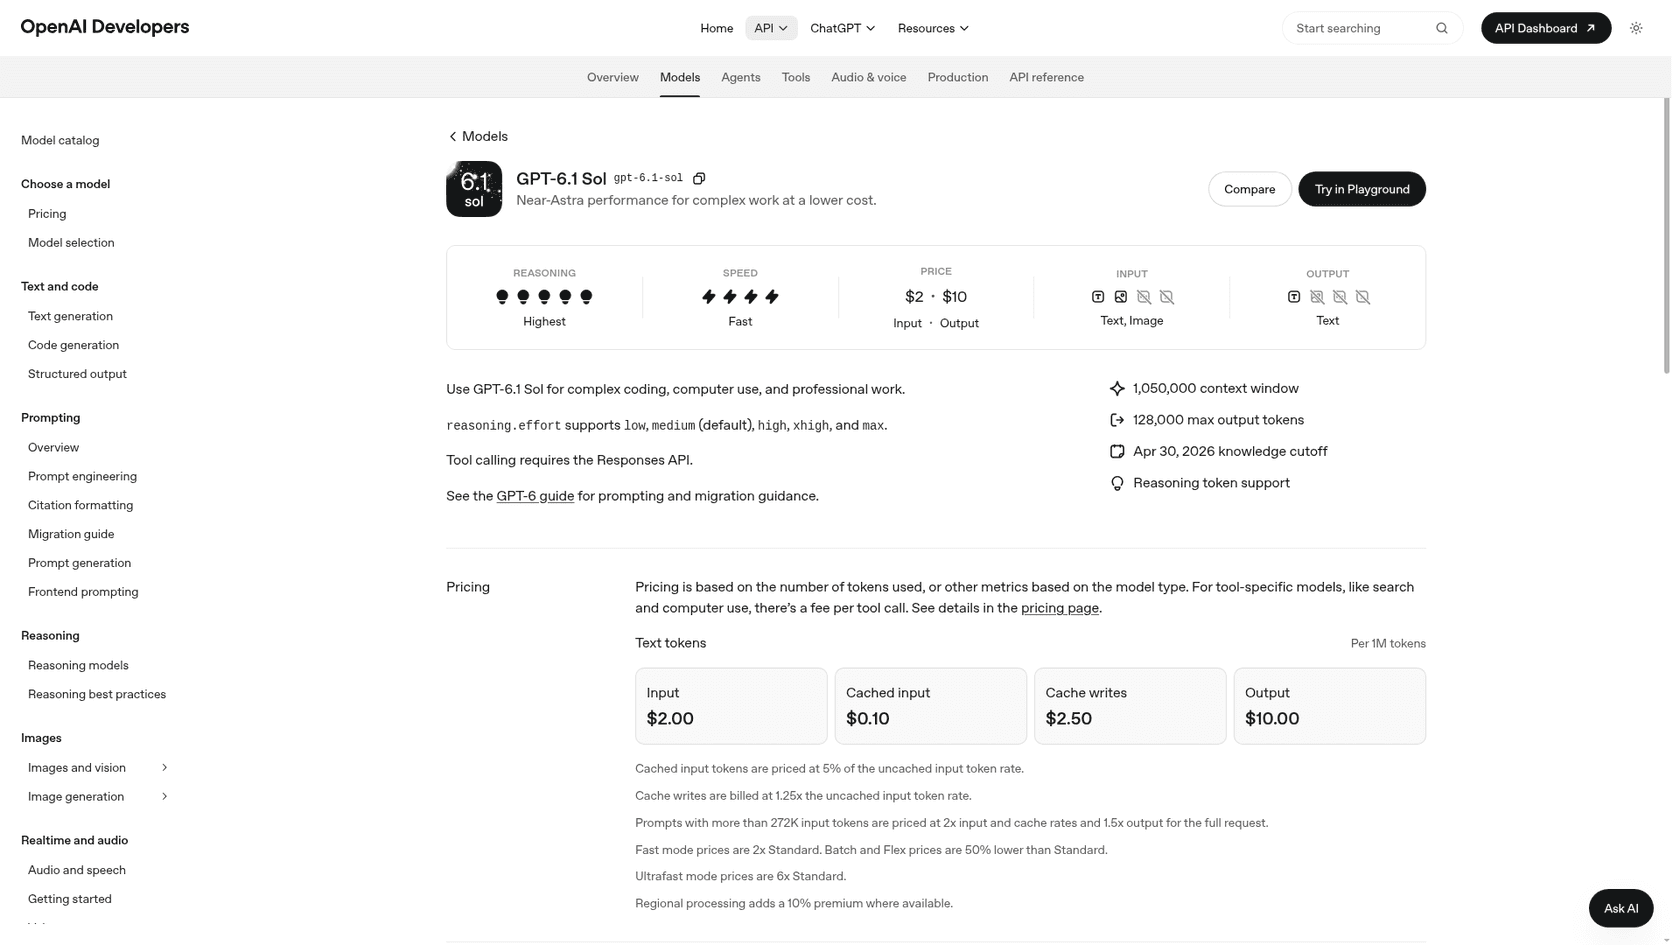
Sol a été la première suggestion de ChatGPT pour un agent de support, et les chiffres la confirment. La page du modèle d'OpenAI le qualifie de "Near-Astra performance for complex work at a lower cost", avec une fenêtre de contexte de 1 050 000 tokens et un effort de raisonnement de low à max.
À effort maximal, Sol obtient 54,5 sur l'index d'Artificial Analysis pour $1,27 par tâche, contre $7,76 pour Carbon. Cela fait 92% du score de Carbon pour 16% du coût. En xhigh, c'est 52,3 pour $0,76, et en medium 46,1 pour $0,36, le réglage avec lequel je démarrerais un agent de support.
Avantages
- Le meilleur score par dollar de toute cette liste.
- Cinq niveaux d'effort, donc un seul modèle peut couvrir les tickets simples et difficiles.
- Le tarif batch divise la facture par deux, à $1/$5, pour tout ce qui peut attendre.
Inconvénients
- A inventé des réponses dans 52% des cas sur AA-Omniscience à effort maximal. Il doit être ancré dans votre propre contenu.
- Le tool calling exige la Responses API, donc l'ancien code Chat Completions demande une migration.
- Les prompts de plus de 272K tokens d'entrée sont facturés 2x en entrée et 1,5x en sortie.
Tarifs
| Mode (par 1M de tokens) | Entrée | Sortie | Entrée en cache |
|---|---|---|---|
| Standard | $2.00 | $10.00 | $0.10 |
| Batch / Flex | $1.00 | $5.00 | $0.05 |
| Fast | $4.00 | $20.00 | $0.20 |
| Ultrafast | $12.00 | $60.00 | $0.60 |
Les prix viennent de la page tarifaire d'OpenAI. Mon guide des tarifs de GPT-6.1 Sol contient des exemples chiffrés.
Mon avis : le choix par défaut si vous n'avez pas de raison de rester chez Google. Ne le laissez simplement pas répondre aux clients de mémoire. Mon test de GPT-6.1 Sol couvre ses faiblesses.
3. Claude Opus 5.5
Idéal pour : les équipes qui veulent ce qui se rapproche le plus du score de Carbon et sont prêtes à le payer.
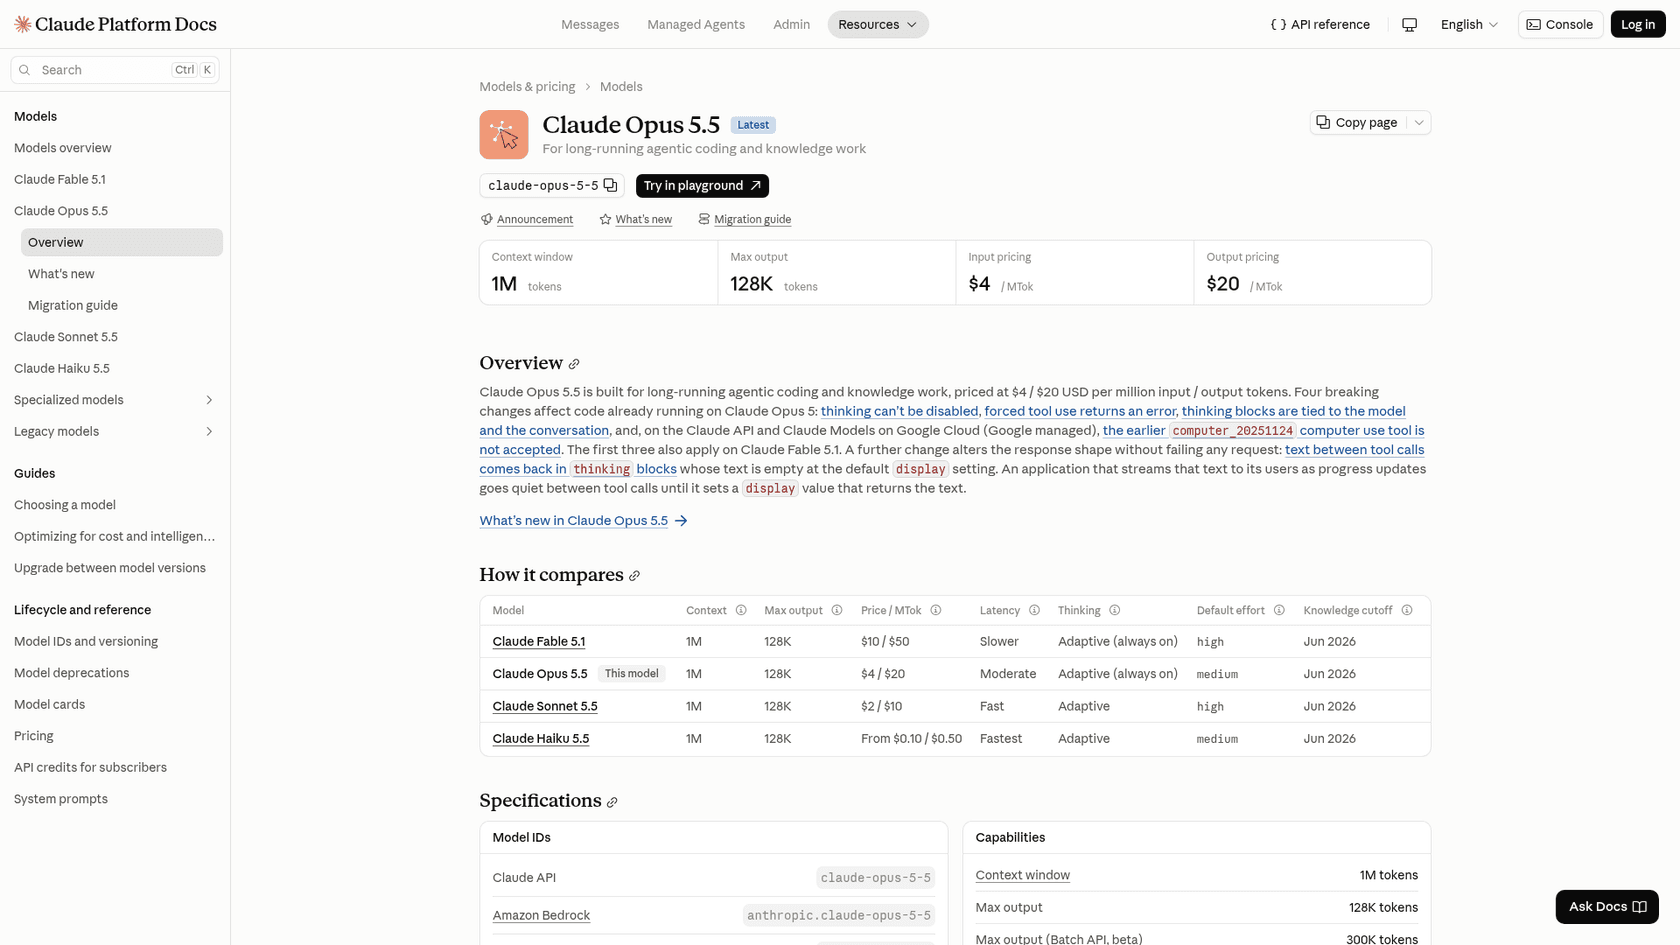
Opus 5.5 est le modèle que Carbon n'a battu que de peu. Sur Artificial Analysis il obtient 58,4 à effort maximal, un point derrière les 59,4 de Carbon, et dans le tableau de Google lui-même il domine encore l'usage d'ordinateur OSWorld-2.1 avec 87,2% contre 81,5% pour Carbon. Anthropic le positionne pour "long-running agentic coding and knowledge work".
Le hic, côté argent, c'est la facture. À effort maximal une tâche AA a coûté $10,04, le plus élevé de cette liste. Xhigh est le meilleur compromis : 57,0 pour $6,05, ce qui bat encore Carbon en coût par tâche. Anthropic note aussi qu'Opus 5.5 a changé certains comportements de l'API par rapport à Opus 5 (le thinking ne peut pas être désactivé, l'usage forcé d'outils renvoie une erreur), donc consultez le guide de migration avant de le brancher.
"I've found its worse in most tasks, especially when ranked on a cost-per-task metric."
Cette réponse portait sur Claude Fable 5.1 face à Opus 5.5, et résume bien pourquoi c'est Opus, et non Fable, le choix Anthropic ici.
Avantages
- Le score brut le plus proche de Carbon que vous puissiez réellement acheter.
- Les hits de cache de prompt coûtent 5% de l'entrée ($0,20 par million), moins que les 10% habituels.
- Également éligible au Cyber Verification Program d'Anthropic si la sécurité fait partie du travail.
Inconvénients
- Coût par tâche le plus élevé à effort maximal ($10,04).
- A inventé des réponses dans 50% des cas à effort maximal sur AA-Omniscience.
- Le mode Fast coûte $8/$40, le double du standard.
Tarifs
| Mode (par 1M de tokens) | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| Standard | $4.00 | $20.00 | $0.20 |
| Batch | $2.00 | $10.00 | n/a |
| Mode Fast | $8.00 | $40.00 | n/a |
Selon la documentation tarifaire d'Anthropic. Plus de détails dans mon article sur les tarifs de Claude Opus 5.5.
Mon avis : choisissez Opus 5.5 en xhigh si le travail est difficile et long, comme le code agentique ou la recherche approfondie. Pour une file de support, c'est plus de modèle que n'en demandent la plupart des tickets. Mon test de Claude Opus 5.5 donne les détails.
4. Claude Sonnet 5.5
Idéal pour : la rédaction en contact avec les clients et l'usage d'outils où le ton compte.
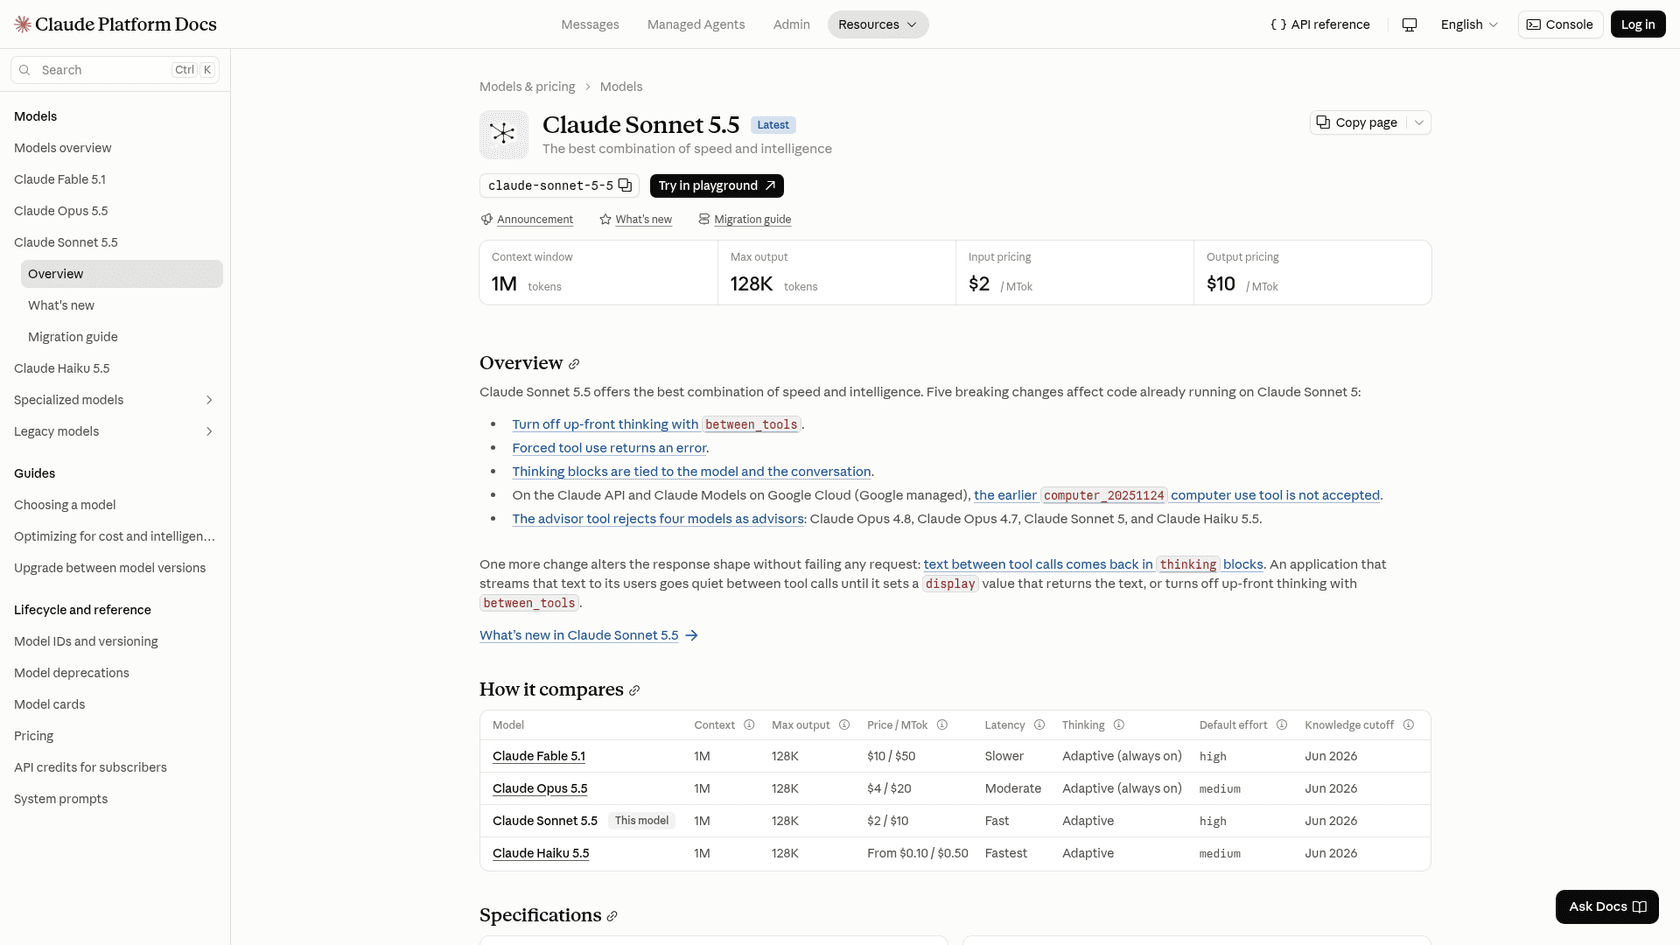
Sonnet 5.5 est le troisième modèle suggéré par ChatGPT, pour "nuanced, high-quality customer conversations". Anthropic le décrit comme "the best combination of speed and intelligence" de sa gamme, au même $2/$10 que le prix de lancement de Carbon.
Les scores dépendent beaucoup de l'effort. En max, Sonnet atteint 54,2 sur Artificial Analysis, près de Sol, mais ce run a coûté $10,02 par tâche. À effort high il tombe à 41,1 pour $1,64. Son taux d'hallucination est le meilleur des modèles de pointe d'Anthropic et OpenAI ici à effort maximal (43%), et son score AutomationBench en max (71,8%) n'est devancé que par les deux modèles Gemini 4 et Kimi.
Avantages
- Le modèle intermédiaire d'Anthropic : plus rapide qu'Opus 5.5 pour la moitié du prix par token.
- Hits de cache à $0,10 par million, 5% de l'entrée.
- Même API et mêmes outils qu'Opus, donc vous pouvez router entre les deux.
Inconvénients
- L'effort max coûte autant par tâche qu'Opus 5.5.
- La chute de score de max à high est forte (54,2 à 41,1).
- Pas de poids ouverts, pas d'auto-hébergement.
Tarifs
| Mode (par 1M de tokens) | Entrée | Sortie | Lecture du cache |
|---|---|---|---|
| Standard | $2.00 | $10.00 | $0.10 |
| Batch | $1.00 | $5.00 | n/a |
Selon la documentation tarifaire d'Anthropic. Mon guide des tarifs de Claude Sonnet 5.5 détaille les coûts selon l'effort.
Mon avis : un bon choix par défaut pour les réponses de support, utilisé en effort medium ou high avec grounding. Évitez l'effort max sauf si la tâche est difficile. Voir mon test de Claude Sonnet 5.5 pour en savoir plus.
5. Kimi K3.1 Pro
Idéal pour : les longs tickets, les longs documents et le travail d'outils en plusieurs étapes à une grille tarifaire de modèle de pointe.
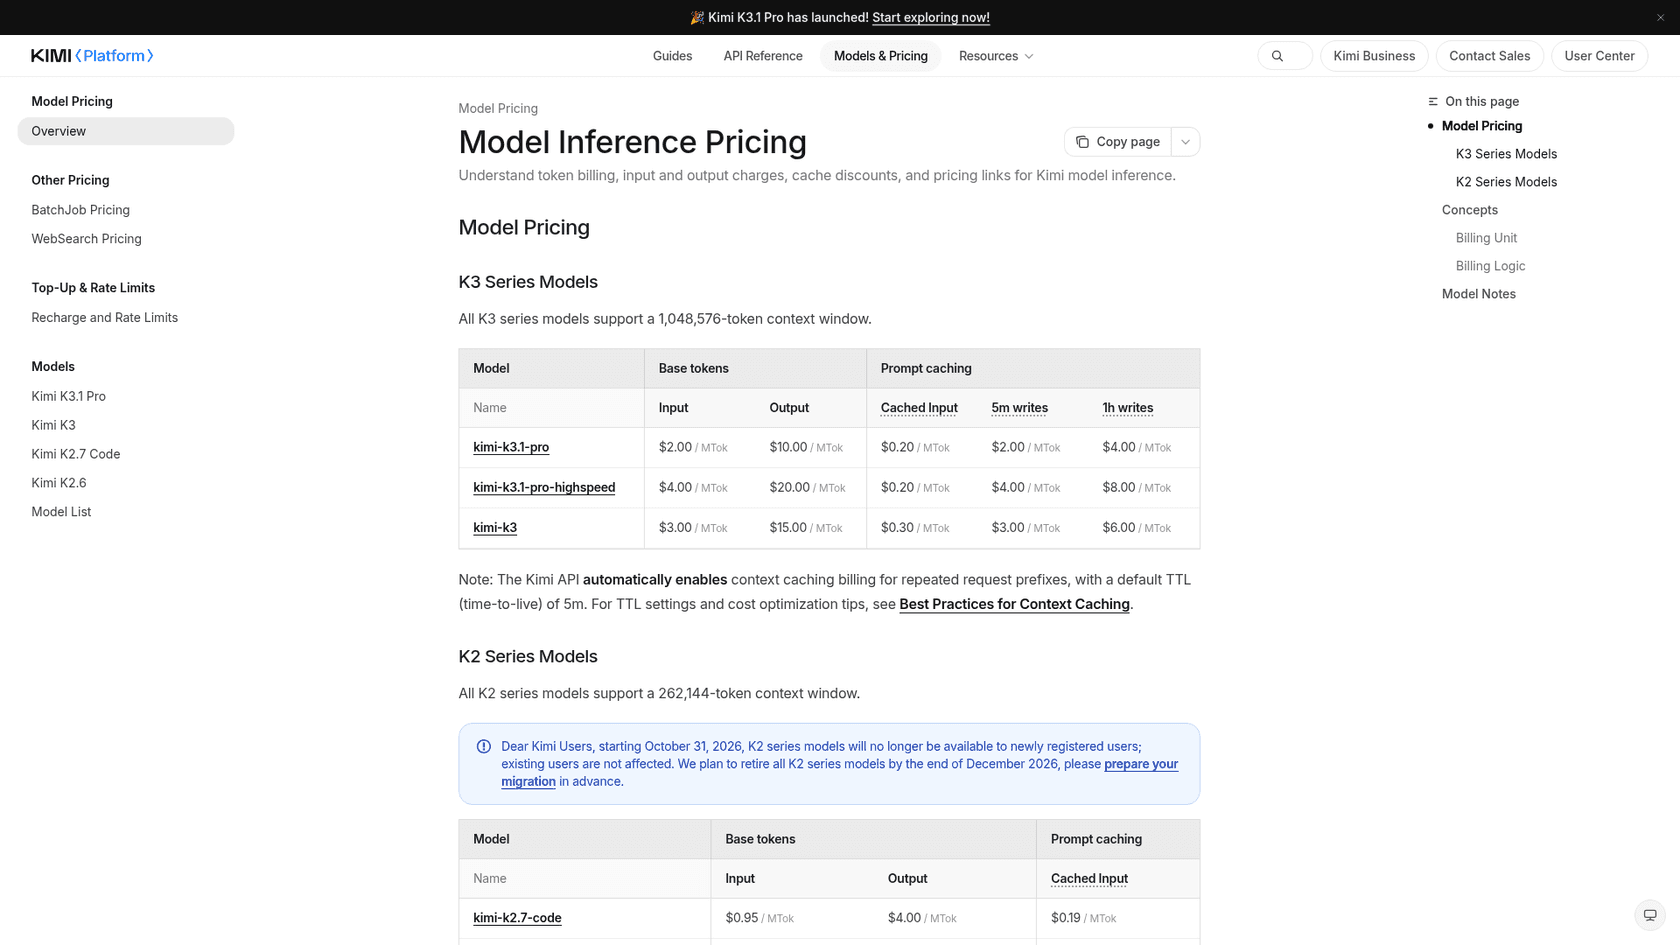
Kimi K3.1 Pro, de Moonshot, est un peu le discret de cette liste. Il obtient 46,0 sur l'index d'Artificial Analysis, en dessous des autres, mais affiche le meilleur résultat de raisonnement en contexte long de ma comparaison (86,3% au test de contexte long d'AA, contre 79,3% pour Carbon) et 73,3% sur AutomationBench. Son taux d'hallucination de 37% est le plus bas en dehors de la famille Gemini 4.
Il coûte $3,68 par tâche AA, la moitié de Carbon, et c'est le modèle le plus lent ici, à environ 36 tokens de sortie par seconde. Pour un agent de support qui rédige des réponses en arrière-plan, cette vitesse convient, pour le chat en direct non.
Avantages
- Meilleur score de contexte long du groupe.
- Deuxième taux de réponses inventées le plus bas parmi les modèles que l'on peut acheter.
- Même grille de $2/$10 que le prix de lancement de Carbon.
Inconvénients
- Sortie lente, donc pas un choix pour le chat en direct.
- Score affiché plus bas que les modèles de pointe américains.
- Les poids ouverts ne sont pas encore disponibles, donc API uniquement pour l'instant.
Tarifs
| Modèle (par 1M de tokens) | Entrée | Sortie | Entrée en cache |
|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $10.00 | $0.20 |
| kimi-k3.1-pro-highspeed | $4.00 | $20.00 | $0.20 |
Selon la page tarifaire de Kimi Platform. Mon article sur les tarifs de Kimi K3.1 Pro contient les calculs par tâche.
Mon avis : à tester si vos tickets sont longs et désordonnés, ou si votre agent lit de gros documents. Utilisez le niveau highspeed si la latence compte. Plus dans mon test de Kimi K3.1 Pro.
6. DeepSeek V4.1 Flash
Idéal pour : les équipes qui ont besoin de poids ouverts, d'auto-hébergement ou de la facture la plus basse par token.
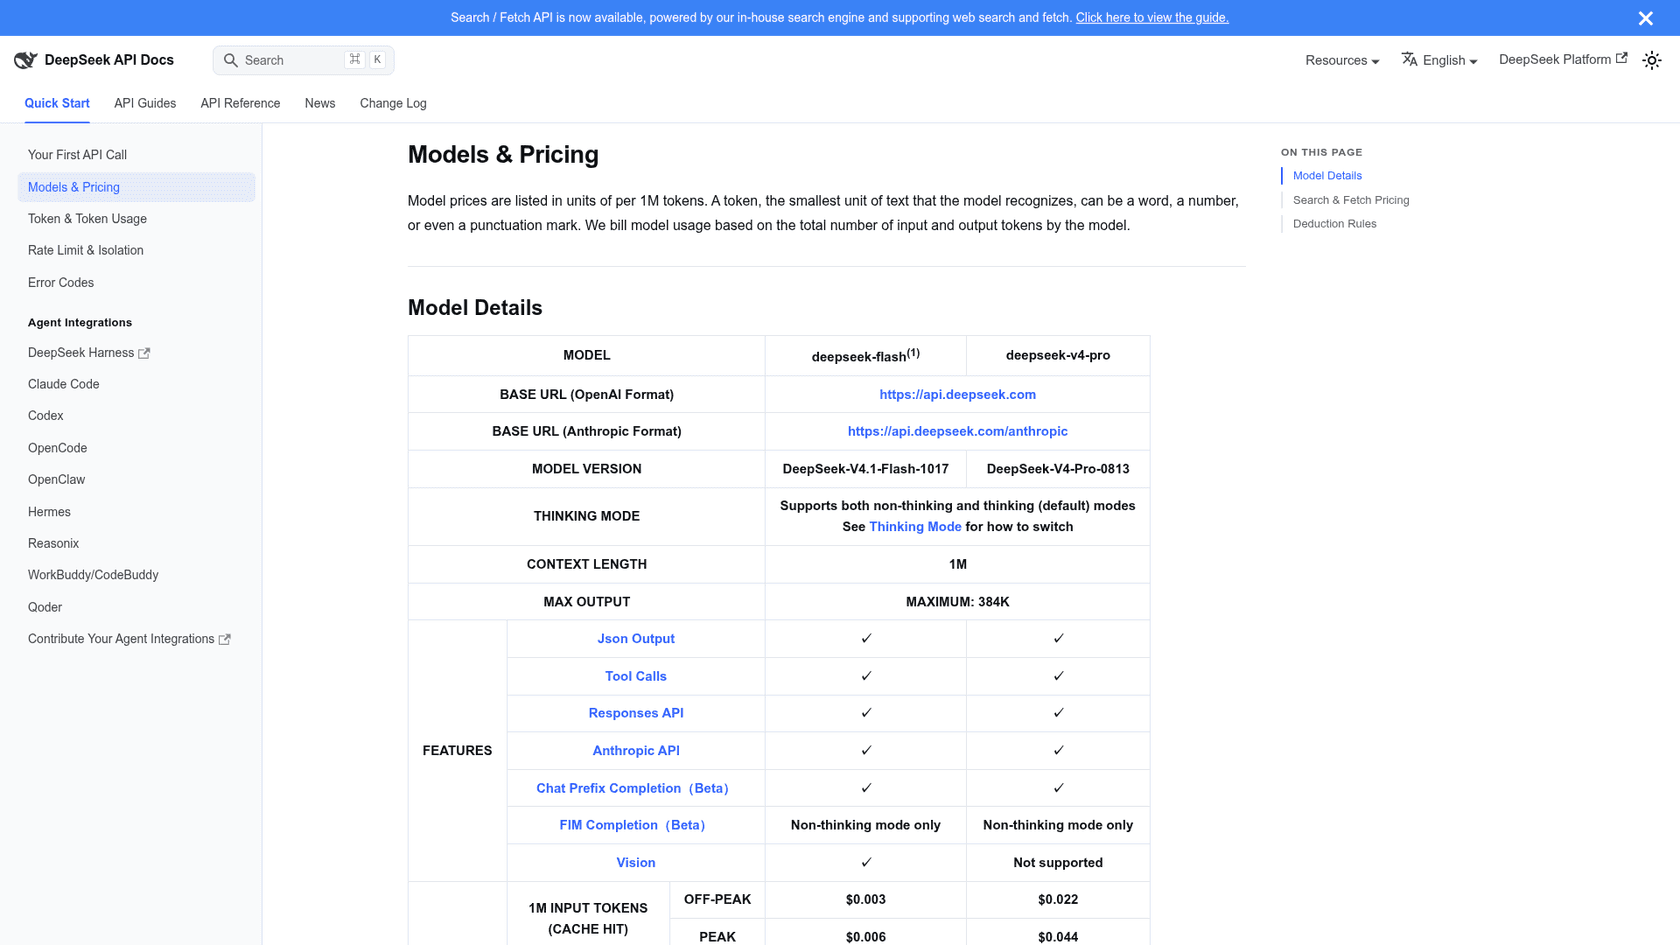
DeepSeek V4.1 Flash est le seul modèle de cette liste à poids ouverts, ce qui compte si vos données ne peuvent pas quitter vos propres serveurs. Sur l'API, il tourne à $0,15 en entrée et $0,60 en sortie en heures creuses, les heures de pointe (01:00 à 04:00 et 06:00 à 10:00 UTC en semaine) étant au double, selon la page tarifaire de DeepSeek.
Il obtient 32,5 sur l'index d'Artificial Analysis à effort maximal pour $0,60 par tâche, et son taux d'hallucination est de 64%. C'est un cheval de trait capable et bon marché, pas un modèle de la classe de Carbon, et il demande un guidage ferme.
"I use DeepSeek too but it's more of a workhorse model, requires a lot more guiding and sometimes struggles to get where I want it."
Avantages
- Poids ouverts, vous pouvez donc l'auto-héberger.
- La facture d'API la moins chère de cette liste proche de la pointe, avec des hits de cache à $0,003 par million en heures creuses.
- 1M de contexte, 384K de sortie maximum, tool calls et vision.
Inconvénients
- Score bien plus bas que Carbon (32,5 contre 59,4).
- 64% de réponses inventées, donc il doit être ancré.
- Le tarif de pointe double le coût les matins de semaine en Asie et en Europe.
Tarifs
| Par 1M de tokens | Heures creuses | Heures de pointe |
|---|---|---|
| Entrée, hit de cache | $0.003 | $0.006 |
| Entrée, miss de cache | $0.15 | $0.30 |
| Sortie | $0.60 | $1.20 |
Les API Search et Fetch de DeepSeek coûtent $0,75 pour 1 000 requêtes, la facturation des appels d'outils côté serveur commençant le 1er novembre 2026. Mon article sur les tarifs de DeepSeek V4.1 Flash détaille les horaires de pointe.
Mon avis : choisissez-le quand l'auto-hébergement ou le coût par token est la contrainte. Ne le choisissez pas comme remplaçant de Carbon sur la qualité. Voir mon test de DeepSeek V4.1 Flash.
7. GPT-6 Luna
Idéal pour : un modèle bon marché de première passe qui trie et répond aux tickets faciles avant qu'un modèle plus fort ne voie le reste.
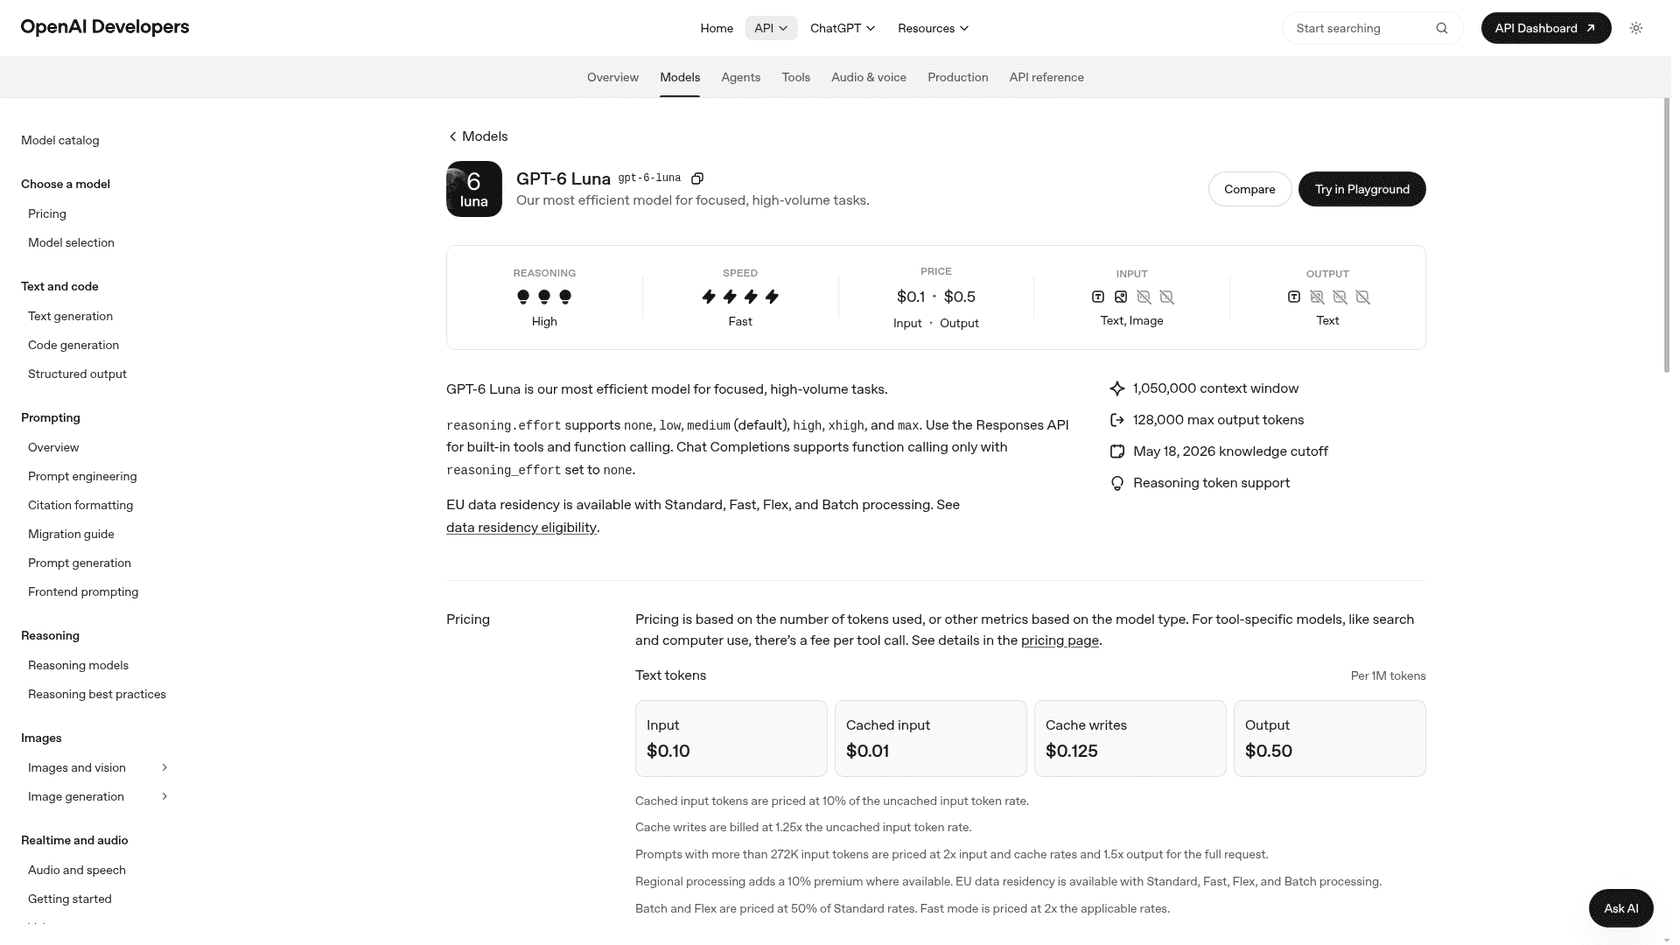
Luna est la quatrième suggestion de ChatGPT, pour "high-volume, repetitive requests". OpenAI le décrit comme son "most efficient model for focused, high-volume tasks", et à $0,10 en entrée et $0,50 en sortie par million de tokens il est 20 fois moins cher que le prix de lancement de Carbon.
Seul, ce n'est pas un substitut de Carbon. Luna obtient 27,8 sur l'index d'Artificial Analysis à effort maximal pour $0,15 par tâche, et il a inventé des réponses dans 79% des cas sur AA-Omniscience. Son rôle est le tri : étiqueter le ticket, répondre à la question de suivi de commande à partir de vos données et remonter tout le reste.
Avantages
- Le moins cher par tâche de cette liste.
- Rapide, avec une fenêtre de 1 050 000 tokens.
- Même API que Sol, donc le routage entre les deux est simple.
Inconvénients
- Le taux de réponses inventées le plus élevé ici (79% à effort maximal).
- Pas adapté à tout ce qui demande du jugement.
- Sortie texte uniquement.
Tarifs
| Mode (par 1M de tokens) | Entrée | Sortie | Entrée en cache |
|---|---|---|---|
| Standard | $0.10 | $0.50 | $0.01 |
| Batch / Flex | $0.05 | $0.25 | $0.005 |
| Fast | $0.20 | $1.00 | $0.02 |
Selon la page tarifaire d'OpenAI. Si vous voulez un modèle de tri bon marché avec moins de réponses inventées, Claude Haiku 5.5 coûte le même $0,10/$0,50 pour des prompts jusqu'à 100K tokens et a affiché un taux d'hallucination de 34% à effort maximal.
Mon avis : utilisez Luna (ou Haiku 5.5) comme première couche bon marché, jamais comme seul modèle. Plus dans mon analyse des tarifs de GPT-6 Luna.
Et si vous aviez besoin de Carbon pour du vrai travail de sécurité ?
Alors ne vous contentez pas d'un modèle généraliste, candidatez à un programme restreint, parce que les modèles généralistes bloquent volontairement une partie du travail cyber. Il y a trois voies :
| Voie | Modèle obtenu | Comment entrer | Coût |
|---|---|---|---|
| Google Fairwind | Gemini 4 Carbon | Formulaire d'intérêt, vérification des antécédents, 650+ partenaires jusqu'ici | $2/$10 de lancement de Carbon, puis $4/$20 |
| OpenAI Daybreak | GPT-5.6-Cyber et niveaux d'accès Daybreak | Candidature ; OpenAI offre $1 milliard de crédits Daybreak aux défenseurs | $12.50 / $75 par 1M pour gpt-5.6-cyber sur la grille tarifaire d'OpenAI |
| Anthropic Cyber Verification Program | Claude Opus 5.5, Sonnet 5.5 et Mythos 5.1 avec moins de blocages cyber | Une candidature par organisation ; décision sous sept jours ouvrés | Tarifs standard de l'API Claude |
Le programme d'Anthropic est le plus facile d'accès des trois. Sa mise à jour d'octobre 2026 a ajouté trois niveaux d'accès et qualifie Opus 5.5 de son "most capable cyber model yet". Les chercheurs indépendants, mainteneurs et chasseurs de bug bounty peuvent candidater à titre individuel, mais les particuliers n'obtiennent pour l'instant que le niveau Defense. Mon article sur les alternatives à GPT-5.6-Cyber compare ces programmes plus en profondeur.
Tout le monde n'apprécie pas ce filtrage :
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
Pour les tâches de sécurité courantes, vous n'avez peut-être besoin d'aucun programme. Anthropic dit que ses modèles généralement disponibles peuvent toujours servir à la revue de code sécurisée, à la modélisation des menaces, au correctif de problèmes connus et au tri des alertes de sécurité.
Quelle alternative à Gemini 4 Carbon choisir ?
Partez de ce pour quoi vous vouliez Carbon. La carte ci-dessous montre comment j'orienterais la décision.
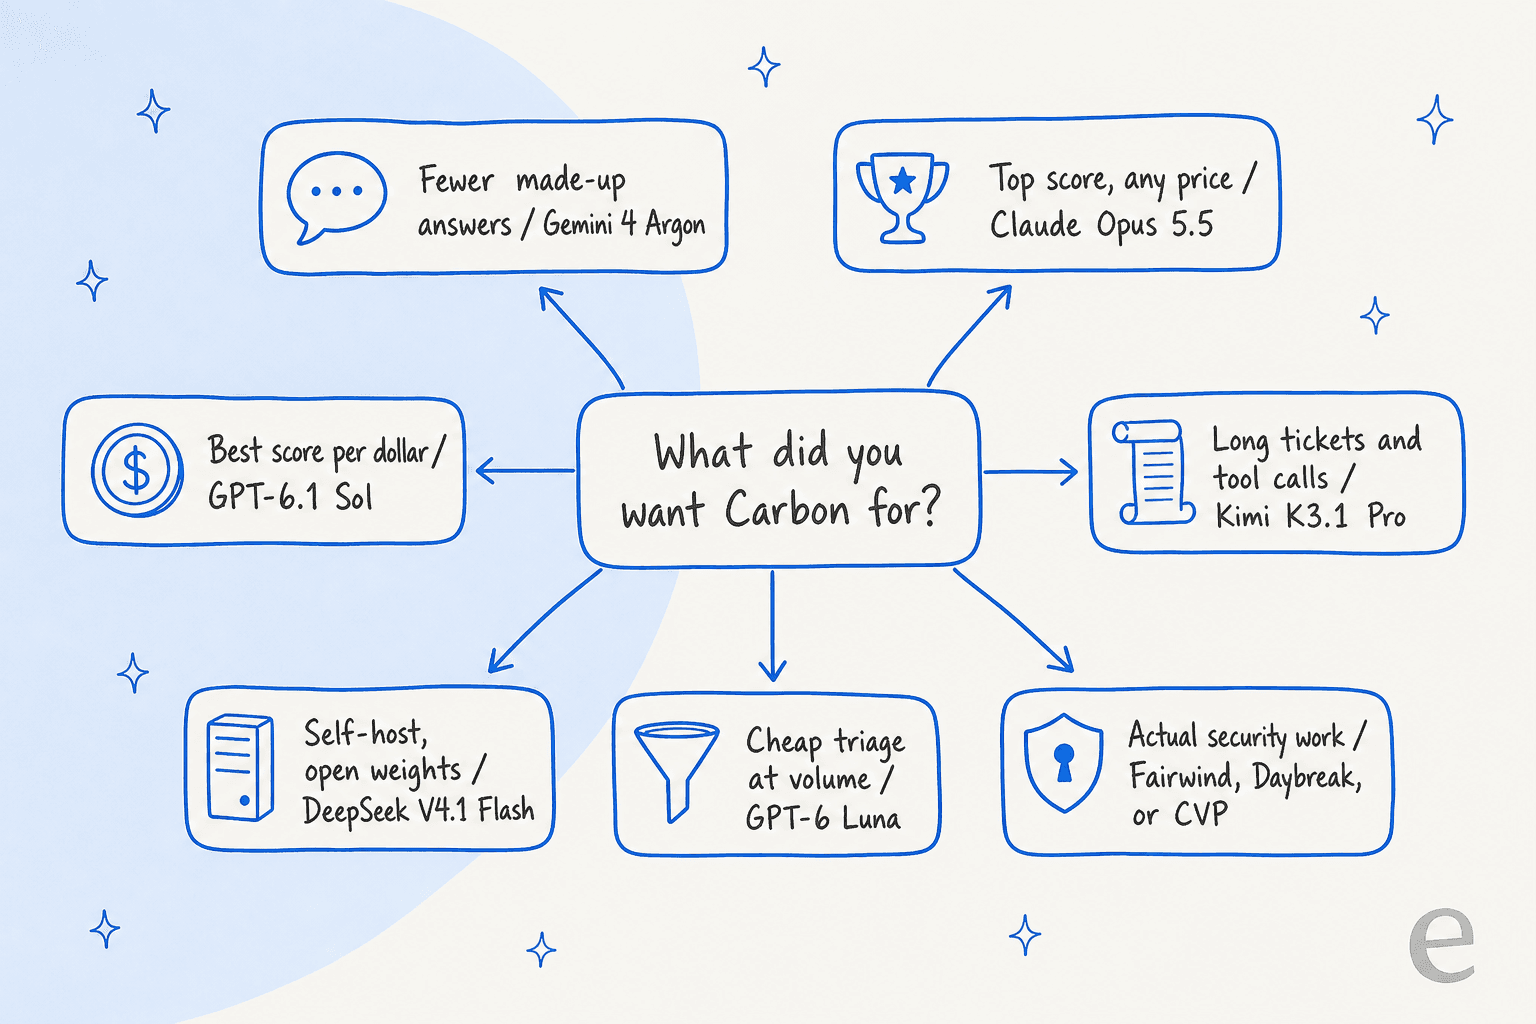
Pour la plupart des lecteurs, la réponse honnête est une paire de modèles, pas un seul. La suggestion à deux modèles de ChatGPT est la bonne : un modèle bon marché comme Luna ou Haiku 5.5 gère le travail facile à gros volume, et un modèle plus fort (Argon, Sol ou Sonnet 5.5) prend les cas difficiles. Comme cinq de ces modèles coûtent le même prix par token, le choix du modèle plus fort se résume au coût par tâche et au taux de réponses inventées, pas à la grille tarifaire.
Et une chose à dire clairement : l'écart entre Carbon et Argon sur une file de support est plus petit que l'écart entre un agent ancré et un agent non ancré. Tous ces modèles inventent des réponses quand on leur demande quelque chose que votre documentation ne couvre pas. La solution, c'est la couche autour du modèle, la partie sur laquelle je travaille.
Comment ce choix se traduit-il dans un vrai agent de support ?
Dans eesel, le modèle n'est qu'un réglage. Ce qui décide si les clients obtiennent de bonnes réponses, c'est ce que le coéquipier IA lit et ce qu'il a le droit de faire. Quand une équipe connecte son helpdesk, l'agent apprend de ses anciens tickets, de son centre d'aide et de ses documents internes, suit des règles écrites sur ce qu'il faut passer à une personne, et est simulé sur des tickets historiques avant de répondre à qui que ce soit en direct.
Deux clients sur Freshdesk montrent à quoi cela ressemble. Qontro, une société de logiciels ERP, reçoit un brouillon de réponse avec des articles d'aide déjà liés sur chaque ticket Freshdesk, a fait rédiger 190 tickets en un mois et répond à partir de 9 800 anciens tickets et articles d'aide. SamCart fait tourner un agent par canal, un sur les tickets Freshdesk et un sur le chat de son site, avec un forfait dimensionné pour 8 000 interactions par mois.
Aucun des deux n'avait besoin d'un modèle de sécurité de pointe. Ils avaient besoin d'un agent qui dit "je vais chercher quelqu'un" au lieu de deviner. Si vous comparez des modèles pour une file de support, mon guide du meilleur modèle pour les tickets de support approfondit ce compromis, tout comme l'article sur les LLM pour le support client.
Essayer eesel
Si vous êtes venu ici parce que vous vouliez Carbon dans un agent de support, eesel est le chemin le plus court. C'est un coéquipier helpdesk IA qui se branche sur Freshdesk, Zendesk et d'autres helpdesks, apprend de vos anciens tickets et de votre centre d'aide, et est testé sur votre propre historique de tickets avant de répondre à un client. Le choix du modèle est géré, et vous avez l'ancrage qui empêche n'importe lequel de ces modèles d'inventer des choses.
Vous pouvez voir les forfaits sur la page tarifaire d'eesel, ou essayer eesel gratuitement sur vos propres tickets.