

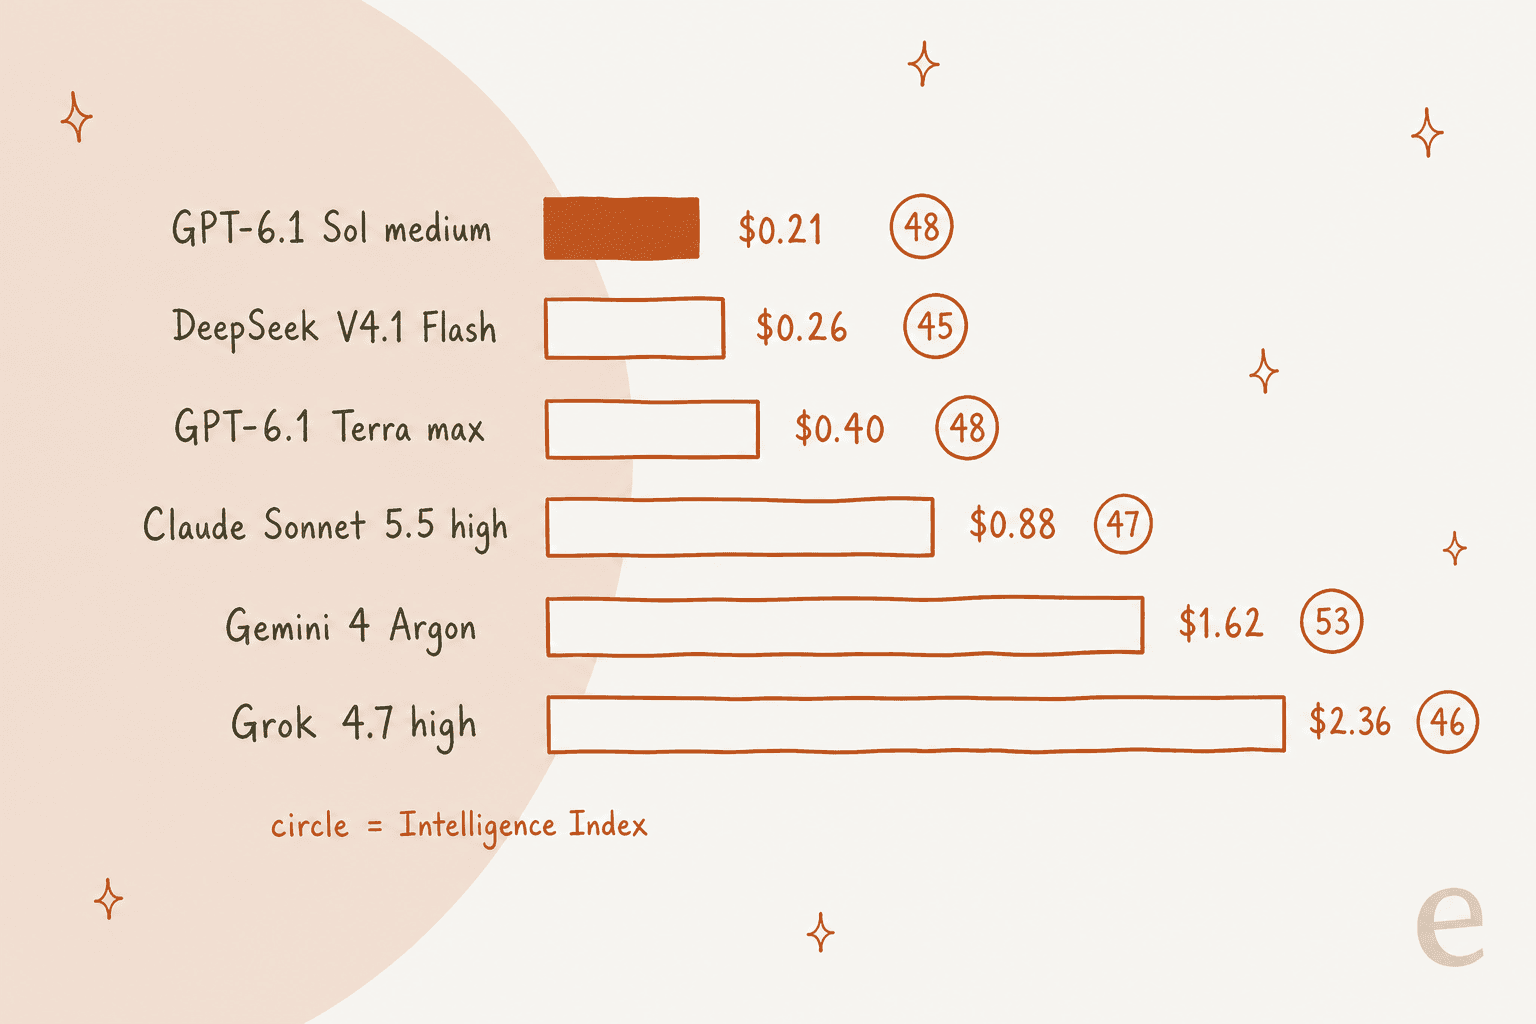
La meilleure alternative à GPT-6.1 Terra pour la plupart des équipes est GPT-6.1 Sol à effort moyen, ce qui paraît illogique puisque Sol coûte deux fois plus par token. Par tâche, c'est l'inverse : Artificial Analysis donne à Sol medium 47.8 pour $0.21 la tâche, alors que Terra en max obtient 48.1 pour $0.40. Si vous alliez passer Terra en effort max, changez plutôt de modèle.
Si vous voulez quitter OpenAI : Claude Sonnet 5.5 pour le code et les agents ($2/$10), DeepSeek V4.1 Flash pour la facture la plus basse ($0.15/$0.60 en heures creuses, poids ouverts), et Gemini 4 Argon pour le raisonnement le plus difficile, à un prix promotionnel qui double le 1er décembre. Sur un mois d'1 million de requêtes, la facture au tarif catalogue va de $480 chez DeepSeek à $7,000 chez Sol ou Sonnet, contre $3,500 chez Terra.
Si le modèle est destiné à une file de support, le modèle compte moins qu'on le croit. Dans mon test de GPT-6.1 Terra, Terra a traité correctement 15 tickets sur 16 contre 16 pour Sol, et le seul raté venait d'une règle d'escalade, pas d'un manque d'intelligence. Cette règle se trouve dans la couche que gère eesel, comme Koffer.ch la fait tourner sur Freshdesk avec chaque réponse en brouillon.
Pourquoi regarder au-delà de GPT-6.1 Terra ?
Je commence par le dire : Terra est un bon modèle. GPT-6.1 Terra est sorti le 26 octobre 2026 à $1 par million de tokens en entrée et $5 par million en sortie. Il a une fenêtre de contexte de 1,050,000 tokens, plus un niveau de raisonnement none que Sol et Astra n'ont pas. Sur mes propres tickets de support, c'était le modèle le plus rapide que j'aie essayé, entre 2.5s et 3.1s chacun.
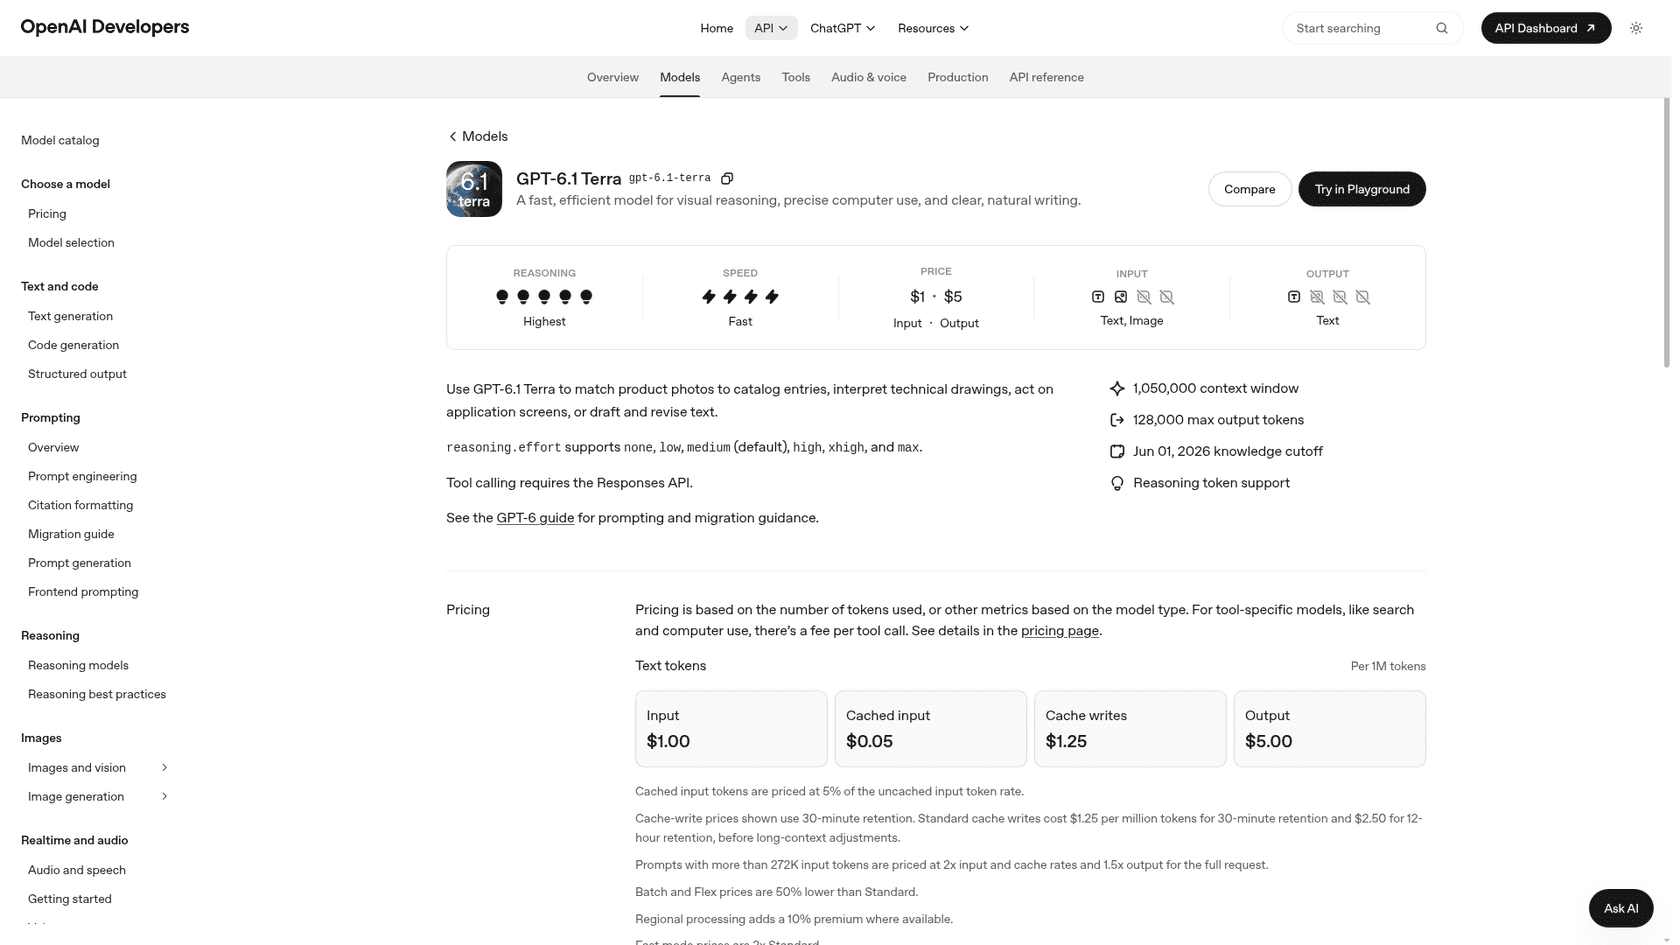
Pourtant, on cherche autre chose, et cela revient généralement à ceci :
- Il devient cher quand on le pousse. L'Intelligence Index de Terra passe de
36.2à effort faible à48.1en max. Mais le coût par tâche passe de$0.05à$0.40, et le temps par tâche de29sà384s, selon Artificial Analysis. Si vous le poussez au maximum, vous payez le prix de Sol pour quelque chose qui n'est pas Sol. - Le code et le travail en terminal sont en retrait par rapport aux modèles plus gros. Terminal-Bench 4.0 revenait sans cesse dans le fil de lancement sur Hacker News. Un commentateur situait Terra en max à 50 %, et Claude Opus 5.5 à 70 %.
- Risque lié à un seul fournisseur. Quand tout votre produit repose sur un seul modèle OpenAI, leur changement de prix ou leur panne devient aussi le vôtre.
Un commentaire sceptique résume assez bien le point 1 :
"Terra XHigh more expensive than Sol Low and still does worse."

Et voici celui à garder en tête en lisant chaque tableau ci-dessous :
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."
Comment j'ai choisi et chiffré ces options
Je construis les agents IA qui travaillent sur les helpdesks des clients d'eesel, et c'est moi qui ai mené l'évaluation de Terra sur 80 tickets pour mon test. Des années de files en direct m'ont appris que le prix par token est la mauvaise chose à mesurer. Moitié prix avec deux fois plus de nouvelles tentatives, ça n'économise rien en production. J'ai donc jugé chaque choix ci-dessous sur ces critères :
- Le prix catalogue par 1M de tokens, relevé le 28 octobre 2026 sur la page de tarifs de chaque fournisseur.
- Le coût par tâche et l'Intelligence Index d'Artificial Analysis. Il fait tourner une même suite de tests sur tous les modèles et consigne ce que chacun a réellement dépensé.
- Une facture mensuelle pour un acheteur type : imaginez un produit qui envoie 1 million de requêtes par mois, chacune avec 2 000 tokens en entrée et 300 en sortie. Cela fait 2 milliards de tokens en entrée et 300 millions en sortie, sans compter le cache ni les tokens de réflexion.
J'ai aussi posé cette question à ChatGPT comme le ferait un acheteur. Sa présélection était Sonnet 5.5, Gemini 3.6 Flash, DeepSeek V4.1 Flash, Gemini 4 Argon et Grok 4.7. La plupart sont restés. J'ai remplacé Gemini 3.6 Flash par 3.8 Flash (même prix, modèle plus récent) et ajouté Sol et Haiku 5.5, que ChatGPT avait omis.
Les alternatives à GPT-6.1 Terra comparées
| Modèle | Entrée / sortie par 1M | Entrée en cache | Contexte | AA Intelligence Index | AA coût par tâche | Délai avant le premier token | Poids ouverts | Facture mensuelle (acheteur type) |
|---|---|---|---|---|---|---|---|---|
| GPT-6.1 Terra (référence) | $1 / $5 | $0.05 | 1.05M | 48.1 (max) | $0.40 | 1.3s (low) | Non | $3,500 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | 47.8 (medium) | $0.21 | 4.4s | Non | $7,000 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | 46.8 (high) | $0.88 | 3.1s (medium) | Non | $7,000 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 heures creuses | $0.003 | 1M | 45.1 (max) | $0.26 | 1.2s | Oui | $480 (heures creuses) |
| Gemini 3.8 Flash | $0.75 / $3.75 jusqu'au 31 déc. | $0.075 | 1M | 40.9 (high) | $3.49 | 28.3s (high) | Non | $2,625 |
| Gemini 4 Argon | $2 / $10 jusqu'au 30 nov. | $0.10 | 1M | 52.6 (high) | $1.62 | 48.2s | Non | $7,000 |
| Grok 4.7 | $2 / $6 | n/d | 500K | 46.3 (high) | $2.36 | 5.4s (low) | Non | $5,800 |
| Claude Haiku 5.5 | $0.10 / $0.50 jusqu'à 100K de prompt | $0.01 | 1M | 37.8 (high) | $0.08 | 26.7s (high) | Non | $350 |
Deux choses ressortent. DeepSeek V4.1 Flash coûte environ 7 fois moins que Terra en facture et reste à moins de 3 points sur l'index. Ensuite, Gemini 3.8 Flash : bon marché par token, mais l'un des plus chers par tâche, car il réfléchit beaucoup avant de répondre. L'index, le coût par tâche et les délais avant le premier token proviennent tous des pages de modèles d'Artificial Analysis, au niveau d'effort indiqué entre parenthèses.
1. GPT-6.1 Sol
Idéal pour : les équipes déjà sur l'API OpenAI qui veulent un meilleur jugement sans changer une ligne de code d'intégration.
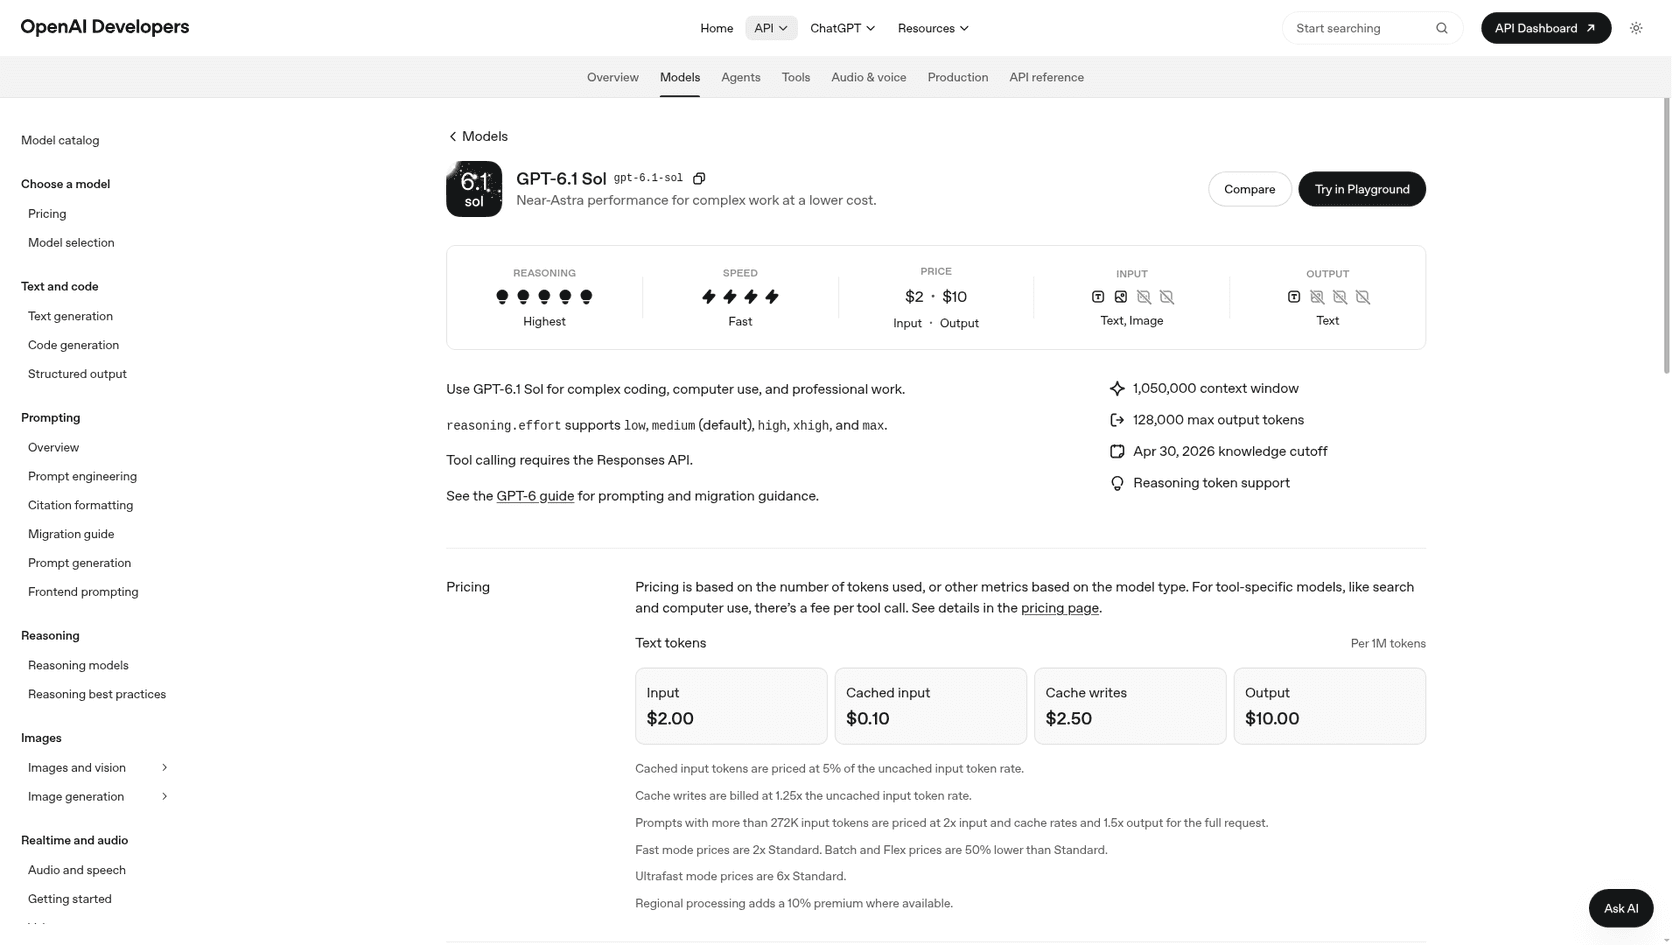
Voyez Sol comme le grand frère de Terra. Il se situe un barreau plus haut sur l'échelle d'OpenAI, entre Terra et GPT-6 Astra. L'API, les outils et la génération gpt-6.1 sont identiques, donc changer revient à modifier le nom du modèle.
Avantages
- Sol à effort moyen égale Terra en max sur l'index d'Artificial Analysis, pour environ la moitié du coût par tâche (
$0.21contre$0.40). - Dans mon test de support, son jugement était le meilleur : 16 sur 16. C'était aussi la seule configuration à avoir escaladé un changement d'adresse en espagnol qu'elle ne pouvait pas effectuer.
- AA situe son taux d'hallucination à effort élevé à
49%, contre38%pour Terra en max. Ce n'est donc pas le modèle le plus soigneux sur les faits. Là où il gagne, c'est sur les décisions aux cas limites.
Inconvénients
- Il est plus lent. AA mesure environ
54tokens de sortie par seconde en medium contre91pour Terra, et un premier token à4.4scontre1.3spour Terra en low. - Les requêtes courtes et faciles coûtent plus cher sur Sol. Mon test est ressorti à
$1.62pour 1 000 tickets, contre$0.75pour Terra en low. - Il n'y a pas d'effort
none, donc pas de voie rapide sans réflexion.
Tarifs : $2 en entrée, $0.10 en cache, $10 en sortie par 1M de tokens sur la page de tarifs d'OpenAI. Le mode batch réduit de moitié, à $1/$5.
Mon avis : laissez les 80 % faciles sur Terra en low, et routez vers Sol en medium tout ce qui nécessiterait un effort élevé. Le chemin de montée en gamme depuis Terra n'est pas Terra en max, c'est Sol. Vous trouverez tous les chiffres dans le test de GPT-6.1 Sol.
2. Claude Sonnet 5.5
Idéal pour : les outils de code, les agents de terminal et l'utilisation d'outils en plusieurs étapes.
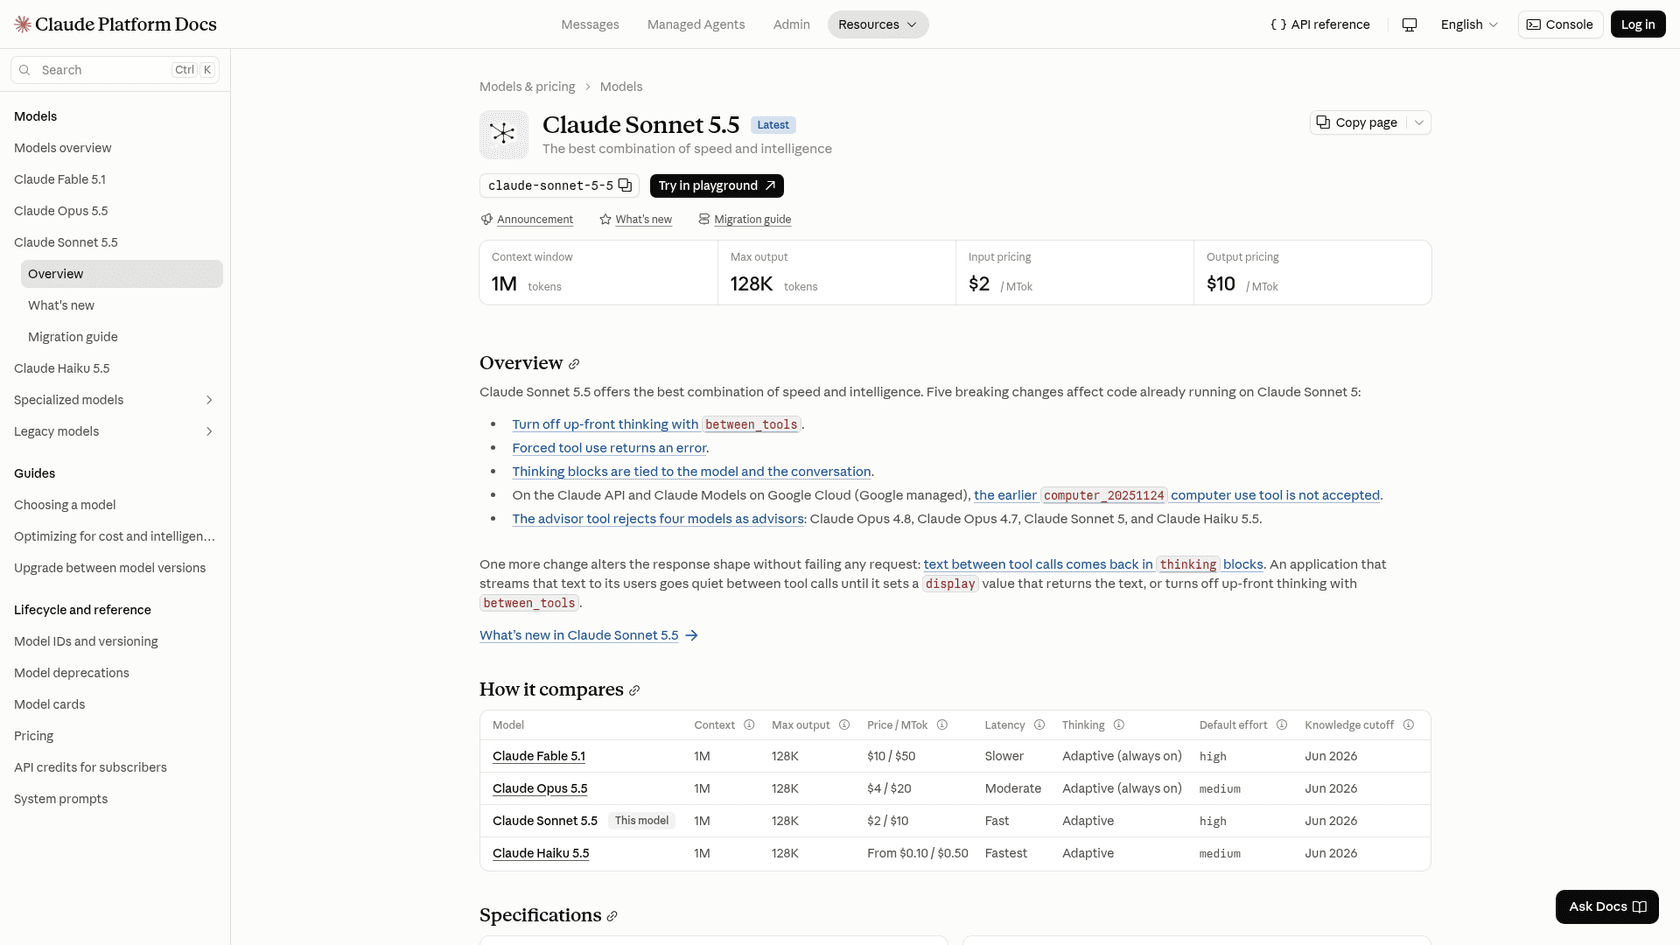
C'est le modèle de milieu de gamme d'Anthropic, sorti le 28 septembre 2026. ChatGPT l'a qualifié de "best first alternative to test", et pour le travail avec des agents, je dirais que c'est juste.
Avantages
- Les meilleurs chiffres en code de sa tranche de prix. Anthropic annonce
70.6%sur Terminal-Bench 4.0, devant les66.4%d'Opus 5.5, et80.1%sur OSWorld 2.1 pour l'utilisation d'ordinateur. - Il est au même prix que Sol,
$2/$10, et propose une fenêtre de contexte de 1M et 128K de sortie. - Premier token rapide à effort moyen (
3.1schez AA), et environ107tokens de sortie par seconde.
Inconvénients
- À effort élevé, il coûte
$0.88par tâche chez AA. C'est plus de 4 fois Sol medium, pour un score d'index plus bas. - Chez AA, son taux d'hallucination à effort élevé est de
65%, le plus élevé parmi les modèles fermés présentés ici. - La migration n'est pas indolore :
thinking: disabledet untool_choiceforcé renvoient tous deux une erreur 400 sur Sonnet 5.5, donc le code conçu pour des modèles Claude plus anciens devra être modifié.
Tarifs : $2 en entrée, $10 en sortie, $0.10 pour les accès au cache, selon la page de tarifs de Claude. Le batch est à $1/$5.
Mon avis : si votre produit écrit ou exécute du code, ou pilote un navigateur pendant de longues périodes, prenez Sonnet 5.5. Les tâches de texte court comme la rédaction et l'extraction rapportent plus par dollar sur Terra ou Sol. Le test de Claude Sonnet 5.5 et la comparaison Sol vs Opus 5.5 vont plus loin.
3. DeepSeek V4.1 Flash
Idéal pour : le chat à gros volume, l'extraction et le RAG quand la facture de tokens est la principale contrainte, ou quand vous voulez des poids que vous pouvez héberger.
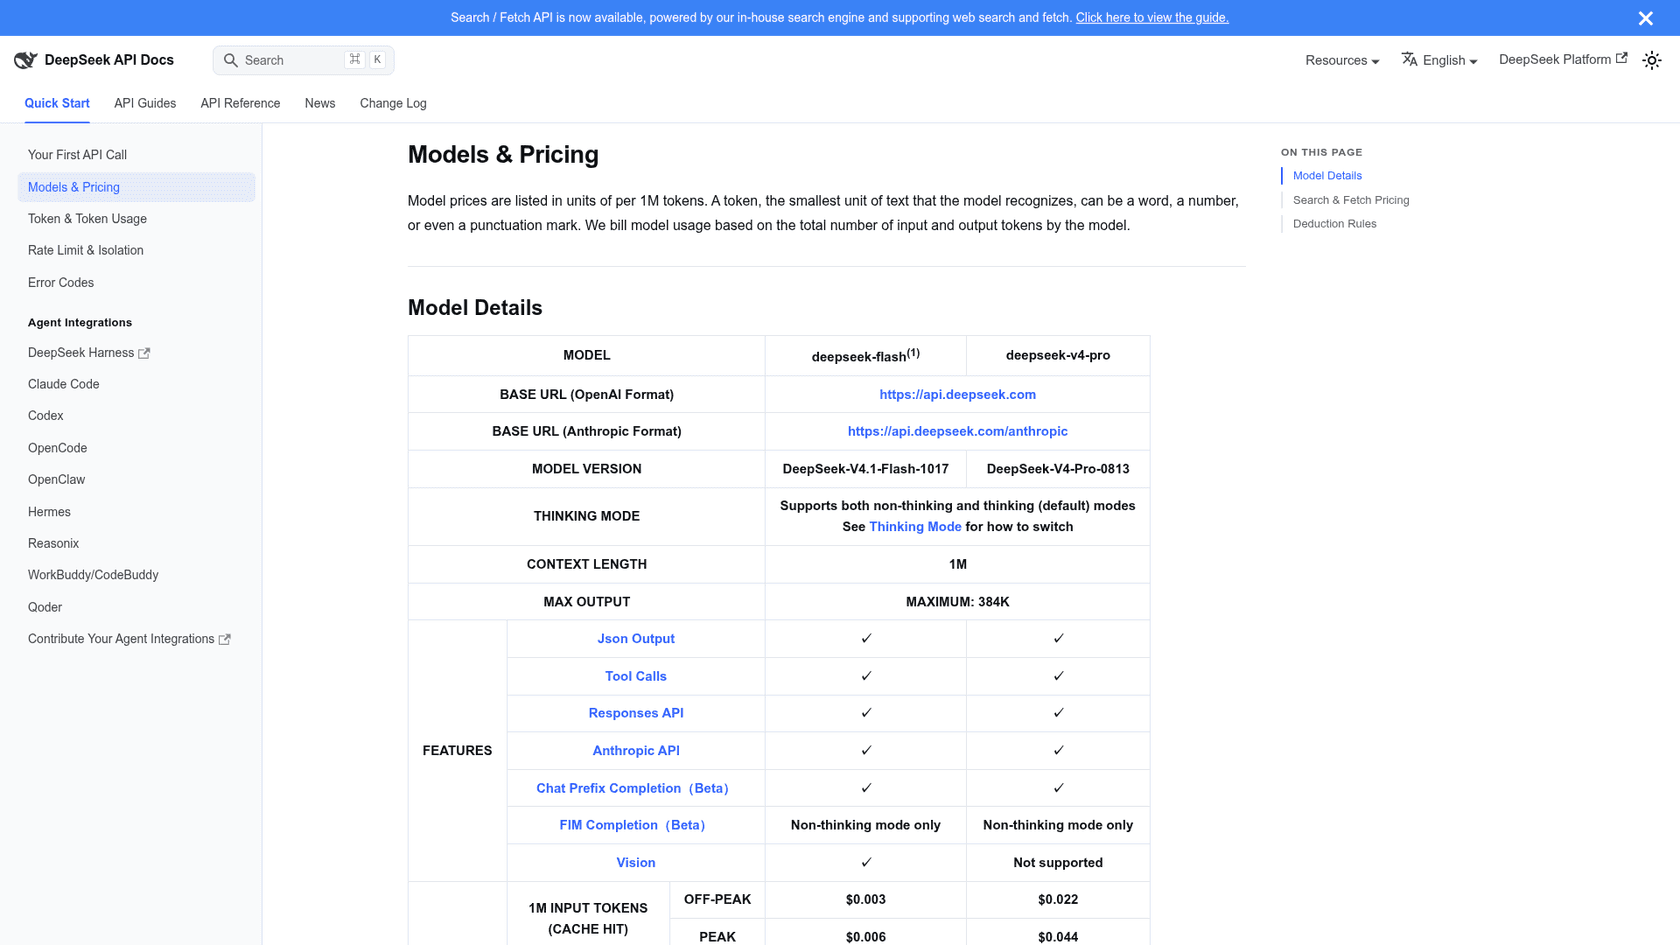
Sur l'API, le nom est désormais simplement deepseek-flash, et c'est le checkpoint DeepSeek-V4.1-Flash-1017 qui le sert. Les anciens noms comme deepseek-v4-flash continuent de fonctionner et sont facturés au prix de Flash, d'après la documentation tarifaire de DeepSeek.
Avantages
- Parmi les modèles présentés ici qui dépassent 45, c'est celui dont la facture est la plus basse. L'acheteur type paie
$480par mois en heures creuses, contre$3,500avec Terra. - Les accès au cache coûtent
$0.003par 1M de tokens en heures creuses, donc les prompts système répétés ne coûtent presque rien. - Les poids sont ouverts, vous pouvez donc l'héberger vous-même quand la résidence des données compte. Il lit aussi les images, prend en charge les appels d'outils et parle les formats d'API d'OpenAI et d'Anthropic.
- Il a le premier token le plus rapide d'ici,
1.2ssur Artificial Analysis.
Inconvénients
- Le tarif de pointe double tout, à
$0.30/$1.20. Les heures de pointe vont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine, ce qui tombe en plein sur la matinée de travail européenne. - Le taux d'hallucination d'AA pour le checkpoint 1017 en max est de
67%, donc gardez-le ancré à vos propres documents. - Les appels Search et Fetch côté serveur commencent à être facturés
$0.75pour 1 000 requêtes le 1er novembre 2026.
Tarifs : $0.15 en entrée (absence dans le cache), $0.003 pour un accès au cache, $0.60 en sortie en heures creuses ; $0.30, $0.006 et $1.20 en heures de pointe.
Mon avis : pour un trafic surtout simple, et si changer de fournisseur ne vous gêne pas, DeepSeek est le remplacement le moins cher à prendre au sérieux. Un commentateur de HN a résumé le partage sans détour :
"If all I want is coding at a cheaper price, then deepseek is a good model for that."
Le test de DeepSeek V4.1 Flash 1017 et le guide de l'API DeepSeek détaillent la mise en place.
4. Gemini 3.8 Flash
Idéal pour : les traitements multimodaux par lots (PDF, vidéo, audio) où personne n'attend la réponse.
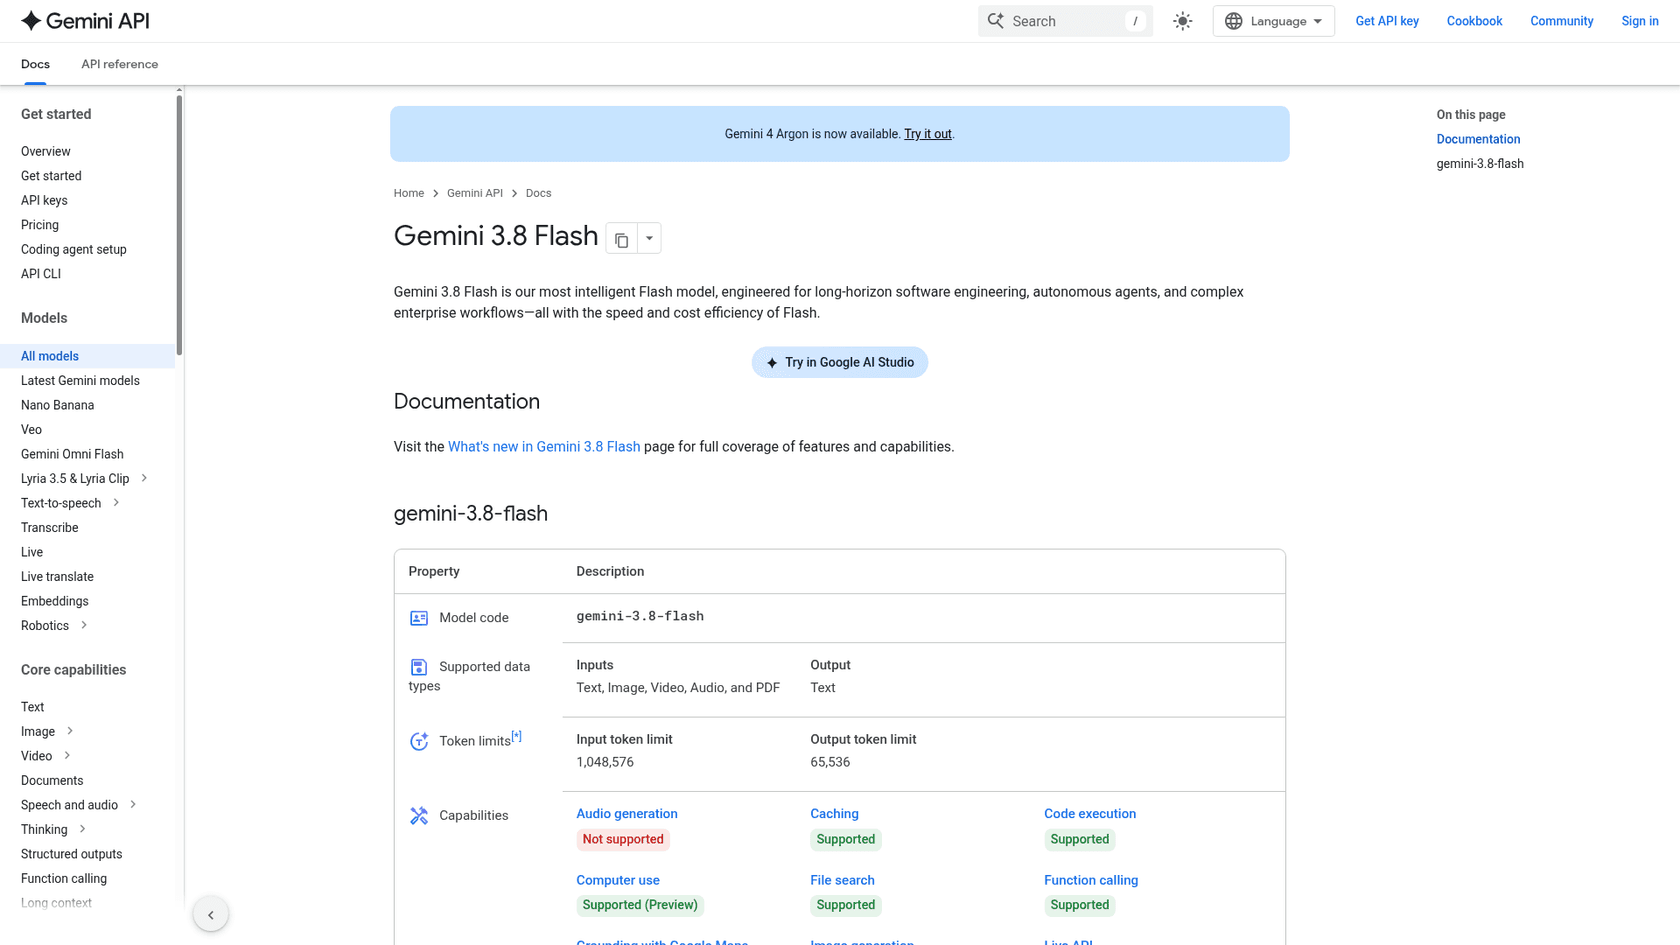
Le choix de ChatGPT pour cette place était Gemini 3.6 Flash. Mais sur la page de tarifs de Gemini, 3.6 Flash et 3.8 Flash coûtent exactement la même chose, et Google qualifie désormais 3.6 de "previous generation Flash model". Si vous testez la gamme Flash de Google, testez donc 3.8.
Avantages
- Moins cher par token que Terra jusqu'à fin 2026 :
$0.75en entrée et$3.75en sortie, ce qui place l'acheteur type à$2,625. - Il accepte le texte, l'image, la vidéo, l'audio et le PDF en entrée, soit plus large que tout autre modèle ici.
- Il y a un niveau gratuit pour tester, ce que Terra ne propose pas.
Inconvénients
- Le 1er janvier 2027, le prix double à
$1.50/$7.50, ce qui le place au-dessus de Terra par token. - Il réfléchit beaucoup. AA le situe à
$3.49par tâche et à28.3spour le premier token à effort élevé, ce qui le rend peu adapté à une fenêtre de chat que quelqu'un regarde. - Les notes de lancement de Google précisent que 3.8 Flash peut utiliser davantage de tokens pour maximiser les performances. Le test de Gemini 3.8 Flash donne les détails.
Tarifs : $0.75/$3.75 jusqu'au 31 décembre 2026, puis $1.50/$7.50. Batch et Flex coûtent moitié moins.
Mon avis : il convient bien au traitement de documents de nuit, facturé aux tokens. Pour tout ce qui est interactif, ou qui tourne encore en janvier, calculez d'abord le coût par tâche.
5. Gemini 4 Argon
Idéal pour : le raisonnement le plus difficile, la recherche et les longs agents autonomes, quand obtenir la bonne réponse vaut le prix.
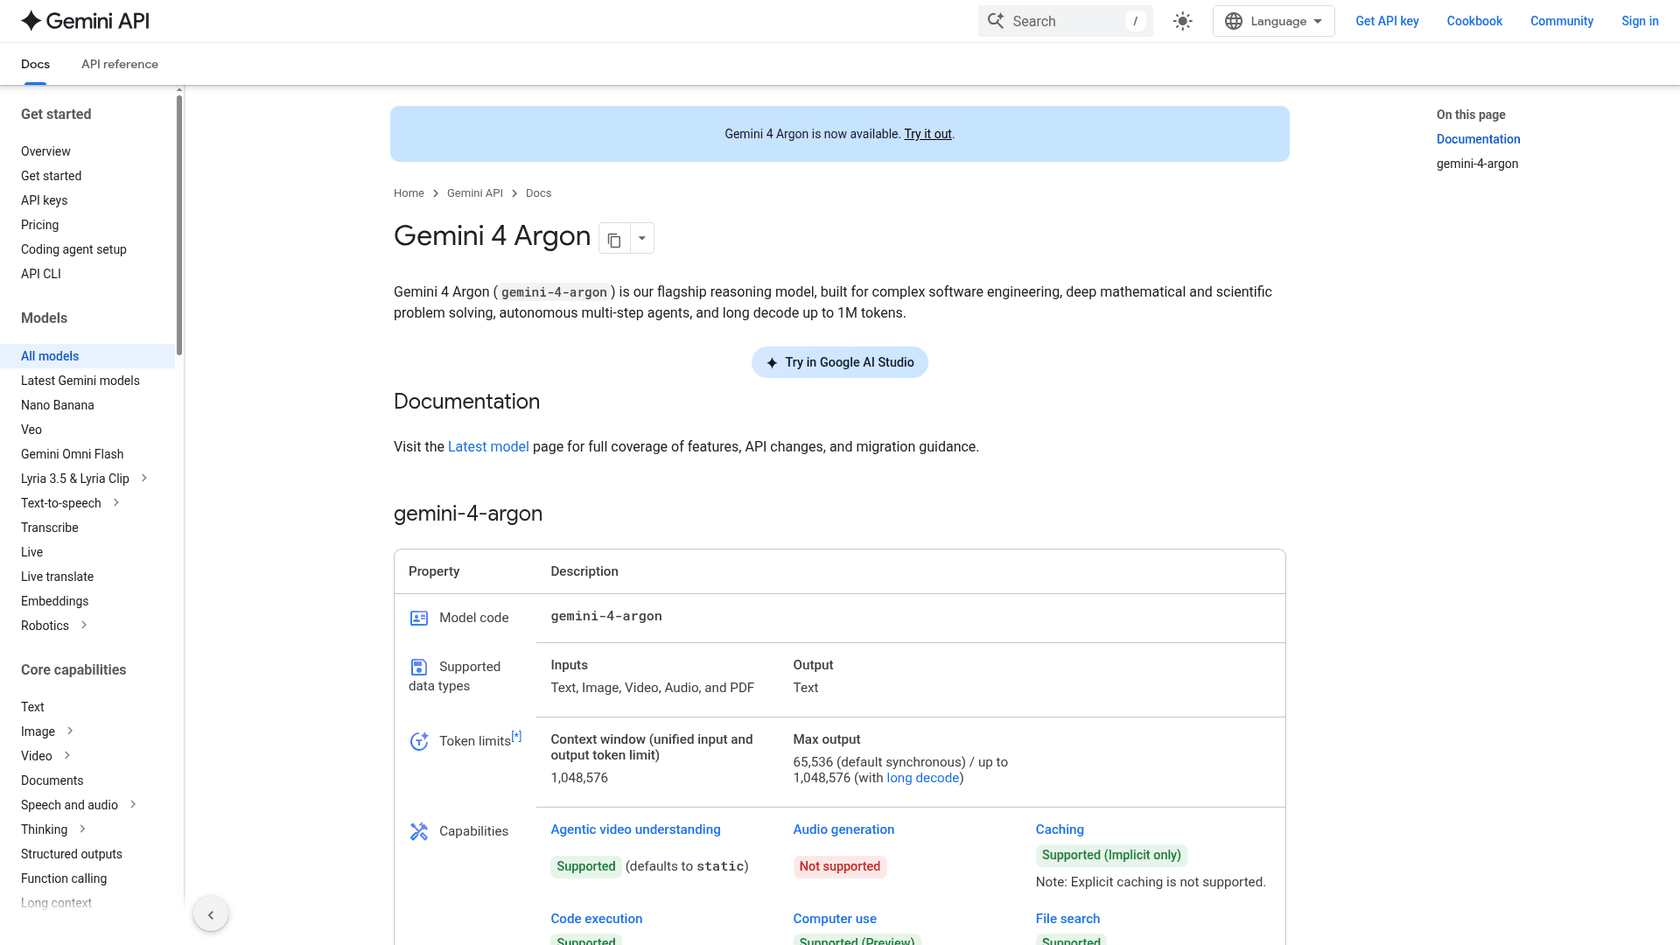
C'est le modèle phare de Google, sorti le 30 septembre 2026, et rien dans cette liste ne marque plus haut.
Avantages
- Le meilleur Intelligence Index d'ici à
52.6, plus de 4 points devant Terra en max, sur Artificial Analysis. - Son taux d'hallucination chez AA,
15%, est le plus bas de cette liste, contre38%pour Terra en max. Si les faits erronés sont votre plus grand risque, Argon est le modèle le plus sûr d'ici. - 1M de contexte et de longues sorties.
Inconvénients
- Ce prix de
$2/$10n'est qu'un tarif de lancement, qui se termine le 30 novembre. À partir du 1er décembre, il passe à$4/$20, ce qui double la facture de l'acheteur type de$7,000à$14,000. - Il est lent, avec un premier token à
48.2set environ80tokens par seconde chez AA. - Il n'y a pas de niveau gratuit, et le cache est uniquement implicite.
Tarifs : $2/$10 jusqu'au 30 novembre 2026, puis $4/$20, selon la page de tarifs de Gemini. Le guide des tarifs de Gemini 4 Argon détaille la promotion.
Mon avis : traitez Argon comme le spécialiste coûteux vers lequel votre routeur escalade, pas comme un remplaçant de Terra pour le trafic quotidien. Et budgétez au prix de décembre plutôt qu'au prix promotionnel. Le test de Gemini 4 Argon en dit plus.
6. Grok 4.7
Idéal pour : ajouter un quatrième fournisseur indépendant à votre comparatif, surtout pour de longues réponses riches en sortie.
C'est le modèle phare de xAI, décrit sur sa page de modèles comme "our flagship model for code and everything else".
Avantages
- La sortie est bon marché pour un modèle de pointe :
$6par 1M contre$10pour Sol et Sonnet, ce qui amène l'acheteur type à$5,800. - Le taux d'hallucination d'AA à effort élevé est de
32%, inférieur à celui de Terra en max. - Le raisonnement est configurable, et il existe des outils de recherche web et X côté serveur.
Inconvénients
- Avec 500K tokens, il offre deux fois moins de contexte que tout le reste ici.
- Il est cher par tâche. AA le situe à
$2.36à effort élevé pour un index de46.3, le pire rapport de cette liste. - Le premier token prend
45.7sà effort élevé, même si l'effort faible le ramène à5.4s.
Tarifs : $2 en entrée, $6 en sortie par 1M dans la documentation de xAI.
Mon avis : il mérite une place dans un comparatif pour ne pas dépendre uniquement des trois grands. D'après ces chiffres, je ne le préférerais pourtant pas à Sol ou à Sonnet. Le test de Grok 4.7 détaille le reste.
7. Claude Haiku 5.5
Idéal pour : l'étiquetage, le routage et la classification à très gros volume, quand rien ne part directement à un client.
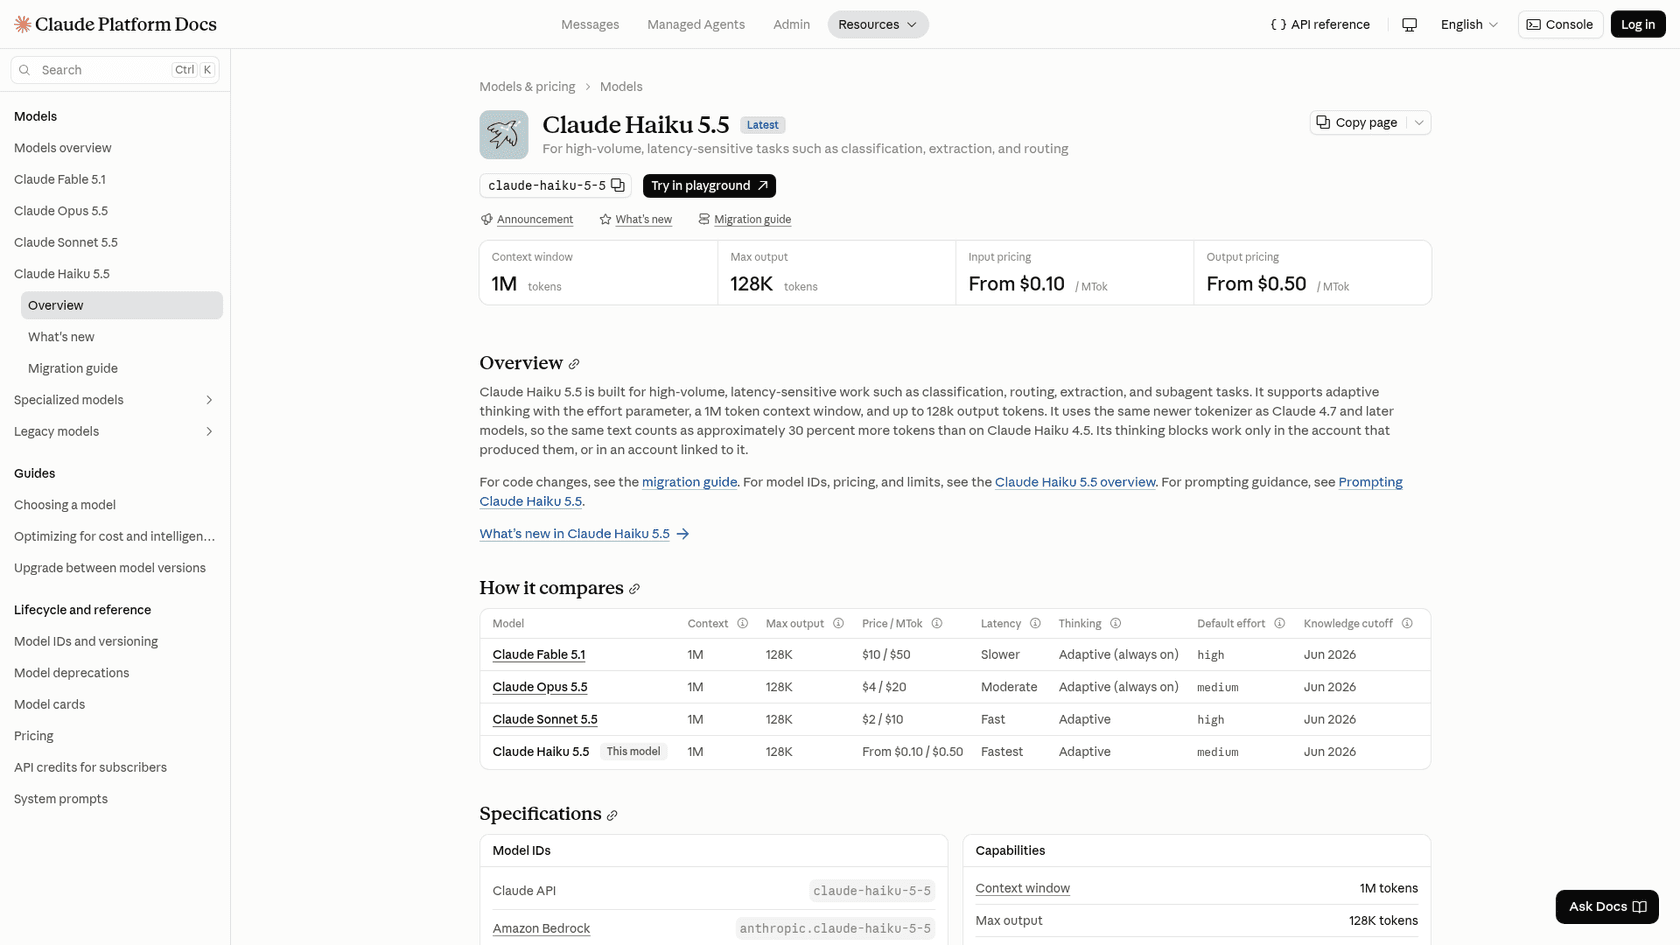
Quand Terra est plus de modèle que la tâche n'en demande, descendez d'un cran au lieu de vous déplacer sur le côté. Claude Haiku 5.5 est le petit modèle d'Anthropic, sorti le 7 octobre 2026, et il se situe au même prix de $0.10/$0.50 que GPT-6 Luna.
Avantages
- L'acheteur type paie
$350par mois, un dixième de la facture de Terra. - AA lui donne
37.8à effort élevé pour$0.08la tâche, devant les32.9de Luna. - Il tourne à environ
185tokens de sortie par seconde chez AA.
Inconvénients
- Dès qu'un prompt dépasse 100 000 tokens, vous payez 5 fois plus :
$0.50en entrée et$2.50en sortie. Un utilisateur de HN l'a qualifié de modèle "destroyed by Anthropics crazy decision to price it x5 after 100k context" (rockdoe). - Il se situe
10points sous Terra sur l'index, considérez-le donc comme un cran en dessous plutôt qu'un remplaçant.
Tarifs : $0.10/$0.50 jusqu'à des prompts de 100K tokens, $0.50/$2.50 au-delà, selon la page de tarifs de Claude.
Mon avis : Haiku 5.5 ou Luna font une bonne première passe bon marché dans un routeur. Gardez simplement les prompts sous 100K. Le test de Claude Haiku 5.5 donne ses benchmarks.
Quelle alternative à GPT-6.1 Terra convient à votre produit ?
Partez du travail à faire, pas du classement. Un modèle peut bien lire une capture d'écran et cliquer quand même sur le mauvais bouton. Un autre peut être brillant en maths et sembler lent dans une fenêtre de chat.
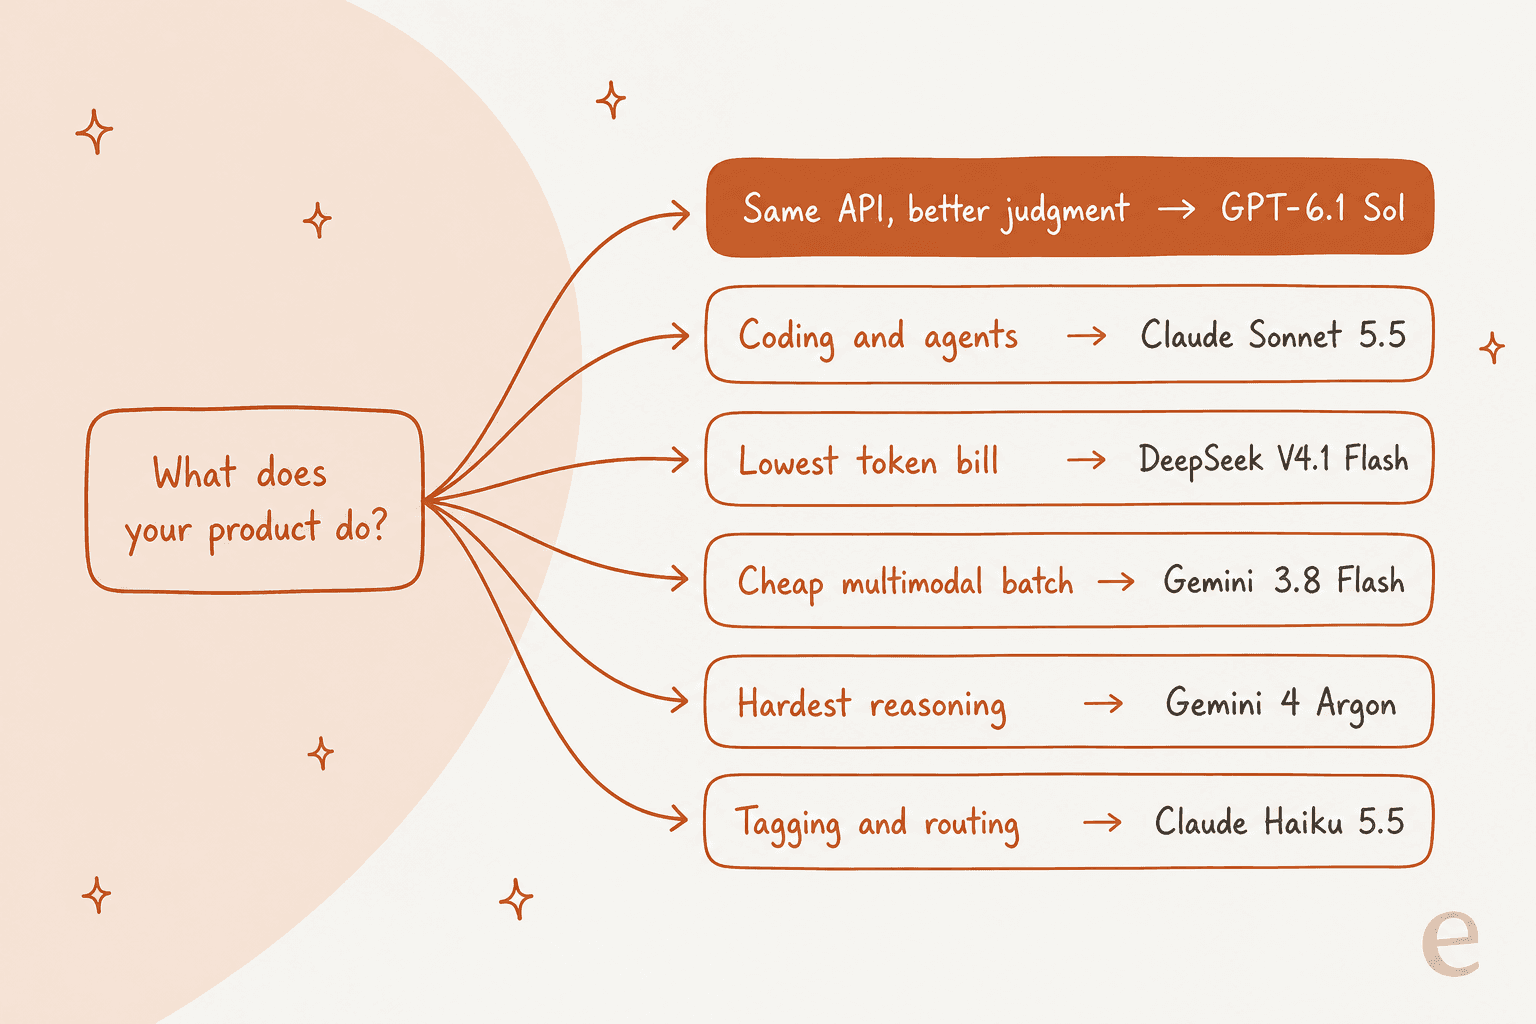
| Si votre produit sert surtout à... | À tester en premier | Pourquoi |
|---|---|---|
| Brouillons et chat orientés client | Terra en low, Sol en medium | Premier token rapide, bonne rédaction, et Sol pour les cas limites |
| Code ou agents de terminal | Claude Sonnet 5.5 | 70.6% sur Terminal-Bench 4.0 selon Anthropic |
| Extraction ou RAG à gros volume | DeepSeek V4.1 Flash | $0.15/$0.60 en heures creuses et poids ouverts |
| Traitement de PDF, vidéo ou audio de nuit | Gemini 3.8 Flash | Types d'entrée les plus larges, bon marché jusqu'en 2027 |
| Recherche et raisonnement le plus difficile | Gemini 4 Argon | Meilleur index AA, taux d'hallucination le plus bas |
| Étiquetage et routage | Claude Haiku 5.5 ou GPT-6 Luna | $0.10/$0.50 |
| Auto-hébergé ou soumis à la résidence des données | DeepSeek V4.1 Flash, ou Qwen 3.8 | Des poids que vous pouvez exécuter vous-même |
Si rien ne convient ici, deux autres valent la peine d'être connus. Kimi K3.1 Pro a obtenu 55.1 chez AA mais tourne lentement, à environ 46 tokens par seconde. Mistral Large 4 est encore en préversion.
Comment mener un comparatif de modèles avant de changer
Un classement montre comment un modèle se comporte sur le test de quelqu'un d'autre. Ce qu'il vous faut, c'est savoir comment il se comporte sur le vôtre. Voici le processus que je suivrais, de la même forme que l'évaluation de mon test de Terra :
- Récupérez 100 à 500 vraies requêtes. Anonymisez-les et gardez les vilaines : fautes de frappe, deux questions en une, délais d'attente d'outils, une injection de prompt.
- Choisissez trois challengers. Utilisez Terra comme référence, et ajoutez les deux ou trois lignes du tableau ci-dessus qui correspondent à votre usage.
- Mesurez ce que ressentent les utilisateurs. Taux de réussite des tâches, faits inventés, latence
p50etp95, exactitude des appels d'outils, nouvelles tentatives et coût par tâche réussie. - Notez à la main au début. Au premier passage, lisez vous-même chaque sortie. Une fois la grille de notation fiable, automatisez ; les outils d'évaluation d'agents d'OpenAI aident pour cela.
- Testez un routeur, pas seulement des modèles isolés. Envoyez tout vers un modèle bon marché par défaut, puis escaladez les cas difficiles ou incertains.
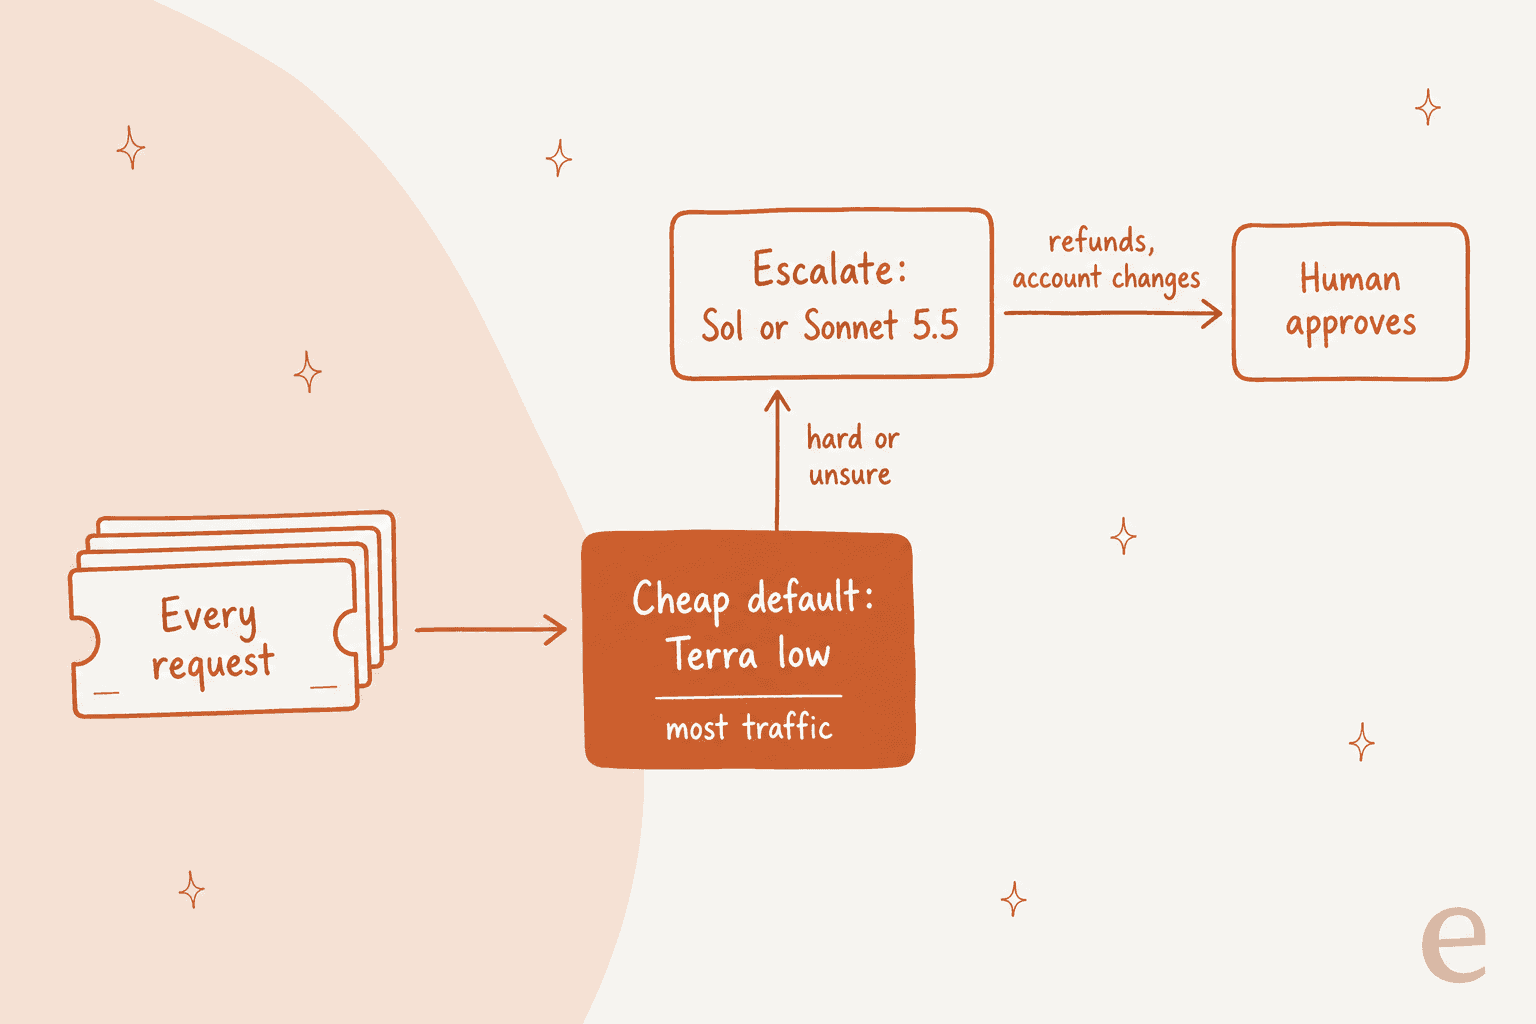
L'essentiel des économies vient du routage. OpenAI a conçu les efforts none et low de Terra pour cette voie rapide, et les utilisateurs de HN revenaient sans cesse à une question à ce sujet :
"Is a high effort terra above a low effort Sol? Are larger models mostly always better regardless of effort?"
D'après les données d'AA, la réponse est souvent non, et mesurer est le seul moyen de le savoir pour votre propre charge. Le cache aide aussi avec toutes les options. L'entrée en cache de Terra coûte $0.05, soit 95 % de remise, et le guide des tarifs de l'API OpenAI traite du Batch et des limites de débit avant de passer à l'échelle.
Si le modèle est destiné à une file de support
Beaucoup d'équipes qui comparent des alternatives à Terra construisent en réalité un bot de support. Je place depuis des années des agents IA sur des files de helpdesk en direct, et je vois toujours la même chose : le modèle est rarement le maillon faible ; ce sont les règles autour. Dans mon test de Terra sur 80 exécutions, aucun modèle n'a traité correctement moins de 15 tickets sur 16. Le seul vrai échec était Terra en none disant à un client hispanophone "we've noted the new address" alors qu'il n'avait aucun moyen de la changer.
C'est un problème d'escalade. On le règle dans la couche qui décide quand passer la main, pas en payant pour un modèle plus gros. Ce qui évite les hallucinations de l'IA, c'est d'ancrer les réponses dans votre centre d'aide et vos tickets passés, quel que soit le modèle qui écrit les mots. Et à côté d'une promesse erronée faite à un client payant, la facture de tokens est une petite part du coût de l'IA pour le service client.
SamCart montre à quoi ressemble cette couche en pratique. Un agent eesel traite ses tickets Freshdesk et un autre son chat de site web, tous deux répondant à partir d'environ 280 articles du centre d'aide, sur une formule dimensionnée pour 8 000 interactions par mois. Koffer.ch, une boutique suisse de valises, garde chaque réponse en brouillon en allemand, français, anglais ou italien sur Freshdesk. C'est exactement le genre de configuration où un modèle moins cher fait très bien le travail.
Vous préférez piloter depuis le code ? La CLI d'eesel exécute le même coéquipier que vous configureriez dans le tableau de bord. Testez une réponse avec eesel chat et voyez ce que l'agent a fait avec eesel activity ; tout changement peut être prévisualisé avec --dry-run. Chaque commande renvoie du JSON. Chaque espace de travail est aussi un serveur MCP, de sorte qu'un agent de code tournant sur Terra ou Sonnet peut appeler votre coéquipier de support comme un outil.
Essayer eesel
Terra, Sol et Sonnet sont des moteurs. Quand ce que vous construisez est de l'automatisation du support, eesel est le coéquipier IA de helpdesk qui fait déjà ce travail par-dessus. Il rejoint le helpdesk que vous utilisez déjà, que ce soit Zendesk, Freshdesk, Gorgias ou un autre. Il apprend de vos tickets et macros passés autant que de votre centre d'aide, et suit les règles d'escalade que vous définissez. Avant de répondre à qui que ce soit en direct, il lance une simulation sur vos vrais tickets passés, pour que vous puissiez comparer ses réponses à ce que votre équipe a réellement envoyé.

La tarification est une formule à crédits mensuelle fixe, où un ticket ou un chat compte pour un crédit. Elle démarre à $299 par mois pour 500 crédits, avec toutes les fonctionnalités et des sièges illimités inclus. Comme il n'y a pas de frais par token, votre facture ne bouge pas quand un modèle moins cher comme Terra sort. Commencez avec la formule gratuite et essayez eesel sur une partie de votre file.