

GPT-6.1 Terra coûte 1 $ par million de tokens d'entrée et 5 $ par million de sortie, avec l'entrée en cache à $0.05, selon la page de tarifs d'OpenAI. C'est la moitié de GPT-6.1 Sol par token et moins de la moitié de l'ancien GPT-5.6 Terra.
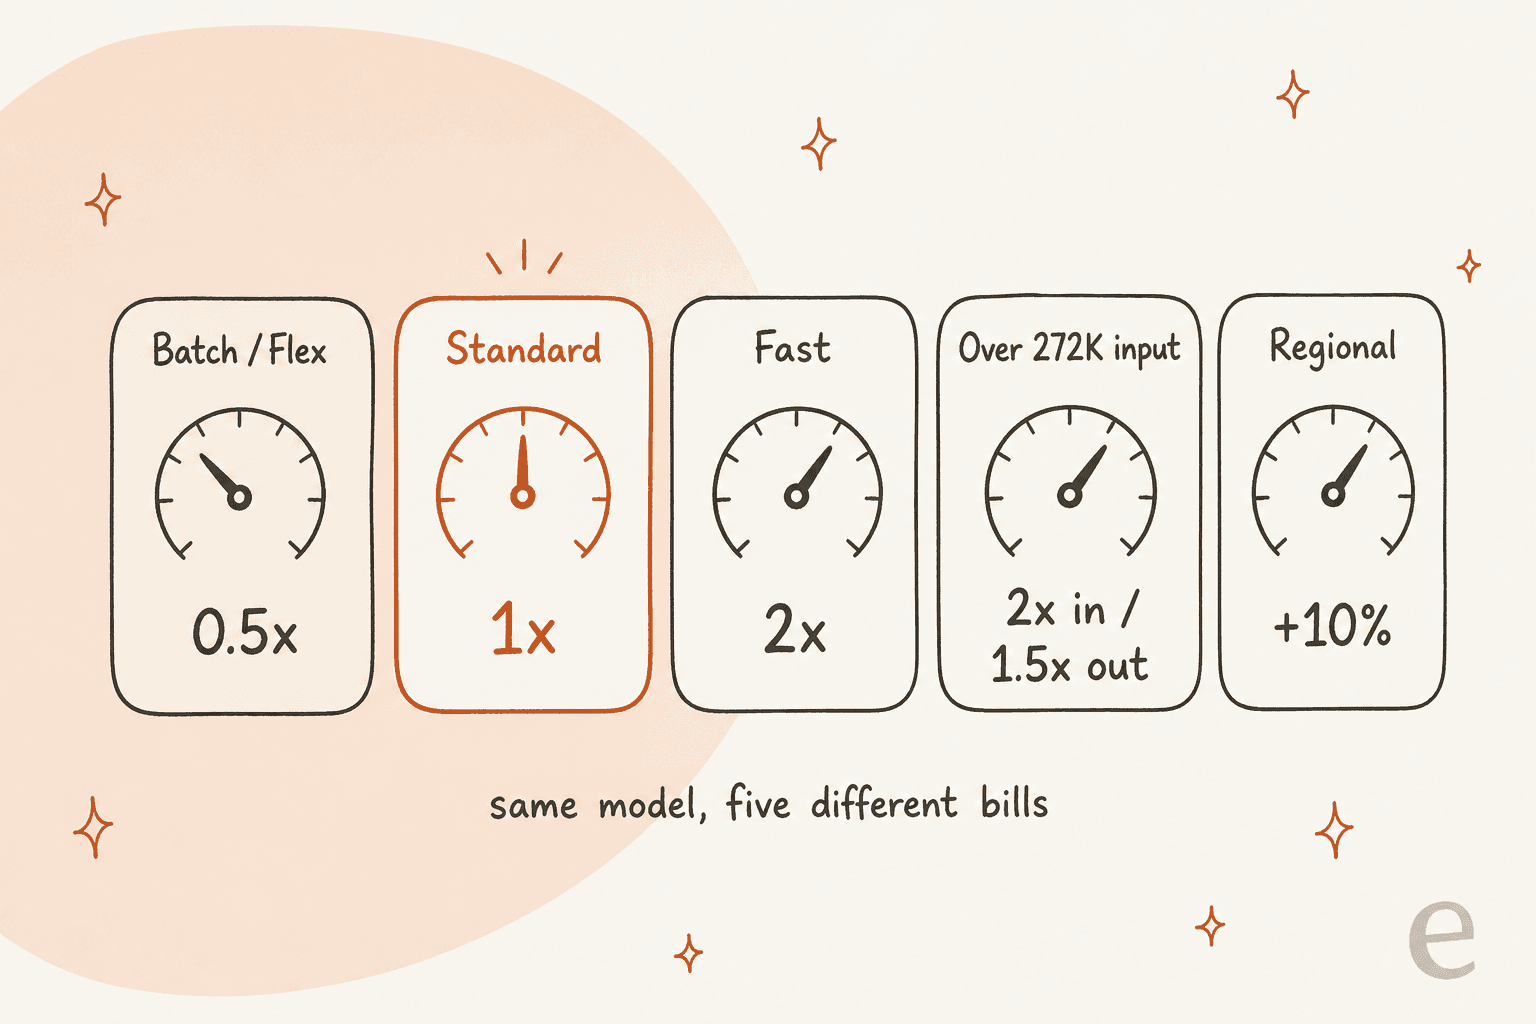
Le prix affiché ne décide pourtant pas de votre facture. Trois choses le font : le niveau d'effort ($0.05 par tâche en low, $0.40 en max, selon Artificial Analysis), la règle de long contexte de 272K qui double le prix de toute la requête, et le cache, qui réduit l'entrée de 95 % mais facture 1,25x pour écrire le cache au départ.
Mon avis : utilisez Terra en low ou medium, gardez les prompts sous 272K et passez par Batch pour tout ce qui peut attendre. Dans le test de GPT-6.1 Terra, j'ai lancé 80 tests de tickets de support, et le modèle a coûté moins d'un centime par ticket. Pour une équipe support, les tokens sont la partie bon marché. smava fait trier et rédiger environ 27 000 tickets allemands par mois dans Zendesk avec eesel, et ce qui a fait fonctionner la chose, ce sont 820 macros et articles, pas le prix du modèle.
Combien coûte GPT-6.1 Terra ?
GPT-6.1 Terra coûte $1.00 par million de tokens d'entrée, $0.05 par million de tokens d'entrée en cache et $5.00 par million de tokens de sortie à la vitesse Standard. Je construis le côté API des intégrations d'eesel, donc je lis les pages de tarifs comme je lis une documentation d'API : je cherche les multiplicateurs cachés sous le chiffre d'appel. Terra en a cinq.
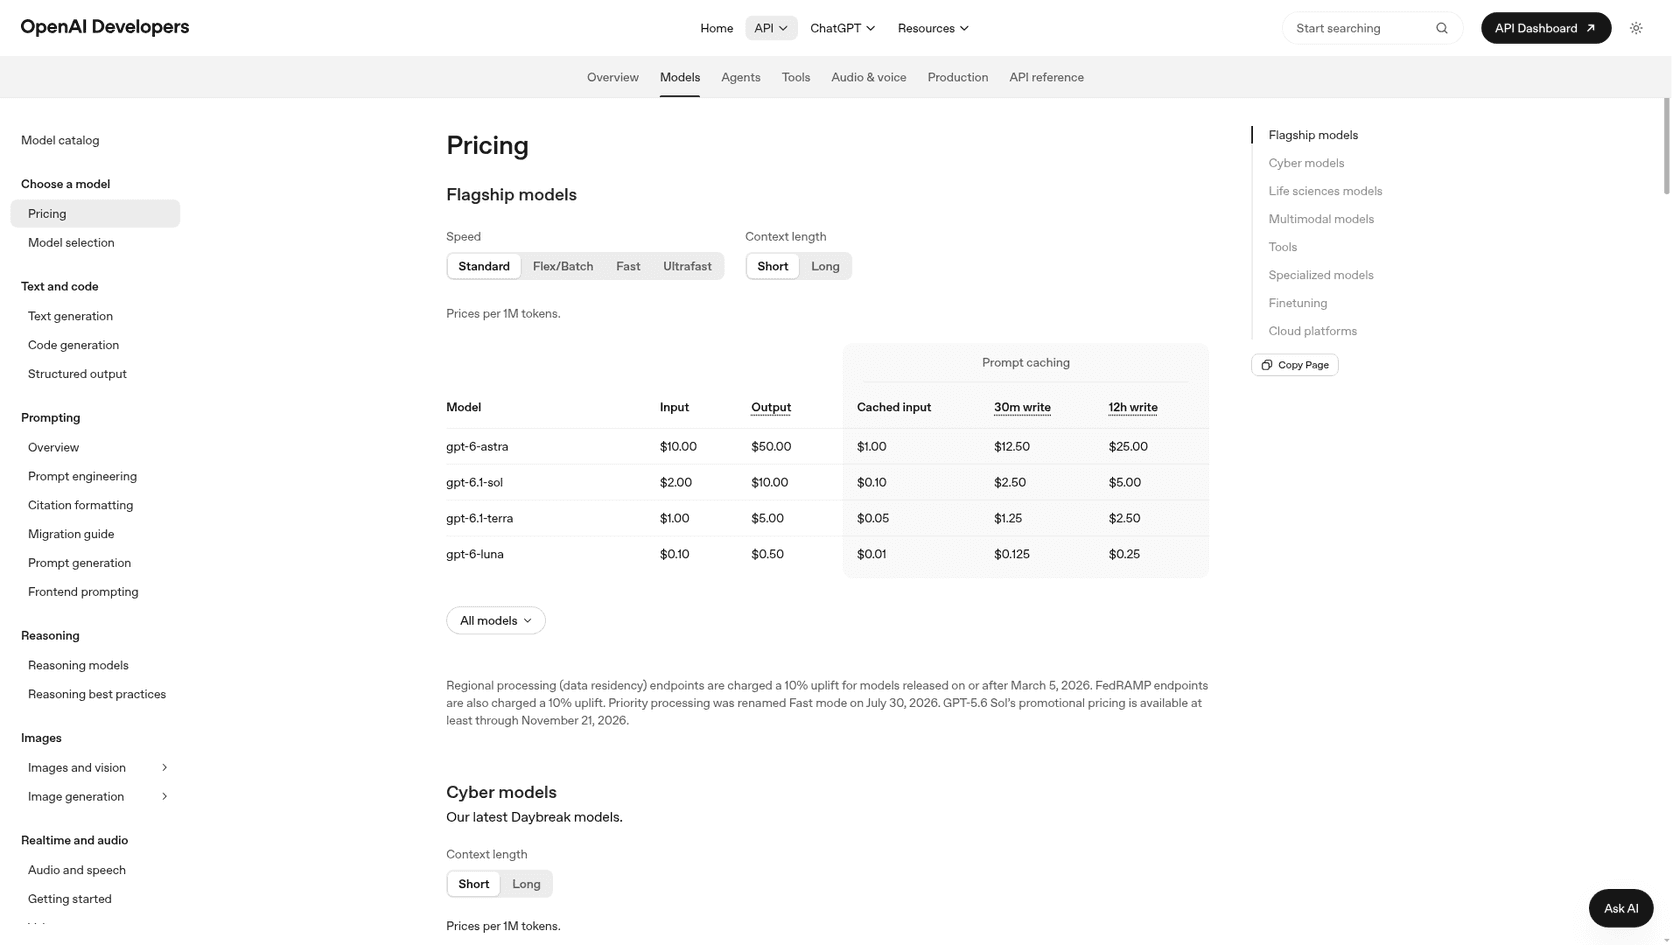
Voici la grille tarifaire complète, par million de tokens :
| Niveau | Entrée | Entrée en cache | Écriture de cache (30 min) | Écriture de cache (12 h) | Sortie |
|---|---|---|---|---|---|
| Standard (jusqu'à 272K en entrée) | $1.00 | $0.05 | $1.25 | $2.50 | $5.00 |
| Standard (plus de 272K en entrée) | $2.00 | $0.10 | $2.50 | $5.00 | $7.50 |
| Batch / Flex | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Fast | $2.00 | $0.10 | $2.50 | $5.00 | $10.00 |
| Ultrafast | Non proposé |
Source : tarifs de l'API OpenAI et la page du modèle GPT-6.1 Terra. Le traitement régional (résidence des données) et les endpoints FedRAMP ajoutent 10 %. Ultrafast n'existe aujourd'hui que pour Sol et Astra.
Quelques points de ce tableau méritent d'être lus lentement :
- Les tokens de raisonnement sont facturés comme de la sortie. Chaque niveau d'effort au-dessus de
noneproduit des tokens de réflexion que vous ne voyez jamais, et chacun coûte$5par million. C'est pourquoi l'effort fait varier la facture plus que tout le reste. - Les lectures de cache coûtent 5 % de l'entrée, les écritures 125 %. La page du modèle indique que l'entrée en cache est facturée à 5 % du tarif sans cache, et que les écritures coûtent
$1.25pour 30 minutes de rétention et$2.50pour 12 heures. - Le tarif long contexte couvre toute la requête. La formulation d'OpenAI est "2x input and cache rates and 1.5x output for the full request." Un seul token au-delà de 272K, et chaque token de cet appel coûte plus cher.
Si vous voulez tout le catalogue OpenAI côte à côte, le guide des tarifs de l'API OpenAI contient chaque modèle, et la liste des modèles OpenAI explique où chacun se place.
Que coûte réellement une tâche avec GPT-6.1 Terra ?
Une tâche coûte entre $0.05 et $0.40 sur la suite de tests d'Artificial Analysis, et le réglage d'effort fait toute la différence. Même modèle, même prix par token, un écart de 8x :
| Effort de Terra | Intelligence Index | Coût par tâche | Temps par tâche |
|---|---|---|---|
none (sans raisonnement) | 33.5 | $0.11 | n/d |
low | 36.2 | $0.05 | 29s |
medium | 41.3 | $0.10 | 63s |
high | 43.9 | $0.13 | 96s |
xhigh | 45.4 | $0.19 | 160s |
max | 48.1 | $0.40 | 384s |
Source : pages de modèle par effort d'Artificial Analysis. Artificial Analysis qualifie low et medium de réglages optimaux au sens de Pareto, c'est-à-dire qu'aucun modèle qu'il suit n'est à la fois moins cher et plus intelligent à ces points.
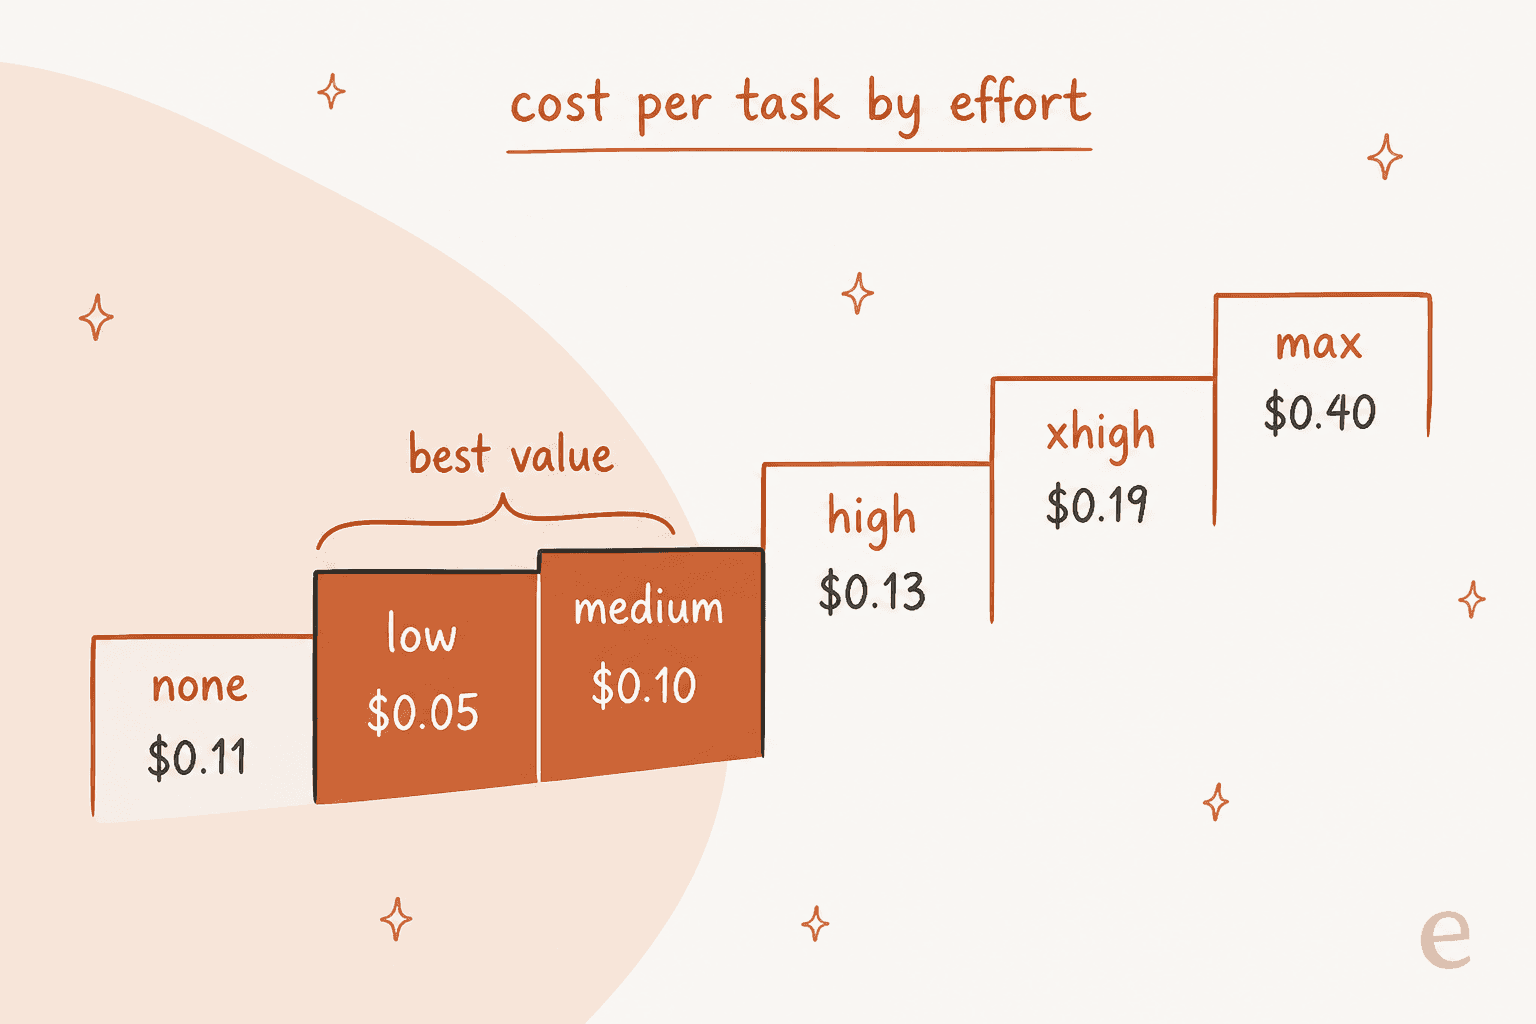
Deux détails m'ont surpris. D'abord, none coûte plus cher par tâche que low sur cette suite, le contraire de ce que suggèrent les noms. simonw a vu quelque chose de similaire dans un test le jour du lancement sur Hacker News : les deux réglages ont dépensé zéro token de raisonnement sur son prompt, et low est tout de même revenu moins cher. Ne supposez pas que none est le réglage économique ; mesurez.
Ensuite, l'effort max est le point où Terra cesse d'être l'option bon marché. Passer de medium à max coûte 4x plus et prend 6x plus de temps pour 7 points d'indice de plus. À ce stade, GPT-6.1 Sol en medium ($0.21 par tâche, indice 47.8) vous donne à peu près le même score pour environ moitié moins cher. Les lecteurs de Hacker News l'ont calculé en quelques heures :
"Per token, yes. But per task it's not even necessarily the case depending on how much thinking is needed."

Et de la part de quelqu'un qui l'utilise en production :
"I have some business automation process for some customers that I maintain, where Terra with low reasoning ended up with the best price/performance & latency."
Cela correspond à ce que j'ai mesuré dans mon propre test de Terra. Sur 16 tickets de support passés par la Responses API, Terra en low a obtenu le même score qu'en medium et a coûté $0.75 pour 1 000 tickets au lieu de $0.92 :
| Configuration | Corrects (sur 16) | Coût pour 1 000 tickets | Temps moyen |
|---|---|---|---|
Terra, none | 15 (1 échec) | $0.65 | 2.5s |
Terra, low | 15 | $0.75 | 2.7s |
Terra, medium | 15 | $0.92 | 3.1s |
GPT-6.1 Sol, medium | 16 | $1.62 | 3.9s |
GPT-6 Luna, medium | 15 | $0.14 | 4.1s |
Le réglage none était le moins cher, mais il a dit à un client hispanophone que son changement d'adresse était « noté » alors qu'il n'avait aucun outil pour modifier quoi que ce soit. C'est 10 centimes d'économie pour 1 000 tickets, payés avec une promesse que votre équipe ne peut pas tenir. Je commencerais à low.
Pourquoi un long prompt coûte-t-il deux fois plus cher ?
Parce que le tarif long contexte s'applique à toute la requête, pas seulement aux tokens au-delà de la limite. Sous 272K tokens d'entrée, vous payez $1/$5. Au-dessus, tout l'appel est facturé à $2/$7.50.
Le saut est brutal. Une requête avec 270K en entrée et 2K en sortie coûte $0.28. Ajoutez 10K d'entrée et elle coûte $0.58, plus du double, pour 4 % de texte en plus.
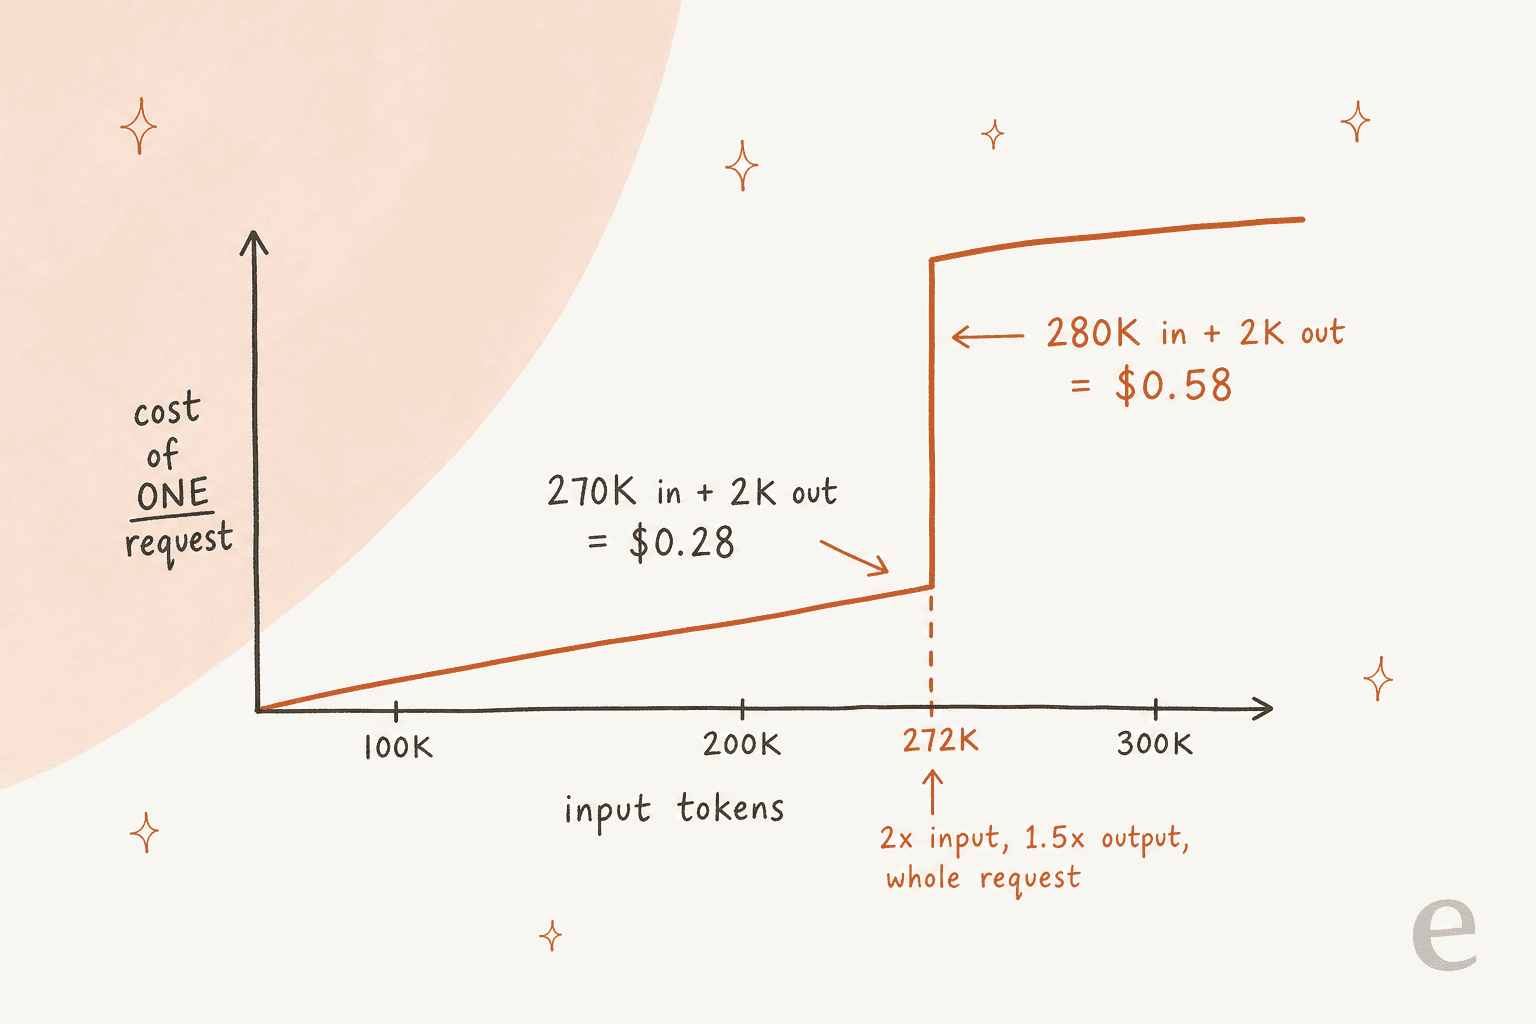
La fenêtre de contexte de Terra est de 1,050,000 tokens, il avale donc volontiers un contrat ou un export de logs de 400K tokens. Voici ce que cela coûte, et ce que coûte le découpage :
| Approche | Calcul | Coût |
|---|---|---|
| Une requête de 400K tokens, 4K en sortie | 400K x $2 + 4K x $7.50 | $0.83 |
| Deux requêtes de 200K tokens, 4K en sortie chacune | 2 x (200K x $1 + 4K x $5) | $0.44 |
Le découpage économise 47 %, tant que la tâche supporte d'être découpée. Les résumés, l'extraction et la relecture par section s'y prêtent généralement. Une question qui a besoin de tout le document d'un coup, non, et vous payez alors le tarif long contexte.
La façon discrète de franchir la limite est une boucle d'agent. Chaque tour renvoie la conversation, donc une session qui démarre à 50K peut dépasser 272K vers le tour 20 sans que personne ne s'en aperçoive. Si vous utilisez Terra comme agent, journalisez les tokens d'entrée par appel et réduisez ou résumez l'historique avant d'y arriver. Le guide du function calling d'OpenAI explique comment les résultats d'outils s'ajoutent à cet historique.
Le cache de prompts fait-il économiser de l'argent avec Terra ?
Oui, quand le trafic est régulier. L'entrée en cache coûte $0.05 par million, 95 % de réduction. Le piège, c'est l'écriture : stocker un préfixe dans le cache coûte $1.25 par million pendant 30 minutes, ou $2.50 pendant 12 heures, soit plus cher que de l'envoyer sans cache.
Prenez une réponse de support avec un prompt système et un bloc de politiques de 4 000 tokens qui ne change jamais, 2 000 tokens de ticket et de contexte du centre d'aide qui changent, et 400 tokens de sortie :
| Scénario | Par ticket | Pour 1 000 tickets |
|---|---|---|
| Sans cache | $0.0080 | $8.00 |
| Préfixe en cache et lu (file chargée) | $0.0042 | $4.20 |
| Préfixe écrit à chaque fois (un ticket toutes les 30 min) | $0.0090 | $9.00 |
Sur une file chargée, le préfixe est écrit une fois par fenêtre et lu des milliers de fois, donc le cache réduit presque la facture de moitié. Sur une file calme, où chaque requête arrive après l'expiration du cache, vous payez la surcharge d'écriture à chaque fois et finissez environ 12 % plus mal qu'en n'utilisant pas du tout le cache.
Le guide du modèle d'OpenAI recommande de suivre cached_tokens et cache_write_tokens pour comprendre le coût net, et c'est la bonne habitude. La rétention de 12 heures ne rapporte que lorsqu'un préfixe est réutilisé sur plusieurs heures mais moins de 30 minutes d'écart entre deux usages, comme dans une tâche de nuit.
Combien Terra coûte-t-il par mois ?
Voici une charge de travail chiffrée sur tous les niveaux : 1 million de requêtes par mois, chacune avec 2 000 tokens d'entrée et 300 de sortie.
| Niveau | Coût d'entrée | Coût de sortie | Total mensuel |
|---|---|---|---|
| Standard | $2,000 | $1,500 | $3,500 |
| Batch / Flex | $1,000 | $750 | $1,750 |
| Fast | $4,000 | $3,000 | $7,000 |
| Standard + régional | $2,200 | $1,650 | $3,850 |
Batch est l'économie la plus simple. Si les résultats peuvent arriver dans la fenêtre du batch (classification, résumés de nuit, reprises d'historique), vous payez moitié moins. Le guide de la Batch API d'OpenAI couvre la mise en place. Le mode Fast n'a de sens que pour les appels côté utilisateur où la latence vous fait perdre un client.
Pour chiffrer votre propre charge, entrez vos chiffres ici :
Les valeurs par défaut correspondent à un mois de 100 000 tickets avec un prompt de 6 000 tokens, soit environ $800. Saisissez la taille réelle de votre prompt, pas celle de votre prototype. Les extraits récupérés du centre d'aide et l'historique de conversation rendent généralement un prompt 5x à 10x plus gros que prévu.
Comment les tarifs de Terra se comparent-ils à ceux des autres modèles ?
Terra est le deuxième barreau de l'échelle de quatre modèles d'OpenAI. Voici la même charge de 1 million de requêtes (2 000 en entrée, 300 en sortie) sur la famille OpenAI et les concurrents les plus proches :
| Modèle | Entrée / sortie par 1M | Entrée en cache | Coût AA par tâche | Facture mensuelle (exemple) |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | n/d | $350 |
| GPT-6.1 Terra | $1.00 / $5.00 | $0.05 | $0.40 (max) | $3,500 |
| GPT-6.1 Sol | $2.00 / $10.00 | $0.10 | $0.21 (medium) | $7,000 |
| GPT-6 Astra | $10.00 / $50.00 | $1.00 | $3.26 (max) | $35,000 |
| GPT-5.6 Terra (précédent) | $2.00 / $12.00 | n/d | $1.40 (max) | $7,600 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $0.10 | $0.88 (high) | $7,000 |
| Claude Haiku 5.5 | $0.10 / $0.50 | $0.01 | $0.08 (high) | $350 |
| DeepSeek V4.1 Flash | $0.15 / $0.60 hors heures de pointe | $0.003 | $0.26 (max) | $480 |
| Gemini 3.8 Flash | $0.75 / $3.75 jusqu'au 31 déc. | $0.075 | $3.49 (high) | $2,625 |
Sources : tarifs de l'API OpenAI, la page de tarifs de chaque éditeur au 28 octobre 2026, et Artificial Analysis pour le coût par tâche. Le tarif de Haiku s'applique jusqu'à un prompt de 100K.
Par rapport à son prédécesseur, la baisse est réelle. Le fil de lancement d'OpenAI l'a dit simplement :
"It's a significant step up over GPT‑5.6 Terra, with 50% lower standard API prices."
Au niveau du token, Terra est dans la moyenne : 10x Luna et Haiku, la moitié de Sol et Sonnet. Par tâche, c'est l'un des modèles les moins chers avec un Intelligence Index supérieur à 45. Si votre travail se limite à de l'étiquetage et du routage, Luna à un dixième du prix est le meilleur achat. S'il s'agit de programmation difficile, OpenAI elle-même vous oriente vers Sol ou GPT-6 Astra. L'article sur les alternatives à GPT-6.1 Terra passe en revue chaque option en détail.
Que coûte Terra dans ChatGPT et Codex ?
Il n'y a pas de tarif Terra distinct dans ChatGPT. Il est inclus avec les offres Plus, Pro, Enterprise et Edu dans ChatGPT Work et Codex, selon l'article de lancement d'OpenAI. OpenAI affirme que votre quota d'utilisation va plus loin avec Terra qu'avec GPT-5.6 Terra, et bien plus loin qu'avec Sol ou Astra.
Dans un abonnement, choisir Terra ne baisse donc pas la facture, cela étire le quota. Si vous atteignez les limites avec Sol sur du travail courant, basculer ces tâches vers Terra est la solution économique. Les guides sur les tarifs de ChatGPT Work et les tarifs de Codex détaillent ce que comprend chaque offre, et ChatGPT Enterprise explique le niveau espace de travail.
Quels sont les coûts cachés et les limites ?
La plupart sont petits pris isolément et s'additionnent ensemble. Voici la liste que je vérifierais avant de m'engager :
- Pas de niveau gratuit pour l'API. La page du modèle indique Free comme "Not supported." Il vous faut un compte payant dès le premier appel.
- Les limites de débit démarrent bas. Le niveau Build donne
5,000requêtes et1,000,000tokens par minute. À 2 300 tokens par requête, cela fait environ 430 requêtes par minute. Launch monte à4,000,000TPM et Grow à40,000,000. Le guide des limites de débit d'OpenAI explique comment monter en niveau. - Les appels d'outils coûtent en plus. La recherche web et la recherche de fichiers sont facturées par appel ou par Go en plus des tokens, et les tokens utilisés par les outils intégrés sont facturés aux tarifs de Terra, selon la page de tarifs.
- Le traitement régional, c'est +10 %. La résidence des données et les endpoints FedRAMP portent la majoration pour les modèles sortis à partir du 5 mars 2026, ce qui inclut Terra.
- Nouvelles tentatives et évaluations. Un appel d'outil raté ou une réponse que vous régénérez est facturé en entier. Prévoyez une marge, et lancez des évaluations d'agents OpenAI sur un jeu fixe avant de changer de niveau d'effort, pour comparer les coûts à qualité égale.
| Niveau de limite de débit | Requêtes par minute | Tokens par minute | Limite de file Batch |
|---|---|---|---|
| Free | Non pris en charge | ||
| Build | 5,000 | 1,000,000 | 3,000,000 |
| Launch | 10,000 | 4,000,000 | 200,000,000 |
| Grow | 15,000 | 40,000,000 | 15,000,000,000 |
Source : page du modèle GPT-6.1 Terra.
GPT-6.1 Terra vaut-il le coup pour le support client ?
Pour la rédaction et le tri, oui, et la facture de tokens est la plus petite ligne du budget. Un ticket de support réaliste, avec un prompt de 6 000 tokens, coûte environ $0.008 en Standard. Un mois de 10 000 tickets représente $80 de coûts de modèle, ou environ $42 avec un préfixe en cache.
Ce qui coûte réellement de l'argent à une équipe support, c'est la mauvaise réponse. Dans mon test, le réglage le moins cher a dit à un client qu'un changement d'adresse était fait alors que ce n'était pas le cas, et ce seul ticket coûterait plus en relance et en remboursement qu'une année d'économies de tokens. eesel place depuis des années des agents IA sur de vraies files de support et construit les intégrations pour eux, et je réapprends sans cesse la même leçon : le modèle est la plus petite moitié du travail. La plus grande moitié, c'est ce qu'il lit, ce qu'il a le droit de faire et le moment où il passe la main à une personne. L'analyse du coût de l'IA pour le service client donne le tableau complet, et les hallucinations de l'IA dans le support traitent du mode d'échec ci-dessus.
L'histoire de smava montre à quoi ressemble cette moitié. Son agent eesel travaille dans l'IA pour Zendesk, traite environ 27 000 tickets par mois sur deux marques de crédit, a préparé 15 300 brouillons de réponse en un mois, et rédige à partir des 820 macros et articles du centre d'aide que l'équipe entretient déjà dans Zendesk. En finance réglementée, une réponse qui promet ce que l'équipe ne tiendra pas est un vrai préjudice, c'est pourquoi la formulation vient des macros, pas de l'imagination du modèle. Dokument 24 applique le même schéma en danois : 670 brouillons de réponse par mois restent des notes internes que l'équipe vérifie et envoie, un bon cas pour le support client multilingue.
Essayer eesel
Si vous chiffrez Terra parce que vous voulez une IA qui rédige ou répond aux tickets, vous n'avez peut-être pas besoin de construire le pipeline. eesel est une plateforme de coéquipiers IA, et son agent IA de helpdesk rejoint votre file Zendesk, Freshdesk ou Gorgias existante, apprend de vos anciens tickets et de votre centre d'aide, puis rédige ou répond avec les règles d'escalade que vous définissez. Vous pouvez le tester sur vos propres tickets historiques avant qu'il ne touche un vrai client.
La tarification se fait par ticket, pas par token : les offres d'eesel démarrent à $299 par mois pour 500 crédits, un ticket valant un crédit quelle que soit la longueur du fil, avec 100 crédits gratuits pour essayer. Le choix du modèle, la taille du prompt et la règle des 272K passent ainsi du côté d'eesel de la table plutôt que du vôtre. SamCart fait tourner un agent sur les tickets Freshdesk et un autre sur le chat de son site, tous deux répondant à partir de 280 articles du centre d'aide.
Si vous préférez piloter par le code, la CLI d'eesel fait fonctionner le même coéquipier depuis un terminal, et chaque espace de travail est aussi un serveur MCP, de sorte qu'une session Codex sous GPT-6.1 Terra peut appeler votre agent de support comme un outil. Essayez eesel et voyez les brouillons sur vos propres tickets.
Questions fréquentes
Combien coûte GPT-6.1 Terra ?
Combien coûte GPT-6.1 Terra par tâche ?
GPT-6.1 Terra est-il moins cher que GPT-6.1 Sol ?
Quel est le tarif long contexte de GPT-6.1 Terra ?
GPT-6.1 Terra a-t-il un niveau gratuit ?
gpt-6.1-terra, et les limites de débit commencent à 5 000 requêtes et 1 million de tokens par minute au niveau Build. Le guide des limites de débit d'OpenAI explique comment les niveaux montent. Dans ChatGPT, Terra est inclus avec les offres Plus, Pro, Enterprise et Edu.