

Tarifs Cohere Embed 5 en un coup d'œil
Cohere a lancé la famille Embed 5 le 30 septembre 2026, en deux niveaux, qui partagent tous deux un contexte de 128K et plus de 100 langues, avec des entrées pouvant être du texte, une image ou la combinaison fusionnée texte plus image. J'ai relevé chaque prix publié et les ai réunis dans un tableau, tirés directement de la page de tarifs de Cohere, de l'article de lancement et des fiches des places de marché cloud :
| Option | Prix | Facturé par | Idéal pour |
|---|---|---|---|
| Clé d'essai | Gratuit, 1 000 appels/mois | n/a (pas d'usage en production) | Tests |
| Embed 5 Pro, texte | 0,12 $ / million de tokens | Tokens d'entrée | Indexer des documents |
| Embed 5 Fast, texte | 0,08 $ / million de tokens | Tokens d'entrée | Requêtes, boucles d'agents |
| Embed 5 Pro ou Fast, images | 0,40 $ / million de tokens | Tokens d'image | Images de pages, diapositives |
| Model Vault Small (Pro ou Fast) | 3,00 $/h ou 2 000 $/mois | Instance dédiée | Volume élevé et constant |
| Model Vault Medium (Pro ou Fast) | 5,00 $/h ou 3 250 $/mois | Instance dédiée | Très gros volume |
| Amazon SageMaker | 2,39 $ à 8,48 $/hôte/h de frais logiciels + instance | Heure | Équipes déjà sur AWS |
| Microsoft Foundry | Listé en préversion, pas encore de prix | n/a | Équipes sur Azure |
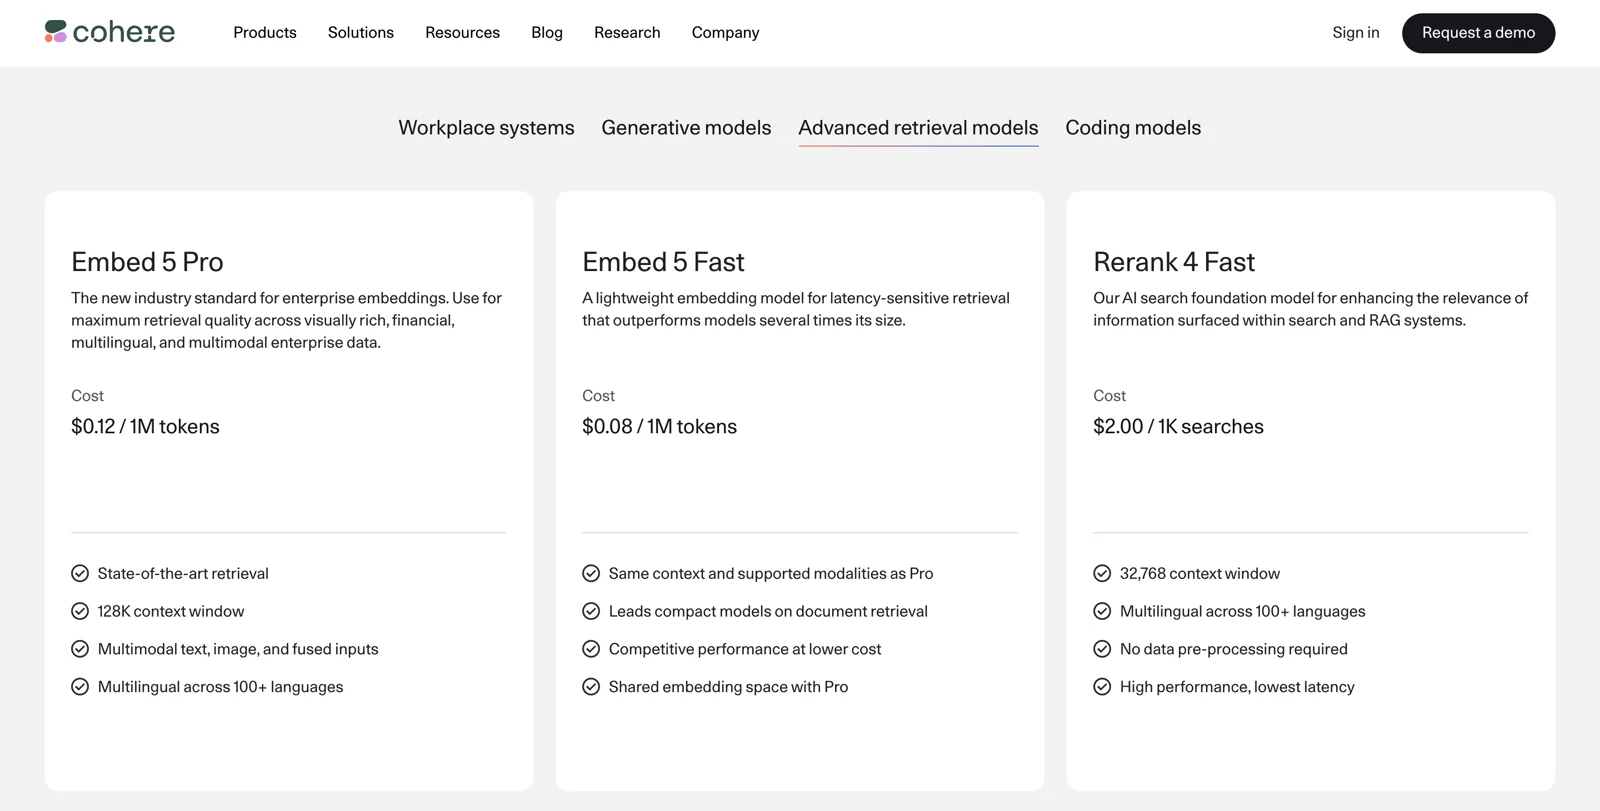
Le même onglet liste aussi Parse 5 à 1,50 $ pour 1 000 pages et Rerank 4 dès 2,00 $ pour 1 000 recherches, et avec Embed 5 ils forment toute la pile de recherche que vend Cohere. En lisant les fiches, deux choses m'ont sauté aux yeux. D'abord, Model Vault facture le même tarif pour Pro et Fast, ce qui signifie que sur une instance dédiée toute la logique du « Fast est moins cher » disparaît, et que la seule raison de choisir Fast y est la vitesse. Ensuite, Embed 4 a complètement disparu de la page de tarifs, alors que la documentation des modèles le liste encore sans avis de dépréciation. Si vous êtes sur Embed 4 aujourd'hui, rien ne casse, mais le signal sur l'endroit où Cohere veut vous voir est assez clair. (Mon avis sur Cohere AI couvre le reste de la gamme.)
Je construis des intégrations chez eesel, et la partie d'eesel qui transforme un centre d'aide et quelques années de tickets en quelque chose qu'une IA peut interroger, c'est précisément cette couche. Quand je lis des fiches de prix d'embeddings, je les lis donc comme un plombier lit un devis de tuyaux. Le prix à l'unité compte, bien sûr, mais ce que vous chiffrez vraiment, c'est tout ce à quoi les tuyaux se raccordent.
Ce qui change par rapport à Embed 4
La version courte : Cohere a tenu le prix, puis bougé à peu près tout le reste. Voici la comparaison côte à côte, avec les tarifs d'Embed 4 tirés des tarifs Cohere sur Azure et de l'instantané de prix de Cohere d'août :
| Embed 4 | Embed 5 Pro | Embed 5 Fast | |
|---|---|---|---|
| Texte, par million de tokens | 0,12 $ | 0,12 $ | 0,08 $ |
| Images, par million de tokens | 0,47 $ | 0,40 $ | 0,40 $ |
| Model Vault Small | 4,00 $/h, 2 500 $/mois | 3,00 $/h, 2 000 $/mois | 3,00 $/h, 2 000 $/mois |
| Dimensions par défaut | 1536 | 2048 | 2048 |
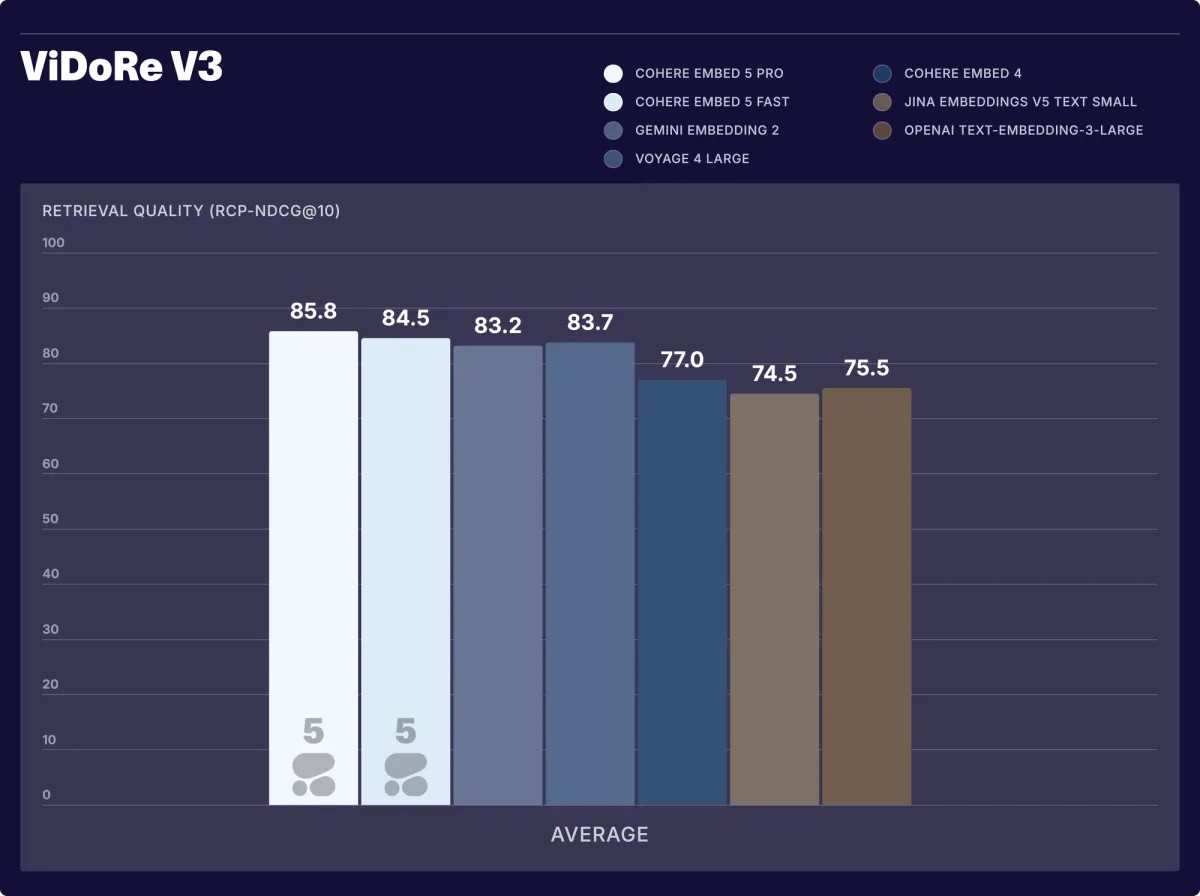
| Score ViDoRe V3 (Cohere) | 77,0 | 85,8 | 84,5 |
Vous obtenez donc un bond de qualité de 8,8 points au même prix du texte, des images 15 % moins chères et une instance dédiée à 500 $ de moins par mois. Fast, lui, n'existait pas du tout avant.
La ligne que j'entourerais est celle des dimensions par défaut. Le prix par token est le même, mais chaque vecteur sort un tiers plus gros par défaut. Si vous changez de modèle en gardant les réglages par défaut, votre facture d'embeddings reste stable et celle de votre base vectorielle augmente. J'y viens plus bas, car la correction est simple et fait vraiment économiser de l'argent.
Ce qui compte comme token facturable
La documentation de facturation de Cohere indique qu'embed est facturé selon le nombre de tokens vectorisés, et les tokens que Cohere ajoute en coulisses ne sont pas facturés. Vous ne payez que l'entrée. Il n'y a aucun frais de tokens de sortie, puisqu'un appel d'embedding renvoie une liste de nombres et non du texte.
Quelques détails méritent d'être connus, car ils façonnent la facture réelle :
- Le batching ne change pas le prix. Chaque appel embed accepte jusqu'à 96 textes ou entrées, ce qui aide le débit, mais le coût par token reste le même.
- Les images sont facturées au token, mais la conversion n'est pas publiée. La documentation explique le redimensionnement (les images de plus de 2 458 624 pixels sont réduites) sans donner de formule de tokens par image. Il vaut donc la peine de lancer d'abord un petit échantillon avant de fixer un budget pour une grosse archive de PDF.
- Aucune remise par lots n'est indiquée. L'article de lancement dit que l'embedding par lots est disponible, mais le guide Embed Jobs dit toujours qu'il ne fonctionne qu'avec les modèles v3.0. Ne comptez pas sur un tarif par lots à 50 % comme celui de Google.
- Les clés d'essai sont étroites. L'embedding de texte tourne à 2 000 entrées par minute en essai comme en production, mais l'embedding d'images est de 5 entrées par minute en essai contre 400 en production.
Tout le reste est de l'arithmétique simple : tokens d'entrée fois le tarif. C'est le même modèle de facturation que l'API OpenAI et la plupart des autres services d'embeddings hébergés.
L'astuce : indexer avec Pro, interroger avec Fast
Pour moi, c'est la chose la plus utile de tout le lancement, et c'est en fait une fonction de prix déguisée en fonction technique. Pro et Fast partagent un même espace d'embeddings, donc une requête vectorisée par Fast peut interroger un index construit par Pro, sans rien reconstruire.
"For many customers, we recommend the following deployment pattern: index with Pro, query with Fast."
Cohere a testé chaque association sur 40 jeux de données de développement. Avec une configuration entièrement Pro notée 100, un index Pro interrogé par Fast obtient 98,4, un index Fast interrogé par Pro 97,3, et tout Fast 96,6. Un piège se cache dans les notes de bas de page : les deux côtés doivent utiliser la même dimension de sortie.
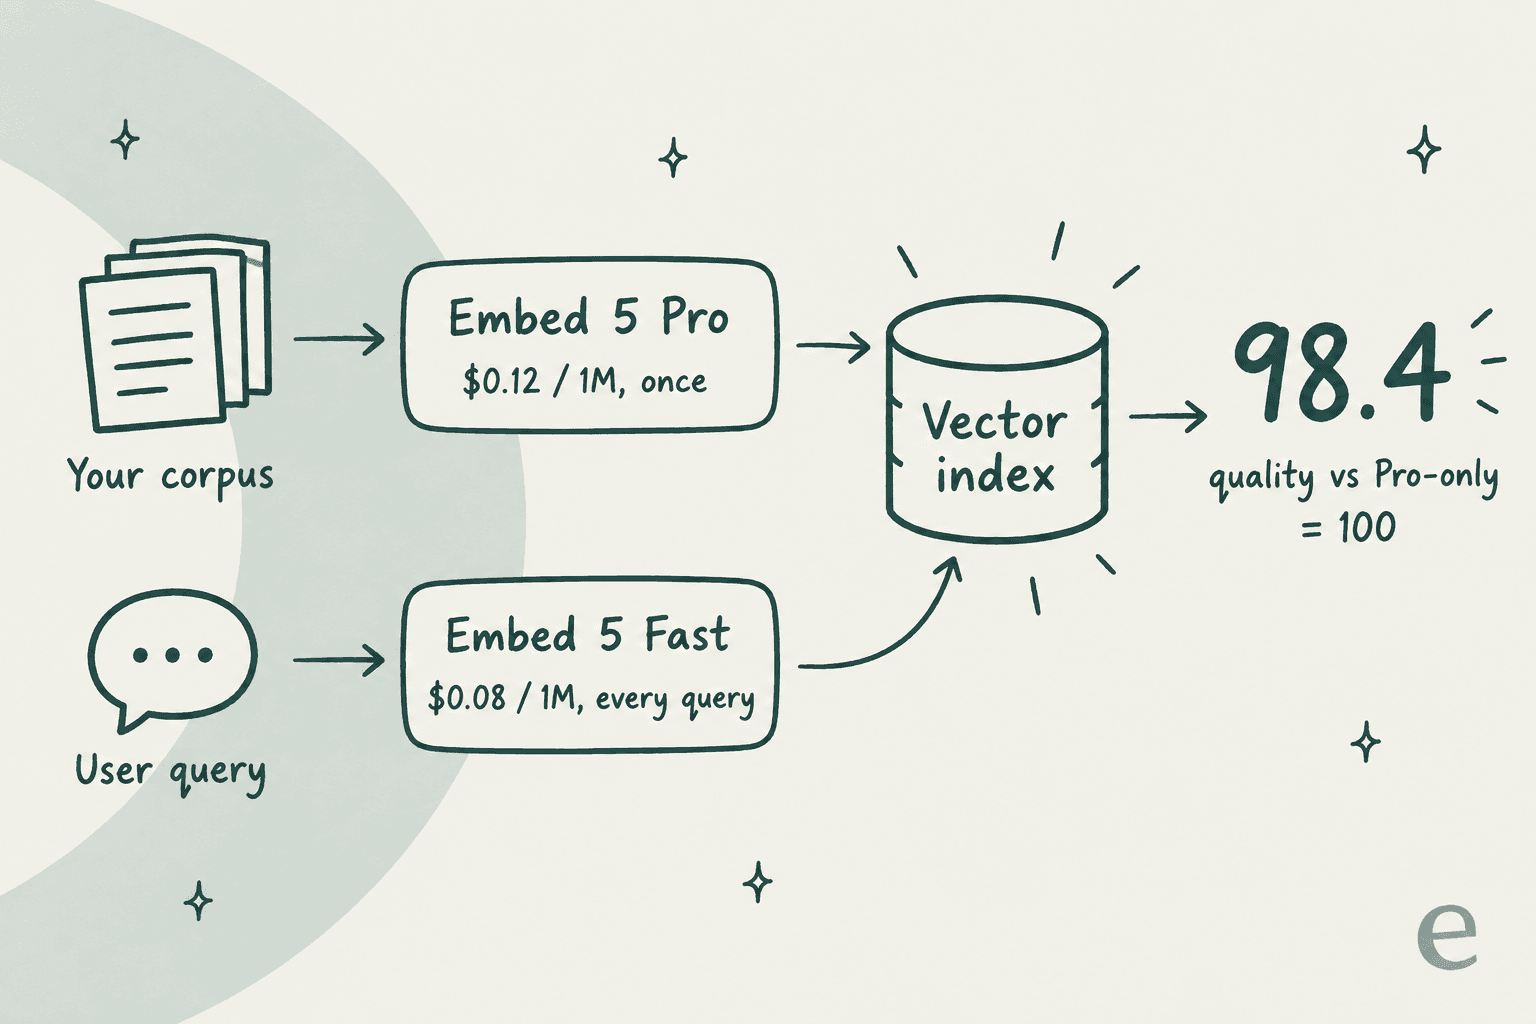
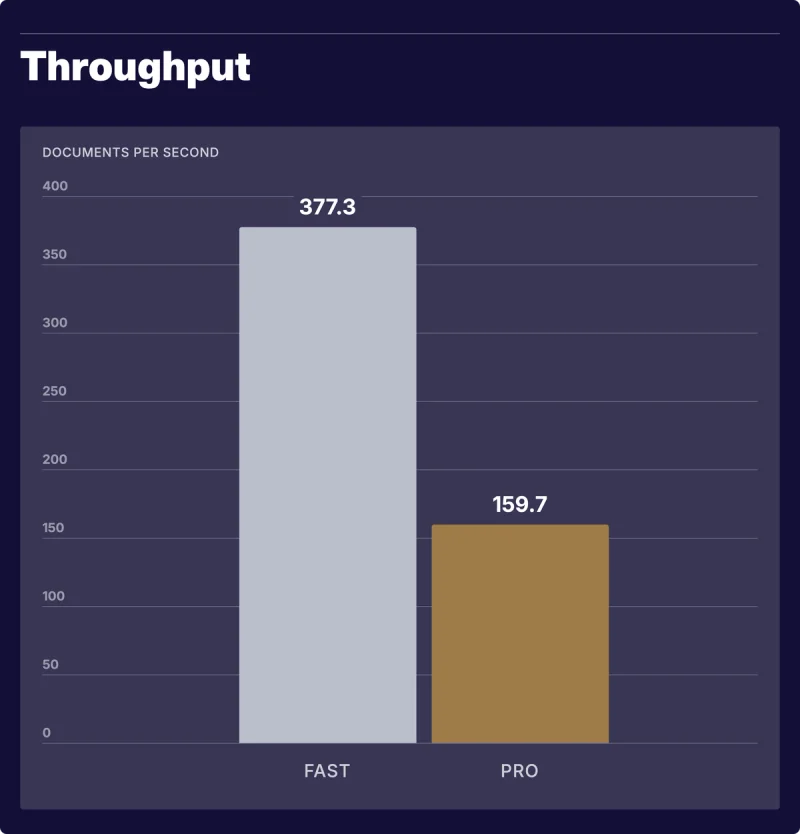
Pourquoi cela compte-t-il pour le coût ? Parce que dans la plupart des systèmes de recherche et de RAG (voici un pipeline RAG de support si vous voulez voir la forme complète), l'indexation se fait une fois (plus les mises à jour), alors que les requêtes se font indéfiniment. Vous payez ainsi le tarif Pro sur la partie rare, et le tarif Fast sur celle que vous faites à chaque seconde. Fast a aussi traité 377,3 documents par seconde contre 159,7 pour Pro dans le test de débit de Cohere, donc les requêtes sont plus rapides en plus d'être moins chères.
Je nuancerais un peu la lecture habituelle, car pour la plupart des équipes le côté requêtes est minuscule. Un bot de support qui traite 30 000 questions par mois, à environ 100 tokens chacune, envoie 3 millions de tokens de requête : 0,36 $ sur Pro ou 0,24 $ sur Fast. Le titre « Fast fait économiser » est réel à l'échelle des boucles d'agents, où un modèle lance des dizaines de recherches par tâche. Pour un centre d'aide normal, choisissez Fast pour la latence, puis ne vous souciez plus de son coût.
Le coût que la page de tarifs ne montre pas : le stockage vectoriel
Chaque vecteur que vous créez doit vivre quelque part, généralement dans une base de données vectorielle, et ce quelque part vous facture chaque mois. Dans un budget d'embeddings, c'est la partie que je vois le plus sous-estimée, car l'API d'embeddings est un coût unique par document alors que la base de données est un loyer.
Embed 5 vous laisse choisir la taille de sortie (256, 512, 768, 1024, 1536 ou 2048 dimensions) et le format (float, int8, binary et quelques variantes). L'exemple de Cohere : 100 millions de chunks avec les 2048 dimensions float par défaut occupent 819 Go, tandis que 256 dimensions binary occupent 3,2 Go, soit 256 fois moins.
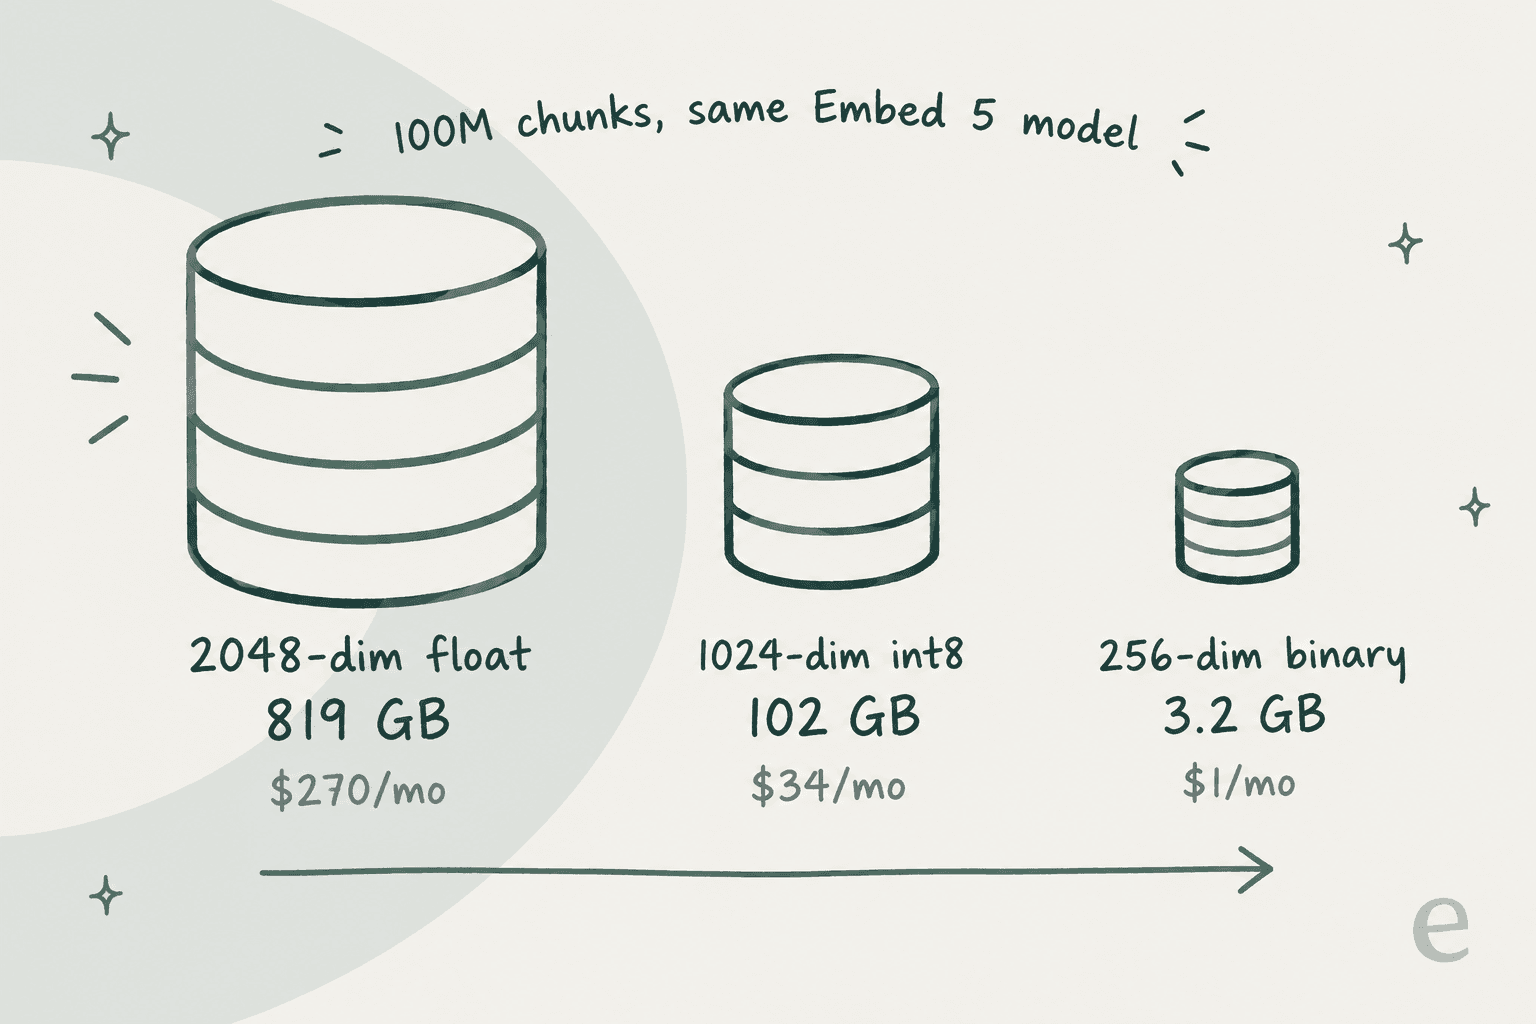
J'ai chiffré ces trois tailles sur le plan serverless de Pinecone à 0,33 $ par Go et par mois (octets de vecteurs bruts uniquement, avant surcoût d'index et métadonnées). L'écart est alors de 270 $ par mois contre 34 $ contre environ 1 $. Sur deux ans, le réglage float par défaut coûte environ 6 500 $ rien qu'en stockage, plus que les 6 000 $ que coûte la vectorisation de 50 milliards de tokens avec Pro au départ.
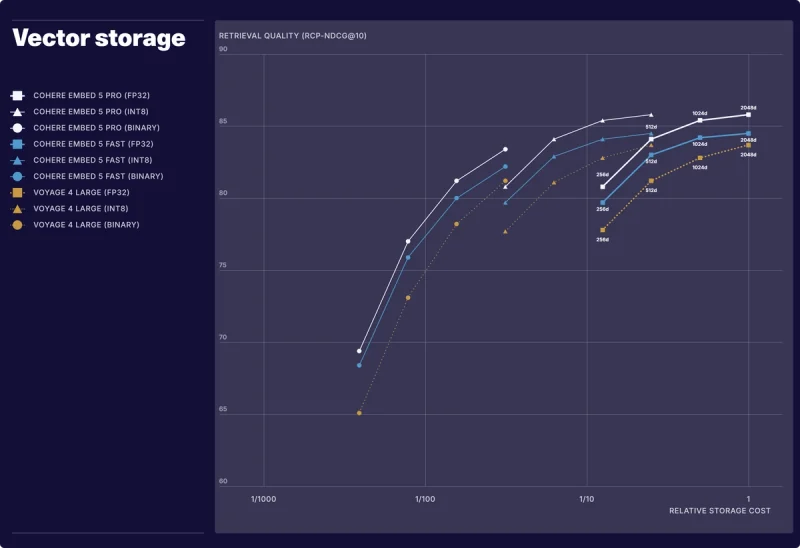
Ce que vous perdez en qualité en réduisant est plus faible qu'on ne le pense. Le graphique de Cohere trace la qualité de recherche face au coût de stockage relatif, et les courbes int8 se superposent presque aux courbes float. La recommandation de Cohere elle-même est int8 en 1024 dimensions, et c'est aussi le réglage par lequel je commencerais.
D'autres bases de données tarifent différemment, et la forme de la facture change avec elles. Weaviate Cloud facture par million de dimensions vectorielles stockées (dès 0,00465 $ sur Flex), donc 2048 dimensions coûtent littéralement le double de 1024. Pinecone facture aussi de 16 $ à 18 $ par million d'unités de lecture sur Standard, avec un minimum mensuel de 50 $, et pour de petits index cela pèse plus que le stockage. J'ai comparé les options de bases de données plus en détail dans mon analyse des tarifs Weaviate et le tour d'horizon des alternatives à Weaviate.
Si vous préférez ne pas gérer de base du tout, l'option hébergée d'OpenAI est traitée dans mon guide des vector stores, même si elle vous lie aux modèles d'embeddings d'OpenAI.
Estimez votre facture Embed 5
Saisissez ici votre propre corpus et votre propre trafic. Le calculateur utilise les tarifs publiés de l'API et le tarif de stockage de Pinecone de 0,33 $/Go, la ligne de stockage est donc à considérer comme un plancher.
Essayez de passer de int8 en 1024 dimensions à float en 2048 dimensions, les valeurs par défaut d'Embed 5. Sur un million de chunks, la facture d'indexation ne bouge pas du tout, tandis que la ligne de stockage est multipliée par 8.
API vs Model Vault vs places de marché cloud
Model Vault remplace le compteur au token par un loyer fixe pour une instance dédiée mono-locataire. Le calcul du seuil de rentabilité est assez simple :
| Instance | Mensuel | Rentable sur Pro | Rentable sur Fast |
|---|---|---|---|
| Small | 2 000 $ | ~16,7 Md de tokens/mois | ~25 Md de tokens/mois |
| Medium | 3 250 $ | ~27,1 Md de tokens/mois | ~40,6 Md de tokens/mois |
Seize milliards de tokens par mois, c'est environ 550 millions par jour. Très peu d'équipes vectorisent autant, donc pour presque tout le monde l'API reste l'option la moins chère. Cohere ne publie pas non plus combien de tokens une instance Small peut traiter par mois : vérifiez le débit avec l'équipe commerciale avant de supposer qu'une instance couvrira votre pic.
Des gens achètent quand même Model Vault, et la raison tient plus au contrôle qu'au prix. Il n'y a pas de multi-location partagée et le débit est garanti, ce qui donne aussi un meilleur argumentaire pour les revues de sécurité. Cela colle avec tout le discours de Cohere sur le déploiement en entreprise. Si vous avez besoin que tout reste dans votre propre réseau, les deux modèles peuvent être auto-hébergés sur vLLM via un déploiement privé, au prix fixé par l'équipe commerciale.
Les places de marché sont alors une troisième voie. Sur Amazon SageMaker, Embed 5 est facturé comme des frais logiciels horaires par hôte (2,39 $ sur une ml.g5.xlarge, jusqu'à 8,48 $ sur la plus grande instance Pro) plus l'instance SageMaker elle-même. Microsoft Foundry liste les deux modèles en préversion, sans prix pour l'instant. Amazon Bedrock et Oracle OCI n'ont encore qu'Embed 4 au 1er octobre, à 0,12 $ par million de tokens sur Bedrock. Si votre entreprise a des dépenses cloud engagées, la voie de la place de marché peut rester pertinente même quand le tarif brut est moins bon.
Exemples concrets : ce que paie une vraie équipe
Voici trois scénarios, avec les tarifs publiés et un stockage int8 en 1024 dimensions sauf mention contraire.
Le centre d'aide et l'historique de tickets d'une équipe support. 2 000 articles d'aide d'environ 800 tokens et 50 000 anciens tickets d'environ 400 tokens font 21,6 millions de tokens. Indexer avec Pro coûte 2,59 $, une seule fois. Les requêtes, à 30 000 par mois sur Fast, coûtent 0,24 $ par mois. Les vecteurs tiennent dans l'offre gratuite de 2 Go de Pinecone. La facture d'embeddings est ici une erreur d'arrondi. Le vrai coût se trouve dans l'ingénierie du découpage et de la synchronisation, plus les permissions et la couche LLM par-dessus, le même arbitrage que je détaille dans la recherche sémantique sur Zendesk Guide.
Une archive de documents pour un outil de recherche interne. 20 millions de chunks de 500 tokens font 10 milliards de tokens. L'indexation Pro coûte 1 200 $ ; Fast serait à 800 $. Le stockage en float 2048 dimensions est d'environ 164 Go, soit 54 $ par mois sur Pinecone. En int8 1024, environ 20 Go, soit 6,76 $ par mois. À la sortie du prochain modèle, une réindexation recoûte les 1 200 $ complets, et si les PDF doivent d'abord être analysés, Parse 5 ajoute sa propre facture à la page.
Un agent à fort volume qui cherche à chaque étape. 500 millions de tokens de requête par jour font 15 milliards par mois. Sur Fast, 1 200 $ par mois ; sur Pro, 1 800 $. Aucun des deux ne franchit la ligne des 2 000 $ de Model Vault, donc l'API l'emporte, sauf si vous avez besoin de capacité dédiée.
La leçon des trois : l'API d'embeddings n'est presque jamais la partie coûteuse. Le stockage et la réindexation le sont, tout comme les personnes qui maintiennent le pipeline.
Comment se positionnent les tarifs d'Embed 5
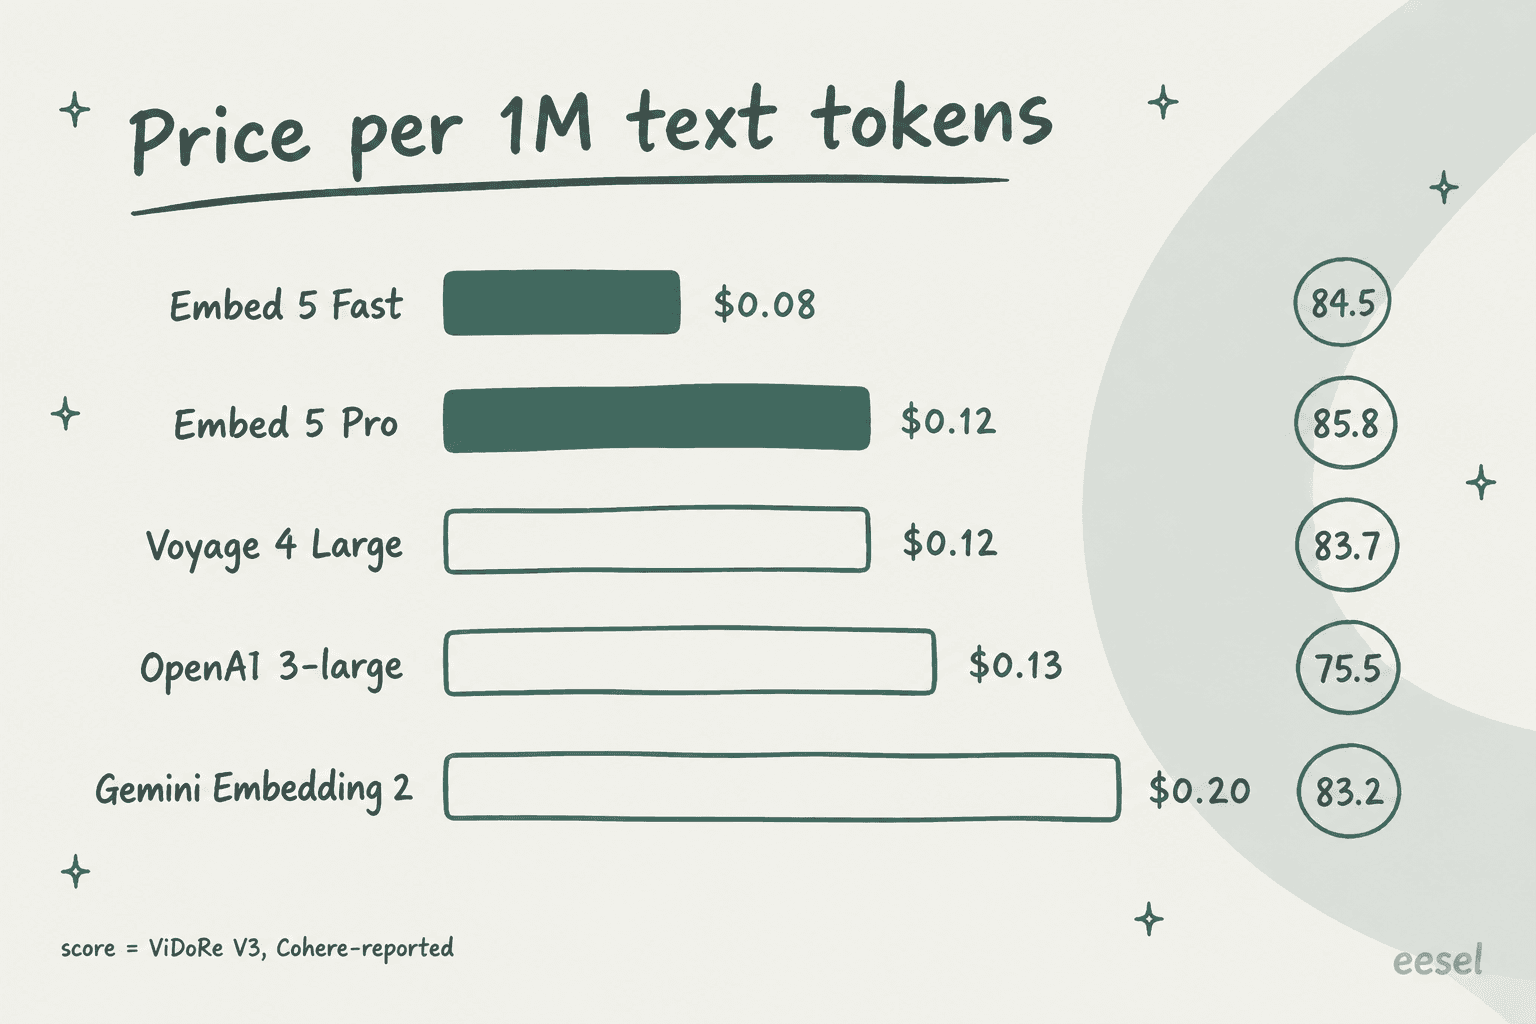
J'ai aligné Embed 5 face aux autres modèles d'embeddings phares, chaque prix tiré de la page de tarifs de l'éditeur. Les scores sont les chiffres ViDoRe V3 de Cohere issus de son article de lancement : lisez-les comme le test de Cohere elle-même et non comme un test indépendant.
| Modèle | Texte / million de tokens | Lots | Offre gratuite | ViDoRe V3 (Cohere) |
|---|---|---|---|---|
| Cohere Embed 5 Pro | 0,12 $ | Non indiqué | Essai de 1 000 appels/mois | 85,8 |
| Cohere Embed 5 Fast | 0,08 $ | Non indiqué | Essai de 1 000 appels/mois | 84,5 |
| Voyage 4 Large | 0,12 $ | 33 % de remise | 200 M de tokens | 83,7 |
| Gemini Embedding 2 | 0,20 $ | 0,10 $ | Oui | 83,2 |
| OpenAI text-embedding-3-large | 0,13 $ | n/a | Aucune | 75,5 |
| OpenAI text-embedding-3-small | 0,02 $ | n/a | Aucune | n/a |
| Jina Embeddings v5 | 0,045 $ à 0,05 $ | n/a | 10 M de tokens, non commercial | 74,5 (v5 Small) |
| Mistral embed | 0,10 $ | n/a | n/a | n/a |
Embed 5 Fast est le modèle le moins cher du groupe le mieux noté, et Pro égale Voyage 4 Large sur le prix tout en le devançant légèrement sur le test de Cohere. Gemini Embedding 2 coûte 2,5 fois ce que coûte Fast au plein tarif, même si son prix par lots de 0,10 $ réduit beaucoup l'écart pour l'indexation hors ligne (tarifs complets dans mon guide des tarifs Gemini). L'API d'embeddings d'OpenAI coûte un cent de plus que Pro pour un score bien plus bas sur ce benchmark.
Deux réserves honnêtes s'imposent. Si le prix pur par token est votre seul objectif, 3-small d'OpenAI et Voyage 4 Lite sont tous deux à 0,02 $, un quart de Fast. Et le tableau multilingue de Cohere elle-même montre Gemini Embedding 2 devant Pro sur 9 des 10 langues asiatiques et moyen-orientales testées, le télougou affichant le plus grand écart (91 contre 80). Si votre corpus est surtout en hindi, japonais ou arabe, testez Gemini avant de vous engager. Le modèle embed de Mistral à 0,10 $ est une autre option pour des données européennes ; voir mes notes sur les tarifs de Mistral AI. Pour une liste plus large, mon article sur les alternatives à Cohere AI compare les fournisseurs au-delà des embeddings.
Ce que disent les développeurs
Embed 5 a un jour au moment où j'écris, donc il n'existe pas encore de vrais avis d'utilisateurs. Ce qui existe, c'est un historique régulier pour les embeddings de Cohere en général, et le thème qui revient est la fiabilité :
"It has the most crisp, steady P50 of any external service I've used in a long time."

Les critiques portent plutôt sur le coût à grand volume et sur la dépendance à une API fermée, ce qui est vrai de tout modèle d'embeddings hébergé :
"The API can also become expensive when you start using it more frequently."

"Voyage for embeddings + rerank is totally defensible - Cohere is popular partly because it's been the default in a lot of examples, not because it's always better."

Je trouve cette dernière remarque juste, et les chiffres d'Embed 5 confirment les deux côtés : Pro gagne le benchmark de Cohere elle-même, mais de 2,1 points sur Voyage 4 Large au même prix. Si vous faites déjà bien tourner Voyage, rien ne presse pour migrer. Si vous êtes sur Embed 4, passer à Embed 5 ne coûte rien de plus par token et c'est presque un gain pur. L'intégration Cohere de LangChain réduit le changement à une modification d'une ligne du modèle, même s'il faudra quand même revectoriser le corpus.
Quelle option tarifaire d'Embed 5 vous convient
Voici mes recommandations, selon la situation :
- Vous prototypez. Utilisez la clé d'essai, puis une clé de production à l'usage. Ne pensez pas encore à Model Vault.
- Vous construisez une recherche ou un RAG sur un corpus fixe. Indexez avec Pro, interrogez avec Fast, stockez en int8 1024 dimensions. C'est la configuration de haute qualité la moins chère que propose Cohere.
- Vous faites tourner des agents qui cherchent en permanence. Fast des deux côtés si vous avez besoin du débit 2,4 fois supérieur ; index Pro plus requêtes Fast si la qualité prime.
- Vous vectorisez des dizaines de milliards de tokens par mois ou avez besoin d'isolation. Chiffrez Model Vault et demandez à l'équipe commerciale le débit par instance avant de signer. Sur AWS, comparez avec SageMaker et les tarifs des agents Bedrock que vous payez peut-être déjà.
- Vous vectorisez surtout du contenu en langues asiatiques. Comparez d'abord Gemini Embedding 2 à Pro sur vos propres données.
- Vous voulez juste un bot de support qui répond à partir de vos documents. Sautez complètement la décision sur les embeddings et regardez une base de connaissances IA ou un coéquipier helpdesk qui gère la recherche pour vous.
Essayez eesel quand l'objectif, ce sont des réponses de support
La plupart de ceux qui chiffrent des modèles d'embeddings ne construisent pas un moteur de recherche pour lui-même. Ils hésitent souvent entre RAG et fine-tuning pour un centre d'aide. Ce qu'ils veulent au final, c'est un bot qui répond aux clients à partir d'un centre d'aide et d'anciens tickets. C'est là que je m'arrêterais pour demander si vous avez vraiment besoin de posséder la pile.
Chez eesel, j'ai vu des équipes faire ce choix dans les deux sens. Une entreprise néerlandaise d'hébergement web sur Zendesk, qui dépensait environ 1 700 $ par mois, a quitté eesel pour construire sa propre IA en interne. Le constat de l'équipe par la suite n'avait rien à voir avec le coût des modèles :
"A lot of their friction came from setup complexity (handovers, Zendesk integration, business hours logic) and a lack of clear guidance on how to configure things correctly."
C'est la partie que les pages de tarifs d'embeddings ne montrent jamais. Les vecteurs ne coûtent presque rien. Ce sont les transferts et les intégrations, plus les règles autour, qui constituent le vrai travail.

eesel est un coéquipier helpdesk IA qui rejoint votre file existante dans Zendesk, Freshdesk et d'autres helpdesks, apprend de votre base de connaissances et de vos anciens tickets, et vous laisse rejouer de vrais tickets à travers lui avant qu'il ne parle à un client. Il n'y a aucun modèle d'embeddings à choisir ni nombre de dimensions à régler, et vous n'avez pas non plus de facture de base vectorielle.
La tarification repose sur des plans de crédits fixes à partir de 299 $ pour 500 crédits par mois, un ticket ou un chat traité valant un crédit.
Si vous êtes développeur, choisir cette voie ne signifie pas perdre le contrôle, ce que je détaille davantage dans mon guide de l'API d'agent de support client. La CLI eesel permet de connecter des intégrations, de modifier les instructions du coéquipier, d'approuver ou de refuser les actions en attente et de lire son journal d'activité depuis un terminal, avec une sortie JSON et un indicateur --dry-run pour les scripts. Des agents de code comme Claude Code peuvent aussi la piloter via MCP.
J'ai écrit davantage sur ce flux de travail dans gérer des agents depuis le terminal et le guide de la CLI pour le support.
Essayez eesel gratuitement et voyez à quoi ressemble votre centre d'aide en coéquipier de support opérationnel, sans écrire un seul appel d'embedding.
Questions fréquentes
Combien coûte Cohere Embed 5 ?
Quelle est la différence de prix entre Embed 5 Pro et Embed 5 Fast ?
Cohere Embed 5 est-il plus cher qu'Embed 4 ?
Existe-t-il une offre gratuite pour Cohere Embed 5 ?
Quand Cohere Model Vault devient-il moins cher que l'API Embed 5 ?
Ai-je besoin de Cohere Embed 5 pour créer un agent de support IA ?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.






Comment les tarifs de Cohere Embed 5 se comparent-ils aux embeddings d'OpenAI ?