Ce qu'est vraiment Cohere Embed 5
Cohere est l'entreprise d'IA pour grandes organisations derrière les modèles Command, Rerank et l'analyseur de documents Parse 5. Un modèle d'embeddings est la partie discrète de tout système de recherche ou de RAG : la pièce qui transforme un fragment de texte (ou une image) en liste de nombres, et les fragments au sens proche se retrouvent alors proches les uns des autres. Quand un utilisateur pose une question, celle-ci est aussi transformée en nombres, puis le système va chercher les fragments les plus proches.
Quand le modèle d'embeddings est faible, la bonne réponse n'est tout simplement jamais retrouvée, et un prompt astucieux n'y changera rien. C'est la même couche qui alimente la recherche d'entreprise par IA.
Embed 5 succède à Embed 4 comme modèle phare de Cohere et existe en deux niveaux : Pro, "optimized for maximum quality across multimodal, multilingual, financial, code, and parsed-document retrieval", et Fast, qui "brings highly competitive performance to latency- and cost-sensitive workloads".
Je construis des agents IA chez eesel, et la recherche est la couche où passe l'essentiel de mon temps de débogage ; ces spécifications sont donc les premières que j'ai cherchées. Les voici côte à côte, tirées de la documentation du modèle de Cohere et de son article de lancement :
| Embed 5 Pro | Embed 5 Fast | Embed 4 (précédent) | |
|---|---|---|---|
| ID du modèle dans l'API | embed-v5.0-pro | embed-v5.0-fast | embed-v4.0 |
| Prix du texte (par million de tokens) | 0,12 $ | 0,08 $ | 0,12 $ |
| Prix de l'image (par million de tokens) | 0,40 $ | 0,40 $ | 0,47 $ |
| Longueur de contexte | 128K tokens | 128K tokens | 128K tokens |
| Entrées | Texte, images, texte + image fusionnés | Texte, images, texte + image fusionnés | Texte, images, mixte |
| Dimensions de sortie | 256 à 2048 (2048 par défaut) | 256 à 2048 (2048 par défaut) | 256 à 1536 (1536 par défaut) |
| Formats | float, int8, binary | float, int8, binary | float, int8, binary |
| Langues | 100+ | 100+ | Multilingue |
| Idéal pour | Indexation hors ligne, recherche où la qualité est critique | Requêtes en direct, boucles d'agents, gros volumes |
Les tarifs d'Embed 4 viennent des tarifs Cohere de Microsoft Foundry, car la page de tarifs de Cohere ne liste plus Embed 4. Si vous venez de la série 3 d'OpenAI, notez que ses tarifs d'API plafonnent toujours à 0,13 $ pour text-embedding-3-large. Dans le tableau Cohere, deux petits détails échappent souvent. La sortie par défaut est passée de 1536 à 2048 dimensions, ce qui compte pour le stockage (plus bas), et l'entrée d'images est aussi devenue moins chère, de 0,47 $ à 0,40 $ par million de tokens.
Comment fonctionne Embed 5 : indexer avec Pro, interroger avec Fast
C'est la fonctionnalité autour de laquelle je construirais, et celle qui fait le moins de bruit. La plupart des familles d'embeddings, y compris l'API d'embeddings d'OpenAI, vous font choisir un modèle et vivre avec, car les vecteurs de deux modèles différents ne sont pas comparables. Cohere a entraîné Pro et Fast dans un espace unique partagé, si bien qu'une requête encodée avec Fast peut être comparée directement à des documents encodés avec Pro.
Cela compte parce que l'indexation et l'interrogation demandent des choses opposées. L'indexation se fait une fois (ou à chaque mise à jour d'un document) et personne n'attend dessus, donc on veut ici la meilleure qualité possible. L'interrogation est une autre histoire : elle se produit à chaque requête utilisateur et dans votre budget de latence, donc c'est la vitesse qui compte. Un espace partagé vous laisse choisir chaque côté séparément.
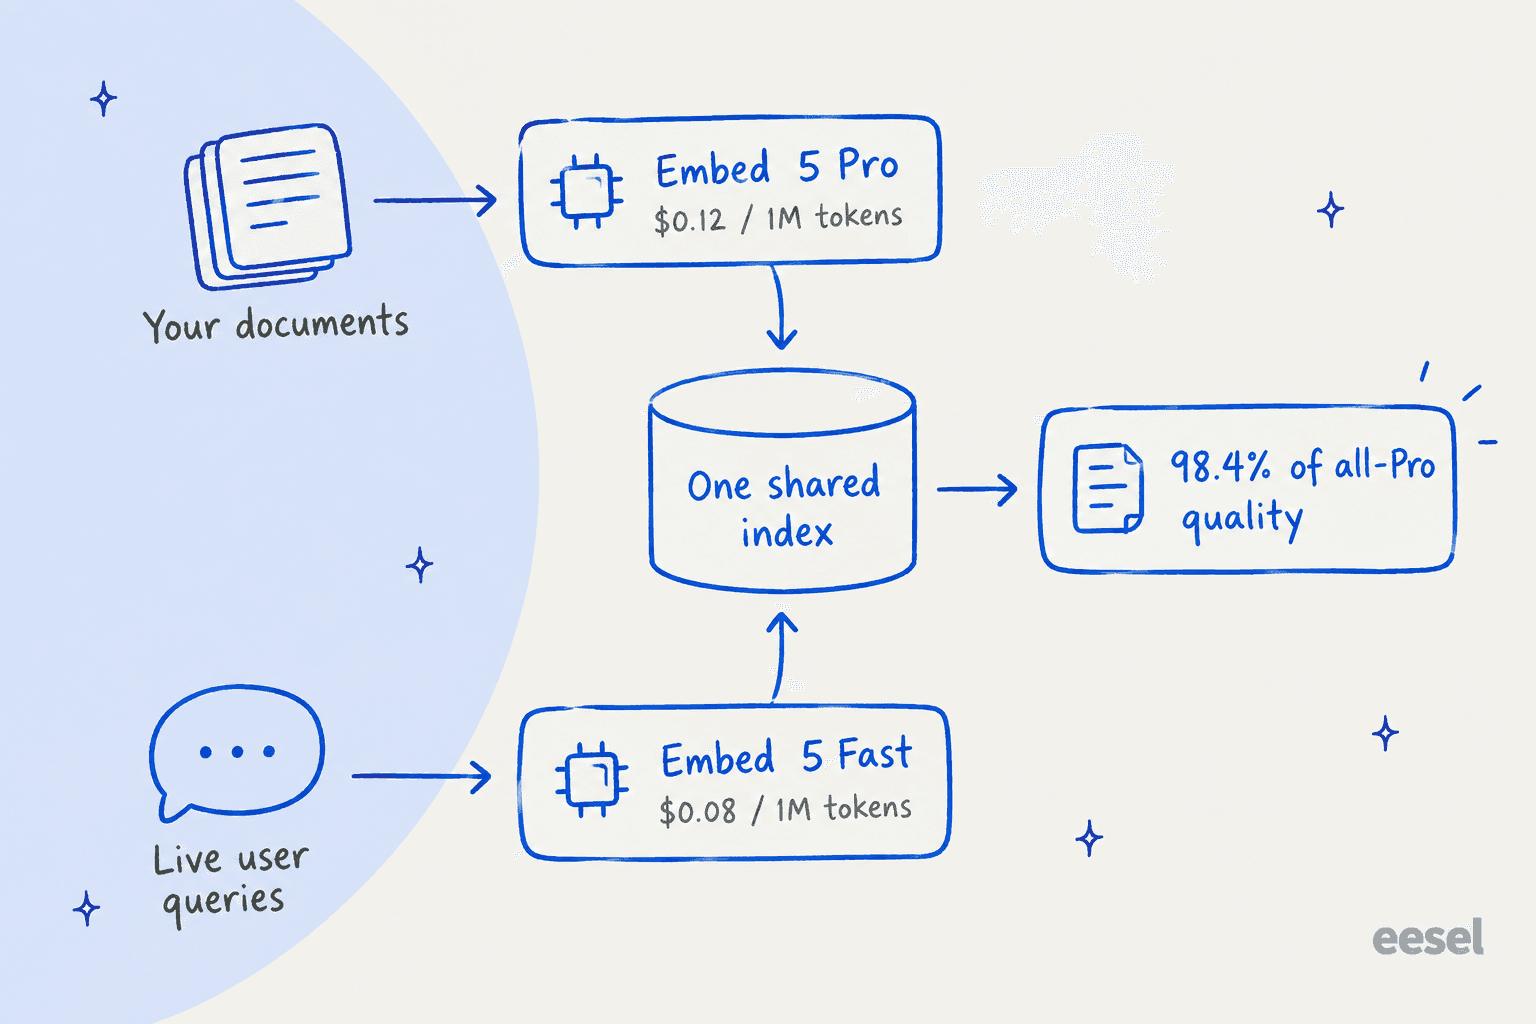
Cohere a testé chaque combinaison sur 40 jeux de données de développement, puis normalisé les scores de sorte que documents Pro plus requêtes Pro égale 100 :
| Qualité moyenne de recherche | Documents indexés avec Fast | Documents indexés avec Pro |
|---|---|---|
| Requêtes avec Fast | 96.6 | 98.4 |
| Requêtes avec Pro | 97.3 | 100 |
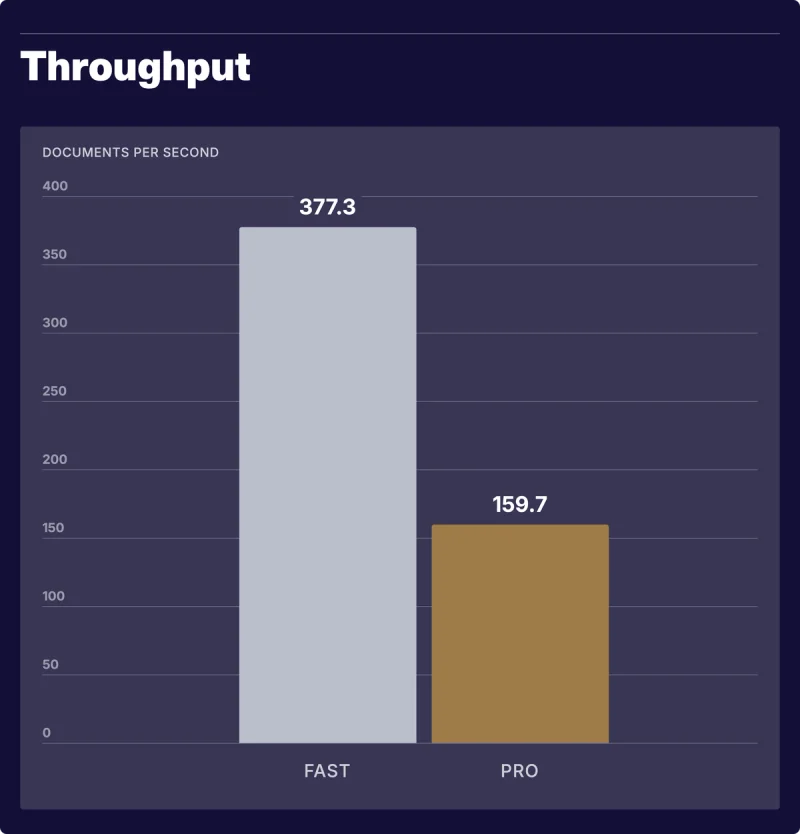
Donc index Pro plus requêtes Fast atteint 98,4, soit 1,6 % de perte, tandis que Fast fait le travail au moment de la requête avec environ 2,4 fois le débit de Pro (377,3 contre 159,7 documents par seconde dans le test de Cohere). Cohere recommande lui-même ce schéma, et la note de bas de page contient le piège à connaître : les deux côtés doivent utiliser la même dimension de sortie. L'appariement tient aussi quand on ajoute la troncature Matryoshka et la quantification int8, un index compressé fonctionne donc également.
Quelques détails d'API tirés de la référence Embed qui conditionnent la façon de l'appeler :
input_typeest obligatoire. Utilisezsearch_documentà l'indexation etsearch_queryà l'interrogation. Il existe aussi des modesclassificationetclustering.- 96 entrées par appel. Chaque entrée peut mélanger des parties texte et image, avec un plafond de 20 Mo de charge totale.
- La troncature est par défaut sur
END. Avec 128K de contexte, on l'atteint rarement, mais si vous préférez une erreur plutôt que de perdre silencieusement la fin d'un long document, metteztruncatesurNONE. - Les limites de débit sont par entrée, pas par requête : 2 000 entrées de texte par minute pour les clés d'essai comme de production, et 5 contre 400 entrées d'image par minute, selon la page des limites de débit. Les clés d'essai sont gratuites mais limitées à 1 000 appels par mois et interdites en production.
Les benchmarks : solides, mais lisez les petites lignes
Les chiffres publiés par Cohere sont bons. Voici le tableau principal de ViDoRe V3, qui couvre des documents d'entreprise sur huit domaines :
| Modèle | Moyenne ViDoRe V3 | Prix du texte par million de tokens |
|---|---|---|
| Cohere Embed 5 Pro | 85.8 | 0,12 $ |
| Cohere Embed 5 Fast | 84.5 | 0,08 $ |
| Voyage 4 Large | 83.7 | 0,12 $ |
| Gemini Embedding 2 | 83.2 | 0,20 $ |
| Cohere Embed 4 | 77.0 | 0,12 $ |
| OpenAI text-embedding-3-large | 75.5 | 0,13 $ |
| Jina Embeddings v5 Text Small | 74.5 | 0,05 $ |
Sur le même test, Pro gagne 8,8 points sur Embed 4, avec les plus gros bonds sur les RH (+11,4) et les documents industriels (+10,3). Il mène aussi la suite de PDF analysés de Cohere avec 84,8. En recherche financière, il se classe premier sur FinanceBench (80,1) et FinQA (90,0), ainsi que sur ViDoRe V3 Finance (85,0), avec Fast deuxième à chaque fois.
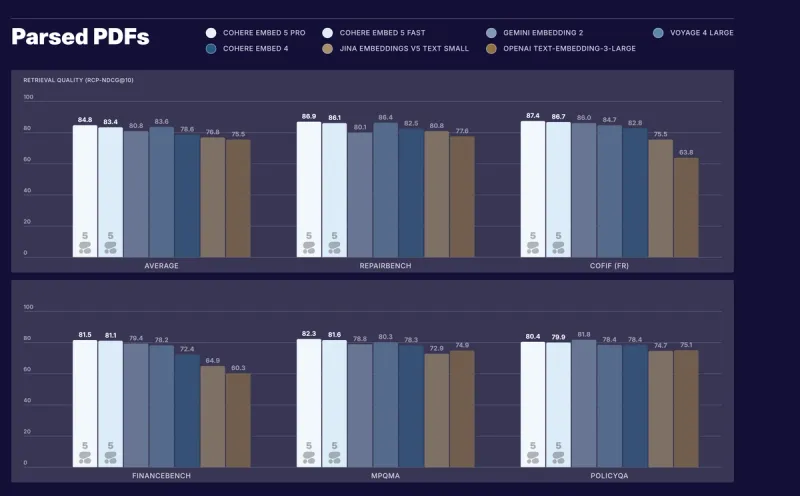
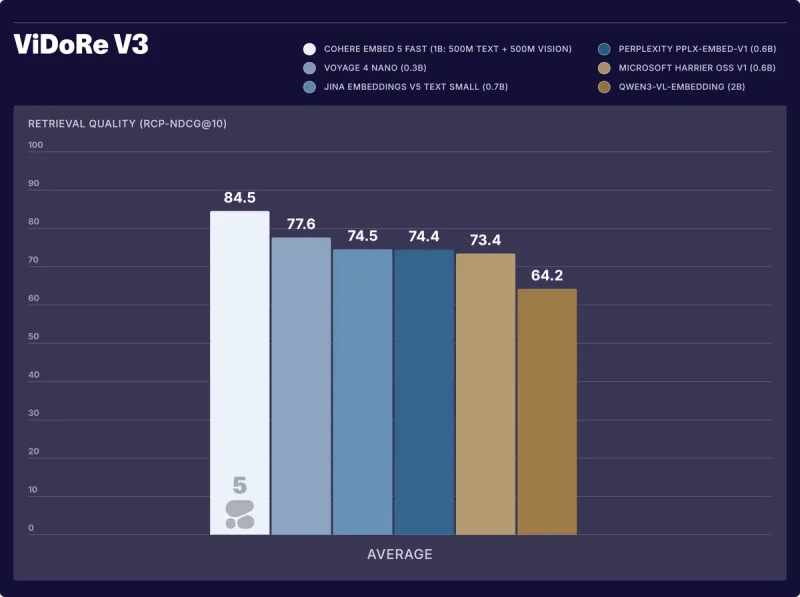
Pour moi, le résultat le plus impressionnant est en fait celui de Fast. Face à d'autres modèles compacts sur ViDoRe V3, il obtient 84,5, là où Voyage 4 Nano plafonne à 77,6 et Qwen3-VL-Embedding à 64,2. La légende du graphique de Cohere (ci-dessous) indique Fast à environ 1B de paramètres, 500M de texte plus 500M de vision, et l'article de lancement dit qu'il bat Qwen3-VL-Embedding-2B d'environ 20 points tout en étant environ deux fois plus petit.
Maintenant les petites lignes, car une lecture honnête en a besoin.
C'est une nouvelle métrique, exécutée par le fournisseur. Embed 5 est la première famille de modèles notée avec RCP-nDCG@10, une méthode que Cohere a publiée le même jour. La note de bas de page de Cohere précise qu'elle évalue les modèles en réordonnant un ensemble fixe de candidats, donc "scores therefore reflect reranking quality rather than first-stage retrieval performance." C'est une façon raisonnable de mesurer, et le code est public, mais ce n'est pas le même chiffre que vous obtiendriez avec une simple recherche top-10 sur tout votre index. De plus, certains jeux de données sont internes, comme le jeu "High Finance" que Cohere a annoté elle-même.
Gemini Embedding 2 l'emporte sur la plupart des langues non européennes. Pro domine l'ensemble européen (moyenne de 77 sur allemand, français, espagnol, italien et russe). Mais dans le tableau de dix langues de Cohere, Gemini Embedding 2 bat Pro sur 9 des 10 : japonais, coréen, arabe, persan, hindi, bengali, telugu, indonésien et thaï. Pro ne le devance que sur le chinois (82 contre 81). Le telugu montre le plus grand écart, 91 contre 80.
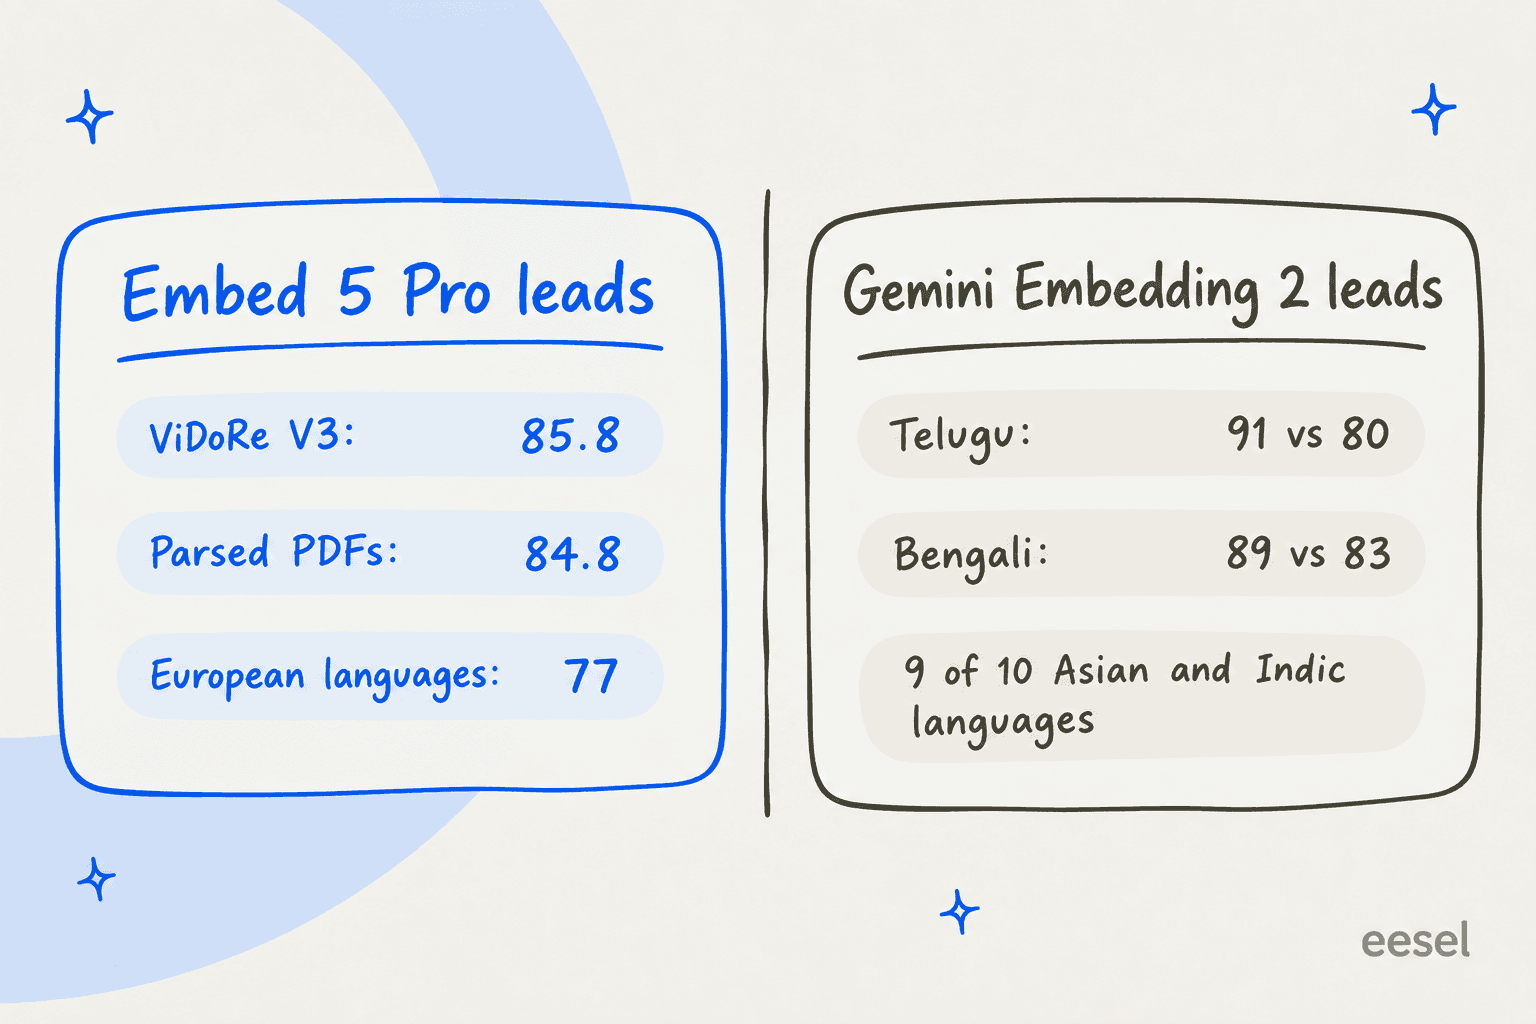
Si votre file de support ou votre base documentaire repose beaucoup sur le hindi, le thaï ou le bengali, ce tableau est ce qu'il y a de plus utile dans tout le lancement, et il faut saluer Cohere de l'avoir publié. Pour une équipe qui sert une base de connaissances multilingue en Europe et en anglais, Pro est le choix le plus solide d'après ces chiffres.
La réaction de la communauté est encore précoce et mince, ce qui est normal un jour après un lancement. La voix de praticien la plus utile que j'aie trouvée est plus ancienne et porte sur les embeddings de Cohere en général, pas sur Embed 5 :
"My experience with Cohere and interacting with their sales engineers has been boring, I say that is the most flattering way possible. Embeddings are a core service at this point like VMs and DBs. They just need to work and work well and thats what they're selling."

Cela correspond assez bien à l'offre. Embed 5 ne cherche pas à être excitant, il cherche à être la couche ennuyeuse et fiable qui se trouve sous votre recherche.
Tarifs de Cohere Embed 5
La facturation d'Embed 5 se fait par token d'entrée, sans frais de sortie. Voici tout ce que Cohere publie, depuis la page de tarifs et l'article de lancement :
| Option | Embed 5 Pro | Embed 5 Fast | Unité de facturation |
|---|---|---|---|
| API Cohere, texte | 0,12 $ par million de tokens | 0,08 $ par million de tokens | Tokens d'entrée |
| API Cohere, images | 0,40 $ par million de tokens | 0,40 $ par million de tokens | Tokens d'image |
| Clé d'essai | Gratuite, 1 000 appels par mois | Gratuite, 1 000 appels par mois | Pas pour la production |
| Model Vault Small | 3,00 $/heure ou 2 000 $/mois | 3,00 $/heure ou 2 000 $/mois | Par instance dédiée |
| Model Vault Medium | 5,00 $/heure ou 3 250 $/mois | 5,00 $/heure ou 3 250 $/mois | Par instance dédiée |
| Amazon SageMaker | 2,39 $ à 8,48 $ par heure d'hôte | 2,39 $ à 3,36 $ par heure d'hôte | Frais logiciels plus coût de l'instance AWS |
| Microsoft Foundry | Pas encore publié (préversion) | Pas encore publié (préversion) |
Les tarifs SageMaker viennent des fiches AWS Marketplace pour Embed 5 Pro, avec une fiche équivalente pour Fast. Cohere facture à la fin de chaque mois, ou plus tôt dès que 250 $ sont en attente. Pour le reste du catalogue (Rerank, Parse, Command), consultez mon guide complet des tarifs Cohere. Si vous analysez aussi des PDF, le détail des tarifs de Parse 5 couvre ce compteur.
Trois remarques de facturation que j'aurais voulu connaître avant de fixer un budget :
- Le nombre de tokens par image n'est pas documenté. Le prix est par million de tokens d'image, mais Cohere ne publie aucune formule de tokens par image. La réponse de l'API compte les images en nombre (
"images": 1), lancez donc un petit lot de test et lisez la facture avant d'encoder un million d'images de pages. - Model Vault ne devient rentable qu'à très gros volume. Une instance Small à 2 000 $ par mois équivaut à environ 16,7 milliards de tokens Pro, ou 25 milliards de tokens Fast, aux tarifs de l'API. En dessous, l'API revient moins cher. Si vous choisissez Vault, les vraies raisons sont l'isolation et la capacité garantie, pas le prix.
- Pas encore sur Bedrock. Amazon Bedrock liste toujours Embed 4 à 0,12 $ par million de tokens, sans référence Embed 5. OpenRouter ne propose aucun modèle d'embeddings Cohere.
Pourquoi le prix par token est le chiffre le moins important ici
Faisons le calcul pour une configuration de support réaliste, puisque c'est le monde dans lequel je travaille au quotidien. Supposons 2 000 articles de centre d'aide (environ 1 500 tokens chacun) et 200 000 anciens tickets (environ 600 tokens chacun), soit environ 123 millions de tokens au total. Tout encoder une fois avec Pro coûte environ 14,76 $. Avec Fast, environ 9,84 $. Cinquante mille questions de clients par mois à 30 tokens chacune font 1,5 million de tokens, environ 12 centimes avec Fast. Autrement dit, la facture d'embeddings est une erreur d'arrondi.
Ce qui ne s'arrondit pas, c'est le stockage, qui évolue avec les dimensions et la précision. L'exemple de Cohere : un vecteur float32 de 2048 dimensions pèse 8 Ko, un vecteur int8 de 1024 dimensions pèse 1 Ko et un vecteur binaire de 256 dimensions pèse 32 octets.
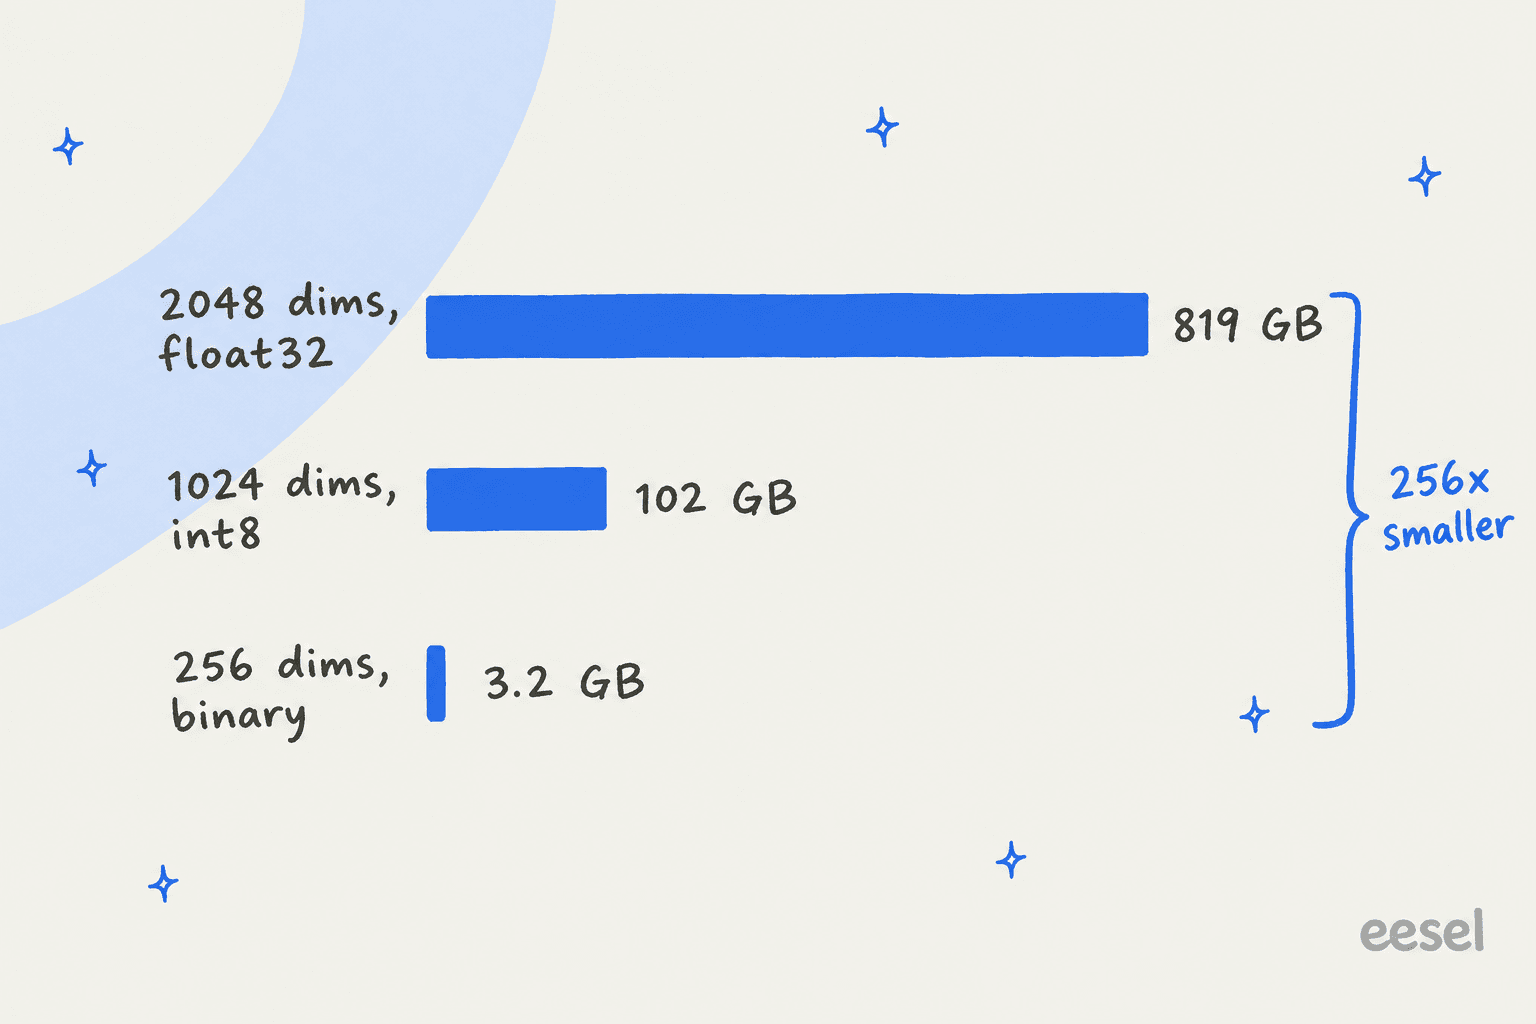
Pour 100 millions de fragments, la sortie float32 par défaut représente environ 819 Go de vecteurs bruts. Sur le forfait Standard de Pinecone (ou une base vectorielle hébergée) à 0,33 $ par Go et par mois, cela fait environ 270 $ par mois avant les frais d'index, chaque mois. Les mêmes fragments en int8 à 1024 dimensions font environ 102 Go, soit environ 34 $ par mois. Encoder ces 100 millions de fragments une fois (à environ 500 tokens chacun) coûte environ 6 000 $ avec Pro, une dépense unique. Choisissez vos dimensions et votre précision avant d'indexer, car les changer plus tard oblige à tout réencoder de zéro.
La recommandation de Cohere va dans ce sens : "For most deployments, we recommend 1,024-dimensional int8 vectors as the ideal performance-efficiency point," et l'int8 "retains near-full-precision retrieval quality." Le binaire est le plus petit, il perd un peu de précision et sert bien de première passe rapide avant un reranker.
Passer d'Embed 4 : ce qu'il faut prévoir
Si vous utilisez Embed 4 aujourd'hui, la migration est plus qu'un simple changement de nom de modèle. À prévoir :
- Tout réindexer. Cohere dit que Pro et Fast partagent un espace entre eux. Il ne dit rien sur la comparabilité des vecteurs d'Embed 4 avec ceux d'Embed 5 ; supposez donc qu'ils ne le sont pas et budgétez un réencodage complet. Avec les prix ci-dessus, c'est généralement peu coûteux en dollars, mais cher en temps d'ingénierie.
- Surveillez la dimension par défaut. Embed 4 utilisait 1536 par défaut, Embed 5 utilise 2048. Si l'index de votre base vectorielle est figé à 1536, passez
output_dimension=1536(Embed 5 le gère) ou reconstruisez l'index. - Vérifiez votre cloud. Si vous appelez Cohere via Bedrock ou Oracle OCI, Embed 5 n'y est pas encore. Les canaux de lancement sont l'API Cohere, Model Vault, Microsoft Foundry et SageMaker.
- Traitements par lots. Cohere dit que l'embedding par lots est disponible pour l'ingestion à grande échelle, mais le tableau de la documentation ne liste que le point d'accès Embed standard pour les modèles v5 ; confirmez donc la prise en charge d'Embed Jobs pour votre modèle avant de bâtir un pipeline en masse autour.
Avant de blâmer (ou de féliciter) le modèle, vérifiez d'abord le reste du pipeline. Cette réponse dans un fil r/Rag sur l'ajustement fin des embeddings est le conseil le plus pratique sur les changements de modèle que j'aie lu :
"more than I expected. but only after chunking was already clean. dirty chunks make every embedding model look bad."

Cela rejoint ma propre expérience. Pour un exemple concret, le guide de la recherche sémantique sur Zendesk Guide détaille le côté découpage. Un meilleur modèle d'embeddings aide surtout quand le découpage est déjà sain et que vous avez en place une recherche hybride et un reranker.
Où Embed 5 trouve sa place, et où il n'en trouve pas
Embed 5 est un excellent choix si vous êtes une équipe plateforme qui construit sa propre pile de recherche ou de RAG, surtout sur des documents longs, riches visuellement ou financiers. Les 128K de contexte réduisent les découpages maladroits et l'entrée fusionnée texte plus image prend en charge les présentations et les pages scannées. De plus, la séparation Pro/Fast offre un curseur clair entre vitesse et qualité. Associez-le à Parse 5 pour convertir les PDF en Markdown et à Rerank pour trier les résultats, et vous avez toute la pile de recherche de Cohere. Cohere a aussi annoncé que sa plateforme de recherche gérée, Compass Cloud, est désormais en bêta privée.
"Cohere seems to be doing a lot on the search side this year with their parsing model, Compass Cloud announcement, and now Embed 5... exciting stuff"
C'est le mauvais niveau de la pile si votre vrai objectif est un outil du quotidien, comme une base de connaissances IA pour votre équipe ou une IA qui répond aux questions des clients à partir de votre centre d'aide et de vos anciens tickets. Un modèle d'embeddings vous donne des vecteurs. Il vous faut encore le découpage, une base de données vectorielle, un reranker, un modèle de génération comme GPT-6.1 Sol, des garde-fous, et un moyen d'intégrer les réponses à votre helpdesk.
Pour approfondir les compromis, commencez par RAG contre LLM seuls. Pour les centres d'aide en particulier, il existe un guide séparé sur RAG contre ajustement fin.
La leçon la plus dure que j'ai tirée de l'exploitation d'IA sur des files de support en direct n'a rien à voir avec la qualité de la recherche, mais avec ce qui se passe quand la recherche revient vide. J'ai vu des bots de clients payants répondre à de vrais clients avec des affirmations assurées et inventées parce que la base de connaissances n'avait rien de pertinent et que le modèle comblait le vide avec ses données d'entraînement. Un meilleur modèle d'embeddings rend cela plus rare, mais pas impossible. La solution se trouve dans la couche au-dessus : un repli strict quand rien de pertinent n'est trouvé, et des tests sur de vrais tickets avant le lancement.
Essayez eesel si vous voulez les réponses, pas le pipeline
Si vous lisez sur les modèles d'embeddings à cause d'un problème de support, eesel est le raccourci. eesel est une plateforme de coéquipiers IA, et son coéquipier IA pour le helpdesk est toute la pile de recherche, déjà assemblée : il se connecte à votre centre d'aide, vos docs et vos anciens tickets, et rédige ou envoie des réponses dans votre helpdesk, Slack ou un lien partageable. Pas de vecteurs à dimensionner, pas d'index à reconstruire quand un nouveau modèle sort.
Il s'intègre aux helpdesks que la plupart des équipes de support utilisent déjà. Sur Zendesk, il répond à partir des macros et des tickets résolus ; sur Freshdesk et Gorgias, il travaille la même file que vos agents.

Avant de toucher un client en direct, eesel simule le déploiement sur vos tickets historiques, ce qui vous montre d'avance les réponses qu'il aurait envoyées et le taux de résolution. C'est ainsi que je voudrais que toute résolution automatisée de tickets gagne sa place dans une file en direct.
Et si vous êtes venu parce que vous aimez travailler depuis un terminal, la CLI eesel vous permet de piloter le même coéquipier en ligne de commande : connecter une intégration avec eesel integrations connect, modifier ses instructions permanentes, approuver ou refuser les actions en attente et lire chaque exécution avec eesel activity. Chaque commande renvoie du JSON et accepte --dry-run, si bien que des scripts et des agents de code comme Claude Code peuvent aussi la piloter. Il existe un guide complet sur la gestion des agents depuis un terminal et un texte plus court sur la CLI pour le support client.
Essayez eesel gratuitement sur vos propres tickets.
Questions fréquentes
Qu'est-ce que Cohere Embed 5 ?
embed-v5.0-pro) et Embed 5 Fast (embed-v5.0-fast), tous deux avec une fenêtre de contexte de 128K tokens et plus de 100 langues.Combien coûte Cohere Embed 5 ?
0,12 $ par million de tokens de texte et Embed 5 Fast coûte 0,08 $. L'entrée d'images est à 0,40 $ par million de tokens d'image pour les deux. Les instances dédiées Model Vault démarrent à 3,00 $ de l'heure (2 000 $ par mois). Pour la grille tarifaire complète de Cohere, consultez ce détail des tarifs Cohere.Quelle est la différence entre Embed 5 Pro et Embed 5 Fast ?
Cohere Embed 5 est-il meilleur que les embeddings d'OpenAI ?
Dois-je recalculer mes embeddings pour passer d'Embed 4 à Embed 5 ?
output_dimension explicitement si le schéma de votre index est fixe.Cohere Embed 5 est-il disponible sur Amazon Bedrock ?
Puis-je utiliser Cohere Embed 5 pour la recherche en support client ?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.