Pourquoi vous avez besoin d'une alternative à Argon dès maintenant
Je passe beaucoup de temps chez eesel à regarder ce que les gens recherchent vraiment, et « alternatives à Gemini 4 Argon » cette semaine, c'est au fond une seule question : que puis-je utiliser à la place, aujourd'hui ? C'est une question légitime, et plutôt urgente. Google a annoncé Argon le 30 septembre et, dès le premier jour, ne l'a donné qu'aux défenseurs en cybersécurité de son Fairwind Program. Google indique que les clients payants de l'API et les abonnés à Google AI Ultra viennent ensuite. Il n'a pas encore dit quand.
J'ai revérifié avant d'écrire ceci, pour être sûr. À 08:13 UTC le 1er octobre, gemini-4-argon et gemini-4-argon-preview ont tous deux renvoyé 404 NOT_FOUND, et ma clé listait 61 modèles sans aucun Argon dedans. Le modèle Pro le plus récent de la liste était gemini-3.1-pro-preview. Donc si vous avez un produit à livrer ce mois-ci, Argon n'est pas encore une option, et l'inquiétude de ce développeur le jour du lancement reste valable :
"Hopefully they sort out their infrastructure and model versioning so that we can feel confident building production applications on top of their APIs. The capacity limitations I've experienced with them in the past have been deeply problematic."

Il faut être juste envers Argon, cependant, car c'est un modèle solide et une partie de ce qu'il fait est difficile à remplacer. Sur Artificial Analysis, il obtient 52,6 à effort élevé, à peu près au niveau de GPT-6 Astra. Il est n° 1 sur AutomationBench avec 77,5 %. C'est le seul modèle ici avec une limite de sortie de 1M de tokens ; GPT-6.1 Sol s'arrête à 128K et Gemini 3.1 Pro à 65 536. Et il dit « je ne sais pas » bien plus souvent que tout autre modèle que vous pouvez appeler.
Ce qu'Argon fait de mieux, et ce qui remplace chaque partie
Une bonne alternative remplace la chose précise que vous vouliez, pas « Argon » dans son ensemble. J'ai relevé les pages Artificial Analysis d'Argon et de chaque modèle de cet article à 08:14 UTC le 1er octobre, donc tous les scores, coûts et taux d'hallucination ci-dessous proviennent d'un seul index, un seul jour.
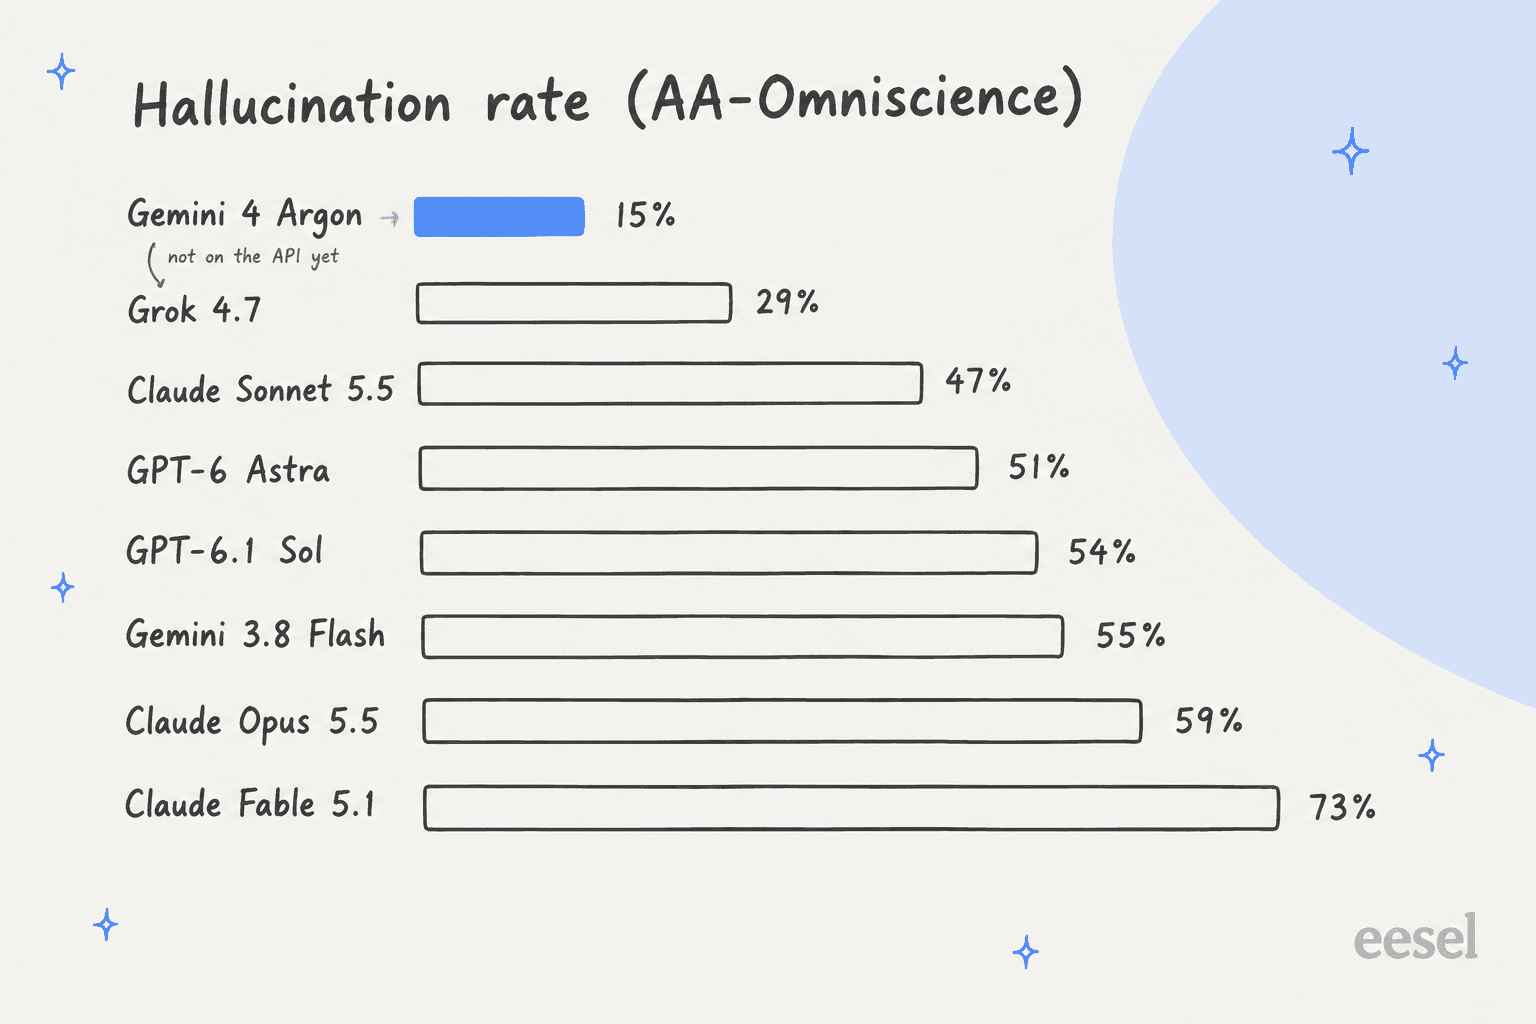
Le taux d'hallucination sur AA-Omniscience est la part des questions qu'un modèle a ratées en répondant quand même, parmi toutes celles qu'il n'a pas réussies. C'est pourquoi les chiffres peuvent sembler un peu étranges. Claude Fable 5.1 a la meilleure précision de tous les modèles ici (67 %) et l'un des taux d'hallucination les plus élevés (73 %), car lorsqu'il ne sait pas, il devine le plus souvent. Argon est l'inverse : 50 % de précision, mais il refuse la plupart des questions auxquelles il ne peut pas répondre.
Ramené à 100 questions, c'est plus clair. Argon en réussit environ 50 et en rate environ 8. GPT-6 Astra en réussit environ 63 et en rate environ 19. Grok 4.7 en rate environ 15, le plus proche d'Argon parmi les modèles disponibles, mais il en réussit aussi moins (environ 47).
| Ce que vous vouliez d'Argon | Chiffre d'Argon | Le meilleur que vous pouvez appeler aujourd'hui |
|---|---|---|
| Un score élevé à 2 $/10 $ | 52,6 pour 1,99 $ la tâche | GPT-6.1 Sol : 51,8 pour 0,72 $ |
| Le meilleur score, quel que soit le prix | 52,6 (n° 8 de l'index) | Claude Opus 5.5 : 57,6 pour 5,98 $ |
| Moins de réponses inventées | 15 % de taux d'hallucination | Grok 4.7 : 29 % |
| Workflows d'agents | 77,5 % sur AutomationBench | Claude Sonnet 5.5 max : 71,3 % |
| Documents longs | 79,7 % en raisonnement sur contexte long | Kimi K3 : 88,7 % |
| Sorties très longues | 1M de tokens de sortie | Rien n'y est comparable pour l'instant |
| Rester chez Google | Pas sur l'API | Gemini 3.8 Flash ou 3.1 Pro |
Cette ligne sur le contexte long m'a surpris. Le tableau de Google lui-même met en avant le score GraphWalks d'Argon, mais sur le test de raisonnement sur contexte long d'Artificial Analysis, tous les modèles de cette liste sauf Grok 4.7 obtiennent un score supérieur à celui d'Argon. Kimi K3 est en tête avec 88,7 %.
Comment j'ai choisi et testé ces alternatives
Chaque modèle de cette liste est disponible aujourd'hui sur une API publique. Je les ai choisis selon quatre critères : le prix tiré de la page tarifaire de chaque éditeur, le score et le coût par tâche du même instantané Artificial Analysis, le taux d'hallucination, et la façon dont chacun couvre la raison précise pour laquelle vous vouliez Argon.
Ensuite, j'ai mené mon propre test sur ce pour quoi Argon est réputé. Un benchmark d'hallucination pose des questions de culture générale sans documentation. Un bot de support travaille à partir d'un centre d'aide. Je voulais savoir si l'écart d'honnêteté d'Argon apparaît aussi quand le modèle a une base de connaissances sous les yeux.
Le montage était une courte politique de remboursement et de livraison pour une entreprise SaaS fictive, que j'ai reprise du banc d'essai du test de GPT-6.1 Sol. J'ai posé 12 questions : 4 auxquelles la politique répond, et 8 pièges auxquels elle ne répond pas (PayPal, un SLA de disponibilité, le stockage des données dans l'UE, une ligne téléphonique, les limites de débit de l'API, une intégration Salesforce, une date de Black Friday et HIPAA). J'ai fait tourner cinq modèles que je pouvais atteindre directement (GPT-6.1 Sol, GPT-6 Astra, GPT-6 Luna, Gemini 3.8 Flash, Gemini 3.1 Pro Preview) dans trois modes, soit 160 appels au total :
- Strict : « Réponds uniquement à partir de la politique. Si ce n'est pas couvert, dis-le et passe le relais à un humain. »
- Loose : « Sois aussi utile que possible », avec la ligne « ne devine pas, escalade » de la politique elle-même laissée en place.
- Bare : « Sois aussi utile que possible et donne aux clients une réponse directe », avec la ligne « ne devine pas » supprimée.
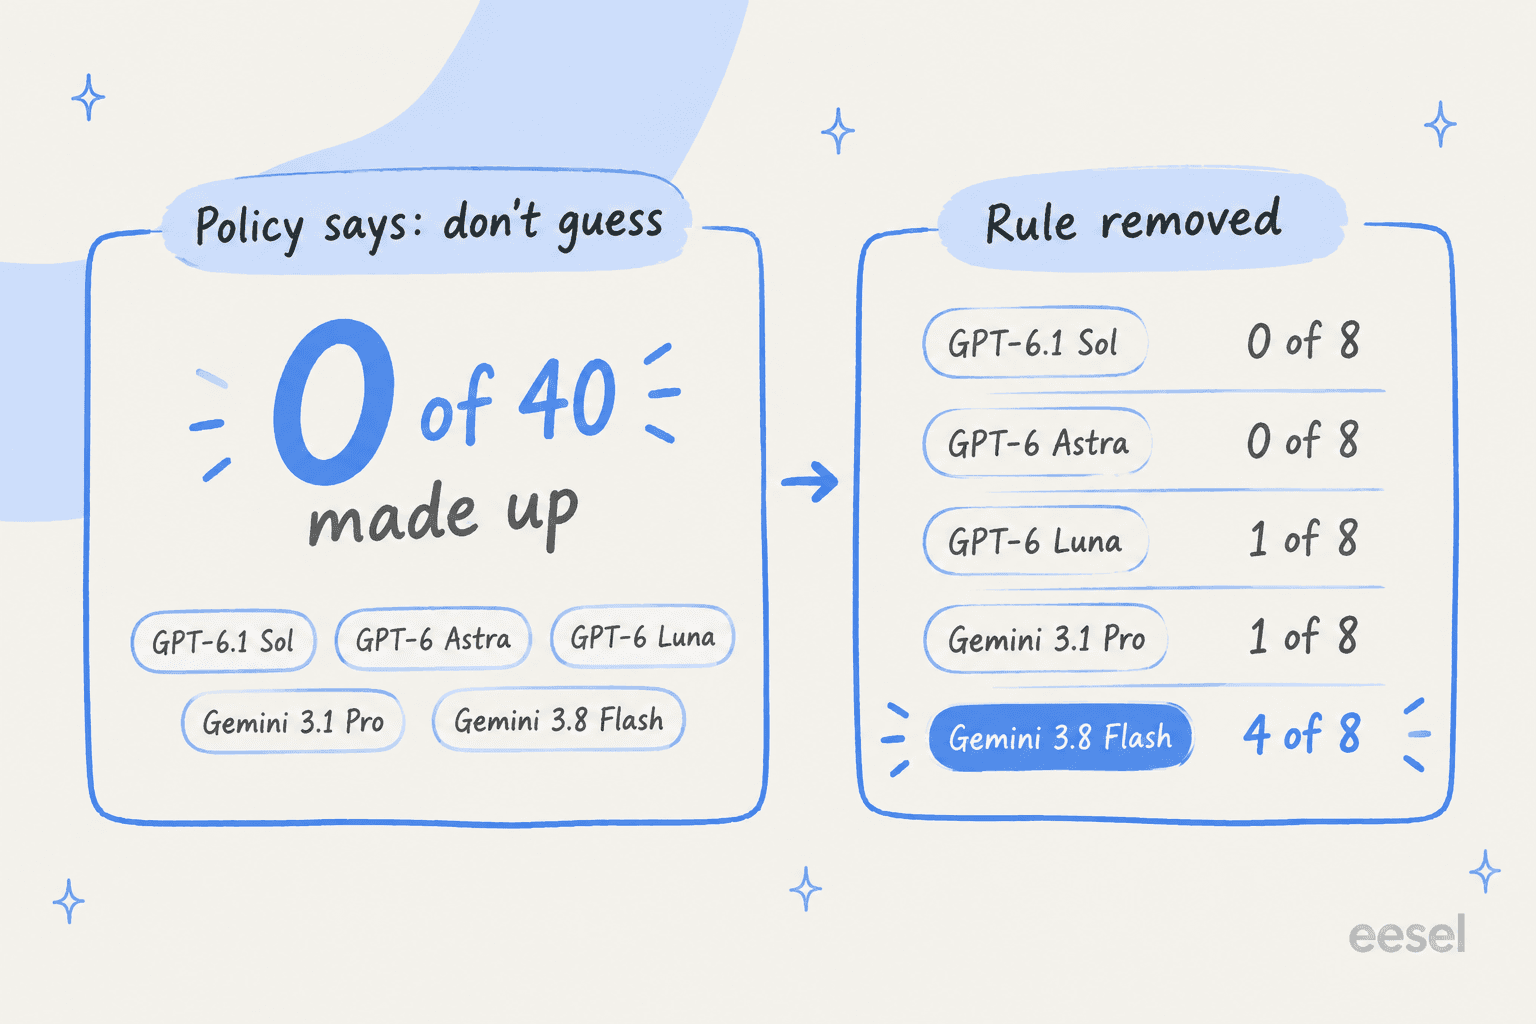
En modes strict et loose, chaque modèle a inventé 0 réponse sur 40 aux pièges et réussi les 4 questions couvertes. Le mode bare est celui où ils se séparent. GPT-6.1 Sol et GPT-6 Astra n'ont toujours rien inventé. Luna a dit « We haven't announced this year's Black Friday sale start date yet », et Gemini 3.1 Pro a dit « We don't currently offer phone support. » Gemini 3.8 Flash a inventé quatre réponses, dont une du genre qui finit dans un e-mail juridique : « our standard services are not certified as HIPAA compliant, and we do not sign Business Associate Agreements (BAAs) under our standard plans. » Il a aussi inventé une fausse adresse support@acmecloud.com.
Deux réserves. Douze questions sur une politique bien rangée, c'est un test plutôt petit et clément. Et je n'ai pas pu y soumettre Argon lui-même, Grok ni les modèles Claude, donc il renseigne sur l'effet de la consigne, pas sur un classement complet. Le résultat concorde néanmoins avec l'index : la règle dans votre prompt a fait bien plus bouger le résultat que le choix du modèle.
Voici l'ensemble du paysage.
| Modèle | Meilleure raison de le choisir | Prix API (entrée / cache / sortie par 1M) | Score AA / coût par tâche | Hallucination | Sortie max | Poids | Mon test (mode bare) |
|---|---|---|---|---|---|---|---|
| Gemini 4 Argon (référence) | Indisponible | 2 $ / 0,10 $ / 10 $ promo, puis 4 $ / 0,20 $ / 20 $ | 52,6 / 1,99 $ (high) | 15 % | 1M | Fermés | Test impossible |
| GPT-6.1 Sol | Même prix, aujourd'hui | 2 $ / 0,10 $ / 10 $ | 51,8 / 0,72 $ (max) | 54 % | 128K | Fermés | 0/8 inventées |
| Claude Opus 5.5 | Meilleur score | 4 $ / 0,20 $ / 20 $ | 57,6 / 5,98 $ (max) | 59 % | - | Fermés | - |
| Grok 4.7 | Moins de réponses inventées | 2 $ / 0,50 $ / 6 $ | 46,4 / 3,74 $ (xhigh) | 29 % | - | Fermés | - |
| GPT-6 Astra | Même score, OpenAI | 10 $ / 1 $ / 50 $ | 52,7 / 3,26 $ (max) | 51 % | - | Fermés | 0/8 inventées |
| Claude Sonnet 5.5 | Workflows d'agents | 2 $ / 0,20 $ / 10 $ | 56,0 / 7,62 $ (max) | 47 % | - | Fermés | - |
| Claude Fable 5.1 | Meilleure précision | 10 $ / 0,25 $ / 50 $ | 53,4 / 7,63 $ (max) | 73 % | 128K | Fermés | - |
| Gemini 3.8 Flash | Google, offre gratuite | 0,75 $ / 0,075 $ / 3,75 $ | 40,9 / 1,24 $ (high) | 55 % | - | Fermés | 4/8 inventées |
| Gemini 3.1 Pro Preview | Modèle Pro de Google | 2 $ / 0,20 $ / 12 $ | 29,7 / 0,67 $ | 51 % | 65,536 | Fermés | 1/8 inventée |
| Kimi K3 | Poids ouverts, documents longs | 3 $ / 0,30 $ / 15 $ | 43,6 / 2,00 $ (max) | 53 % | - | Ouverts | - |
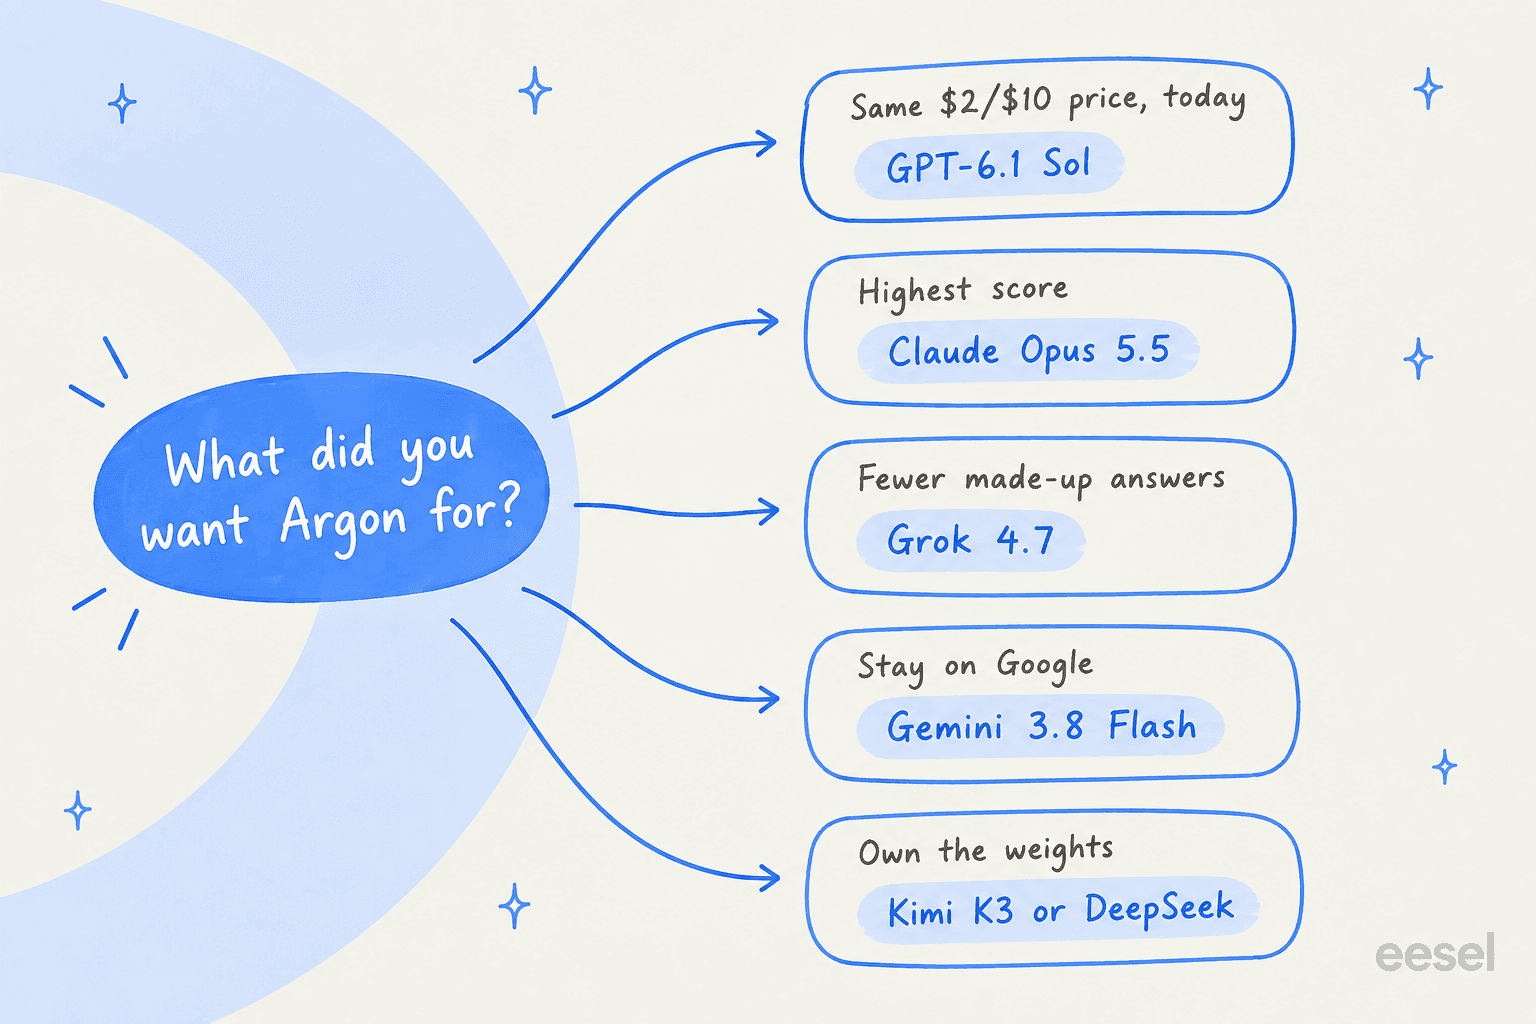
Pour quoi vouliez-vous Gemini 4 Argon ?
Choisissez la raison la plus proche de la vôtre.
1. GPT-6.1 Sol : la même grille tarifaire, disponible aujourd'hui
Idéal pour : les équipes qui voulaient le prix de 2 $/10 $ d'Argon pour un modèle quasi de pointe, et en ont aussi besoin en production ce mois-ci.
Si le prix d'Argon vous plaisait, c'est l'échange le plus proche. GPT-6.1 Sol a été lancé lors du DevDay d'OpenAI le 29 septembre, un jour avant Argon, et sa page de modèle indique 2 $ en entrée, 0,10 $ en cache et 10 $ en sortie, la même grille que la promotion d'Argon, ligne pour ligne. Il a une fenêtre de contexte de 1 050 000 tokens, 128 000 tokens de sortie maximum et une date limite de connaissances d'avril 2026.
Côté score, il est proche aussi. Artificial Analysis donne à 6.1 Sol 51,8 à effort maximal contre 52,6 pour Argon. La différence se joue sur le coût par tâche : 6.1 Sol écrit environ 38K tokens de sortie par tâche contre 62K pour Argon, donc il coûte 0,72 $ la tâche là où Argon coûte 1,99 $. Une fois la promotion d'Argon terminée, c'est 3,98 $, plus de cinq fois plus. Les commentateurs du jour du lancement ont fait le calcul assez vite :
"Sol 6.1 scores one point less than Gemini 4 on intelligence AND costs less than half ($0.72 vs $1.99) per task."
Le compromis porte sur l'honnêteté. Le taux d'hallucination de 6.1 Sol est de 54 % à effort maximal, contre 15 % pour Argon. Dans mon test, cela ne s'est pas vu en pratique : il a inventé 0 réponse sur 8 aux pièges même en mode bare, et il a été le seul modèle avec Astra à y arriver. L'API a aussi quelques aspérités : 6.1 Sol n'accepte pas l'effort none, et Chat Completions ne fonctionne que sans appel d'outils, donc prévoyez l'API Responses.
Avantages : même prix par token que la promotion d'Argon ; 2,7 fois moins cher par tâche ; disponible aujourd'hui ; 0/8 inventées dans mon test en mode bare.
Inconvénients : environ 3,5 fois le taux d'hallucination d'Argon dans l'index ; pas d'effort none ; plafond de sortie de 128K.
Tarifs : 2 $ en entrée, 0,10 $ en cache, 10 $ en sortie par 1M de tokens ; les prompts de plus de 272K en entrée sont facturés à des tarifs plus élevés. Détail complet dans GPT-6.1 Sol pricing.
Mon avis : c'est le choix par défaut. Il vous donne le prix d'Argon aujourd'hui, à environ un tiers du coût par tâche d'Argon, et vous pourrez toujours le comparer en A/B à Argon quand Google ouvrira l'API.
2. Claude Opus 5.5 : le plafond plus haut
Idéal pour : le code difficile, les longues exécutions d'agents et le travail d'expert quand vous vouliez Argon pour son score.
Si l'attrait était « le modèle de pointe de Google », Claude Opus 5.5 est le modèle de pointe que vous pouvez appeler. Il obtient 57,6 sur Artificial Analysis à effort maximal, environ 5 points au-dessus d'Argon, et il est devant sur Terminal-Bench 4.0 là-bas (59,6 % contre 57,1 %). Sa grille tarifaire est aussi familière : 4 $ en entrée, 0,20 $ en cache, 20 $ en sortie, c'est exactement ce que coûtera Argon après la promotion.
La comparaison équitable se fait à effort moyen. Opus 5.5 medium obtient 51,2 pour 1,34 $ la tâche, environ le niveau d'Argon pour moins d'argent. Un commentateur de HN a fait la même remarque avec un effort élevé :
"It's comparable to Opus 5.5 on "high" (54 vs 53; $1.82 vs $1.99), crushes every model except the most modern OAI/Ant ones, has way lower hallucination than every existing model and probably broader support for multimodal like existing Gemini models."
Cette citation est aussi l'argument honnête contre Opus. Son taux d'hallucination est de 59 % en max et 68 % en medium, donc il devine plus qu'Argon quand il n'est pas sûr de la réponse. Si votre travail est de la recherche ouverte, où personne ne vérifie la réponse face à une source, cela compte beaucoup.
Avantages : le meilleur score ici ; la grille tarifaire d'Argon après promotion ; code en terminal solide ; contexte de 1M.
Inconvénients : 5,98 $ la tâche en max ; devine plus souvent qu'Argon ; un fournisseur de plus à gérer.
Tarifs : 4 $ en entrée, 0,20 $ en lecture de cache, 20 $ en sortie par 1M de tokens ; Batch à -50 %. Plus de détails dans Claude Opus 5.5 pricing.
Mon avis : faites tourner Opus 5.5 en medium pour du travail de niveau Argon, et gardez l'effort maximal pour les tâches où les 6 points de plus se rentabilisent. Le test d'Opus 5.5 explique où se situe cette limite.
3. Grok 4.7 : ce qui se rapproche le plus de l'honnêteté d'Argon
Idéal pour : la recherche, l'analyse et les questions-réponses où une mauvaise réponse coûte plus cher qu'un « je ne suis pas sûr ».
Ce n'est pas le choix évident, et c'est celui que je recommanderais le plus souvent. Grok 4.7 a un taux d'hallucination de 29 % sur AA-Omniscience, le plus bas de tous les modèles que vous pouvez appeler aujourd'hui. Argon est à 15 %, et tout le reste de cette liste est à 47 % ou plus. Sur 100 questions, cela fait environ 15 mauvaises réponses pour Grok, contre environ 19 pour GPT-6 Astra et environ 8 pour Argon.
Il rejoint aussi Argon en cybersécurité. Dans le tableau de Google lui-même, Argon, Grok 4.7 et GPT-6 Astra sont à égalité à 68 % sur CWE-bench v1. Le prix semble bon sur le papier : 2 $ en entrée et 6 $ en sortie par million, d'après la page des modèles de xAI, donc la sortie est 40 % moins chère que la promotion d'Argon.
Les inconvénients sont réels, cependant. La précision de Grok sur le même test est de 47,5 %, inférieure à celle d'Argon, donc il refuse davantage, puis répond moins. Il écrit pas mal : à effort xhigh, il coûte 3,74 $ la tâche pour un score de 46,4. Et au-delà de 200K tokens de prompt, toute la requête est facturée à 4 $/12 $, pas seulement l'excédent. Un commentaire du jour du lancement a signalé une habitude qu'il vaut la peine de tester :
"What keeps both Gemini and Grok from actually being frontier class AIs is effort. Both AIs rush to give you a response even when the effort is set to the highest setting. Hopefully, Argon isn't as prone to satisficing and premature convergence compared to its predecessor"
Avantages : le taux d'hallucination le plus bas que vous puissiez obtenir aujourd'hui ; à égalité avec Argon sur CWE-bench v1 ; tarif de sortie moins cher ; contexte de 500K.
Inconvénients : précision et score inférieurs à Argon ; 3,74 $ la tâche en xhigh ; saut de prix sur contexte long à 200K.
Tarifs : 2 $ en entrée, 0,50 $ en cache, 6 $ en sortie par 1M de tokens sous 200K ; 4 $/1 $/12 $ au-dessus. Voir Grok 4.7 pricing.
Mon avis : si les 15 % d'Argon sont le titre qui vous a enthousiasmé, Grok 4.7 est ce qui s'en rapproche le plus ce mois-ci. Utilisez-le là où un « je ne sais pas » honnête vaut plus qu'une supposition assurée, et consultez le test de Grok 4.7 pour les notes pratiques.
4. GPT-6 Astra : le jumeau d'Argon en score
Idéal pour : les équipes déjà sur OpenAI qui veulent exactement le niveau de score d'Argon, plus le mode Ultrafast.
GPT-6 Astra est le modèle auquel Artificial Analysis a comparé Argon : 52,7 pour Astra à effort maximal, 52,6 pour Argon. En précision, Astra est nettement devant, 63 % contre 50 % pour Argon. En hallucination, il est à 51 %, donc il devine plus souvent quand il ne sait pas.
Il est aussi plus efficace en tokens. Astra écrit environ 27K tokens de sortie par tâche contre 62K pour Argon, c'est pourquoi Artificial Analysis dit que l'avantage de coût d'Argon vient du prix, pas du fait qu'il écrit moins. Astra coûte 3,26 $ la tâche ; Argon 1,99 $ pendant la promotion et 3,98 $ après, donc après la promotion, Astra est le moins cher des deux. Dans mon test, Astra a inventé 0 réponse sur 8 aux pièges en mode bare, à égalité avec 6.1 Sol pour le résultat le plus propre de tous.
Avantages : même score qu'Argon ; meilleure précision ; moins cher par tâche qu'Argon après promotion ; mode Ultrafast disponible maintenant ; 0/8 inventées dans mon test.
Inconvénients : 10 $/50 $ par million ; 6.1 Sol est presque aussi bon pour environ un cinquième du coût par tâche ; 51 % d'hallucination dans l'index.
Tarifs : 10 $ en entrée, 1 $ en cache, 50 $ en sortie par 1M de tokens ; Batch et Flex à -50 %. Voir GPT-6 Astra pricing.
Mon avis : Astra a du sens si vous avez besoin d'Ultrafast ou de ce dernier point de précision dès aujourd'hui. Pour tous les autres, GPT-6.1 Sol donne presque le même résultat pour beaucoup moins, et le guide des alternatives à GPT-6.1 Sol compare le reste du paysage.
5. Claude Sonnet 5.5 : le choix pour les workflows d'agents au même prix affiché
Idéal pour : les agents à plusieurs étapes et le code en terminal, si l'avance d'Argon sur AutomationBench vous a tapé dans l'œil.
Le chiffre indépendant le plus frappant d'Argon est AutomationBench : 77,5 % sur Artificial Analysis, n° 1. Le modèle le plus proche que vous pouvez appeler est Claude Sonnet 5.5 à effort maximal, avec 71,3 %. Sonnet bat aussi Argon sur Terminal-Bench 4.0 là-bas (63,6 % contre 57,1 %), et son prix affiché est le même 2 $/10 $.
Un praticien sur LinkedIn a bien résumé l'écart entre benchmarks en citant le chiffre auto-déclaré de chaque laboratoire :
"On Terminal-Bench 4.0, the one benchmark Google and Anthropic both publish, Argon scores 57.4%. Sonnet 5.5 scores 70.6%. Same price, 13 points apart."

Le coût par tâche est l'endroit où il faut regarder de plus près. À effort maximal, Sonnet 5.5 obtient 56,0 mais coûte 7,62 $ la tâche, car il écrit près de 194K tokens de sortie par tâche. L'effort élevé donne 46,7 pour 1,08 $. Et si votre agent force un appel d'outil avec tool_choice, Sonnet 5.5 renvoie une erreur 400, donc vérifiez cela avant de changer.
Avantages : même prix affiché de 2 $/10 $ que la promotion d'Argon ; les meilleurs scores AutomationBench et terminal que vous puissiez appeler ; la plus faible hallucination des modèles Claude (47 % en max).
Inconvénients : 7,62 $ la tâche en max ; un tool_choice forcé renvoie une erreur ; gros volumes de tokens aux réglages d'effort élevé.
Tarifs : 2 $ en entrée, 0,20 $ en lecture de cache, 10 $ en sortie par 1M de tokens ; Batch 1 $/5 $. Voir Claude Sonnet 5.5 pricing.
Mon avis : pour le travail d'agents, Sonnet 5.5 est le substitut le plus solide. Commencez à effort élevé et ne montez que si l'agent échoue toujours aux mêmes étapes ; le test de Sonnet 5.5 détaille le calcul de l'effort.
6. Claude Fable 5.1 : le modèle le plus précis, à prix premium
Idéal pour : le travail d'expert où vous vérifiez chaque réponse de toute façon, et où la précision compte plus que le coût.
Claude Fable 5.1 est le modèle généralement disponible le plus capable d'Anthropic, et il obtient 53,4 sur Artificial Analysis, légèrement au-dessus d'Argon. Il a la meilleure précision de tous les modèles de cet article, 67 %, et aussi le meilleur score de raisonnement sur contexte long parmi les modèles fermés, 85,3 %.
Il a aussi le taux d'hallucination le plus élevé d'ici, 73 %, qui est l'image miroir d'Argon. Fable répond juste à plus de questions, et il répond aussi à plus de questions auxquelles il ne devrait pas répondre. C'est acceptable pour un avocat ou un analyste qui lit chaque ligne, et moins pour tout ce qui part directement chez un client.
Ensuite, il y a le prix : 10 $ en entrée et 50 $ en sortie, avec des lectures de cache à 0,25 $. À effort maximal, c'est 7,63 $ la tâche. Un employé de Google sur LinkedIn a utilisé précisément cet écart pour vanter Argon :
"I've been testing it using our internal AI tool, and the performance is incredible. What stands out more is the cost. 5x cheaper than GPT-6 Astra and Claude Fable 5.1 at current pricing."
C'est au token, au prix promotionnel. Par tâche Artificial Analysis, Argon est environ 3,8 fois moins cher que Fable, ce qui reste un gros écart.
Avantages : la meilleure précision ici ; raisonnement solide sur contexte long ; lectures de cache peu chères pour un modèle de pointe ; 128K de sortie.
Inconvénients : 10 $/50 $ par million ; taux d'hallucination de 73 % ; l'usage forcé d'outils renvoie une erreur 400.
Tarifs : 10 $ en entrée, 0,25 $ en lecture de cache, 50 $ en sortie par 1M de tokens ; Batch 5 $/25 $. Voir Claude Fable 5.1 pricing.
Mon avis : Fable est le bon choix quand un expert humain relit la sortie et veut le modèle le plus susceptible d'avoir raison. Pour tout ce qui tourne sans surveillance, Opus 5.5 ou 6.1 Sol est la dépense la plus sûre.
7. Gemini 3.8 Flash : le modèle Google sur lequel vous pouvez vraiment construire
Idéal pour : les équipes engagées sur Google Cloud ou AI Studio, les prototypes sur l'offre gratuite et le traitement par lots économique.
Si vous voulez rester chez Google en attendant l'ouverture d'Argon, Gemini 3.8 Flash est le meilleur modèle Gemini sur l'API d'après les chiffres d'Artificial Analysis, à 40,9 à effort élevé. C'est bien derrière les 52,6 d'Argon, et devant les 29,7 de Gemini 3.1 Pro Preview, ce qui déroute souvent : le Flash plus récent obtient plus que le Pro plus ancien.
Il est peu cher et propose aussi une offre gratuite. La page tarifaire de Gemini indique 0,75 $ en entrée et 3,75 $ en sortie jusqu'au 31 décembre 2026, puis 1,50 $ et 7,50 $ à partir du 1er janvier 2027. Mieux vaut budgéter sur le tarif 2027.
Mon test est la mise en garde ici. En mode bare, Gemini 3.8 Flash a inventé 4 réponses sur 8, dont celle sur HIPAA et une adresse e-mail de support qui n'existe pas. Avec la règle « ne devine pas » en place, il n'en a inventé aucune. C'est donc un bon modèle pour le support si vous lui donnez des règles strictes, et un risque si vous ne le faites pas. Un commentateur de HN avait une autre inquiétude à propos du cache de Google :
"And this pricing is their 'discount pricing'. Add that to AI studio and Vertex's famously terrible caching, it is hard to see this as competitive."
Avantages : meilleur score Gemini sur l'API aujourd'hui ; offre gratuite ; modèle fermé le moins cher ici ; réponses en 2,6 s en moyenne dans mon test.
Inconvénients : très en dessous du score d'Argon ; le prix double le 1er janvier 2027 ; a inventé 4 réponses sur 8 sans prompt strict.
Tarifs : 0,75 $ en entrée, 0,075 $ en lecture de cache, 3,75 $ en sortie par 1M de tokens jusqu'au 31 décembre 2026, puis 1,50 $/0,15 $/7,50 $. Voir Gemini 3.8 Flash pricing.
Mon avis : si vous comptez passer à Argon plus tard, construire dès maintenant sur 3.8 Flash vous garde sur la même API et les mêmes outils. Écrivez simplement la règle « ne devine pas » dans le prompt dès le premier jour. Le test de Gemini 3.8 Flash couvre le reste.
8. Gemini 3.1 Pro Preview : l'option prudente de Google
Idéal pour : les équipes dans l'écosystème Google qui veulent moins de réponses inventées que Flash et peuvent vivre avec un score plus bas.
Gemini 3.1 Pro Preview est le modèle Pro le plus récent que ma clé d'API pouvait atteindre, et sur le papier c'est le prédécesseur d'Argon. Artificial Analysis dit qu'Argon a +23 points d'avance sur lui, ce qui correspond à l'instantané : 29,7 pour 3.1 Pro. Sa page de modèle indique une limite d'entrée de 1 048 576 tokens et une limite de sortie de 65 536 tokens.
La raison de sa présence dans cette liste est le comportement, pas le score. Son taux d'hallucination est de 51 %, un peu meilleur que les 55 % de 3.8 Flash, et sa précision de 55 %. Dans mon test en mode bare, il a inventé 1 réponse sur 8 contre 4 pour Flash. C'était aussi mon exécution la plus lente et la plus chère, à environ 6 à 9 secondes et 6 $ à 10 $ pour 1 000 réponses, car il dépense beaucoup de tokens à réfléchir.
Avantages : moins de réponses inventées que 3.8 Flash dans mon test ; contexte d'entrée de 1M ; Batch à moitié prix.
Inconvénients : le score Artificial Analysis le plus bas de cette liste ; toujours un modèle en preview ; lent et gourmand en tokens ; supplément sur contexte long au-delà de 200K.
Tarifs : 2 $ en entrée, 0,20 $ en cache, 12 $ en sortie par 1M de tokens jusqu'à 200K ; 4 $/0,40 $/18 $ au-dessus ; Batch 1 $/6 $ ; pas d'offre gratuite. Plus de détails dans le guide des tarifs Gemini.
Mon avis : je ne choisirais 3.1 Pro que si vous êtes lié à Google et que le travail consiste en réponses soignées à faible volume. Pour presque tout le reste, 3.8 Flash ou le modèle d'un autre laboratoire est la meilleure dépense jusqu'à l'ouverture d'Argon.
9. Kimi K3 : poids ouverts et meilleur score sur contexte long
Idéal pour : les équipes qui doivent auto-héberger, ou qui voulaient Argon pour de très longs documents.
Argon est fermé, donc si vous avez besoin de poids téléchargeables, la liste devient assez courte. Kimi K3, de Moonshot AI, publie ses poids complets sur Hugging Face sous une licence personnalisée et obtient 43,6 sur Artificial Analysis à effort maximal. Il a aussi le meilleur score de raisonnement sur contexte long de tous les modèles que j'ai vérifiés, 88,7 %, contre 79,7 % pour Argon.
Sur l'API hébergée, il coûte 3 $ en entrée, 0,30 $ en cache et 15 $ en sortie par million, d'après la page tarifaire de Kimi, donc il est plus cher que la promotion d'Argon au token. À la tâche, c'est 2,00 $, à peu près comme Argon. Le raisonnement ne peut pas être désactivé.
L'option ouverte moins chère est DeepSeek V4.1 Flash, sous licence MIT, à 0,15 $/0,60 $ par million en heures creuses et 0,27 $ la tâche. Je le tiendrais à l'écart de tout ce qui est en contact avec les clients et demande une honnêteté à la Argon : son taux d'hallucination dans l'index est de 96 %.
Avantages : les poids ouverts les plus solides de cette liste ; meilleur score de raisonnement sur contexte long d'ici ; contexte de 1M ; entrée image et vidéo.
Inconvénients : licence personnalisée, ni MIT ni Apache ; l'API hébergée coûte plus au token que la promotion d'Argon ; taux d'hallucination de 53 %.
Tarifs : 3 $ en entrée, 0,30 $ en cache hit, 15 $ en sortie par 1M de tokens. Voir Kimi K3 pricing.
Mon avis : Kimi K3 est le choix pour l'auto-hébergement, et aussi pour le travail riche en documents. Si vous n'avez besoin que de l'API hébergée, 6.1 Sol est moins cher et obtient un meilleur score.
Si vous vouliez Argon pour la sécurité
Les premiers utilisateurs d'Argon sont les équipes de sécurité, donc certains lecteurs sont venus pour cela. Les chiffres de Google sont plutôt solides : 85,8 sur son benchmark de vulnérabilités réelles contre 71,0 pour Gemini 3.8 Flash Cyber, et 70,9 % contre 58,2 % sur le test d'intrusion en boîte noire de Wiz, d'après l'article de lancement.
Chaque laboratoire de pointe restreint de la même façon son modèle de sécurité le plus puissant. Claude Mythos 5.1 d'Anthropic est derrière Project Glasswing, et GPT-5.6-Cyber d'OpenAI derrière son propre programme d'accès de confiance. Si vous ne faites partie d'aucun de ces programmes, le guide des alternatives à Codex Security Cloud couvre les outils auxquels vous pouvez vous inscrire aujourd'hui. Parmi les modèles généralistes ci-dessus, GPT-6 Astra et Grok 4.7 sont à égalité avec Argon sur CWE-bench v1, ce sont donc de bons points de départ.
Ce que mon test dit de l'hallucination en support
Le test a changé la façon dont je lis le chiffre phare d'Argon. Un taux d'hallucination de 15 % est un résultat sans documentation : le modèle répond à des questions de culture générale sans rien devant lui. Un bot de support n'est pas sans documentation. Il a votre centre d'aide, vos macros et vos politiques, et ses consignes lui disent quoi faire quand tout cela s'épuise. Dans ce montage, la consigne a fait plus de travail que le modèle : 0 réponse inventée sur 40 avec la règle, jusqu'à 4 sur 8 sans elle.
eesel a aussi vu la défaillance du mode bare dans des files réelles. Plus tôt cette année, quelques clients payants d'eesel avaient des bots qui répondaient à de vrais clients avec des connaissances générales quand la base de connaissances revenait vide, et l'un d'eux a répondu à une question de support par « Oxygen ». Une autre équipe, un groupe de support technique B2B sur Zendesk, s'inquiétait pour une autre raison : leur centre d'aide disait « we support all models », et le bot confirmait volontiers des produits qu'ils ne prenaient pas en charge. Dans aucun des cas, le problème n'était le modèle. Les deux relevaient de l'ancrage dans les sources et du repli, c'est pourquoi la première chose que je vérifierais sur n'importe quel bot de support est une règle ferme « dis que tu ne sais pas et passe le relais », testée sur des tickets passés avant la mise en production.
C'est aussi ce que demandent les acheteurs. Un responsable CX traitant environ 7 000 tickets par mois a dit à l'équipe eesel lors d'un appel commercial que l'IA ne devrait prendre que les tickets dont elle est sûre et laisser le reste aux humains. C'est une règle de passage de relais. L'honnêteté d'Argon serait un bon filet de sécurité, mais vous pouvez fixer la règle dès aujourd'hui, sur n'importe quel modèle. Les guides sur la prévention des hallucinations de l'IA et l'escalade par l'IA expliquent comment.
Essayer eesel

Si vous attendiez Argon pour rendre votre bot de support plus fiable, vous n'avez pas à attendre. eesel est un coéquipier de helpdesk IA qui rejoint votre file existante dans Zendesk, Freshdesk ou Gorgias, apprend de votre centre d'aide et de vos tickets passés, et ne répond qu'à ce qu'il peut sourcer. Avant de répondre à qui que ce soit, il lance une simulation sur votre historique de tickets, pour que vous voyiez à quelles questions il répond et lesquelles il transmet. Quand Argon ouvrira, le modèle pourra changer tandis que vos règles resteront en place.
Si vous travaillez depuis un terminal, la CLI eesel pilote le même coéquipier et le même espace de travail que le tableau de bord. Vous pouvez scripter une simulation sur un lot d'anciens tickets, récupérer les réponses dans votre propre feuille de relecture, et même laisser un agent de code comme Claude Code, Codex ou Cursor la configurer pour vous. Essayez eesel gratuitement et lancez-le sur vos propres tickets avant de choisir le modèle.
Questions fréquentes
Quelle est la meilleure alternative à Gemini 4 Argon en ce moment ?
Puis-je déjà utiliser Gemini 4 Argon ?
gemini-4-argon, et il ne figurait pas parmi les 61 modèles que ma clé pouvait lister. Google indique que les clients payants de l'API et les abonnés à Google AI Ultra sont les suivants, sans date. L'aperçu de Gemini 4 Argon suit ce que l'on sait.Quelle alternative à Gemini 4 Argon hallucine le moins ?
Existe-t-il une alternative Google à Gemini 4 Argon ?
GPT-6.1 Sol est-il moins cher que Gemini 4 Argon ?
Quelle est la meilleure alternative open-weight à Gemini 4 Argon ?
Ai-je besoin de Gemini 4 Argon pour un bot de support client ?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.