

En bref
Gemini 3.8 Flash TTS coûte 0,50 $ par million de tokens de texte en entrée et 9,00 $ par million de tokens audio en sortie sur le palier payant standard, jusqu'au 31 décembre 2026. L'audio est facturé à 25 tokens par seconde, donc une heure complète de parole générée revient à environ 0,81 $. Il existe aussi un palier réellement gratuit sur Google AI Studio.
Deux choses à retenir. D'abord, les deux tarifs doublent le 1er janvier 2027, donc tout budget construit sur les chiffres d'aujourd'hui doit être doublé pour l'année prochaine. Ensuite, à environ 0,81 $ l'heure, c'est l'un des modèles vocaux expressifs les moins chers du marché, bien en dessous d'ElevenLabs et des paliers génératifs premium d'Amazon et de Deepgram.
Le piège est celui qui s'applique à tout modèle brut : un audio bon marché n'équivaut pas à un produit fonctionnel. Un endpoint TTS parle ; il ne connaît pas votre base de connaissances, n'appelle pas vos outils et n'a pas été testé au préalable sur de vraies conversations. Si vous placez un modèle vocal face au service client, cet écart est déterminant, et c'est précisément ce qu'un agent de support IA existe pour combler.
Ce qu'est vraiment Gemini 3.8 Flash TTS
Gemini 3.8 Flash TTS (gemini-3.8-flash-tts) est l'actuel modèle de synthèse vocale de Google, et contrairement à beaucoup de modèles audio qui circulent, il est stable plutôt qu'en préversion. L'identifiant ne porte pas de suffixe -preview, et Google le présente comme le remplaçant recommandé de l'ancien gemini-3.1-flash-tts-preview. Il prend du texte en entrée et produit de l'audio en sortie, rien de plus, exactement ce qu'on attend d'un modèle vocal dédié.
La fiche technique est généreuse. Vous disposez de 30 voix de studio prédéfinies (Zephyr, Puck, Kore, Fenrir et d'autres), chacune avec un descripteur comme Bright ou Firm, plus une Extended Voice Library de centaines d'autres accessibles via client.voices.list(). Il parle 130 langues avec détection automatique de l'entrée, et vous pouvez orienter le style, l'accent, le rythme et le ton avec des prompts en langage naturel, ou insérer des balises en ligne comme <laugh> et <sigh> pour des événements vocaux ponctuels. Il propose aussi la création de voix (construire une persona à partir d'une description textuelle) et le clonage vocal à partir d'un extrait de référence.
Le détail technique qui pose problème en production : le multi-locuteur est limité à deux locuteurs par requête. Un podcast à trois voix ou une scène de groupe implique de synthétiser chaque tour de parole séparément et d'assembler l'audio soi-même. La sortie par défaut est en WAV mono 24 kHz, avec mulaw et alaw disponibles pour la téléphonie. Cela coexiste avec le modèle texte seul Gemini 3.8 Flash, et les deux sont facturés de façon totalement différente, ce qui est à l'origine de la plupart des confusions.
Prix de Gemini 3.8 Flash TTS : le tableau complet
Voici chaque palier, en USD par million de tokens, aux tarifs promotionnels de 2026. Le tarif 2027 est entre parenthèses car, comme on le verra, tout double.
| Palier | Texte en entrée / 1M | Audio en sortie / 1M | Remarques |
|---|---|---|---|
| Standard | 0,50 $ (1,00 $) | 9,00 $ (18,00 $) | Le tarif par défaut |
| Batch | 0,25 $ (0,50 $) | 4,50 $ (9,00 $) | ~50 % de réduction, tâches asynchrones |
| Flex | 0,25 $ (0,50 $) | 4,50 $ (9,00 $) | Même tarif, cache moins cher |
| Priority | 0,90 $ (1,80 $) | 16,20 $ (32,40 $) | ~1,8x, sensible à la latence |
| Free | Gratuit | Gratuit | Standard/priority via AI Studio |
Tout cela provient directement de la page de tarifs de l'API Gemini de Google. La mise en cache du contexte est prise en charge et démarre à 0,125 $ par million de tokens de cache en entrée sur le palier standard, plus des frais de stockage de 0,50 $ par million par heure. Le chiffre de sortie audio est celui qui compte, car c'est celui qui évolue avec la quantité de parole générée. Le texte en entrée est presque une erreur d'arrondi en comparaison.
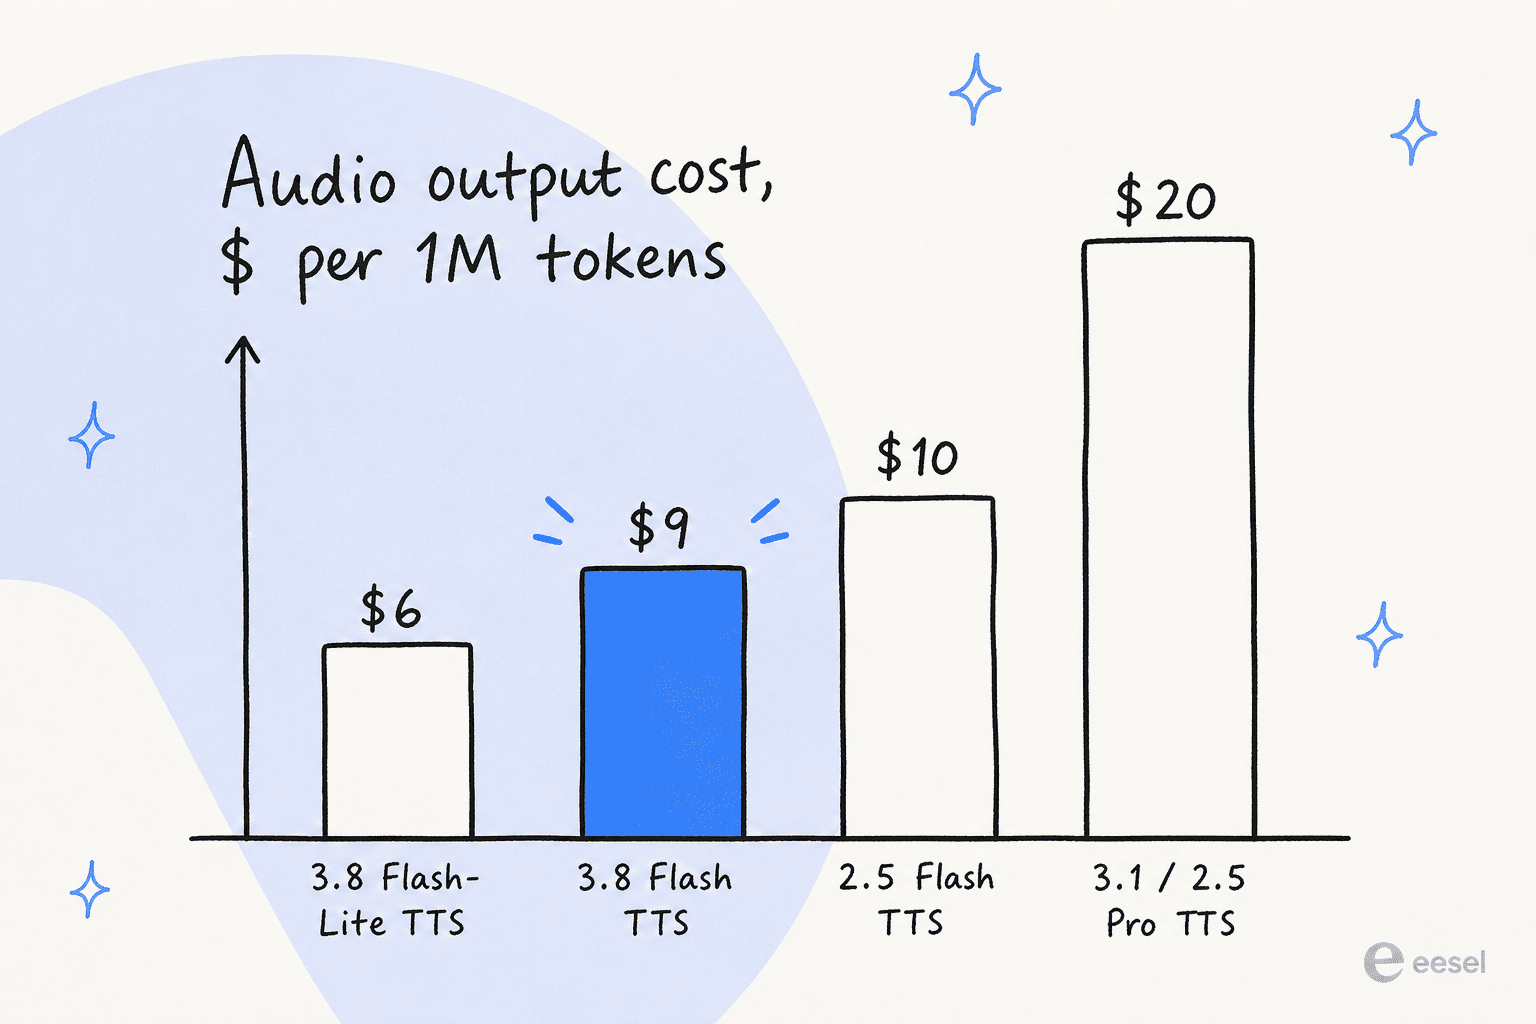
Ce qui est discrètement intéressant, c'est où se situent ces 9,00 $ dans la propre gamme de Google. C'est moins cher que le Gemini 2.5 Flash TTS qu'il remplace (10 $ en sortie audio), et moins de la moitié du prix des modèles en préversion 2.5 Pro et 3.1 Flash TTS (20 $ en sortie audio). Il existe aussi un cousin moins cher, Flash-Lite TTS, à 6 $ en sortie audio si vous pouvez vous contenter de 101 langues au lieu de 130.
Ce que cela coûte réellement
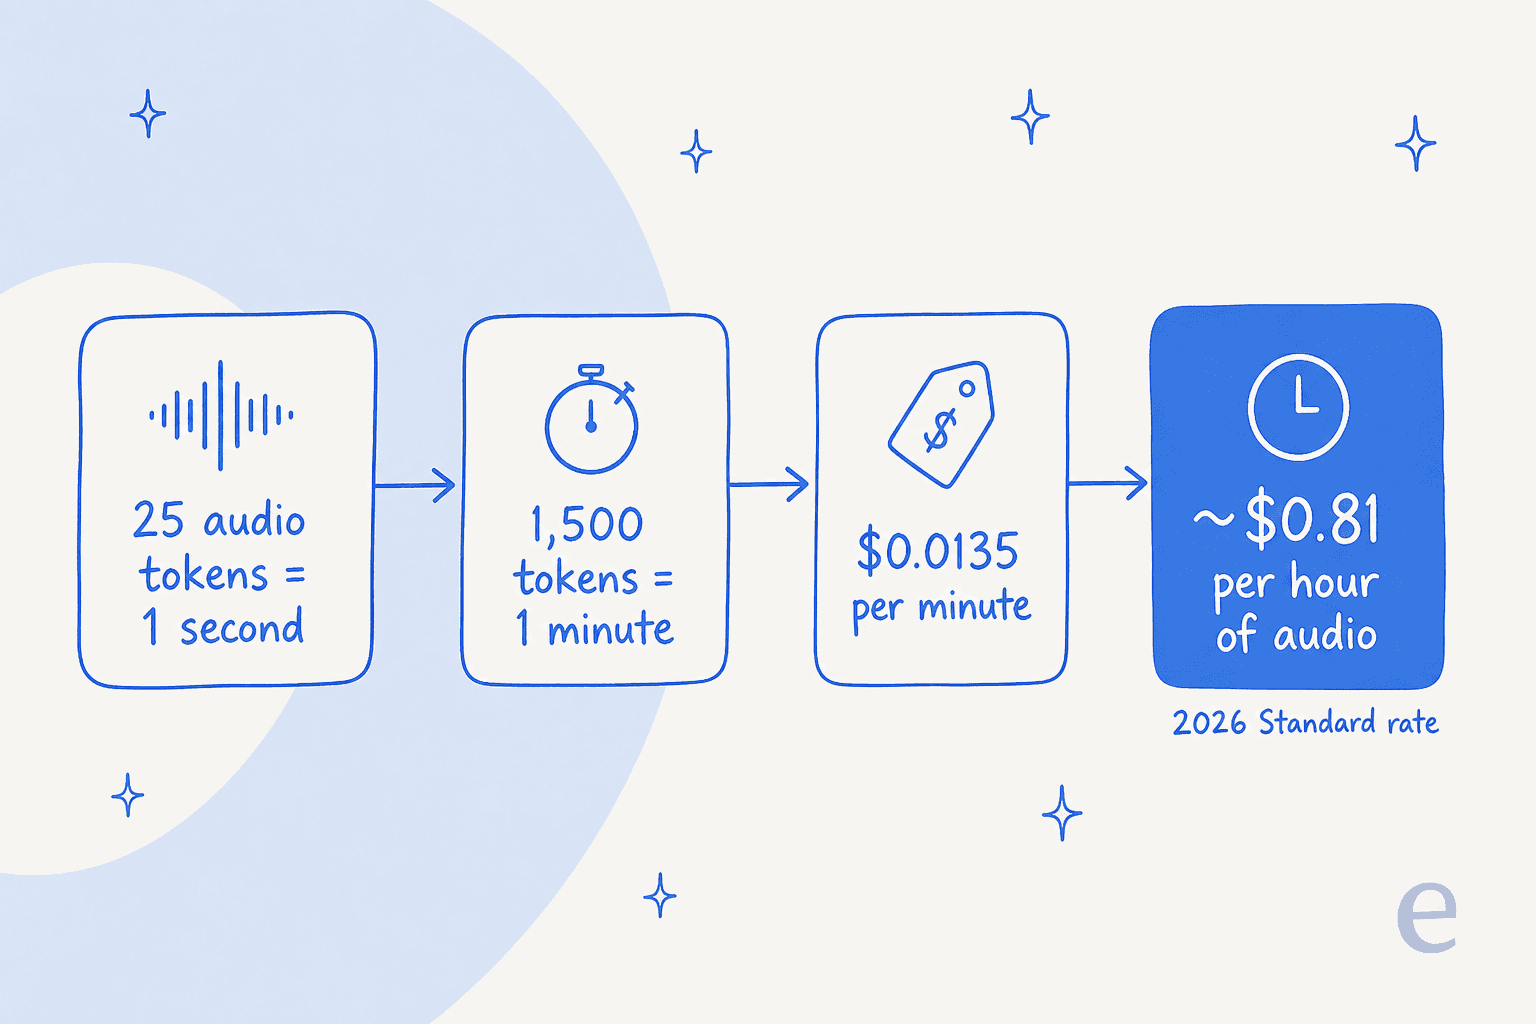
Le prix par token est difficile à ressentir concrètement, alors convertissons-le en argent réel. L'audio est facturé à 25 tokens par seconde, ce qui donne 1 500 tokens par minute et 90 000 tokens par heure. Au tarif standard 2026 de 9,00 $ par million, une heure de parole générée coûte environ 0,81 $. En ajoutant le texte fourni en entrée (une heure complète de narration ne représente qu'environ 12 000 tokens d'entrée), on ajoute bien moins d'un centime.
Quelques exemples concrets au tarif standard :
- Un épisode de podcast de 30 minutes : environ 0,41 $ d'audio.
- Un livre audio de 8 heures : environ 6,48 $.
- 10 000 messages SVI de support de 15 secondes chacun : 3,75 millions de tokens audio, soit environ 33,75 $.
En exécutant l'un de ces cas comme un job batch nocturne, vous divisez le coût par deux, ce qui rapproche le livre audio de 3,24 $. Pour une génération à fort volume et non interactive, le batch est le choix évident. Le seul endroit où le prix affiché ne raconte pas toute l'histoire, c'est tout ce qu'un humain attend en temps réel, où vous payez le tarif priority et supportez une latence que vous ne maîtrisez pas totalement.
Le piège : les prix doublent le 1er janvier 2027
Voici la partie à noter sur un post-it. Les chiffres de 0,50 $ et 9,00 $ sont des tarifs promotionnels de lancement. Le 1er janvier 2027, le texte en entrée standard passe à 1,00 $ par million et la sortie audio à 18,00 $ par million. Tous les autres paliers doublent au même rythme : sortie audio batch et flex à 9,00 $, sortie audio priority à 32,40 $.
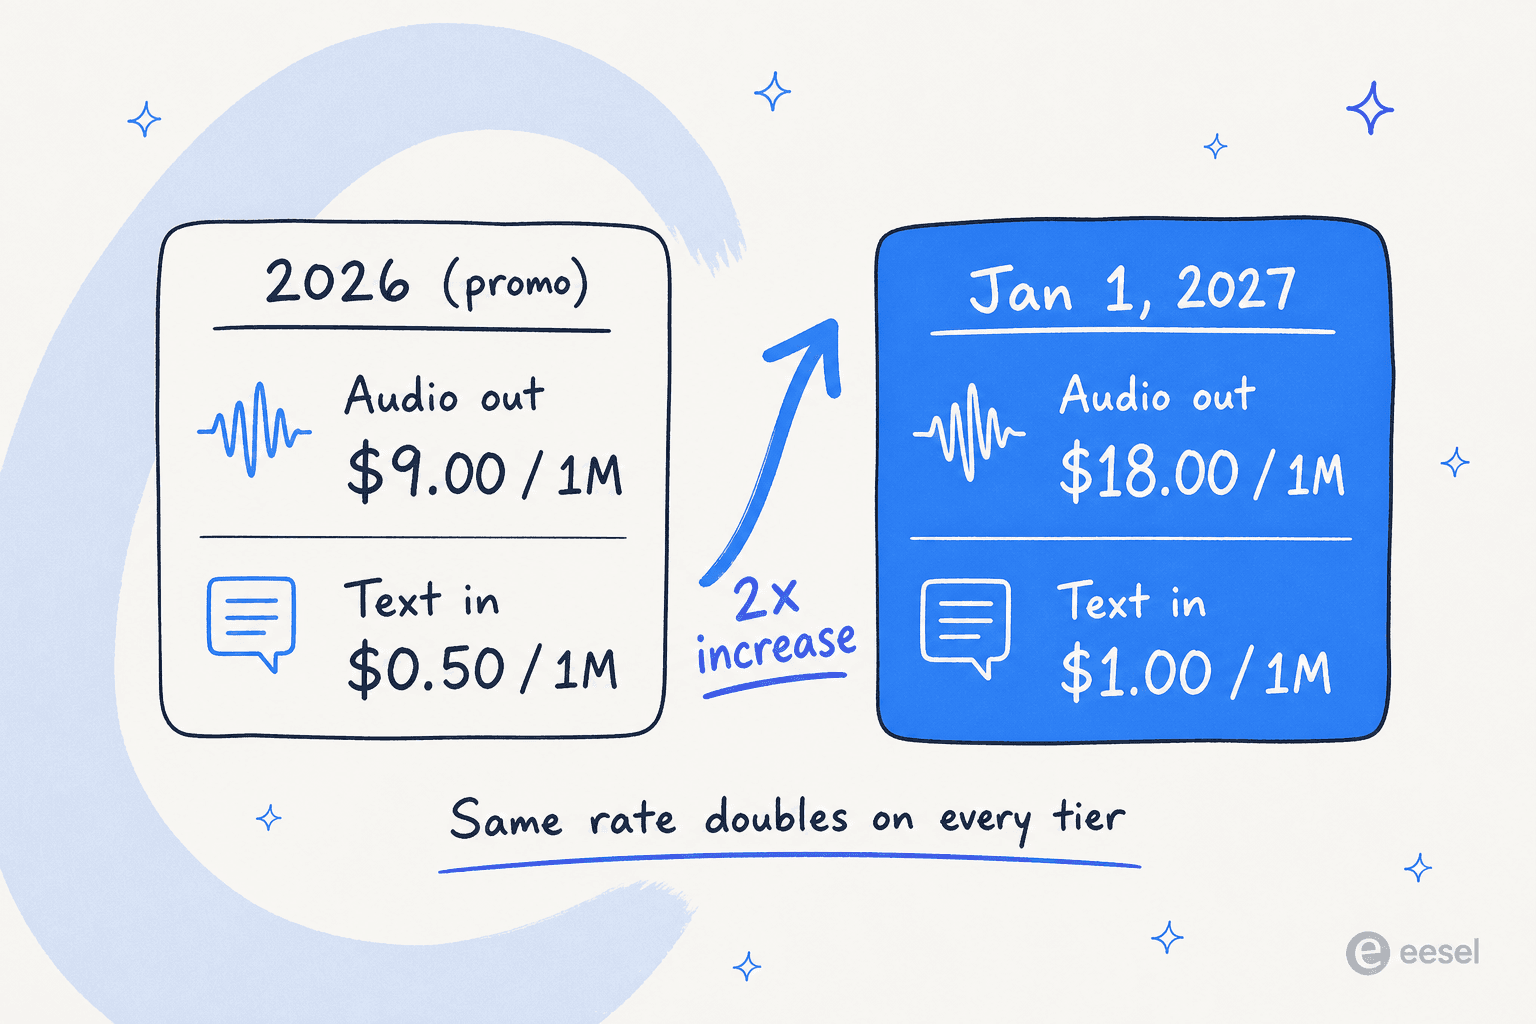
Cette heure d'audio à 0,81 $ passe donc à environ 1,62 $ en 2027, et le livre audio de 8 heures passe de 6,48 $ à 12,96 $. C'est exactement le même mouvement que Google a opéré sur les modèles texte, et c'est un mouvement raisonnable tant qu'on l'anticipe. Si vous budgétez au-delà de cette année, doublez les chiffres de cet article et planifiez à partir de là. C'est aussi une incitation à sécuriser dès maintenant toutes les économies de cache et de batch possibles.
Comparaison avec ElevenLabs, OpenAI et le reste
Comparer des modèles vocaux est vraiment délicat, car les fournisseurs ne facturent pas de la même façon. Amazon, Azure et Deepgram facturent au caractère de texte en entrée. OpenAI et Google facturent au token audio en sortie, qui évolue avec la durée de la parole générée, pas avec le script. ElevenLabs vend des crédits d'abonnement. Pour tout ramener sur un même axe, j'ai converti l'ensemble en coût estimé par heure de parole, en utilisant le repère propre d'Amazon selon lequel 1 million de caractères représentent environ 23 heures d'audio. Considérez les chiffres à l'heure comme des estimations, pas comme des conditions contractuelles, car ils varient avec le débit de parole.
| Fournisseur | Modèle phare | Prix natif | ~ $/heure d'audio | Palier gratuit |
|---|---|---|---|---|
| Gemini 3.8 Flash TTS | gemini-3.8-flash-tts | 9 $ / 1M tokens audio | ~0,81 $ | Gratuit sur AI Studio |
| Amazon Polly (Neural) | Neural | 16 $ / 1M caractères | ~0,70 $ | 1M caractères/mois (12 mois) |
| Azure AI Speech | Neural / HD Flash | 15 $ / 1M caractères | ~0,65 $ | 0,5M caractères/mois |
| OpenAI | gpt-4o-mini-tts | 12 $ / 1M tokens audio | ~0,90 $ | Aucun |
| Amazon Polly (Generative) | Generative | 30 $ / 1M caractères | ~1,30 $ | 100k caractères/mois |
| Deepgram | Aura-2 | 30 $ / 1M caractères | ~1,30 $ | 200 $ de crédit |
| ElevenLabs | Eleven v3 / Flash | ~5c/min (Business) | ~3,00 $ | 10k crédits/mois |
Ce qui m'a le plus surpris : Gemini 3.8 Flash TTS est tarifé comme une voix neuronale banale, alors qu'il fait partie des modèles génératifs les plus expressifs. Les lignes les moins chères d'Amazon et d'Azure correspondent à leurs anciennes voix neuronales ; leur palier de qualité générative (Polly Generative) est à 1,30 $ l'heure, et le modèle phare de Deepgram atterrit au même niveau. ElevenLabs, toujours la référence en matière de qualité vocale, coûte environ quatre fois plus cher à l'heure. Si le coût à l'heure est votre critère décisif et que vous voulez une sortie expressive, Gemini est difficile à battre en ce moment, du moins jusqu'à ce que le réajustement de 2027 le fasse monter à environ 1,62 $.
Pour le volet OpenAI de cette comparaison, mes articles sur l'API Realtime d'OpenAI et les prix de gpt-realtime-mini approfondissent les cas où la voix facturée au token a du sens.
La voix est-elle vraiment bonne ?
Le prix ne compte que si le résultat est exploitable, et c'est là que les premières réactions sont plus partagées. Le déploiement a suscité quelques critiques sur la qualité. Un développeur sur Hacker News l'a dit sans détour :
"I don't know, I guess their roll out is a bit sloppy. It's a bit of a shame, though, since the voices which are available all sound like generic Gemini voices to me. Nothing stands out."

C'est l'avis d'une seule personne, et la préférence vocale est subjective, mais cela correspond à une tendance : le TTS de Google est bon marché et large, tandis qu'ElevenLabs continue de remporter, pour beaucoup, le test du « cette voix précise sonne-t-elle remarquablement bien ». Certains utilisateurs s'en tiennent pour l'instant à ce qu'ils connaissent :
"For on the go, I've been using ElevenReader. Technically not free but their free tier has been plenty for me."
La lecture honnête est donc celle-ci. Si vous avez besoin d'une narration bon marché, multilingue et suffisamment bonne à grande échelle, Gemini 3.8 Flash TTS offre un excellent rapport qualité-prix. Si une voix unique, distinctive et qui incarne la marque est le produit lui-même, testez-la soigneusement face à ElevenLabs, et ne présumez pas que l'écart de prix se traduit par un écart de qualité en votre faveur.
Où un modèle vocal bon marché a sa place, et où il ne l'a pas
Voici le recadrage que j'aimerais qu'un acheteur retienne. Un modèle TTS est une infrastructure. C'est un moyen fantastique et bon marché de donner une voix à une application : un pipeline de livres audio, un narrateur intégré au produit, une couche d'accessibilité, des messages SVI. Pour cela, 0,81 $ l'heure est une excellente affaire.
Mais dès que le cas d'usage devient le service client, le modèle n'est que les 10 % faciles du problème. La partie difficile, c'est tout ce qui l'entoure : extraire la bonne réponse de votre base de connaissances, appeler les outils qui résolvent vraiment un ticket, et être testé sur votre historique réel avant de s'adresser à un client. C'est la différence entre une infrastructure et un employé. Gemini TTS relève de la première catégorie. Il ne connaîtra pas votre politique de remboursement et ne pourra pas trier un ticket, et assembler tout cela soi-même est un projet, pas un simple appel d'API.
C'est le cadre dans lequel nous travaillons chaque jour. Cela fait des années que nous mettons de l'IA sur des files de support réelles, et ce qui sépare une démo d'un déploiement réussi n'est jamais le modèle, c'est toujours la plomberie et les tests. C'est pourquoi un agent de support IA est un achat très différent d'un endpoint vocal, même quand les deux affichent « IA » sur l'étiquette. Si vous évaluez plus généralement le calcul humain contre automatisation, notre analyse du coût d'un agent IA face à un agent humain constitue un meilleur point de départ qu'un tarif au token.
Essayer eesel
eesel est une plateforme de coéquipiers IA, et l'effectif actuel inclut un agent de support IA prêt à l'emploi qui rejoint votre file de support existante. Là où Gemini TTS est un modèle autour duquel vous devez tout construire, eesel arrive en sachant déjà se connecter à votre helpdesk, apprendre de vos tickets passés, et être simulé sur de vraies conversations historiques afin que vous connaissiez son taux de résolution avant sa mise en production.

Si vous préférez travailler dans un terminal, la CLI eesel pilote ce même coéquipier et cet espace de travail de façon programmatique. Vous pouvez l'utiliser manuellement, l'intégrer dans des scripts, ou laisser un agent de codage comme Claude Code ou Cursor l'exécuter sans interface, de sorte que l'IA que vous achetez soit disponible à la fois depuis le tableau de bord et via l'API, tout comme vous le feriez avec un modèle comme Gemini TTS. Vous pouvez essayer eesel gratuitement et le simuler d'abord sur vos propres tickets.
Questions fréquentes
Combien coûte Gemini 3.8 Flash TTS ?
Existe-t-il un palier gratuit pour Gemini 3.8 Flash TTS ?
Pourquoi le prix de Gemini 3.8 Flash TTS double-t-il en janvier 2027 ?
Gemini 3.8 Flash TTS est-il assez bon pour la voix du service client ?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.







Comment les prix de Gemini 3.8 Flash TTS se comparent-ils à ElevenLabs ?