

Gemini 3.7 Flash est un très bon modèle qui a discrètement cessé d'être bon marché. Rapide, oui. Artificial Analysis le mesure à 340.1 tokens par seconde, le plus rapide qu'ils suivent actuellement. Il est sorti en disponibilité générale le 13 août 2026. Le prix au lancement était de $0.75 par million de tokens en entrée et de $3.75 par million en sortie.
Puis le piège, et il se trouve dans la grille tarifaire, pas dans un graphique de benchmark. Ce prix est un tarif de lancement. Le 1er janvier 2027, il double, à $1.50 et $7.50. Par ailleurs, le niveau de réflexion minimal a disparu, celui qui rendait les anciens modèles Flash viables pour la classification à gros volume, donc low devient votre plancher le moins cher. Et les tokens de réflexion sont facturés au tarif de sortie, alors que ce qui vous revient n'en est qu'un résumé.
Je construis les intégrations et la plomberie des modèles chez eesel. Nos agents tournent sur des helpdesks en production avec de vrais volumes, et un client fait passer plus de 100 000 tickets par mois en allemand par Zendesk. Ce travail m'a rendu allergique au choix d'un modèle sur la foi d'un tableau de benchmarks. Donc : pour le code, le travail d'agent et le travail sur documents, la 3.7 est une vraie amélioration. Mais si vous aviez choisi Flash à l'origine parce que c'était le palier économique, la 3.7 n'est pas votre chemin de mise à niveau, et la grille tarifaire de Google me donne discrètement raison.
Ce qu'est réellement Gemini 3.7 Flash
Gemini 3.7 Flash est le modèle de travail le plus récent de la gamme Gemini AI. Il sort sous le nom gemini-3.7-flash et il est indiqué GA plutôt que preview. La formule de Google est sans détour : "our most intelligent workhorse model yet for coding and agents."
Il offre une fenêtre de contexte de 1M de tokens avec un plafond de sortie de 64k. L'entrée peut être du texte, de l'image, de la vidéo, de l'audio et du PDF, mais la sortie reste uniquement du texte. Six surfaces l'ont en production, dont AI Studio et la Gemini API, ainsi que Google Antigravity, où il est désormais le modèle par défaut derrière l'agent Antigravity.
Un élément de contexte compte pour lire tout ce qui suit. Il n'existe actuellement aucun Gemini 3 Pro stable. gemini-3-pro-preview est indiqué comme arrêté, et le seul Pro restant dans la liste est la 3.1 Pro en preview, ce qui change réellement la forme du lancement de Gemini 3. Flash porte donc plus de poids dans la gamme que ne le ferait normalement un modèle avec "Flash" dans son nom, et cela explique beaucoup de choses sur son positionnement et son prix.
L'API a plus changé que le modèle
C'est la partie qui vous coûtera réellement un après-midi, et presque personne ne la met en avant.
Si vous migrez depuis Gemini 3.5 Flash, Gemini 3 Flash Preview ou Gemini 3.1 Pro, la liste de migration de Google vous dit de supprimer temperature, top_p, top_k et candidate_count, de remplacer le thinking_budget numérique par une chaîne thinking_level, de retirer les tours du modèle préremplis et de déplacer l'historique multi-tours vers un previous_interaction_id côté serveur. Gemini 3.6 Flash avait déjà abandonné les paramètres d'échantillonnage, donc passer de la 3.6 à la 3.7 est presque gratuit. Pour tous les autres, le grand nettoyage.
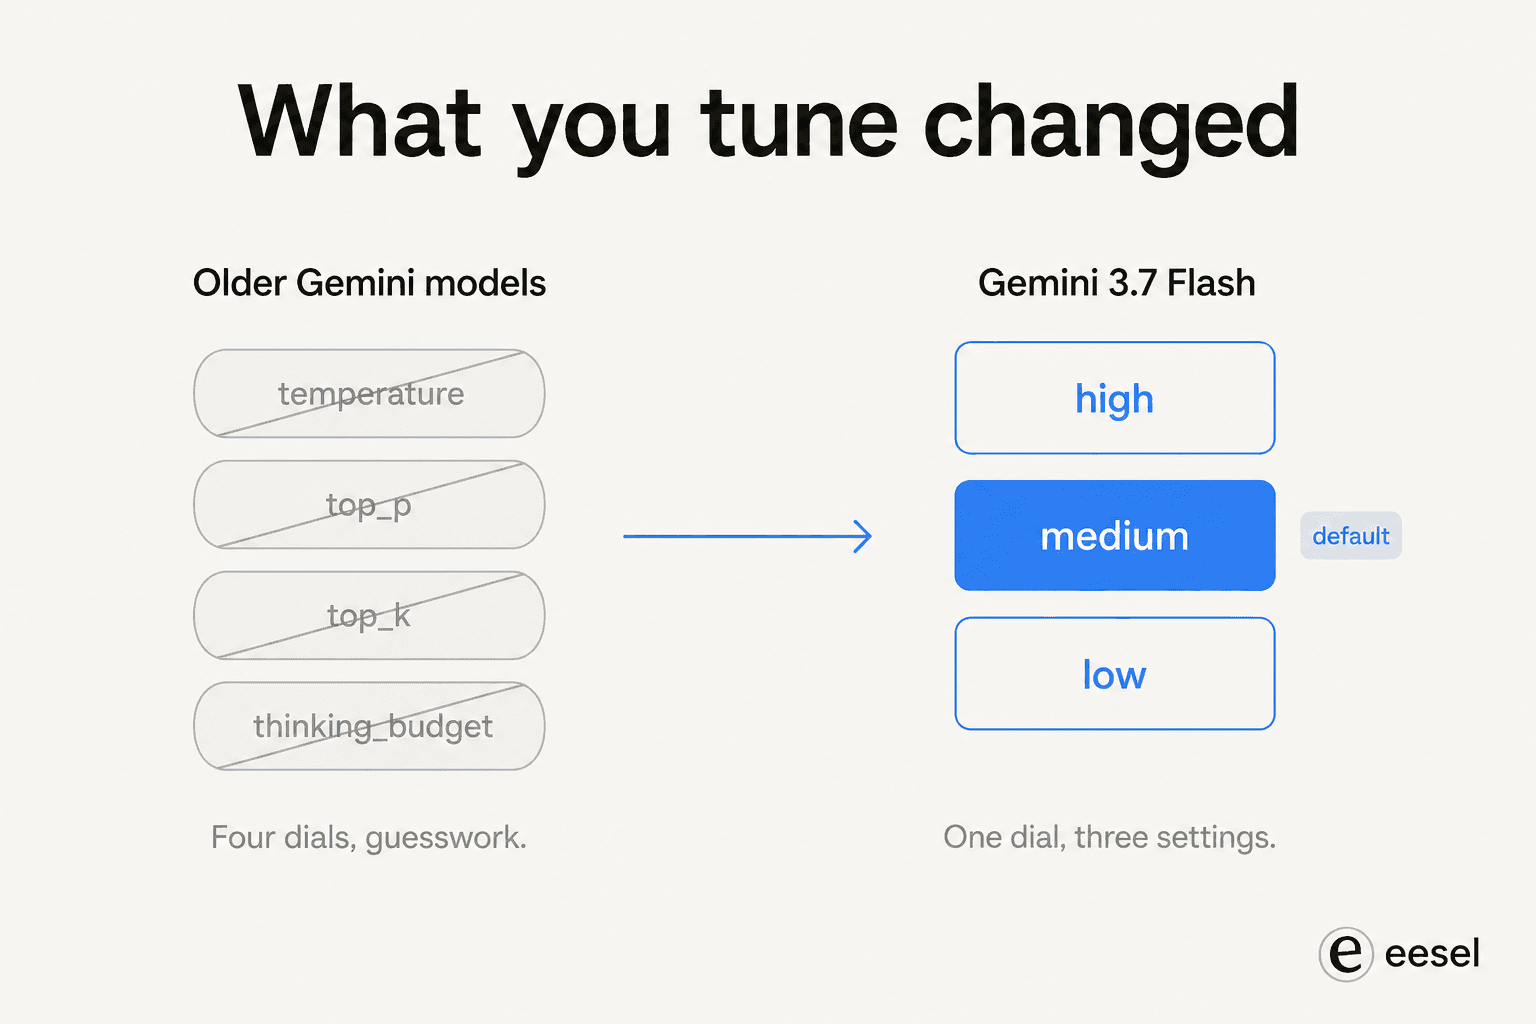
À la place de quatre boutons, vous en avez maintenant un, avec trois réglages, qui se définit dans generation_config :
| Niveau | Usage indiqué par Google | Profil de coût |
|---|---|---|
low | Travail à latence critique : réponse aux incidents, chat en temps réel, brouillons, analyse rapide de données | Plancher le moins cher disponible |
medium (par défaut) | Code complexe et usage agentique, avec une meilleure précision du premier coup | Par défaut si vous ne réglez rien |
high | Maths difficiles, tâches de code et d'agent les plus dures, usage prolongé d'outils | "Higher token consumption and cost" |
Voici la régression que personne n'a mise dans un communiqué de presse. Gemini 3.6 Flash, 3.5 Flash, 3.5 Flash-Lite et 3 Flash Preview acceptent tous un quatrième niveau, minimal. Gemini 3.7 Flash ne l'accepte pas. Dans un fil de lancement de 347 commentaires, Simon Willison a été la seule personne à le signaler :
"The 'introductory pricing' for this 3.7 Flash model is really weird.
It's scheduled to double in price on December 31, 2026, but who would anticipate still using this model five months from now? Especially since 3.6 Flash came out just three weeks ago!"

Perdre minimal compte plus qu'il n'y paraît. Si vous utilisiez Flash pour de l'OCR et de l'étiquetage, ou pour la classification de tickets, minimal était le réglage qui rendait l'équation économique viable. low est un vrai plancher. Mais ce n'est pas le même plancher.
L'autre changement discret : chaque exemple de code de la page utilise maintenant l'Interactions API, passée en GA en même temps que le modèle, au lieu de generateContent. Bon à savoir avant de copier un extrait dans une base de code construite sur l'ancienne forme.
À quelle vitesse il va, et comment cette vitesse se répartit
La vitesse est le domaine où 3.7 Flash reste incontesté. Artificial Analysis le chronomètre à 340.1 tokens de sortie par seconde, premier sur les 188 modèles qu'ils suivent, contre une médiane de classe de 68.6. L'Intelligence Index atteint 56, dix-septième sur 188, bien au-dessus de la médiane de classe de 34.
Les chiffres en conditions réelles sont moins flatteurs, et plus utiles. OpenRouter affiche un P50 de 93 tokens par seconde avec 1.85 seconde de latence. La répartition par fournisseur est nette : Google AI Studio sert 124 tokens par seconde à 1.74 seconde, là où Vertex atteint 84 à 2.02 secondes.
Le temps jusqu'au premier token est le point faible, et il dépend entièrement du niveau de réflexion choisi. Artificial Analysis mesure une médiane de 9.83 secondes jusqu'au premier token en effort high, avec un p95 de 49.5 secondes, contre une médiane de classe de 2.88. En low, il tombe à 0.74 seconde. C'est la différence entre une latence interactive utilisable et une latence dont vos utilisateurs se plaindront.
Ce qui fait ressortir la découverte la plus pratique de tout le jeu de données :
| Niveau de réflexion | Intelligence Index | Temps jusqu'au premier token | Coût par tâche de benchmark |
|---|---|---|---|
high | 56.0 | 9.83s | $0.40 |
medium | 53.5 | 4.22s | $0.26 |
low | 50.9 | 0.74s | $0.16 |
En effort low, il marque encore 50.9, à moins d'un point de Gemini 3.6 Flash à plein effort high, pour 40 % du coût par tâche et environ un treizième de l'attente. Donc si vous migrez depuis 3.6 Flash et laissez le réglage par défaut sur medium, vous payez probablement pour un raisonnement dont vous n'aviez pas besoin.
Le plus étrange, c'est que 93.1 % du trafic d'OpenRouter va vers Vertex, le point d'accès le plus lent, parce que celui-ci porte une remise de plateforme de 50 %. Les gens sacrifient la latence au prix, ce qui dit pour quoi ils achètent réellement ce modèle.
Il y a aussi un solide contre-argument à toute l'histoire de la vitesse, et il arrive avec des chiffres. Artificial Analysis a mesuré qu'avec un raisonnement élevé, 3.7 Flash augmente la consommation de tokens d'environ 40 % par rapport à 3.6 Flash, avec une moyenne de 37k tokens de sortie par tâche. Tokens par seconde et temps jusqu'à la réponse ne sont pas la même chose :
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens. And that's with Sol high being a substantially better model."
Cette hausse de 40 % des tokens est une hausse de prix qui porte un badge de vitesse. La grille tarifaire n'a pas bougé. Ce qui a bougé, c'est le nombre de tokens de sortie facturables par tâche, et les tokens de réflexion s'y ajoutent aussi au tarif de sortie. Gardez-le en tête pour le calculateur ci-dessous.
Les benchmarks, y compris ceux que Google n'a pas mis en avant
Google a publié une comparaison de 21 lignes face à Gemini 3.6 Flash, Claude Sonnet 5, GPT-5.6 Terra et Muse Spark 1.2. À leur crédit, ils ont aussi publié les défaites. Voici les lignes qui comptent le plus :
| Benchmark | Gemini 3.7 Flash | Gemini 3.6 Flash | Claude Sonnet 5 | GPT-5.6 Terra | Muse Spark 1.2 |
|---|---|---|---|---|---|
| Prix d'entrée, $/1M | $0.75 | $0.75 | $2.00 | $2.00 | $1.25 |
| Prix de sortie, $/1M | $3.75 | $3.75 | $10.00 | $12.00 | $4.25 |
| AA Intelligence Index | 56 | 52 | 55 | 57 | 57 |
| FrontierCode 1.1 Main | 43.6% | 34.4% | 42.7% | 41.3% | - |
| DeepSWE v1.1 | 65.3% | 48.6% | 53.8% | 69.6% | 54.9% |
| Code Arena (Elo) | 1588 | 1538 | 1541 | 1523 | 1535 |
| Terminal-bench 2.1 | 85.8% | 78.0% | 80.4% | 87.4% | 82.9% |
| Terminal-bench 3.0 | 14.9% | 5.4% | 14.6% | 20.8% | - |
| AutomationBench (privé) | 30.4% | 17.0% | 10.7% | 23.6% | - |
| GDPVal-AA v2 (Elo) | 1525 | 1422 | 1598 | 1578 | 1628 |
| Harvey LAB-AA (juridique) | 90.7% | 85.1% | 90.1% | 85.2% | - |
| GDP.pdf (compréhension de PDF) | 34.0% | 22.0% | 28.0% | 24.7% | 16.0% |
| CharXiv Reasoning (sans outils) | 84.5% | 85.2% | 77.0% | 85.9% | - |
| CharXiv Reasoning (avec outils) | 88.7% | 89.4% | 88.3% | - | - |
| LVBench (vidéo longue) | 85.4% | 84.2% | 68.5% | 78.9% | - |
| GDM-MRCR v2 @128k | 97.0% | 91.8% | 81.5% | 93.5% | - |
| OSWorld-2.0 (utilisation d'ordinateur) | 47.9% | 33.8% | - | 50.2% | - |
| HLE-Verified | 53.6% | 51.2% | 31.0% | 51.1% | - |
Quelques lectures honnêtes de ce tableau.
Les sauts par rapport à son propre prédécesseur sont grands et réels. DeepSWE passant de 48.6% à 65.3%, et AutomationBench de 17.0% à 30.4%, ce ne sont pas des arrondis. Le texte de Google cite lui-même DeepSWE à 49.0% plutôt que 48.6% pour 3.6 Flash, un petit écart entre le texte et le graphique, même si le sens ne fait aucun doute.
GPT-5.6 Terra reste maître du travail agentique en terminal. Terminal-bench 2.1, Terminal-bench 3.0, DeepSWE et OSWorld-2.0 vont tous à Terra. Si votre charge est un agent de code au long cours qui mâche un vrai dépôt, ce sont quatre benchmarks sur quatre qui comptent, et c'est la raison pour laquelle plusieurs personnes sur Hacker News ont lu celui-ci comme un concurrent de Terra plutôt que comme un choix économique.
Il a perdu deux lignes face à Gemini 3.6 Flash. Toutes deux sont du raisonnement sur graphiques CharXiv, 84.5 contre 85.2 sans outils et 88.7 contre 89.4 avec. Petit. Mais cela veut dire que "3.7 bat 3.6 sur tout" n'est pas vrai, et si les graphiques sont votre charge de travail, vérifiez-le avant de migrer.
Il y a un chiffre de plus qui n'apparaît que dans les tests indépendants. Artificial Analysis mesure un taux d'hallucination de 64.5% pour 3.7 Flash contre 55.6% pour 3.6 Flash. La précision a augmenté, et l'hallucination a augmenté avec elle.
Pour être juste envers Google, ce chiffre paraît très différent selon la référence retenue. Un lecteur qui épluchait les mêmes données sur Reddit l'a replacé dans un contexte plus large :
"Flash 3 had 93 % hallucination but also very good world knowledge. 3.7 Flash has 65 %. This is a considerable improvement but it still lacks behind 3.1 Pro. […] Both Gemini Flash and GPT Sol are very good at getting the right answer, better than all other models except Claude Fable and Opus. It's just that when they don't get it right hallucination is likely or almost guaranteed."

Donc : bien meilleur que Flash 3. Légèrement moins bon que le modèle qu'il remplace directement, et toujours derrière 3.1 Pro. Ce dernier point est celui qui compte, et je reviens plus loin sur la raison pour laquelle il m'empêche de dormir.
Deux réserves sur les sources. Artificial Analysis n'a pas de score 3.7 Flash pour SWE-Bench Verified, AIME, LiveCodeBench ou MMLU-Pro, donc tout chiffre qui circule pour ceux-là vient du graphique de Google et non d'une exécution indépendante. De plus, la fenêtre de contexte diffère selon les sources : Artificial Analysis indique 1,000,000 là où la fiche Vertex de Google indique 1,048,576.
Ce que ça coûte, et la date à laquelle ce prix s'arrête
Le titre dit $0.75 par million de tokens en entrée et $3.75 par million en sortie. L'astérisque est toute l'histoire.
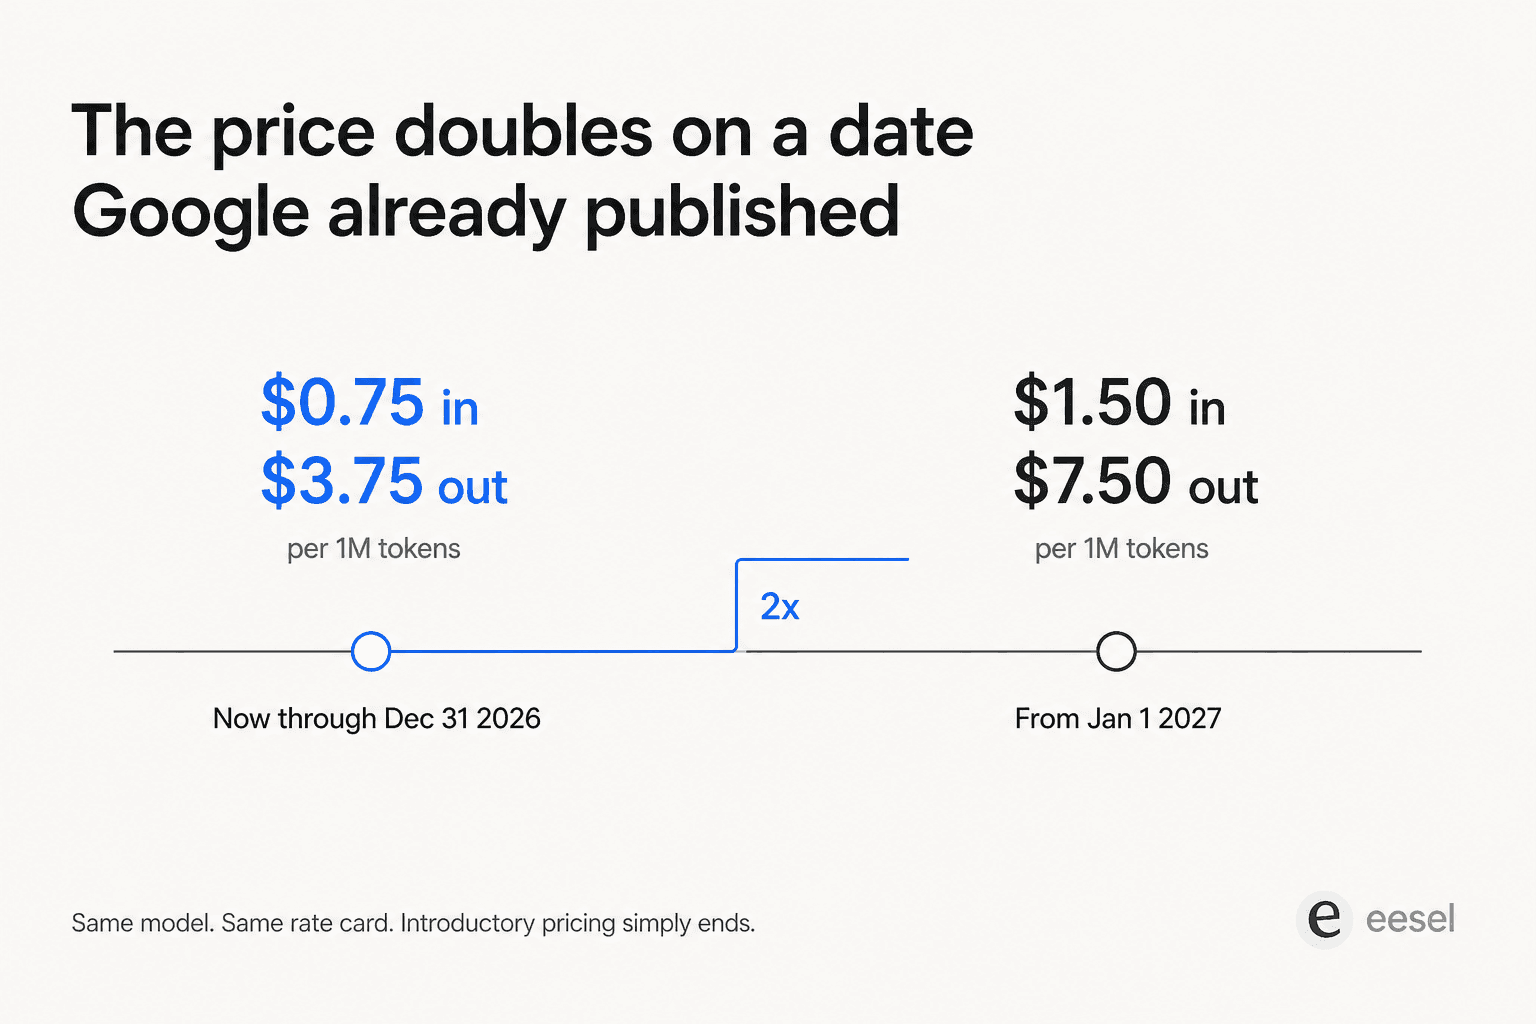
Voici la grille tarifaire complète, tirée de la page de tarifs de Google :
| Poste | Jusqu'au 31 déc. 2026 | À partir du 1er janv. 2027 |
|---|---|---|
| Entrée, par million de tokens | $0.75 | $1.50 |
| Sortie (réflexion incluse), par million | $3.75 | $7.50 |
| Mode batch entrée / sortie | $0.375 / $1.875 | $0.75 / $3.75 |
| Mode Flex | Identique au batch | Identique au batch |
| Mode Priority | $1.35 / $6.75 | $2.70 / $13.50 |
| Lecture du cache de contexte, par million | $0.075 | $0.15 |
| Stockage du cache de contexte, par million et par heure | $0.50 | $1.00 |
| Google Search grounding | 5,000 requêtes gratuites par mois sur tous les modèles 3.x, puis $14 pour 1,000 | Identique |
Quelques points à relever. Il n'y a aucun palier de prix selon la longueur du contexte, donc un prompt de 900k tokens coûte le même prix par token qu'un de 900, contrairement à 3.1 Pro Preview. Il n'y a aucune surtaxe de modalité non plus : l'entrée audio et vidéo est facturée au même tarif que le texte, alors que 3 Flash Preview facture le double pour l'audio. Et le grounding est devenu bien moins cher au fil de la génération 3.x, passant de $35 pour 1,000 requêtes à $14.
Ce qui paraît étrange, c'est que Gemini 3.6 Flash est désormais au même prix que 3.7 Flash, même tarif de lancement et même échéance, et le même prix standard ensuite aussi. Le texte de Google décrit 3.7 Flash comme coûtant environ la moitié du 3.6 Flash d'origine, vrai par rapport au prix catalogue, faux par rapport à ce que 3.6 Flash vous coûte aujourd'hui. Il n'y a pas de surcoût sur le modèle récent, ce qui signifie surtout qu'il n'y a aucune raison de rester sur 3.6, sauf si CharXiv ou minimal sont essentiels pour vous. Notre détail des tarifs de 3.6 Flash reste valable, puisque c'est maintenant la même grille.
Saisissez ici votre propre volume :
Vous payez pour une réflexion que vous ne voyez jamais
C'est le poste qui surprend les gens, et il est énoncé clairement dans la documentation thinking de Google : "When thinking is turned on, response pricing is the sum of output tokens and thinking tokens."
Puis la phrase plus tranchante, quelques paragraphes plus bas : "Pricing is based on the full thought tokens the model needs to generate, despite only the summary being output from the API."
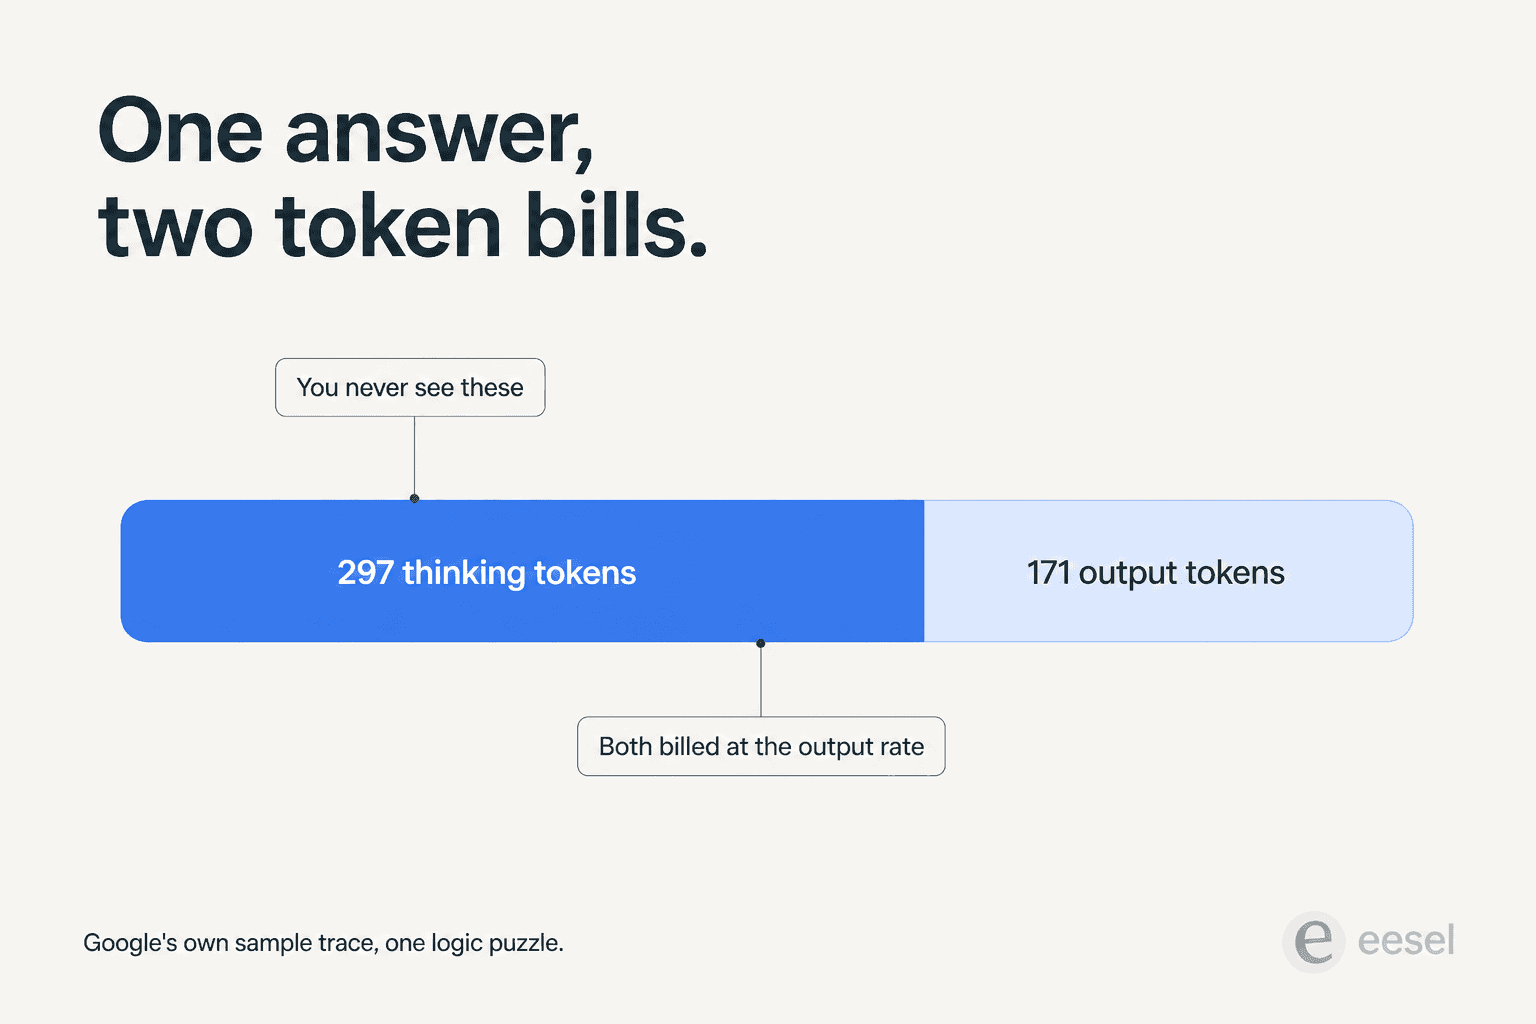
La trace d'exemple de Google sur une énigme logique à trois indices dépense 297 tokens de réflexion contre 171 tokens de sortie. Près des deux tiers de la facture de sortie de cette réponse étaient donc un raisonnement que l'appelant ne reçoit jamais, seulement un résumé. Le compte est exposé sous usage.total_thought_tokens, on peut donc le mesurer, mais il faut aller le chercher. Si vous faites tourner plusieurs modèles côte à côte, c'est exactement le genre de chose que les outils de suivi de LLM servent à détecter.
Multipliez cela sur une charge de production et le fait que medium soit le réglage par défaut devient une vraie décision plutôt qu'un haussement d'épaules. C'est aussi la raison pour laquelle le curseur de surcharge de réflexion du calculateur ci-dessus est réglé sur 75 % et non sur zéro.
Certains développeurs trouvent l'approche par résumé pire qu'inutile. Extrait du fil de lancement :
"I really, really like DSv4 Flash because you see the full, real thinking text. That's been so useful for helping steer the model; as well as seeing its thoughts and correcting any errors, or expanding on it. It's so difficult for me to use closed models with no or summarised thinking now."
Ce que disent réellement les développeurs
Le fil de lancement a atteint 621 points et 347 commentaires en environ huit heures, et sa forme est plus intéressante que son score.
Le chiffre le plus cité de tout le fil se trouve être le prix d'un concurrent :
"Ever since the insane discount with GPT-5.6 Luna, not much excites me anymore. I mean just look at the benchmarks, even though Gemini 3.7 Flash performs well on the DeepSWE 1.1, Luna (Max) still performs way better.
> Starting January 1, 2027, $1.50/1M input tokens and $7.50/1M output tokens will apply.
Compare this to Luna which is at $0.2/1M input ($0.02 cached) and $1.2/1M output."
La correction de positionnement est arrivée quelques commentaires plus tard, et c'est la chose la plus utile de tout le fil :
"They need to release benchmarks against Luna/Terra. Luna is much cheaper which feels like it undercuts the need for Flash.
I've always considered the Flash series of models to be for low-cost, high-volume, mostly text-based use cases (e.g. summarization, parsing, formatting), emphasis on low-cost."
C'est le recadrage. Flash ne concurrence plus le bas du marché ; c'est Flash-Lite qui le fait. Si vous aimiez Flash parce qu'il était bon marché, le modèle que vous voulez réellement ensuite se trouve un palier plus bas, ou entièrement hors de la famille Google.
Les endroits évidents où regarder sont Qwen et Kimi. Si vous cherchez un hébergeur occidental pour un budget similaire, Mistral est la comparaison la plus proche.
Le verdict pratique le plus tranchant est venu d'un test image vers HTML mené dans opencode, opposant 3.7 Flash à Claude Opus 5 et à Grok :
"It's not a bad model by any means, but I just don't know what situation I'd reach for 3.7 Flash first for. Google really needs a differentiator, especially given how hard it is to get an API key from them. They can't be high friction and non-pareto."
Cette dernière proposition a ouvert le plus gros sous-fil de la journée, et le modèle n'en était pas du tout le sujet. Le sujet était de savoir si l'on peut acheter chez Google. Un commentateur a signalé le message d'erreur "Failed to create project, The request is suspicious. Please try again" sur une clé neuve ; un autre a signalé la même chose sur un compte Cloud vieux de dix ans, qui n'a fonctionné que deux jours plus tard. Le plus douloureux sur le plan opérationnel :
"There are places where you CAN set a limit. This seems great until you are at the center of a huge traffic spike because of good pr and so you try to change it to a larger number only to be told you need to wait 24 hours for the setting to change.
Biggest traffic day of the decade and our site was down because of google."
Pour être équitable, cela est contesté plus bas dans le fil. Un commentateur a créé une clé sur un compte neuf en deux clics et sans quitter la page, et Google propose désormais des plafonds de dépenses sur la Gemini API. La friction est donc réelle pour certains et inexistante pour d'autres, ce qui est un problème en soi. En contraste, les limites de débit d'OpenAI et les tarifs de l'API GPT-5 Pro sont documentés de telle façon que la plupart des gens s'en sortent sans un seul ticket de support.
Là où Flash gagne encore haut la main
La vision et les documents. C'est le seul axe sur lequel même les critiques du fil ont concédé le point.
Revoyez le tableau des benchmarks : GDP.pdf à 34.0% contre 24.7% pour Terra, LVBench à 85.4% contre 68.5% pour Sonnet 5, puis le test de l'aiguille à 128k à 97.0%. Cela forme un tableau cohérent et non trois lignes chanceuses. Un commentateur a exprimé la version pratique mieux que n'importe quel benchmark, en décrivant Gemini qui a correctement diagnostiqué un problème de plante à partir d'une photo, après qu'un modèle orienté texte s'était trompé.
"That's been my association as well. I see Flash get brought up a lot in relation to things like OCR and PDF processing frequently, and a lot of other routine multimodal workloads."
Il y a aussi un argument d'échelle, et il m'a surpris :
"did you try to ingest 1M documents per hour with any provider except GCP with Flash? None work at scale. Deepseek, Luna, Mistral all fail. 1 in 3 requests is a fail. I stopped trying. The only thing that works at scale is gemini flash."
Bon marché au token et fiable à grand volume sont deux choses différentes, et c'est une distinction que les fils de comparaison de prix omettent la plupart du temps.
Les clients cités par Google aboutissent au même constat. Gregor Zunic, cofondateur de Browser Use, rapporte que l'agent était "35% cheaper than 3.6 Flash, with a +8% observed prompt-cache hit rate and fewer tool errors." Il faut lire cela comme une dépense totale et non comme une grille tarifaire, car les deux modèles sont facturés à l'identique aujourd'hui ; l'économie vient des succès de cache et de moins d'appels d'outils relancés. Niko Grupen, de Harvey, rapporte +2.6 points all-pass sur leur Legal Agent Bench. Kyrill Hux, de Nunu.ai, le qualifie de comparable à GPT-5.6 Terra "at around half the cost." Ce sont des citations fournies par le fournisseur sur une page de lancement, pondérez-les en conséquence.
La lecture tierce la plus utile est venue de Cognition, qui l'a intégré dans Devin puis a été précis sur l'endroit où il s'insère :
"On FrontierCode 1.1, it reaches Claude Sonnet 5-level performance at less than half the cost, with the low latency the Flash series is known for. […] Within Devin, Gemini 3.7 Flash performs particularly well on tightly scoped refactors, where it delivers minimal diffs that match repo conventions."
"Tightly scoped refactors" est une frontière précise et honnête, et elle correspond à ce que disent les benchmarks d'agents en terminal sur le bout long.
Qui devrait utiliser Gemini 3.7 Flash, et qui non
Prenez-le si vous faites de l'extraction de documents, du travail sur PDF et graphiques, de la récupération en contexte long, de la compréhension vidéo ou de la génération de code web et d'interface à partir de maquettes. Les 1588 Elo de Code Arena sont le meilleur score du tableau de Google, et les benchmarks de documents ne sont pas serrés. C'est aussi le bon choix si vous êtes déjà sur Antigravity, puisque c'est désormais le modèle par défaut là-bas.
Passez votre tour si votre charge est un agent de code en terminal au long cours, où GPT-5.6 Terra remporte ces quatre benchmarks qui mesurent exactement cela. Passez aussi votre tour si vous êtes venu à Flash pour le plancher de prix. Entre la perte de minimal, les tokens de réflexion facturés comme de la sortie et un tarif qui double en janvier, l'argument du palier économique s'est discrètement déplacé vers Flash-Lite et vers des concurrents d'un ordre de grandeur plus bas sur la sortie.
Attendez si vous êtes sur 3.6 Flash et que le raisonnement sur graphiques de type CharXiv est essentiel pour vous. Vous paieriez le même prix pour deux lignes de benchmark qui se dégradent légèrement.
Si vous pesez encore le secteur, les comparatifs qui valent votre temps sont les alternatives à Gemini, les alternatives à Gemini 3 et les alternatives à Claude.
Côté outillage, le modèle compte moins que l'environnement dans lequel vous le faites tourner. La plupart de ceux qui lisent ceci rencontreront 3.7 Flash via un éditeur et non via un appel d'API brut, et nos notes sur les meilleurs assistants de code IA, les CLI de code agentique et les tarifs de Cursor couvrent cette couche.
Ce que cela signifie si vous mettez un modèle sur une file de support
Revenons au chiffre d'hallucination, car c'est ici que commence mon travail quotidien.
Artificial Analysis mesure Gemini 3.7 Flash à 64.5 % d'hallucination, contre 55.6 % pour 3.6 Flash. La précision s'est améliorée, et l'hallucination s'est aggravée, en même temps. Cette combinaison n'est pas une contradiction ; c'est la forme normale d'un modèle réglé pour s'engager sur des réponses plutôt que pour se couvrir. Excellent pour un agent de code qu'un compilateur peut corriger. Un risque quand la sortie part directement chez un client.
Quelqu'un qui fait tourner exactement cette charge en production a tracé la frontière mieux que je ne saurais le faire :
"Yeah we use it for auto-triage of incidents, attempts to auto-remediate, and escalation to human. But for actual development, it's not a viable option for us."
Tri, puis tentative, puis escalade. C'est la bonne forme, et notez que l'humain y est la dernière étape et non une réflexion après coup.
Nous faisons tourner des agents IA sur des helpdesks en production depuis des années, avec de vrais volumes, dont un prêteur qui fait passer plus de 100 000 tickets par mois en allemand par Zendesk et une équipe e-commerce qui traite plus de 50 000 par mois sur Freshdesk. Ce que cette expérience enseigne, c'est qu'un score de benchmark ne dit presque rien sur le comportement d'un modèle sur vos tickets. Deux équipes sur le même modèle, le même helpdesk et le même secteur obtiennent des réponses différentes, parce que leurs bases de connaissances n'ont pas la même forme.
Le choix du modèle compte donc moins que ce qui l'entoure. Une récupération qui trouve réellement le bon document, et c'est un problème de RAG plutôt qu'un problème de modèle. Un routage par confiance, pour qu'une réponse à faible confiance devienne un brouillon plutôt qu'un envoi. Et puis une répétition sur votre propre historique de tickets, avant qu'aucun client ne voie un seul mot, l'étape que la plupart des déploiements d'automatisation du support sautent.
Remarquez qu'aucun de ces éléments n'est le modèle lui-même. La plupart des raisons pour lesquelles un chatbot IA répond mal sont des défauts de contenu et de récupération, et non un modèle pas assez malin, et corriger la base de connaissances fait généralement plus bouger le chiffre que de passer à ce qui est sorti cette semaine.
Ce dernier point est tout l'argument. On ne peut pas lire un taux d'hallucination de 64.5 % sur un classement et prédire ce que recevront vos clients. Ce que vous pouvez faire, c'est faire tourner l'agent sur 500 de vos tickets clos et lire les réponses vous-même. C'est aussi la seule façon honnête de comparer des outils d'automatisation de tickets ou de choisir entre des plateformes de helpdesk IA, car la démo de chaque éditeur est construite sur ses données et non sur les vôtres.

Si la raison pour laquelle vous chiffrez des tokens est un budget de support, la comparaison la moins chère à faire en premier est coût d'un agent IA vs humain, qui tend à écraser l'écart entre $3.75 et $7.50 par million. Nous avons chiffré cela dans économies de l'IA dans le support.
Essayer eesel
Si vous êtes arrivé ici parce que vous évaluez Gemini 3.7 Flash pour alimenter votre support, le conseil honnête est d'arrêter de comparer des fiches de modèles et de commencer à tester sur vos propres tickets. C'est pour cela qu'eesel est conçu : il se connecte en quelques minutes à Zendesk, Freshdesk, Gorgias, HubSpot, Front ou Slack, apprend à partir des tickets que vous avez déjà résolus et pas seulement de votre centre d'aide, puis exécute une simulation sur votre historique de tickets, pour que vous voyiez les réponses exactes qu'il aurait envoyées, par thème, avant que quoi que ce soit ne passe en production.
C'est un prix mensuel fixe, à partir de $299/mois pour 500 crédits (1 crédit par ticket ou chat) sans frais par siège, de sorte que le calcul se compare plus facilement à une facture de tokens que ne le permet la plupart des éditeurs. Un client a résolu 73 % des demandes de niveau 1 dès le premier mois, et les résultats étaient visibles au sein d'un essai de sept jours.
Essayez eesel gratuitement, faites-le tourner sur vos quelques centaines de derniers tickets, puis laissez la simulation vous dire si le modèle est assez bon ou non. Cette réponse vaut plus que n'importe quel tableau de benchmarks de cette page, le mien compris.
Comment Gemini 3.7 Flash se compare-t-il à Claude et GPT ?