Ce qu'est réellement Gemini 3.8 Flash TTS
D'abord les faits ennuyeux mais importants, car une bonne partie de la confusion en ligne vient de gens qui mélangent les ID de modèles.
Gemini 3.8 Flash TTS est un modèle texte-vers-parole : du texte entre, de l'audio sort, rien de plus. Il est sorti stable, pas en preview, sous l'identifiant gemini-3.8-flash-tts, et Google le présente comme le remplaçant recommandé de l'ancien gemini-3.1-flash-tts-preview. Il existe une version sœur moins chère, gemini-3.8-flash-lite-tts, sur laquelle je reviendrai.
Quelques caractéristiques à retenir, toutes tirées de la documentation de génération vocale de Google :
- 130 langues sur Flash TTS, avec détection automatique de la langue d'entrée.
- 8 192 tokens en entrée et 16 384 tokens en sortie par requête, donc conçu pour des répliques et des paragraphes, pas des romans entiers en un seul appel.
- La sortie par défaut est en WAV mono 24 kHz, avec des options mulaw et alaw pour la téléphonie.
- L'audio est facturé à 25 tokens par seconde, ce qui est le détail qui fait tenir le calcul du prix.
Il ne gère pas l'appel de fonctions, la sortie structurée, le raisonnement, l'ancrage par recherche ni la Live API. C'est un moteur de rendu, pas un agent. Gardez ce cadrage en tête, car il compte pour la suite.
À quel point sonne-t-il réellement bien ?
C'est la seule question qui compte pour un modèle vocal, et c'est aussi là où le marketing et la réalité divergent un peu.
L'argumentaire de Google est solide. Le billet de lancement revendique la #1 place au Voice Design Benchmark de Hume AI (71,4) et les #1 et #2 places à l'Overall Quality Index de Hume pour Flash et Flash-Lite. Ce sont de vrais chiffres. Une réserve que je voudrais garder à l'esprit avant d'y accorder toute ma confiance : le fondateur de Hume est crédité comme auteur dans l'annonce même de Google, donc le fournisseur et l'auteur du benchmark ne sont pas totalement indépendants ici. Cela ne rend pas les scores faux, mais je les pondère un peu plus légèrement pour autant.
La lecture indépendante est plus utile. Selon Artificial Analysis, Gemini 3.8 Flash TTS a décroché la #1 place en Pronunciation Robustness à 89,5 % (contre 88,2 % pour 3.1 Flash TTS), mais seulement la #2 place dans la Provider Voice Arena à l'aveugle, avec un Elo d'environ 1 263, derrière Sonic 3. Le résumé équitable est donc le suivant : meilleur de sa catégorie pour bien prononcer les mots, deuxième pour sonner comme la voix qu'on choisirait vraiment.
« Google a lancé Gemini 3.8 Flash TTS et Gemini 3.8 Flash-Lite TTS. Gemini 3.8 Flash TTS fait ses débuts #1 de notre Pronunciation Robustness Benchmark et #2 de notre classement Provider Voice Arena »
Les développeurs qui l'ont vraiment essayé ont été plus directs. La remarque la plus tranchante du fil du jour de lancement sur Hacker News :
« Les voix disponibles sonnent toutes comme des voix Gemini génériques pour moi. Rien ne ressort de particulièrement intéressant ou impressionnant là-dedans. »

Cela correspond à l'écart de benchmark. La prononciation est résolue ; la personnalité, non. Si votre besoin est un narrateur clair, correct et neutre, vous serez très satisfait. Si vous avez besoin d'une voix qu'on retient, tempérez vos attentes.
Ce que vous pouvez réellement contrôler
La raison de préférer Gemini à une simple voix neuronale, c'est le contrôle, et c'est la partie que j'ai le plus appréciée. Vous ne choisissez pas juste une voix sur une étagère, vous la dirigez.
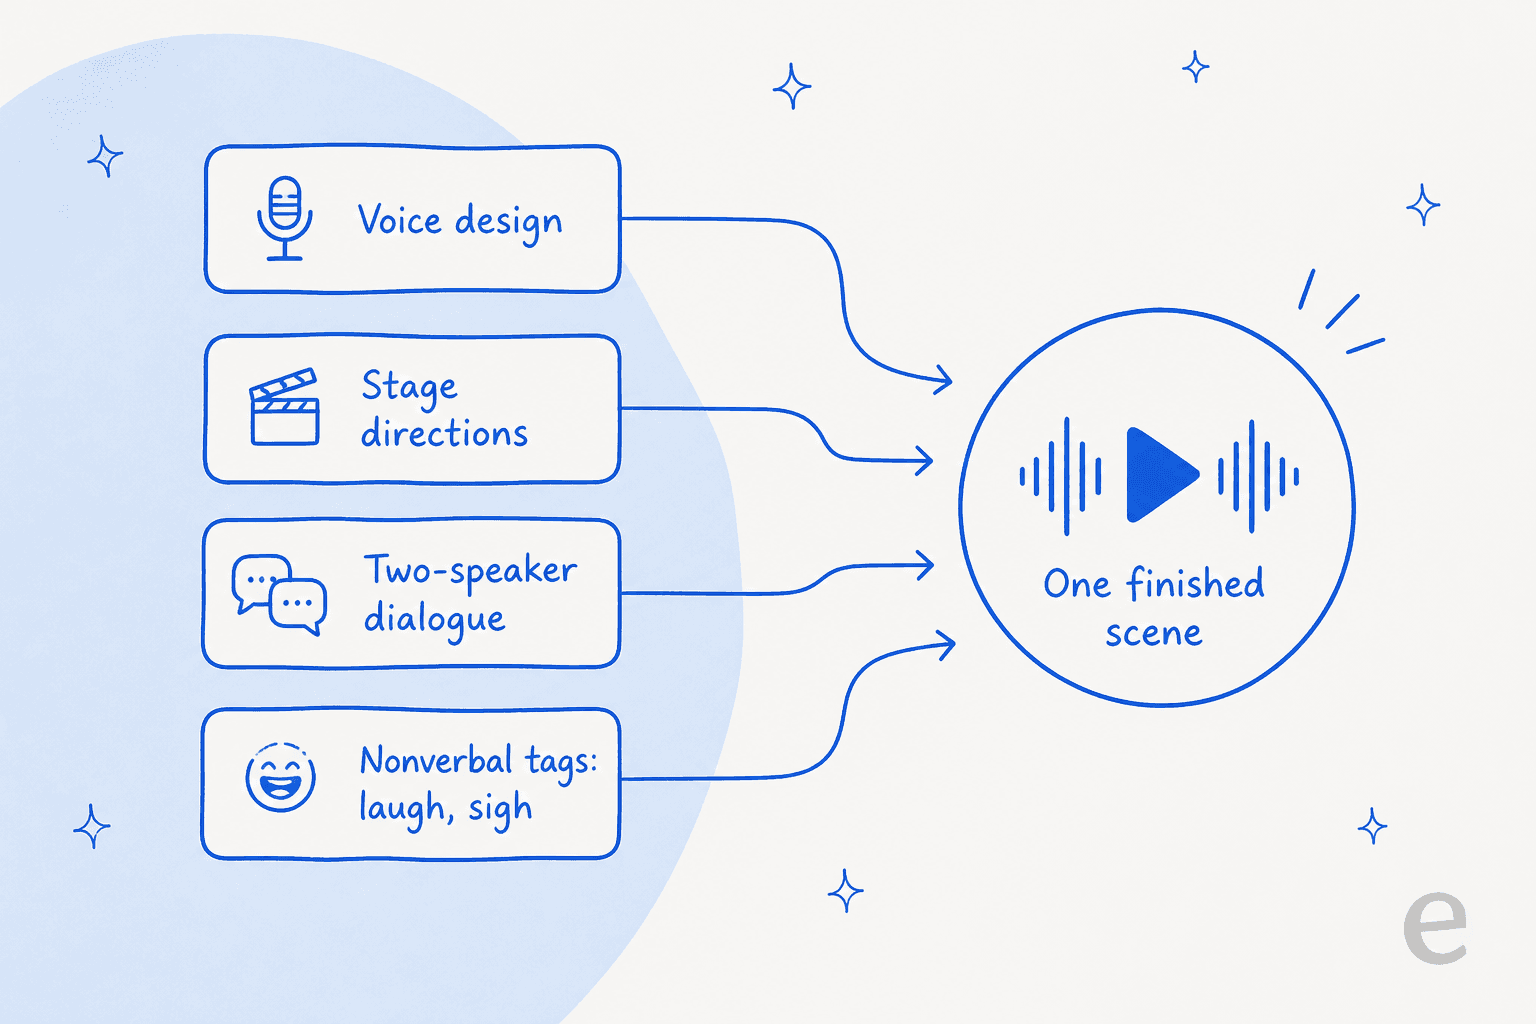
Quatre couches s'empilent :
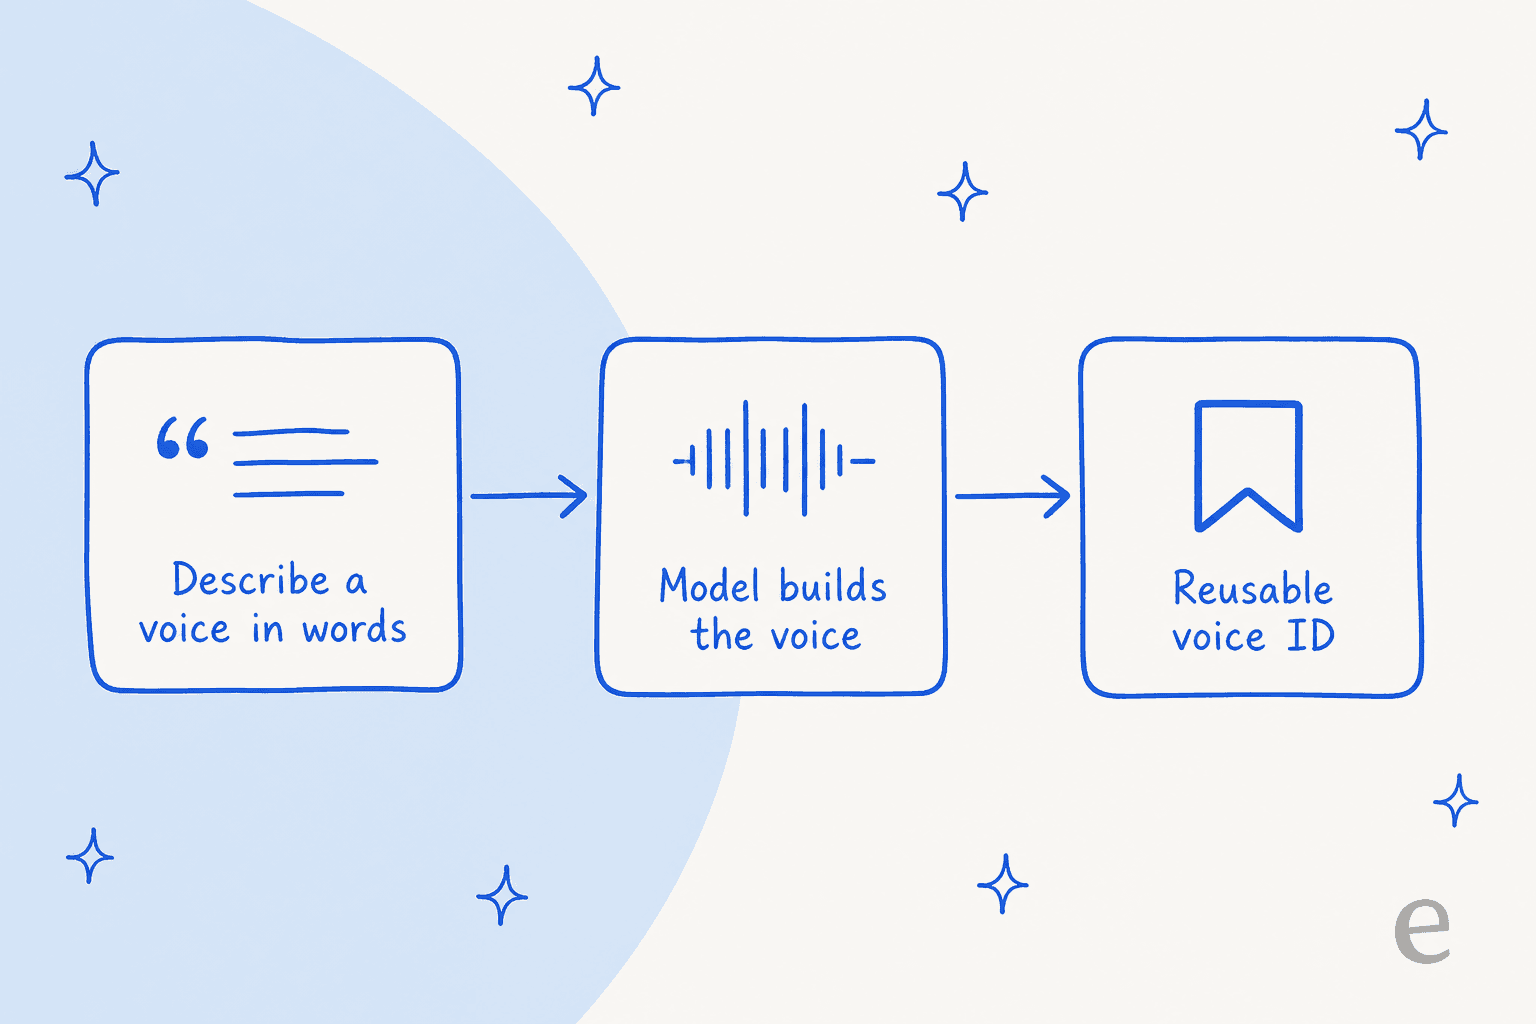
- Conception de voix. Décrivez un personnage en langage naturel et le modèle construit une voix à partir de la description, que vous pouvez ensuite enregistrer comme identifiant réutilisable.
- Indications de mise en scène. Un champ de type
speech_metadatapermet de piloter le ton, l'accent et le rythme par réplique (« lis ceci avec chaleur, légèrement pressé »). - Dialogue à deux locuteurs. Un mode conversationnel gère jusqu'à deux voix prédéfinies dans une seule requête, ce qui rend possibles des clips rapides façon podcast.
- Balises non verbales. Des marqueurs en ligne comme
<laugh>,<sigh>,<breath>et<short pause>placent des événements vocaux exactement où vous le souhaitez.
Le flux de conception de voix est la fonctionnalité phare et il est vraiment ingénieux : vous passez d'une phrase de description à une voix persistante et réutilisable sans jamais rien enregistrer.
La limite honnête : la contrôlabilité est réelle mais pas parfaitement fiable. Sur une précédente version de Gemini TTS, un développeur a signalé que les indications étaient parfois purement et simplement ignorées :
« Peu importe ce que j'écrivais dans le profil audio, AI Studio ne le suivait jamais, quelle que soit la scène ou le contexte. Par exemple, j'ai essayé d'obtenir une voix masculine et j'ai continué à recevoir des voix féminines. »
Google affirme que 3.8 améliore la direction créative, et à ma lecture c'est le cas, mais prévoyez quelques régénérations quand une indication ne fonctionne pas du premier coup. C'est un prompt, pas une garantie.
La réplication de voix (clonage) est également arrivée, alors que Google semblait longtemps hésitant sur ce point. Comme l'a formulé Simon Willison :
« Je suppose que le clonage vocal est désormais assez largement disponible chez d'autres fournisseurs pour que Google n'hésite plus à le lancer. »
Flash vs Flash-Lite : lequel utiliser
La répartition en deux modèles est simple une fois qu'on la comprend, et se tromper vous coûte simplement de l'argent ou de la qualité.
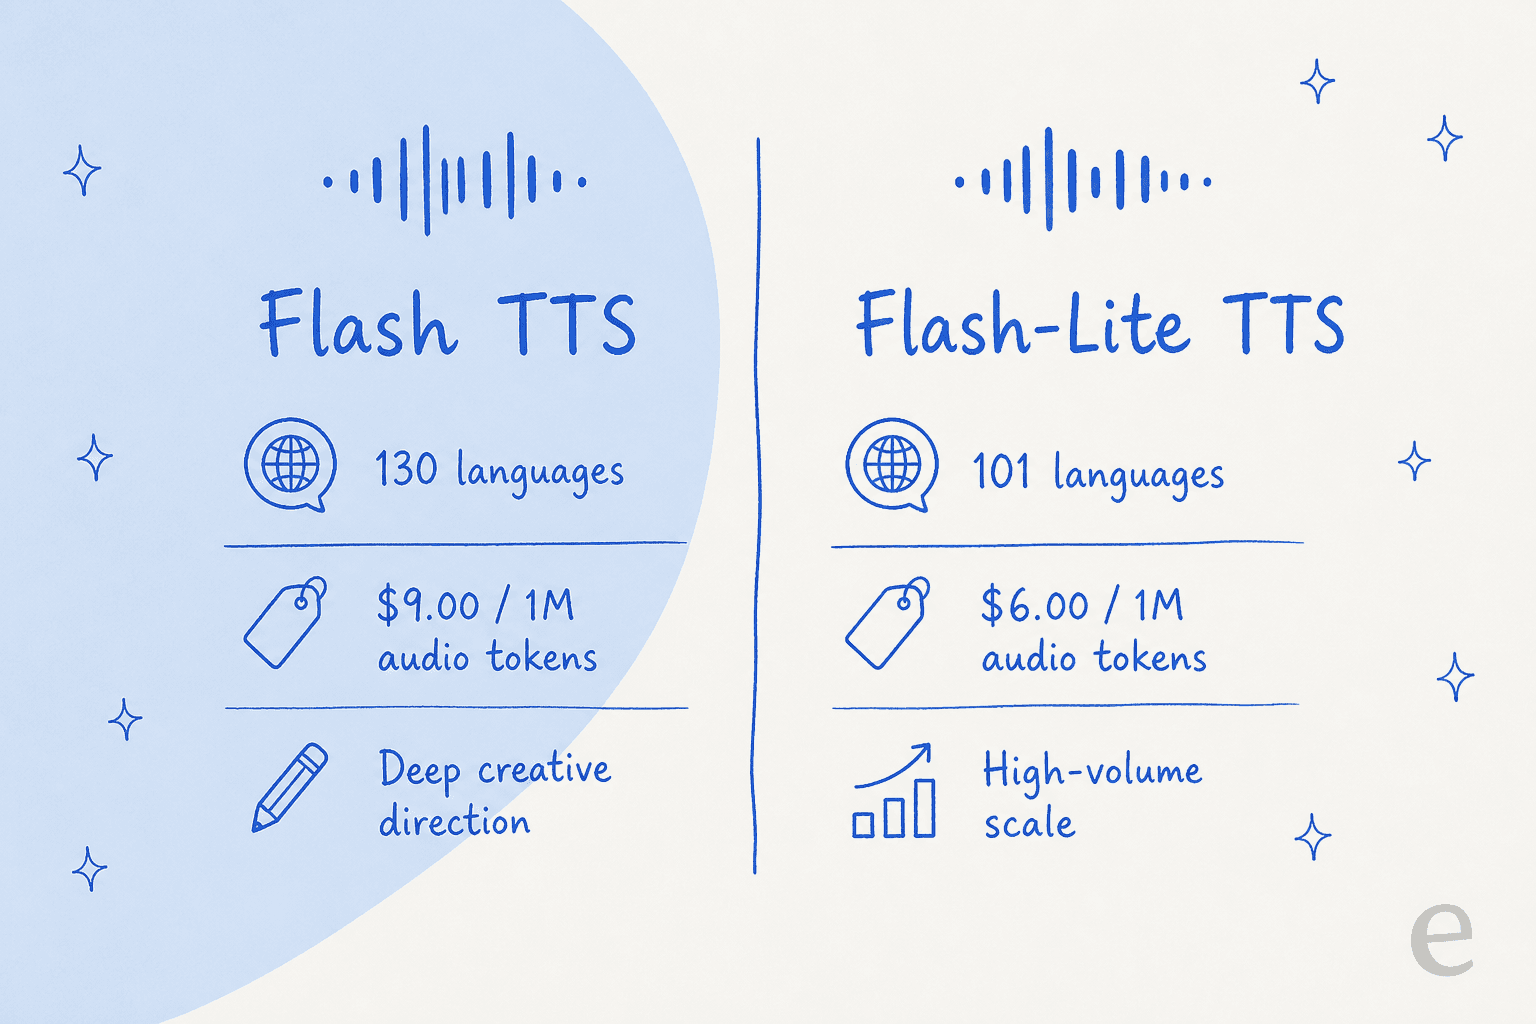
Flash TTS est le modèle expressif : 130 langues, 9,00 $ par million de tokens audio, et la boîte à outils complète de direction créative. Choisissez-le quand l'audio est le produit, comme un livre audio, une publicité de marque ou un personnage.
Flash-Lite TTS est le cheval de trait : 101 langues, 6,00 $ par million de tokens audio, réglé pour un rendu à fort volume où « bon et bon marché » l'emporte sur « expressif ». Choisissez-le quand vous générez des milliers de clips et que personne ne remarquera une lecture un peu plus plate.
Ma règle empirique : prototypez sur Flash pour entendre le plafond de qualité, puis passez à Flash-Lite pour tout ce que vous rendez en volume. Si aucun des deux ne convient, les alternatives à Gemini qui valent le détour sont Sonic 3 de Cartesia et ElevenLabs.
La réalité du prix (et le piège de 2027)
Je garde les chiffres complets dans l'article tarifs de Gemini 3.8 Flash TTS, mais la version pertinente pour cet avis est courte.
Au palier standard, Flash TTS coûte 9,00 $ par million de tokens audio en sortie. Comme l'audio est facturé à 25 tokens par seconde, une heure de parole représente environ 90 000 tokens, soit environ 0,81 $ par heure d'audio généré. Batch et Flex bénéficient de 50 % de réduction sur ce montant. Il existe un vrai palier gratuit via Google AI Studio.
Le piège à anticiper : ce sont des tarifs promotionnels valables jusqu'au 31 décembre 2026, et ils doublent à peu près au 1er janvier 2027 (Flash passe à 18,00 $ par million de tokens audio). Si vous budgétisez une charge de travail pour 2027, budgétisez le chiffre doublé, pas le prix de lancement. C'est le même schéma dans toute la gamme de tarifs Gemini, donc ce n'est pas une surprise si vous suivez Gemini de près.
Sur le coût, le verdict de la communauté était clair, même chez les sceptiques. Simon Willison, en testant le mode conversation :
« Le mode conversation est chouette, et la plupart de mes essais ont coûté moins d'un centime. »
Face à la concurrence
Les tarifs TTS d'un fournisseur à l'autre sont un vrai bazar car les unités de facturation diffèrent : Amazon, Azure et Deepgram facturent au caractère, tandis qu'OpenAI et Google facturent au token audio. Pour comparer équitablement, j'ai tout normalisé en dollars par heure d'audio (en utilisant le repère propre d'Amazon d'environ 23 heures de parole par million de caractères). Considérez ces chiffres comme des estimations, car la vitesse d'élocution modifie le calcul.
| Modèle | Prix affiché | ~ $/heure d'audio | Palier gratuit |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 9,00 $ / 1M tokens audio | ~0,81 $ | Oui (AI Studio) |
| Gemini 3.8 Flash-Lite TTS | 6,00 $ / 1M tokens audio | ~0,54 $ | Oui (AI Studio) |
| Amazon Polly Neural | 16 $ / 1M caractères | ~0,70 $ | 1M caractères/mois (12 mois) |
| Azure Neural / HD Flash | 15 $ / 1M caractères | ~0,65 $ | 0,5M caractères/mois |
| OpenAI gpt-4o-mini-tts | 12 $ / 1M tokens audio | ~0,90 $ | Aucun (TTS) |
| Deepgram Aura-2 | 30 $ / 1M caractères | ~1,30 $ | 200 $ de crédit à l'inscription |
| ElevenLabs Business | « à partir de 5 c/min » | ~3,00 $ | 10 000 crédits/mois |
Ce qu'il faut retenir : Gemini 3.8 Flash TTS est au prix d'une voix neuronale banale mais se comporte comme une voix expressive et générative. Il se situe juste à côté d'Amazon Polly Neural et d'Azure sur le coût, sous-cote OpenAI et Deepgram, et ne représente qu'une fraction d'ElevenLabs à l'heure. Si le ratio prix/expressivité vous importe, c'est le titre de tout ce lancement.
Une nuance à mentionner honnêtement : les tarifs ElevenLabs vous offrent une bibliothèque de voix et un niveau de caractère que le tableau des coûts ne capture pas, ce qui explique exactement pourquoi les équipes continuent de payer pour cela, comme le montrent les avis sur ElevenLabs.
Devriez-vous l'utiliser ? Une décision rapide
Plutôt qu'un paragraphe de plus disant « ça dépend », voici la décision que je prendrais selon le cas d'usage.
Là où il montre ses limites
Pour rester équitable, voici les vraies limites que je signalerais avant de vous engager :
- Les voix manquent de caractère. La critique la plus plébiscitée par les développeurs est que tout sonne « génériquement Gemini ». Excellent pour l'utilitaire, plus faible pour la marque.
- Les indications peuvent être ignorées. Le contrôle créatif est un prompt, pas un contrat, donc attendez-vous à des ratés occasionnels et des régénérations.
- Ce n'est pas le sommet de l'arène. #1 en prononciation, mais #2 en préférence humaine à l'aveugle derrière Sonic 3. Si « la meilleure voix » est votre exigence, ce n'est pas tranché.
- Le coût double en 2027. Le prix de lancement est promotionnel. Une charge de travail que vous dimensionnez en 2026 coûtera deux fois plus cher en janvier.
- Les modèles locaux rattrapent leur retard. Plusieurs développeurs ont mentionné des options ouvertes comme Fish Audio, Higgs et Qwen3 TTS comme suffisamment bonnes pour un rendu final, surtout quand le coût ou les règles de confidentialité excluent une API cloud.
Rien de tout cela n'est disqualifiant. C'est la différence entre « exceptionnel » et « très bon et très bon marché », ce qui est mon constat final.
La partie pour laquelle les gens viennent vraiment : une voix pour le support
Beaucoup de gens qui cherchent un modèle vocal se posent en réalité une autre question : puis-je mettre ça face à mes clients ? C'est la section que je ne sauterais pas.
Un modèle TTS est de l'infrastructure. Il transforme du texte en audio, et c'est tout son travail. Il ne connaît pas votre politique de remboursement, ne peut pas lire votre logiciel de service client, et n'a aucune idée si la phrase qu'il vient de dire est réellement vraie. Si vous placez un modèle vocal brut face à une ligne de support, il lira avec assurance une mauvaise réponse d'une belle voix, ce qui est pire qu'un simple message d'erreur. C'est l'inverse des économies de coûts que la plupart des équipes recherchent.
Je travaille là-dessus chez eesel, et ma façon de voir les choses est simple : le modèle est la voix, le coéquipier est l'employé. eesel est une plateforme de coéquipiers IA, et le coéquipier pertinent ici est l'agent de support IA. Il se connecte à votre helpdesk existant, apprend de vos tickets passés et de votre centre d'aide, suit les règles que vous fixez, et est simulé sur votre historique réel de tickets avant de jamais répondre à un client en direct. Ce dernier point compte : nous avons vu des bots au ton confiant donner tranquillement de mauvaises réponses, ce qui explique précisément pourquoi chaque déploiement est d'abord testé à blanc sur des tickets historiques. Un modèle vocal n'a pas de filet de sécurité équivalent.
Si vous travaillez dans un terminal ou souhaitez scripter cela, la CLI eesel pilote le même coéquipier et le même espace de travail que le tableau de bord. Une personne peut inspecter les instructions d'un coéquipier en ligne de commande, un script peut automatiser un flux de travail, et un agent de code comme Claude Code, Codex ou Cursor peut piloter eesel de façon programmatique, afficher des résultats JSON et proposer des changements limités pour approbation par un responsable. C'est l'interface adaptée aux agents pour le même produit, pas une chose séparée. C'est une vraie différence par rapport à câbler vous-même Gemini TTS, où vous assumez seul toute l'orchestration, les métriques de support, la logique d'escalade et la gestion des SLA.
Donc : utilisez Gemini 3.8 Flash TTS pour ce qu'il fait très bien, à savoir une parole bon marché, claire et contrôlable. Pour une voix qui résout réellement les problèmes des clients, il vous faut un coéquipier testé au-dessus, pas le modèle brut. Si c'est votre véritable objectif, commencez par un vrai chatbot de support IA et l'outillage plus large d'automatisation du support, et comparez les options du meilleur agent IA pour le service client avant de construire quoi que ce soit à partir de zéro.
Mon verdict
Gemini 3.8 Flash TTS est un très bon modèle vocal à un prix véritablement disruptif. Il excelle en prononciation, offre un vrai contrôle créatif, propose la conception et le clonage de voix, et coûte une fraction d'ElevenLabs à l'heure. Les bémols honnêtes sont que les voix manquent de caractère marquant, qu'il est #2 plutôt que #1 en préférence à l'aveugle, et que le prix double en 2027.
Pour la plupart des développeurs rendant de l'audio à grande échelle, c'est le nouveau choix raisonnable par défaut. Pour une voix de marque signature, ElevenLabs et Sonic 3 restent dans la course. Et si vous êtes venu en voulant une IA qui parle à vos clients et résout vraiment leurs problèmes, rappelez-vous que la voix est la partie facile : les entreprises de service client IA qui méritent votre temps sont celles qui résolvent la partie difficile, et le logiciel de helpdesk IA qui résout un ticket compte bien plus que la voix qui lit la réponse.

Vous voulez un coéquipier IA pour votre file de support, pas juste une jolie voix ? eesel se connecte à votre helpdesk en quelques minutes, apprend de vos propres tickets, et vous pouvez le simuler sur votre historique réel avant sa mise en production. Essayez eesel gratuitement, ou réservez une démo pour le voir sur vos propres données.
Questions fréquentes
Gemini 3.8 Flash TTS est-il bon ?
Oui, avec une réserve. Il offre une qualité studio en clarté et en prononciation, et a fait ses débuts à la #1 place du benchmark Pronunciation Robustness d'Artificial Analysis. Mais en préférence humaine à l'aveugle, il arrive #2, derrière Sonic 3 de Cartesia, et plusieurs développeurs ont trouvé les voix prédéfinies génériques. C'est un excellent choix par défaut, pas un sans-faute.
Combien coûte Gemini 3.8 Flash TTS ?
Il coûte 0,50 $ par million de tokens de texte en entrée et 9,00 $ par million de tokens audio en sortie sur le palier standard jusqu'au 31 décembre 2026, ce qui représente environ 0,81 $ pour une heure de parole. Les deux tarifs doublent le 1er janvier 2027. Le détail complet des paliers se trouve dans mon article sur les tarifs de Gemini 3.8 Flash TTS, et l'ensemble de la famille figure dans le guide des tarifs de Gemini 3.
Gemini 3.8 Flash TTS vs ElevenLabs : lequel est le meilleur ?
Gemini l'emporte largement sur le prix, environ 4 à 5 fois moins cher par heure d'audio. ElevenLabs a toujours l'avantage sur des voix marquantes, avec du caractère, et sa bibliothèque de voix. Si le coût et l'échelle priment, choisissez Gemini ; si une voix distinctive compte le plus, regardez aussi les alternatives à ElevenLabs.
Quelle est la différence entre Gemini 3.8 Flash TTS et Flash-Lite TTS ?
Flash TTS couvre 130 langues à 9,00 $ par million de tokens audio et est conçu pour un audio expressif et dirigé. Flash-Lite TTS couvre 101 langues à 6,00 $ par million de tokens audio et est conçu pour des tâches à fort volume et sensibles au coût. Choisissez Flash quand la direction créative compte, et Flash-Lite quand vous rendez à grande échelle.
Gemini 3.8 Flash TTS peut-il cloner une voix ?
Oui. Il prend en charge la conception de voix (décrire un personnage en mots) et la réplication de voix (clonage à partir d'un court extrait de référence plus un audio de consentement). Les voix clonées peuvent être enregistrées comme un identifiant de voix réutilisable, plafonné à 200 par projet avec une durée de vie d'un an, ou comme une clé sans état valable 7 jours.
Gemini 3.8 Flash TTS prend-il en charge plusieurs locuteurs ?
Jusqu'à deux locuteurs par requête avec des voix prédéfinies, avec un mode conversationnel pour le dialogue. Au-delà de deux voix, vous synthétisez chaque réplique séparément et assemblez les audios.
Un modèle vocal comme Gemini TTS suffit-il pour le support client ?
Non. Un modèle TTS transforme du texte en parole ; il ne lit pas votre centre d'aide, ne suit pas vos politiques et ne résout pas un ticket. Pour le support, il vous faut un coéquipier IA au-dessus, comme un agent de support IA connecté à votre logiciel de service client et d'abord testé sur votre historique réel de tickets.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.