

Les tarifs de Mistral Large 4 en un coup d'œil
Je construis les intégrations d'API chez eesel, et le coéquipier helpdesk fonctionne avec des modèles d'OpenAI, d'Anthropic et de Google, donc une bonne partie de ma semaine consiste à lire des grilles tarifaires puis à regarder au-delà du chiffre affiché. La grille de Mistral pour Large 4 est courte, mais elle cache plus qu'elle ne montre. Voici tout ce qui figure sur la page de tarifs de l'API de Mistral pour la famille phare, niveau Standard, au 8 octobre 2026.
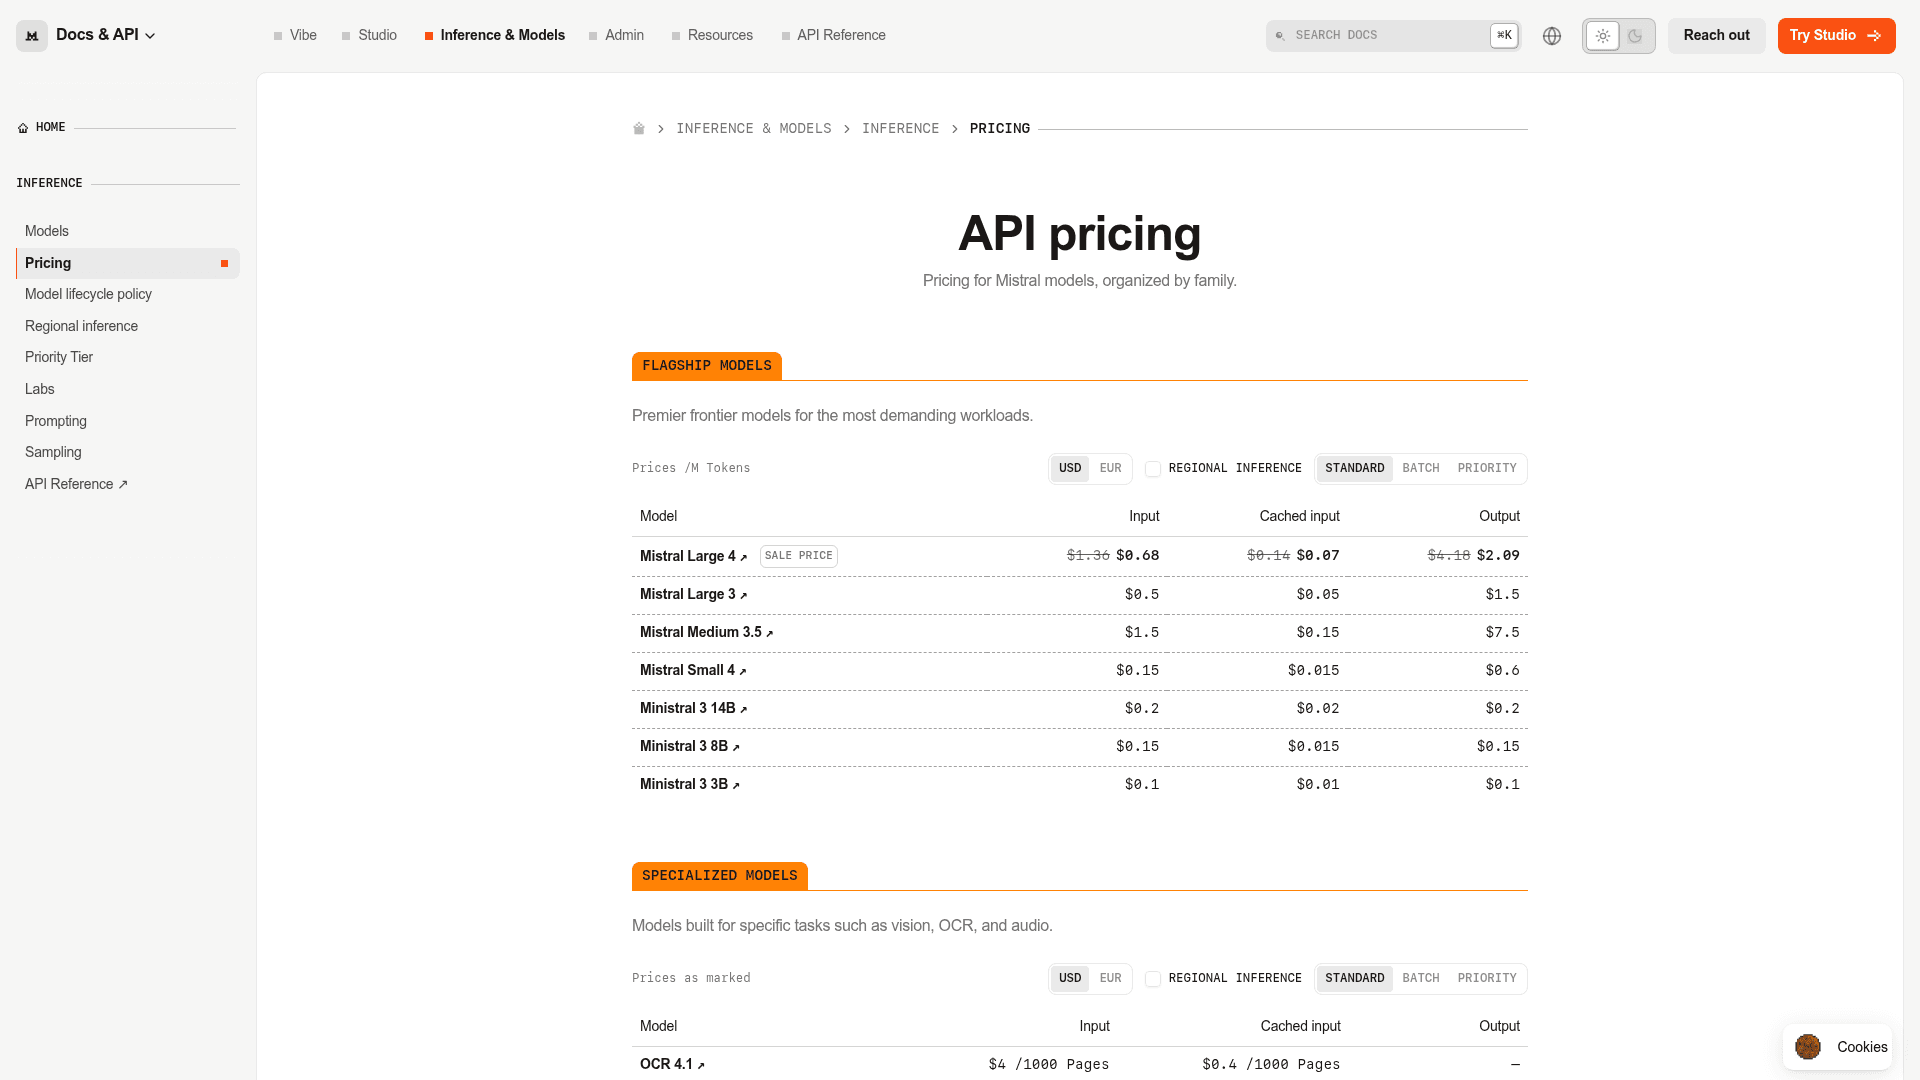
| Modèle | Entrée (par 1M) | Entrée en cache (par 1M) | Sortie (par 1M) | Notes |
|---|---|---|---|---|
| Mistral Large 4 (promo) | $0.68 | $0.07 | $2.09 | Préversion publique, contexte de 1M |
| Mistral Large 4 (catalogue) | $1.36 | $0.14 | $4.18 | Barré sur la page |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 | Ancien modèle phare, toujours listé |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 | Ancien modèle de raisonnement |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 | Niveau économique |
| Ministral 3 14B | $0.20 | $0.02 | $0.20 | Petit modèle dense |
| Z.ai GLM 5.3 (hébergé par Mistral) | $1.40 | $0.14 | $4.40 | Modèle tiers |
Quelques points à connaître avant de reporter ces chiffres dans un tableur :
- La promotion est exactement 50% de remise, sur les trois compteurs. La fiche du modèle Large 4 montre le même schéma de prix barrés et ne donne pas de date de fin.
- L'article de lancement de Mistral cite le prix catalogue. L'annonce de Mistral Large 4 indique $1.36 / $4.18, donc la promotion est une opération ajoutée par-dessus, pas le "vrai" prix.
- L'entrée en cache bénéficie de 90% de remise. $0.07 contre $0.68 en promotion. Cela compte plus que d'habitude pour ce modèle, et j'explique pourquoi plus bas.
- Large 4 coûte plus cher par token que Large 3. Le prix catalogue est passé de $0.50 / $1.50 à $1.36 / $4.18, soit environ 2.7x en entrée et 2.8x en sortie. Même en promotion, c'est 36% de plus en entrée et 39% de plus en sortie.
Pour l'historique de la façon dont Mistral en est arrivé là, mon tour d'horizon des nouveaux modèles Mistral couvre les lancements de Large 3 et Medium 3.5.
Ce que signifie vraiment "prix promotionnel" pour un modèle en préversion
Large 4 est une Public Preview sur l'API de Mistral, et cette étiquette change la façon de lire le prix. La politique de cycle de vie des modèles de Mistral dit trois choses sur les modèles en préversion qui comptent pour un acheteur :
- Ils sont facturés au même tarif que les modèles en General Availability. La promotion n'est donc pas une "remise de préversion" qui disparaît au GA par conception. C'est une opération distincte.
- Ils n'ont aucune garantie d'accéder à la General Availability, et peuvent être retirés avant d'y arriver.
- Le préavis de dépréciation d'un modèle en préversion est de 1 mois, contre 6 mois pour un modèle GA. Une fois retiré, les requêtes renvoient une erreur
404.
Au total, le chiffre prudent pour planifier est le prix catalogue, plus un plan de migration exécutable en quatre semaines. Le cofondateur de Mistral, Guillaume Lample sur X, a déjà annoncé que la version finale arrive :
"The RL run behind this preview is still in flight and shows no sign of saturation -- we will release a final version before the end of the month along with the weights of the model."
Le document de cycle de vie note aussi que les modèles en préversion ne peuvent pas utiliser d'alias -latest, et que les alias "may expose you to silent updates in model behavior and pricing." Mon conseil est le même que pour tout modèle en production : épinglez l'identifiant exact de la version et rechiffrez quand vous changez.
Un token, quatre prix : batch, standard, regional et Priority
La page de tarifs a des onglets Standard, Batch et Priority ainsi qu'un sélecteur d'inférence régionale, tandis que les multiplicateurs se trouvent sur des pages de documentation distinctes. La plupart des articles sur les tarifs de Mistral Large 4 passent cette partie sous silence, et c'est ici que la facture peut plus que tripler.
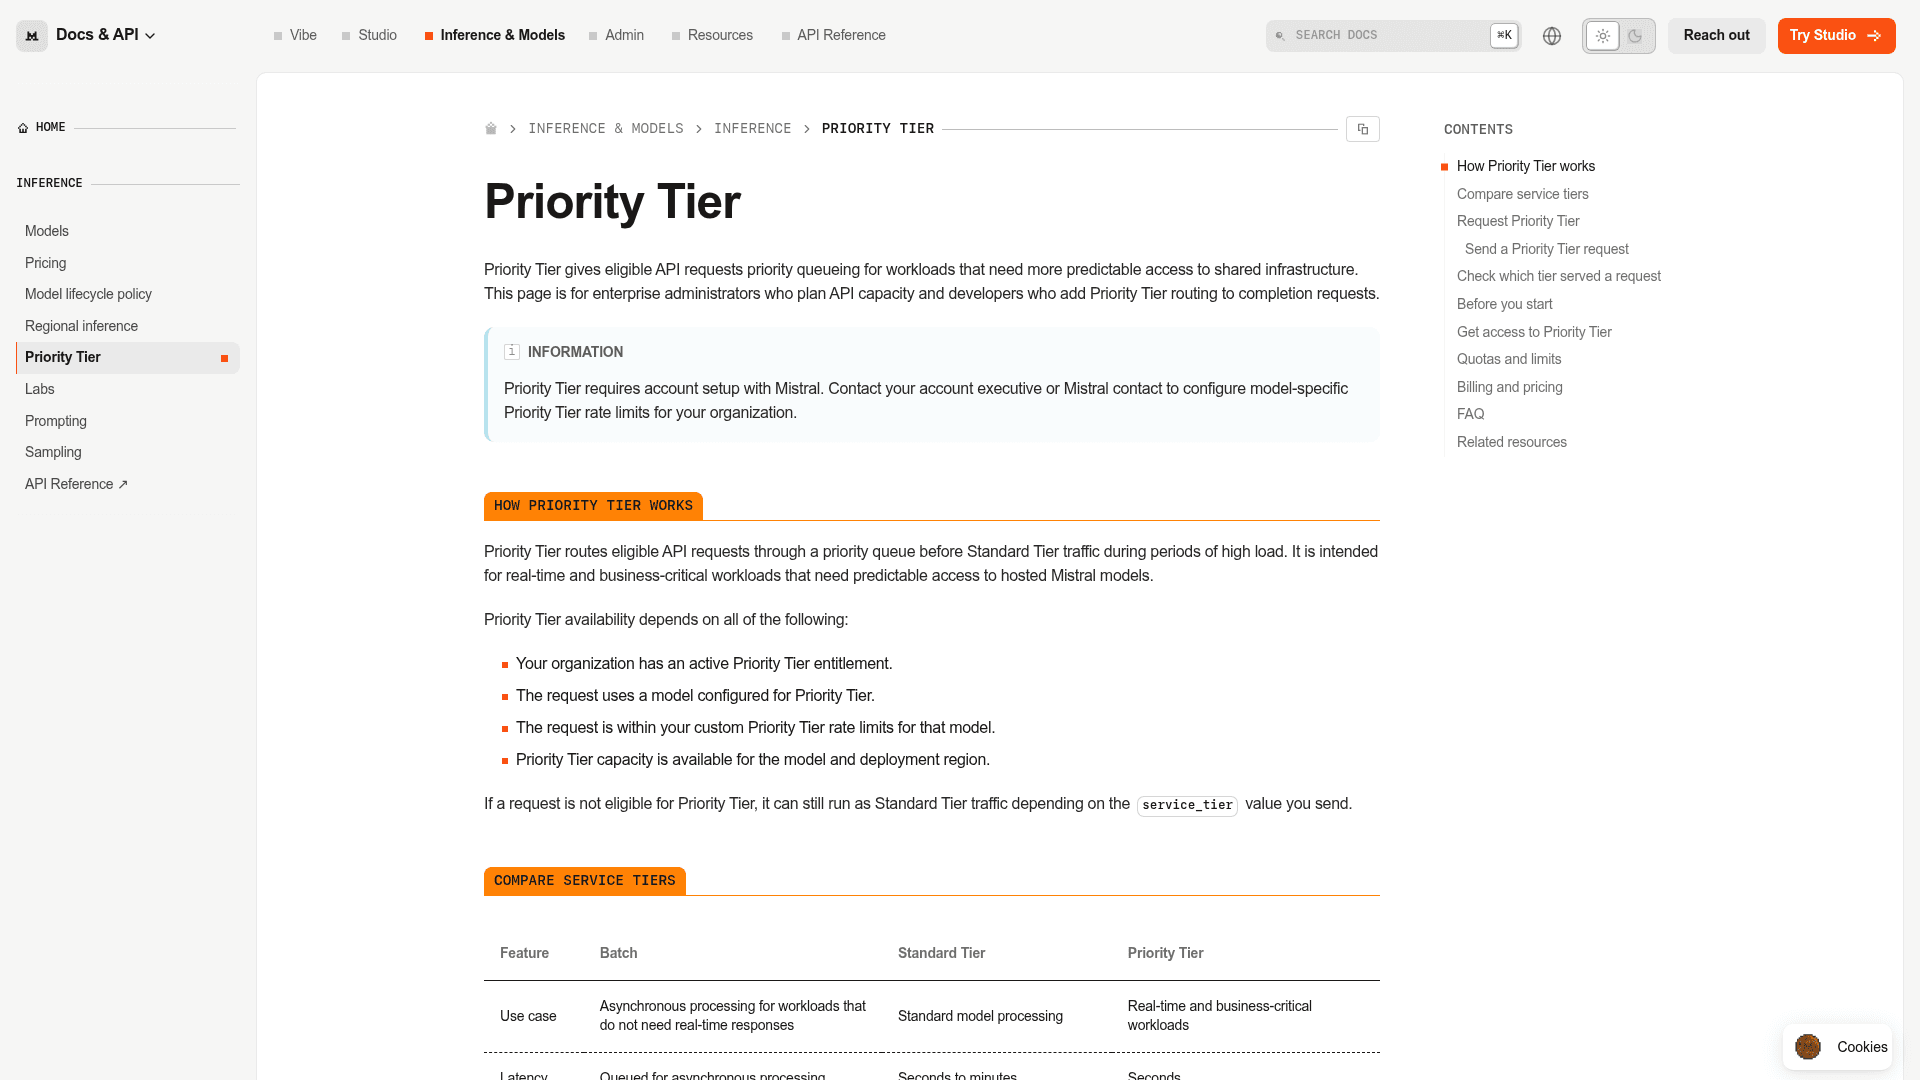
| Niveau | Mode de tarification | Entrée / cache / sortie par 1M | Latence | SLA de disponibilité |
|---|---|---|---|---|
| Batch | 50% de remise | $0.34 / $0.035 / $1.045 si cumulable avec la promo ; $0.68 / $0.07 / $2.09 sur le catalogue | En file d'attente, jusqu'à 24 heures | Aucun |
| Standard (promo) | Promotion de lancement | $0.68 / $0.07 / $2.09 | Secondes à minutes | Aucun |
| Standard (catalogue) | Grille tarifaire | $1.36 / $0.14 / $4.18 | Secondes à minutes | Aucun |
| Regional (UE ou États-Unis) | 1.1x le catalogue standard | $1.496 / $0.154 / $4.598 | Secondes à minutes | Aucun |
| Priority Tier | 1.75x le catalogue standard | $2.38 / $0.245 / $7.315 | Secondes | 99.5% |
Les sources de chaque ligne :
- Batch. La documentation du traitement batch de Mistral promet "a 50% discount" et jusqu'à 1 million de requêtes par lot. La documentation ne dit pas si cette remise s'applique au prix promotionnel ou au prix catalogue. Notez que 50% de remise sur le catalogue tombe exactement sur le prix promotionnel actuel.
- Inférence régionale. La page d'inférence régionale indique que c'est "billed at 1.1× standard list pricing (a 10% upcharge) for input tokens, output tokens, cached reads, and cache writes." Les régions actuelles sont l'UE et les États-Unis.
- Priority Tier. La page du Priority Tier indique que le multiplicateur "is 1.75x standard list pricing." Il exige une configuration du compte via les ventes, retombe sur Standard quand vous dépassez vos limites, et c'est le seul niveau avec un SLA de disponibilité.
Cela compte davantage pour Mistral que pour la plupart des fournisseurs. La raison la plus forte qu'on donne pour choisir Mistral est qu'elle est européenne. Le propre message de lancement de Mistral sur X commence par là :
"Forged in Europe end-to-end and is deployable from Europe via our own Mistral Cloud infrastructure."
Mais le point d'accès qui garantit que l'inférence s'exécute dans l'UE est le régional, et son multiplicateur de 1.1x est exprimé par rapport au prix catalogue. Les deux pages de documentation sont rédigées en termes généraux et ne disent rien de la promotion de Large 4, donc Mistral pourrait en pratique appliquer le multiplicateur au tarif remisé. Je ne budgéterais pas là-dessus. Si la résidence est la raison de votre achat, budgétez environ 2.2x le prix affiché jusqu'à ce que votre facture dise autre chose.
La même logique vaut pour une équipe de support qui a besoin d'un SLA. Le Priority Tier est la seule option qui en propose un, et à 1.75x le catalogue, cela fait $7.32 par 1M de tokens de sortie et $2.38 en entrée. Ce tarif d'entrée est supérieur aux $2 à partir desquels commencent les tarifs de Claude Sonnet 5.5, et le tarif de sortie est bien plus proche des $10 de Sonnet que des $2.09 affichés.
Pourquoi le prix par token sous-estime la facture
Les grilles tarifaires comparent les modèles par token, mais votre facture les compare par tâche. Pour les modèles de raisonnement, les deux classements divergent. Un modèle de raisonnement écrit un long brouillon interne avant de répondre, et vous payez le tarif de sortie pour chaque mot.
Artificial Analysis a exécuté l'Intelligence Index complet sur Mistral Large 4 Preview et publié une ventilation des coûts. Au prix catalogue, l'exécution entière a coûté $1,601.97, et voici où est passé l'argent :
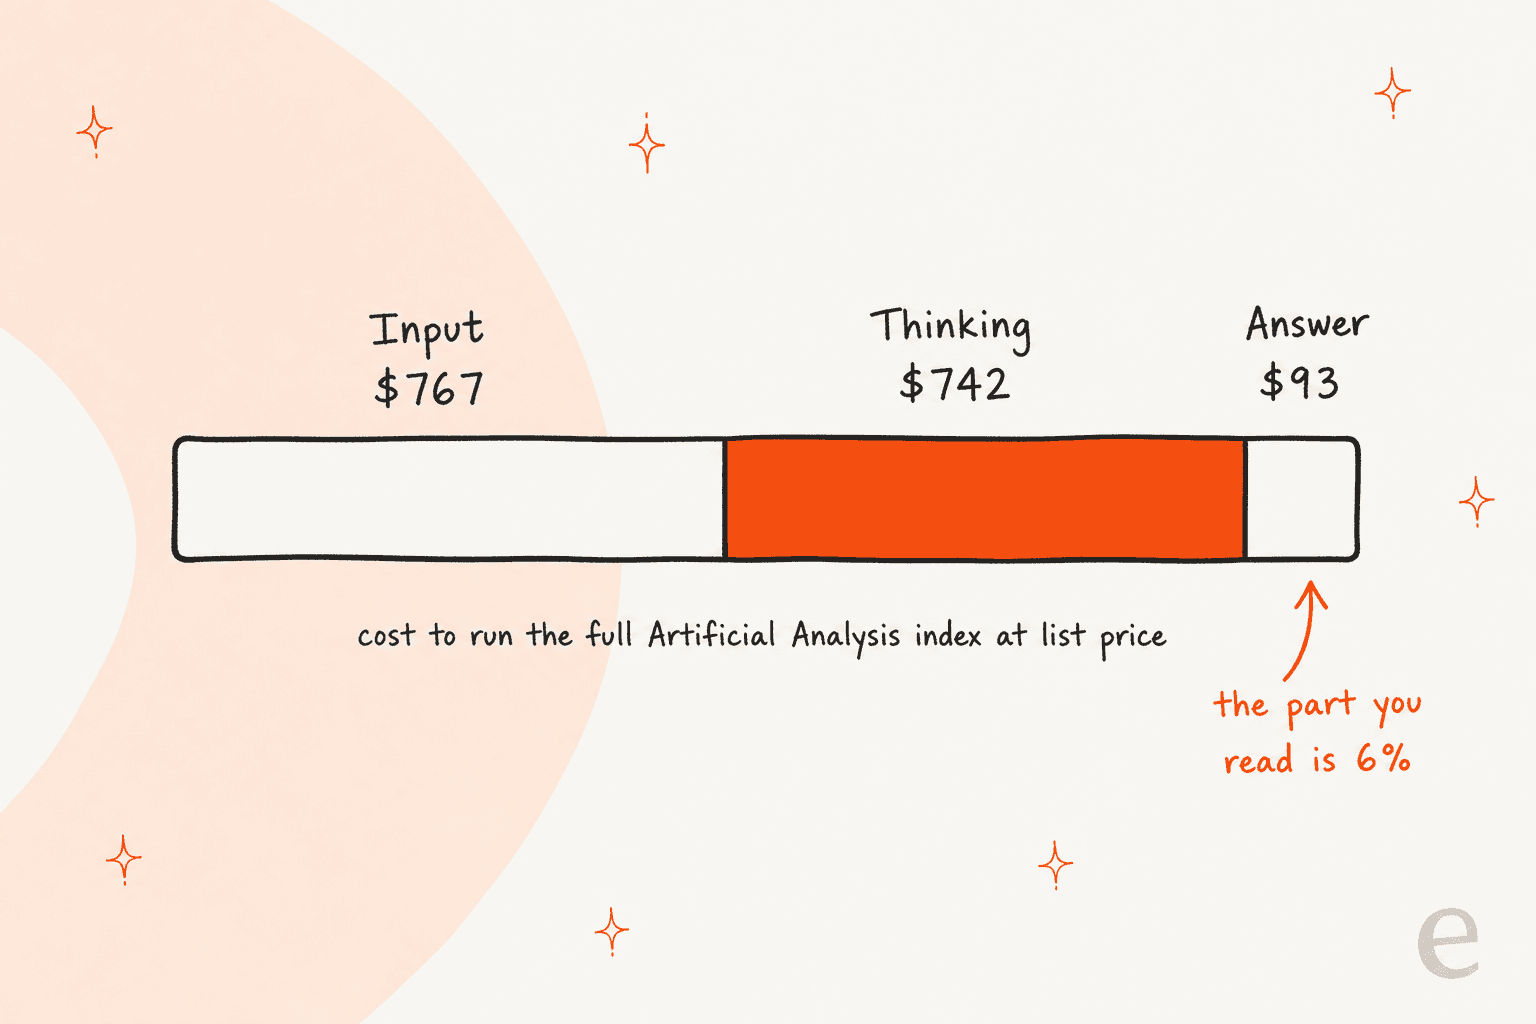
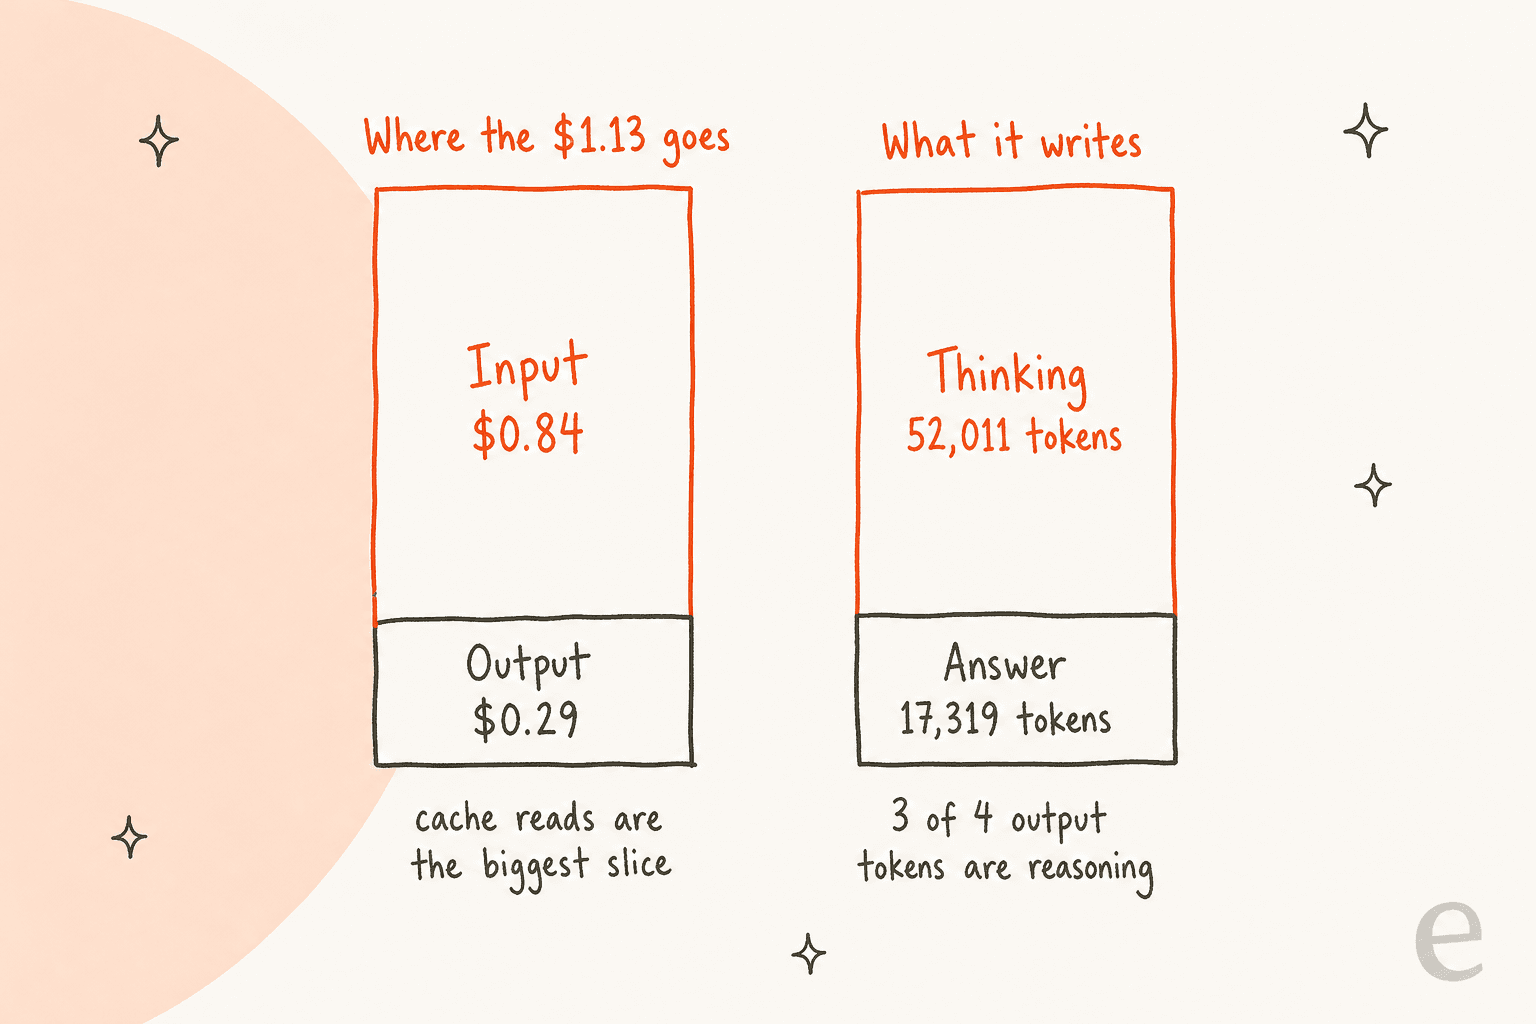
- Sortie de raisonnement : $742.45. Large 4 a produit en moyenne 69,330 tokens de sortie par tâche, dont 52,011, soit 75%, de raisonnement.
- Entrée : $766.79, dont $479.04 de lectures de cache. Les longues tâches agentiques renvoient leur contexte à chaque tour, ce qui explique pourquoi la remise de 90% sur le cache vaut la peine d'être optimisée.
- La réponse que vous lisez vraiment : $92.73. C'est moins de 6% de la facture.
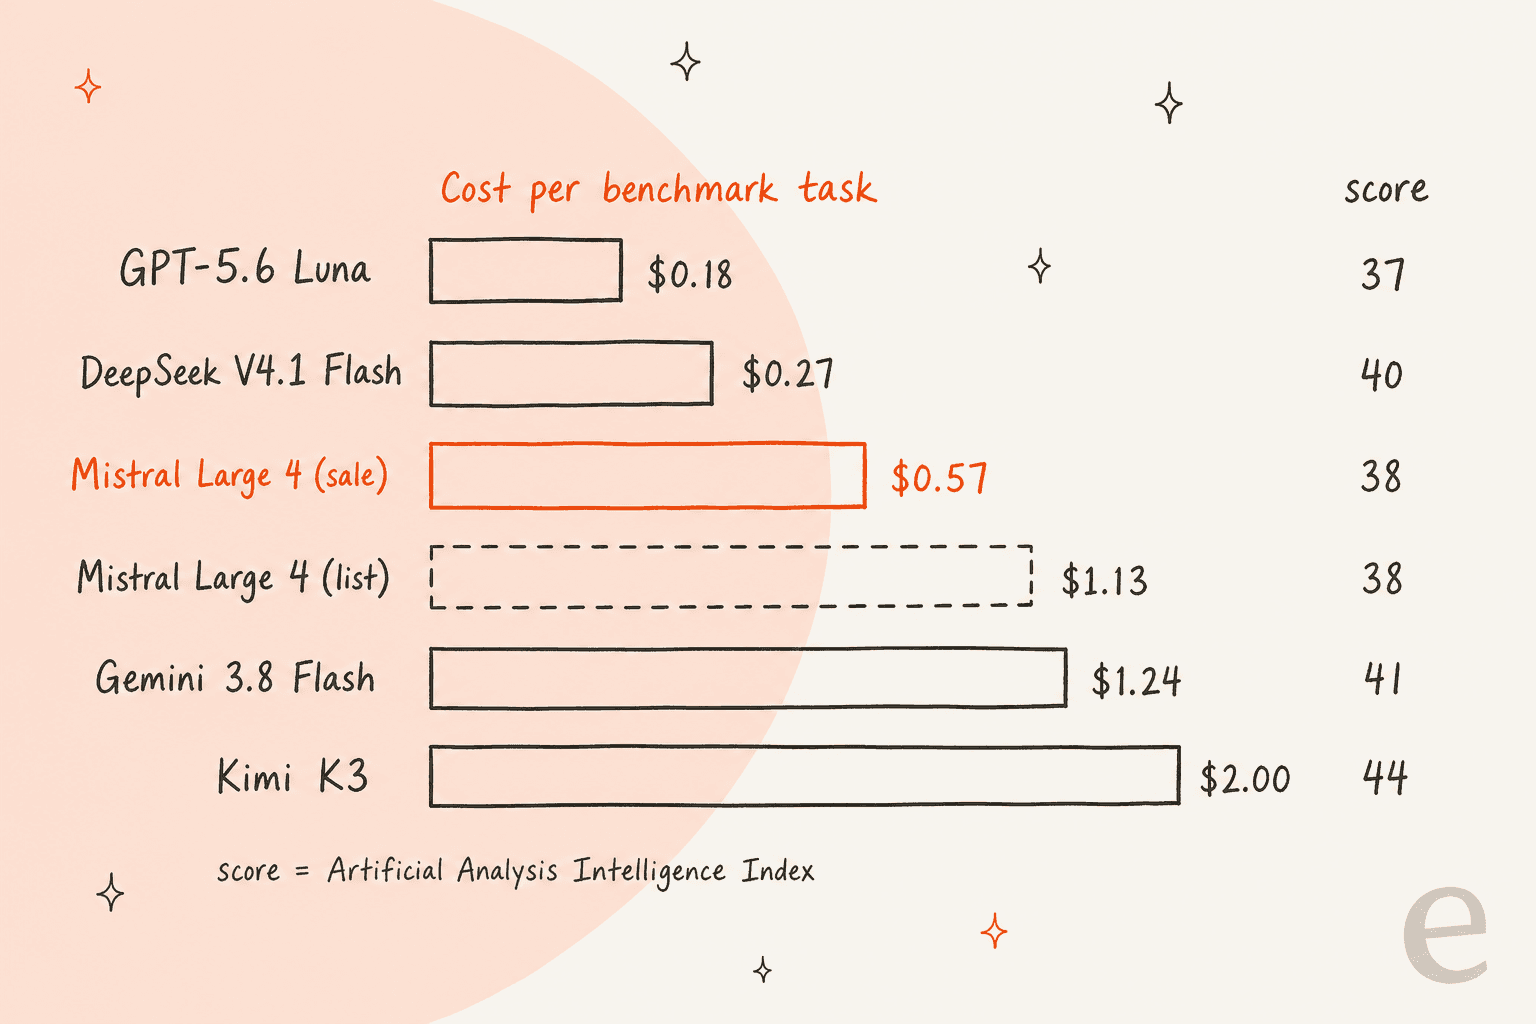
L'unité utile est donc le coût par tâche. Artificial Analysis place Large 4 à $1.13 par tâche de l'indice au prix catalogue, ce qui donne environ $0.57 au tarif promotionnel si chaque compteur est divisé par deux. À côté, le tableau compare des modèles qui se situent près de lui sur le même indice.
| Modèle | Intelligence Index | Prix entrée / sortie par 1M | Coût par tâche de l'indice | Tokens de sortie par tâche |
|---|---|---|---|---|
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.178 | 41,235 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.265 | 88,574 |
| Mistral Large 4 Preview (promo, dérivé) | 38.4 | $0.68 / $2.09 | ~$0.57 | 69,330 |
| Mistral Large 4 Preview (catalogue) | 38.4 | $1.36 / $4.18 | $1.132 | 69,330 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.243 | 71,003 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.000 | 48,455 |
| Claude Sonnet 5.5 (Xhigh) | 51.9 | $2 / $10 | $2.012 | 74,810 |
Tous les chiffres proviennent de la page Artificial Analysis de chaque modèle, consultée le 8 octobre 2026 ; la ligne au tarif promotionnel est mon calcul. Ma lecture : même en promotion, Large 4 coûte environ le double de DeepSeek V4.1 Flash par tâche pour un score à environ un point (les tarifs du modèle plus ancien figurent dans mon guide des tarifs de DeepSeek V4 Flash). Il est moins cher par tâche que Kimi K3, mais Kimi score 5 points de plus. Il en va de même pour Gemini 3.8 Flash, dont les tarifs sont dans mon guide des tarifs de Gemini 3.8 Flash.
Les lecteurs de Hacker News ont remarqué la même tension le jour du lancement. Un commentateur a apprécié la grille tarifaire sans être convaincu :
"The pricing ($.68 in/$.07 cached/$2.09 out) makes it much cheaper than Kimi K3, GLM 5.3, and Meta Muse Spark 1.3. That's great! But also much more expensive than GLM 5.3-flash and Spark 1.3 Contributor (the Meta-takes-your-data pricing of Spark 1.3)."

Un autre commentateur a cité un benchmark différent, où le coût par test allait dans l'autre sens, même face à un rival plus cher par token :
"Otherwise, behind on the broader Pareto frontier, but not by much (Vals Index: 48.05% vs. GLM-5.3's 53.51%; $13.78 vs. $7.25 per test). Many companies will prefer it over Chinease models."
Cette seconde citation résume toute la leçon : GLM 5.3 coûte plus cher par token sur la propre liste de prix de Mistral ($1.40 / $4.40 contre un catalogue à $1.36 / $4.18) et est pourtant ressorti moins cher par test dans cette exécution, parce qu'il a utilisé moins de tokens pour y arriver.
Calculateur de coût Mistral Large 4
Saisissez votre propre trafic. Le calculateur utilise les tarifs publiés par 1M ci-dessus, applique les multiplicateurs regional et Priority au prix catalogue comme le décrit la documentation de Mistral, et traite le batch comme 50% sur le tarif promotionnel. Les tokens de sortie doivent inclure le raisonnement, qui pour Large 4 a représenté environ 3 tokens de raisonnement pour chaque token de réponse sur Artificial Analysis.
Exemples concrets : ce que coûteraient trois charges de travail réelles
Les chiffres abstraits se hochent facilement de la tête. Voici des charges de travail que je m'attendrais à voir chiffrer, passées dans les tarifs publiés.
| Charge de travail | Hypothèses | Promo | Catalogue | Regional | Priority |
|---|---|---|---|---|---|
| Chatbot de support | 20,000 conversations/mois, 8,000 tokens d'entrée chacune (70% en cache), 1,200 tokens de sortie | $90.64 | $181.28 | $199.41 | $317.24 |
| Même bot, sans cache | Comme ci-dessus, 0% en cache | $158.96 | $317.92 | $349.71 | $556.36 |
| Tâches agentiques | 1,000 tâches/mois de la taille de l'indice Artificial Analysis | ~$566 | $1,132 | ~$1,245 | ~$1,981 |
| Traitement batch de documents | 1M de documents, 3,000 tokens d'entrée + 500 de sortie chacun | $3,085 | $6,170 | n/a | n/a |
Trois enseignements de ce tableau :
- Le cache vaut plus que la promotion. Sur le bot de support, activer le cache au prix catalogue ($181) égale presque le prix promotionnel sans cache ($159). Si vous structurez vos prompts de sorte que le prompt système et les extraits de base de connaissances restent en tête et stables, vous conservez l'essentiel de cette économie une fois la promotion terminée.
- Le choix du niveau fait plus bouger la facture que le choix du modèle. Le même bot va de $91 à $317 par mois selon uniquement le niveau Mistral qui le sert.
- Le traitement batch de documents est l'endroit où la promotion de Large 4 brille. Si la remise batch se cumule avec le prix promotionnel, ce traitement d'1M de documents tombe à environ $1,542. Sinon, il atteint $3,085, ce qui reste le tarif promotionnel.
Forfaits Vibe : avez-vous besoin de l'API ?
Si vous voulez simplement utiliser les modèles de Mistral pour votre propre travail plutôt que construire dessus, le côté grand public est Vibe (le produit anciennement appelé Le Chat). Tarifs tirés de la page de tarifs de Mistral :
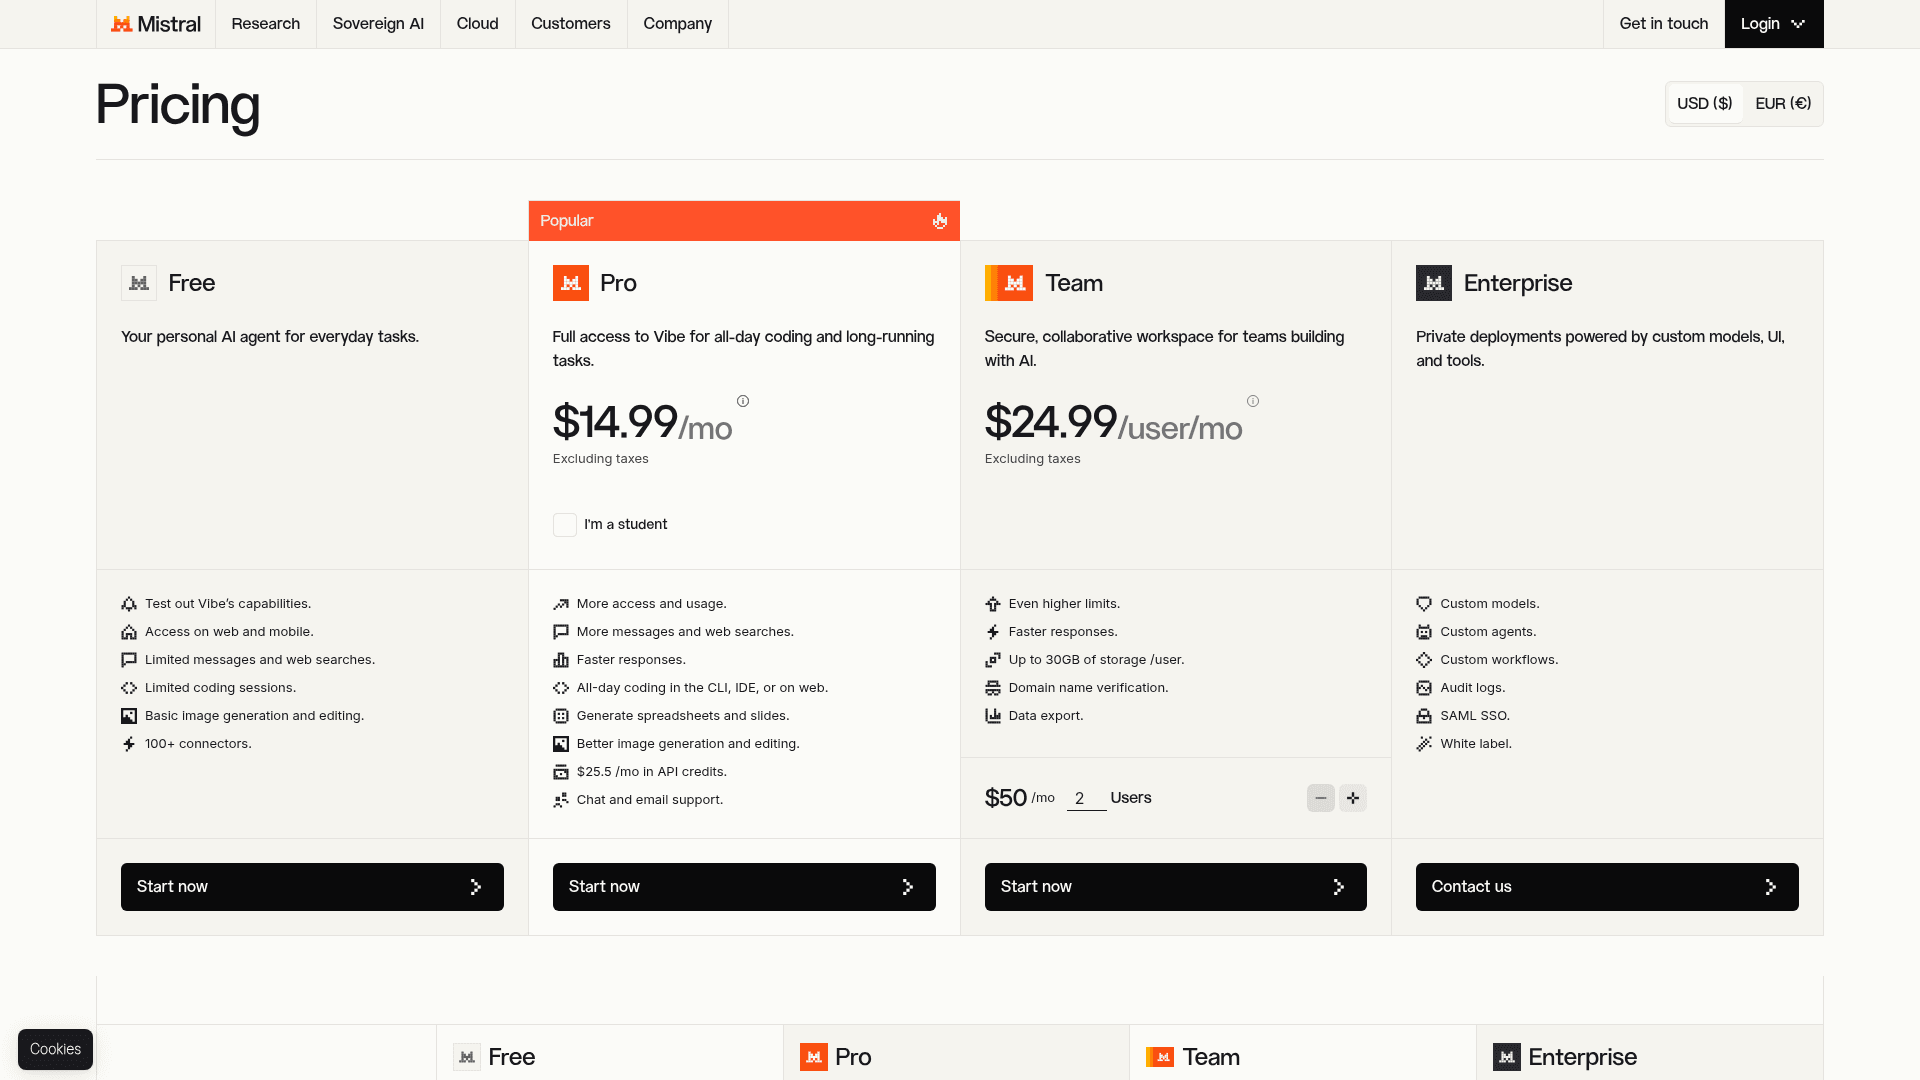
| Forfait | Prix | Ce que vous obtenez |
|---|---|---|
| Free | $0 | Messages, recherches web et sessions de code limités, plus de 100 connecteurs, accès à Mistral Studio |
| Pro | $14.99/mois | Plus d'usage, code toute la journée en CLI, IDE ou web, $25.50/mois de crédits API |
| Pro (étudiants) | $5.99/mois | Étudiants vérifiés ; $15/mois de crédits API |
| Team | $24.99/utilisateur/mois | Limites plus élevées, jusqu'à 30GB de stockage par utilisateur, vérification de domaine, export de données ; le calculateur de la page démarre à 2 utilisateurs ($50/mois) |
| Enterprise | Contacter les ventes | Modèles et agents personnalisés, journaux d'audit, SAML SSO, marque blanche |
Un détail à signaler : le forfait Pro inclut $25.50 par mois de crédits API. Au tarif promotionnel, cela représente environ 12M de tokens de sortie de Large 4, largement de quoi prototyper avant de vous engager sur l'API. Ce que la page ne dit pas, c'est quels forfaits Vibe exécutent Large 4 dans l'application de chat elle-même, donc ne supposez pas que Free reçoit le modèle phare. Mon tour d'horizon des avis sur Mistral AI et la comparaison ChatGPT vs Mistral couvrent Vibe comme espace de travail plus en profondeur.
Auto-hébergement : le prix après la sortie des poids
Mistral dit que Large 4 est open-weight, avec des poids annoncés pour "end of October." Aujourd'hui, aucune licence n'est nommée et il n'y a pas de poids publics, donc le prix de l'auto-hébergement reste une prévision. Deux faits la façonnent.
D'abord, la taille. La fiche du modèle indique 1.05T de paramètres au total et 52B actifs, plus un encodeur de vision de 1.6B. Faire tourner un modèle de 1T de paramètres demande un serveur multi-GPU, pas un portable. La réponse la plus likée au tweet de lancement de Mistral le dit mieux que moi :
"me with 12 GB of VRAM reading "open weights, 1.05T parameters""
Ensuite, la licence. La FAQ tarifaire de Mistral dit que ses modèles open-weight sont "Apache 2.0 licensed for research/individual use; while commercial deployments require a Mistral license with separate terms." Cette phrase concerne des modèles plus anciens comme Mistral 7B, et la licence de Large 4 n'est pas publiée, mais c'est une raison de ne pas supposer que "open weights" signifie "gratuit pour un usage commercial". Si l'auto-hébergement est votre plan, attendez le texte de la licence avant de chiffrer les GPU. En attendant, les agents IA open source construits sur des modèles déjà publiés sont le pari le plus sûr.
Mistral Large 4 vaut-il son prix ?
La réponse dépend de la force de Mistral que vous payez, donc je serais précis.
Il vaut le coup si :
- Vous avez besoin d'une inférence hébergée dans l'UE par un fournisseur européen. C'est le cas le plus clair, et même à 1.1x le catalogue vous payez $4.60 par 1M de tokens de sortie, ce qui reste bien en dessous de la plupart des modèles de pointe américains. Un commentateur Reddit sur r/singularity a résumé le compromis :
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."

- Votre travail correspond à ses points forts en benchmark. Les graphiques de Mistral le montrent en tête en cyberdéfense et sur le benchmark d'agent juridique de Harvey, et Lample affirme qu'il obtient 82% en reproduction et correction de vulnérabilités. Pour ces tâches, $0.57 la tâche est un bon rapport qualité-prix.
- Vous lancez de gros traitements batch pendant la promotion. Le travail sur documents à long contexte à $0.68 en entrée est peu cher, et Artificial Analysis note son raisonnement à long contexte à 81.3%.
Passez votre chemin si :
- Vous voulez le modèle le moins cher à ce niveau d'intelligence. DeepSeek V4.1 Flash et GPT-5.6 Luna s'approchent à environ un point pour un tiers à la moitié du coût par tâche. Mon test de DeepSeek V4 Flash couvre le côté DeepSeek. Pour les niveaux d'OpenAI, voir les tarifs de GPT-5.6.
- La justesse factuelle compte. Artificial Analysis a mesuré un taux d'hallucination de 41.9% sur son test de connaissances AA-Omniscience. Pour tout ce qui est en contact avec les clients, cela signifie fonder chaque réponse sur vos propres documents avec du RAG.
- Vous avez besoin de tarifs stables pendant un an. Un modèle en préversion avec un préavis de dépréciation d'un mois et une promotion sans date est une cible mouvante.
Pour une vue plus large de la position de Large 4, voyez mon tour d'horizon de Mistral Large 4 ou la liste des alternatives à Mistral.
Si vous choisissez entre fournisseurs plutôt qu'entre modèles, Claude vs Mistral compare les produits complets. Mon comparatif Gemini vs Mistral aussi.
Ce que le prix par token laisse de côté pour les équipes de support
Beaucoup de gens qui chiffrent Large 4 cette semaine le font pour un seul usage : un bot de support. Si c'est votre cas, le tableau ci-dessus montre déjà la partie désagréable. Même aux tarifs Priority, la facture du modèle pour 20,000 conversations se chiffre en quelques centaines de dollars. Ce qui coûte cher, c'est tout ce qui entoure le modèle : la récupération d'informations, les solutions de repli, les tests, la connexion au helpdesk, et aussi la personne qui maintient le tout.
C'est le compromis que Karel, de GENERAL BYTES, client d'eesel, a décrit en choisissant de ne pas construire lui-même :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
L'autre chose qu'un modèle moins cher ne réglera pas, c'est un bot qui répond quand il ne devrait pas. Avec un taux d'hallucination de 41.9% sur les questions de connaissances, les garde-fous comptent plus que la grille tarifaire : répondre uniquement à partir de vos propres documents, passer la main quand le doute s'installe avec un human in the loop, et tester sur de vrais tickets passés avant la mise en ligne. Mon article sur les hallucinations de l'IA dans le support couvre les modes de défaillance.
Si vous en êtes encore au choix du modèle, mes guides sur le meilleur LLM pour le support et sur comment entraîner un agent de support IA approfondissent les deux moitiés du travail.
À mes yeux, le modèle est de l'infrastructure, et ce qu'une équipe de support veut embaucher, c'est l'employé qui l'utilise. Pour un regard plus large sur cette catégorie, voyez le comparatif des meilleurs logiciels de helpdesk IA.
Essayer eesel
Si vous êtes venu chiffrer Mistral Large 4 pour un bot de support, il existe un raccourci. Le coéquipier helpdesk IA d'eesel rejoint votre file Zendesk, Freshdesk ou Gorgias existante, apprend de vos anciens tickets et de votre centre d'aide, et lance une simulation sur des centaines de vos anciens tickets avant de répondre à un client. Il est facturé par ticket traité, à partir de $299 pour 500 crédits sur la page de tarifs, donc que le modèle en dessous réfléchisse sur 1,000 ou 50,000 tokens, c'est le problème d'eesel, pas votre facture. Deux remarques honnêtes : eesel fonctionne avec des modèles d'OpenAI, d'Anthropic et de Google, pas de Mistral, et la résidence des données dans l'UE est une option à $500/mois.

Les développeurs peuvent aussi le configurer depuis un terminal : la CLI eesel affiche du JSON pour chaque commande, de sorte que Claude Code ou Cursor peuvent connecter votre helpdesk, modifier les instructions et lancer des chats de test pour vous. Le forfait gratuit inclut 100 crédits sans carte. Essayer eesel.