

GPT-6.2 Sol coûte 2 $ par million de tokens en entrée, 0,10 $ en cache et 10 $ en sortie, exactement ce que coûtait GPT-6.1 Sol. Par tâche difficile, il est environ 20 % moins cher, parce qu'il utilise moins de tokens. Mais un simple changement de modèle peut coûter plus cher à deux endroits. Dans mon test, GPT-6.2 Sol n'a rien mis en cache depuis le champ instructions de premier niveau, alors que 6.1 Sol le faisait, ce qui transforme 5,45 $ pour 1 000 tickets de support en 29,20 $. Et il n'y a plus de palier Flex, donc les tâches qui tournaient sur 6.1 Sol Flex coûtent maintenant 20 % à 100 % plus cher, sauf à passer à l'API Batch.
Combien coûte GPT-6.2 Sol ?
GPT-6.2 Sol coûte 2 $ par million de tokens en entrée et 10 $ par million de tokens en sortie au palier Standard, avec une entrée mise en cache à 0,10 $. OpenAI l'a lancé le 17 novembre 2026 avec GPT-6.2 Astra, et le billet de lancement dit qu'il « reprend les tarifs de GPT-6.1 Sol ». Si vous vous intéressez au modèle lui-même, l'aperçu de GPT-6.2 Sol couvre ce qui a changé et ses performances aux benchmarks.
Si vous l'évaluez pour une file de support, un coéquipier IA du helpdesk comme eesel se passe du compteur de tokens, et avec la CLI eesel, un agent de code peut charger des articles d'aide approuvés et tester des questions avant que rien ne passe en direct. Connecter le helpdesk lui-même nécessite toujours qu'un administrateur l'approuve.
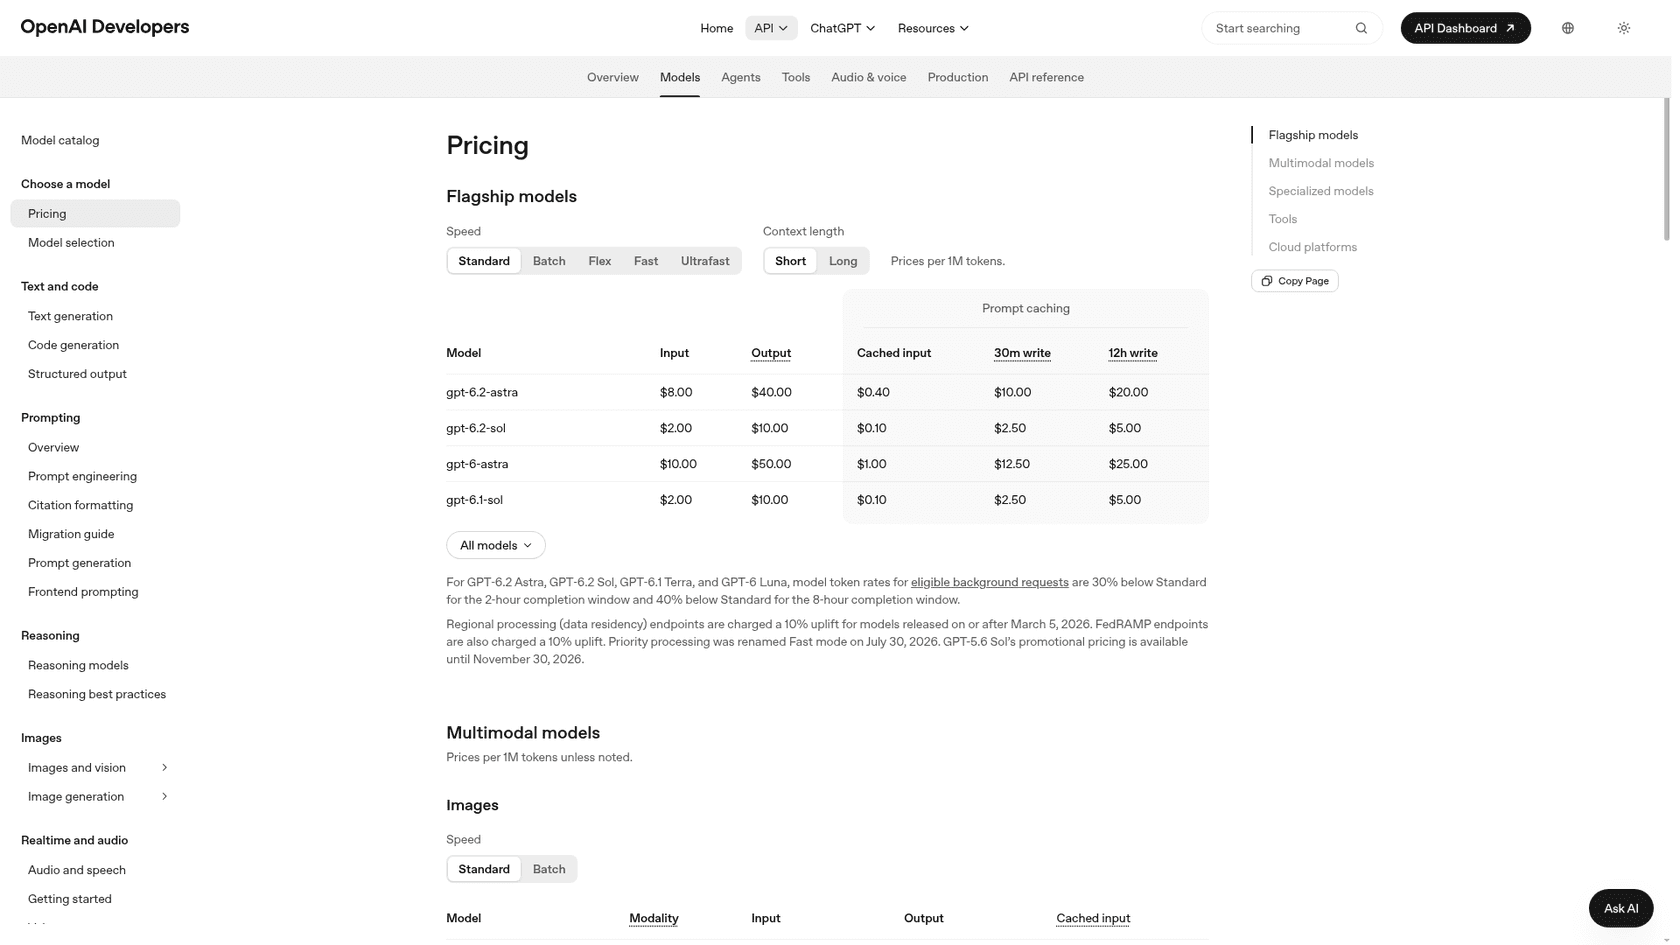
Je passe une bonne partie de ma semaine à observer comment les gens cherchent les prix des modèles, et la question derrière « tarifs GPT-6.2 Sol » est presque toujours la même : est-ce que la mise à niveau va changer ma facture ? J'ai donc fait le calcul comme eesel le fait pour un agent de support, par ticket, et j'ai mené mon propre test de cache sur les deux versions de Sol. Voici chaque compteur de la page tarifaire d'OpenAI et de la page du modèle GPT-6.2 Sol, par million de tokens :
| Palier | Entrée | Entrée mise en cache | Écriture de cache 30 min | Écriture de cache 12 h | Sortie |
|---|---|---|---|---|---|
| Standard | 2,00 $ | 0,10 $ | 2,50 $ | 5,00 $ | 10,00 $ |
| Standard, plus de 272 000 en entrée | 4,00 $ | 0,20 $ | n/a | n/a | 15,00 $ |
| Batch | 1,00 $ | 0,05 $ | 1,25 $ | 2,50 $ | 5,00 $ |
| Background, fenêtre de 8 heures | 1,20 $ | 0,06 $ | 1,50 $ | 3,00 $ | 6,00 $ |
| Background, fenêtre de 2 heures | 1,40 $ | 0,07 $ | 1,75 $ | 3,50 $ | 7,00 $ |
| Fast | 4,00 $ | 0,20 $ | 5,00 $ | 10,00 $ | 20,00 $ |
| Ultrafast (jusqu'au 28 fév. 2027) | 6,00 $ | 0,30 $ | 7,50 $ | 15,00 $ | 30,00 $ |
| Ultrafast (à partir du 1er mars 2027) | 12,00 $ | 0,60 $ | 15,00 $ | 30,00 $ | 60,00 $ |
| Flex | Non proposé |
Les lignes background sont mon calcul à partir de la règle d'OpenAI selon laquelle les requêtes en arrière-plan éligibles tournent « 30 % sous Standard pour la fenêtre de 2 heures et 40 % sous Standard pour la fenêtre de 8 heures ». La ligne contexte long vient de la page du modèle : au-delà de 272 000 tokens en entrée, les tarifs d'entrée et de cache doublent et la sortie coûte 1,5 fois le tarif contexte court pour toute la requête. Elle ne liste pas de tarifs d'écriture de cache en contexte long, donc j'ai laissé ces cases vides.
Le modèle a une fenêtre de contexte de 1 050 000 tokens, 922 000 tokens d'entrée maximum, 128 000 tokens de sortie maximum et une date de coupure des connaissances au 1er juin 2026. L'API « rejette aussi les requêtes qui fixent l'effort de raisonnement à none », donc low est le réglage le moins cher que vous puissiez choisir. Les points de terminaison régionaux de résidence des données coûtent 10 % de plus, comme pour tout modèle lancé après le 5 mars 2026.
De quoi êtes-vous exactement facturé ?
Chaque requête GPT-6.2 Sol tombe sur jusqu'à quatre compteurs, facturés très différemment :
- Entrée fraîche à 2 $ par million : le message du client et tout ce qui a changé.
- Entrée mise en cache à 0,10 $ par million : la partie au début du prompt qui correspond exactement à une requête récente.
- Écritures de cache à 2,50 $ (30 minutes) ou 5 $ (12 heures) par million : la première fois qu'un préfixe réutilisable est enregistré.
- Sortie à 10 $ par million : la réponse, plus tout token de raisonnement caché, facturé comme sortie par le guide du raisonnement d'OpenAI.
Le guide de cache des prompts d'OpenAI dit que les écritures de cache « ne sont pas des frais additionnels » : chaque token d'entrée est facturé une fois, à l'un des trois tarifs d'entrée. Les lectures sur GPT-6.2 Sol coûtent « 0,05 fois le tarif d'entrée normal », une réduction de 95 %, alors que la plupart des autres modèles OpenAI récents offrent 90 %. Le préfixe minimal pouvant être mis en cache est de 1 024 tokens.
Cela fait qu'un token mis en cache coûte un vingtième du prix d'un token frais. Sur toute application qui envoie les mêmes instructions ou les mêmes connaissances à chaque appel, le taux d'accès cache compte plus que le prix catalogue. C'est pourquoi le résultat suivant m'a surpris.
GPT-6.2 Sol met-il vraiment votre prompt en cache ?
Seulement si le prompt est au bon endroit. Je l'ai testé le 18 novembre 2026 via l'API Responses : un centre d'aide de 8 300 tokens pour une entreprise SaaS fictive, trois questions clients différentes à la suite, effort faible, chaque cas exécuté deux fois sur les deux modèles Sol. La seule variable était l'emplacement du centre d'aide.
| Modèle | Emplacement du prompt | Appel 1 | Appels 2 et 3 |
|---|---|---|---|
| GPT-6.1 Sol | instructions de premier niveau | 8 295 tokens écrits en cache | 8 283 tokens lus depuis le cache |
| GPT-6.1 Sol | Message developer | 8 295 écrits | 8 283 lus |
| GPT-6.2 Sol | instructions de premier niveau | 0 écrit | 0 lu |
| GPT-6.2 Sol | Message developer | 8 295 écrits | 8 283 lus |
Les deux séries ont donné des chiffres identiques. Le même code qui mettait parfaitement en cache sur GPT-6.1 Sol arrête donc de le faire dès que vous changez l'ID du modèle pour gpt-6.2-sol, sans aucune erreur. Vous payez alors 2 $ par million sur chaque token de prompt au lieu de 0,10 $. Le test du jour de lancement d'eesel sur GPT-6.2 Astra a montré le même comportement, ce qui ressemble donc à un changement de toute la génération 6.2, pas une particularité de Sol.
La documentation d'OpenAI va dans le même sens sans le dire explicitement. Le guide de cache indique que « les instructions de premier niveau ne peuvent pas contenir de point de rupture explicite », et que les instructions developer réutilisables vont « dans un bloc input_text à l'intérieur d'un message developer ». Le billet de lancement recommande aussi de « garder les préfixes de prompt inchangés et d'ajouter les nouvelles instructions à la fin ».
Voici ce que cela fait à un agent de support qui réutilise un prompt de 12 500 tokens (instructions plus contenu du centre d'aide) avec 600 tokens d'entrée nouvelle et 300 tokens de sortie par ticket :
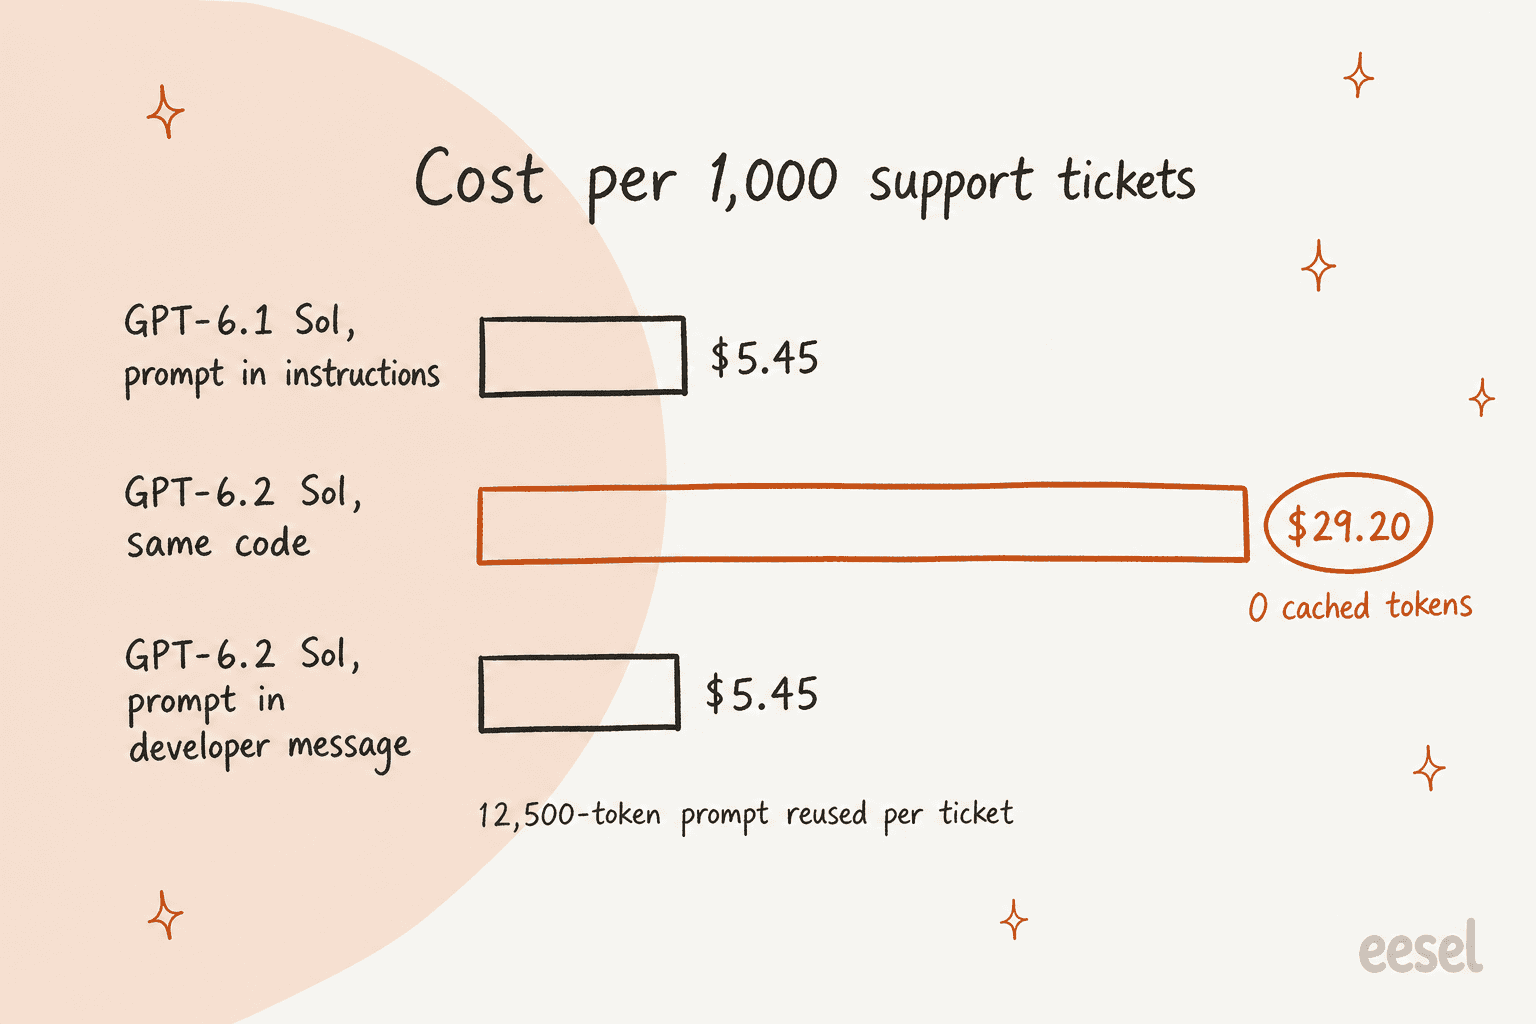
C'est une multiplication par 5,4 du coût par ticket pour une mise à niveau de modèle censée être neutre en prix. La correction tient en quelques lignes : déplacez le prompt dans un message developer, puis vérifiez cached_tokens dans le bloc usage de vos premiers appels. Si vous avez migré directement depuis GPT-5.6 Sol ou une version antérieure, le guide de migration d'OpenAI recommande aussi de remplacer prompt_cache_retention par prompt_cache_options.ttl.
Qu'est devenu le tarif Flex ?
GPT-6.2 Sol ne l'a pas. Le tableau Flex d'OpenAI liste GPT-6.1 Sol à 1 $/5 $, avec GPT-6 Astra, GPT-6.1 Terra et GPT-6 Luna, mais aucune ligne pour 6.2 Sol :
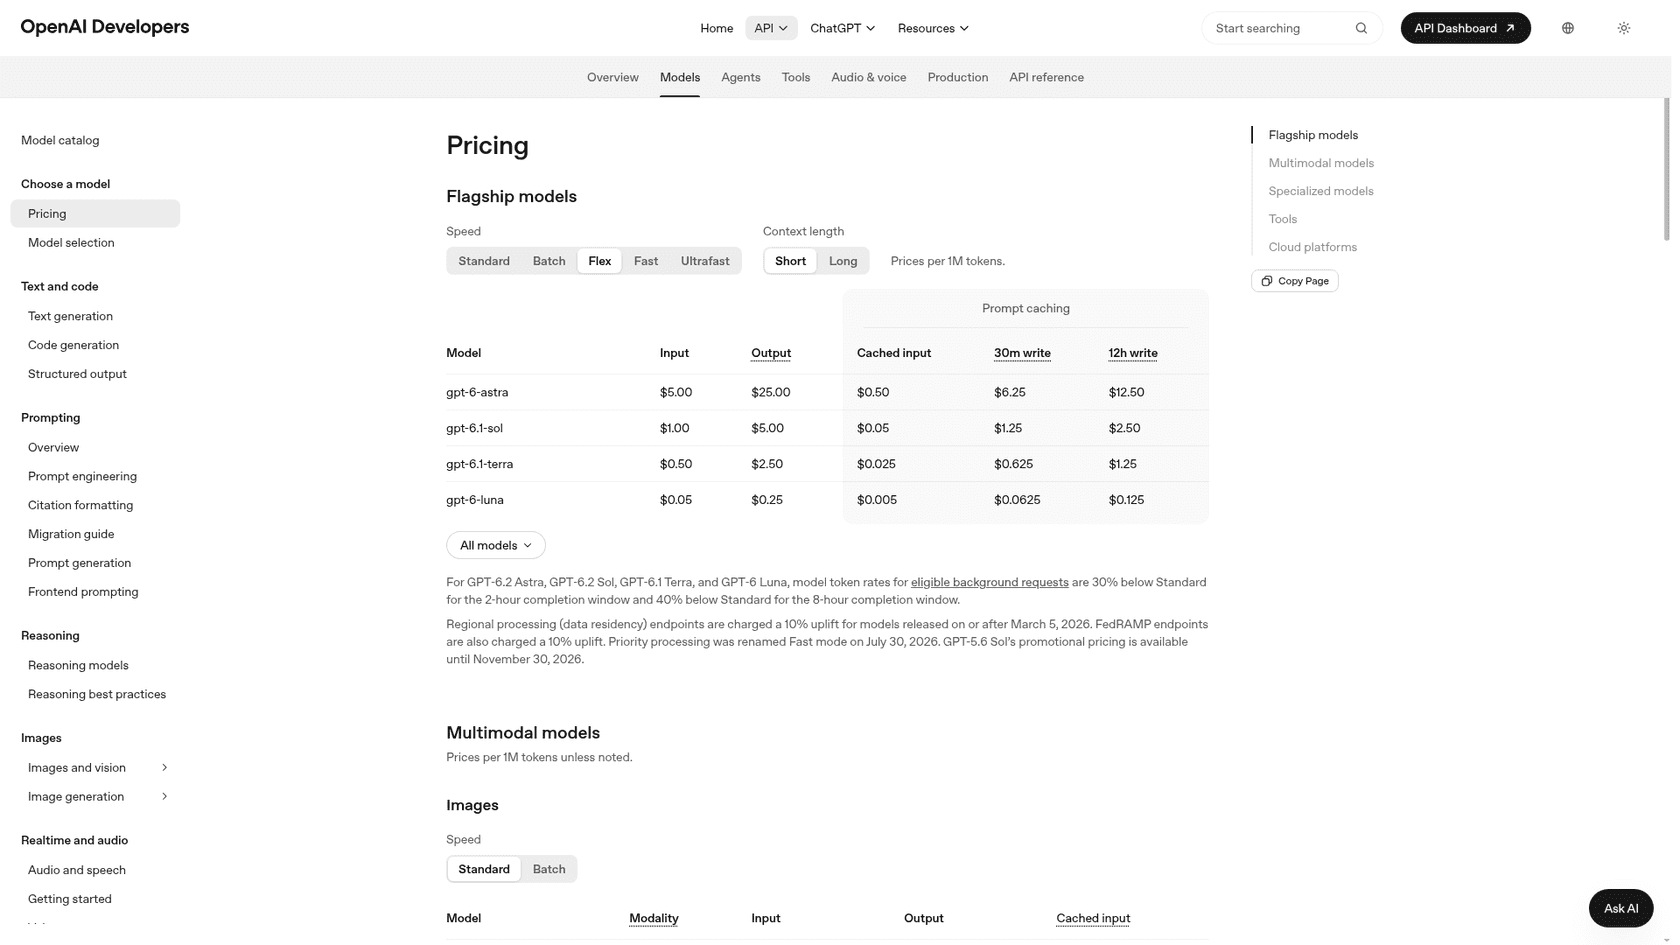
Des développeurs l'ont remarqué quelques heures après le lancement :
"Did they remove the flex pricing? I see it here:- https://developers.openai.com/api/docs/models/gpt-6.1-sol but not here:- https://developers.openai.com/api/docs/models/gpt-6.2-sol"

Flex comptait parce qu'il tarifait les tokens « aux tarifs de l'API Batch », selon le guide Flex d'OpenAI, tout en répondant à un appel d'API normal, juste plus lentement et avec une « disponibilité des ressources parfois réduite ». Il convenait aux evals, à l'enrichissement de données et aux travaux de nuit. Sur GPT-6.2 Sol, ces tâches ont trois routes de réduction, chacune avec un piège :
- API Batch (50 % de réduction). Même prix que l'ancien Flex, mais vous soumettez un fichier et récupérez les résultats plus tard, donc le code change.
- Background, fenêtre de 8 heures (40 % de réduction). Un flag sur un appel Responses normal, mais 20 % plus cher que Flex.
- Background, fenêtre de 2 heures (30 % de réduction). Plus rapide, mais 40 % plus cher que Flex.
Selon le guide background d'OpenAI, les fenêtres à prix réduit sont en bêta publique, nécessitent un traitement Standard et partagent la limite de débit de Batch. Il y a aussi un piège de cache : « les requêtes Standard hors des fenêtres de complétion à prix réduit ne peuvent pas réutiliser les entrées de cache de prompt créées par des requêtes en arrière-plan de 2h ou 8h, même quand le prompt est identique ». Vous ne pouvez donc pas chauffer un cache pendant la nuit et le lire à bas prix depuis votre application en direct.
Voici un travail de nuit, étiquetant 50 000 anciens tickets avec environ 2 000 tokens en entrée et 200 en sortie chacun :
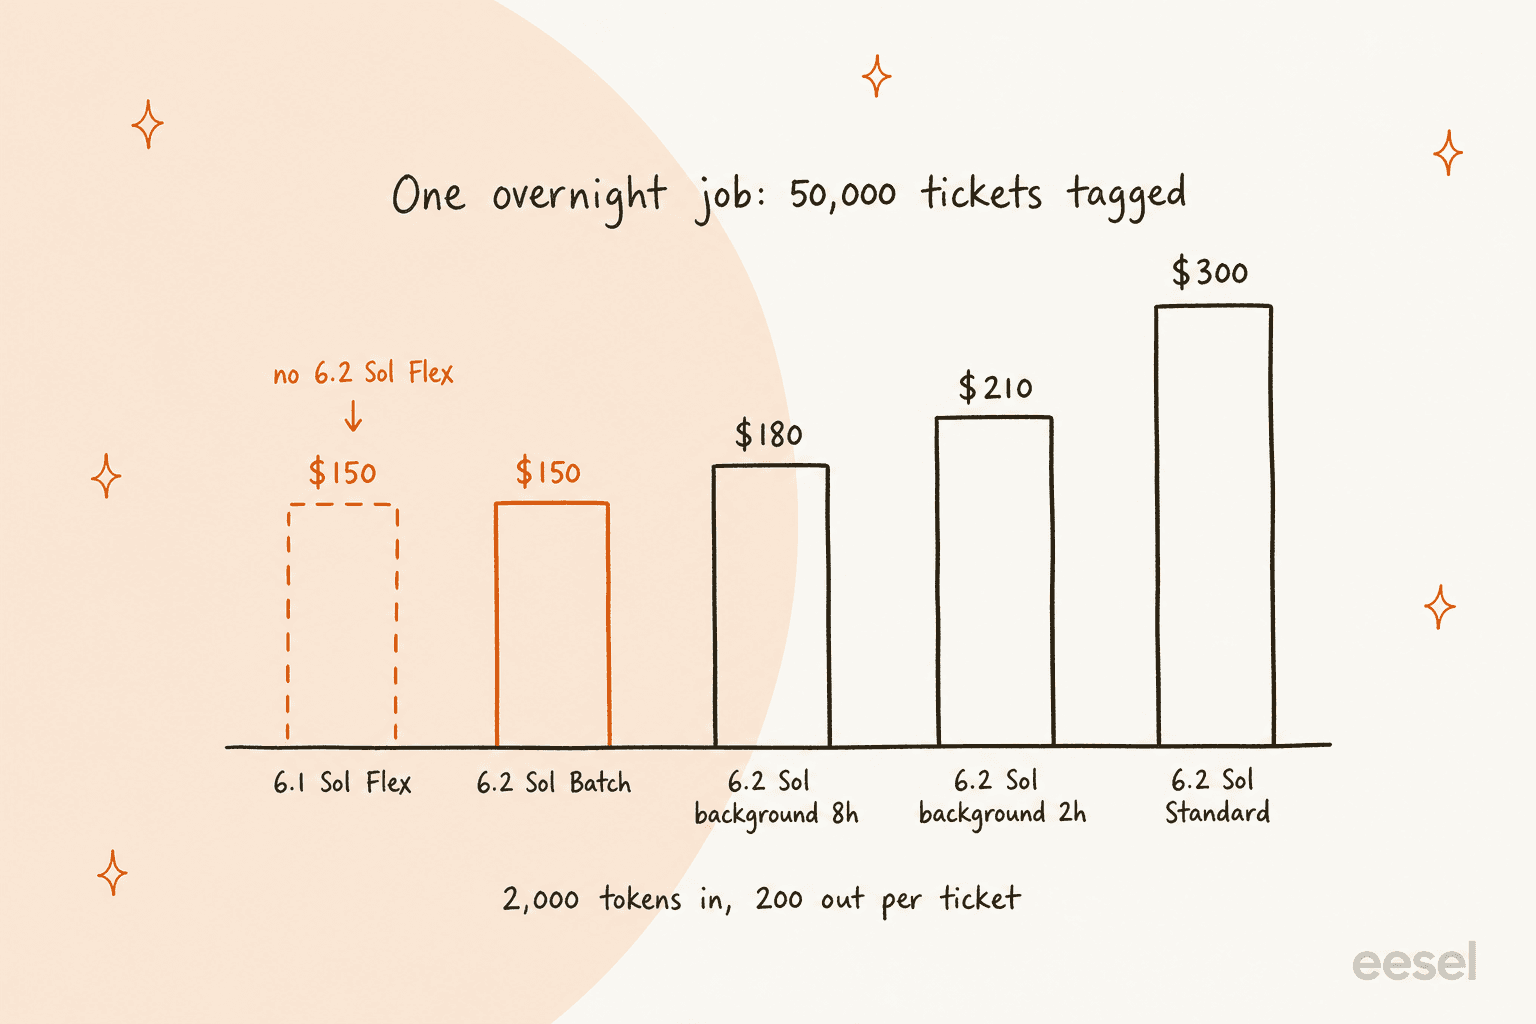
Si un tel travail tourne chaque nuit, l'écart entre Batch et Standard est de 4 500 $ par mois. Pour du simple étiquetage ou du triage, un modèle plus petit peut offrir la meilleure économie : GPT-6.1 Terra a toujours Flex à 0,50 $/2,50 $, et GPT-6 Luna descend encore plus bas.
GPT-6.2 Sol est-il moins cher par tâche que GPT-6.1 Sol ?
Sur du travail long et difficile, oui, d'environ 20 %. Sur des réponses courtes, il est un peu plus cher. Les deux sont vrais, et ce que vous ressentez dépend de combien le modèle doit réfléchir.
Artificial Analysis chiffre le coût pour faire tourner son Intelligence Index à 1,01 $ par tâche pour GPT-6.2 Sol contre 1,27 $ pour GPT-6.1 Sol à effort maximal, avec un score de 57 contre 55. Mêmes tarifs, moins de tokens : Artificial Analysis a compté 60,9 millions de tokens de sortie pour 6.2 Sol à max contre 63,7 millions pour 6.1 Sol. Il place aussi 6.2 Sol « au niveau de GPT-6 Astra pour environ 15 % du coût par tâche ».
Les réponses de support courtes racontent une autre histoire. Dans le test de 60 tickets d'eesel pour la revue de GPT-6.2 Sol, avec 15 tickets à effort faible et moyen sur les deux modèles, chaque configuration a réussi les 15 :
| Configuration | Coût pour 1 000 tickets | Tokens de sortie moyens |
|---|---|---|
| GPT-6.2 Sol, moyen | 1,42 $ | 60 |
| GPT-6.2 Sol, faible | 1,41 $ | 58 |
| GPT-6.1 Sol, moyen | 1,35 $ | 55 |
| GPT-6.1 Sol, faible | 1,32 $ | 52 |
GPT-6.2 Sol a écrit des réponses légèrement plus longues, et au même prix par token, cela explique la majeure partie de la différence de 5 % à 7 %. Ces tickets utilisaient un prompt court sans centre d'aide, ce qui explique pourquoi ils sont si bon marché face à l'exemple de 12 500 tokens plus haut.
Sur Hacker News, un développeur lisant les graphiques d'OpenAI est arrivé à la même conclusion sur le compromis d'effort :
"Looks like 6.1-sol high+ is equivalent to 6.2-sol medium at the same price. So a bit smarter at a cheaper cost."
Quel effort de raisonnement devriez-vous payer ?
Pour la plupart des applications, moyen. Les tokens de raisonnement sont facturés comme de la sortie à 10 $ par million, donc l'effort est autant un réglage de prix que de qualité. Artificial Analysis a compté ces tokens de sortie sur tout son Intelligence Index pour GPT-6.2 Sol :
| Effort | Indice d'intelligence AA | Tokens de sortie pour faire tourner l'indice | Sortie vs max |
|---|---|---|---|
| Faible | 41 | 7,2 M | 12 % |
| Moyen | 53 | 14,6 M | 24 % |
| Élevé | 55 | 22,7 M | 37 % |
| Xhigh | 56 | 33,3 M | 55 % |
| Max | 57 | 60,9 M | 100 % |
Moyen conserve 53 des 57 points de max avec un quart des tokens de sortie. Passer de xhigh à max double presque la sortie pour un seul point de plus. Le guide de migration d'OpenAI recommande aussi de démarrer les nouvelles intégrations à medium.
Sur les tâches courtes comme les réponses de support, le réglage se remarque à peine. Les tests à effort faible et moyen dans ce test de tickets coûtaient 1,41 $ et 1,42 $ pour 1 000 tickets, parce que le modèle réfléchit très peu avant une réponse de trois phrases, dans les deux cas. Passez votre temps de réglage sur le cache, pas sur l'effort, sauf si votre agent exécute de longues tâches à plusieurs étapes.
Que coûterait GPT-6.2 Sol pour votre volume ?
Entrez vos propres chiffres dans le calculateur. Il compare GPT-6.2 Sol à GPT-6.1 Sol et GPT-6.2 Astra sur la même charge, avec les tarifs publiés par OpenAI. Les échecs de cache sont facturés comme des écritures de cache de 30 minutes. Le sélecteur d'emplacement du prompt applique ce que j'ai observé dans mon test : sur les modèles 6.2, un prompt dans le champ instructions de premier niveau est facturé comme une entrée fraîche à chaque appel.
Avec les valeurs par défaut, 8 000 requêtes par mois avec un taux d'accès cache de 95 % coûtent 55,60 $ sur GPT-6.2 Sol. Basculez l'emplacement du prompt sur le champ instructions, et le même mois coûte 233,60 $, alors que GPT-6.1 Sol reste à 55,60 $. Changez le palier pour une fenêtre background et vous verrez l'écart Flex de la section précédente.
Que coûte GPT-6.2 Sol selon la taille de l'équipe ?
Voici la charge de support de 12 500 tokens à trois volumes mensuels, aux tarifs Standard. La colonne du milieu suppose que le prompt est dans un message developer avec un taux d'accès de 95 % ; la troisième montre ce qui se passe quand il est dans le champ instructions.
| Tickets par mois | GPT-6.2 Sol, en cache | GPT-6.2 Sol, champ instructions | GPT-6.2 Sol, Batch | GPT-6.2 Astra, en cache |
|---|---|---|---|---|
| 1 000 | 6,95 $ | 29,20 $ | 3,48 $ | 27,80 $ |
| 8 000 | 55,60 $ | 233,60 $ | 27,80 $ | 222,40 $ |
| 50 000 | 347,50 $ | 1 460,00 $ | 173,75 $ | 1 390,00 $ |
Batch ne convient qu'au travail que personne n'attend, comme rédiger des résumés des tickets de la semaine passée. Les réponses en direct restent sur Standard. Le détail des tarifs GPT-6.2 Astra montre pourquoi Astra coûte quatre fois plus sur la même charge.
Pour donner une idée d'échelle, MentorShow, une plateforme française d'apprentissage en ligne, a indiqué à eesel qu'elle reçoit entre 5 000 et 13 000 tickets par mois. Son agent eesel lit chaque nouvelle conversation HubSpot, vérifie la fiche du membre et une base de connaissances de 123 articles, et laisse une note interne avec un brouillon de réponse dans la langue du membre. À ce volume, les tokens de GPT-6.2 Sol avec un cache qui fonctionne reviennent à environ 35 $ à 90 $ par mois. Avec le bug du champ instructions, 146 $ à 380 $.
Dans tous les cas, les tokens sont la petite ligne du coût du service client IA. Les plus grosses lignes sont le retrieval, le function calling pour les recherches de commandes, les règles d'escalade et l'observabilité pour voir ce que l'agent a dit.
C'est pourquoi le coût d'un agent de support IA dépend bien plus de construire ou acheter que du modèle.
GPT-6.2 Sol est-il moins cher que Claude Sonnet 5.5 ?
Au prix catalogue, ils sont identiques. La page tarifaire d'Anthropic liste Claude Sonnet 5.5 à 2 $ en entrée, 10 $ en sortie et 0,10 $ pour les lectures de cache par million de tokens. Les différences sont dans les petites lignes :
| Par million de tokens | GPT-6.2 Sol | Claude Sonnet 5.5 | GPT-6.2 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Entrée | 2,00 $ | 2,00 $ | 8,00 $ | 4,00 $ |
| Sortie | 10,00 $ | 10,00 $ | 40,00 $ | 20,00 $ |
| Lecture de cache | 0,10 $ | 0,10 $ | 0,40 $ | 0,20 $ |
| Écriture de cache la moins chère | 2,50 $ (30 min) | 2,50 $ (5 min) | 10,00 $ (30 min) | 5,00 $ (5 min) |
| Écriture de cache plus longue | 5,00 $ (12 h) | 4,00 $ (1 h) | 20,00 $ (12 h) | 8,00 $ (1 h) |
| Prompts de plus de 272 000 | 2x entrée, 1,5x sortie | Même tarif jusqu'à 1M | 2x entrée, 1,5x sortie | Même tarif jusqu'à 1M |
| Batch | 50 % de réduction | 50 % de réduction | 50 % de réduction | 50 % de réduction |
Trois choses décident lequel est le moins cher pour vous :
- Les files calmes favorisent Sol. La même écriture à 2,50 $ achète 30 minutes sur Sol et 5 minutes sur Sonnet. Si les requêtes arrivent à 10 minutes d'écart, Sol garde son cache chaud alors que Sonnet le réécrit sans arrêt.
- Les prompts énormes favorisent Sonnet. Anthropic facture « le même tarif par token » sur toute la fenêtre de 1M. Une requête de 400 000 tokens avec une réponse de 4 000 tokens coûte 1,66 $ sur GPT-6.2 Sol et 0,84 $ sur Sonnet 5.5. Découper les documents sous 272 000 referme la plus grande partie de cet écart.
- Le nombre de tokens par tâche décide le reste. À tarifs égaux, le modèle qui répond en moins de tokens gagne. C'est spécifique à la charge de travail, donc testez les deux sur vos propres prompts.
Pour une comparaison plus large, Claude Opus 5.5 coûte deux fois plus par token, et meilleur modèle IA pour support compare tout le champ sur le travail de tickets.
Combien coûte GPT-6.2 Sol dans ChatGPT ?
Dans ChatGPT, vous payez un abonnement fixe, pas par token. OpenAI dit que GPT-6.2 Sol est « disponible pour tous les utilisateurs Plus, Pro, Enterprise et Edu dans ChatGPT Work et Codex », avec un accès Enterprise et Edu une fois qu'un administrateur du workspace l'active.
| Plan | Prix | Accès à GPT-6.2 Sol |
|---|---|---|
| Free | 0 $ | Non mentionné dans le billet de lancement |
| Go | 8 $/mois | Non mentionné dans le billet de lancement |
| Plus | 20 $/mois | Oui, dans ChatGPT Work et l'app Codex |
| Pro (Pro 100, Pro 200, Pro 500) | À partir de 100 $/mois | Oui ; Pro 200 obtient Ultrafast avec Sol pour la première fois, et Pro 500 obtient Ultrafast avec Sol ou Astra |
| Enterprise et Edu | Contacter les ventes | Oui, une fois qu'un administrateur l'active |
Les prix viennent de la page tarifaire de ChatGPT. Les paliers Pro incluent aussi des crédits API mensuels : 100 $, 200 $ ou 500 $ selon le niveau, sous réserve des conditions d'éligibilité d'OpenAI. Au tarif en cache de 6,95 $ pour 1 000 tickets, 200 $ de crédits couvrent environ 28 800 tickets GPT-6.2 Sol par mois. Le guide tarifs ChatGPT a le détail complet des plans.
GPT-6.2 Sol vaut-il le coup pour le support client ?
Au prix, oui. C'est un quart du coût en tokens de GPT-6.2 Astra, et il a réussi les 15 tickets du test d'eesel. Les vrais risques sont ailleurs. Artificial Analysis a mesuré un taux d'hallucination de 55 % pour Sol à effort maximal, c'est-à-dire qu'il devine plutôt que d'admettre qu'il ne sait pas. Dans ce test, il a transformé un numéro de suivi en un lien ups.com que l'outil de commande n'avait jamais fourni. Un modèle bon marché qui devine a encore besoin d'ancrage, de prévention des hallucinations et de tests sur de vrais tickets avant de répondre aux clients.
Il y a aussi la question de savoir si vous voulez une facture de tokens tout court. Elle peut bouger sans que votre code change : le cache arrête de fonctionner après une mise à niveau, un palier de réduction disparaît, ou Ultrafast double le 1er mars 2027. Lors d'un appel commercial d'eesel, un acheteur attentif au budget a dit à l'équipe que le prix d'un fournisseur précédent avait plus que doublé, et a demandé un blocage contractuel du prix avant de signer quoi que ce soit. Les tarifs par token ne peuvent pas offrir ça.
C'est l'arbitrage entre construire et acheter. Si vous construisez sur GPT-6.2 Sol, vous obtenez des tokens bon marché, plus le travail de surveiller cached_tokens, les paliers et les pages tarifaires. Si vous achetez, le choix du modèle et ses particularités de facturation deviennent le problème de quelqu'un d'autre.
Essayer eesel
Si vous évaluez les tarifs de GPT-6.2 Sol parce que vous voulez de l'IA sur votre file de support, le coéquipier IA du helpdesk d'eesel vous donne ça sans compteur de tokens. Il se connecte au helpdesk que vous utilisez déjà, apprend de vos tickets passés et de votre centre d'aide, et vous laisse le faire tourner sur des tickets historiques pour que vous lisiez chaque réponse avant qu'elle touche un vrai client. Les plans sont des forfaits de crédits fixes, à partir de 299 $ pour 500 crédits, donc un changement de cache ou un nouveau palier chez OpenAI n'apparaît pas sur votre facture.
Lesson Pro, un groupe de marques de cours particuliers, l'utilise sur deux comptes Zendesk : en un mois, il a traité 1 900 tickets, laissé 1 700 notes internes pour l'équipe, et rédigé 560 réponses à faire approuver par une personne, en répondant à partir d'environ 4 000 tickets, articles et pages web.

Vous pouvez essayer eesel gratuitement sur une partie de votre file, ou le comparer avec utiliser ChatGPT directement si vous hésitez encore à construire vous-même.
Comment obtenir la réduction sur l'entrée mise en cache de GPT-6.2 Sol ?
cached_tokensdans le bloc usage de l'API Responses pour le confirmer.