

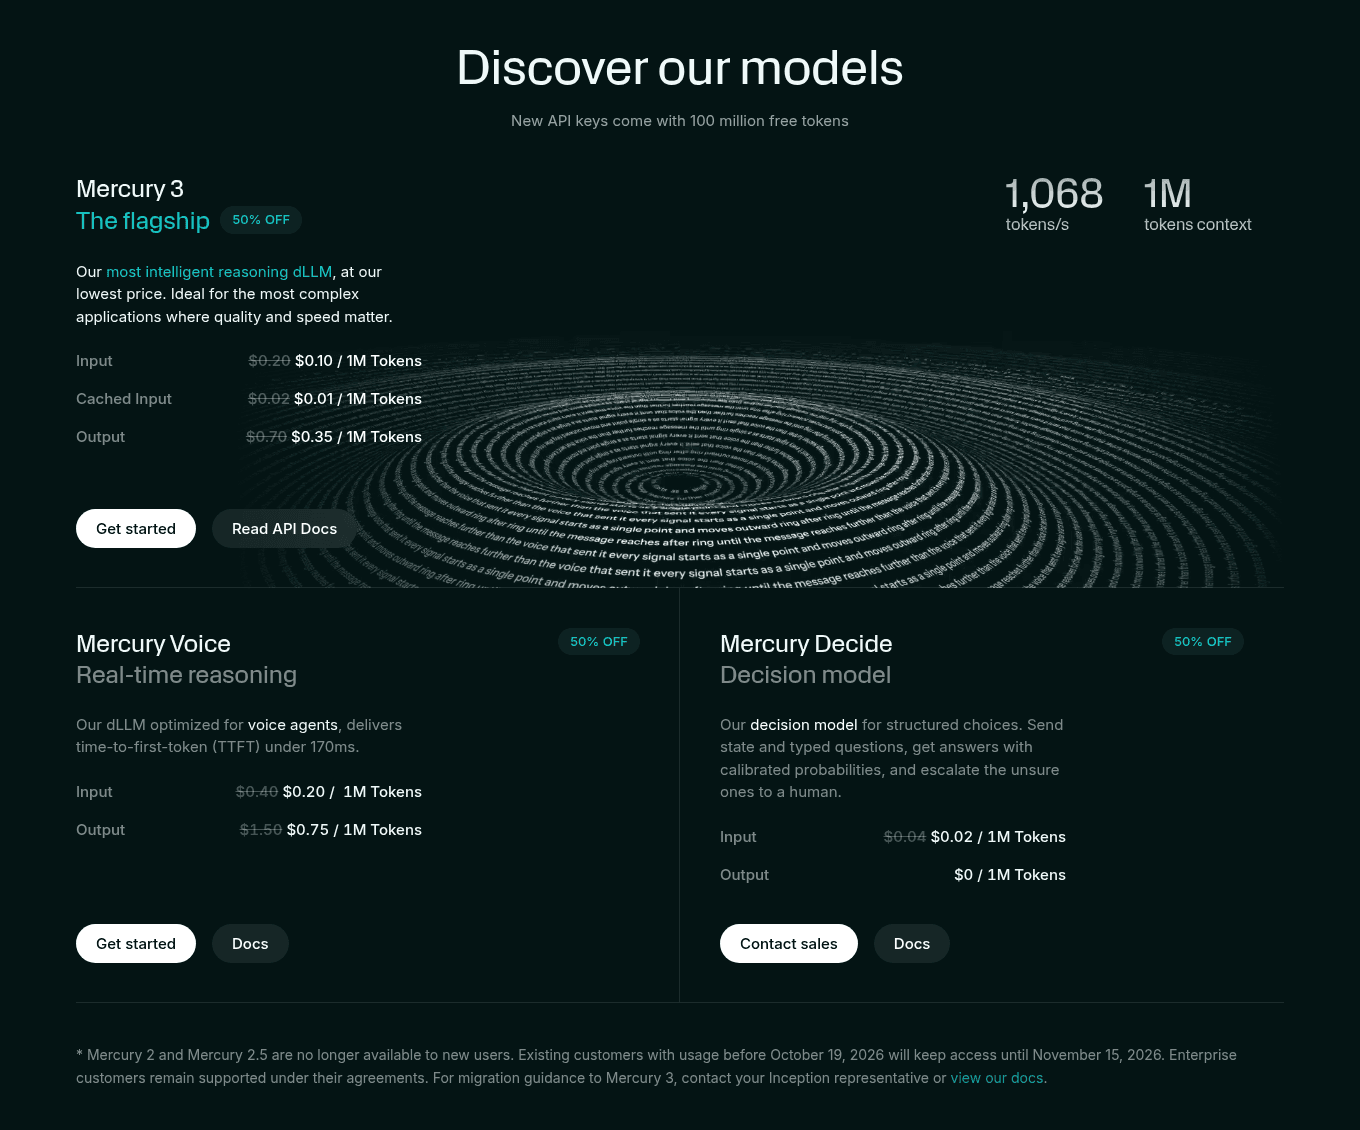
Mercury 3 coûte $0.10 par million de tokens d'entrée et $0.35 par million de sortie au lancement, avec l'entrée en cache à $0.01. C'est 50% de remise sur le vrai prix catalogue de $0.20 / $0.70 / $0.02, et Inception n'a pas dit quand elle prend fin. Les nouveaux comptes reçoivent 100 millions de tokens gratuits.
Au prix de lancement, c'est le modèle le moins cher de sa catégorie sur toutes les tâches que j'ai chiffrées. Au prix catalogue, il coûte environ 1,6 à 1,8 fois plus que GPT-6 Luna et Claude Haiku 5.5 sur des prompts courts, car la sortie est à $0.70 contre $0.50 pour eux. Au catalogue, il ne gagne que sur les prompts longs : il bat Haiku 5.5 au-delà de 100K tokens et fait à peu près jeu égal avec Luna au-delà de 272K, car Mercury 3 facture le même tarif jusqu'à 1M. Budgétez au prix catalogue et considérez la remise comme un bonus.
Si vous chiffrez Mercury 3 pour un bot de support, rappelez-vous que les tokens sont la petite ligne. Un mois de 10 000 tickets sur Mercury 3 coûte bien moins de $100 en tokens, et des semaines d'ingénierie pour tout ce qui l'entoure. C'est le vide que comble le teammate de helpdesk IA d'eesel, à un prix mensuel fixe par ticket, avec l'intégration et les tests déjà construits.
Pourquoi je l'ai chiffré par tâche, pas par token
Je construis des intégrations et des API pour gagner ma vie, et la première chose que je fais avec n'importe quel nouveau modèle est de lire l'objet usage qu'il renvoie. Un tarif par million de tokens n'est que l'étiquette. Ce que vous payez vraiment dépend du nombre de tokens qu'une tâche consomme, du nombre d'entre eux qui sont en cache et du nombre de tokens de raisonnement que vous ne voyez jamais. Pour cet article, j'ai donc chiffré Mercury 3 comme je le ferais avant de l'intégrer quelque part : par tâche, au lancement et au catalogue, face aux modèles qu'il poursuit.
Il y a une deuxième raison de voir les choses ainsi. eesel fait tourner des modèles d'IA sur de vraies files de support depuis des années, et la facture au token n'a jamais été la partie coûteuse de ces déploiements. Le coûteux, c'est tout ce qui entoure le modèle. J'y reviendrai à la fin, avec des chiffres réels d'un de nos clients.
Si vous voulez d'abord l'histoire de la vitesse et des benchmarks, ma présentation de Mercury 3 explique ce qu'est le modèle et sa vitesse. Cet article ne parle que d'argent.
Combien coûte Mercury 3 ?
Voici la grille tarifaire d'Inception elle-même, tirée de la page des modèles et de la documentation des modèles, vérifiée le 20 octobre 2026.
| Modèle | Entrée (catalogue → lancement) | Entrée en cache | Sortie (catalogue → lancement) | Contexte | Sortie max. |
|---|---|---|---|---|---|
| Mercury 3 | $0.20 → $0.10 | $0.02 → $0.01 | $0.70 → $0.35 | 1M | 131,072 |
| Mercury Voice | $0.40 → $0.20 | $0.04 → $0.02 | $1.50 → $0.75 | 128K | 50,000 |
| Mercury Decide | $0.04 → $0.02 | $0 | $0 (non facturé) | n/d | n/d |
| Mercury Edit 2 | $0.25 | $0.025 | $0.75 | 32K | 8,192 |
| Mercury 2.5 (retiré) | $0.20 | $0.02 | $0.75 | 260K | 65,536 |
| Mercury 2 (retiré) | $0.25 | $0.025 | $0.75 | 128K | 50,000 |
Tous les prix sont par million de tokens. Quelques points que le tableau ne dit pas seul :
- L'unité facturée est le token simple. La FAQ d'Inception indique que les tokens de raisonnement sont comptés dans les tokens de completion et facturés au tarif de sortie, et que les tokens en cache sont un sous-ensemble des tokens du prompt facturés au tarif du cache. Il n'y a pas de frais par requête.
- L'effort de raisonnement se règle par requête. Mercury 3 accepte
instant,low,mediumouhigh, et selon la documentation sur le raisonnement il utiliselowpar défaut si vous ne le réglez pas. Les benchmarks d'Inception ont tous été exécutés en medium : si vous copiez leurs réglages, attendez-vous à plus de tokens de sortie qu'avec la valeur par défaut. - Mercury Voice est réservé à l'enterprise via l'API, selon la documentation, et Mercury Decide est un endpoint distinct pour la classification qui ne facture que l'entrée.
Les trois formules d'accès
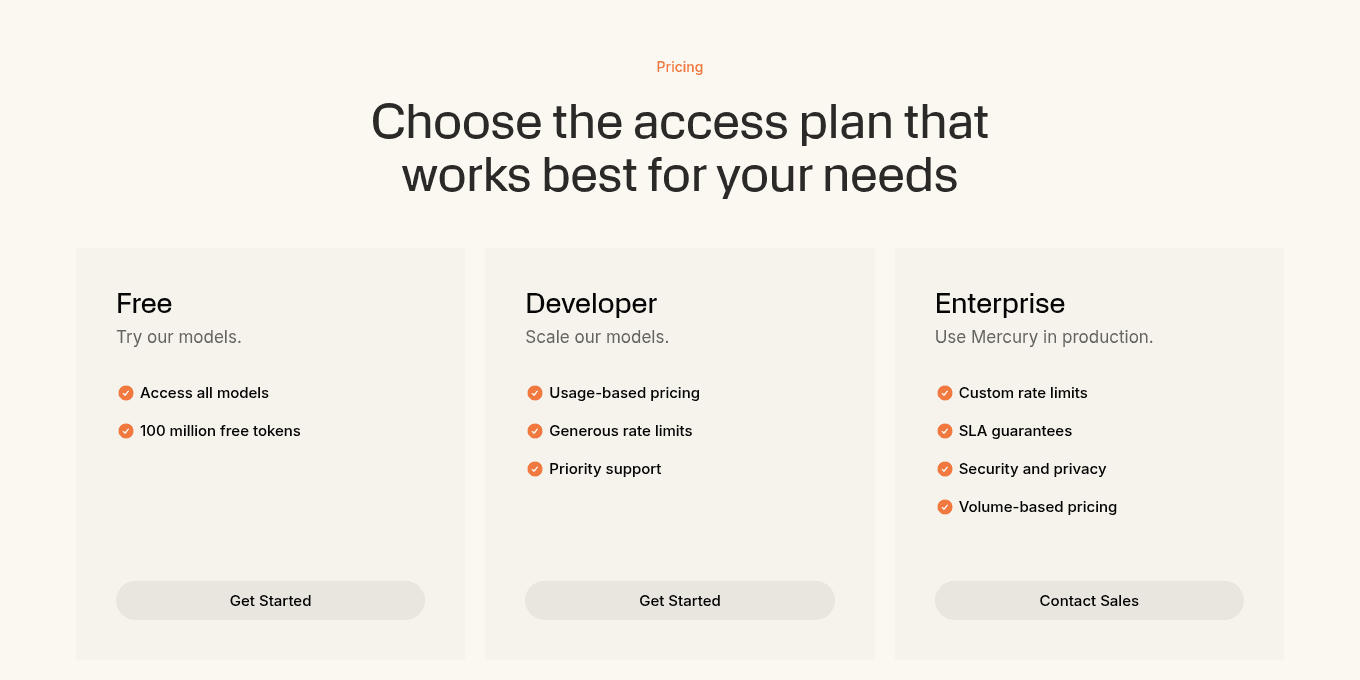
En plus des prix par token, Inception vend l'accès en trois formules. Elles changent vos limites de débit et le support, pas le prix du token.
| Formule | Ce que vous payez | Requêtes par minute | Tokens d'entrée par minute | Tokens de sortie par minute |
|---|---|---|---|---|
| Free | 100M de tokens gratuits, une seule fois | 1,000 | 1,000,000 | 100,000 |
| Developer (paiement à l'usage) | À l'usage, grille ci-dessus | 3,000 | 3,000,000 | 300,000 |
| Enterprise | Tarifs au volume | Personnalisé | Personnalisé | Personnalisé |
Les limites proviennent de la page des limites de débit d'Inception. Le crédit gratuit est une dotation unique partagée entre tous les modèles, pas une allocation mensuelle, d'après la FAQ. Quand il s'épuise, vous ajoutez une carte dans la facturation et continuez aux tarifs à l'usage.
Ce que signifie vraiment la remise de lancement de 50%
La remise est le fait tarifaire le plus important de Mercury 3, et le moins précisé. La page des modèles comme la documentation disent que Mercury 3 est "50% off at launch". Aucune ne donne de date de fin, de plafond de tokens ni de préavis.
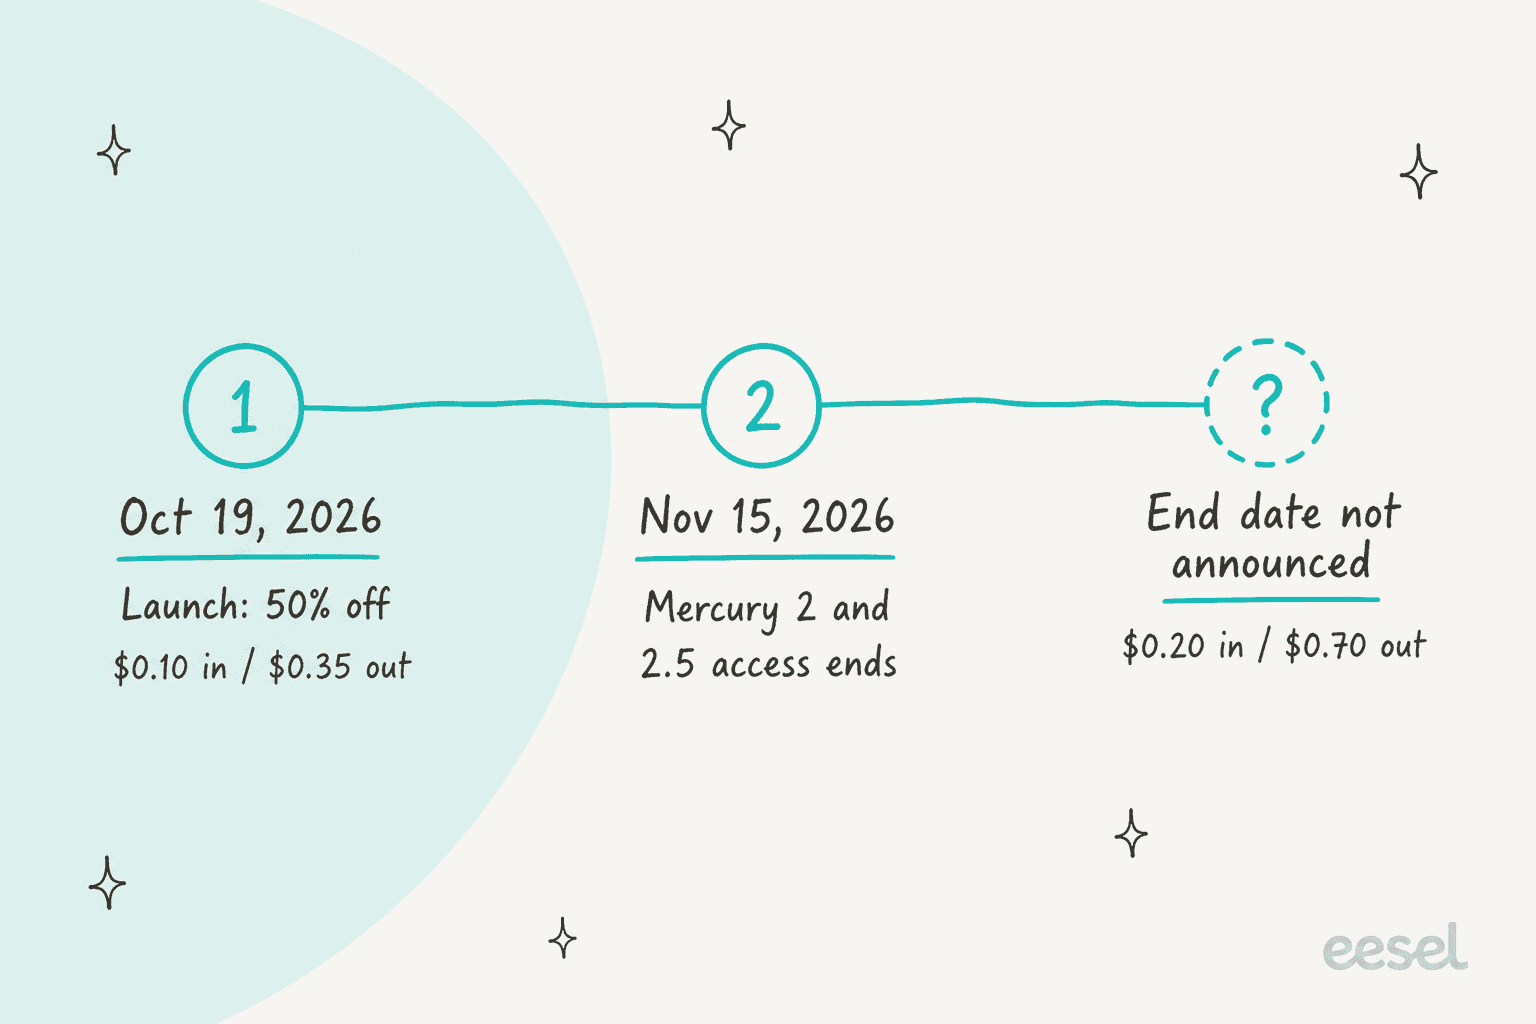
C'est inhabituel pour ce segment. La page de tarifs Gemini de Google propose aussi une promo sur Gemini 3.8 Flash, mais elle date les deux bouts : $0.75 en entrée et $3.75 en sortie jusqu'au 31 décembre 2026, puis $1.50 et $7.50 à partir du 1er janvier 2027. Avec Mercury 3, vous connaissez le prix d'après mais pas la date, donc tout budget bâti sur $0.35 de sortie a un trou. Les premiers utilisateurs l'ont remarqué :
"I'm going to start using this instead of Haiku/GPT-Luna for tasks that require speed. I'm wondering if it'll still be useful once the discount is lifted?"

Deux bonnes nouvelles accompagnent cela. D'abord, le cofondateur d'Inception a dit dans ce même fil que le modèle "runs in our API at reasonable costs", ce qui est son explication des prix de lancement. Un autre commentateur a objecté que les prix "can always be set at a loss", et il n'existe aucune donnée publique dans un sens ou dans l'autre.
Ensuite, si vous êtes déjà client Mercury, le prix catalogue reste une petite économie. Mercury 2.5 coûte aujourd'hui $0.20 en entrée et $0.75 en sortie, donc Mercury 3 à son plein tarif de sortie de $0.70 est moins cher que le modèle qu'il remplace, avec près de quatre fois plus de contexte. Les utilisateurs de Mercury 2 économisent aussi sur l'entrée. Les clients existants conservent l'accès à Mercury 2 et 2.5 jusqu'au 15 novembre 2026 : cette migration a donc une échéance, même si la remise n'en a pas.
Mercury 3 vs GPT-6 Luna, Haiku 5.5, DeepSeek et Gemini Flash
Inception positionne Mercury 3 face à GPT-6 Luna et Claude Haiku 5.5. J'ai ajouté DeepSeek V4.1 Flash, auquel les testeurs de Hacker News l'ont comparé, et Gemini 3.8 Flash comme option de Google. Chaque prix ci-dessous vient de la page du fournisseur concerné.
| Modèle | Entrée | Entrée en cache | Sortie | Règle pour prompts longs | Source |
|---|---|---|---|---|---|
| Mercury 3 (lancement) | $0.10 | $0.01 | $0.35 | Fixe jusqu'à 1M | Inception |
| Mercury 3 (catalogue) | $0.20 | $0.02 | $0.70 | Fixe jusqu'à 1M | Inception |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | Au-delà de 272K : 2x l'entrée, 1,5x la sortie | OpenAI |
| Claude Haiku 5.5 | $0.10 | $0.01 | $0.50 | Au-delà de 100K : $0.50 / $2.50 | Anthropic |
| DeepSeek V4.1 Flash | $0.15 | $0.003 | $0.60 | Fixe jusqu'à 1M ; heures de pointe 2x | DeepSeek |
| Gemini 3.8 Flash | $0.75 | $0.075 | $3.75 | Promo jusqu'au 31 déc. 2026, puis 2x |
Par million de tokens, palier standard. Les chiffres de DeepSeek sont ceux des heures creuses ; en heures de pointe (de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine) le prix double.
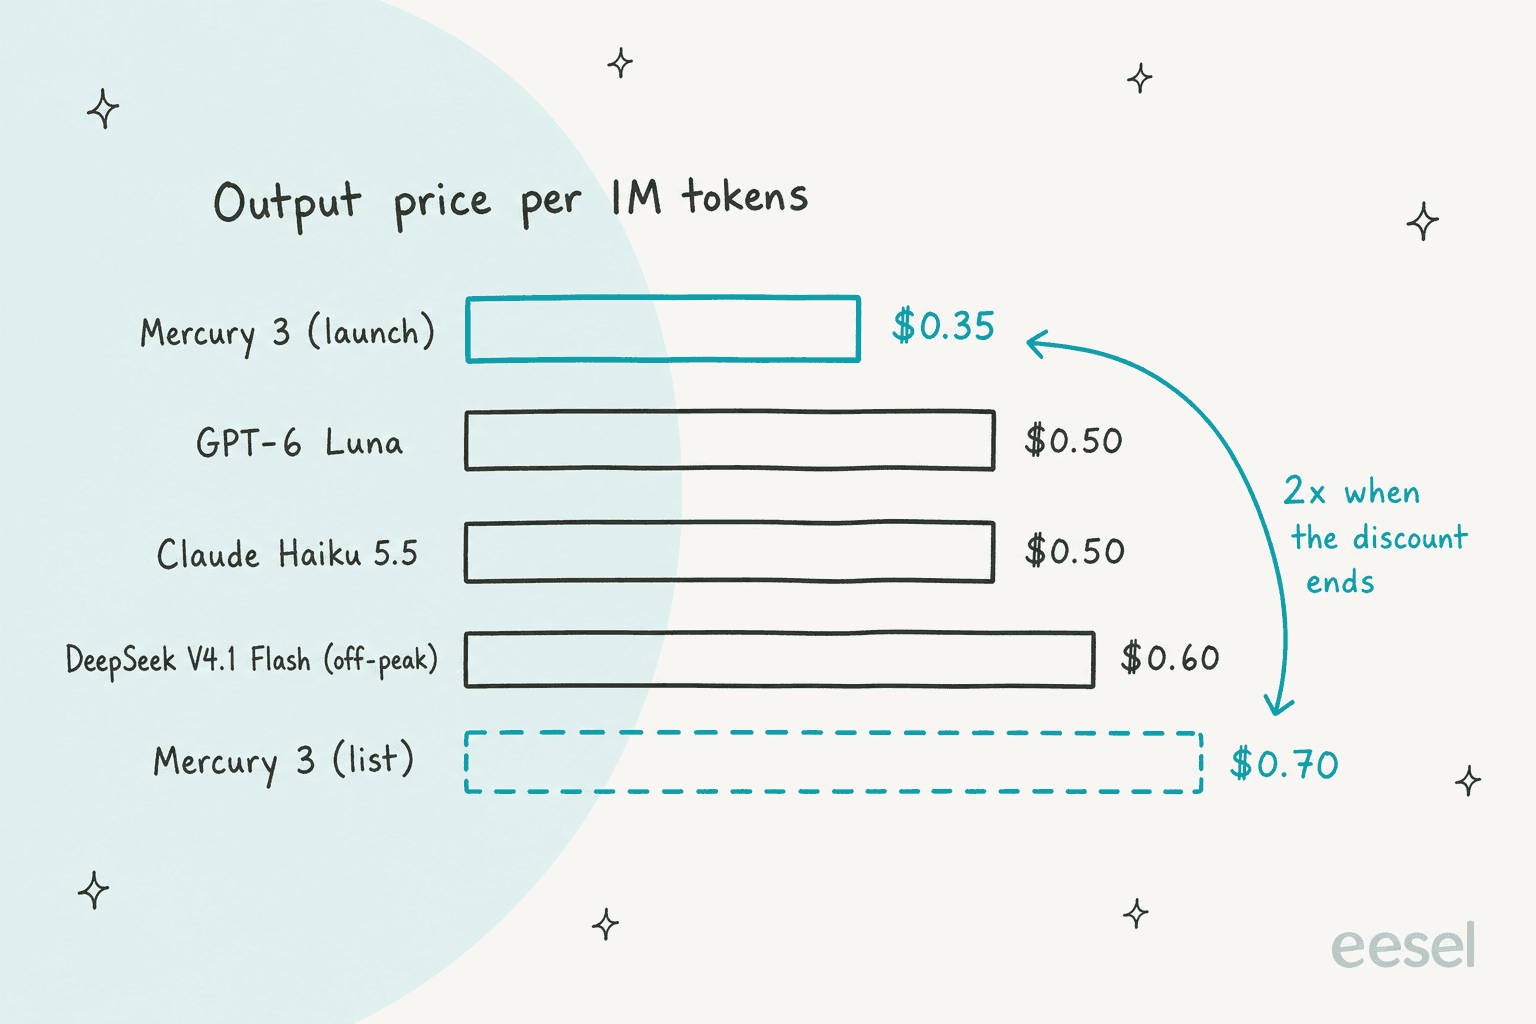
Lisez la colonne de sortie et l'histoire est simple. Au lancement, Mercury 3 a le token de sortie le moins cher de ce groupe. Au catalogue, il a la sortie la plus chère des quatre modèles économiques, et Gemini 3.8 Flash se situe dans une tout autre gamme de prix.
Sur l'entrée, c'est l'égalité avec Luna et Haiku à $0.10 pendant le lancement, puis le double au catalogue. Sur l'entrée en cache, DeepSeek joue dans une autre ligue à $0.003, plus de trois fois moins cher que le tarif en cache de tous les autres.
La colonne que la plupart des comparatifs sautent est la règle pour prompts longs. Haiku 5.5 facture toute la requête à $0.50 en entrée et $2.50 en sortie dès que le prompt dépasse 100 000 tokens, lectures de cache comprises. Luna passe à 2x l'entrée et 1,5x la sortie au-delà de 272K. Mercury 3 facture le même tarif sur toute sa fenêtre de 1M, ce qu'un testeur précoce a tout de suite repéré :
"If these benchmarks hold up it is a no-brainer against Haiku 5.5 and GPT-6 Luna, especially considering that Haiku 5.5 becomes 5x more expensive past 100k context, and this model goes up to 1M for the same price. (Note: the price increases 2x after a period post launch but is still way lower than Haiku is priced for >100k requests)"
Mes analyses des tarifs de GPT-6 Luna et des tarifs de Haiku 5.5 détaillent ces seuils, et l'article sur les tarifs de V4.1 Flash explique les règles d'heures de pointe de DeepSeek.
Calculateur de coût Mercury 3
Les tarifs par million de tokens sont difficiles à se représenter. Choisissez une tâche ci-dessous, ou saisissez vos propres volumes de tokens, et le calculateur chiffre un mois sur chaque modèle au tarif standard de son fournisseur. Basculez DeepSeek entre heures creuses et heures de pointe pour voir à quel point l'horloge compte chez lui.
Choisissez une tâche ou saisissez vos propres volumes de tokens pour comparer un mois de Mercury 3 au prix de lancement et au prix catalogue avec GPT-6 Luna, Claude Haiku 5.5, DeepSeek V4.1 Flash et Gemini 3.8 Flash.
Ce que coûte une vraie tâche sur Mercury 3
Voici les quatre préréglages du calculateur sous forme de tableau, pour voir la tendance sans cliquer. Chacun suppose les tarifs standard, DeepSeek en heures creuses et aucun crédit gratuit.
| Tâche (par mois) | Forme d'une tâche | Mercury 3 lancement | Mercury 3 catalogue | GPT-6 Luna | Haiku 5.5 | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|---|
| 20,000 réponses de support | 1 appel, 6,000 en entrée (70% en cache), 400 en sortie | $7.24 | $14.48 | $8.44 | $8.44 | $10.45 | $63.30 |
| 10,000 tâches d'agent | 12 appels, 8,000 en entrée (85% en cache), 600 en sortie | $47.76 | $95.52 | $58.56 | $58.56 | $67.25 | $439.20 |
| 1,000 documents longs | 1 appel, 200,000 en entrée, 2,000 en sortie | $20.70 | $41.40 | $21.00 | $105.00 | $31.20 | $157.50 |
| 500,000 classifications | 1 appel, 1,500 en entrée, 150 en sortie | $101.25 | $202.50 | $112.50 | $112.50 | $157.50 | $843.75 |
Trois choses ressortent.
D'abord, chaque chiffre est petit. Dix mille tâches d'agent de 12 étapes coûtent moins de $100 par mois sur Mercury 3, même au prix catalogue. Pour la plupart des équipes qui lisent ceci, la facture du modèle n'est pas la décision. La vitesse, la qualité et le travail autour du modèle le sont.
Ensuite, le prix catalogue change le classement. Au lancement, Mercury 3 gagne toutes les lignes. Au catalogue, il perd face à Luna et Haiku 5.5 sur les réponses de support, les tâches d'agent et la classification, d'environ 1,6 à 1,8 fois. Sur les documents longs, il bat Haiku 5.5, dont le tarif au-delà de 100K s'applique ($41.40 contre $105), mais coûte encore environ le double des $21 de Luna. Au-delà de 272K de prompt, le tarif contexte long de Luna ramène cet écart à l'égalité.
Enfin, la sortie représente l'essentiel de la facture dès que le cache fonctionne. Sur la ligne des tâches d'agent au prix catalogue, voici où va l'argent :
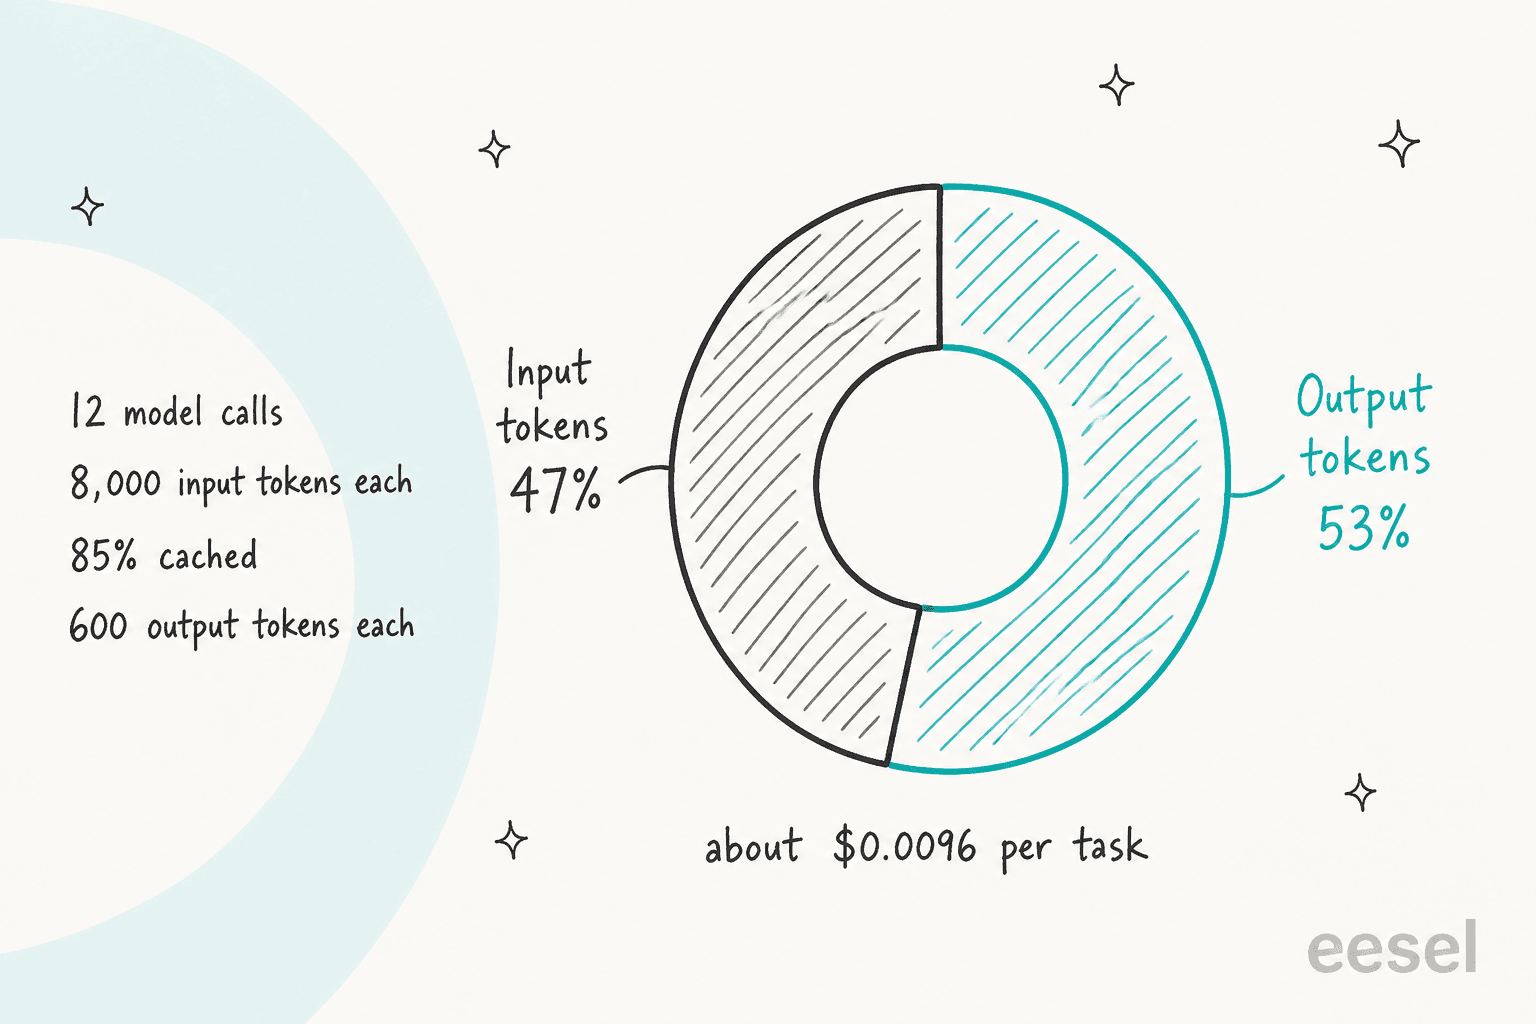
Avec 85% de l'entrée en cache au dixième du prix, les 600 tokens de sortie par appel pèsent plus que 8 000 tokens d'entrée. Comme les tokens de raisonnement sont facturés en sortie, l'effort de raisonnement choisi est le principal levier de coût. Passer du low par défaut à medium ou high ajoute des tokens de réflexion à chaque appel. Testez si instant ou low tiennent la qualité sur votre tâche avant de payer davantage.
Une autre ligne de ce tableau mérite sa propre remarque. Si votre tâche est de la classification, Mercury 3 n'est pas le bon modèle Inception à chiffrer. Mercury Decide ne facture que l'entrée, à $0.02 par million au lancement et $0.04 au catalogue, et ne facture pas la sortie. Les mêmes 500 000 classifications coûteraient environ $15 au lancement, contre $101.25 sur Mercury 3. Mon guide sur la classification de tickets par IA explique quand un classifieur bat un modèle de chat pour cette tâche.
Les détails de facturation qui font bouger votre facture
Au-delà de la grille tarifaire, cinq détails changent ce que vous payez réellement. Aucun n'est caché, mais ils sont répartis sur quatre pages différentes.
Le cache est automatique, sans frais d'écriture
Inception met en cache de lui-même les préfixes de prompt répétés, sans paramètre de requête. Les tokens en cache sont facturés au dixième du prix d'entrée, et la grille n'a pas de surcoût d'écriture en cache. C'est plus simple que les grilles d'OpenAI et d'Anthropic, qui affichent toutes deux un tarif d'écriture en cache distinct ($0.125 par million pour Luna et pour les écritures de 5 minutes de Haiku 5.5). La contrepartie est le contrôle : la FAQ dit qu'Inception ne documente pas la durée de conservation d'un préfixe, et vous ne pouvez ni épingler ni inspecter les entrées.
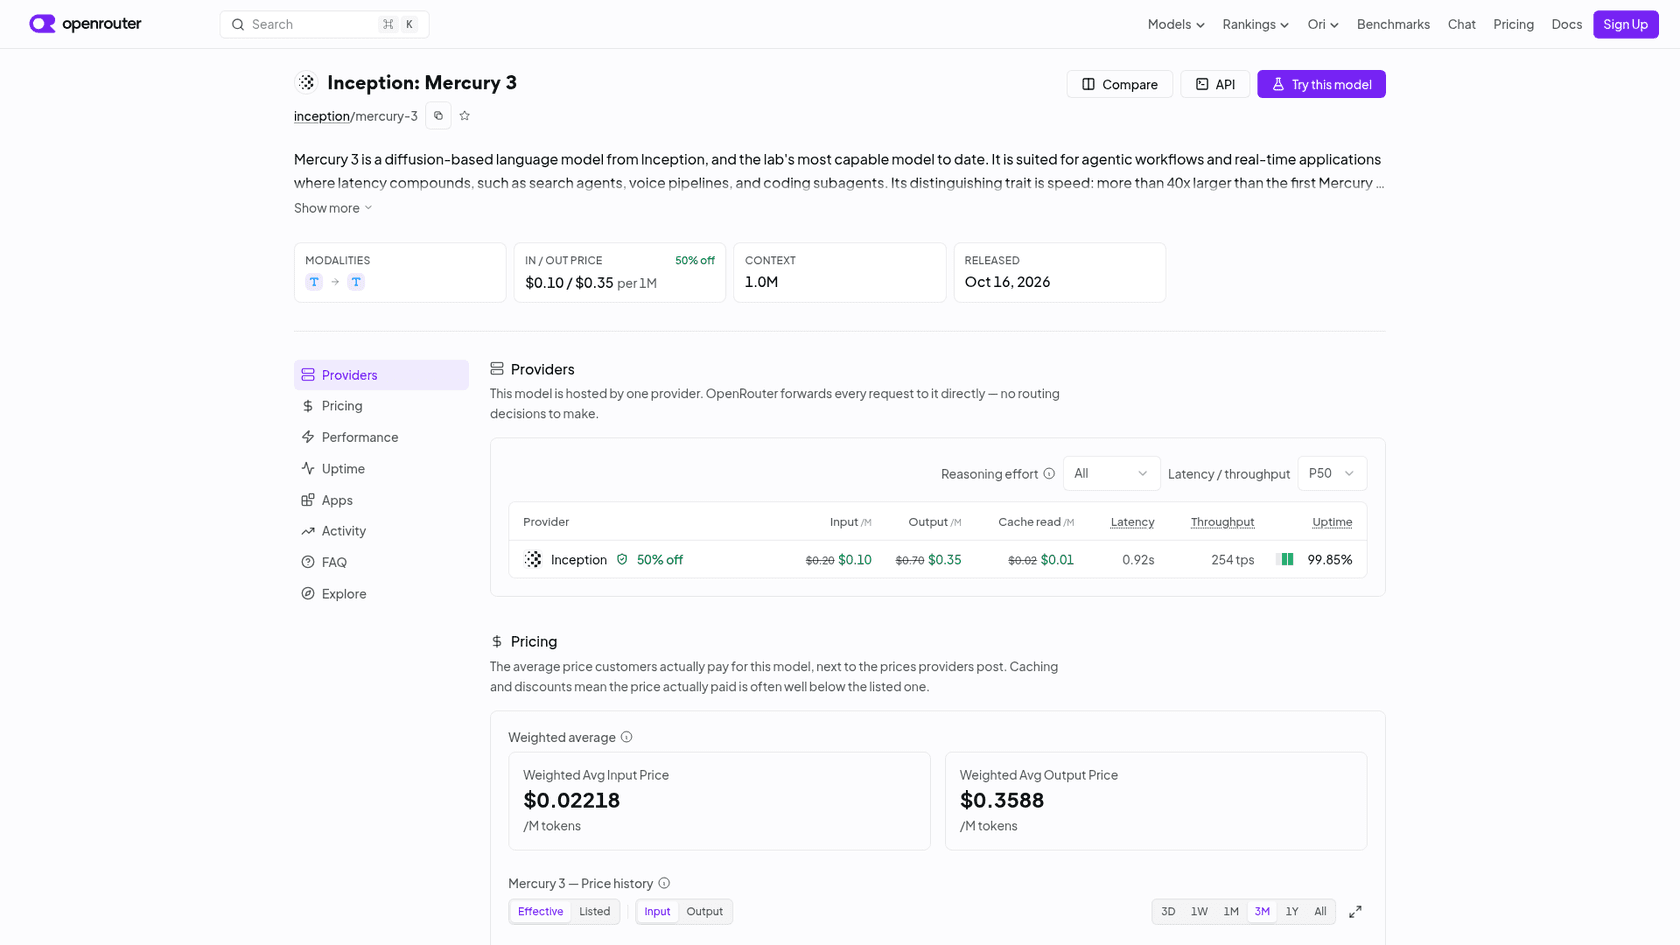
L'effet en pratique est important. OpenRouter publie ce que les utilisateurs de Mercury 3 paient réellement, et le 20 octobre 2026 son prix d'entrée moyen pondéré était de $0.0222 par million, contre $0.10 affichés, avec un taux de réussite du cache de 86,6% sur l'ensemble de son trafic. Si votre application réutilise un long prompt système, budgétez votre entrée plus près du tarif en cache que du tarif d'appel.
OpenRouter coûte pareil
La page Mercury 3 d'OpenRouter liste un seul fournisseur, Inception, aux mêmes prix de lancement de $0.10 / $0.35 / $0.01. Passer par OpenRouter ne vous fait donc ni gagner ni perdre sur le tarif au token. Inception cite aussi Baseten et Vercel comme partenaires de lancement, mais aucun ne publie de prix pour Mercury 3 ; Baseten demande de les contacter. Si vous achetez déjà des modèles ouverts via Together AI ou Fireworks, gardez à l'esprit que Mercury 3 n'a pas de poids publics : il n'est vendu que par Inception et les partenaires qu'elle nomme.
Les tokens gratuits vont plus loin qu'il n'y paraît
100 millions de tokens, c'est beaucoup à cette échelle. Avec la forme de réponse de support ci-dessus, environ 6 400 tokens par réponse, cela fait à peu près 15 600 réponses si chaque token est imputé sur la dotation. Avec la forme de tâche d'agent à 12 appels, environ 103 000 tokens par tâche, cela fait moins de 1 000 tâches. C'est suffisant pour mener une vraie évaluation sur votre propre trafic, ce qui est exactement comme je l'utiliserais.
Les limites de débit peuvent frapper avant le prix
Le palier gratuit autorise 100 000 tokens de sortie par minute. Une seule requête en streaming aux 1 068 tokens par seconde annoncés par Inception produit environ 64 000 tokens par minute, donc deux flux à pleine vitesse peuvent atteindre le plafond de sortie du palier gratuit. Le paiement à l'usage le triple à 300 000. En pratique, OpenRouter a mesuré une moyenne sur une semaine de 203 tokens par seconde, vous avez donc plus de marge, mais si vous prévoyez une flotte d'agents en parallèle, consultez le tableau des limites avant le tableau des prix.
Il n'y a pas de remise sur le traitement par lots
OpenAI et Anthropic proposent tous deux un traitement par lots à moitié prix sur Luna et Haiku 5.5, et Google a des paliers Batch et Flex. La grille d'Inception n'a pas de palier par lots. Pour les tâches de nuit où la latence importe peu, Luna en lot à $0.05 en entrée et $0.25 en sortie fait même mieux que le prix de lancement de Mercury 3, donc les charges compatibles avec le traitement par lots sont le seul cas où je laisserais de côté Mercury 3 pour le seul coût. Mon guide sur les tarifs de l'API OpenAI explique comment fonctionne le palier par lots.
La vitesse vaut-elle le prix catalogue ?
C'est la vraie question derrière la remise. Si Mercury 3 n'était que bon marché, la fin de la promo mettrait fin à l'argument. L'argument qui survit au prix catalogue, c'est la vitesse.
Inception annonce 1 068 tokens par seconde ; la moyenne mesurée par OpenRouter sur une semaine était de 203, contre environ 130 qu'Inception indique pour Luna. L'écart compte surtout dans les boucles d'agents, où les appels s'enchaînent et où chaque seconde de génération s'accumule. Ma présentation de Mercury 3 contient un calculateur pour ce temps d'attente. Pour les tarifs, l'angle utile est celui-ci : au catalogue, vous payez environ 1,6 à 1,8 fois la facture de tokens de Luna pour réduire le temps de génération sur de longues chaînes. Pour les sous-agents de Claude Code, les agents de navigation et les pipelines vocaux, cela en vaut souvent la peine. Pour une tâche de fond que personne n'attend, non.
Si la vitesse est ce qui vous amène, il vaut aussi la peine de comparer la voie matérielle. Groq vend de l'inférence rapide sur des modèles ouverts, présentée dans mon article sur Groq 3 LPX. Et si vous voulez comprendre pourquoi les modèles de diffusion sont rapides en premier lieu, mon explication sur les modèles d'IA basés sur la diffusion vous guide pas à pas.
Quand Mercury 3 est le choix économique, et quand il ne l'est pas
Voici comment je déciderais, en gardant le prix catalogue en tête.
- Prompts longs, à partir de 100K tokens. Mercury 3 au catalogue bat clairement Haiku 5.5 ici. Face à Luna, il coûte environ le double entre 100K et 272K, puis fait à peu près jeu égal au-delà de 272K. Si vos appels portent plusieurs centaines de milliers de tokens de documents ou d'historique, c'est un choix solide aux deux prix.
- Boucles d'agents où la vitesse compte. Payez la prime au catalogue. Relancez d'abord le calculateur avec vos vrais volumes de tokens.
- Appels courts, à gros volume et tolérants à la latence. Au catalogue, Luna et Haiku 5.5 sont moins chers, et DeepSeek V4.1 Flash en heures creuses s'en approche. Profitez du prix de lancement tant qu'il dure, mais bâtissez votre budget sur les alternatives.
- Tâches par lots ou de nuit. Utilisez un fournisseur avec palier par lots. Luna en lot coûte la moitié du tarif standard de Luna.
- Classification et routage. Chiffrez Mercury Decide, pas Mercury 3, ou un petit modèle. Mon panorama des petits modèles de langage présente des options que vous pouvez héberger vous-même.
- Tout ce qui nécessite la vision ou des poids ouverts. Mercury 3 est texte seul avec des poids fermés. DeepSeek V4.1 Flash prend en charge la vision et Gemini 3.8 Flash accepte aussi les images. Si vous voulez un modèle de diffusion ouvert, regardez DiffusionGemma.
Si vous comparez d'autres modèles de la gamme économique, mes analyses des tarifs de Gemini 3.8 Flash, des tarifs de Gemini 3.5 Flash-Lite et des tarifs de Kimi K3 utilisent la même méthode par tâche.
La facture de tokens vs le coût total d'un agent IA
L'essentiel du coût de mise au travail d'un modèle sur un vrai cas se situe hors de la grille tarifaire, et c'est dans le support que je le vois le plus clairement. Un mois de 10 000 tickets représente moins de $100 de tokens Mercury 3, même au prix catalogue. Mais pour que ces tokens répondent à des tickets, il faut construire la connexion au helpdesk, la recherche sur votre centre d'aide et vos anciens tickets, des règles de transfert, un moyen de tester sur de vraies conversations et la supervision pour repérer une mauvaise réponse. Cela représente des semaines d'ingénierie, plus la maintenance à chaque évolution de votre helpdesk ou de vos politiques.
Ce compromis nous est familier par nos propres appels commerciaux. Un responsable ingénierie d'une entreprise de matériel crypto, avec une base de connaissances Confluence de plus de 300 articles, l'a dit simplement en choisissant d'acheter plutôt que de construire :
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Regardez ce que fait tourner l'un de nos clients pour mesurer l'échelle. smava, une plateforme berlinoise de comparaison de crédits, traite environ 27 000 tickets Zendesk par mois sur deux marques avec trois agents eesel : un catégorise chaque ticket, un rédige la réponse à partir d'environ 820 macros et articles du centre d'aide, et un par marque prépare des réponses prêtes à envoyer pour les tickets sans conseiller assigné. Les agents valident chaque brouillon, et un ticket avec pièces jointes passe à une personne avec une note. Chacune de ces règles est un travail qu'une facture au token n'inclut pas.
SE Ranking est une autre forme du même constat : environ 4 650 conversations par mois sur trois produits, avec un agent eesel par produit, répondant à partir d'environ 16 800 pages de connaissances. Aucune des deux équipes n'a eu à penser aux tokens, au cache ni à l'effort de raisonnement. Mes guides sur le coût d'un agent IA vs humain et le coût d'un chatbot détaillent les chiffres complets des deux voies.
Essayer eesel
Mercury 3 est de l'infrastructure, et au lancement c'est de l'infrastructure au très bon rapport qualité-prix. eesel est l'employé. Si vous chiffrez un modèle parce que vous voulez qu'une IA réponde aux tickets de support, son teammate de helpdesk IA rejoint la file que vous gérez déjà, sur Zendesk et les autres grands helpdesks, apprend de vos anciens tickets et documents, et se rejoue sur vos conversations historiques avant de répondre à un seul client.

La tarification fonctionne comme pense un responsable support : les forfaits démarrent à $299 par mois pour 500 crédits, un ticket ou un chat vaut un crédit quelle que soit sa durée, et l'essai gratuit vous donne 100 crédits sans carte. Comparez cela à une solution maison au token sur la page des tarifs.
Si vous préférez le piloter comme vous piloteriez une API de modèle, la CLI eesel fait fonctionner le même teammate depuis un terminal, et chaque commande renvoie du JSON qu'un script ou un agent de code comme Claude Code peut lire. Mon guide sur la CLI d'agent IA montre à quoi cela ressemble. Essayez eesel sur les tickets du mois dernier et voyez par vous-même le coût par ticket traité. Et si vous êtes ici parce que vous écrivez du contenu, pas des tickets, l'équipe compte aussi un rédacteur de blog IA.
Comment fonctionne le tarif de l'entrée en cache de Mercury 3 ?