

Combien coûte Elorian Glimpse ?
Je suis Alicia, je développe des fonctionnalités et des agents IA chez eesel. Une bonne part de ma semaine passe dans l'écart entre ce qu'un modèle coûte par token et ce qu'il coûte par travail terminé, car c'est dans cet écart que les budgets IA dérapent. Avant de faire le moindre calcul sur Glimpse, j'ai donc lu ligne par ligne l'article de lancement d'Elorian, les conditions de la plateforme et les pages des fournisseurs. La vision est aussi une question d'actualité dans mon travail : dans les appels commerciaux d'eesel cette année, des équipes de support de produits techniques demandaient sans cesse une IA capable de lire les schémas de leurs PDF et les photos que les clients joignent aux tickets. Je voulais donc connaître le coût réel d'un modèle conçu précisément pour ce genre de regard.
Glimpse a été lancé le 16 octobre 2026, comme premier modèle d'Elorian, une startup fondée par Andrew Dai, qui a auparavant codirigé le travail sur les données de Gemini chez Google DeepMind. Elorian l'appelle un modèle de « pensée visuelle » : il prend des images et de la vidéo, zoome sur des régions, revoit de courts passages à une cadence d'images plus élevée, et ne répond qu'ensuite en texte. C'est un aperçu de recherche, post-entraîné à partir d'un modèle de base à poids ouverts.
Voici tout ce que vous pouvez acheter aujourd'hui et ce que cela coûte :
| Mode d'accès | Entrée (par 1 M de tokens) | Entrée en cache (par 1 M) | Sortie (par 1 M de tokens) | Remarques |
|---|---|---|---|---|
| API d'Elorian | $0.60 | Non publié | $3.00 | Inscription sur la plateforme d'Elorian |
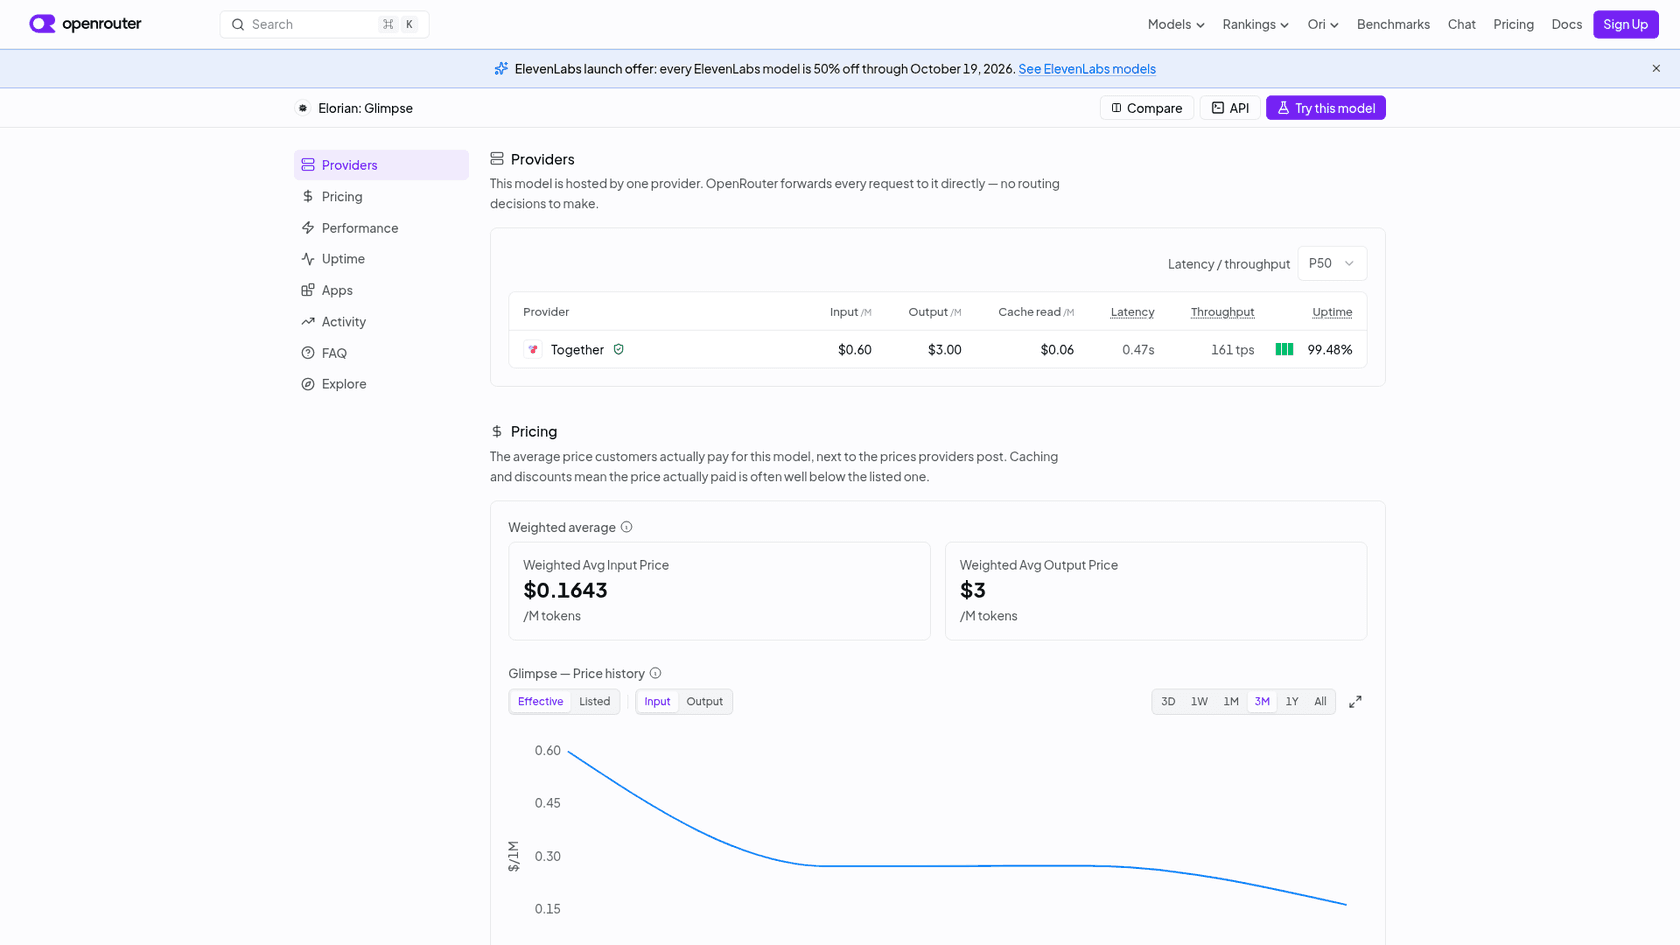
| OpenRouter | $0.60 | $0.06 | $3.00 | Chaque requête va chez Together AI |
| Together AI dédié | Contacter les ventes | Contacter les ventes | Contacter les ventes | GPU mono-locataire, facturés à l'heure |
| Interface de chat d'Elorian | Gratuit | Gratuit | Gratuit | Chat web, pas une API |
Côté caractéristiques, OpenRouter indique une fenêtre de contexte de 262,144 tokens et jusqu'à 256,000 tokens de sortie. Les entrées sont du texte, des images et de la vidéo. La sortie est uniquement du texte.
Deux choses manquent dans les documents d'Elorian, et elles comptent. Il n'y a pas de prix de cache publié sur l'API d'Elorian elle-même, et il n'y a de remise pour le traitement par lots nulle part. Si vous voulez le cache noir sur blanc aujourd'hui, la fiche d'OpenRouter est la seule source publique.
Comment les tarifs de Glimpse se comparent-ils à Astra, Sol, Opus 5.5 et Gemini ?
L'article de lancement d'Elorian compare Glimpse à quatre modèles de pointe, et les lignes de prix sont la première chose de son tableau de résultats. Voici ce tableau, tel qu'il figure sur la page de lancement :
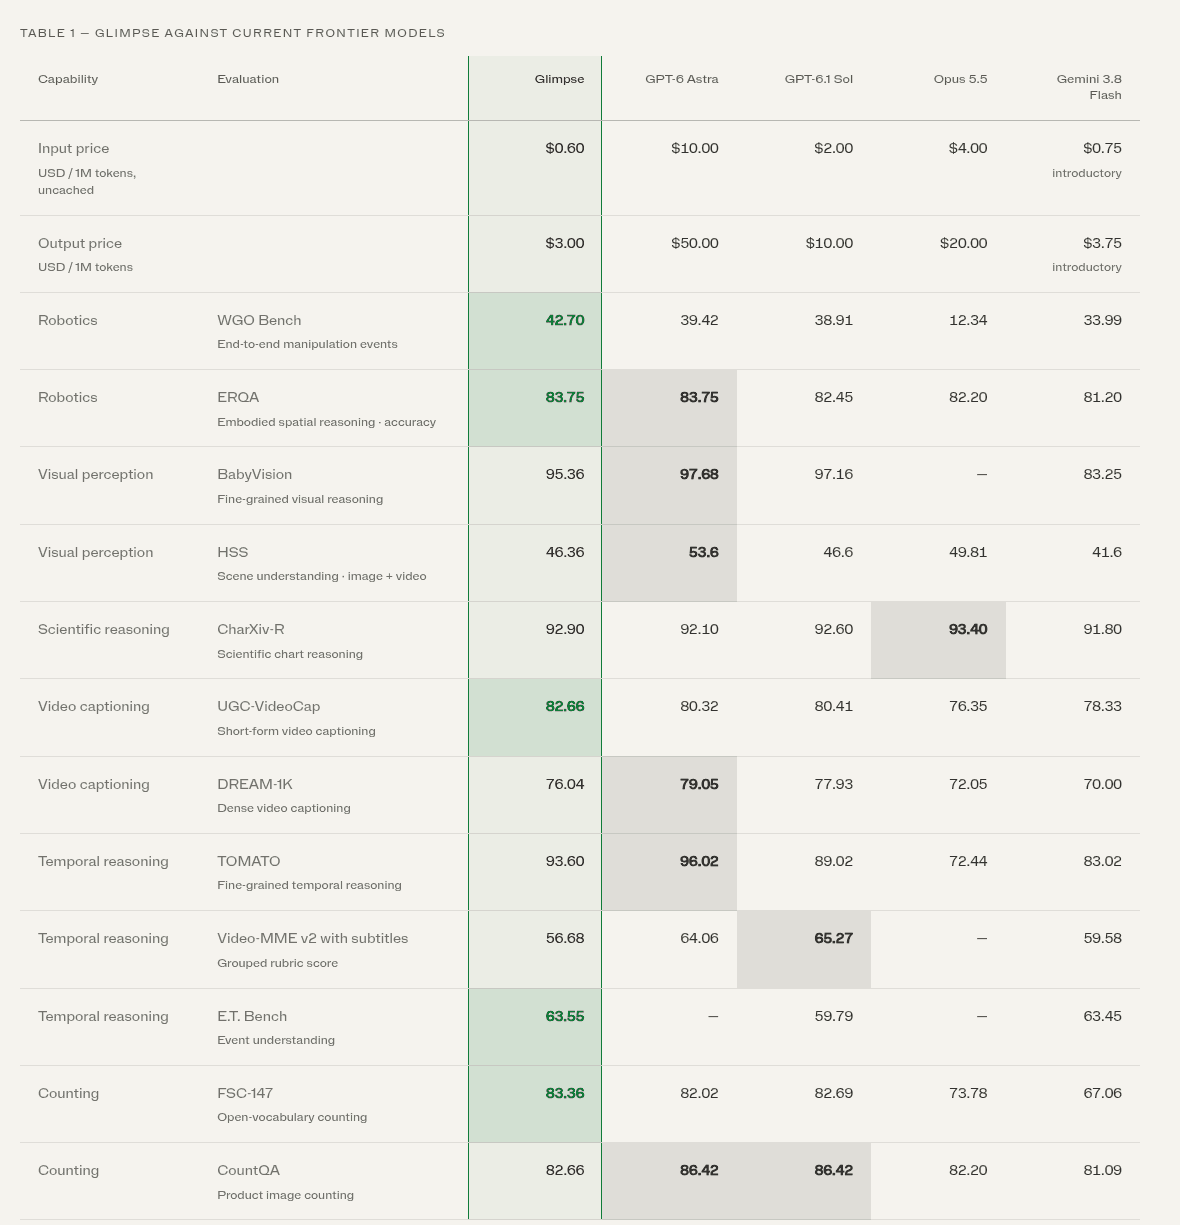
J'ai vérifié le prix de chaque concurrent sur sa page officielle et ajouté les tarifs de cache, car le cache change la donne pour les travaux riches en images où les mêmes images de référence sont envoyées encore et encore :
| Modèle | Entrée (par 1 M) | Entrée en cache (par 1 M) | Sortie (par 1 M) | Économie de Glimpse en sortie |
|---|---|---|---|---|
| Elorian Glimpse | $0.60 | $0.06 (OpenRouter) | $3.00 | - |
| Gemini 3.8 Flash (jusqu'au 31 déc. 2026) | $0.75 | $0.075 | $3.75 | 20 % |
| Gemini 3.8 Flash (à partir du 1er janv. 2027) | $1.50 | $0.15 | $7.50 | 60 % |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | 70 % |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 | 85 % |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | 94 % |
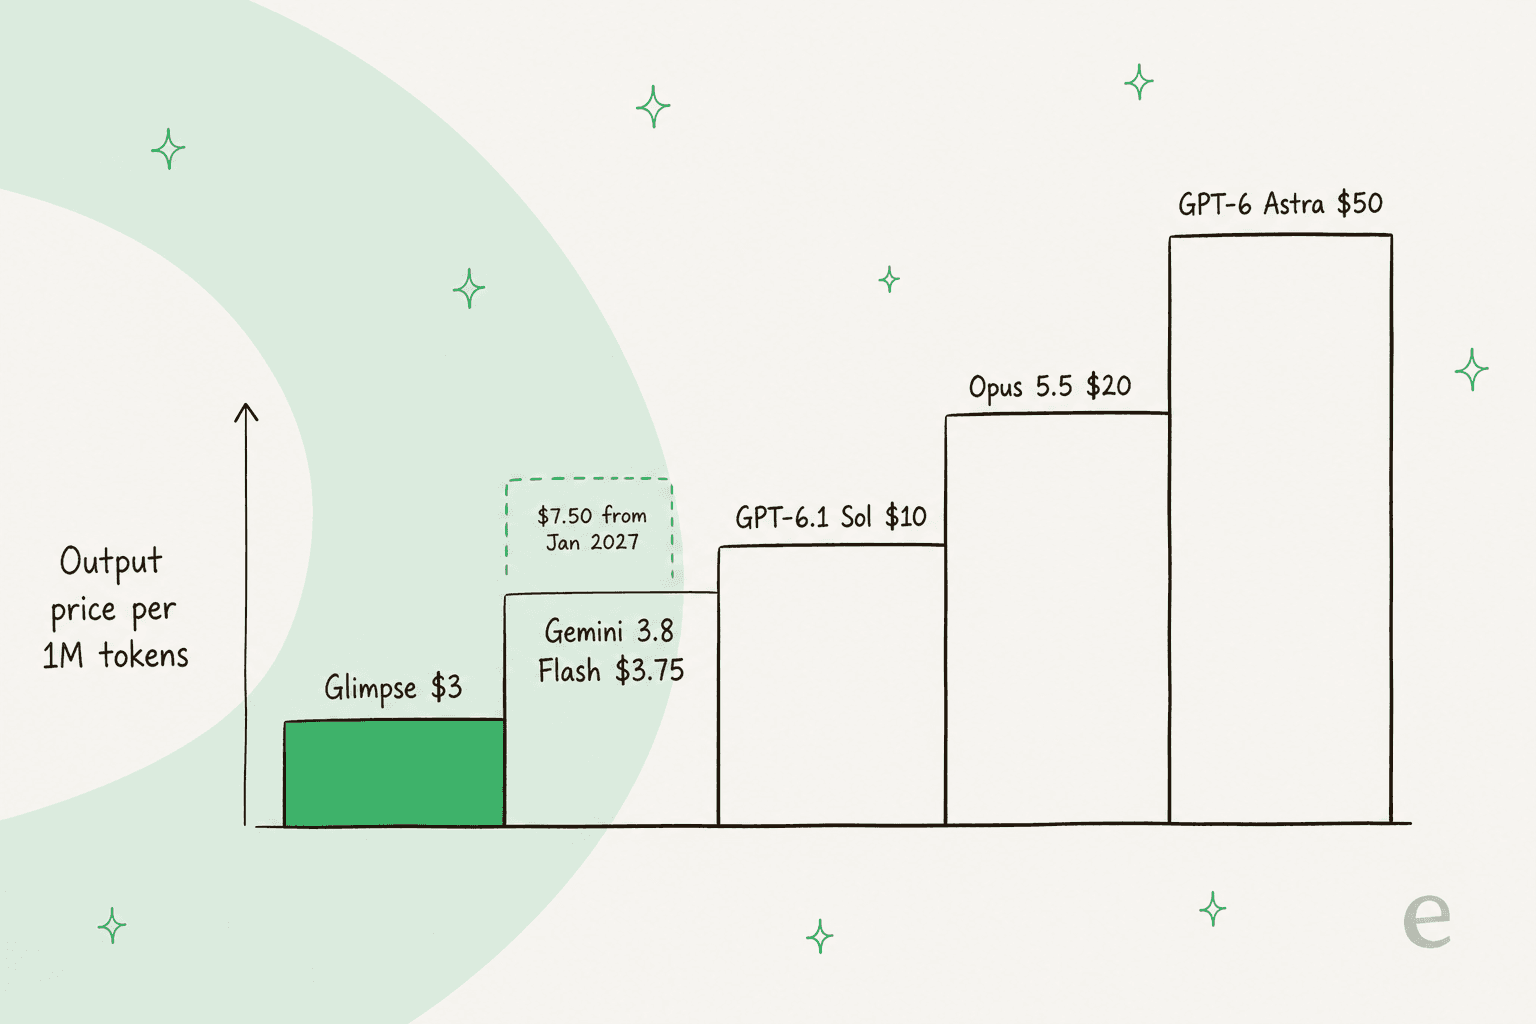
La ligne qui mérite le plus d'attention est celle de Gemini. Elorian prend soin d'écrire « introductory » à côté du prix de Flash, et ce mot compte : Gemini 3.8 Flash passe de $0.75 et $3.75 à $1.50 et $7.50 le 1er janvier 2027. Aujourd'hui, Glimpse sous-cote Flash de 20 %. Dans dix semaines, il le sous-cote de 60 %. Si vous choisissez entre les deux pour un projet qui court jusqu'en 2027, calculez sur la colonne 2027, pas sur celle d'octobre.
À l'autre bout, la comparaison avec Astra est le titre qu'Elorian met en avant, et elle tient sur la grille tarifaire. GPT-6.1 Sol se situe au milieu, à $2 et $10, et Opus 5.5 à $4 et $20.
Parmi les alternatives ouvertes et économiques avec vision, l'aperçu DeepSeek V4 Flash Vision et Nemotron 3.5 Super VL sont tous deux encore moins chers par token, même si aucun n'est conçu pour revoir la vidéo comme Glimpse.
Pour les grilles tarifaires complètes des éditeurs, consultez les guides des tarifs de l'API OpenAI, des tarifs de Gemini et des tarifs de l'API Anthropic.
Pourquoi l'économie réelle est-elle inférieure à 94 % ?
Parce que Glimpse est conçu pour regarder deux fois, et regarder coûte des tokens. Elorian le dit lui-même dans l'article de lancement : « Looking that closely takes time, and tokens. Token efficiency is our next highest focus. »
La preuve la plus nette est la démo de robot d'Elorian elle-même. Glimpse et GPT-6 Astra ont tous deux joué le rôle de planificateur pour la même politique de robot (π0.5 de Physical Intelligence) sur la même tâche : mettre le fromage frais dans le bol, puis poser le bol sur le meuble. Les deux ont réussi. D'après l'article de lancement, la planification de Glimpse a coûté $0.035 pour l'épisode et celle d'Astra $0.249.
C'est un écart de 7,1 fois. L'écart de la grille tarifaire est de 16,7 fois. La différence ne peut venir que du nombre de tokens, et sur cette tâche, elle implique que Glimpse a utilisé environ 2,3 fois plus de tokens qu'Astra pour arriver au même résultat. C'est mon calcul à partir des deux chiffres d'Elorian, pas un chiffre publié par Elorian, et il vient d'une seule démo. Mais c'est la bonne forme d'avertissement pour quiconque budgète à partir du titre à 94 %.
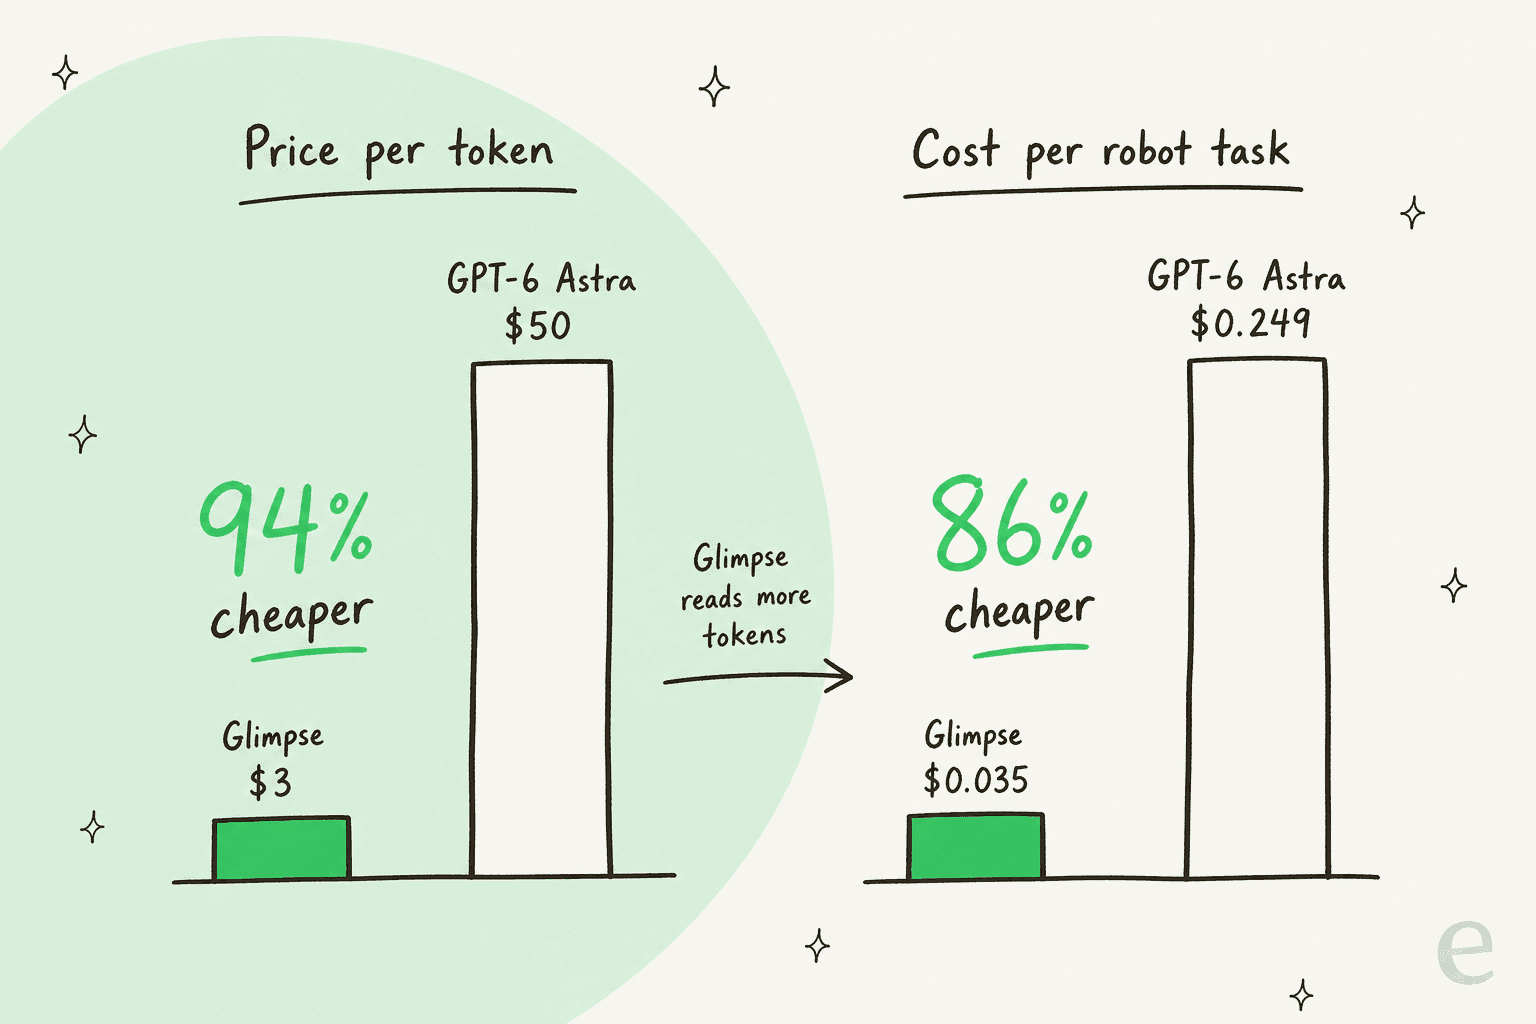
Une économie de 86 % reste une très bonne affaire, et pour la robotique, elle change ce qui est abordable. Brian Zhan, investisseur dans Elorian, a fait le calcul à l'heure sur cette démo précise :
"A check every 2s is 1,800 calls per robot-hour. Glimpse is 7x cheaper than GPT-6 Astra and ~1s faster per call. The same budget on Astra buys one check every 14s."
Notez le « 7x », pas « 16x ». Même les soutiens d'Elorian citent le chiffre par tâche quand ils font de vrais calculs. Ce regard supplémentaire se voit aussi dans la façon dont les premiers testeurs décrivent le modèle :
"Glimpse broke the image into four sections, zoomed in to examine the details, and analyzed the visual clues before reaching its final answer: 5 horses."
Quatre recadrages et un zoom donnent une meilleure réponse. Cela représente aussi les tokens de quatre recadrages et d'un zoom.
Où part réellement la facture de Glimpse ?
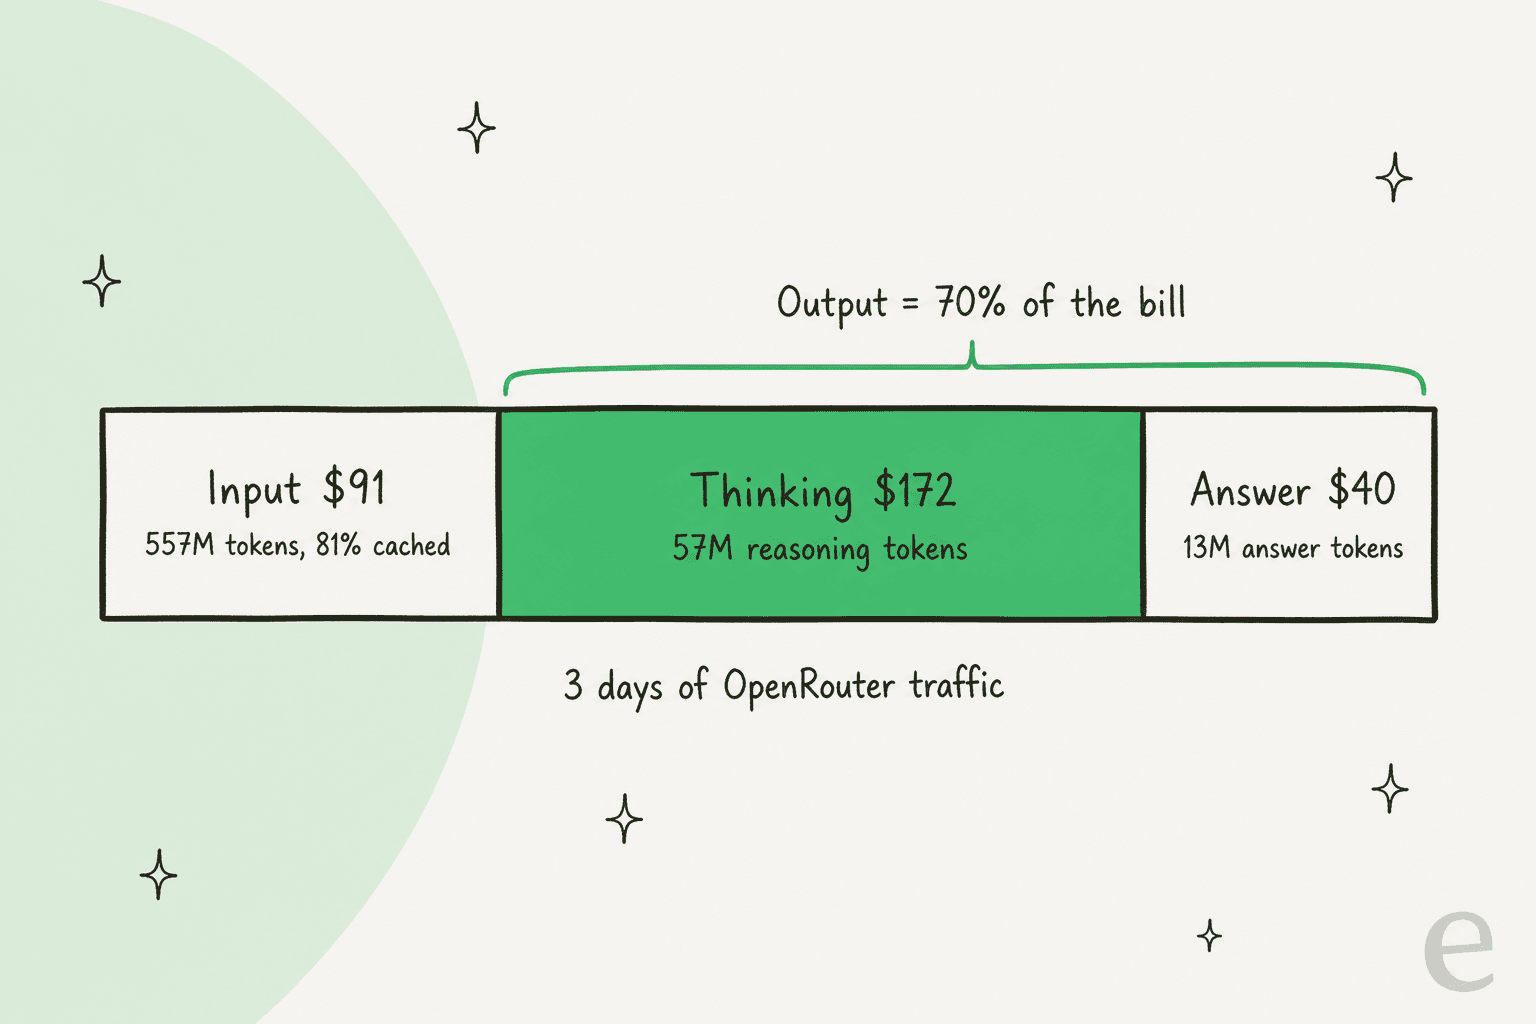
OpenRouter publie le trafic en direct de chaque modèle qu'il héberge, ce qui offre un aperçu rare de la façon dont de vraies charges de travail dépensent de l'argent sur Glimpse. Pendant ses trois premiers jours, la page d'OpenRouter affichait 557M tokens de prompt, 57.2M tokens de raisonnement et 13.2M tokens de réponse.
Deux chiffres de cette page expliquent l'essentiel de la facture :
- Taux de réussite du cache de 80,7 %. La plus grande partie de l'entrée a été servie depuis le cache à
$0.06, ce qui fait tomber le prix d'entrée moyen payé à$0.1643par million, environ 73 % sous le prix catalogue de$0.60. - Le raisonnement représente 81 % de la sortie. Sur les
70.4Mtokens de sortie,57.2Métaient de la réflexion et seulement13.2Mla réponse visible. Sur OpenRouter, les tokens de raisonnement sont facturés comme de la sortie au tarif plein de$3.
Mettez ces deux chiffres ensemble et l'argent bascule. L'entrée représente 89 % des tokens, mais seulement environ $91 des quelque $303 dépensés. La sortie représente environ $211, soit 70 %, et la réflexion seule coûte plus cher que toute l'entrée réunie.
C'est un mélange de trafic, pas le vôtre. Les principales applications envoyant du trafic à Glimpse ces premiers jours étaient des agents de codage et Hermes Agent, qui renvoient de longs prompts stables et utilisent bien le cache. Un pipeline qui envoie un nouveau clip vidéo à chaque appel utilisera beaucoup moins le cache, et l'entrée prendra une plus grande part. Mais la leçon reste valable : sur Glimpse, le levier est le raisonnement, pas l'image. Le paramètre reasoning d'OpenRouter permet de fixer l'effort ou un budget maximal de raisonnement, et c'est le premier bouton que je tournerais lors d'une revue des coûts.
Estimez votre propre facture Glimpse
Saisissez votre volume de requêtes et vos tailles de tokens. Le « multiplicateur de tokens de Glimpse » est là à cause de l'exemple du robot ci-dessus : mettez 1.0 si vous supposez que Glimpse utilise les mêmes tokens que les autres modèles, ou environ 2.3 pour coller à ce qu'implique la démo d'Elorian elle-même.
Avec les valeurs par défaut (10 000 requêtes, 20 000 tokens d'entrée et 3 000 tokens de sortie chacune, sans cache), Glimpse revient à $210 par mois contre $262.50 pour Gemini 3.8 Flash, $700 pour Sol, $1,400 pour Opus 5.5 et $3,500 pour Astra. Faites maintenant glisser le multiplicateur à 2.3 et Glimpse passe à $483, plus que ce que coûte Gemini 3.8 Flash aujourd'hui. Activez les prix 2027 et Flash monte à $525, donc Glimpse gagne de nouveau. Ce basculement, c'est toute la décision d'achat dans un curseur.
L'interface de chat de Glimpse est-elle gratuite ?
Oui. Le fondateur Andrew Dai l'a dit dans le fil de lancement :
"Free on the chat interface at https://platform.elorian.ai with an API available too."
L'article de lancement d'Elorian le répète avec un bouton « Try Glimpse free on the Elorian platform ». L'inscription se fait par Google ou par e-mail, et il existe un contact distinct pour les comptes entreprise.
Je n'ai trouvé aucune limite d'utilisation publiée pour le chat gratuit. Les conditions de la plateforme, mises à jour pour la dernière fois le 12 octobre 2026, décrivent le fonctionnement de l'usage payant une fois cette limite dépassée :
- Les frais sont en dollars américains et non remboursables, sauf si la loi l'exige ; les demandes de remboursement sont examinées au cas par cas.
- La facturation peut fonctionner avec des crédits prépayés ou un abonnement continu.
- Si vous activez le paiement automatique, Elorian débite périodiquement votre carte pour l'usage, et vous l'annulez en contactant Elorian avant la prochaine date de facturation.
- Les essais gratuits et les offres bêta ne sont pas garantis et peuvent prendre fin.
Le chat gratuit est le bon endroit pour commencer. Il montre même le « visual scratch space » du modèle pendant qu'il zoome et revoit, ce qui est le moyen le plus rapide de sentir combien d'étapes demande votre type d'image, et donc combien de tokens l'API vous facturera.
Quels sont les coûts cachés et les pièges ?
La grille tarifaire est courte, donc les vraies surprises tiennent au comportement du modèle. Elles viennent des métriques en direct d'OpenRouter et des notes d'Elorian elles-mêmes :
| Piège | Ce que disent les chiffres | Pourquoi cela vous coûte |
|---|---|---|
| Erreurs d'appel d'outils | 9.20% de taux d'erreur sur OpenRouter | Les appels échoués sont généralement relancés, et les relances sont refacturées |
| Erreurs de sortie structurée | 10.38% de taux d'erreur | Les pipelines à schéma strict relanceront environ 1 appel sur 10 |
| Latence de longue traîne | P50 de bout en bout 12.48s, P90 76.17s | Correct pour l'étiquetage par lots, lent pour tout ce qu'une personne attend |
| Un seul fournisseur | Together est le seul hôte, 99.48% de disponibilité | Aucun fournisseur de secours si Together a une mauvaise heure |
| Aperçu de recherche | Étiquette d'Elorian elle-même | Les prix et le comportement peuvent changer, et il n'y a pas encore de palier par lots |
Les taux d'erreur sont ceux que je surveillerais de plus près. Avec 10 % de relances, votre prix effectif est environ 10 % plus élevé que ce qu'indique le calculateur, et pour les appels riches en raisonnement, une relance répète la partie coûteuse. Si vous extrayez des données structurées d'images, validez tôt et plafonnez les relances.
Sur le point des « poids ouverts » : Glimpse est post-entraîné à partir d'un modèle de base à poids ouverts, mais les poids de Glimpse eux-mêmes ne sont pas publics. La page Hugging Face d'Elorian ne liste aucun modèle. L'auto-hébergement n'est pas possible aujourd'hui. Ce qui s'en rapproche le plus est un déploiement dédié chez Together, dont la page de tarifs liste des H100 dédiés à $5.49 par GPU et par heure à la demande. Cela ne devient rentable qu'avec un volume régulier et élevé, et vous le mettriez en place via l'équipe commerciale de Together.
Que coûte Glimpse sur des charges de travail réelles ?
Voici trois exemples chiffrés avec les tarifs d'Elorian. Quand j'ai dû supposer des tailles de tokens, je le dis.
1. Planification de robot, avec le coût par épisode d'Elorian lui-même. À $0.035 par épisode, 1 000 épisodes de planification coûtent $35 avec Glimpse contre $249 avec GPT-6 Astra. C'est le seul exemple dont les nombres de tokens ont été mesurés par Elorian plutôt que supposés, donc le plus fiable. C'est aussi le cas d'usage dont Elorian et ses investisseurs parlent le plus, avec Gemini Robotics 2 et Gemini 4 Argon.
2. Étiquetage vidéo à 10 000 clips par mois. Supposez 20 000 tokens d'entrée par clip et 3 000 tokens de sortie, sans cache puisque chaque clip est nouveau. Cela donne $210 par mois avec Glimpse et $262.50 avec Gemini 3.8 Flash aux prix d'aujourd'hui. Si Glimpse a besoin de 2,3 fois plus de tokens pour revoir les passages délicats, on passe à $483, et Flash est moins cher jusqu'en janvier.
3. Un lecteur de captures d'écran pour tickets de support. Supposez 5 000 tickets par mois avec une capture chacun, environ 3 000 tokens d'entrée et 800 tokens de sortie par ticket. Sur Glimpse, cela fait environ $21 par mois. Sur Claude Opus 5.5, c'est $140. À cette échelle, la facture du modèle est une erreur d'arrondi à côté du temps d'ingénierie pour le brancher à votre helpdesk, qui est le vrai coût que j'explore dans le guide du coût du service client IA.
Le schéma est le même dans les trois cas : Glimpse est le moins cher quand la tâche exige son regard attentif, et l'économie se réduit quand la tâche est assez simple pour qu'un lecteur moins cher y soit arrivé en moins d'étapes.
Qui devrait payer pour Glimpse ?
Glimpse est une bonne affaire quand le raisonnement visuel est le produit. Étiqueter des images de robots, compter des objets avec une caméra en mouvement, vérifier si une étape d'une vidéo a réellement eu lieu : ce sont les tâches où le tableau d'Elorian lui-même montre qu'il égale ou bat des modèles qui coûtent de 6x à 16x plus cher. Un testeur a bien posé la question ouverte :
"Asking why something changed means tracking the same object across frames and tying it to a cause, and that is where a lot of vision models start guessing."
Si c'est votre problème, le prix est facile à justifier, et le chat gratuit vous permet de le vérifier sur vos propres images avant de dépenser quoi que ce soit.
Je m'en passerais, ou au moins je ferais d'abord un benchmark sérieux, dans trois cas. Premièrement, la lecture d'images simple comme l'OCR ou « quel produit est sur cette photo », où Gemini 3.8 Flash ou un modèle DeepSeek économique répondra avec moins de tokens. Deuxièmement, tout ce qu'un client attend en temps réel, vu la latence de longue traîne. Troisièmement, les pipelines à schéma strict, tant que ce taux d'erreur de 10 % en sortie structurée n'a pas baissé.
Pour tout le reste, considérez $0.60 et $3 comme un plafond du prix par token, pas comme une prévision de votre facture, et fixez un budget de raisonnement dès le premier jour. Le guide de l'optimisation des LLM couvre les autres boutons qui valent la peine d'être tournés.
Où eesel intervient
Glimpse est une infrastructure : une paire d'yeux très capable que vous appelez depuis votre propre code. Si vous évaluez des modèles de vision, ou une API de service client brute, parce que des clients envoient sans cesse des captures d'écran et des photos à votre file de support, le modèle est la plus petite partie de ce dont vous avez besoin. Il vous faut toujours la connexion au helpdesk, les connaissances, les garde-fous et un moyen de savoir qu'il répond correctement avant qu'il parle à un client.
C'est la partie dont eesel s'occupe. Le coéquipier IA d'eesel pour helpdesk se connecte à votre helpdesk existant, comme Zendesk ou Freshdesk, apprend de vos anciens tickets et de votre centre d'aide, et est simulé sur vos tickets historiques avant sa mise en service, de sorte que vous voyez ses réponses avant vos clients. Si vous comparez des modèles spécifiquement pour le support, le comparatif des meilleurs modèles pour les tickets de support est une bonne lecture suivante.
Essayez eesel gratuitement et voyez ce qu'il répondrait à vos propres tickets.
Questions fréquentes
Combien coûte Elorian Glimpse ?
$0.60 par million de tokens en entrée et de $3.00 par million de tokens en sortie sur l'API. Sur OpenRouter, les lectures d'entrée en cache coûtent $0.06 par million, ce qui explique que le prix d'entrée moyen payé là-bas soit d'environ $0.16. Comparez avec les tarifs de Gemini 3.8 Flash, à $0.75 et $3.75.Elorian Glimpse est-il gratuit ?
Glimpse est-il vraiment 94 % moins cher que GPT-6 Astra ?
$0.60 et $3 contre $10 et $50 pour Astra. Par tâche, l'écart est plus faible. Dans l'exemple de planification de robot d'Elorian lui-même, Glimpse a coûté $0.035 contre $0.249 pour Astra, soit 86 % de moins, parce que Glimpse lit davantage avant de répondre. Le détail des tarifs de GPT-6 Astra donne la grille complète d'Astra.Glimpse facture-t-il les tokens de raisonnement ?
$3 par million. Dans le trafic public d'OpenRouter pour Glimpse, le raisonnement représentait environ 81 % de tous les tokens de sortie, donc limiter le raisonnement est le plus gros levier sur votre facture. La même règle s'applique à la plupart des modèles qui réfléchissent, dont Claude Opus 5.5.Où puis-je acheter l'accès à l'API de Glimpse ?
$0.60 et $3, pour les deux premiers. Un déploiement dédié est facturé à l'heure de GPU, comme d'autres options de cette comparaison d'API.